Топологическая сортировка: алгоритм Кана и обход DFS
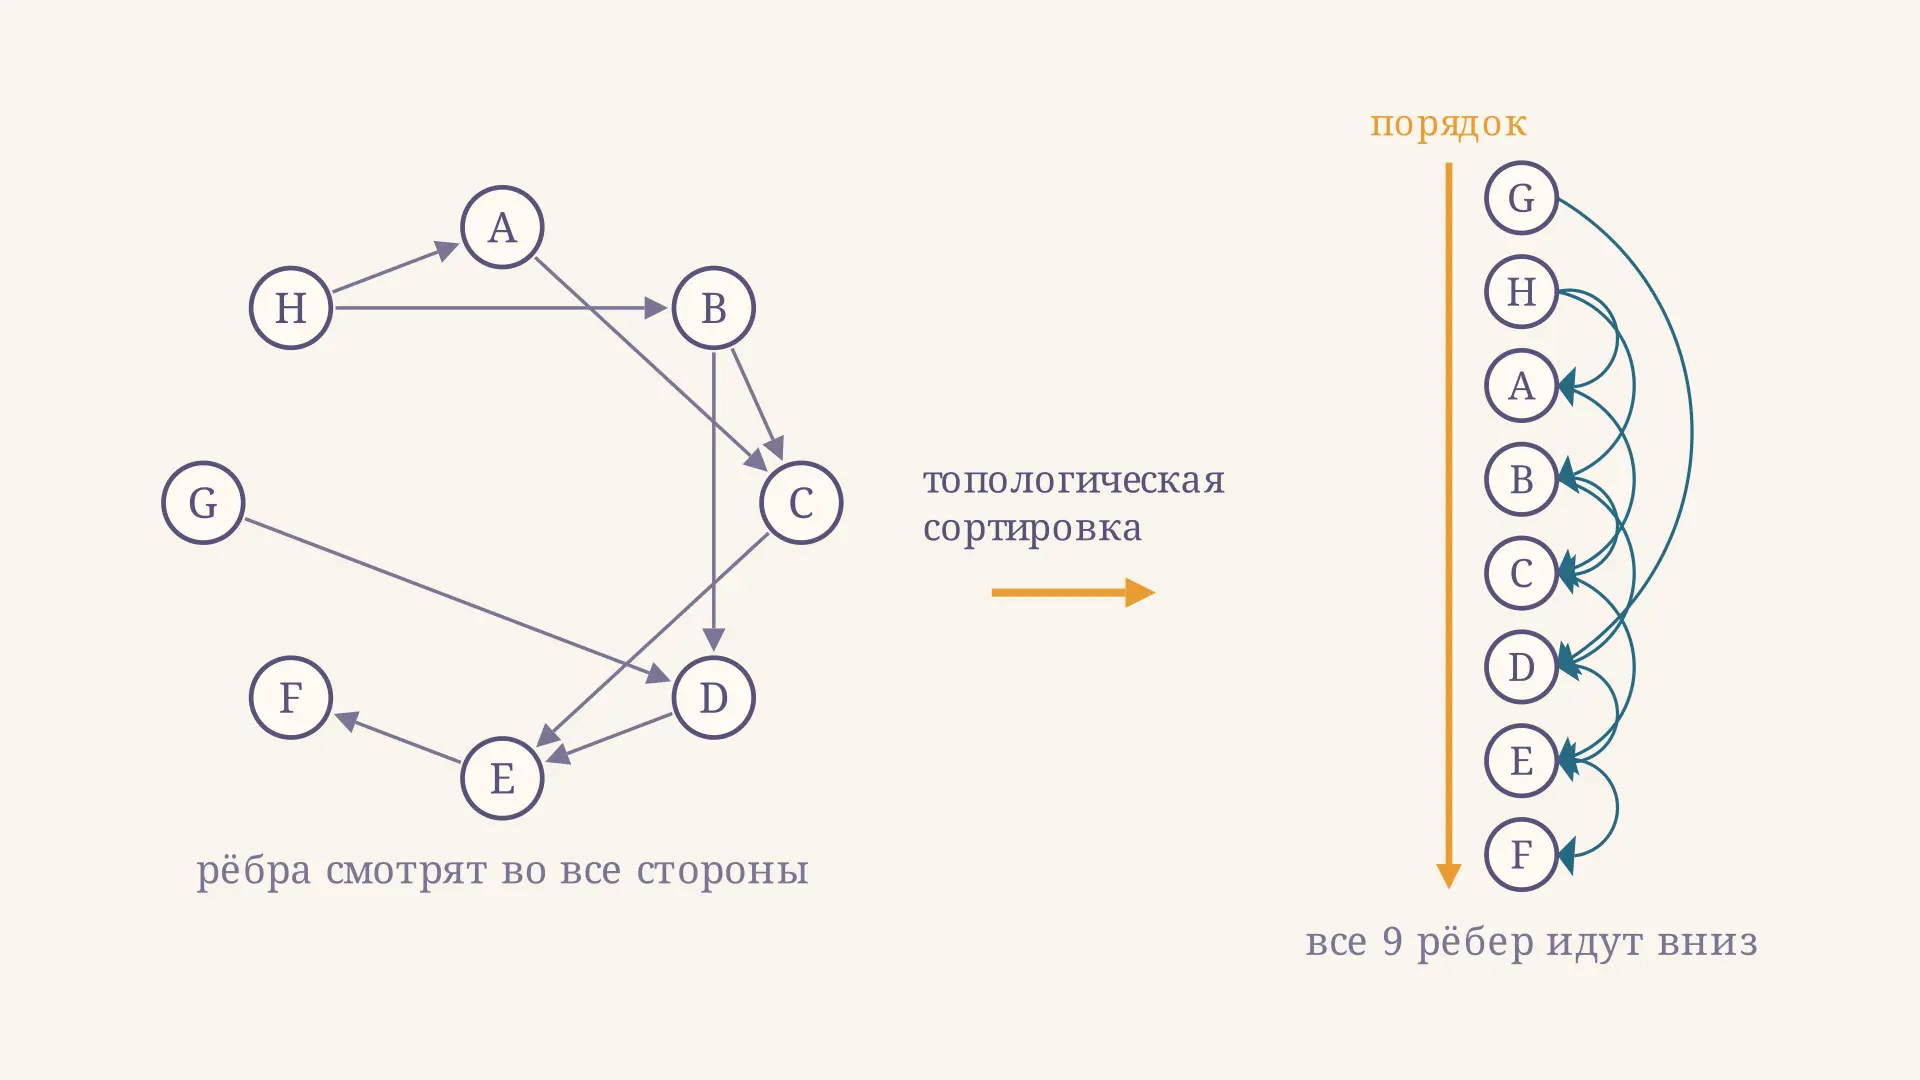
Топологическая сортировка отвечает на бытовой вопрос: в каком порядке делать дела, если часть из них нельзя начать раньше других. Сборка проекта не запустится без скомпилированных библиотек, курс по машинному обучению не пойдёт без алгоритмов, ячейка таблицы не пересчитается раньше тех, на которые ссылается. Формально задача звучит так: расставить вершины ориентированного графа в строку, чтобы каждое ребро шло слева направо. Ниже разберём два классических способа это сделать, критерий существования порядка и способ поймать цикл. Начните с калькулятора: он проводит алгоритм Кана по шагам на конкретном графе из восьми вершин, а числа оттуда встречаются дальше в тексте.
Что такое топологический порядок
Пусть дан ориентированный граф . Топологический порядок (топологическая сортировка) - это нумерация вершин числами от до , при которой для каждого ребра номер меньше номера . Другими словами, если выписать вершины в этом порядке в строку, все стрелки будут направлены вперёд и ни одна не повернёт назад.
Важно сразу зафиксировать: здесь нет ключей, по которым что-то сравнивают, как при сортировке чисел. Рёбра задают лишь частичный порядок: про какие-то пары вершин известно, кто раньше, а про остальные не известно ничего, и их можно ставить как угодно. Поэтому и ответ, как правило, не один.
Наш рабочий пример: восемь вершин и девять рёбер
Почему порядок существует не всегда
Если в графе есть цикл , то в любой расстановке первая вершина цикла должна стоять раньше второй, вторая раньше третьей и так далее по кругу, а значит, обязана стоять раньше самой себя. Противоречие: порядка нет.
Обратное тоже верно. В конечном ациклическом орграфе всегда найдётся вершина со степенью входа : если бы у каждой вершины было входящее ребро, можно было бы бесконечно шагать назад по рёбрам, а в конечном графе такой маршрут рано или поздно наступит на уже пройденную вершину и замкнёт цикл. Поставим вершину с нулевой степенью входа первой, удалим её вместе с рёбрами, а для остатка повторим рассуждение. Отсюда критерий: топологический порядок существует тогда и только тогда, когда граф ациклический. Такой граф называют DAG, от directed acyclic graph.
Алгоритм Кана: степени входа и очередь
Приведённое рассуждение и есть алгоритм Кана (1962). Работает он так:
По форме это тот же обход в ширину: очередь, из которой вершины достают по одной, только условие попадания в неё не «сосед не посещён», а «все предшественники уже сняты».
- посчитать степень входа каждой вершины за один проход по рёбрам;
- положить в очередь все вершины с нулевой степенью входа;
- пока очередь не пуста: взять из неё вершину , дописать её в ответ, а у каждого соседа по ребру уменьшить на единицу; если счётчик соседа обнулился, добавить его в очередь;
- если в ответе оказались все вершин, это и есть порядок; если меньше, в графе есть цикл.
Каждая вершина попадает в очередь ровно один раз, и каждое ребро обрабатывается ровно один раз, поэтому сложность линейна: по времени и по дополнительной памяти на массив степеней и очередь.
Разбор примера по шагам
Начальные степени входа в нашем графе: , , , , , , , . В очередь сразу попадают и .
| Шаг | Снимаем | Степени входа падают | Очередь после шага |
|---|---|---|---|
| 1 | |||
| 2 | , | , | |
| 3 | |||
| 4 | , | , | |
| 5 | |||
| 6 | |||
| 7 | |||
| 8 | нет исходящих рёбер | пусто |
Ответ: . Проверка простая и её стоит делать всегда: пройтись по всем девяти рёбрам и убедиться, что начало каждого стоит в строке левее конца.
Порядок не единственный
Если в очереди лежат сразу несколько вершин, брать можно любую. Реализация с очередью FIFO даёт на нашем графе , а та же программа со стеком вместо очереди выдаёт - и это тоже совершенно верный ответ. Переключите правило выбора в калькуляторе выше и сверьте оба порядка по рёбрам.
Всего у этого графа 21 различный топологический порядок. Такие расстановки называют линейными расширениями частичного порядка, и в общем случае подсчёт их числа - вычислительно тяжёлая задача, хотя перебрать их для небольшого графа несложно. Практический вывод для студента: если ваш ответ не совпал с ответом соседа, это ещё не ошибка. Сверять нужно не строки, а выполнение условия «каждое ребро идёт вперёд».
Когда порядок хотят сделать единственным, добавляют правило разрешения ничьих. Самое частое - брать из очереди лексикографически минимальную вершину (тогда нужна не очередь, а приоритетная очередь, и сложность становится ).
Вариант через обход в глубину
Второй классический способ обходится вообще без степеней входа. Запускаем обход в глубину по всем вершинам и записываем вершину в список не когда входим в неё, а когда выходим, то есть когда все достижимые из неё вершины уже обработаны. Полученный список разворачиваем - это и есть топологический порядок. Времена выхода, на которых держится этот способ, подробно разобраны в статье про обход графа в глубину.
Работает это по той же причине, что и алгоритм Кана: из вершины нельзя выйти раньше, чем выйдут все её потомки, поэтому время выхода строго больше времён выхода всех вершин, до которых из неё есть путь. Значит, при сортировке по убыванию времени выхода конец любого ребра окажется правее его начала.
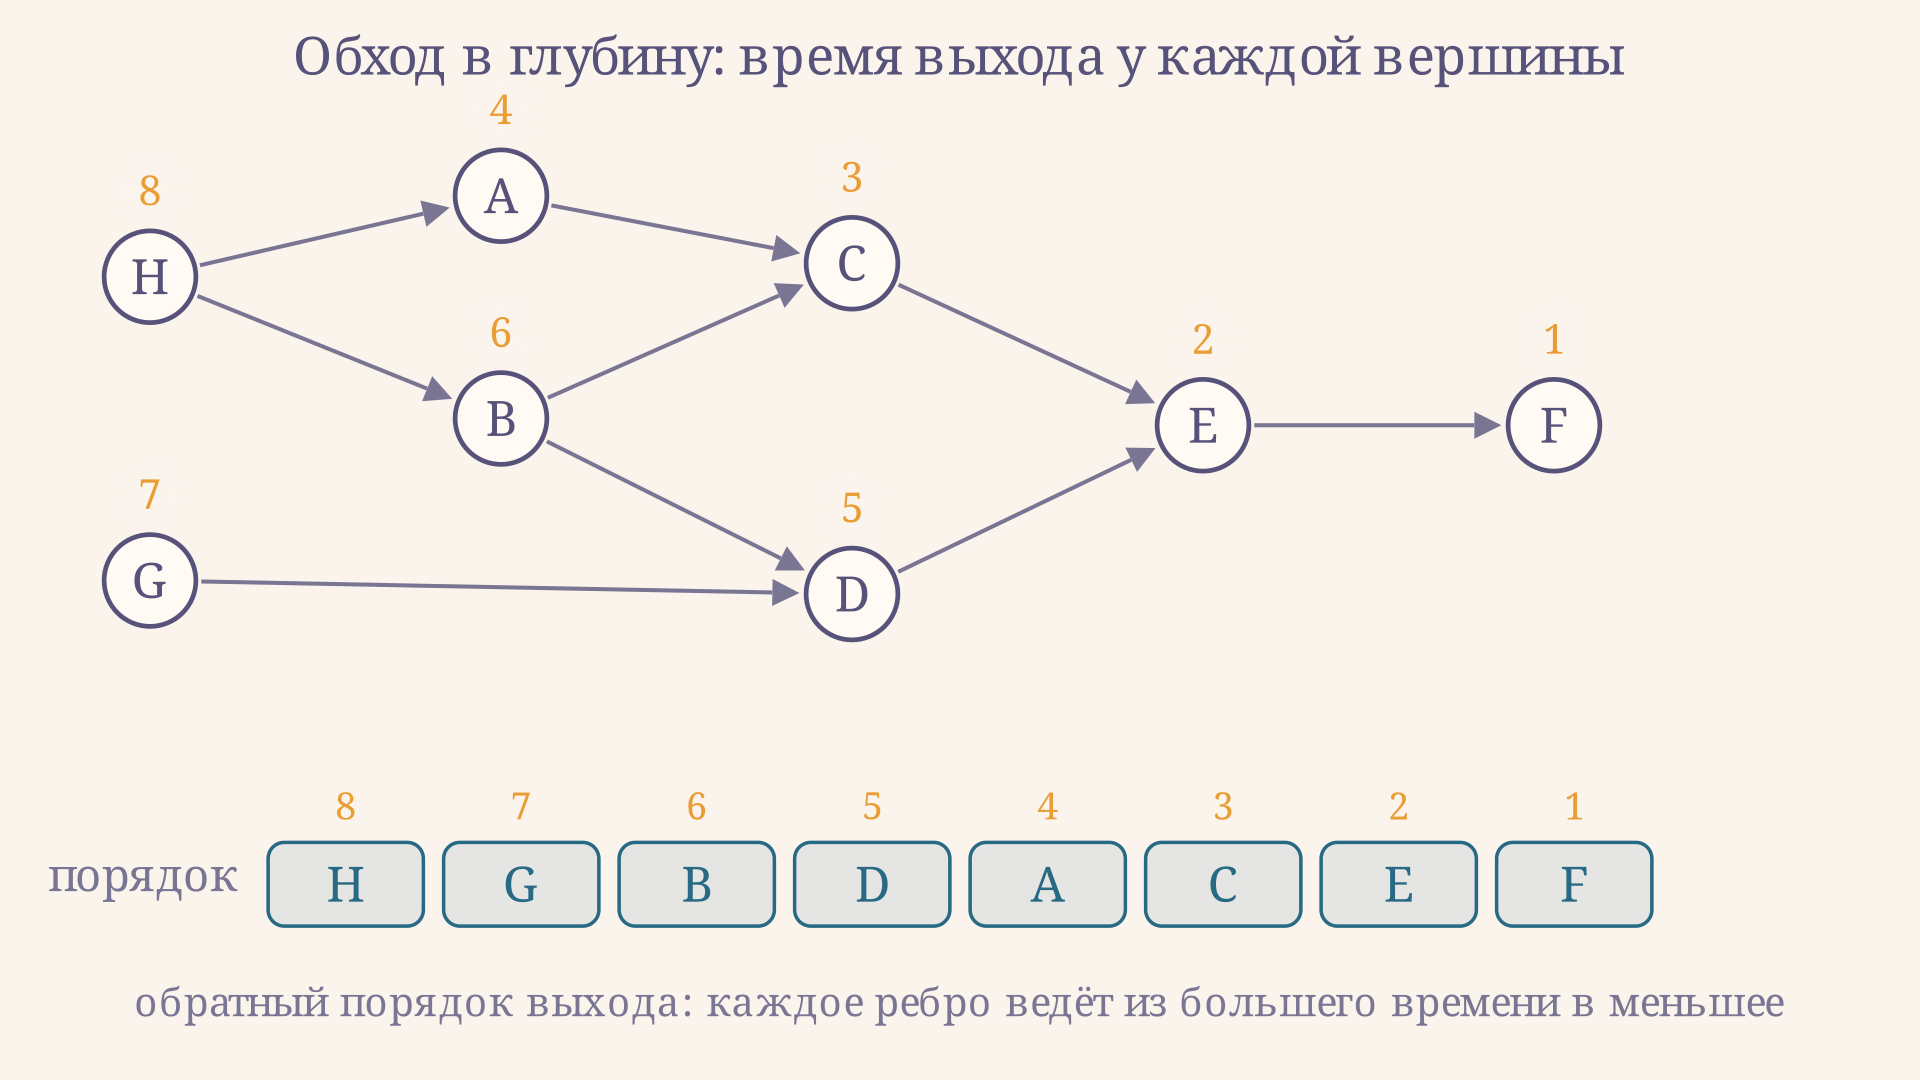
На нашем графе обход в глубину даёт времена выхода , , , , , , , и порядок - третий верный вариант из двадцати одного. Сложность та же, , а на практике выбор между вариантами обычно решает не скорость: алгоритм Кана удобнее, когда порядок нужно строить по частям или когда важна очередь «что можно делать прямо сейчас», а вариант с обходом в глубину короче пишется рекурсией.
Как алгоритм ловит цикл
Отдельная проверка на ацикличность не нужна - оба варианта ловят цикл сами. В алгоритме Кана достаточно сравнить длину ответа с числом вершин. Добавим к нашему графу одно ребро : оно замыкает цикл . Алгоритм спокойно снимет , и , после чего очередь опустеет, хотя пять вершин ещё не выписаны.
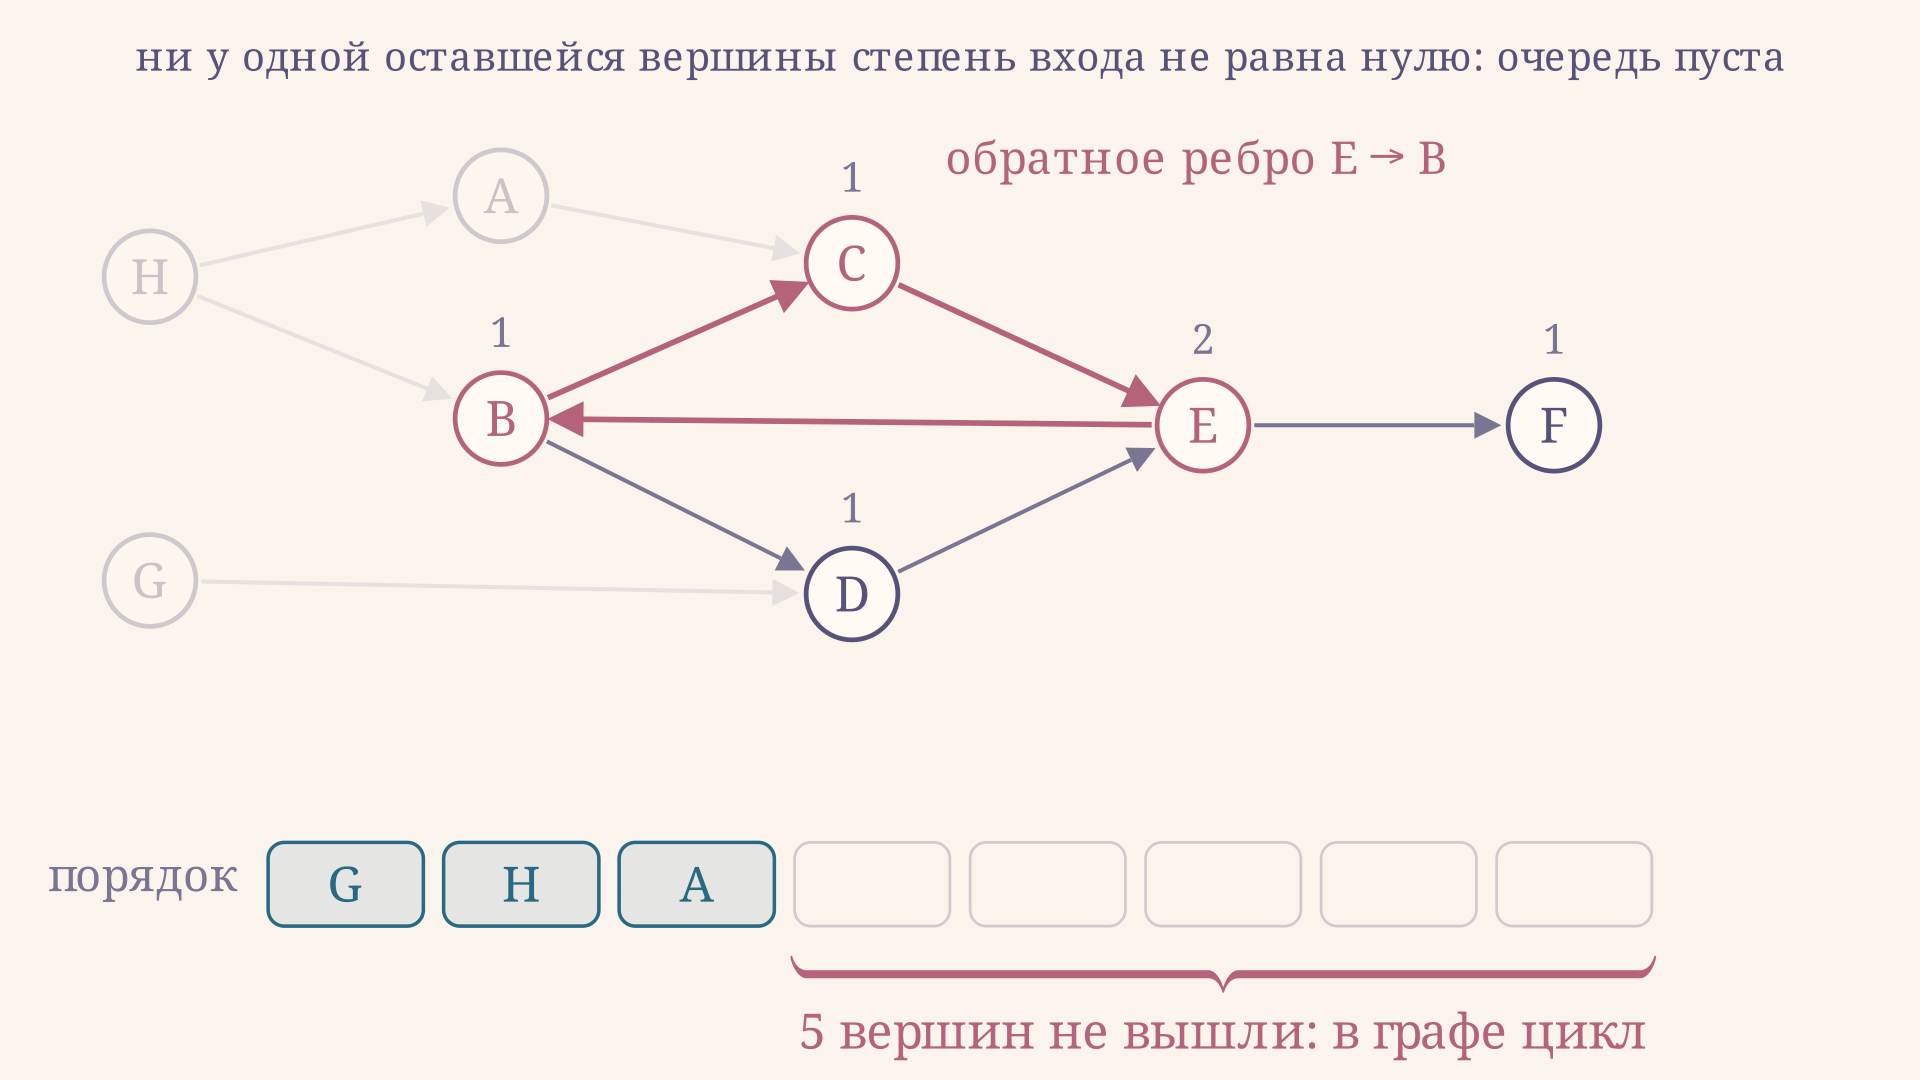
Вершины, оставшиеся с ненулевой степенью входа, - это в точности вершины циклов и всё, что из них достижимо. В варианте с обходом в глубину признак цикла другой: встретилось ребро в вершину, которая уже посещена, но ещё не покинута (её обход не завершён). Такое ребро называют обратным, и оно сразу даёт готовый цикл. Включите в калькуляторе дополнительное ребро и посмотрите, на каком шаге алгоритм встаёт.
Если цикл есть, а порядок всё-таки нужен, стандартный приём - сжать каждую компоненту сильной связности в одну вершину. Компоненты ищет алгоритм Тарьяна, а полученная конденсация всегда ациклична, и её уже можно топологически отсортировать.
Где это встречается
- Сборка проектов и пакетные менеджеры: цели make, зависимости npm и maven, порядок миграций базы данных.
- Учебные планы и производственные маршруты: что можно изучать или запускать параллельно, а что только после предшественников.
- Пересчёт электронных таблиц и реактивных вычислений: формулы обновляются в топологическом порядке ссылок.
- Динамическое программирование на DAG: состояния считают в топологическом порядке, чтобы к моменту расчёта состояния все его предшественники уже были посчитаны. Подробнее про сам метод - в разборе основ динамического программирования.
- Кратчайшие и длиннейшие пути в ациклическом графе: один проход по вершинам в топологическом порядке даёт ответ за , то есть быстрее, чем алгоритм Дейкстры, и в отличие от него допускает отрицательные веса. На этом же держится расчёт критического пути сетевого графика.
Частые ошибки
- Ищут нулевую степень выхода вместо входа. Алгоритм при этом отработает, но выдаст обратный порядок: все рёбра будут смотреть назад. Если так получилось, достаточно развернуть ответ.
- Пересчитывают степени входа заново на каждом шаге. Это превращает линейный в квадратичный по числу рёбер перебор. Счётчики нужно уменьшать по месту, при удалении рёбер.
- Не проверяют длину ответа. Программа молча вернёт три вершины вместо восьми, и «порядок» уедет дальше по коду. Сравнение длины ответа с числом вершин - обязательная часть алгоритма, а не дополнительная проверка.
- Считают ответ единственным. Порядков обычно много, и автоматическая проверка задачи должна сверять условие на рёбрах, а не строку с эталоном.
- В варианте с обходом в глубину пишут вершину при входе. Порядок входа топологическим не является: так вершина может оказаться раньше своего предшественника, до которого обход дойдёт позже из другого корня.
FAQ
Чем топологическая сортировка отличается от обычной? Обычная сортировка упорядочивает элементы по значению ключа, и результат единственный (с точностью до равных ключей). Здесь ключей нет вовсе: есть только заданные рёбрами условия «раньше», а все несравнимые вершины можно переставлять свободно. Поэтому корректных ответов много, а критерий правильности один - каждое ребро идёт вперёд.
Сколько существует топологических порядков и как их перечислить? Для небольшого графа их перебирают рекурсией: на каждом шаге пробуют по очереди все вершины с нулевой степенью входа и откатываются назад. У графа из этой статьи таких расстановок 21, и калькулятор показывает это число. В общем случае подсчёт линейных расширений относится к вычислительно трудным задачам, поэтому для больших графов число порядков не считают.
Что делать, если граф оказался с циклом? Сначала убедиться, что цикл не ошибка данных: в зависимостях сборки или в плане курсов он обычно означает, что кто-то задал взаимное требование. Если цикл настоящий, граф сжимают по компонентам сильной связности: каждая компонента становится одной вершиной, конденсация получается ациклической и сортируется обычным способом, а внутри компоненты порядок выбирают по другим соображениям.
Коротко
Топологическая сортировка выстраивает вершины ориентированного графа в строку так, чтобы каждое ребро шло вперёд; существует она тогда и только тогда, когда граф ациклический. Алгоритм Кана ведёт счётчики степеней входа и очередь вершин с нулём, отдавая ответ за ; вариант с обходом в глубину получает тот же результат как обратный порядок выхода. Ответ почти никогда не единственный - у примера из статьи 21 верный порядок, - поэтому проверять нужно не совпадение со строкой-эталоном, а выполнение условия на всех рёбрах. Если очередь опустела раньше, чем выписаны все вершины, в графе есть цикл, и порядка не существует.
Читайте также
Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
Как работают агрегатные функции SQL: COUNT, SUM, AVG, MIN и MAX, группировка GROUP BY, порядок выполнения запроса, разница HAVING и WHERE и поведение NULL внутри агрегата.
Интегральный синус Si(x): ряд Тейлора и максимум
Интегральный синус Si(x): почему интеграл sin t / t не берётся в элементарных функциях, разложение в ряд, предел π/2, максимум Si(π) и выброс Гиббса. С калькулятором.
Куча как структура данных: массив и просеивание
Куча как структура данных: свойство кучи, хранение в обычном массиве и индексы 2i+1 и 2i+2, просеивание sift-up и sift-down, построение за O(n) и приоритетная очередь.
Линейная зависимость векторов: критерии и примеры
Что такое линейная зависимость векторов, как проверить её определителем и рангом матрицы, чем коллинеарность отличается от компланарности и как всё это связано с базисом.
Линейное уравнение второго порядка: общее решение
Как решить линейное однородное уравнение второго порядка с постоянными коэффициентами: характеристическое уравнение, три случая корней, фундаментальная система и задача Коши с разбором.
Метод вариации постоянных: формулы и разбор примера
Метод вариации произвольных постоянных: как из решений однородного уравнения собрать частное, зачем здесь определитель Вронского и когда быстрее оказывается подбор по виду правой части.