Куча как структура данных: массив и просеивание
Куча (heap) как структура данных отвечает на один очень узкий запрос: «дай самый приоритетный элемент и позволь быстро добавить новый». Она не умеет искать произвольное значение и не хранит элементы отсортированными, зато минимум лежит в ней всегда на одном и том же месте, а вставка и удаление стоят . Ниже разбираем классическую бинарную кучу: свойство кучи, укладку дерева в обычный массив, два просеивания и неожиданный факт про построение за линейное время. Калькулятор ниже считает индексы и цену построения для любого размера, так что формулы можно проверять прямо по ходу чтения.
Свойство кучи: что именно упорядочено
Бинарная куча (min-heap) это полное двоичное дерево, в котором для каждого узла выполнено
Полное двоичное дерево означает, что все уровни заполнены целиком, кроме последнего, а последний заполняется слева направо без дыр. Отсюда сразу следует высота : дерево из узлов не может быть глубже, потому что каждый полный уровень удваивает число узлов.
Важно понять, чего свойство кучи НЕ требует. Порядок задан только вдоль путей от корня к листьям. Между братьями, между соседними ветками, между двумя произвольными узлами одного уровня порядка нет никакого. Поэтому куча это частичный, а не полный порядок, и выписанный подряд массив кучи почти никогда не отсортирован. Зато минимум гарантированно лежит в корне: если бы меньший элемент был где-то глубже, на пути от него к корню нашлась бы пара, нарушающая неравенство.
Максимальная куча (max-heap) устроена зеркально: , в корне лежит максимум. Все формулы индексов и оба просеивания у неё те же, меняется только знак сравнения.
Куча в массиве: индексы 2i+1 и 2i+2
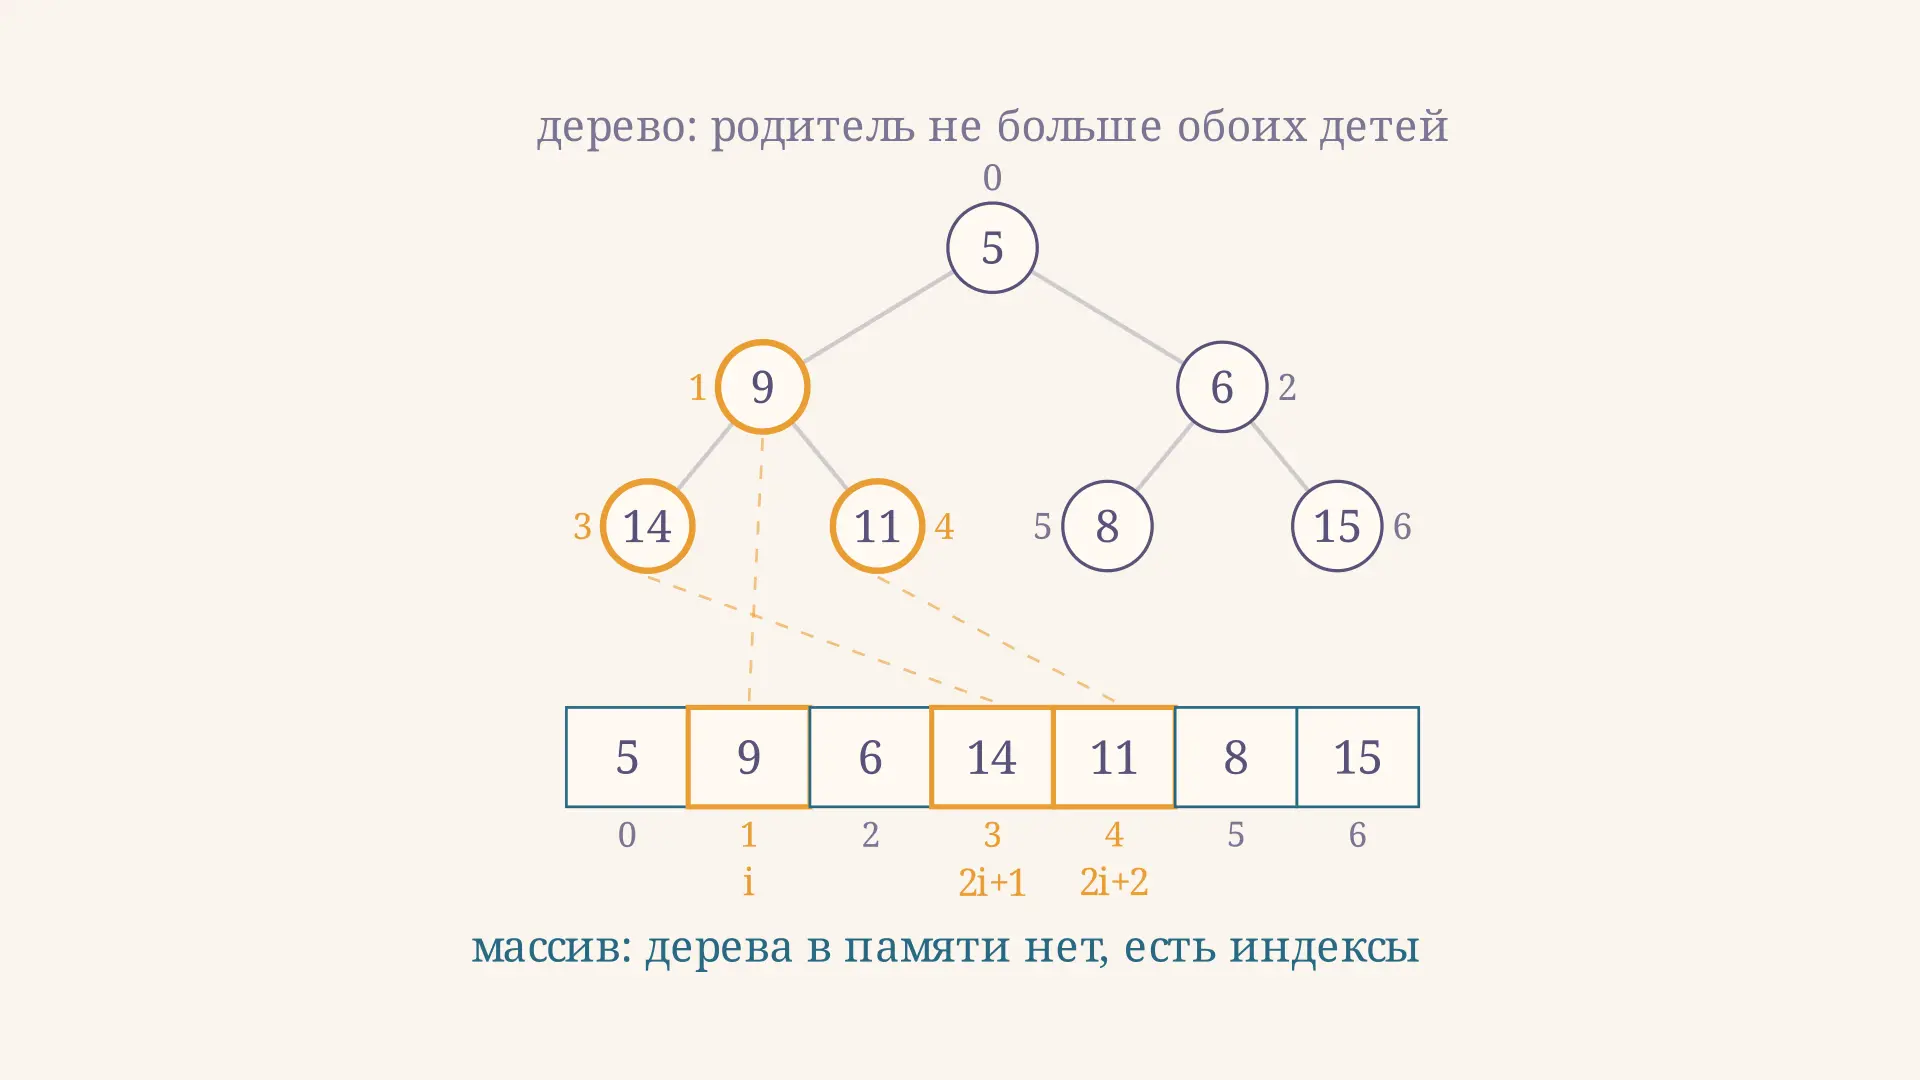
Главный практический трюк кучи в том, что дерево нигде не материализуется. Нет ни узлов, ни указателей, ни выделения памяти под них: есть обычный массив , а дерево живёт в арифметике индексов. При нумерации с нуля
Работает это ровно потому, что дерево полное: узлы идут по уровням слева направо без пропусков, и позиция в массиве однозначно кодирует позицию в дереве. Уровень узла равен , весь уровень занимает индексы от до .
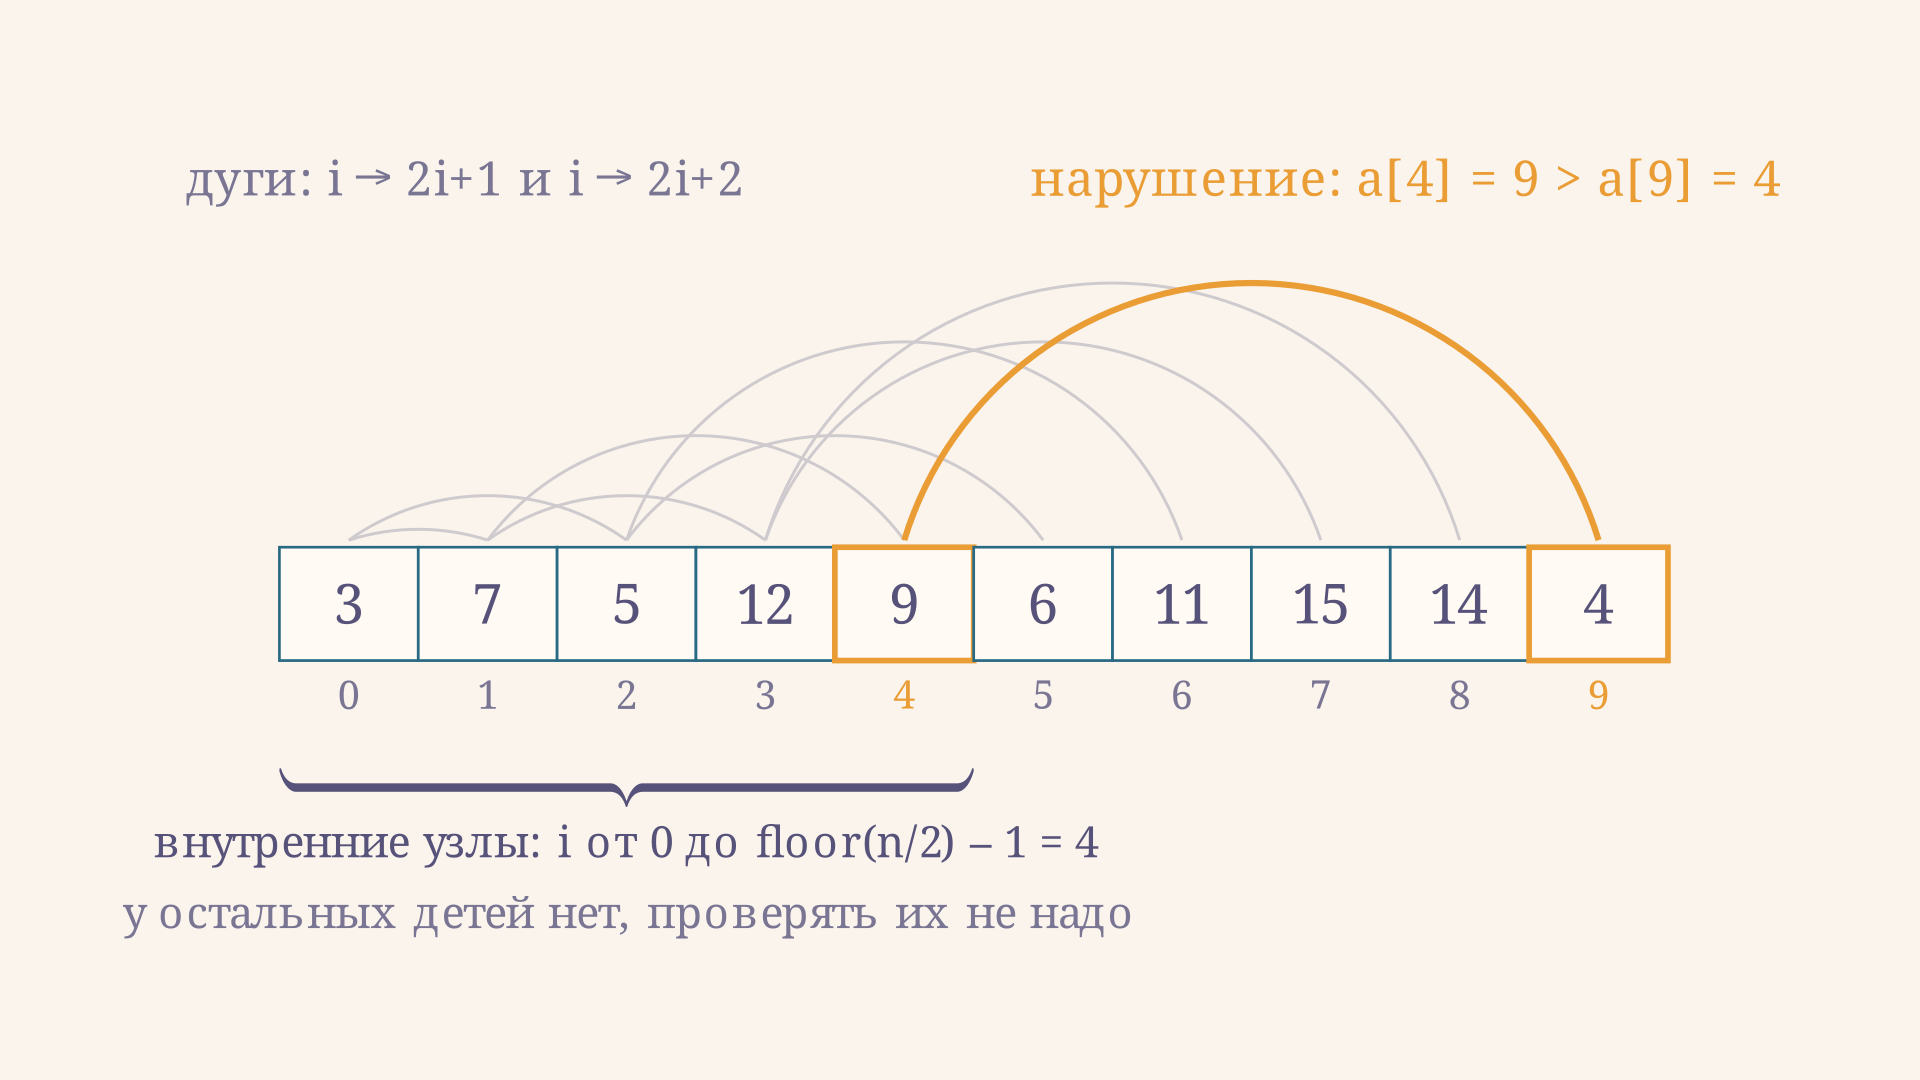
Из тех же формул получается ещё одно полезное следствие. Узел имеет детей только если , то есть внутренние узлы занимают индексы от до , а вся вторая половина массива это листья. Половина элементов кучи, таким образом, вообще не требует проверки.
Если в коде куча вдруг ведёт себя странно, первым делом проверяют именно нумерацию: в учебниках и в академических псевдокодах массив часто нумеруют с единицы, и тогда формулы выглядят как , и . Смешать два соглашения в одном файле это самый быстрый способ получить кучу, которая работает на первых трёх тестах и разваливается на четвёртом.
Sift-up: вставка нового элемента
Вставка не ищет место заранее. Новый ключ кладут в первую свободную ячейку, то есть в , увеличивают размер и запускают просеивание вверх (sift-up, он же swim, он же percolate-up): пока элемент меньше своего родителя, они меняются местами.
siftUp(i):
    while i > 0 and a[i] < a[(i - 1) / 2]:
        swap(a[i], a[(i - 1) / 2])
        i = (i - 1) / 2
Свойство кучи при этом не ломается нигде, кроме одной пары, и каждый обмен чинит именно её, сдвигая проблему на уровень выше. Путь идёт строго по цепочке предков, а их всего , поэтому вставка стоит и ровно столько же сравнений: на каждом уровне сравнение ровно одно.
Sift-down и извлечение минимума
Извлечение минимума устроено сложнее ровно на одну деталь. Корень это ответ, но просто удалить его нельзя: дерево распадётся на два. Поэтому в корень переносят последний элемент массива, уменьшают размер на единицу и запускают просеивание вниз (sift-down, sink, percolate-down): элемент меняется местами с меньшим из двух детей, пока хотя бы один ребёнок меньше него.
siftDown(i):
    while 2*i + 1 < n:
        j = 2*i + 1
        if j + 1 < n and a[j + 1] < a[j]:
            j = j + 1
        if a[i] <= a[j]:
            break
        swap(a[i], a[j])
        i = j
Сравнение с меньшим из детей принципиально: если поменять элемент с бо́льшим ребёнком, новый родитель окажется больше своего второго ребёнка и свойство кучи сломается. Спуск идёт по одной ветке, глубина та же , но сравнений на уровень уже два (какой ребёнок меньше, и нужен ли обмен). Стоимость всё равно .
Из этих двух процедур собирается всё остальное: decrease-key меняет значение и делает sift-up, increase-key делает sift-down, delete(i) заменяет элемент последним и запускает то просеивание, которое требуется по знаку сравнения. Чтение минимума (peek) стоит : это просто .
Построение кучи за O(n), а не O(n log n)
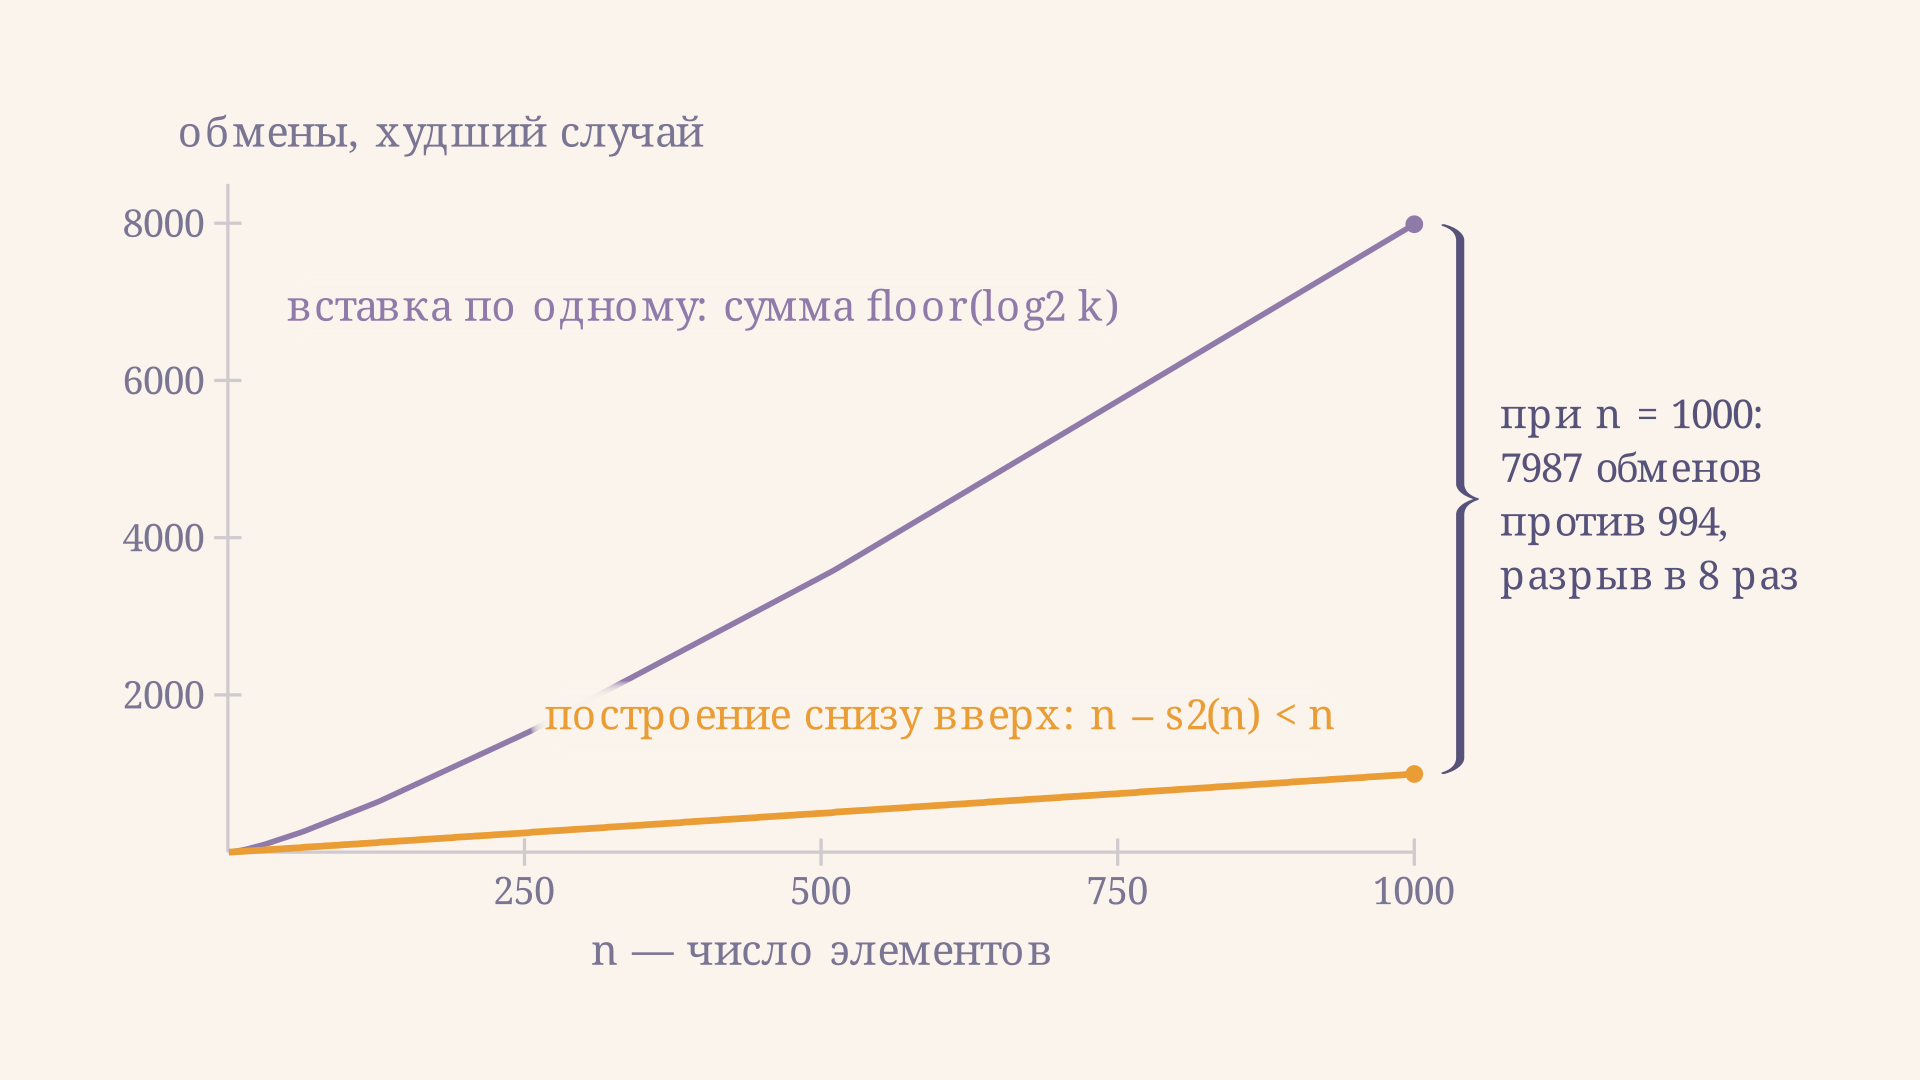
Пусть дан произвольный массив, из которого надо сделать кучу. Очевидный способ: вставлять элементы по одному, вставок по каждая, итого . Правильный способ другой и он быстрее.
Достаточно пройти внутренние узлы от последнего к первому, то есть от индекса до , и для каждого вызвать sift-down. Листья пропускаются: одиночный узел уже является корректной кучей. К моменту обработки узла оба его поддерева уже кучи, поэтому одного просеивания хватает.
Оценка стоимости выглядит контринтуитивно, но арифметика простая. Узлов высоты в куче не больше , а просеивание такого узла стоит не больше обменов, поэтому
Суть в том, что дорогие просеивания достаются редким узлам. Половина элементов это листья с нулевой стоимостью, четверть просеивается на один уровень, и только один корень проходит всю высоту. В худшем случае число обменов равно в точности , где это количество единиц в двоичной записи , то есть строго меньше .
Приоритетная очередь: где куча работает
Куча это стандартная реализация абстрактного типа «приоритетная очередь», и почти всюду, где в алгоритме встречается фраза «взять ближайший или самый дешёвый элемент», внутри стоит именно она. На том же извлечении максимума построена и пирамидальная сортировка: она гоняет кучу по убывающему хвосту массива и получает в худшем случае.
- Алгоритм Дейкстры на каждом шаге достаёт вершину с минимальной оценкой расстояния: с бинарной кучей это вместо на массиве.
- Алгоритм Прима выбирает минимальное ребро, ведущее наружу из уже построенной части остова.
- Коды Хаффмана раз вынимают два самых редких символа и кладут обратно их объединение.
- Задача «top-k из потока»: куча размера даёт и постоянную память, что заметно лучше полной сортировки при малом .
- Планировщики задач и дискретно-событийное моделирование: очередь событий по времени наступления.
У бинарной кучи есть ровно одно слабое место: слияние двух куч стоит , потому что массивы приходится сливать и перестраивать. Если операция merge нужна часто, берут биномиальную кучу с её или кучу Фибоначчи с амортизированной константой на insert и decrease-key. За это платят указателями, ссылками на родителей и заметно худшей константой, поэтому на практике бинарная куча на массиве выигрывает почти всегда.
Частые ошибки
- Считать кучу отсортированным массивом. Порядок есть только вдоль путей к корню; массив это корректная куча, хотя четвёрка стоит после шестёрки.
- Смешивать нумерацию с нуля и с единицы. Формулы , и , нельзя использовать в одном коде: ошибка проявляется не сразу и выглядит как случайное нарушение порядка.
- Строить кучу вставками, считая это оптимальным. Проход sift-down от к нулю даёт линейное время; наивный цикл вставок даёт логарифмический множитель сверху.
- В sift-down сравнивать только с левым ребёнком. Обмен с бо́льшим из детей ломает свойство кучи для второго ребёнка.
- Искать в куче произвольный элемент за . Поиск по значению это полный перебор : для
decrease-keyпо ключу нужен внешний словарь «значение к позиции», который обновляется при каждом обмене.
FAQ
Чем куча отличается от двоичного дерева поиска? Двоичное дерево поиска задаёт полный порядок: левое поддерево меньше узла, правое больше, поэтому поиск любого ключа стоит , а обход по возрастанию делается за один проход. Куча задаёт только частичный порядок, зато гарантирует идеальную сбалансированность без всякой балансировки и обходится массивом без указателей. Одна структура отвечает на вопрос «есть ли такой ключ», другая на вопрос «какой ключ минимален».
Почему построение кучи стоит , если высота дерева ? Потому что высоту проходит не каждый узел. Половина элементов это листья, которые не просеиваются вообще, четверть просеивается на один уровень, восьмая часть на два. Сумма сходится к , тогда как при вставке по одному каждый новый элемент действительно может всплыть до корня.
Что такое куча в смысле управления памятью, это то же самое?
Нет, совпадение терминов случайное. Куча как структура данных это описанное выше дерево в массиве; куча в смысле памяти (heap) это область динамического выделения, где живут объекты, созданные через new или malloc. Общего у них только слово.
Коротко
Бинарная куча это полное двоичное дерево со свойством «родитель не больше обоих детей», уложенное в обычный массив: дети индекса лежат на и , родитель на , высота равна . Все операции держатся на двух просеиваниях: sift-up после вставки в конец и sift-down после переноса последнего элемента в корень, обе стоят , а чтение минимума . Построение кучи из готового массива проходом по внутренним узлам справа налево стоит обменов, а не , потому что дорогие просеивания достаются редким узлам. Эта структура и есть стандартная приоритетная очередь; отказываться от неё в пользу биномиальной или Фибоначчиевой имеет смысл только там, где нужен частый merge или дешёвый decrease-key.
Читайте также
Биномиальная куча: операции и слияние за O(log n)
Биномиальная куча: как устроен лес деревьев, зачем нужно слияние двух куч за O(log n) и чем она лучше бинарной. Разбираем операции insert, extract-min и merge на примерах.
Стек и очередь: чем LIFO отличается от FIFO
Стек и очередь рядом: дисциплины LIFO и FIFO и порядок выхода элементов, очередь на кольцевом буфере за O(1), дек, таблица сложности операций и примеры применения.
Кольцевой буфер: реализация на массиве и индексах
Как реализовать кольцевой буфер на обычном массиве: индексы head и tail, формулы через остаток от деления, проблема совпадения head и tail и её решение счётчиками операций.
Поиск в двоичном дереве поиска: алгоритм и сложность
Как работает поиск в двоичном дереве поиска (BST): пошаговый алгоритм, число сравнений в среднем и худшем случае, влияние баланса дерева и типичные ошибки в задачах.
Стек на списке: реализация push и pop через массив
Как реализовать стек на списке: индекс вершины, амортизированная сложность push O(1), расширение массива вдвое при переполнении и почему pop не освобождает память сразу.
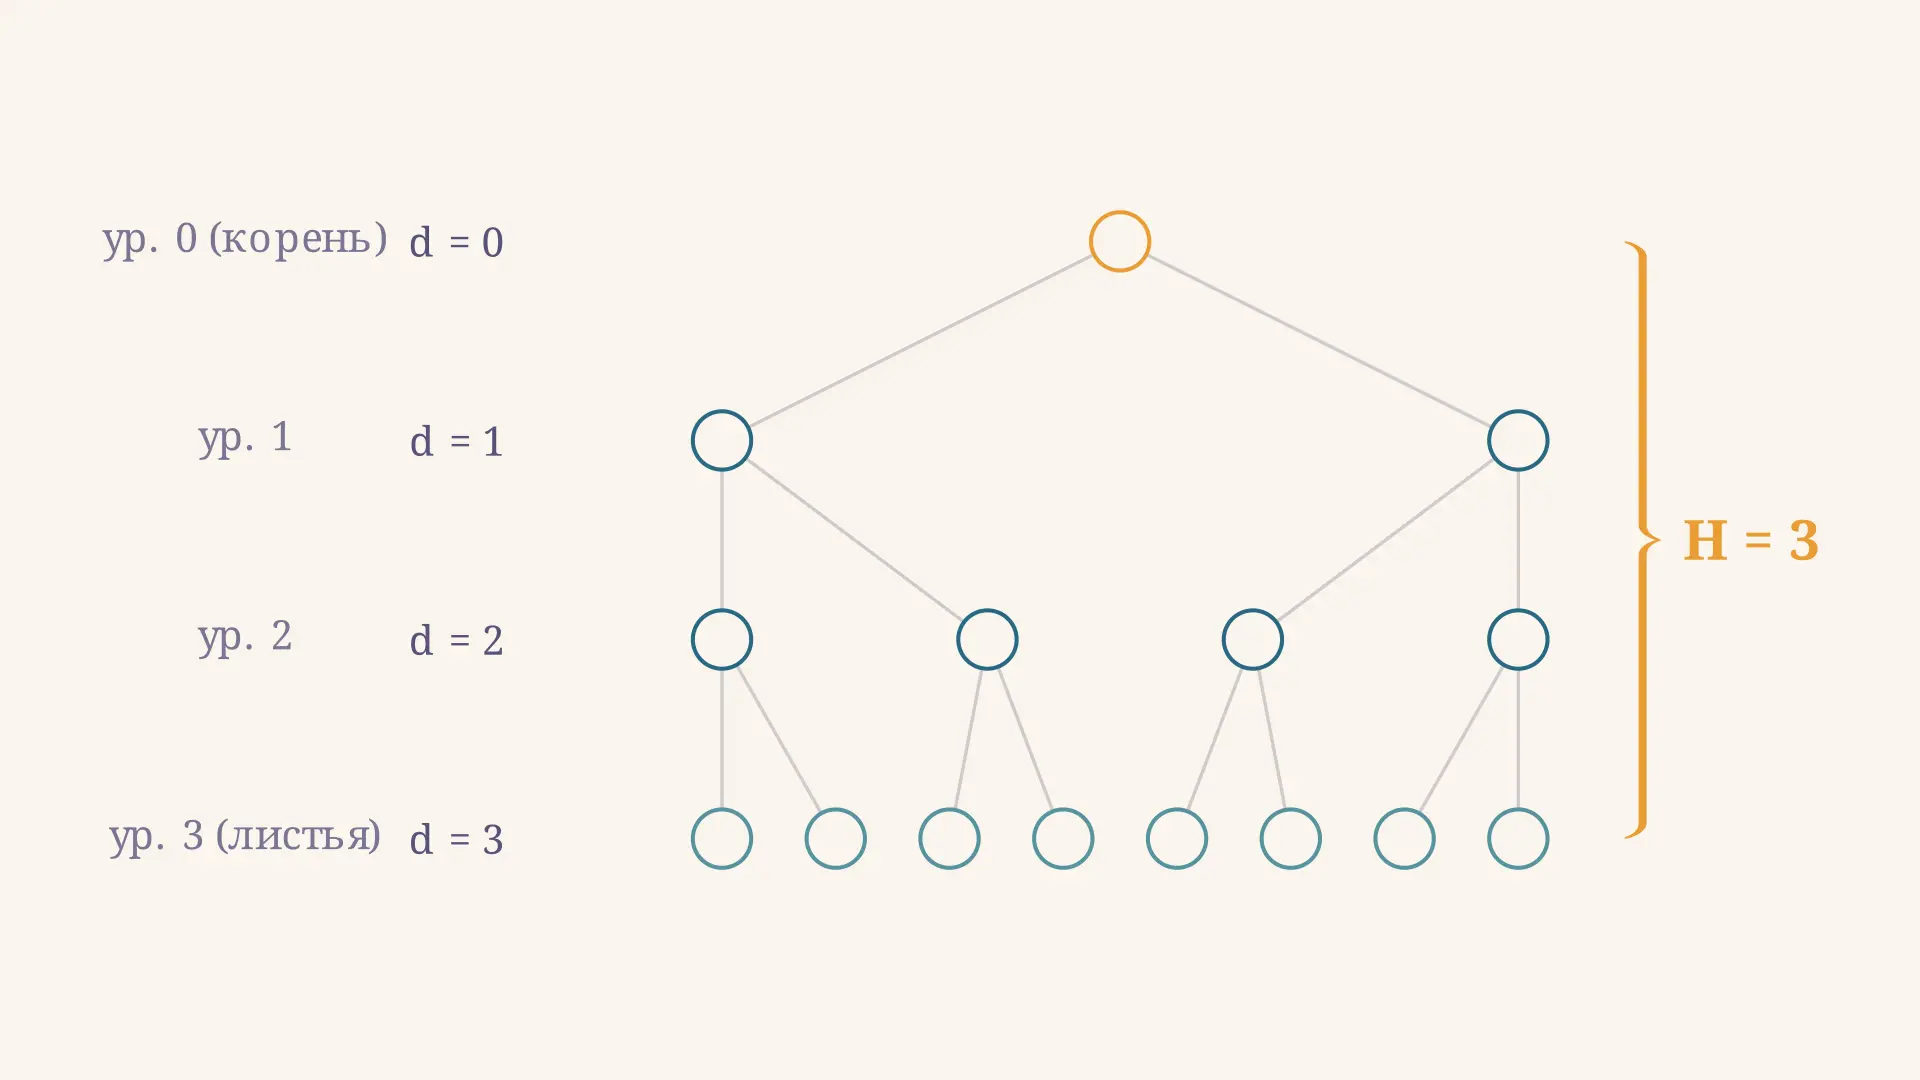
Высота и глубина дерева: формулы и примеры
Разбираем высоту и глубину дерева в информатике: точные определения, формулы для полного двоичного и вырожденного дерева, примеры задач и типичные ошибки.