Пирамидальная сортировка: heapsort за O(n log n)
Пирамидальная сортировка (heapsort) выделяется среди сортировок сравнением редким сочетанием: она даёт гарантию не в среднем, а в худшем случае, и при этом не требует ни одного дополнительного массива. Никакой вход не способен испортить ей время работы, потому что скорость определяется высотой двоичной кучи, а высота у кучи из элементов всегда равна . Платой за эту надёжность оказываются неустойчивость и довольно большая константа: на практике heapsort обычно проигрывает быстрой сортировке, хотя формально имеет ту же асимптотику. Ниже разберём обе фазы алгоритма на конкретном массиве из 15 элементов, выведем оценки для каждой из них и сравним результат с quicksort по памяти и по худшему случаю. Числа в калькуляторе ниже считаются настоящим прогоном heapsort, так что их можно сверять с разбором по шагам.
Как устроена пирамидальная сортировка
Алгоритм работает в две фазы и обе проводит прямо в исходном массиве. Обе опираются на кучу как структуру данных - свойство порядка, хранение в массиве и просеивание разобраны там подробно. Сначала массив превращается в max-кучу, затем максимум из кучи раз за разом переезжает в конец.
Двоичная куча здесь нужна в минимальном объёме: массив читается как полное двоичное дерево, у элемента с индексом дети лежат в ячейках и , а родитель находится в . Свойство max-кучи требует, чтобы родитель был не меньше обоих детей, поэтому максимум всего массива всегда оказывается в ячейке 0. Ни указателей, ни отдельных узлов, ни второго массива: дерево существует только как соглашение об индексах.
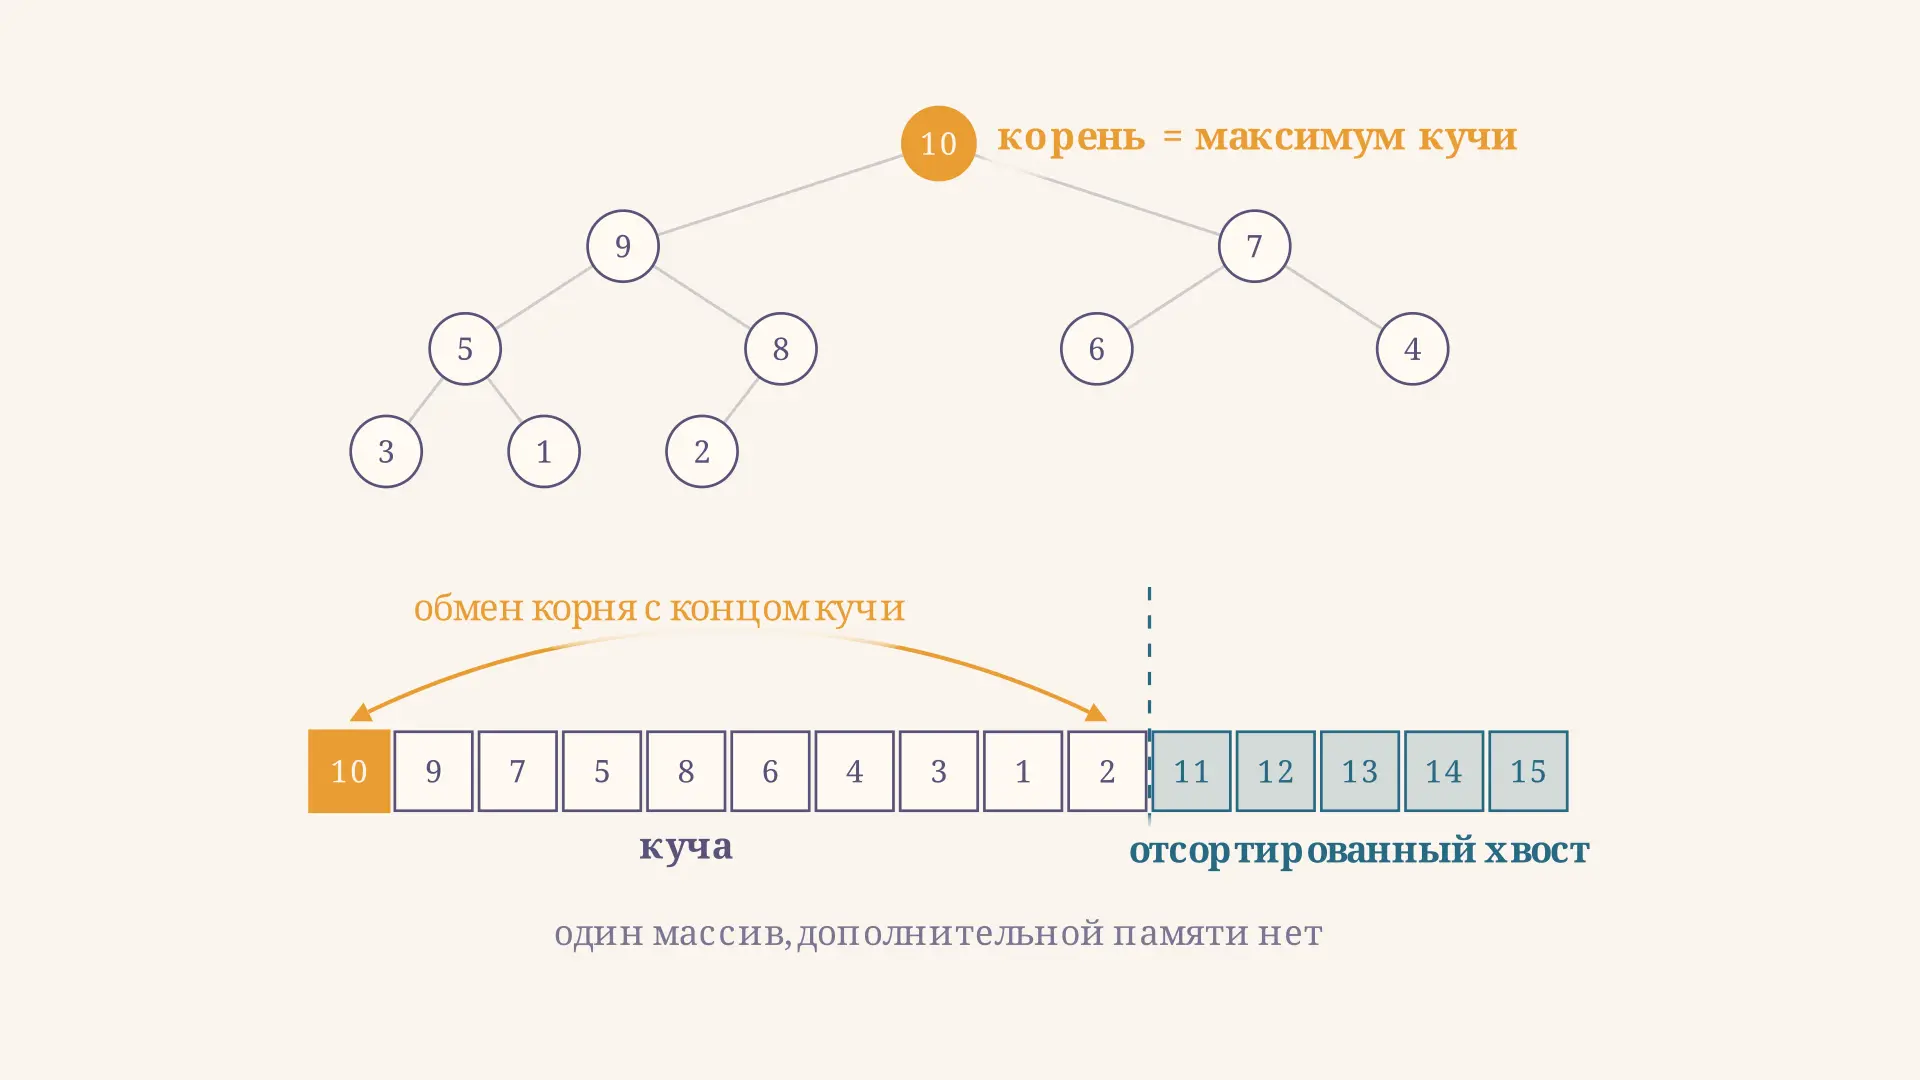
Фаза построения идёт снизу вверх: для каждого узла, начиная с и до нуля, вызывается просеивание вниз (sift-down). Просеивание сравнивает элемент с большим из детей и, если ребёнок больше, меняет их местами и спускается на уровень ниже. Фаза извлечения повторяет раз один и тот же приём: обменять корень с последней ячейкой кучи, уменьшить размер кучи на единицу и просеять новый корень вниз.
Возьмём массив, на котором считает калькулятор и построены все кадры статьи: 7, 10, 11, 5, 2, 6, 15, 3, 1, 8, 9, 14, 4, 12, 13. После фазы построения он превращается в кучу 15, 10, 14, 5, 9, 7, 13, 3, 1, 8, 2, 6, 4, 12, 11: максимум встал в начало, а порядок остальных элементов изменился ровно настолько, чтобы выполнялось свойство кучи.
Построение кучи стоит O(n), а не O(n log n)
Самая частая ошибка в оценке heapsort - посчитать фазу построения за : мол, элементов, каждый просеивается на глубину до . Оценка верна, но грубая. Просеивание узла ограничено не высотой всего дерева, а высотой его собственного поддерева, а большинство узлов сидит у самого низа.
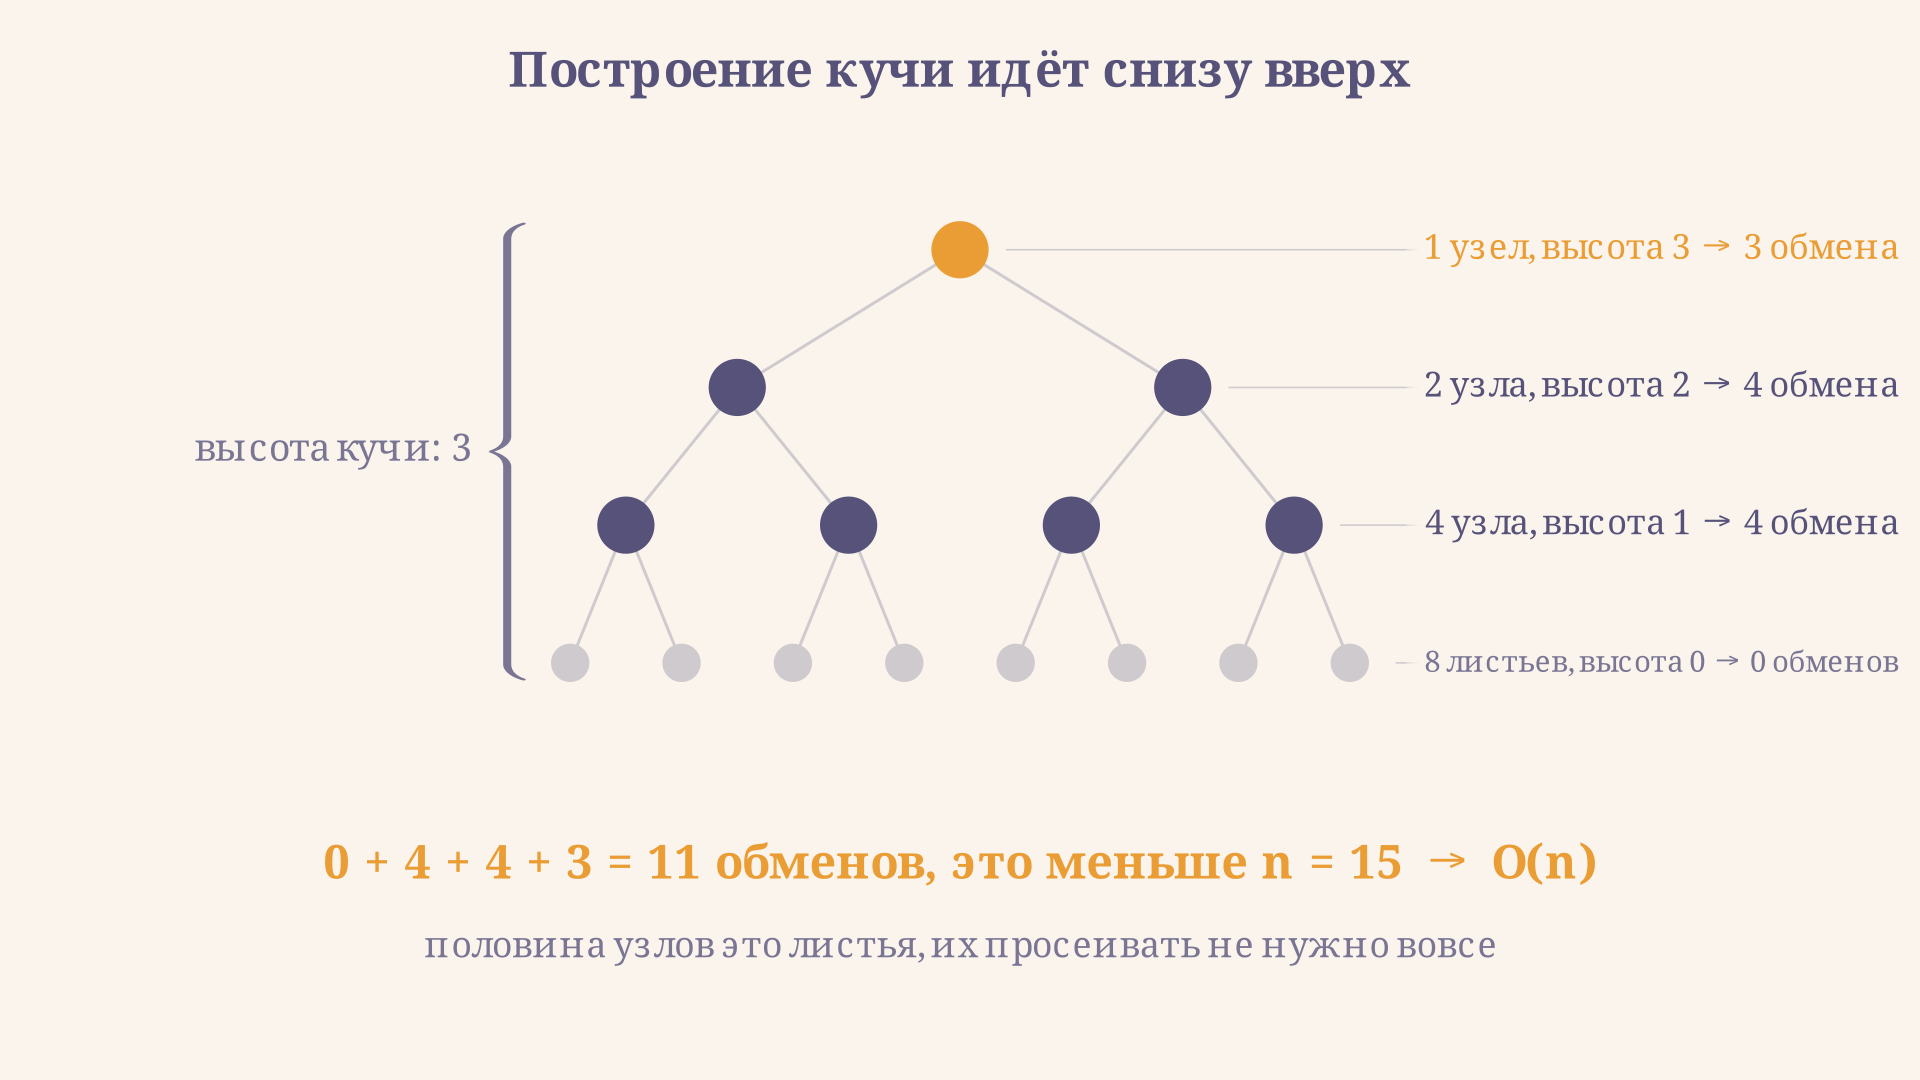
Посчитаем точно. В куче из 15 элементов 8 листьев высоты 0 (их просеивать не нужно вовсе), 4 узла высоты 1, 2 узла высоты 2 и корень высоты 3. Число обменов не превосходит суммы высот всех узлов:
В общем случае сумма высот узлов кучи равна , где - количество единиц в двоичной записи , то есть строго меньше . Отсюда и линейность: фаза построения стоит независимо от входа. На нашем массиве она обошлась в 20 сравнений и 6 обменов, и оба числа ожидаемо уложились в границу.
Извлечение максимума: отсортированный хвост растёт справа
Вторая фаза и есть собственно сортировка. Куча занимает префикс массива, отсортированная часть - суффикс, а граница между ними ползёт влево на одну ячейку за шаг.
Логика шага такая: в корне лежит максимум оставшихся элементов, значит его финальное место - последняя ячейка кучи. После обмена туда встаёт правильное значение, а в корень попадает случайный элемент из низа дерева, который просеивается вниз и восстанавливает свойство кучи. Через таких шагов куча сжимается до одного элемента, а весь массив оказывается упорядочен по возрастанию. На массиве из примера фаза извлечения стоила 47 сравнений и 38 обменов, то есть заметно дороже построения: именно она и определяет асимптотику.
Почему O(n log n) держится и в худшем случае
Каждое просеивание проходит не больше уровней, а на уровне тратит максимум два сравнения: одно выбирает большего ребёнка, второе сравнивает его с родителем. Значит, одно извлечение стоит не больше сравнений, а вся вторая фаза - не больше . Сложив с линейным построением, получаем итоговую оценку:
Принципиально здесь то, что оценка не зависит от данных. Высоту кучи определяет только количество элементов, поэтому подобрать «неудачный» вход невозможно. Для верхняя граница даёт 117 сравнений, а фактически алгоритм тратит 67 на случайном массиве, 77 на уже отсортированном и 66 на массиве в обратном порядке: разброс около 15 процентов, и ни один вариант не приближается к катастрофе.
Снизу пирамидальная сортировка тоже почти упирается в теоретический предел: любая сортировка сравнением делает не меньше сравнений, так что по порядку роста heapsort оптимален.
Сортировка на месте: дополнительной памяти O(1)
Куча не хранится отдельно, поэтому весь алгоритм обходится парой индексов и одной временной переменной для обмена. Важная деталь: просеивание нужно писать циклом, а не рекурсией, иначе появится стек глубины и честное превратится в .
Для сравнения: сортировка слиянием требует дополнительной памяти под буфер, а быстрая сортировка - под стек рекурсии в среднем и до при вырожденном разбиении. Именно поэтому heapsort любят во встраиваемых системах и в ядрах операционных систем, где память и время отклика заранее ограничены.
Неустойчивость: равные ключи меняются местами
Сортировка устойчива, если элементы с одинаковыми ключами сохраняют взаимный порядок. Пирамидальная сортировка этим свойством не обладает, и контрпример нужен совсем крошечный.
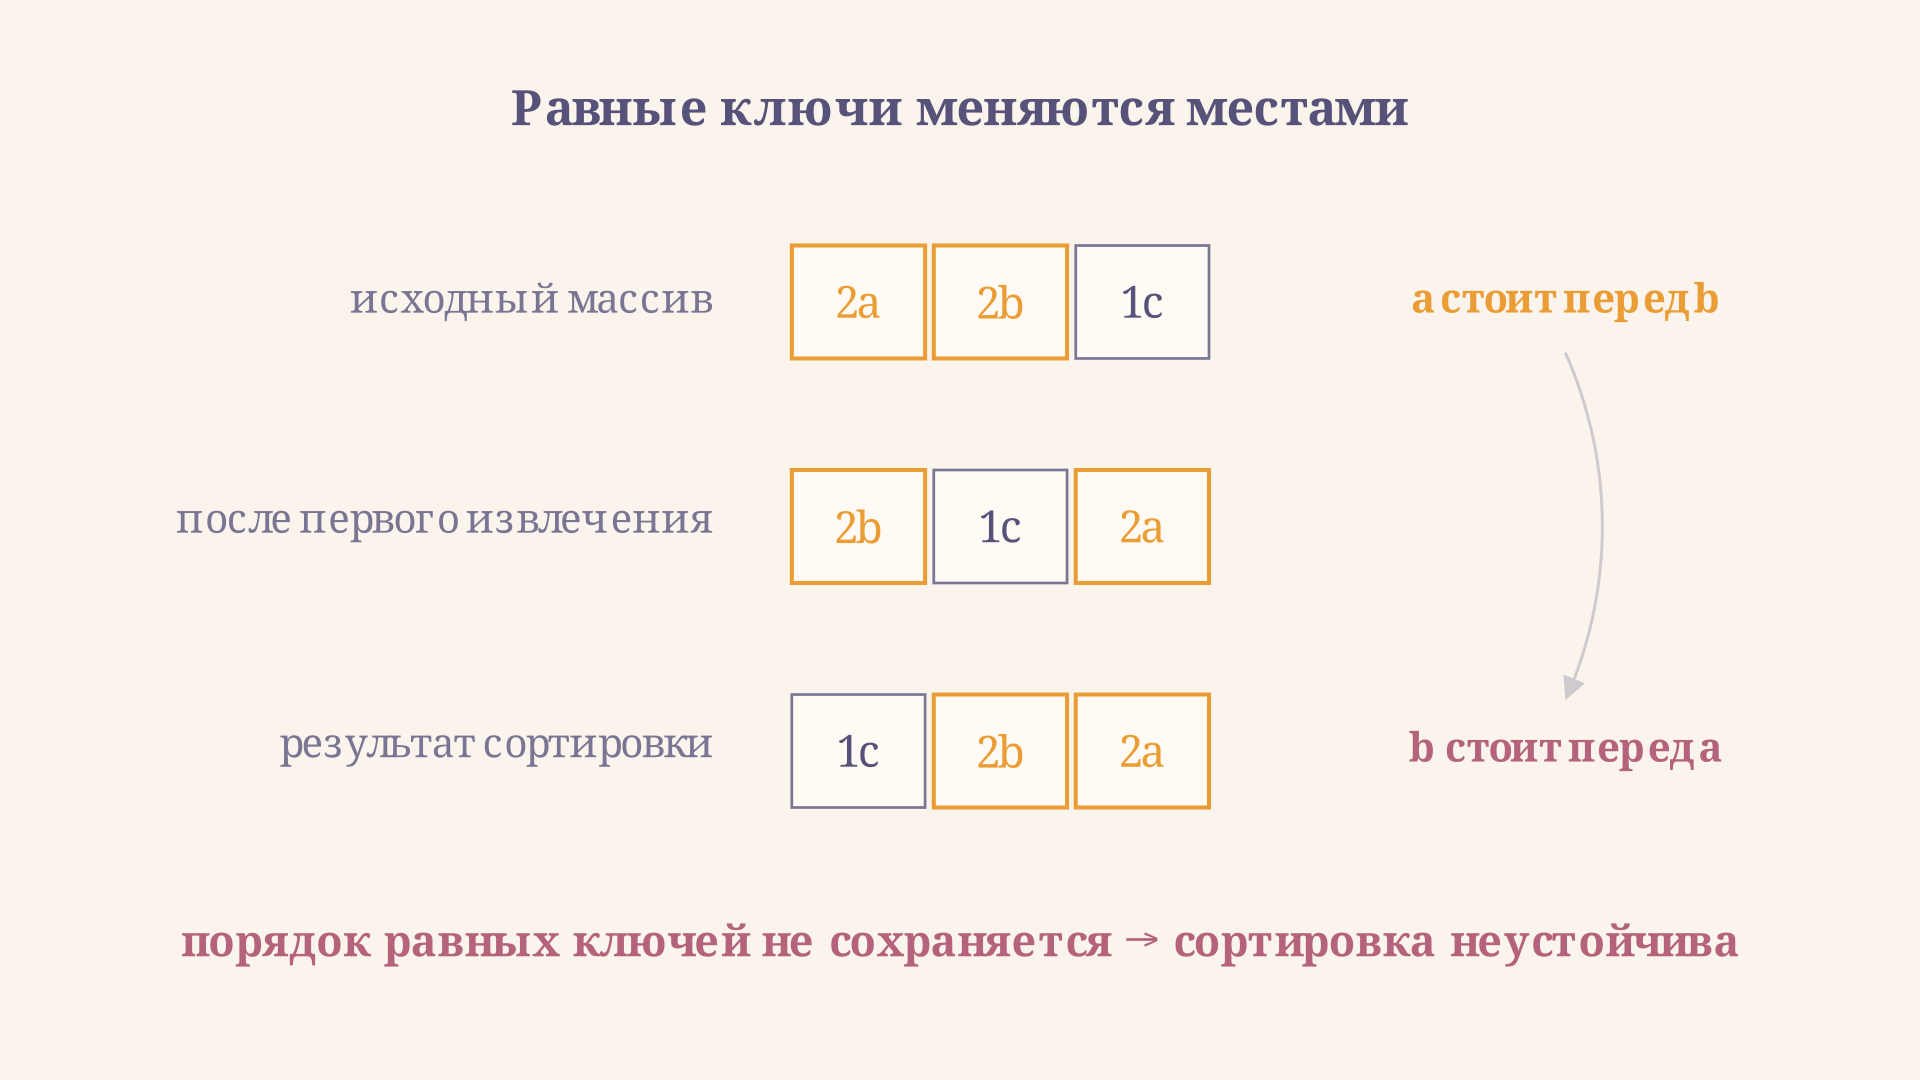
Возьмём массив 2a, 2b, 1c, где буква помечает исходную позицию равных ключей. Куча уже корректна, поэтому первый же шаг меняет корень 2a с последней ячейкой: получается 2b, 1c, 2a. Дальше алгоритм доводит дело до конца и выдаёт 1c, 2b, 2a - элемент a, который стоял раньше b, оказался позже. Причина в самом приёме: обмен перебрасывает элемент через весь массив, никак не учитывая исходные позиции. Если устойчивость нужна, ключ дополняют исходным индексом и сравнивают пары, но за это приходится платить памяти.
Пирамидальная против быстрой сортировки
Обе сортировки работают на месте и обе в типичном случае дают , но ведут себя по-разному:
- Худший случай. У heapsort это при любом входе. У quicksort - , если опорный элемент раз за разом оказывается минимумом или максимумом подмассива; подробный разбор этого сценария есть в статье про худший случай быстрой сортировки. Для 15 элементов это 105 сравнений против 67 у heapsort.
- Память. У heapsort , у quicksort на стек рекурсии, а при вырожденном разбиении до .
- Средний случай. Здесь выигрывает quicksort: он делает меньше обменов и читает память последовательно, а heapsort прыгает между уровнями кучи и промахивается мимо кэша.
- Устойчивость. Обе неустойчивы, так что этот пункт не разводит их вовсе.
Компромисс, который используют стандартные библиотеки, называется introsort: сортировка идёт быстрой, но как только глубина рекурсии превышает , оставшийся кусок дорабатывается пирамидальной. Так сохраняется скорость quicksort в среднем и гарантия в худшем случае. Отдельно стоит помнить, что сама куча полезна и без сортировки: как очередь с приоритетом она обслуживает, например, алгоритм Дейкстры на взвешенном графе.
Частые ошибки
- Строить кучу вставками по одному элементу. Это честные вместо : просеивание вверх идёт от листьев, где сидит большинство узлов, а не к ним.
- Путать индексацию. Формулы и верны для массива с нуля; в варианте с единицы дети находятся в и . Смешение двух схем - самая частая причина «почти работающего» heapsort.
- Забывать уменьшать размер кучи. Если просеивать новый корень по всему массиву, максимум вернётся из отсортированного хвоста обратно наверх, и сортировка зациклится.
- Брать min-кучу для сортировки по возрастанию. Min-куча отдаёт минимум, он встаёт в конец, и массив получается упорядоченным по убыванию.
- Считать heapsort устойчивой только потому, что он работает на месте, как сортировка вставками.
FAQ
Пирамидальная сортировка и сортировка кучей - это разные алгоритмы? Нет, это одно и то же: heapsort в русских учебниках называют и пирамидальной сортировкой, и сортировкой кучей. «Пирамида» здесь просто старое название двоичной кучи.
Почему heapsort с той же асимптотикой на практике медленнее быстрой сортировки? Из-за константы и поведения кэша. Просеивание прыгает по индексам , , , то есть шагает по памяти всё дальше, и почти каждый спуск даёт промах кэша. Быстрая сортировка, наоборот, читает подмассив подряд. Плюс heapsort делает больше обменов: на 15 элементах их 44 против примерно 20 у сбалансированного quicksort.
Когда пирамидальную сортировку выбирают осознанно? Когда нужна жёсткая гарантия времени и памяти: реальное время, ядра ОС, встраиваемые системы, а также как страховка внутри introsort. Ещё heapsort удобен, если из потока нужны не все элементы, а только наибольших: первые извлечений дают ответ за .
Коротко
Пирамидальная сортировка строит из массива max-кучу за , а затем раз обменивает корень с последней ячейкой кучи, сжимает кучу и просеивает новый корень вниз. Просеивание ограничено высотой кучи, поэтому общая оценка выполняется при любом входе, а вся работа идёт в исходном массиве, так что дополнительной памяти нужно . Обратная сторона - неустойчивость и плохая локальность обращений к памяти: по чистой скорости в среднем случае heapsort уступает быстрой сортировке, зато никогда не проваливается в .
Читайте также
Динамическое программирование: основы и идея мемоизации
Что такое динамическое программирование простыми словами: перекрывающиеся подзадачи, оптимальная подструктура, мемоизация и табуляция на примере чисел Фибоначчи, разница с наивной рекурсией.
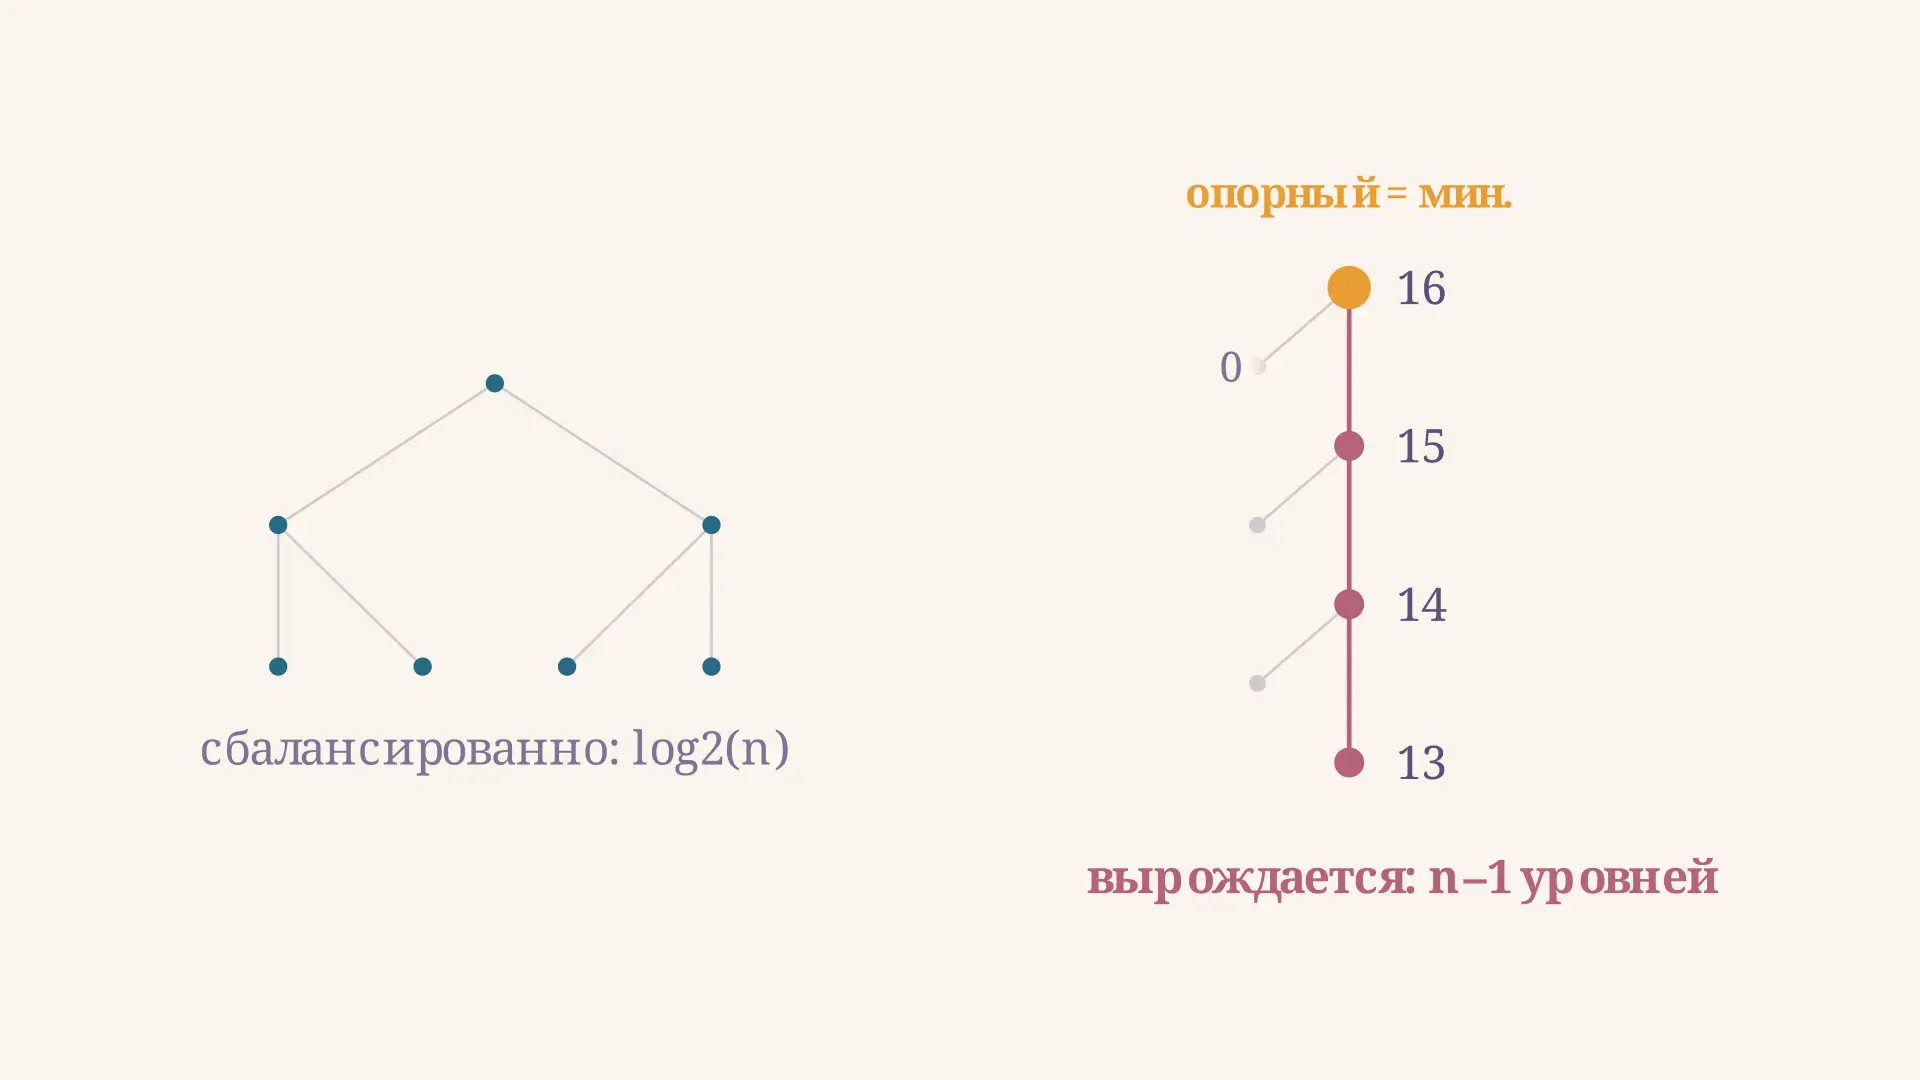
Быстрая сортировка: почему возникает худший случай
Разбираем, из-за чего быстрая сортировка скатывается в худший случай O(n^2): вывод рекуррентного соотношения, разбор на числах и способы избежать вырожденного разбиения на практике.
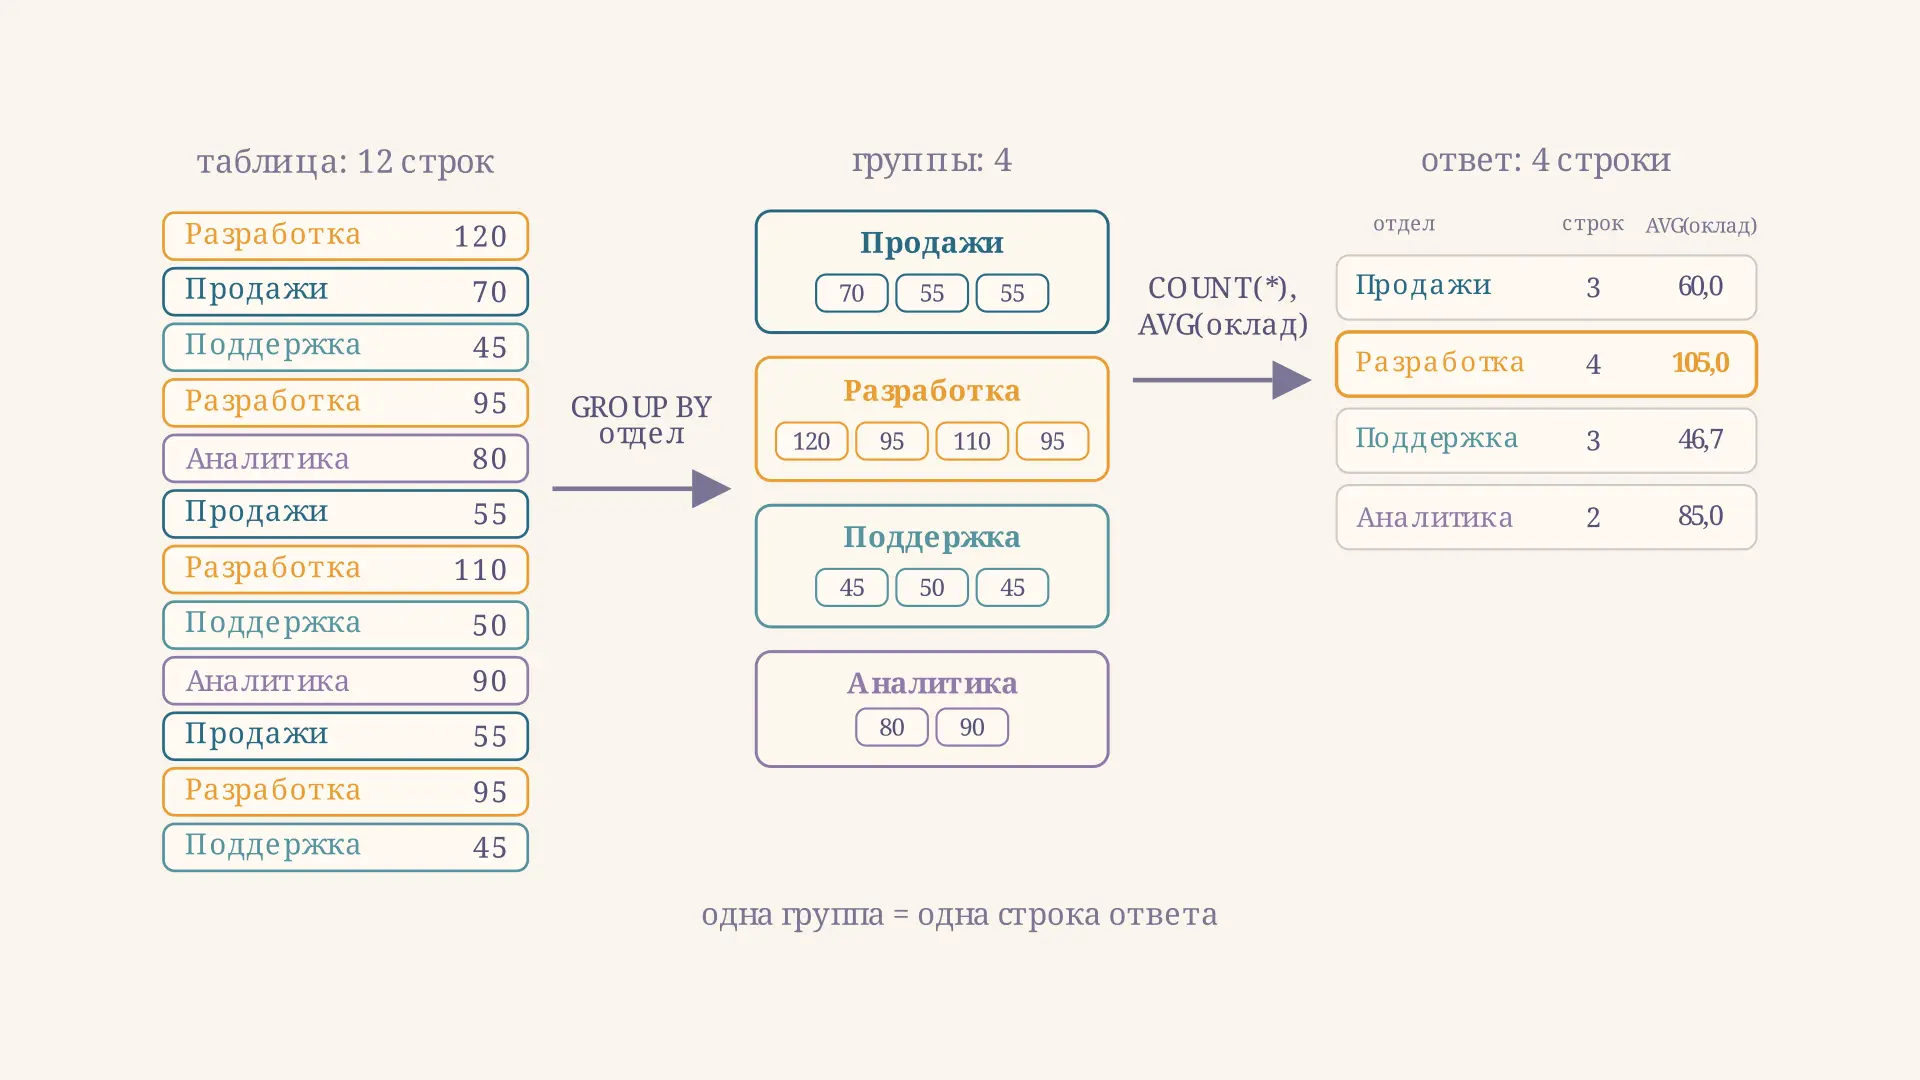
Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
Как работают агрегатные функции SQL: COUNT, SUM, AVG, MIN и MAX, группировка GROUP BY, порядок выполнения запроса, разница HAVING и WHERE и поведение NULL внутри агрегата.
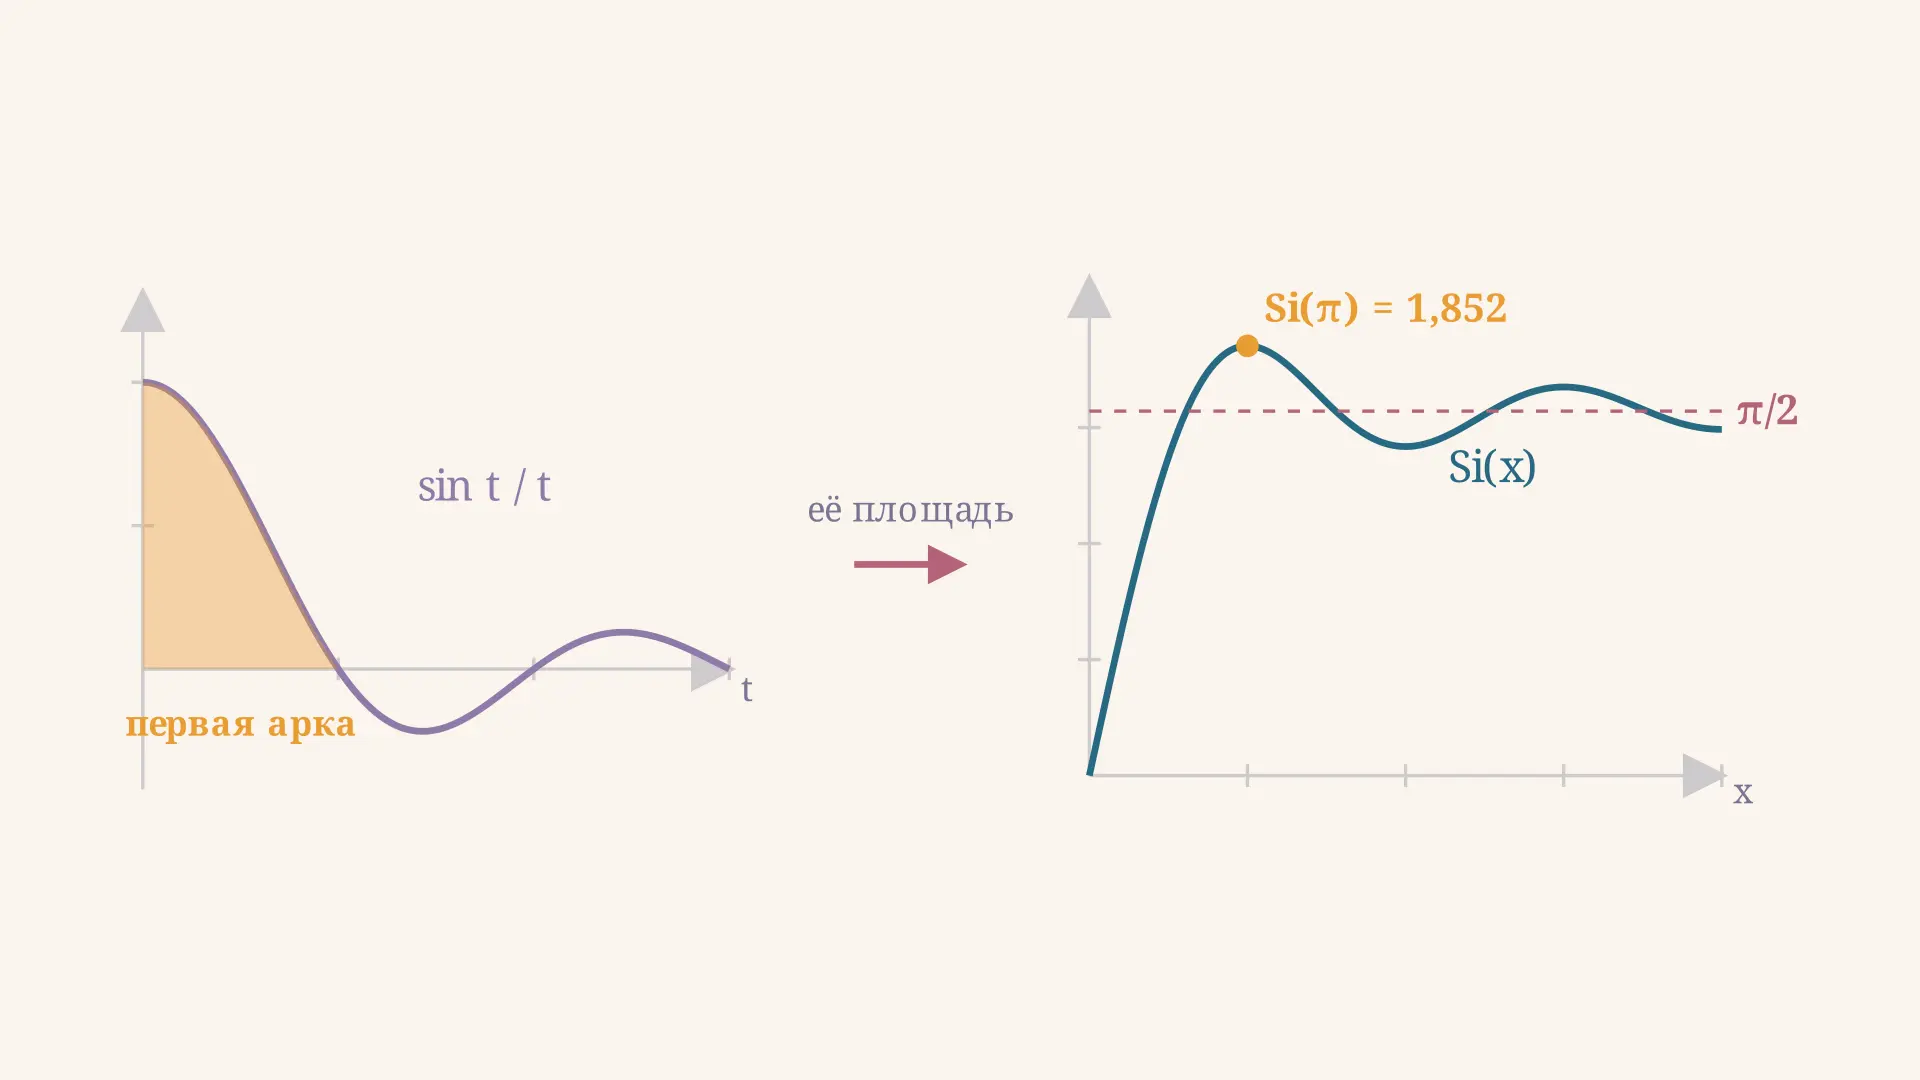
Интегральный синус Si(x): ряд Тейлора и максимум
Интегральный синус Si(x): почему интеграл sin t / t не берётся в элементарных функциях, разложение в ряд, предел π/2, максимум Si(π) и выброс Гиббса. С калькулятором.
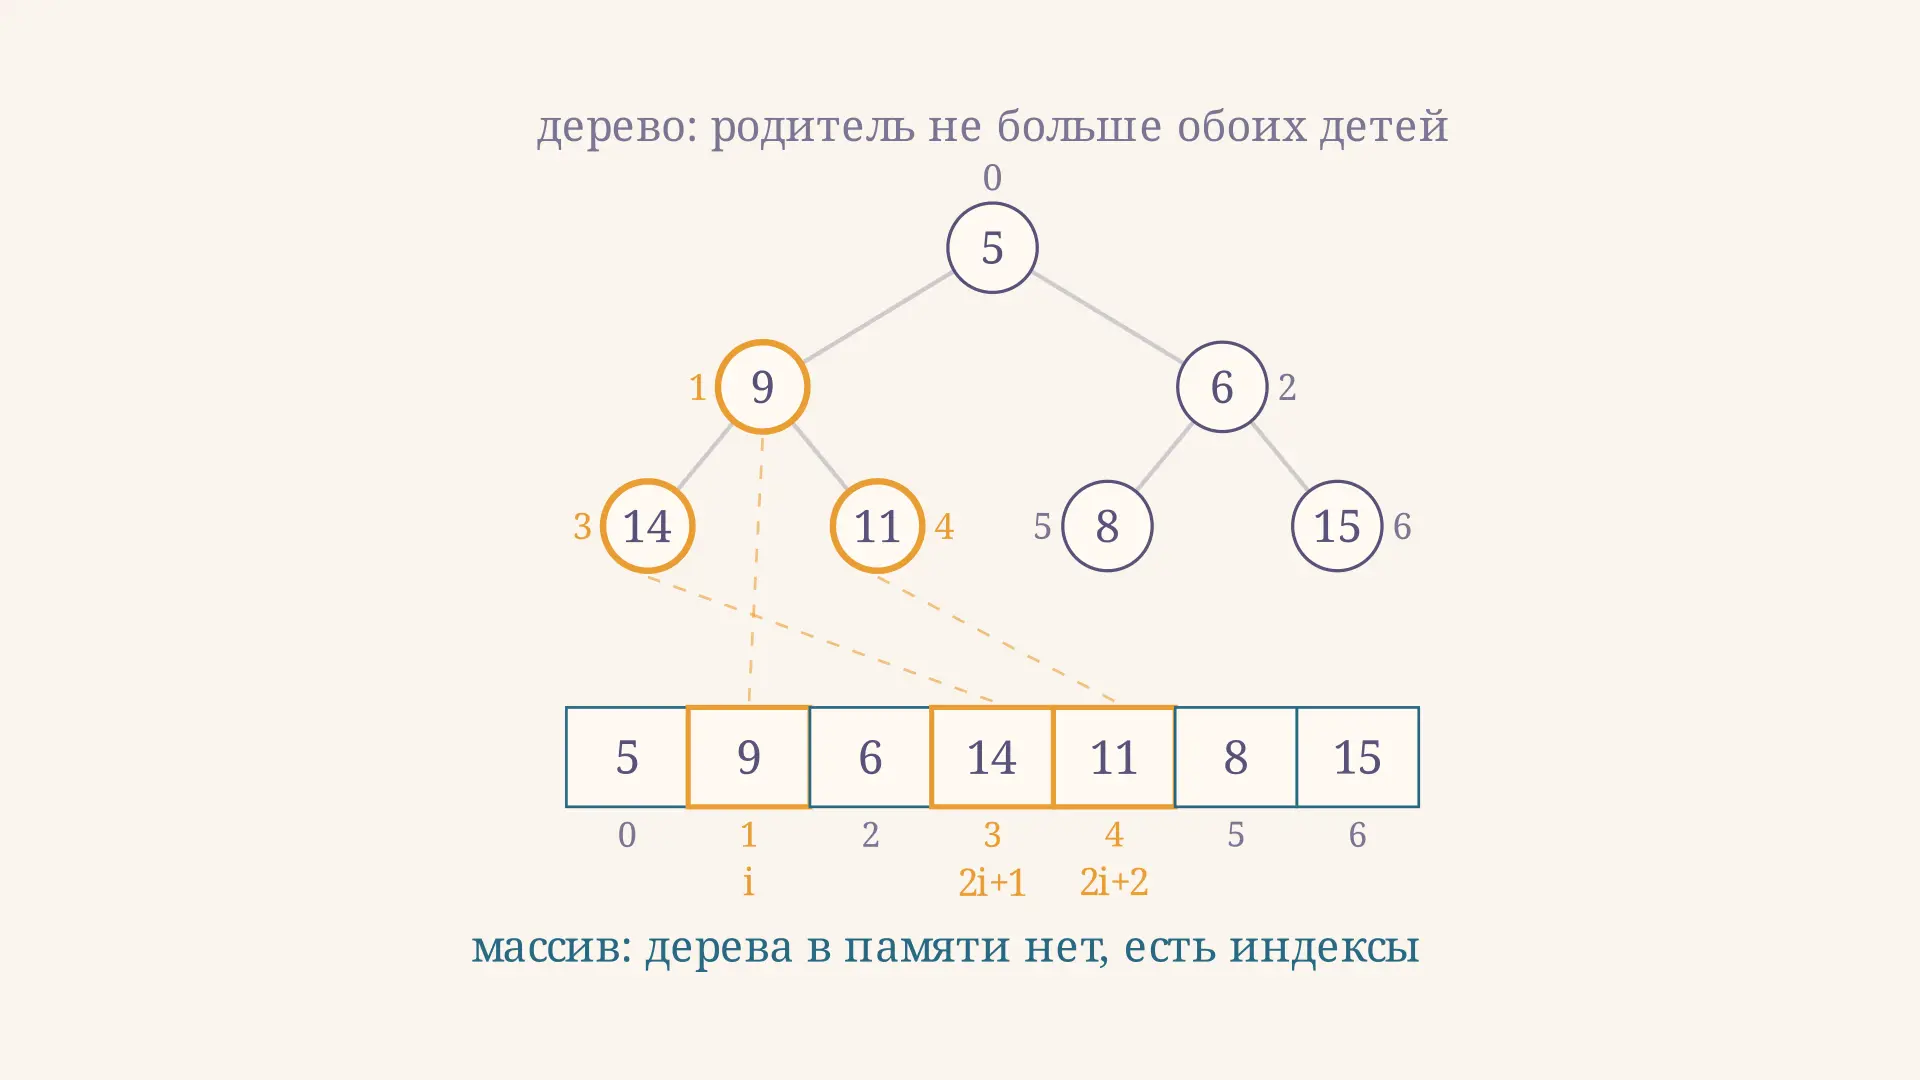
Куча как структура данных: массив и просеивание
Куча как структура данных: свойство кучи, хранение в обычном массиве и индексы 2i+1 и 2i+2, просеивание sift-up и sift-down, построение за O(n) и приоритетная очередь.
Линейная зависимость векторов: критерии и примеры
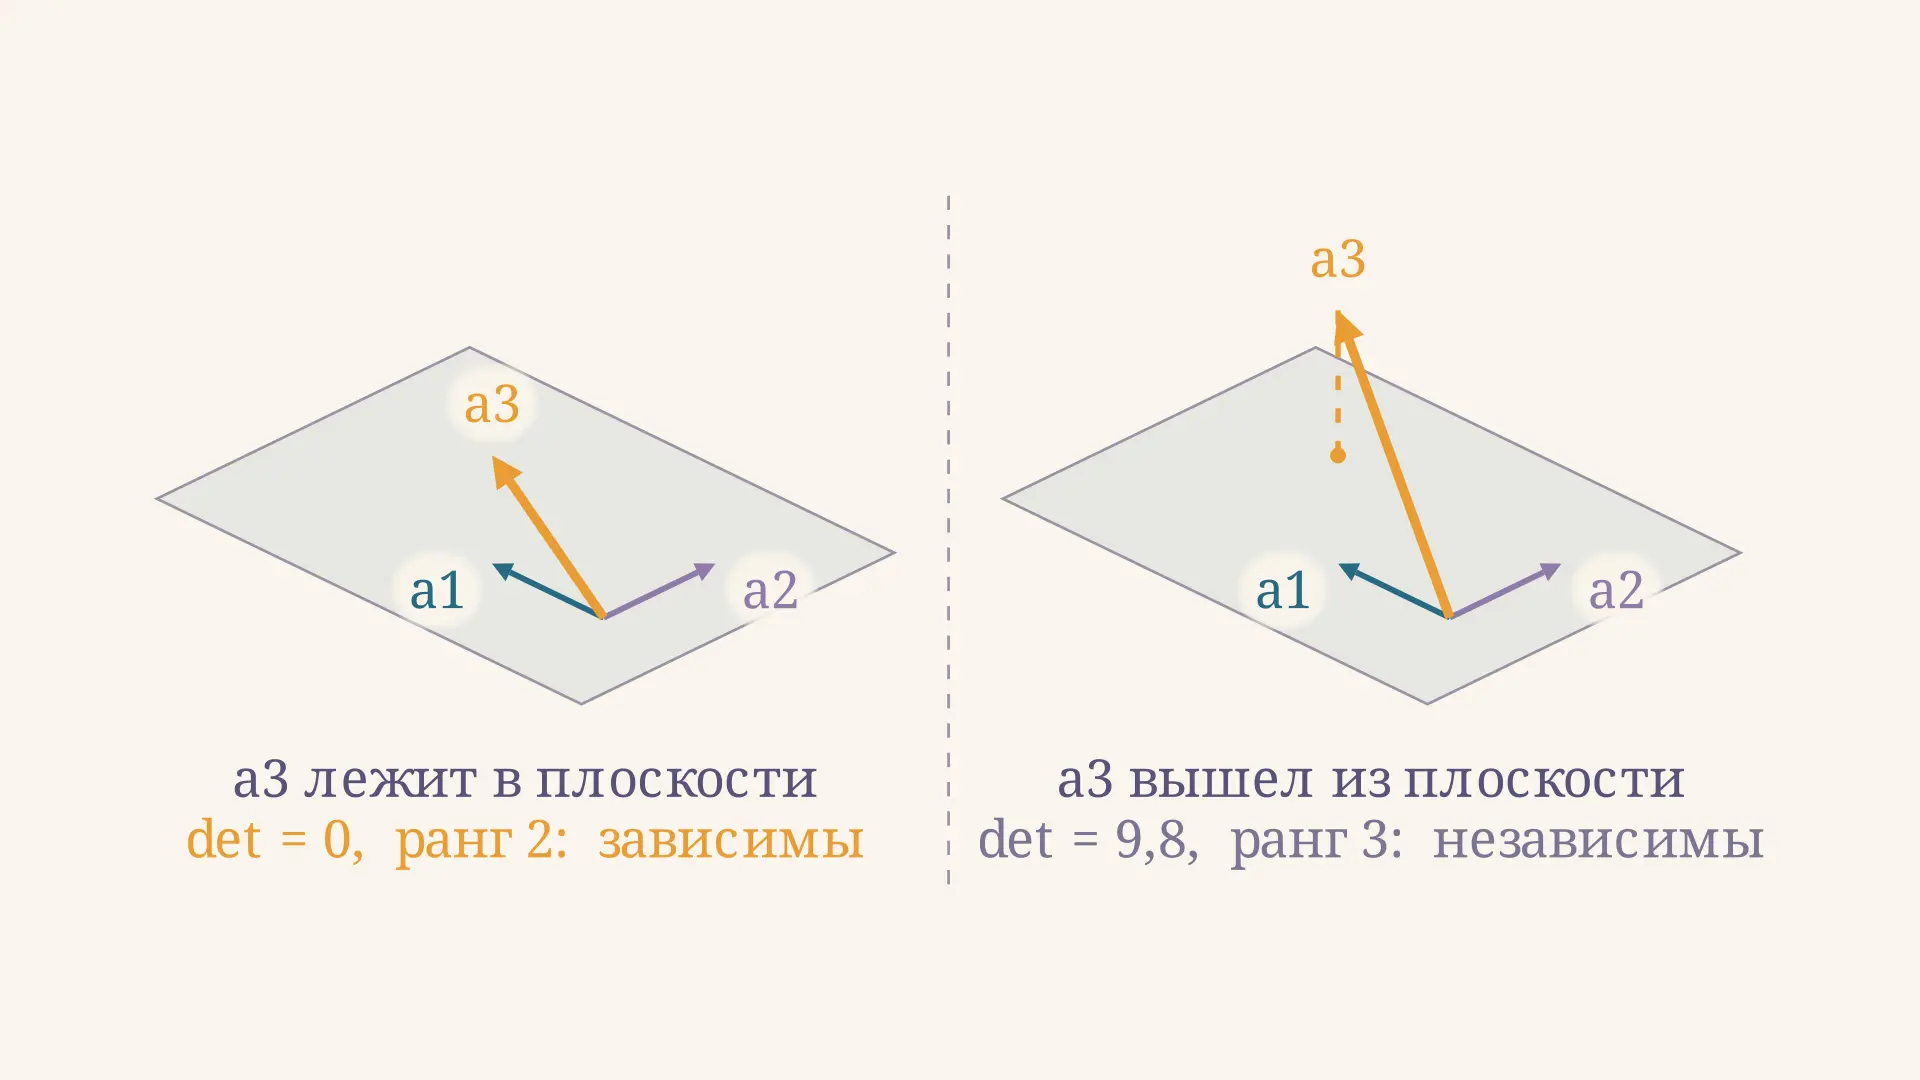
Что такое линейная зависимость векторов, как проверить её определителем и рангом матрицы, чем коллинеарность отличается от компланарности и как всё это связано с базисом.