Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
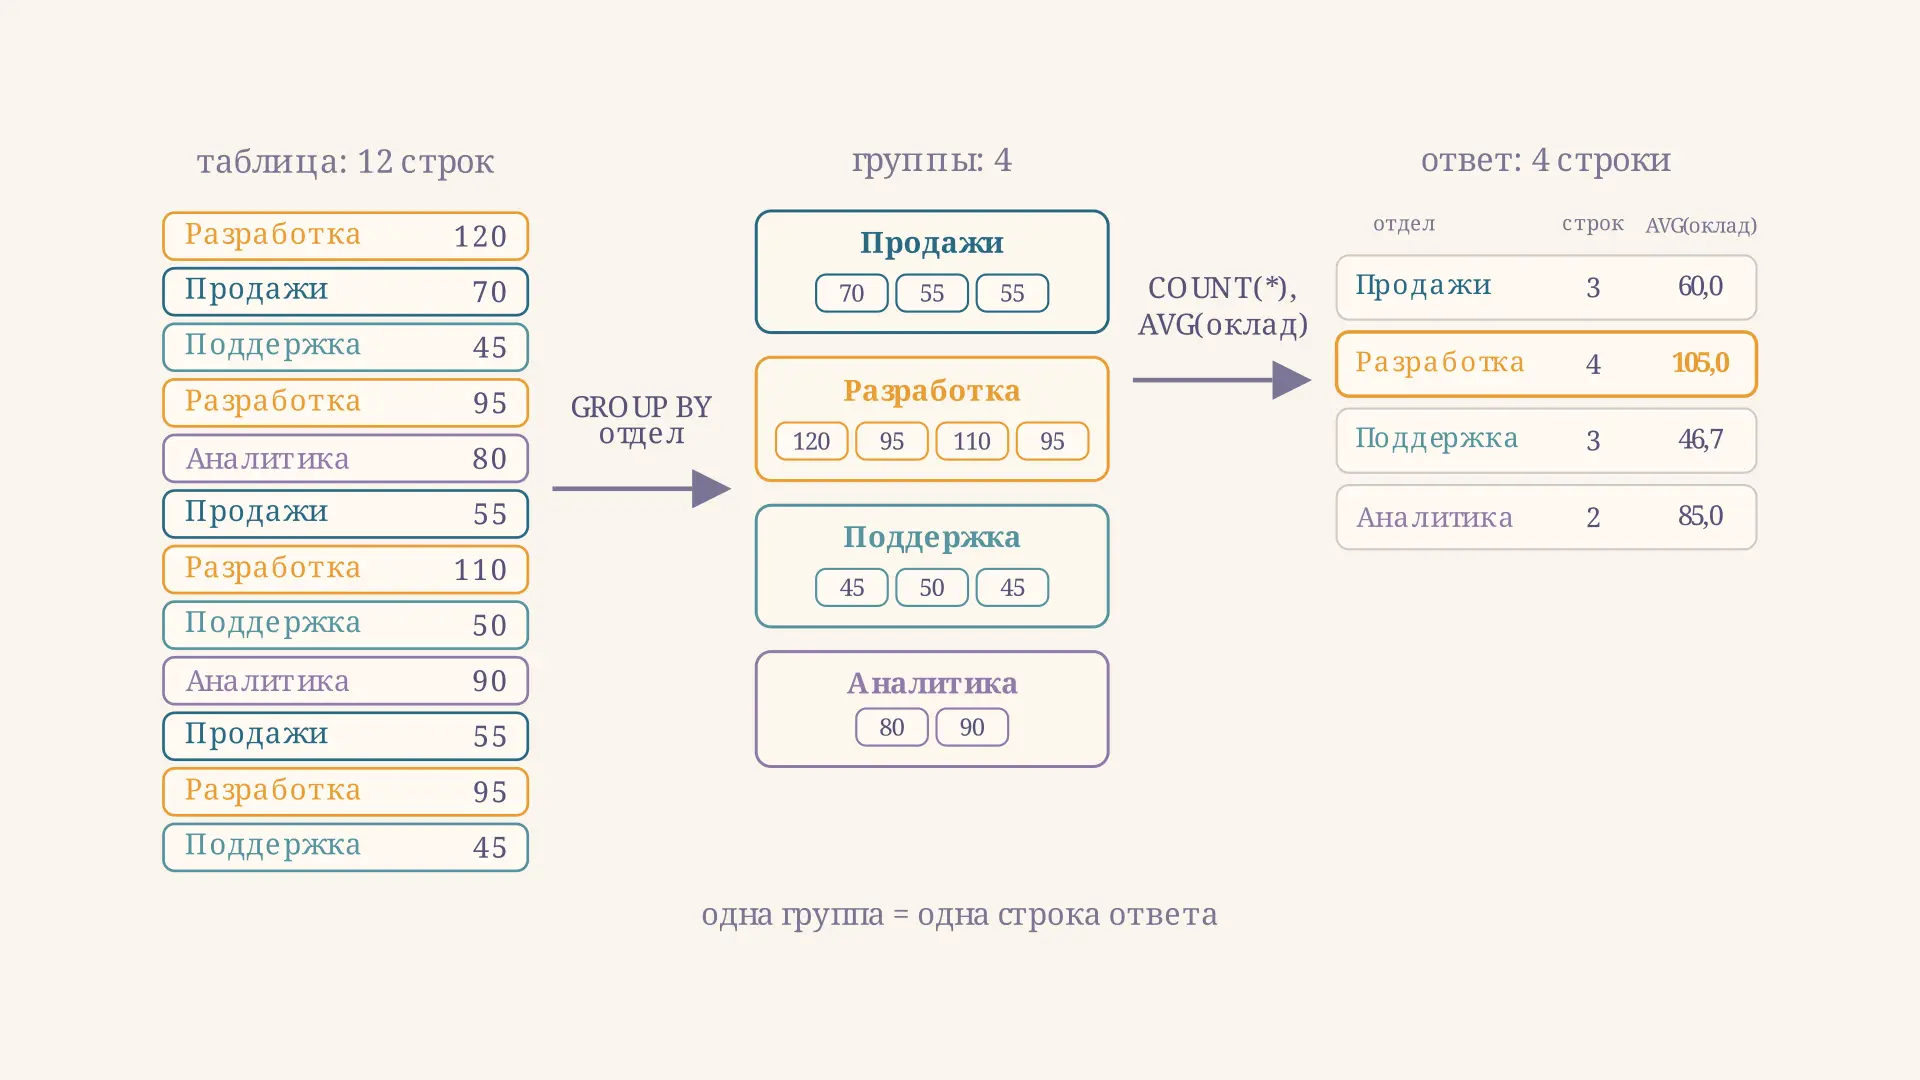
Агрегатная функция в SQL сворачивает множество строк в одно значение: COUNT считает строки, SUM складывает, AVG усредняет, MIN и MAX достают крайние. Без группировки такая функция превращает всю таблицу в одну строку ответа, а вместе с GROUP BY - каждую группу строк в свою строку. Почти все вопросы по теме сводятся к четырём: в каком порядке выполняется запрос, чем HAVING отличается от WHERE, что происходит с NULL и почему COUNT(*) и COUNT(столбец) дают разные числа. Калькулятор ниже собран на учебной таблице из двенадцати сотрудников: подвигайте пороги WHERE и HAVING, переключите агрегат и посмотрите, как меняется состав групп и сам ответ.
Пять агрегатных функций и одна строка вместо множества
Стандарт SQL определяет пять базовых агрегатов, и запомнить их проще всего по тому, что именно они делают с набором значений :
- COUNT - мощность набора, то есть ;
- SUM - сумма ;
- AVG - среднее арифметическое , то есть SUM, делённая на COUNT по тому же столбцу;
- MIN и MAX - наименьшее и наибольшее значение.
Возьмём таблицу сотрудники с колонками отдел, оклад и премия: двенадцать строк, четыре отдела. Запрос SELECT COUNT(*), AVG(оклад), MIN(оклад), MAX(оклад) FROM сотрудники вернёт ровно одну строку: 12, 75,8, 45 и 120. Именно это и есть главное свойство агрегата: сколько бы строк ни было на входе, на выходе одно значение.
Важно, что AVG считается не как «сумма, делённая на число строк таблицы», а как SUM, делённая на COUNT непустых значений того же столбца. На окладах разницы нет, а на премии она будет решающей - к этому вернёмся ниже.
GROUP BY: одна группа равна одной строке ответа
GROUP BY делит строки на непересекающиеся группы по значению столбца, и агрегат считается внутри каждой группы отдельно:
SELECT отдел, COUNT(*) AS сотрудников, AVG(оклад) AS средний
FROM сотрудники
GROUP BY отдел;
Четыре отдела дают четыре строки ответа: Продажи - 3 сотрудника и 60,0; Разработка - 4 и 105,0; Поддержка - 3 и 46,7; Аналитика - 2 и 85,0. В калькуляторе выше эти же числа получаются, если опустить порог WHERE до нуля, то есть пропустить в группировку все двенадцать строк. Исходный порядок строк при этом не важен: группировка собирает строки по значению ключа, а не нарезает готовые блоки.
Отсюда главное правило написания таких запросов: каждый столбец в SELECT либо стоит внутри агрегата, либо перечислен в GROUP BY. PostgreSQL на нарушение ответит ошибкой «column must appear in the GROUP BY clause», MySQL в режиме ONLY_FULL_GROUP_BY тоже, а без этого режима молча вернёт произвольное значение из группы - и это худший сценарий, потому что запрос выглядит работающим. Группировать можно и по нескольким столбцам: тогда ключом группы становится кортеж значений, что прямо следует из того, как устроена реляционная модель данных.
Порядок выполнения запроса: SELECT написан первым, а выполняется пятым
Текст запроса читается сверху вниз, но исполняется он в другом порядке: FROM, затем WHERE, затем GROUP BY, затем HAVING, только потом SELECT и в самом конце ORDER BY. Это не педантизм, а объяснение почти всех ошибок в таких запросах.
Из этого порядка следуют три практических вывода. Первый: WHERE выполняется до группировки, поэтому агрегата в нём ещё не существует - условие WHERE AVG(оклад) >= 70 невозможно в принципе. Второй: псевдоним из SELECT (AVG(оклад) AS средний) не виден ни в WHERE, ни в GROUP BY, ни в HAVING, потому что SELECT к этому моменту не отработал; зато в ORDER BY он виден, так как сортировка идёт последней. Третий: DISTINCT в SELECT применяется уже к результату агрегации, а не к исходным строкам.
HAVING против WHERE: фильтр до группировки и после
WHERE отбирает строки до того, как они попали в группы. HAVING отбирает уже готовые группы по значению агрегата. Условие вроде «оклад не ниже 70» технически можно записать и там, и там, но результат будет разным.
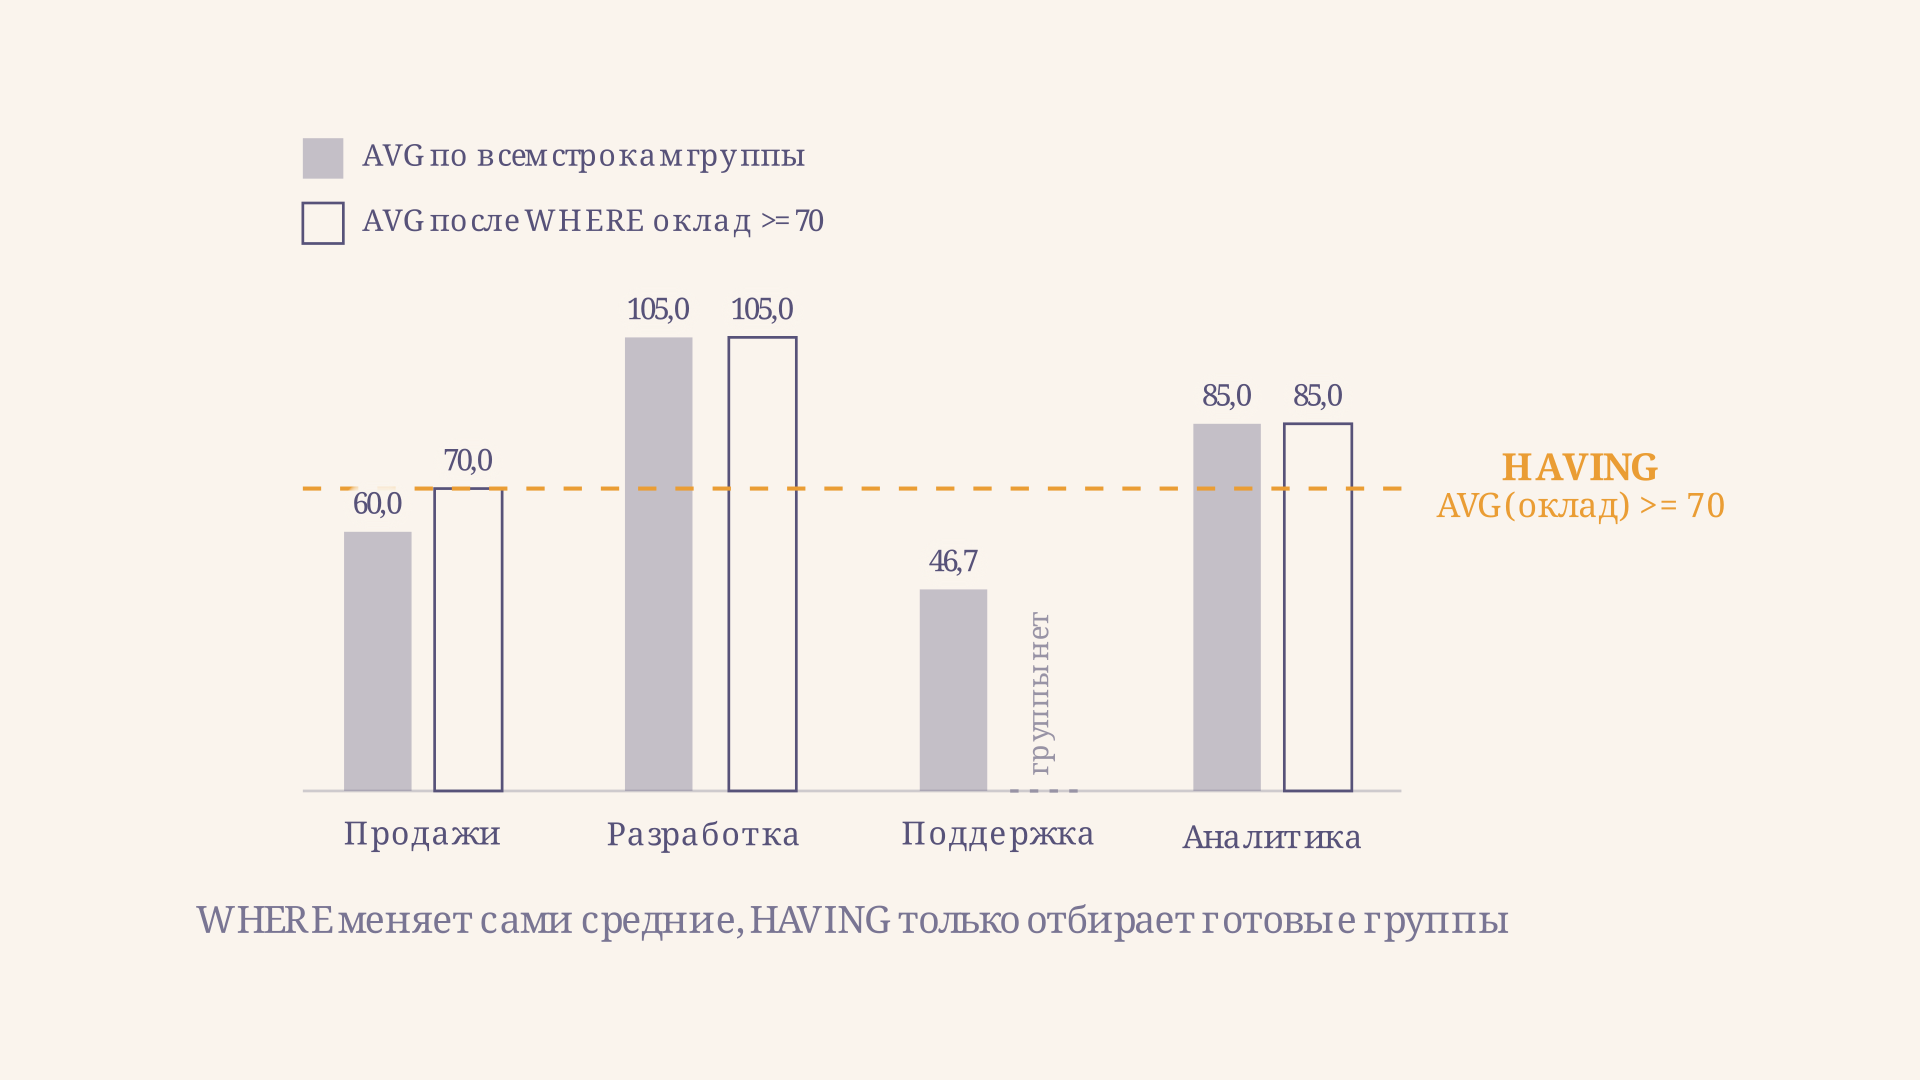
Разница видна по двум отделам. У Продаж WHERE выбрасывает из группы двух сотрудников с окладом 55, и среднее по остатку становится 70,0 вместо 60,0 - фильтр изменил само значение агрегата. У Поддержки под условие не проходит ни одна строка, поэтому группа исчезает из ответа совсем, а не просто отсеивается. HAVING же ничего не меняет внутри групп: он смотрит на уже посчитанные средние и оставляет те группы, которые проходят порог.
Отсюда правило выбора: условие на отдельную строку («договор заключён в 2025 году», «статус не архивный») всегда пишется в WHERE - так до группировки доходит меньше данных, и запрос быстрее. Условие на группу целиком («средний чек больше 5000», «заказов больше трёх») пишется в HAVING. Ставить в HAVING неагрегатное условие технически можно, но это лишняя работа для СУБД.
NULL внутри агрегата: COUNT(*) против COUNT(столбец)
Самая частая ловушка. Все агрегаты, кроме COUNT(*), просто не видят NULL: строка с пустым значением в подсчёте не участвует.
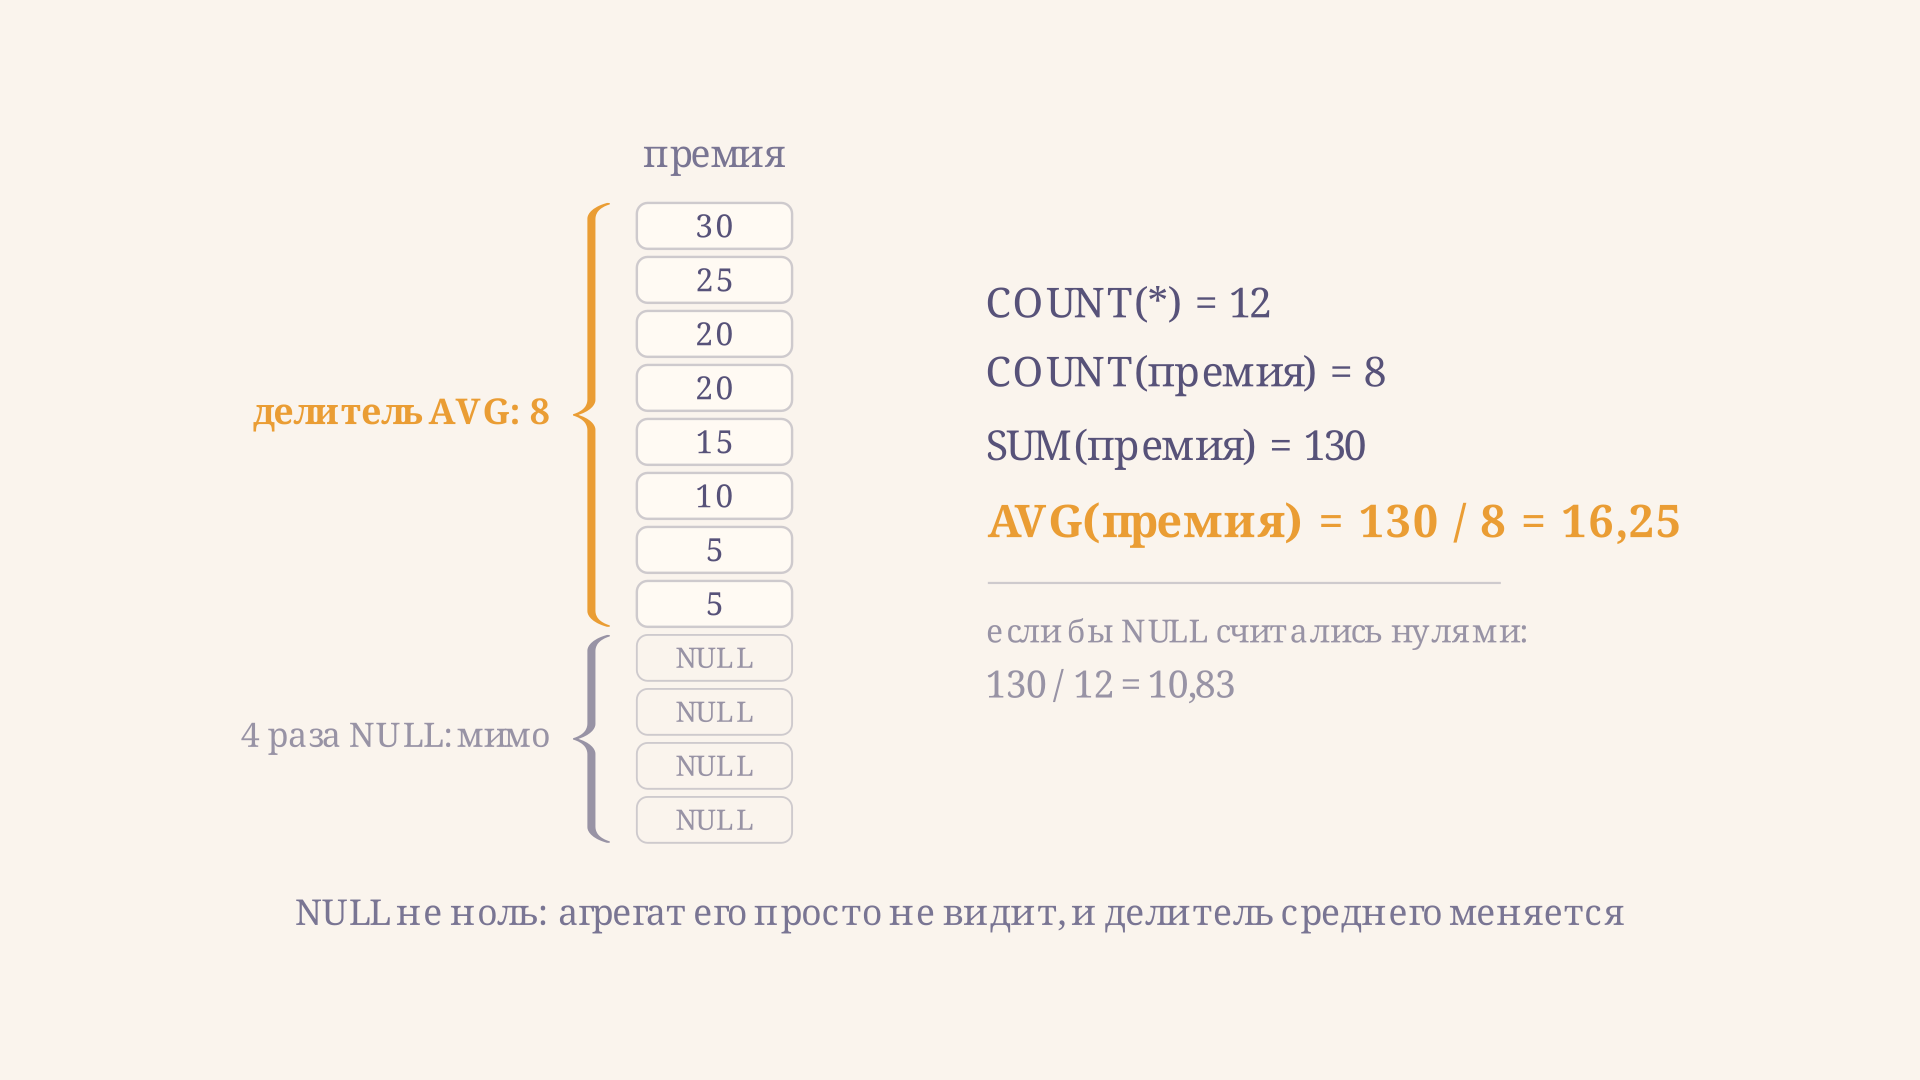
В нашей таблице премия назначена не всем: заполнено восемь значений из двенадцати. Поэтому COUNT(*) даёт 12, COUNT(премия) даёт 8, SUM(премия) равна 130, а AVG(премия) равна . Если считать, что NULL - это ноль, получится , и разница в полтора раза. Оба числа осмысленны, но отвечают на разные вопросы: первое - «сколько в среднем получают премируемые», второе - «сколько в среднем приходится на сотрудника». Какое нужно, решает постановка задачи, а не СУБД.
Ещё два следствия. Если в столбце вообще нет непустых значений, SUM, AVG, MIN и MAX вернут NULL, а COUNT вернёт 0 - поэтому COALESCE(SUM(сумма), 0) в отчётах не перестраховка, а необходимость. И порядок применения важен: AVG(COALESCE(премия, 0)) считает по двенадцати строкам, а COALESCE(AVG(премия), 0) - по восьми, подставляя ноль только если премий нет ни у кого.
DISTINCT внутри агрегата
DISTINCT внутри скобок убирает повторы до того, как агрегат посчитает результат. В нашей таблице встречается девять различных окладов на двенадцать строк, так что COUNT(оклад) даёт 12, а COUNT(DISTINCT оклад) даёт 9. На практике так считают уникальных клиентов, посетителей или товары: COUNT(DISTINCT customer_id) вместо COUNT(*).
Важно не путать два DISTINCT. SELECT DISTINCT отдел FROM сотрудники убирает дубли в готовом результате, а COUNT(DISTINCT отдел) убирает их внутри агрегата в каждой группе. И тот и другой работают уже после отсева NULL: пустые значения в DISTINCT не попадают. SUM(DISTINCT сумма) синтаксически допустим, но почти всегда означает ошибку в постановке задачи - он выбросит одинаковые платежи разных клиентов.
Частые ошибки
- Агрегат в WHERE.
WHERE COUNT(*) > 3не работает никогда: на момент WHERE групп ещё нет. Нужен HAVING или подзапрос. - Столбец в SELECT без GROUP BY. Выводить имя сотрудника рядом с
AVG(оклад)по отделу бессмысленно: в группе таких имён несколько, и СУБД либо выдаст ошибку, либо вернёт случайное. - Ожидание, что NULL это ноль.
AVGпо столбцу с пропусками делит на число заполненных значений. Если нужен другой знаменатель, подставляйте нули явно через COALESCE. COUNT(*)там, где нужны уникальные. Подсчёт строк после соединения таблиц завышает число клиентов ровно во столько раз, сколько у клиента заказов; спасаетCOUNT(DISTINCT ...).- Фильтр строк в HAVING. Условие
HAVING отдел <> 'Поддержка'отработает, но лишние строки дойдут до группировки. То же условие в WHERE отсечёт их раньше и дешевле.
FAQ
Чем COUNT(*) отличается от COUNT(1) и COUNT(столбец)? COUNT(*) и COUNT(1) считают строки и в современных СУБД выполняются одинаково: планы запроса совпадают, разницы в скорости нет. COUNT(столбец) считает строки, где этот столбец не NULL, и потому может дать меньшее число.
Можно ли вложить один агрегат в другой? Напрямую MAX(AVG(оклад)) запрещён: агрегат не принимает агрегат в аргументе. Нужен подзапрос - сначала посчитать средние по отделам, затем взять максимум из полученной выборки. В некоторых СУБД помогает оконная функция.
Что вернёт агрегат на пустой выборке? COUNT вернёт 0, а SUM, AVG, MIN и MAX - NULL. Если при этом в запросе есть GROUP BY, строк не будет вообще: пустых групп не существует, так что и одной строки с NULL вы не увидите.
Коротко
Агрегатные функции сворачивают множество строк в одно значение, а GROUP BY делает такую свёртку по каждой группе: одна группа даёт ровно одну строку ответа. Ключ к правильному запросу - порядок выполнения FROM, WHERE, GROUP BY, HAVING, SELECT, ORDER BY: WHERE фильтрует строки до группировки и потому меняет сами значения агрегатов, HAVING фильтрует готовые группы и агрегат менять не может. Все агрегаты, кроме COUNT(*), пропускают NULL, из-за чего COUNT по столбцу и COUNT по строкам расходятся, а AVG делит на число заполненных значений. Проверить любое из этих правил на числах можно в калькуляторе выше, а как устроены сами таблицы, по которым идёт группировка, разобрано в статье про нормализацию баз данных.
Читайте также
SQL соединения таблиц: типы JOIN и число строк
Разбираем соединение таблиц в SQL на строках: условие ON, отличие INNER JOIN от LEFT, RIGHT и FULL, откуда берутся NULL и почему фильтр в WHERE ломает внешнее соединение.
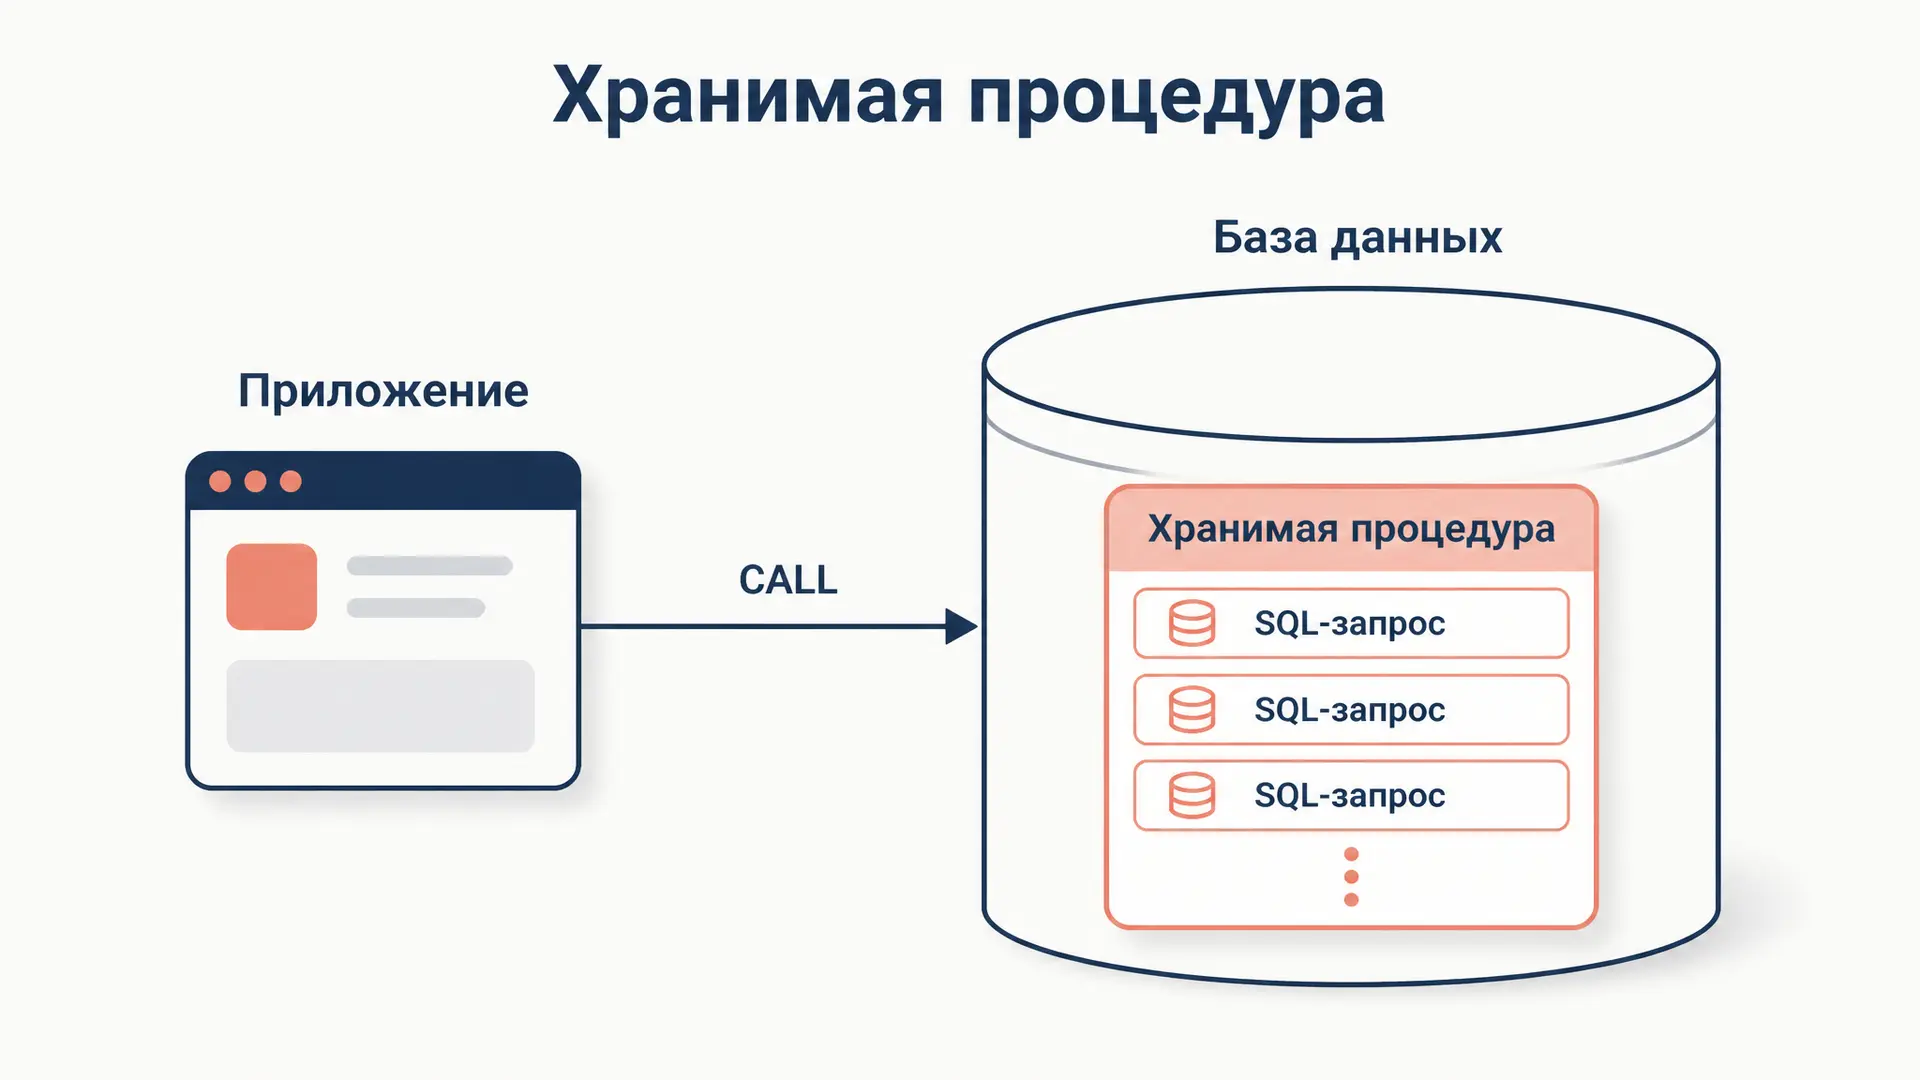
Хранимые процедуры в базе данных: зачем нужны и как писать
Хранимые процедуры в базе данных простыми словами: что это, синтаксис CREATE PROCEDURE, параметры IN OUT, отличие от функций и триггеров, плюсы и минусы, примеры на SQL.
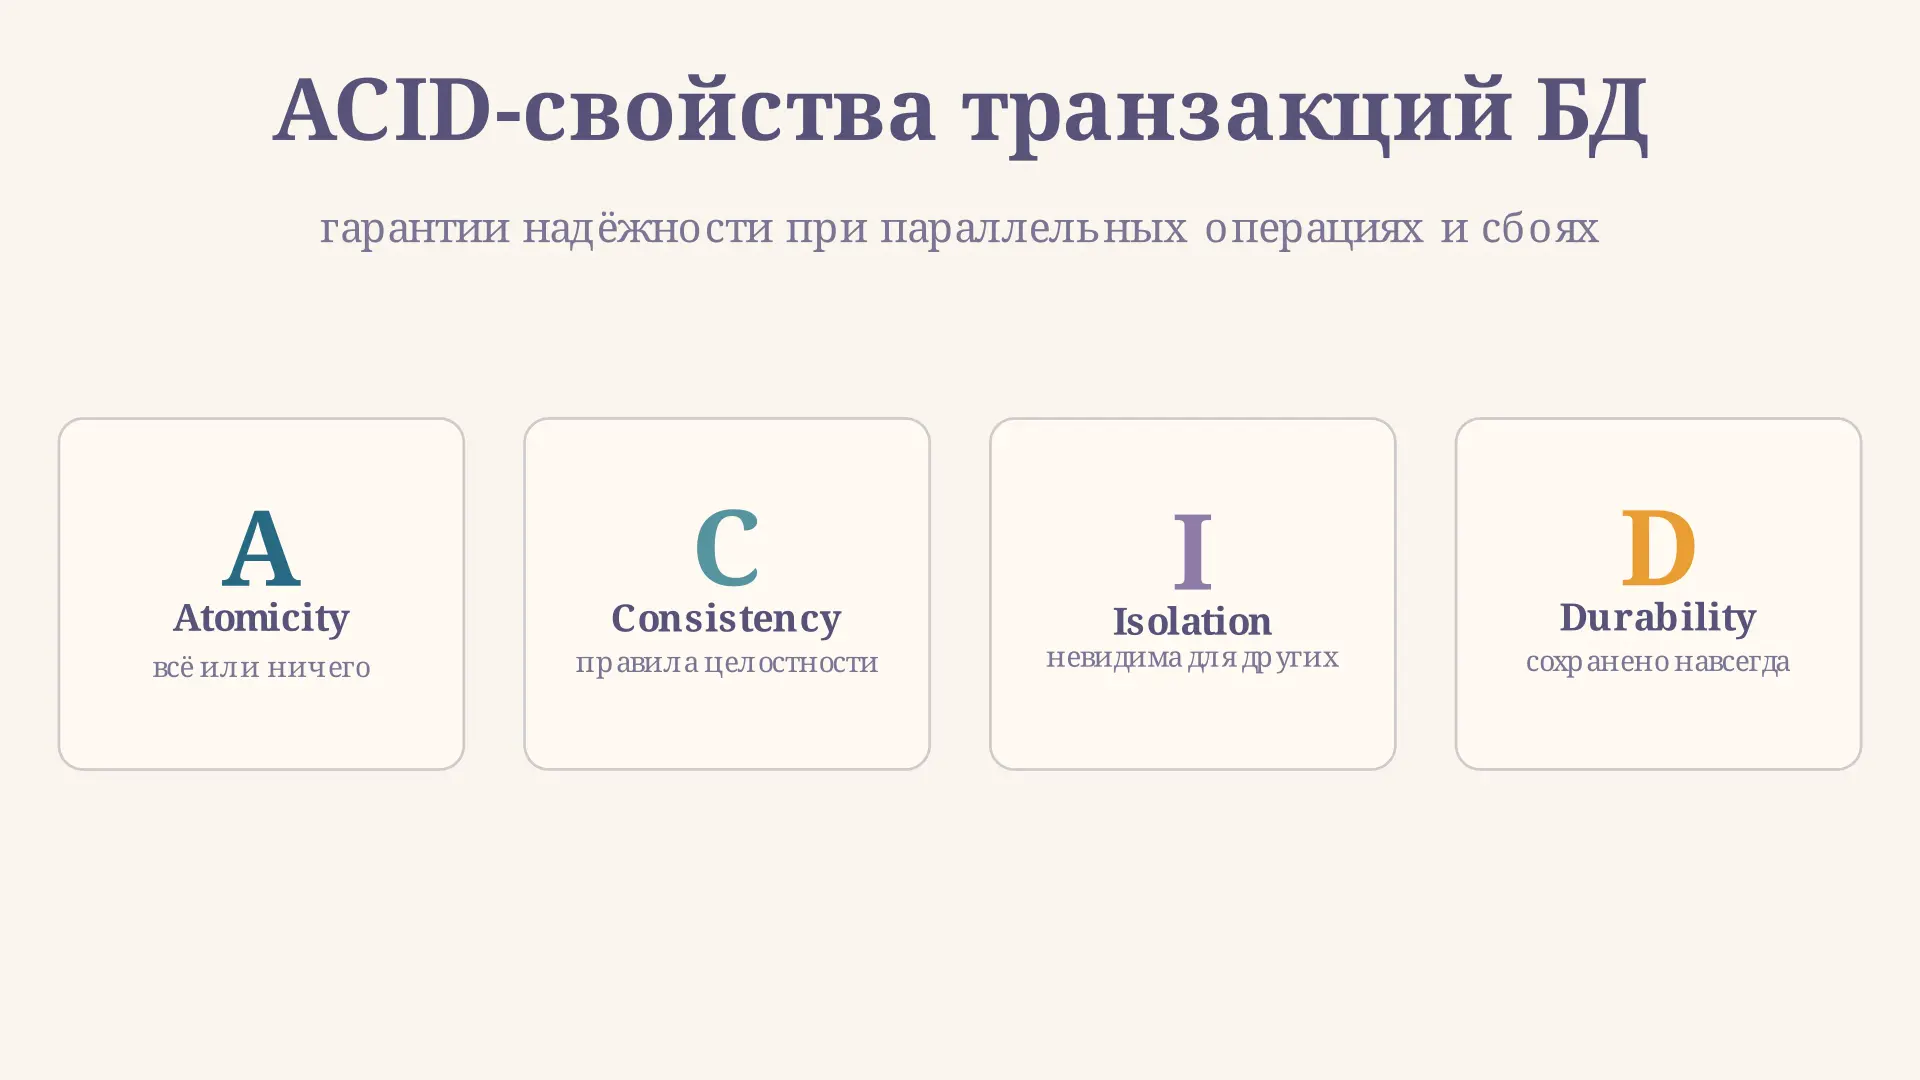
ACID-свойства транзакций: атомарность и изоляция
Разбираем четыре свойства ACID - атомарность, согласованность, изоляцию и долговечность. Примеры уровней изоляции, аномалий и deadlock в реляционных СУБД.
Транзакции ACID: атомарность, изоляция и надёжность
Разбор четырёх свойств ACID транзакции БД: атомарность, согласованность, изолированность, надёжность. Уровни изоляции, аномалии, COMMIT и ROLLBACK с примерами SQL.
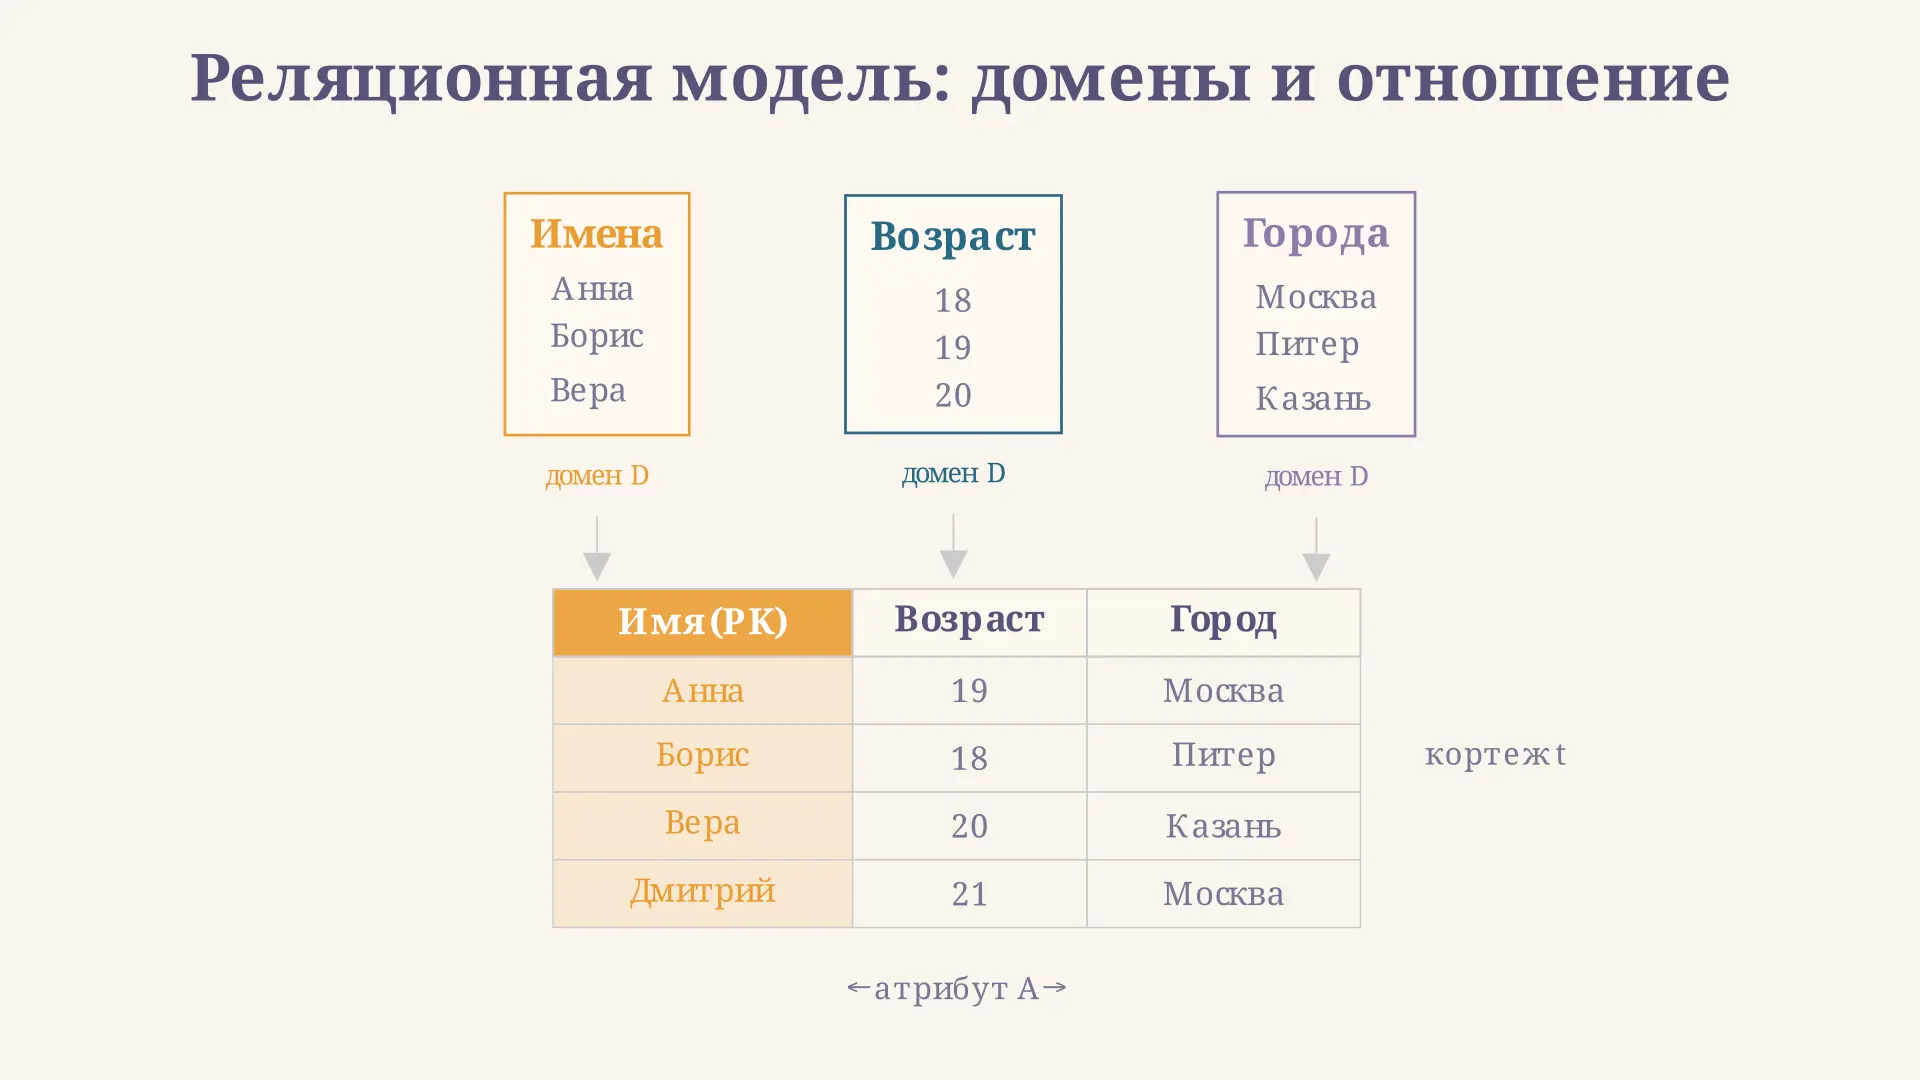
Реляционная модель данных: основные понятия
Домен, атрибут, кортеж, схема отношения, ключ и нормальные формы - разбираем реляционную модель данных от азов до практики с примерами и калькулятором.
Атрибуты сущности в ER-модели: пять типов и примеры
Разбираем пять типов атрибутов сущности в ER-модели: простой, составной, ключевой, многозначный, производный, с примерами и переходом к столбцам и таблицам реляционной схемы.