SQL соединения таблиц: типы JOIN и число строк
Соединение таблиц нужно ровно потому, что данные в нормализованной базе разложены по разным таблицам, а нужны они вместе: имя клиента лежит в одной таблице, сумма его заказа в другой. Оператор JOIN собирает строки обратно по условию, и вся сложность SQL соединения таблиц сводится к двум вопросам: какие пары строк считаются совпавшими и что делать со строками, которым пары не нашлось. Ниже разберём оба на одном наборе данных. Калькулятор считает размер результата по вашей схеме, поэтому начните с него: подвигайте ползунки и посмотрите, как растут столбики разных типов соединения.
Условие ON: от декартова произведения к совпавшим парам
Формально соединение таблиц - это фильтр над декартовым произведением. СУБД перебирает все пары «строка слева, строка справа» и оставляет те, для которых предикат в ON истинен:
Возьмём два отношения. Левая таблица clients из трёх строк:
| id | имя |
|---|---|
| 1 | Иванов |
| 2 | Петрова |
| 3 | Сидоров |
Правая таблица orders из пяти строк:
| id | client_id | сумма |
|---|---|---|
| 101 | 1 | 2500 |
| 102 | 1 | 1800 |
| 103 | 2 | 900 |
| 104 | 2 | 1400 |
| 105 | NULL | 1200 |
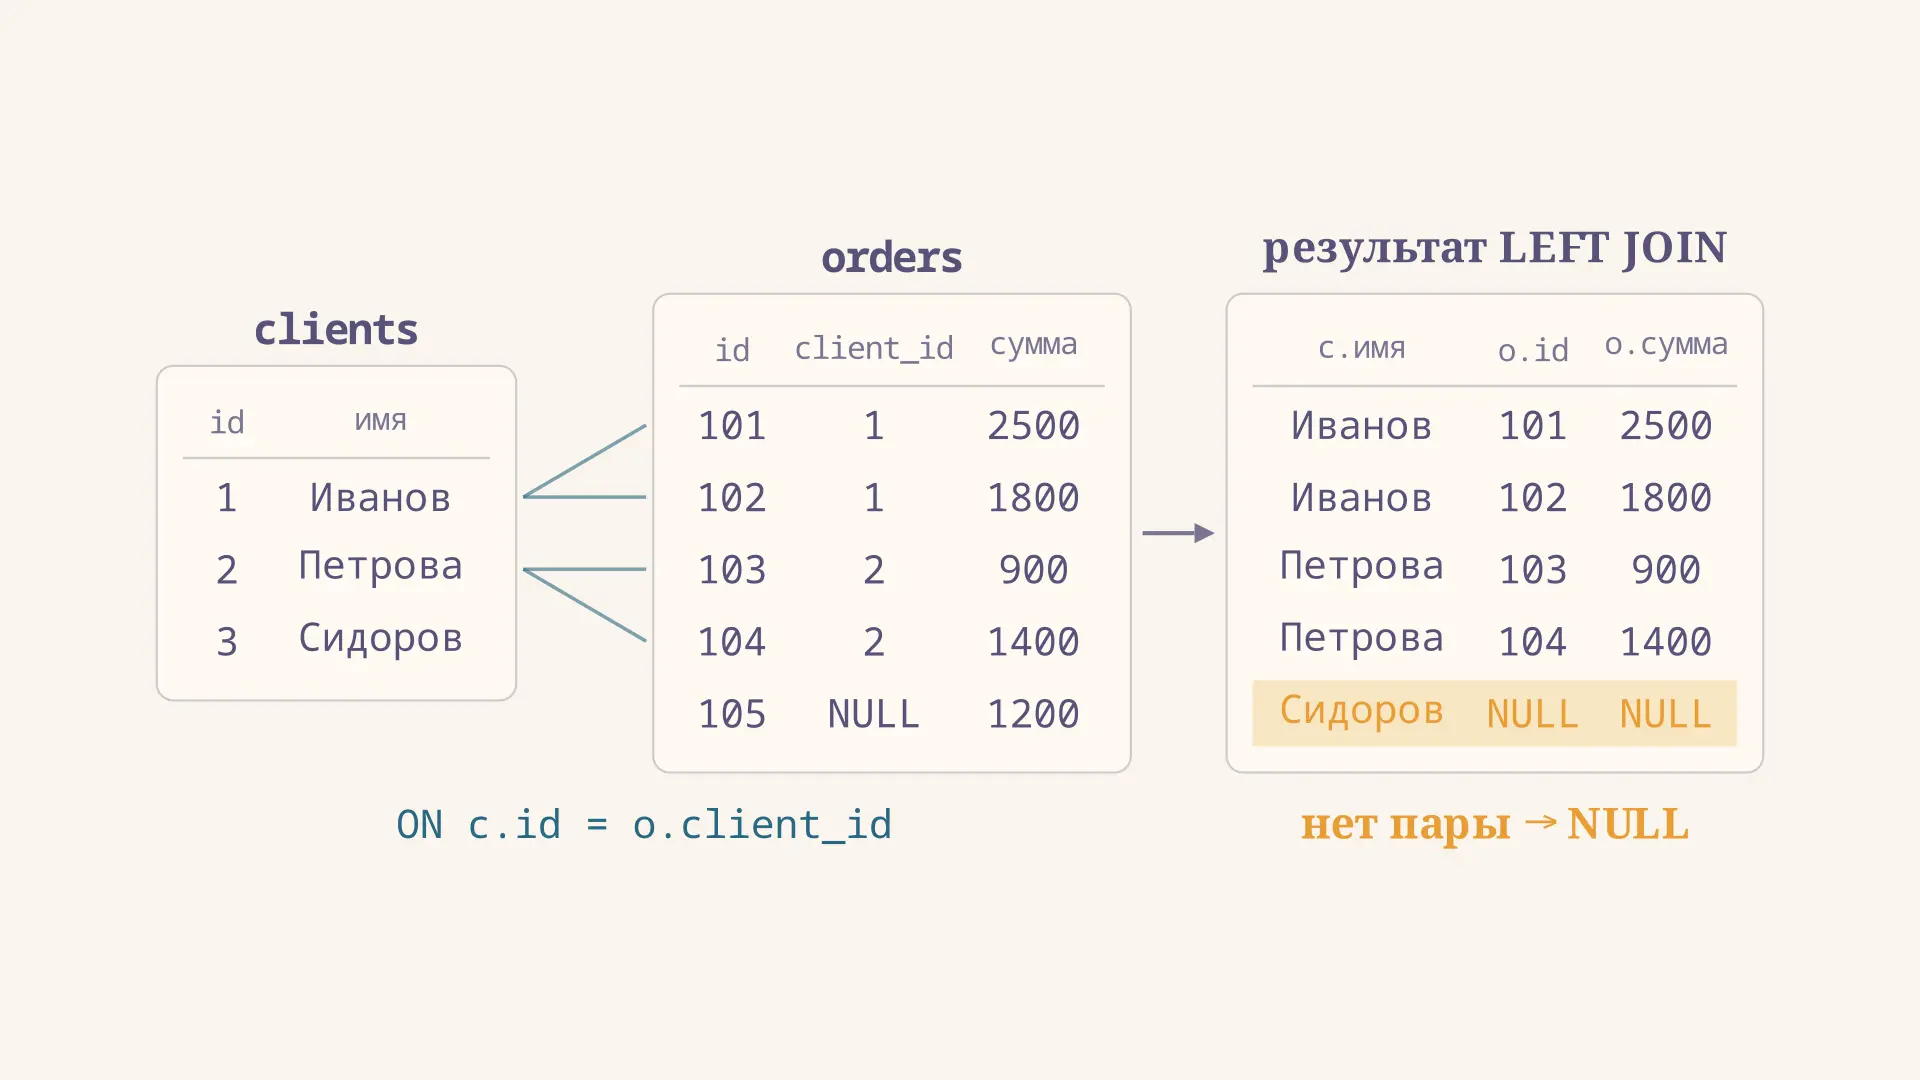
Условие ON c.id = o.client_id даёт четыре совпавшие пары: Иванов попадает в две строки заказов, Петрова тоже в две. Сидоров не совпал ни с чем, потому что заказов у него нет. Заказ 105 тоже остался без пары, и причина здесь тоньше: его client_id равен NULL, а NULL не равен ничему, даже другому NULL. Условие соединения для него никогда не истинно.
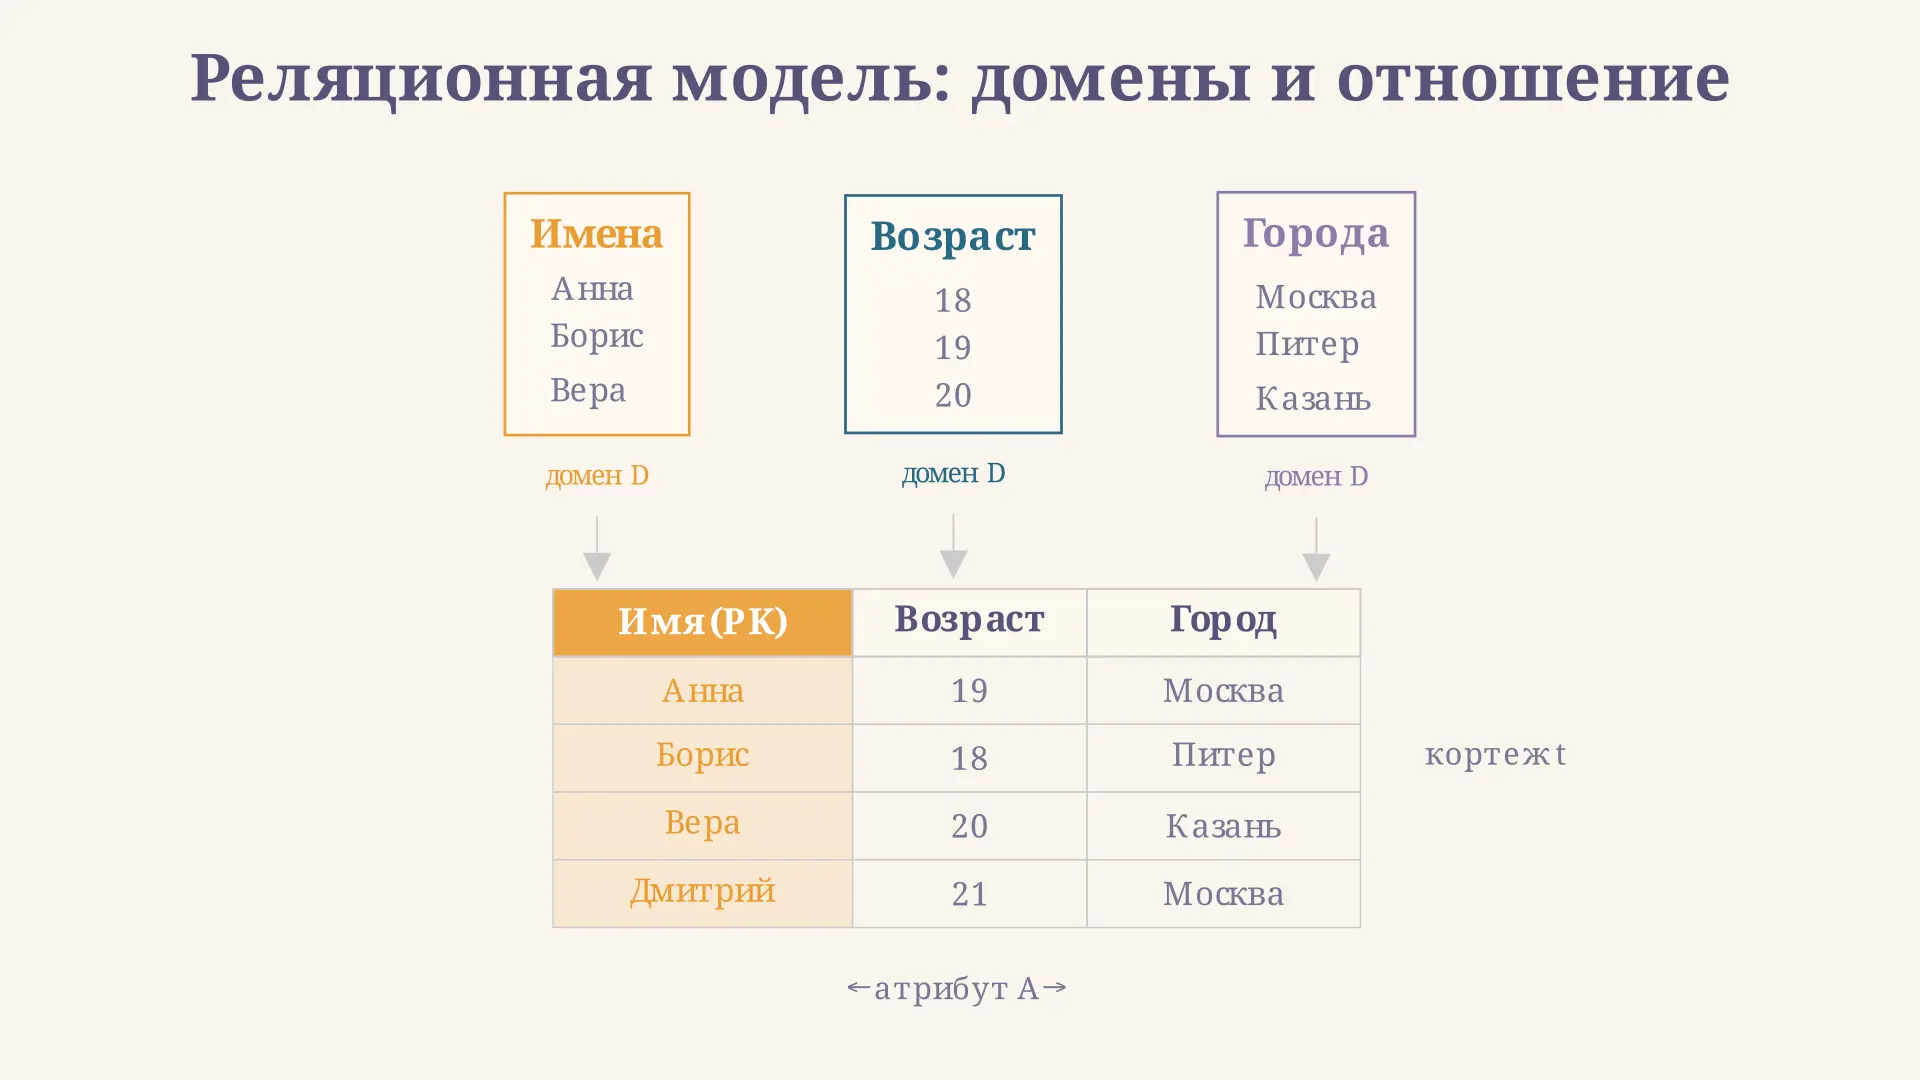
Понятия ключа, кортежа и самого отношения, на которых стоит вся операция, подробно разобраны в статье про реляционную модель данных - здесь мы работаем уже со строками.
Предикат в ON не обязан быть равенством. Соединение по равенству ключей называют эквисоединением, и на практике это почти всегда оно, потому что только для равенства СУБД умеет применять хеш-соединение и поиск по индексу. Но условие вида ON p.дата BETWEEN t.начало AND t.конец тоже законно: так подтягивают тариф, действовавший на момент операции. Если столбцы в обеих таблицах названы одинаково, равенство можно сократить до USING (client_id) - результат тот же, только общий столбец выводится один раз. А вот NATURAL JOIN, который сам ищет совпадающие имена столбцов, в рабочем коде лучше не использовать: добавили в обе таблицы служебную колонку created_at - и запрос молча начал соединять ещё и по ней.
INNER JOIN и внешние соединения: откуда берутся NULL
INNER JOIN возвращает только ядро, то есть совпавшие пары. Внешние соединения ничего из ядра не выбрасывают: они добавляют к нему строки без пары, подставляя NULL во все колонки противоположной таблицы.
- INNER JOIN - четыре строки ядра.
- LEFT JOIN - ядро плюс Сидоров, у которого
o.idиo.суммабудут NULL. - RIGHT JOIN - ядро плюс заказ 105, у которого NULL получат
c.idиc.имя. - FULL JOIN - ядро плюс оба хвоста.
Слово OUTER в LEFT OUTER JOIN необязательно и ничего не меняет, а JOIN без уточнения означает INNER. RIGHT JOIN почти не пишут на практике: он эквивалентен LEFT JOIN с переставленными местами таблицами, а читать запрос слева направо привычнее. FULL JOIN поддерживают PostgreSQL, Oracle и SQL Server, но не MySQL и не SQLite - там его собирают из LEFT и RIGHT через UNION.
Сколько строк вернёт соединение
Число строк результата считается по простой модели. Пусть ключей встречаются в обеих таблицах, на каждый такой ключ приходится строк слева и строк справа, а ещё строк слева и строк справа пары не имеют. Тогда
Для нашего примера , , , , , то есть INNER даст 4 строки, LEFT и RIGHT по 5, FULL - 6.
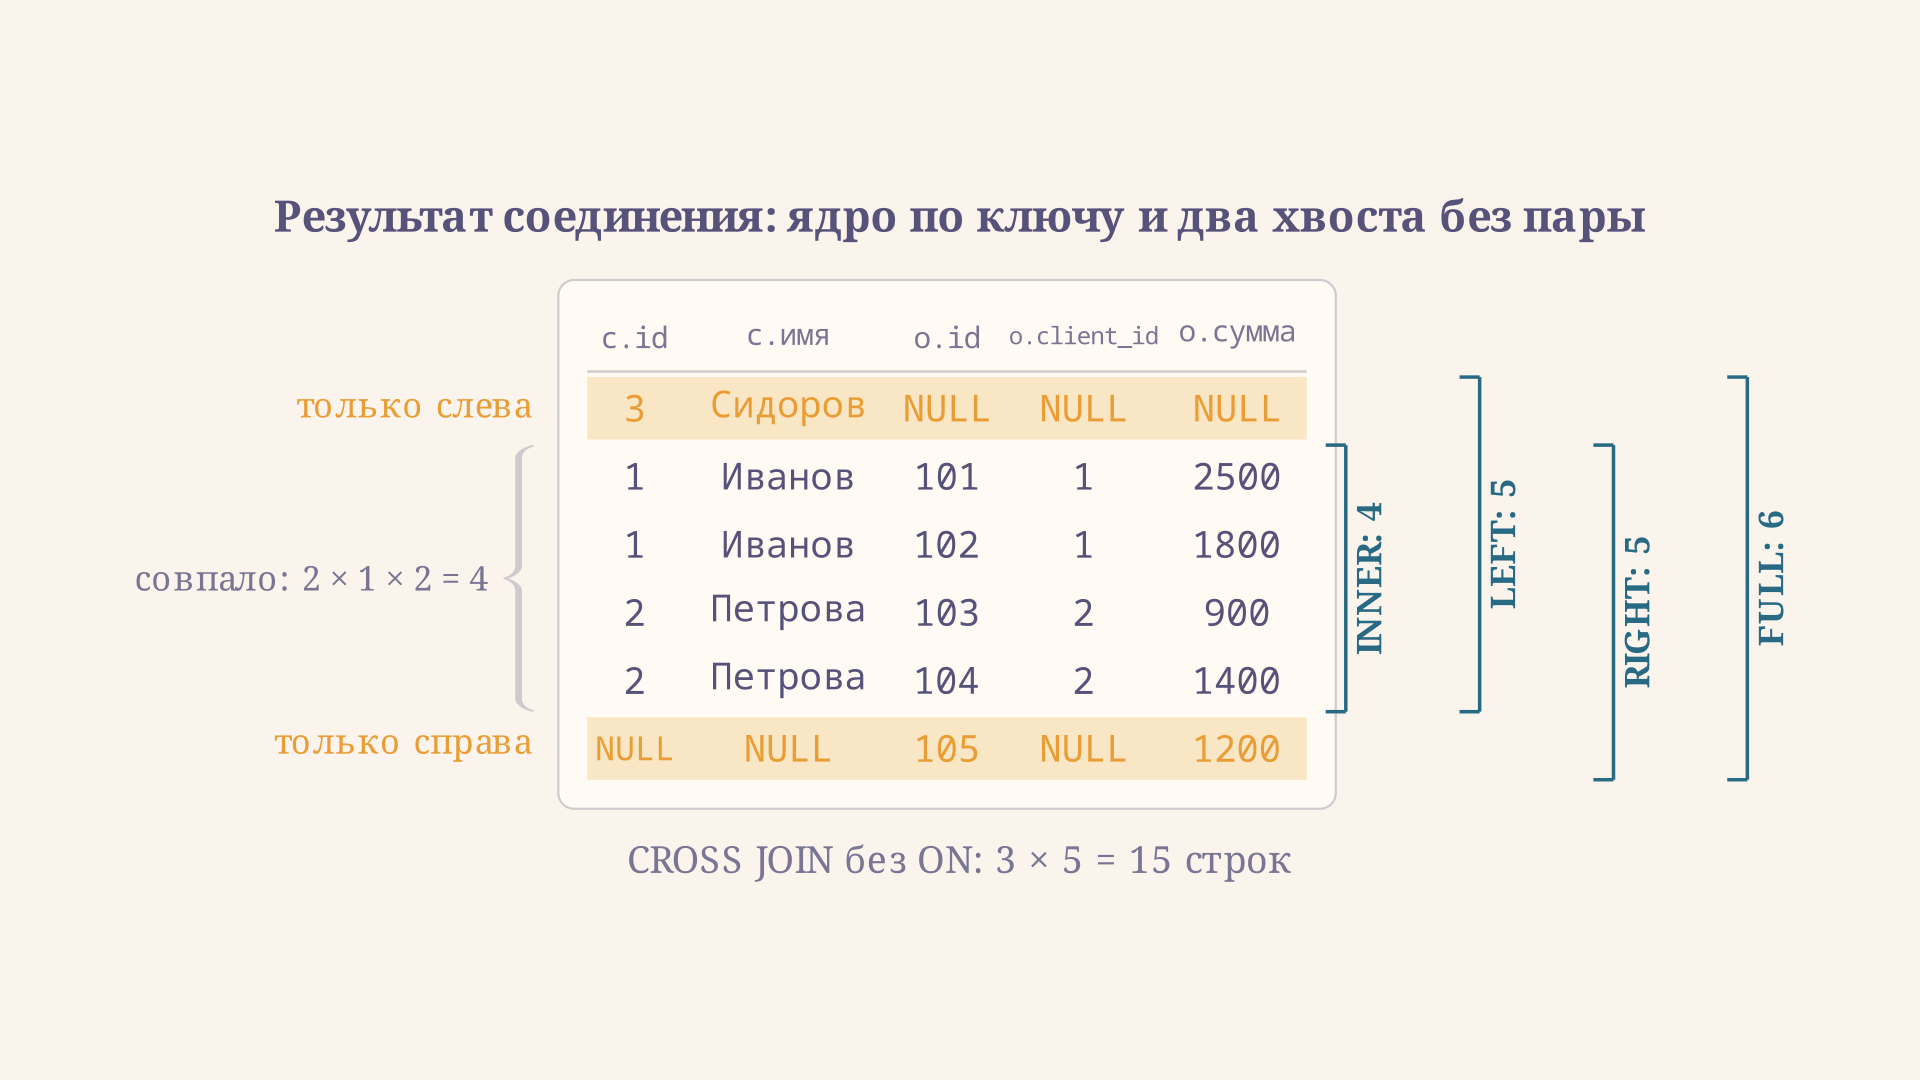
Из формулы видно главное: результат внутреннего соединения может быть и больше, и меньше любой из исходных таблиц. Меньше - если много строк без пары; больше - если на один ключ приходится несколько строк с обеих сторон.
Почему LEFT JOIN ломается от WHERE
Самая частая ошибка с внешним соединением выглядит безобидно. Нужны клиенты с их крупными заказами, включая тех, у кого заказов нет:
SELECT c.имя, o.сумма
FROM clients c
LEFT JOIN orders o ON c.id = o.client_id
WHERE o.сумма > 1000;
Клиентов без заказов в выдаче не будет. Порядок выполнения такой: сначала соединение построит пять строк, включая строку Сидорова с NULL в колонке суммы, а уже потом WHERE применится к результату. Сравнение NULL > 1000 даёт не «ложь», а «неизвестно», и строка отсеивается. Внешнее соединение молча превратилось во внутреннее.
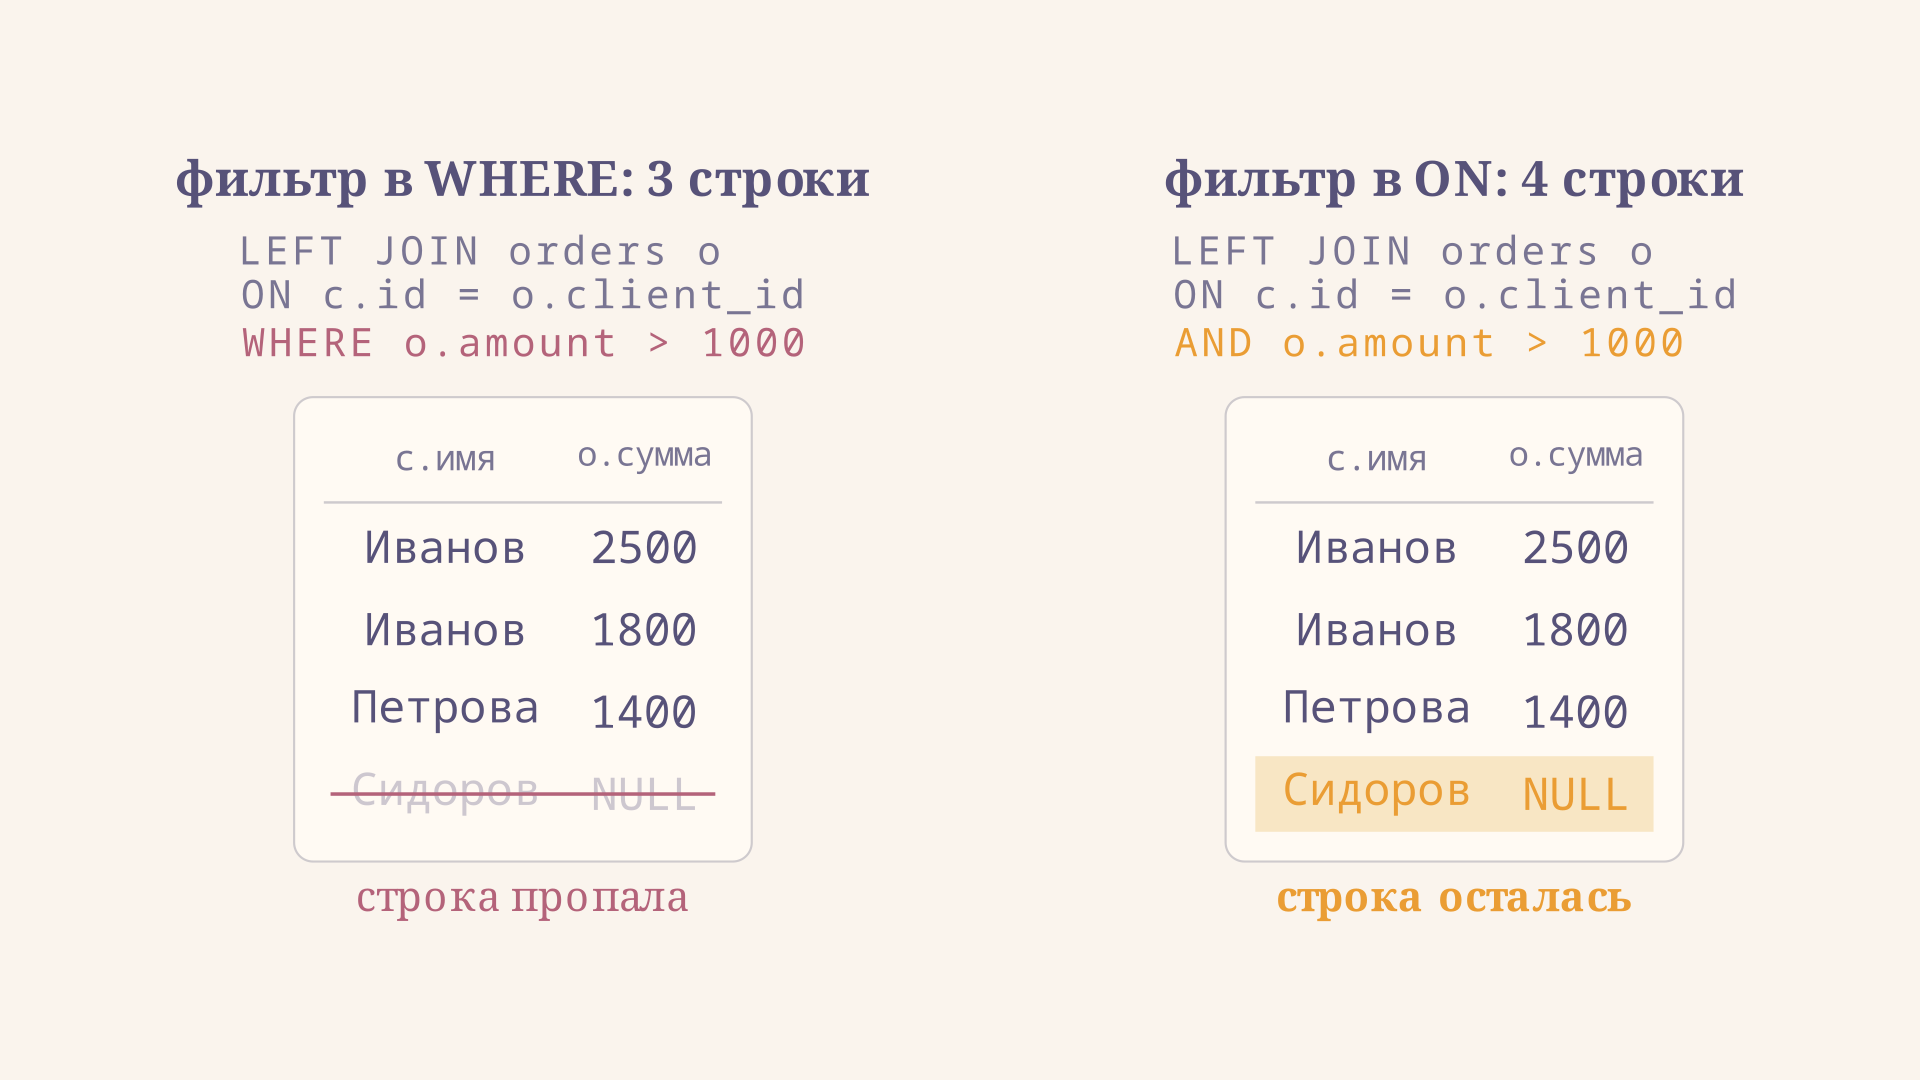
Лечится переносом условия в ON: там фильтр работает до того, как подставятся NULL, поэтому строка без пары уцелеет.
SELECT c.имя, o.сумма
FROM clients c
LEFT JOIN orders o ON c.id = o.client_id AND o.сумма > 1000;
Правило простое: условие на правую таблицу внешнего соединения ставится в ON, условие на левую таблицу можно ставить в WHERE. Исключение - проверка WHERE o.id IS NULL: это идиома «антисоединение», она как раз оставляет только строки без пары и находит клиентов вообще без заказов.
CROSS JOIN: соединение без условия
CROSS JOIN - то самое декартово произведение без фильтра: каждая строка слева склеивается с каждой строкой справа. Для наших таблиц это строк. Операция не бессмысленна: на ней строят календарную сетку «каждый магазин на каждый день месяца», чтобы потом внешним соединением подтянуть продажи и увидеть нули, или разворачивают полный список комбинаций размеров и цветов товара.
Но гораздо чаще CROSS JOIN получают случайно. Старый синтаксис FROM clients c, orders o с забытым условием в WHERE даёт ровно его, и запрос не падает с ошибкой, а честно пытается вернуть произведение. На таблицах по миллиону строк это строк: сервер уходит в своп, а разработчик ищет проблему в индексах. Отсюда практическое правило - писать соединения только явным словом JOIN, тогда пропущенное ON поймает сам парсер.
Self-join: таблица соединяется сама с собой
Соединять можно таблицу с ней же, достаточно дать ей два разных псевдонима. Классический случай - иерархия сотрудников, где руководитель лежит в той же таблице:
SELECT e.name AS сотрудник, m.name AS руководитель
FROM employees e
LEFT JOIN employees m ON m.id = e.manager_id;
Здесь e и m - одна физическая таблица, но для СУБД это два независимых источника строк. LEFT вместо INNER взят не случайно: у директора manager_id равен NULL, и при внутреннем соединении он бы исчез из отчёта. Тем же приёмом ищут дубликаты, сравнивают соседние периоды и строят пары товаров из одной категории.
Размножение строк при связи один ко многим
Соединение не просто дописывает колонки, оно множит строки. Если у клиента два заказа, строка клиента появится в результате дважды. Подключите третью таблицу, где у того же клиента три платежа, и получите строк на одного клиента.
Опасно это тем, что агрегаты считаются уже по размноженному набору: SUM(o.сумма) после присоединения платежей утроится, а COUNT(*) посчитает не заказы, а пары «заказ, платёж». Признак беды - суммы, кратные реальным. Лечится агрегацией до соединения (подзапрос или CTE, который сначала сворачивает заказы до одной строки на клиента) либо COUNT(DISTINCT o.id). Как устроена сама связь и зачем ей индекс по внешнему ключу, разобрано в статье про связь один ко многим.
Частые ошибки
- Фильтр по правой таблице в WHERE при LEFT JOIN. Внешнее соединение превращается во внутреннее. Условие на правую таблицу ставьте в ON.
COUNT(*)после LEFT JOIN. У клиента без заказов получится 1, а не 0, потому что строка с NULL всё равно существует. СчитайтеCOUNT(o.id).- Соединение по столбцу, где есть NULL. Такие строки не совпадают ни с чем, включая другие NULL. Если NULL значит «не задано», отбирайте их отдельно.
- Забытое условие соединения. Старый синтаксис через запятую при пропущенном WHERE даёт CROSS JOIN на всю таблицу.
- Агрегаты поверх нескольких соединений. Суммы завышаются кратно числу строк в третьей таблице; сворачивайте её подзапросом до соединения.
- Соединение по неиндексированному внешнему ключу. Логика верна, но СУБД перебирает таблицу целиком, и запрос деградирует с ростом данных.
FAQ
Чем JOIN отличается от INNER JOIN? Ничем: JOIN - это сокращение, стандарт трактует его как INNER. Явное слово INNER пишут ради читаемости, чтобы в обзоре запроса сразу было видно тип соединения.
Что быстрее, JOIN или подзапрос? Для современных планировщиков разница чаще всего нулевая: PostgreSQL и SQL Server разворачивают коррелированный подзапрос в полусоединение сами. Значение имеют индексы по столбцам из ON и объём промежуточного результата, а не синтаксис. Исключение - подзапрос в списке SELECT, который выполняется для каждой строки выдачи.
Сколько таблиц можно соединить в одном запросе? Технически десятки, но планировщик перебирает порядки соединения и после 8-10 таблиц переходит на эвристику вместо полного перебора. Практический предел читаемости ниже: обычно 4-6 таблиц, дальше запрос разбивают на CTE.
Коротко
Соединение таблиц в SQL - это фильтрация декартова произведения условием ON. Совпавшие по ключу пары образуют ядро результата, и его возвращает INNER JOIN; внешние соединения добавляют к ядру строки без пары, подставляя NULL: LEFT берёт хвост слева, RIGHT справа, FULL оба. Число строк считается как плюс нужные хвосты, поэтому при связи один ко многим результат оказывается длиннее обеих исходных таблиц. Две ловушки стоят отдельно: фильтр по правой таблице в WHERE превращает LEFT JOIN во внутреннее соединение, а размножение строк ломает агрегаты.
Читайте также
Реляционная модель данных: основные понятия
Домен, атрибут, кортеж, схема отношения, ключ и нормальные формы - разбираем реляционную модель данных от азов до практики с примерами и калькулятором.
Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
Как работают агрегатные функции SQL: COUNT, SUM, AVG, MIN и MAX, группировка GROUP BY, порядок выполнения запроса, разница HAVING и WHERE и поведение NULL внутри агрегата.
Хранимые процедуры в базе данных: зачем нужны и как писать
Хранимые процедуры в базе данных простыми словами: что это, синтаксис CREATE PROCEDURE, параметры IN OUT, отличие от функций и триггеров, плюсы и минусы, примеры на SQL.
ACID-свойства транзакций: атомарность и изоляция
Разбираем четыре свойства ACID - атомарность, согласованность, изоляцию и долговечность. Примеры уровней изоляции, аномалий и deadlock в реляционных СУБД.
Транзакции ACID: атомарность, изоляция и надёжность
Разбор четырёх свойств ACID транзакции БД: атомарность, согласованность, изолированность, надёжность. Уровни изоляции, аномалии, COMMIT и ROLLBACK с примерами SQL.
Связь один ко многим в базе данных: схема и SQL
Разбираем связь один ко многим в реляционной БД: как создать таблицы с FOREIGN KEY, написать JOIN-запрос, настроить индекс и избежать типичных ошибок при проектировании.