Стек и очередь: чем LIFO отличается от FIFO
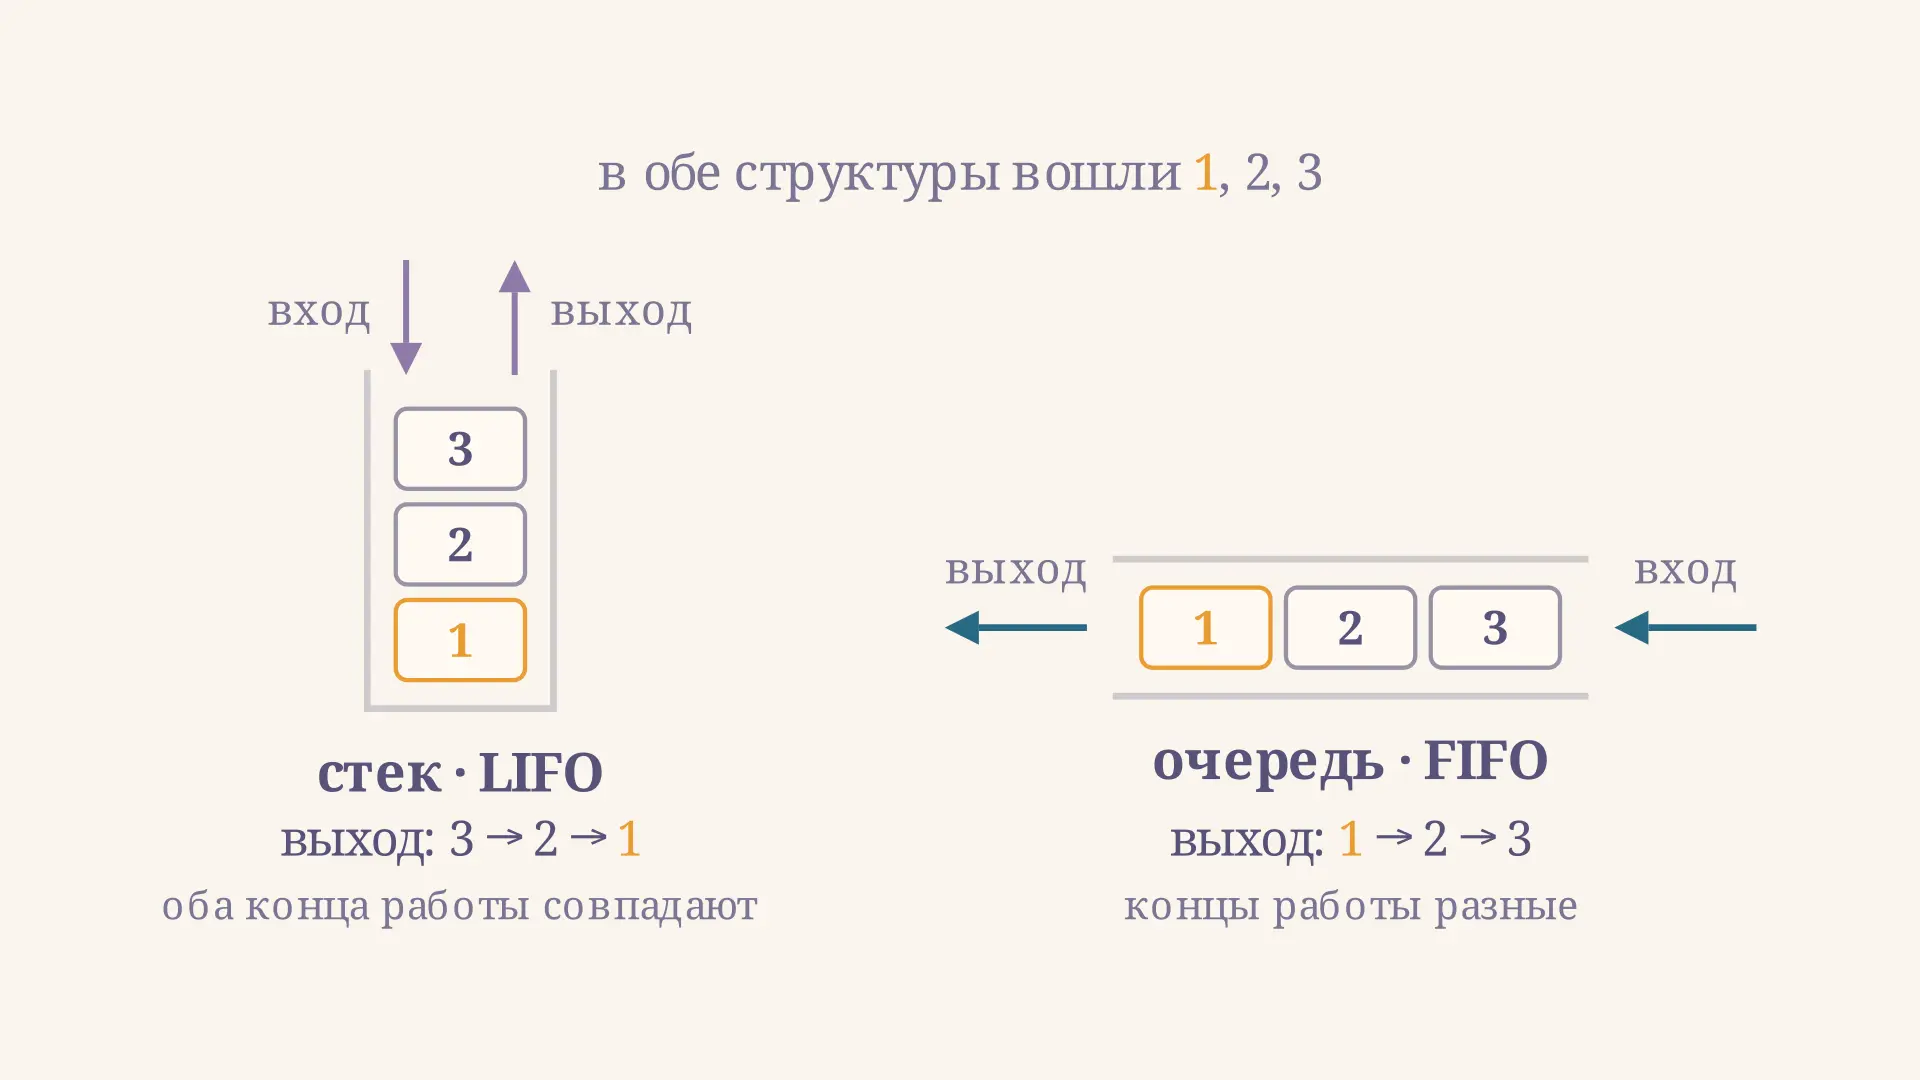
Стек и очередь - две простейшие структуры данных, и набор операций у них почти одинаковый: положить элемент, забрать элемент, посмотреть ближайший, узнать размер. Различаются они ровно одним правилом - какой из уже лежащих элементов считается следующим на выход. Стек отдаёт тот, что положили последним (дисциплина LIFO), очередь - тот, что лежит дольше всех (дисциплина FIFO). Из этого единственного различия вырастает всё остальное: противоположный порядок обработки, разные области применения и разная цена реализации на массиве. Калькулятор ниже показывает порядок выхода для вашей последовательности и считает, во сколько перемещений элементов обходится очередь при разной реализации.
Стек и очередь: одни операции, разная дисциплина доступа
У стека рабочий конец один и называется вершиной: push кладёт элемент на вершину, pop снимает его оттуда же, peek показывает вершину, не снимая. У очереди концов два: enqueue добавляет элемент в хвост, dequeue забирает из головы, front показывает голову. Бытовые аналогии здесь точны: стек - стопка тарелок, из которой берут верхнюю, а очередь - очередь в кассу, где обслуживают того, кто пришёл раньше.
Важно, что обе структуры - это не готовые контейнеры, а именно дисциплины доступа. Физически под ними лежит либо массив, либо связный список, и ни то ни другое не диктуется определением. Разбор того, как устроен стек поверх массива, какие поля нужны и почему push остаётся быстрым при расширении ёмкости, есть в отдельной статье: стек на списке. Здесь же нас интересует пара целиком - чем стек и очередь отличаются друг от друга и когда какую брать.
LIFO и FIFO: один вход, противоположный выход
Самый честный способ увидеть разницу - подать в обе структуры одну и ту же последовательность и посмотреть, что выйдет.
Стек разворачивает последовательность: вход 1, 2, 3, 4 даёт выход 4, 3, 2, 1. Очередь сохраняет порядок: вход 1, 2, 3, 4 даёт выход 1, 2, 3, 4. Отсюда простое правило выбора. Стек нужен там, где надо вернуться к последнему отложенному делу: разобрали вложенную конструкцию - вернулись к внешней; открыли диалог поверх диалога - закрыли верхний. Очередь нужна там, где важен порядок поступления и никого нельзя обогнать: заявки пользователей, пакеты на отправку, задания на печать.
У этого различия есть и оборотная сторона - справедливость. Очередь гарантирует, что элемент не застрянет навсегда: перед ним конечное число других, и он обязательно дождётся. Стек такой гарантии не даёт: при непрерывном потоке новых элементов тот, что лежит на дне, может не дождаться обработки никогда.
Почему наивная очередь на массиве работает за O(n)
Стек на массиве реализуется естественно: и push, и pop работают с последней занятой ячейкой, ничего двигать не нужно, обе операции стоят . С очередью так не выходит. Если сложить элементы в массив подряд и забирать из нулевой ячейки, то после каждого извлечения придётся сдвинуть весь оставшийся хвост на одну позицию влево, иначе голова «уедет» от начала массива. Одно извлечение при этом стоит , а вся серия из элементов обойдётся в
перемещений: записей при добавлении плюс арифметическая прогрессия сдвигов. Квадратичное слагаемое быстро становится главным.
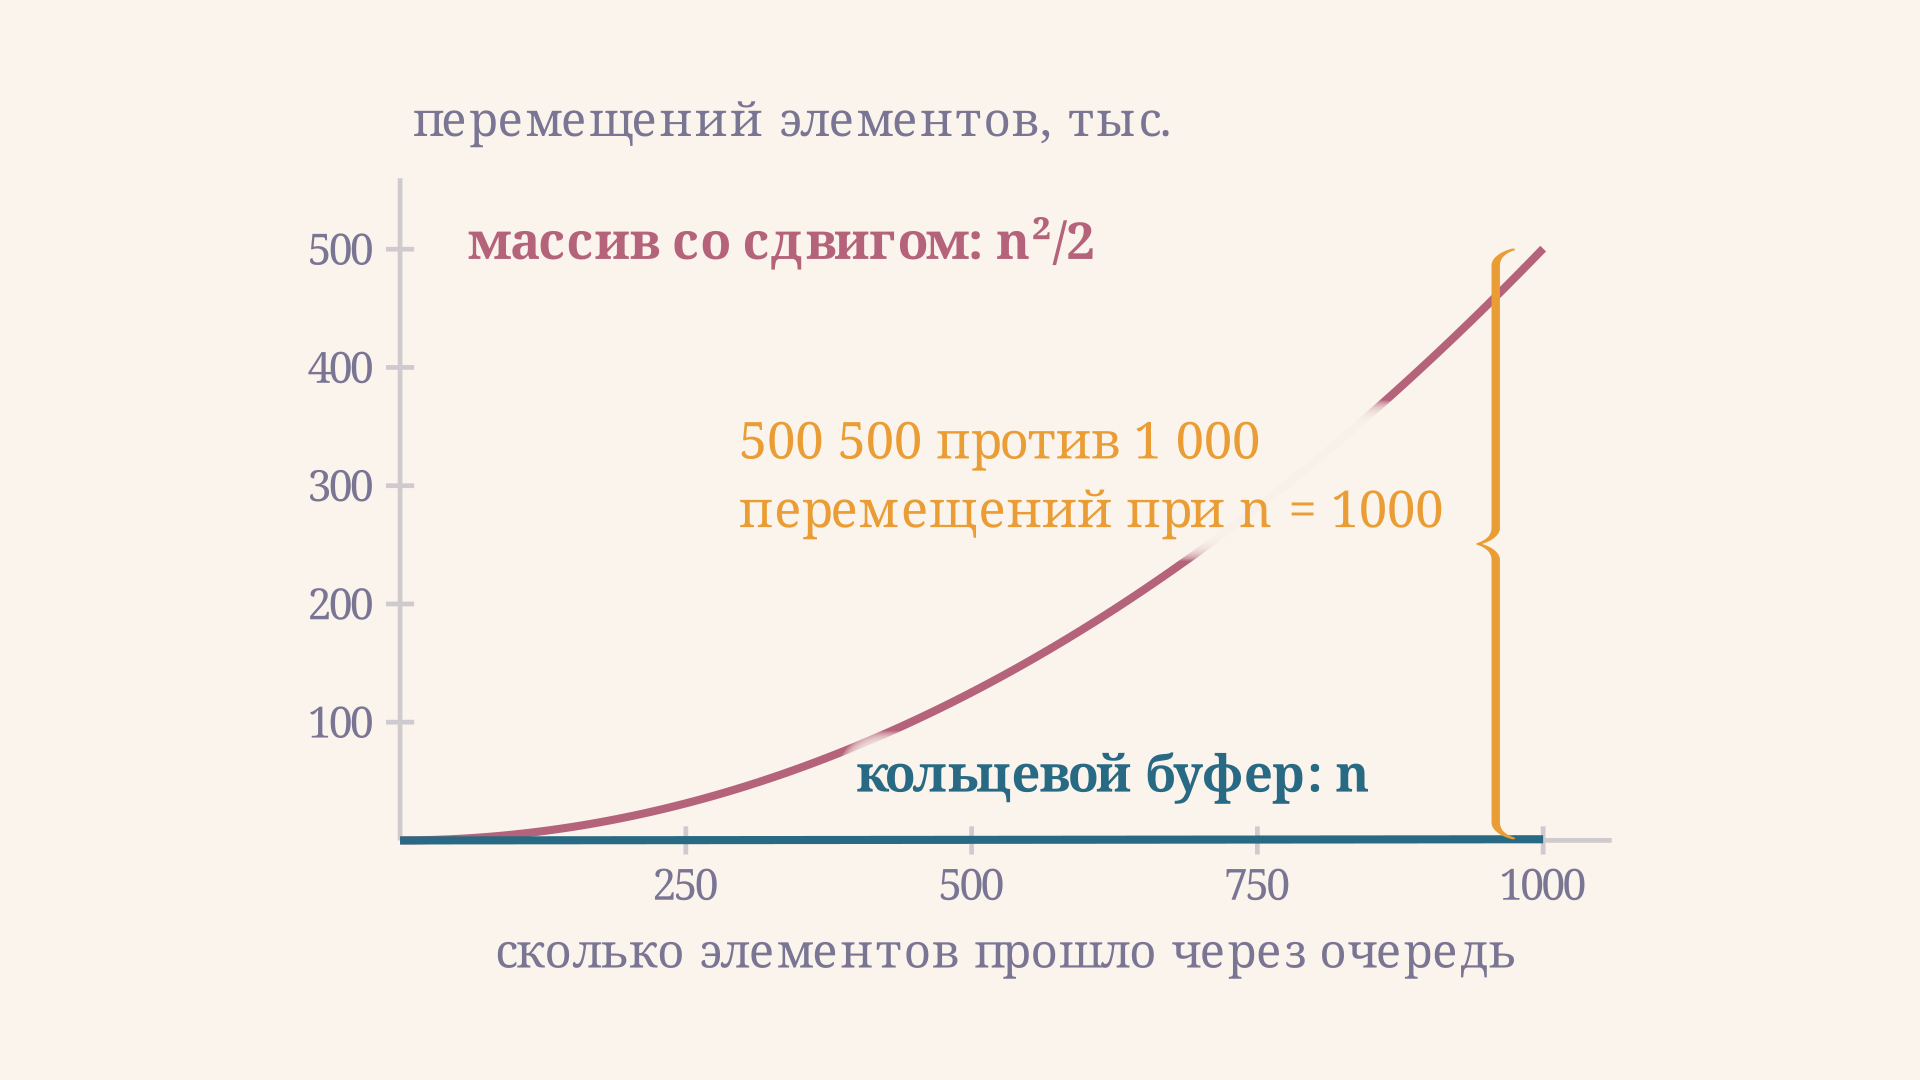
Числа стоит запомнить: на тысяче элементов наивная очередь выполняет 500 500 перемещений против 1000 у нормальной реализации - разница в 500 раз, и она растёт линейно с объёмом. Именно поэтому очередь почти никогда не делают «в лоб» на массиве со сдвигом, хотя стек на массиве - вполне рабочее решение.
Очередь на кольцевом буфере: обе операции за O(1)
Лечится это отказом от сдвига. Вместо того чтобы двигать элементы к началу массива, двигают сами индексы: хранятся два числа, head (откуда читать) и tail (куда писать), и при выходе за границу массива индекс возвращается в начало через остаток от деления на ёмкость :
где и - общее число уже выполненных записей и чтений. Элемент кладётся в ячейку ровно один раз и больше никогда не перемещается, поэтому и enqueue, и dequeue стоят , а память выделяется однократно и не растёт. Плата - фиксированная ёмкость: когда занято все ячеек, буфер либо блокирует запись, либо затирает самый старый элемент. Детали реализации, включая знаменитую неоднозначность состояния при совпадении head и tail, разобраны отдельно: кольцевой буфер.
Вторая рабочая реализация - односвязный список с указателями на голову и хвост. Она тоже даёт на обе операции и не ограничена ёмкостью, но платит памятью: на каждый элемент нужен отдельный узел с указателем, а сами элементы лежат в памяти вразнобой, что заметно хуже для кэша процессора. На практике кольцевой буфер быстрее, список - гибче.
Дек: одна структура вместо двух
Если разрешить работать с обоими концами сразу, получится дек (deque, double ended queue) - структура с четырьмя операциями вместо двух.
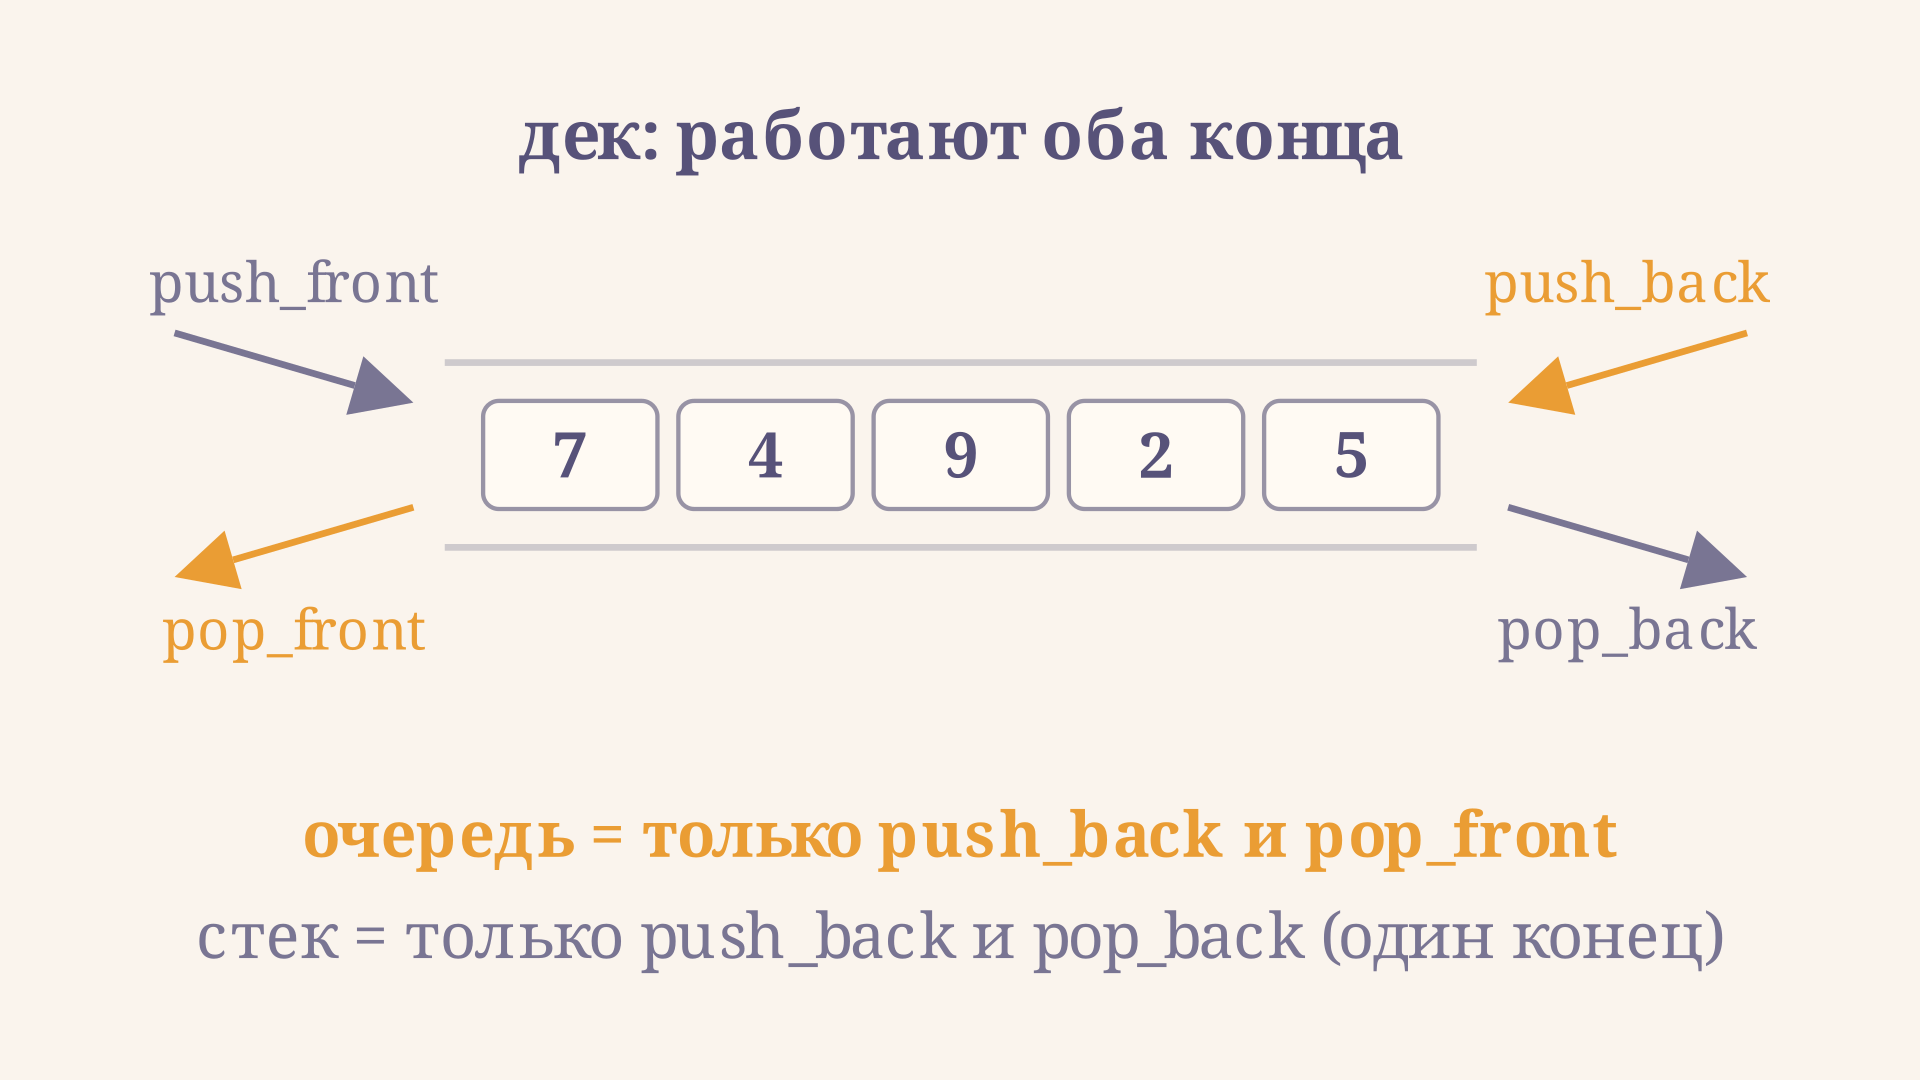
Дек обобщает обе структуры: если пользоваться только парой push_back и pop_back, получится стек; если только парой push_back и pop_front - очередь. Реализуют дек на кольцевом буфере (индексы просто ходят в обе стороны) или на двусвязном списке. Отдельный класс задач, где дек незаменим, - скользящее окно: монотонный дек позволяет находить максимум в окне фиксированной ширины за на шаг, потому что элементы выбрасываются и с головы (вышли из окна), и с хвоста (заведомо хуже нового).
Сложность операций: сводная таблица
| Операция | Стек на массиве | Очередь со сдвигом | Очередь на кольцевом буфере | Дек на двусвязном списке |
|---|---|---|---|---|
| Добавить | амортизированно | |||
| Извлечь | ||||
| Посмотреть ближайший | ||||
| Поиск произвольного элемента | ||||
| Доп. память на элемент | нет | нет | нет | указатели узла |
Строка про поиск здесь не формальность: ни стек, ни очередь не умеют искать и обращаться по индексу - это принципиальное ограничение обеих структур, а не недоработка реализации. Как только в задаче требуется «достать элемент из середины», значит, нужна не очередь, а массив, дерево или хеш-таблица.
Где встречаются стек и очередь
Стек вызовов - самый массовый пример: при каждом вызове функции на него кладётся кадр с локальными переменными и адресом возврата, при выходе кадр снимается. Поэтому рекурсия и есть неявное использование стека, а слишком глубокая рекурсия даёт переполнение стека. По той же причине обход графа в глубину (DFS) пишется либо рекурсивно, либо с явным стеком.
Очередь отвечает за обход в ширину (BFS), который слой за слоем расходится от стартовой вершины и поэтому находит кратчайший путь в невзвешенном графе. Стоит добавить к очереди приоритет, и получится основная структура алгоритма Дейкстры для взвешенного графа. В системном программировании очередь - это планировщик задач, очередь печати и буферизация ввода-вывода: производитель кладёт данные в хвост, потребитель забирает из головы, а согласование их скоростей - классическая задача синхронизации процессов.
Частые ошибки
- Путают, какой конец у очереди рабочий. Добавление идёт в хвост, извлечение - из головы. Если добавлять и забирать с одного конца, получится стек, и порядок обработки молча станет обратным.
- Извлечение из пустой структуры. Pop у пустого стека или dequeue у пустой очереди - это не ноль и не пустая строка, а ошибка (underflow). Размер проверяется до операции, а не после.
- Наивная очередь со сдвигом в горячем цикле. Работает на десятке элементов и разваливается на десятках тысяч: квадратичный рост из формулы выше незаметен на тестовых данных и фатален на боевых.
- Глубокая рекурсия вместо явного стека. Рекурсивный обход на сотнях тысяч вершин переполняет системный стек; тот же алгоритм с явным стеком в куче отрабатывает спокойно.
- Ожидание случайного доступа. Попытка «посмотреть третий элемент снизу» означает, что выбрана не та структура: стек и очередь дают доступ только к своему краю.
FAQ
Чем стек отличается от очереди простыми словами? Порядком выхода при одинаковом порядке входа. Стек отдаёт последний положенный элемент и разворачивает последовательность, очередь отдаёт самый давний и сохраняет порядок. Набор операций и их стоимость при нормальной реализации у обеих структур одинаковы.
Что работает быстрее, стек или очередь? При грамотной реализации обе дают на операцию, так что асимптотически они равны. Разница возникает только из-за реализации: стек на массиве быстр «по умолчанию», а очередь требует либо кольцевого буфера, либо связного списка - иначе извлечение проседает до .
Можно ли сделать очередь из двух стеков? Да, это классический приём: один стек принимает входящие элементы, второй отдаёт. Когда второй пустеет, содержимое первого целиком перекладывается в него и попутно разворачивается - порядок становится FIFO. Каждый элемент перекладывается не больше одного раза, поэтому амортизированная стоимость операции остаётся , хотя отдельное извлечение может стоить .
Коротко
Стек и очередь различаются единственным правилом - какой элемент считается следующим на выход. Стек работает по схеме LIFO, отдаёт последний добавленный элемент и разворачивает последовательность; очередь работает по схеме FIFO, отдаёт самый давний и сохраняет порядок поступления. На массиве стек получается сам собой, а очередь требует кольцевого буфера: наивный сдвиг превращает извлечение в и на тысяче элементов стоит 500 500 перемещений вместо 1000. Дек объединяет обе дисциплины, разрешая работу с двух концов, и обе структуры оказываются его частными случаями. Ни одна из них не умеет искать по содержимому и обращаться по индексу - это цена их простоты и константного времени операций.
Читайте также
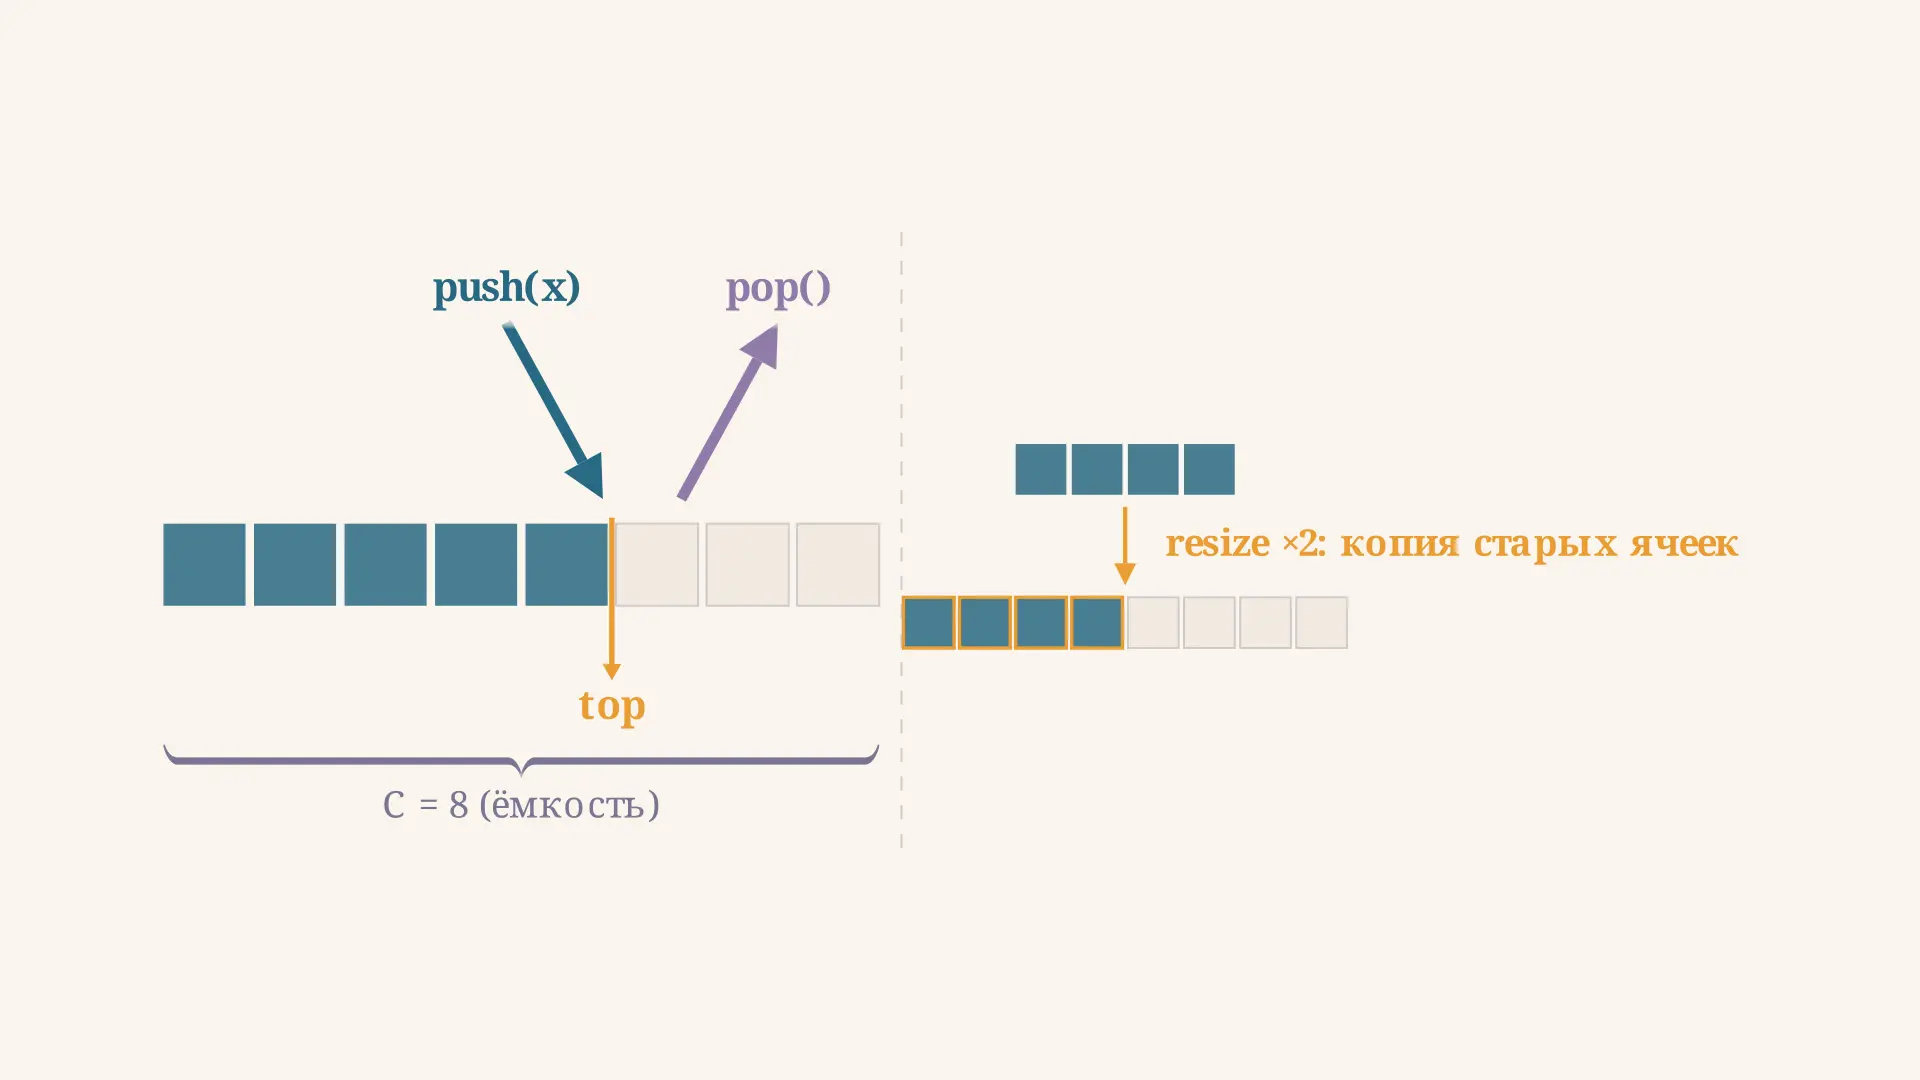
Стек на списке: реализация push и pop через массив
Как реализовать стек на списке: индекс вершины, амортизированная сложность push O(1), расширение массива вдвое при переполнении и почему pop не освобождает память сразу.
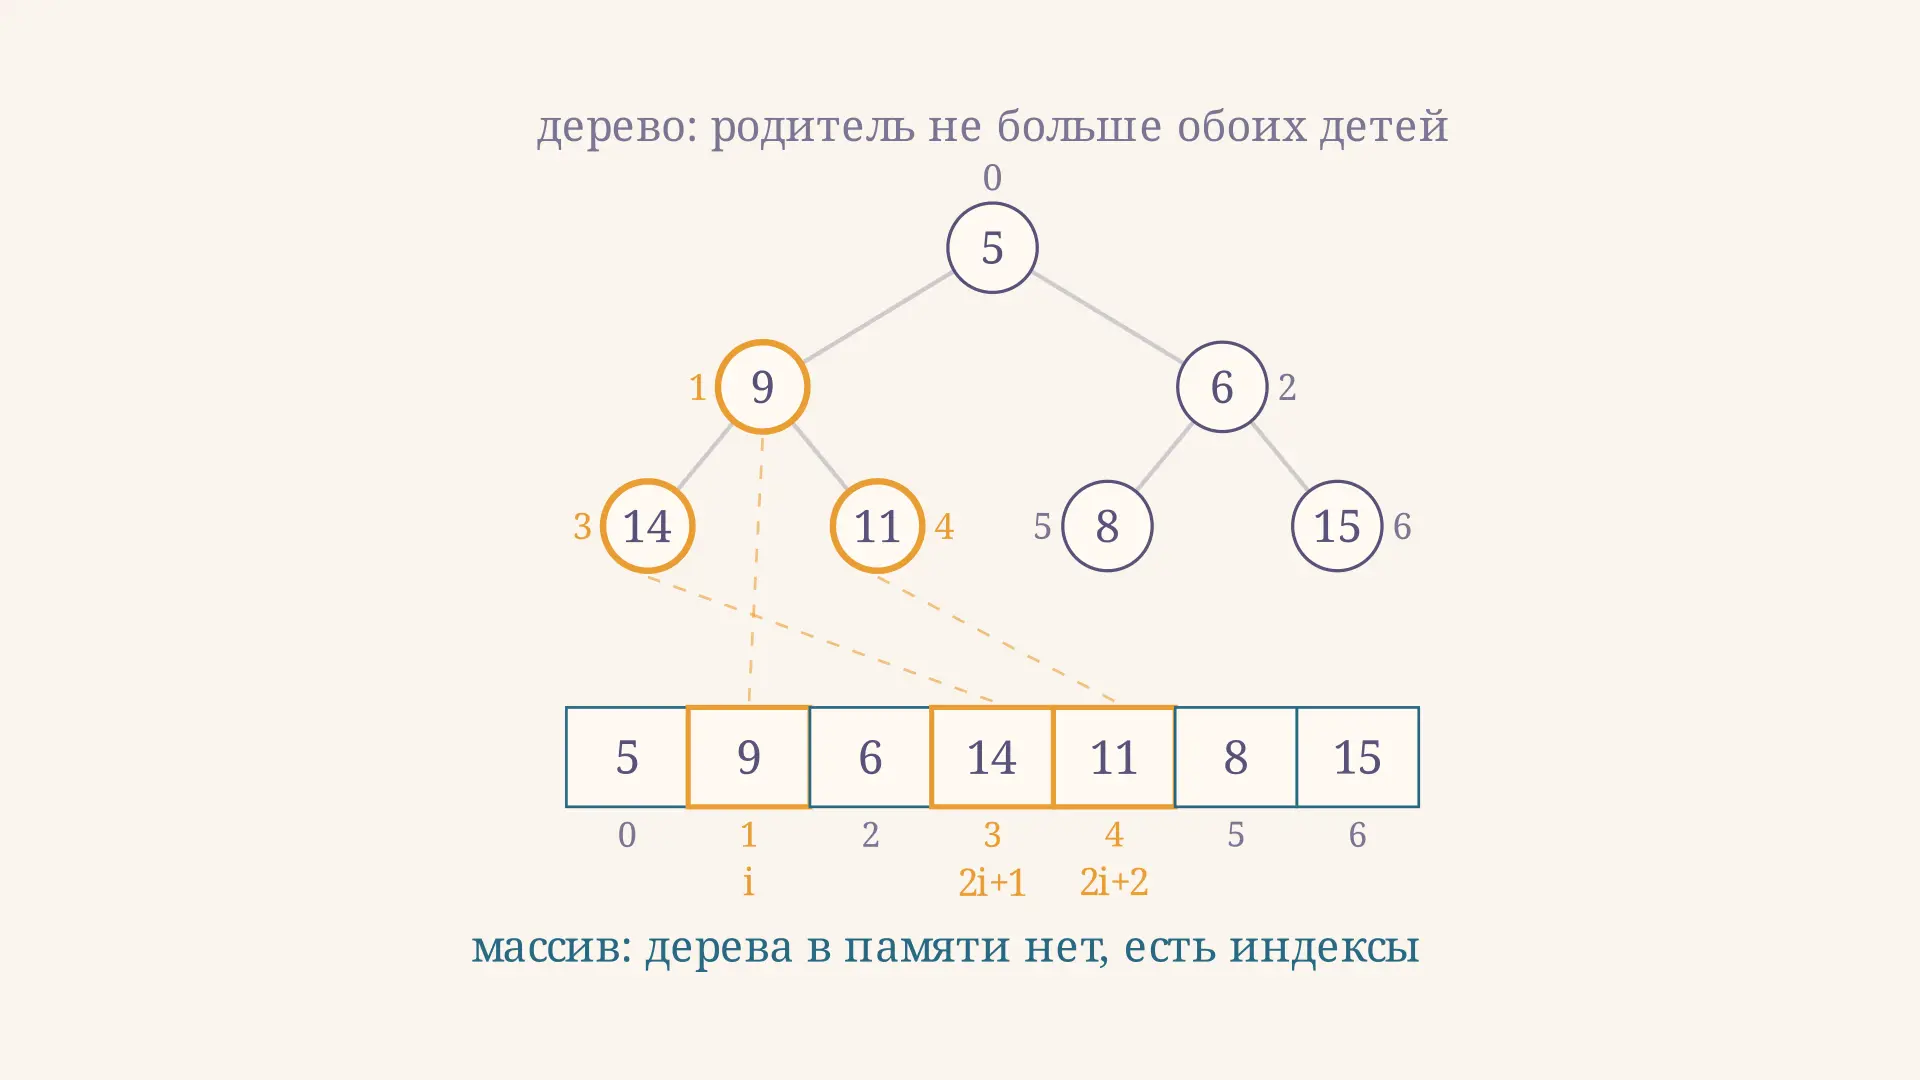
Куча как структура данных: массив и просеивание
Куча как структура данных: свойство кучи, хранение в обычном массиве и индексы 2i+1 и 2i+2, просеивание sift-up и sift-down, построение за O(n) и приоритетная очередь.
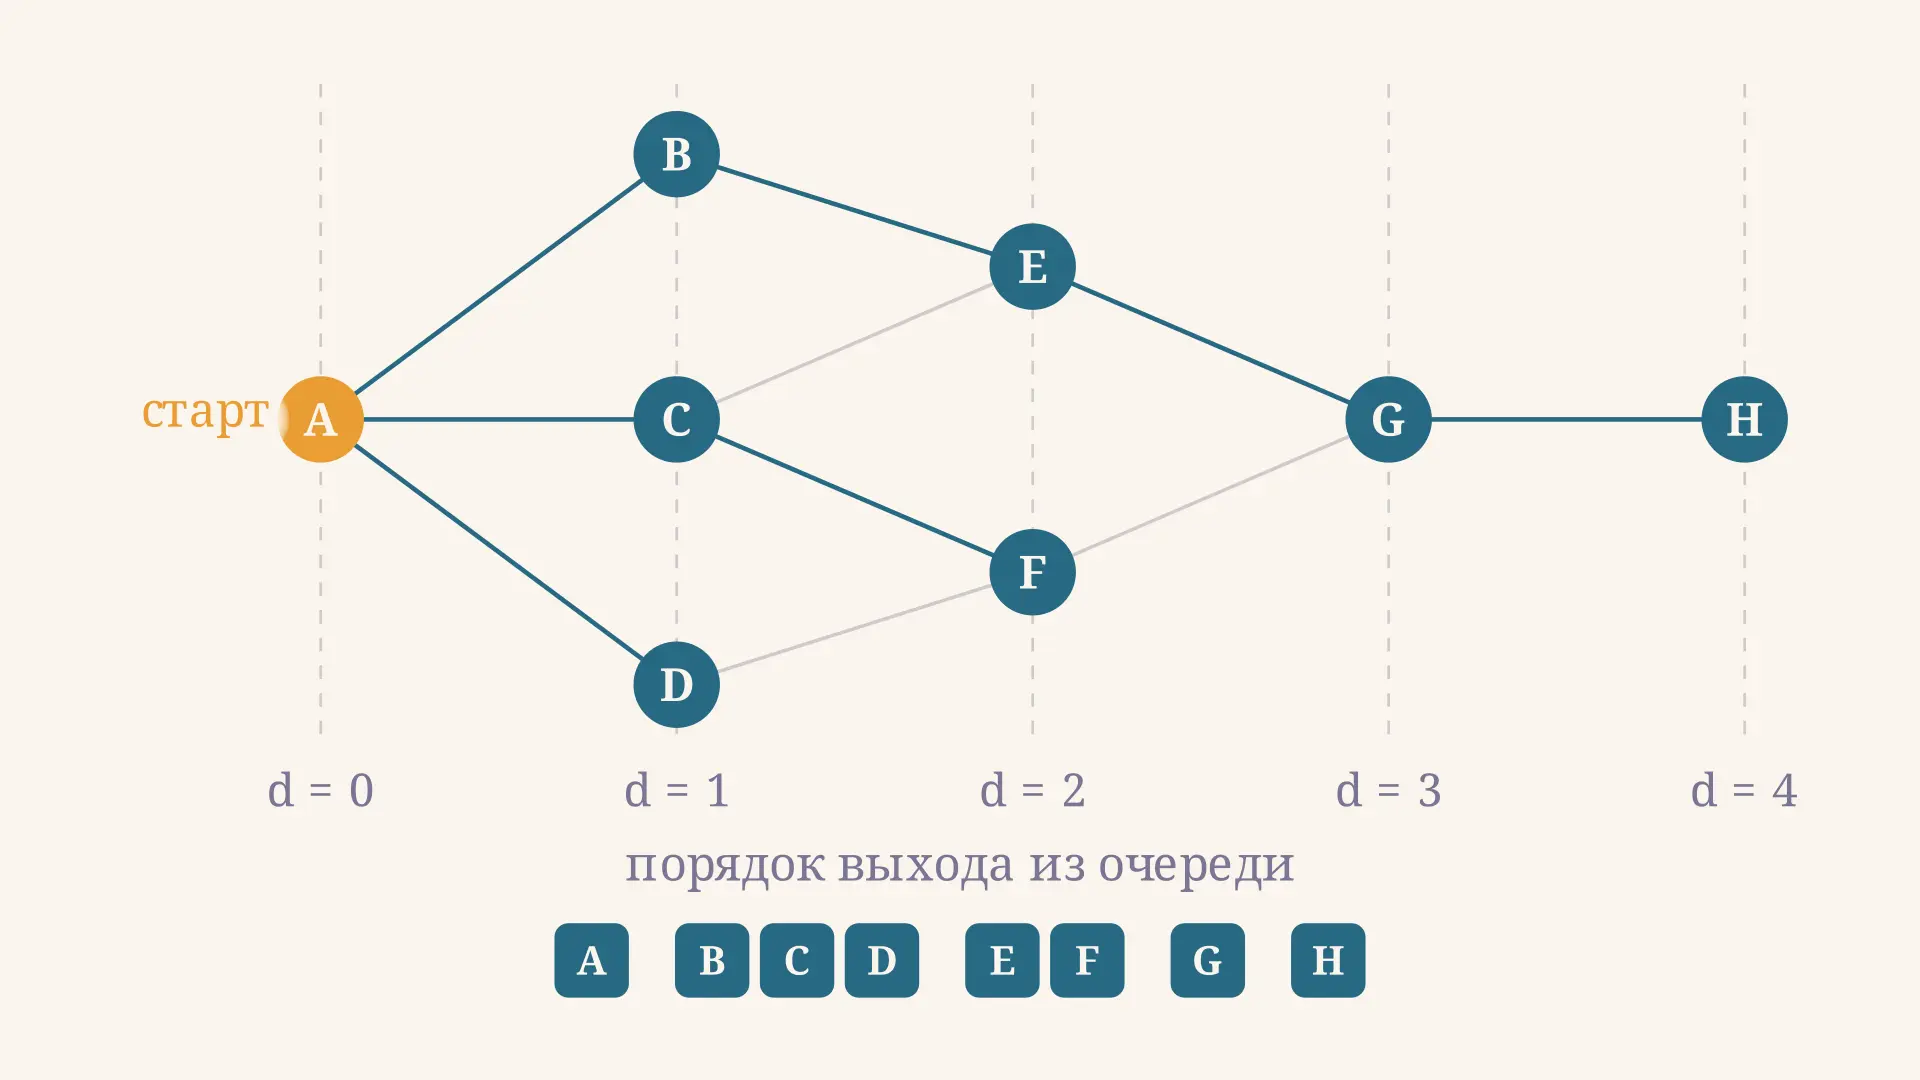
Обход графа в ширину: очередь, слои и кратчайший путь
Обход графа в ширину: как очередь раскладывает вершины по слоям, почему номер слоя равен кратчайшему расстоянию в невзвешенном графе, как восстановить путь по предкам и проверить двудольность.
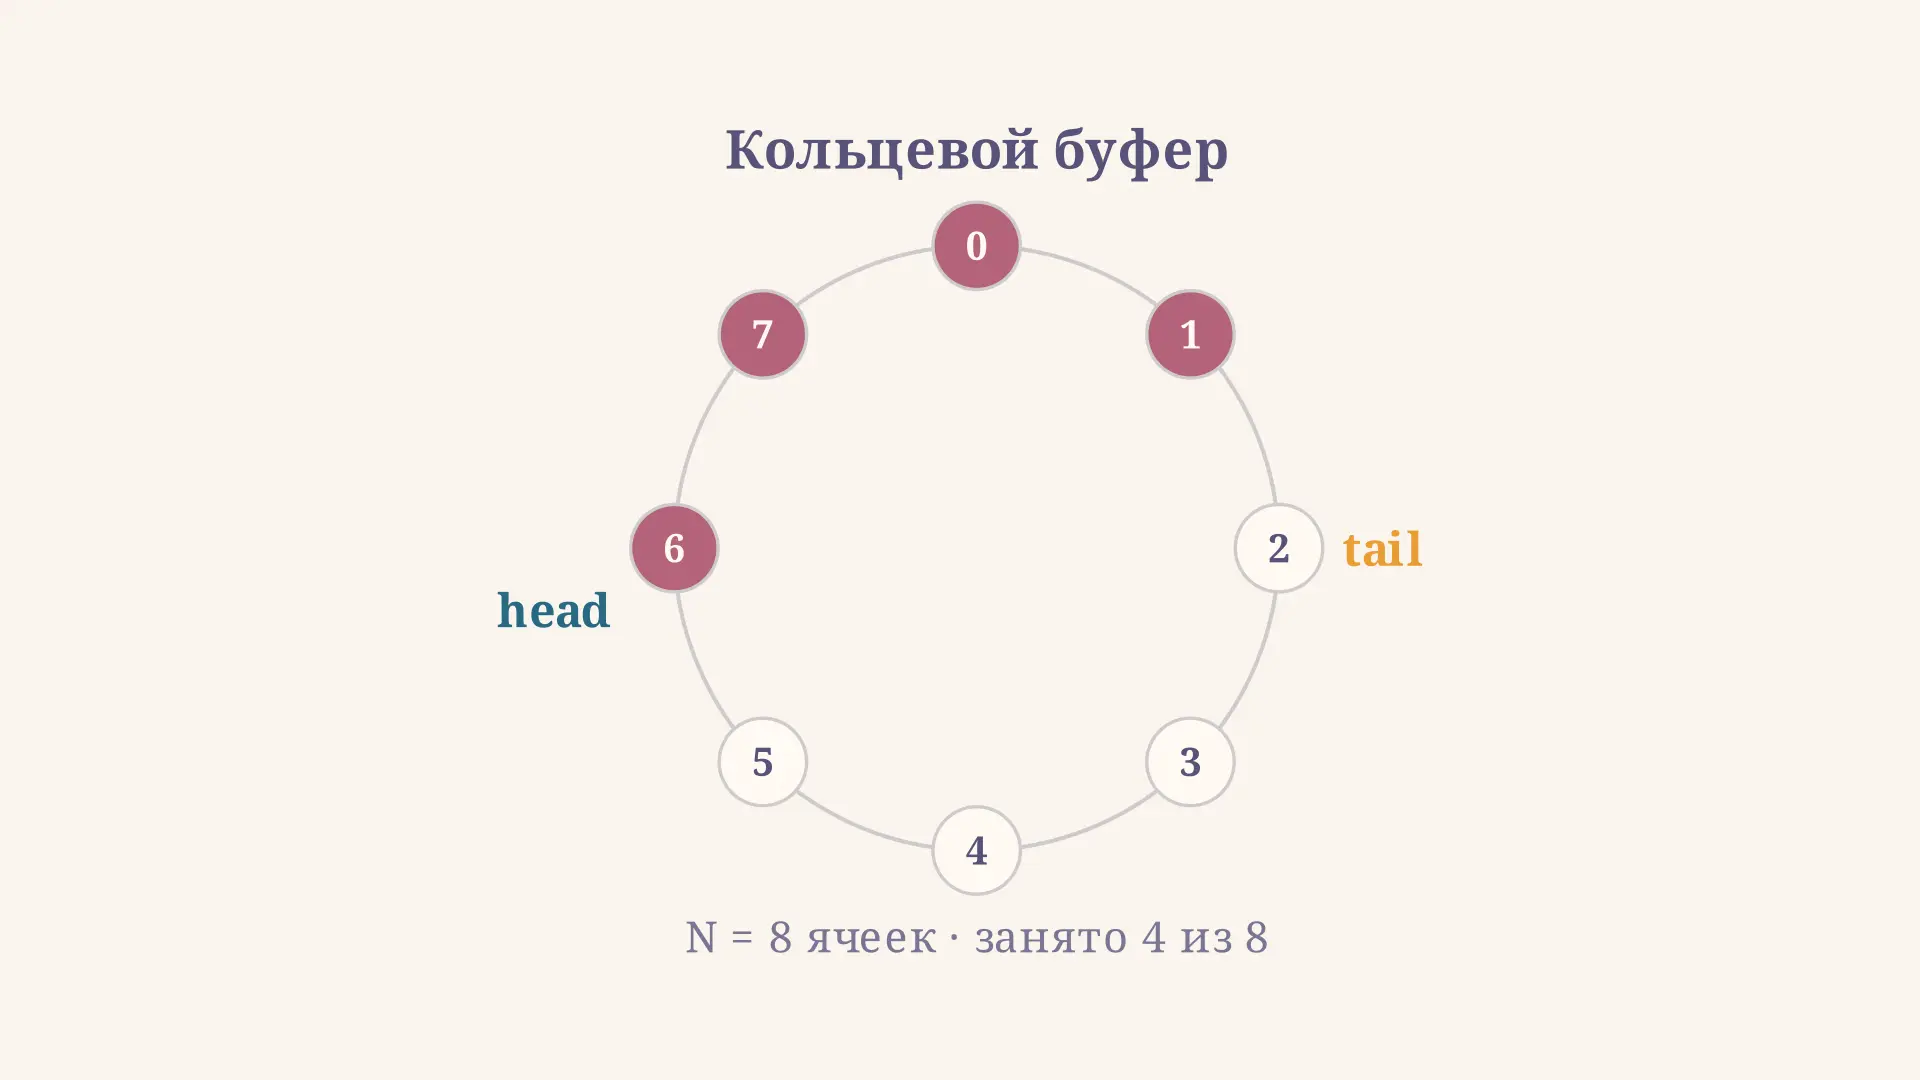
Кольцевой буфер: реализация на массиве и индексах
Как реализовать кольцевой буфер на обычном массиве: индексы head и tail, формулы через остаток от деления, проблема совпадения head и tail и её решение счётчиками операций.
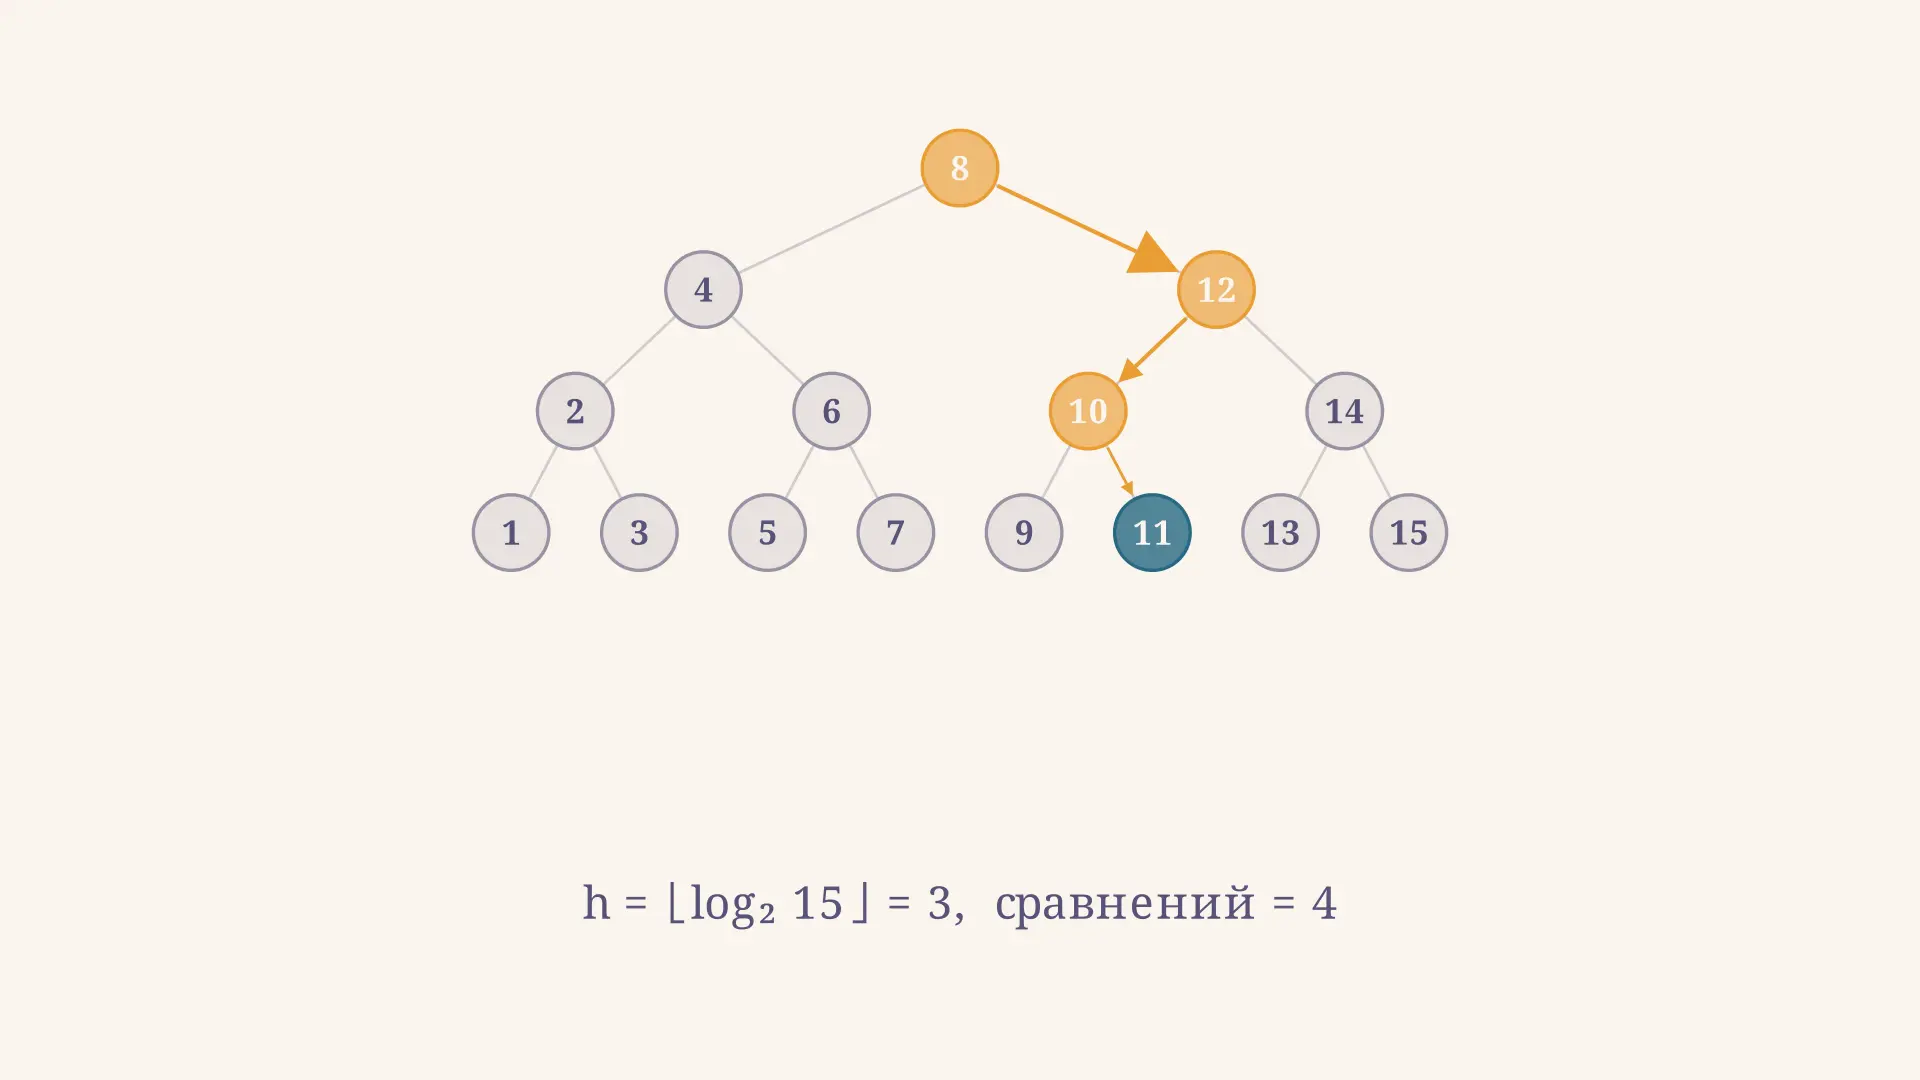
Поиск в двоичном дереве поиска: алгоритм и сложность
Как работает поиск в двоичном дереве поиска (BST): пошаговый алгоритм, число сравнений в среднем и худшем случае, влияние баланса дерева и типичные ошибки в задачах.
Высота и глубина дерева: формулы и примеры
Разбираем высоту и глубину дерева в информатике: точные определения, формулы для полного двоичного и вырожденного дерева, примеры задач и типичные ошибки.