Обход графа в глубину: как работает DFS по шагам
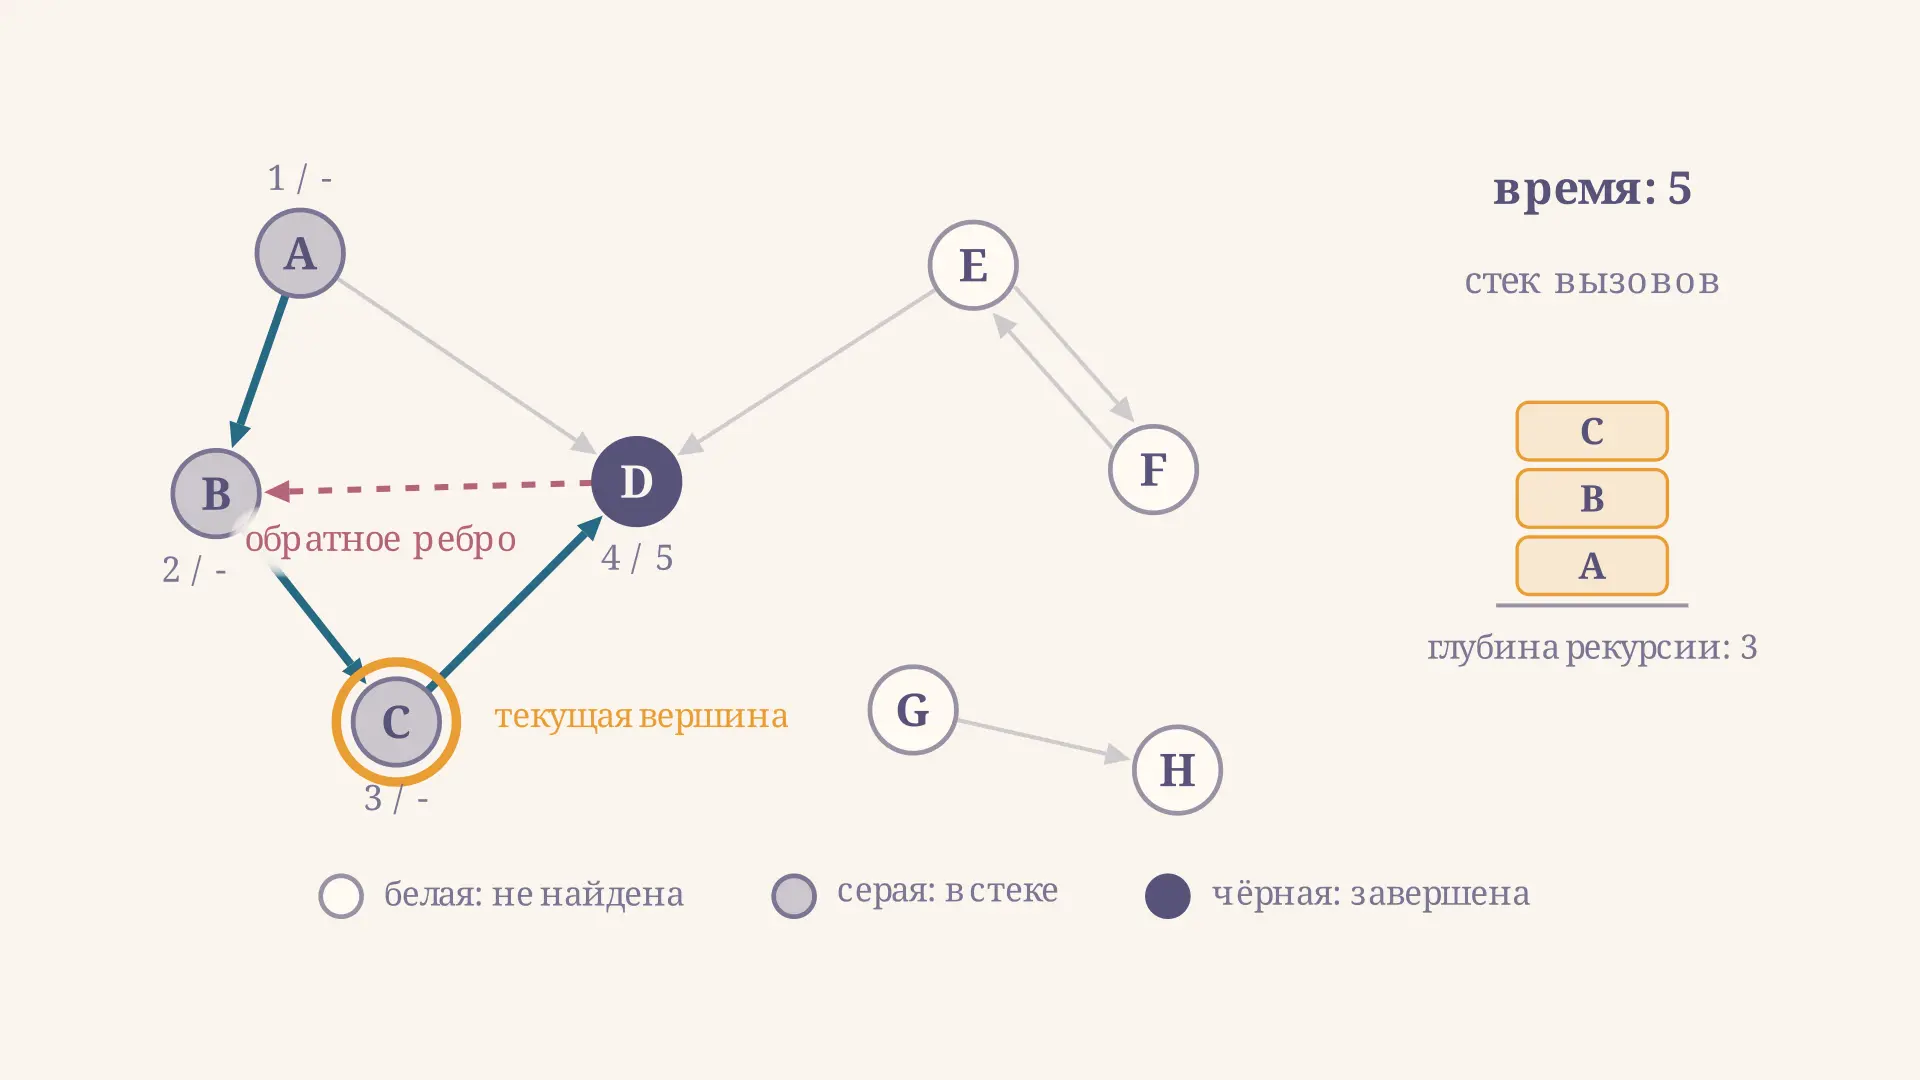
Обход графа в глубину (depth-first search, DFS) перебирает вершины по принципу «иди, пока идётся»: из текущей вершины алгоритм уходит по первому же непройденному ребру как можно дальше и пятится назад только тогда, когда впереди всё уже посещено. Из этой простой дисциплины вырастают почти все структурные алгоритмы на графах: проверка ацикличности, поиск компонент, мосты и точки сочленения, сильно связные компоненты. Разберём обход на одном конкретном графе из восьми вершин и девяти рёбер, а в калькуляторе ниже прокрутите ту же трассировку по шагам.
Что делает обход графа в глубину
Граф задан списками смежности, соседи в каждом списке перебираются по алфавиту:
A: B, D     E: D, F
B: C        F: E
C: D        G: H
D: B
Формально обход в глубину из вершины выглядит так: пометить как найденную, затем для каждого соседа , который ещё не найден, рекурсивно запустить обход из . Когда список соседей закончился, вершина считается завершённой и управление возвращается туда, откуда пришли.
Из вершины алгоритм спускается по цепочке и только там упирается: единственный сосед вершины это , а она уже серая. Вершины закрываются в обратном порядке: , , , . Ключевая особенность обхода в глубину в том, что он не идёт «кольцами» вокруг стартовой вершины, как обход в ширину, а сразу проваливается в одну ветку до упора. Именно поэтому он даёт информацию о структуре графа, а не о расстояниях.
Одного запуска почти никогда не хватает: из недостижимы ни , ни . Поэтому снаружи стоит цикл по всем вершинам, который запускает обход из каждой ещё не найденной. В нашем графе он сработает трижды, и получится лес обхода в глубину из трёх деревьев с корнями , , .
Рекурсия и явный стек: две записи одного алгоритма
Рекурсивная запись занимает шесть строк:
dfs(u):
    color[u] = серый
    for w in adj[u]:
        if color[w] == белый:
            dfs(w)
    color[u] = чёрный
Рекурсия здесь не украшение: стек вызовов интерпретатора хранит ровно текущий путь от корня дерева обхода до активной вершины. Его глубина равна длине этого пути, и в худшем случае (граф-цепочка) она равна числу вершин. Отсюда практическая опасность: на графе из миллиона вершин рекурсивный DFS почти наверняка упадёт с переполнением стека, и обход переписывают через явный стек - ту же структуру «последним пришёл, первым вышел», только в своей памяти, а не в системной (как устроен стек и его операции).
Важная деталь итеративной версии: чтобы получить тот же порядок, что у рекурсии, соседей кладут в стек в обратном порядке, иначе обход пойдёт по последнему соседу вместо первого. И ещё одна: вершину помечают серой в момент снятия со стека, а не в момент добавления, иначе одна и та же вершина попадёт в стек несколько раз.
Три цвета вершин, время входа и время выхода
Стандартная реализация хранит для каждой вершины цвет и две метки времени. Белая вершина ещё не найдена, серая найдена, но её обход не завершён (она лежит в стеке), чёрная завершена полностью. Счётчик времени увеличивается на единицу при каждом событии: ставится при входе, при выходе. Всего событий ровно , поэтому в нашем графе время пробегает значения от 1 до 16.
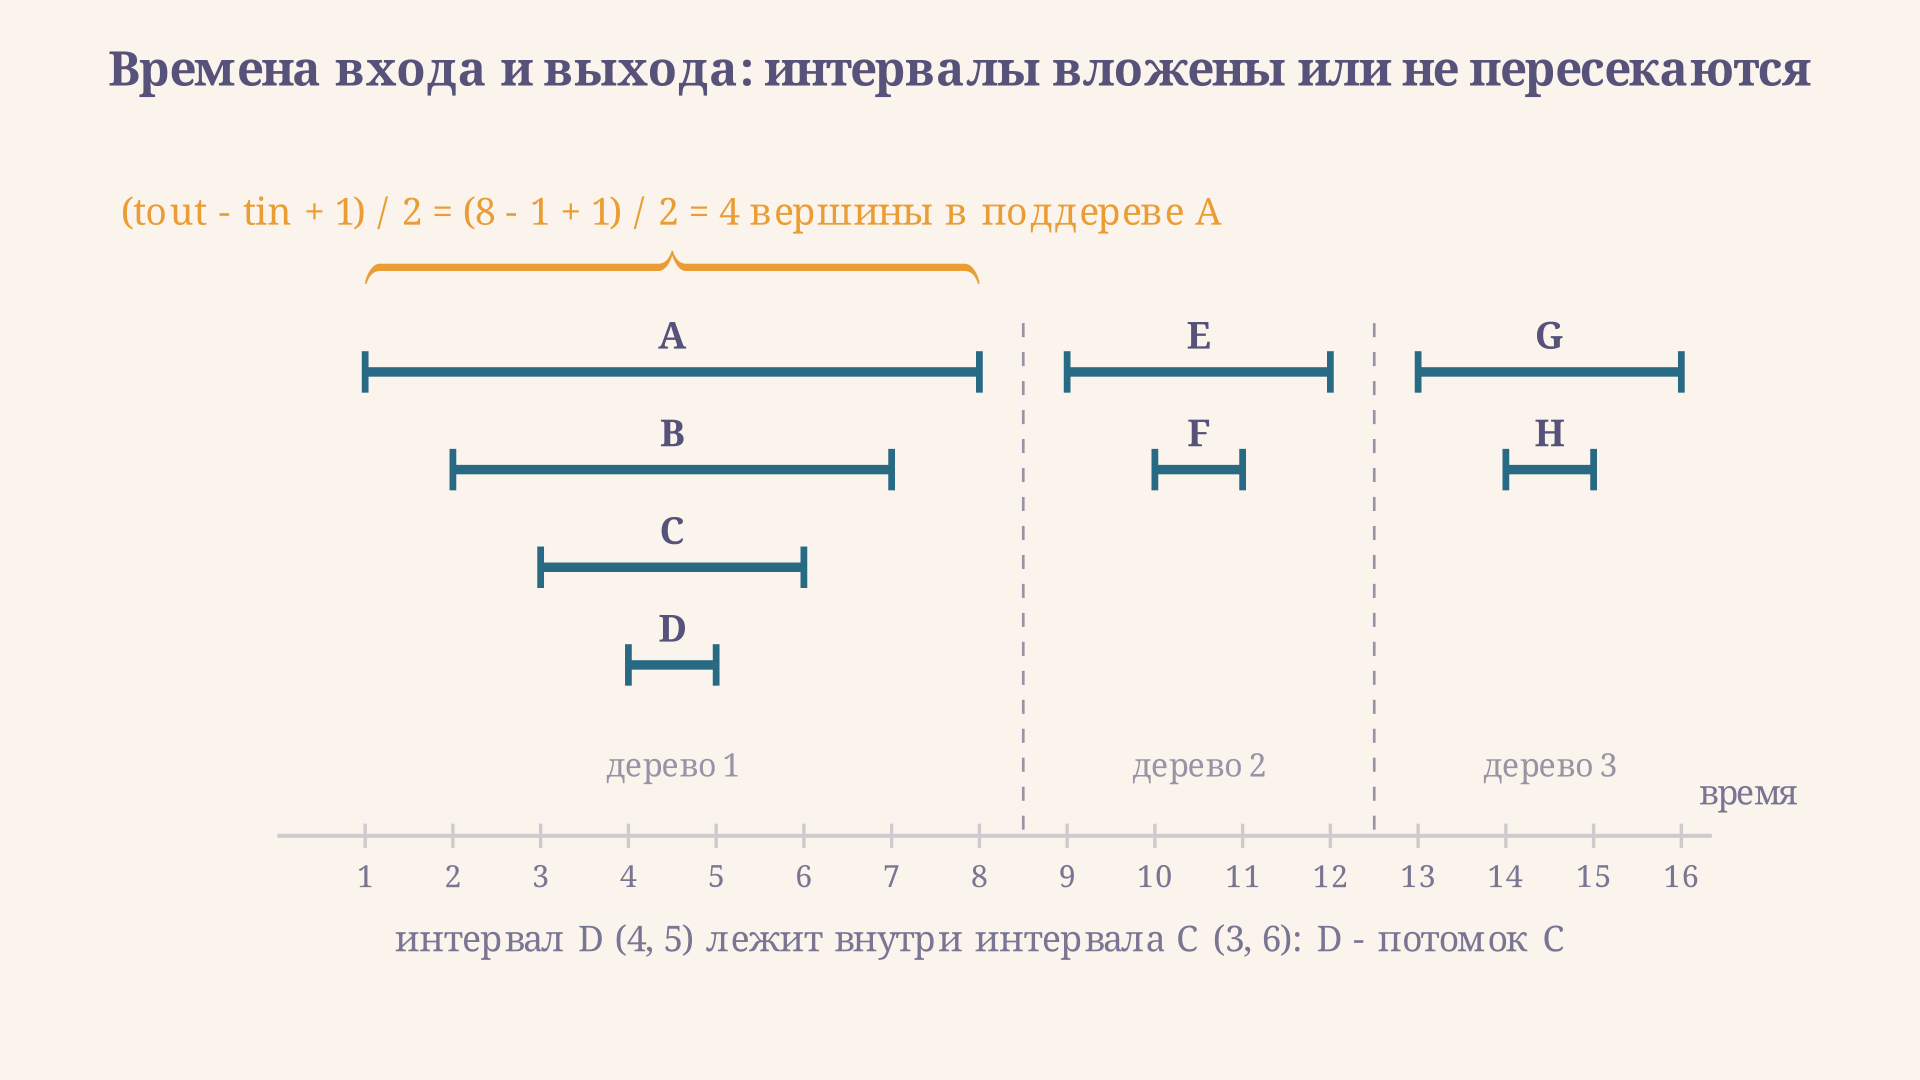
Интервалы подчиняются теореме о скобках: для любых двух вершин интервалы либо вложены один в другой, либо не пересекаются вовсе. Частичного перекрытия не бывает - ровно как у правильно расставленных скобок. Вложенность означает родство: с интервалом лежит внутри с интервалом , значит - потомок в дереве обхода. Непересекающиеся интервалы и говорят, что вершины лежат в разных ветвях или даже в разных деревьях леса.
Из длины интервала бесплатно получается размер поддерева:
Для корня это вершины, и действительно его поддерево - это , , , . Проверка «является ли предком » тоже сводится к одному сравнению: и . На этом приёме держатся запросы к деревьям и методы вроде разбиения на цепочки.
Четыре класса рёбер
Обход в глубину раскладывает все рёбра ориентированного графа на четыре класса. Класс определяется цветом конца ребра в момент, когда алгоритм его рассматривает.
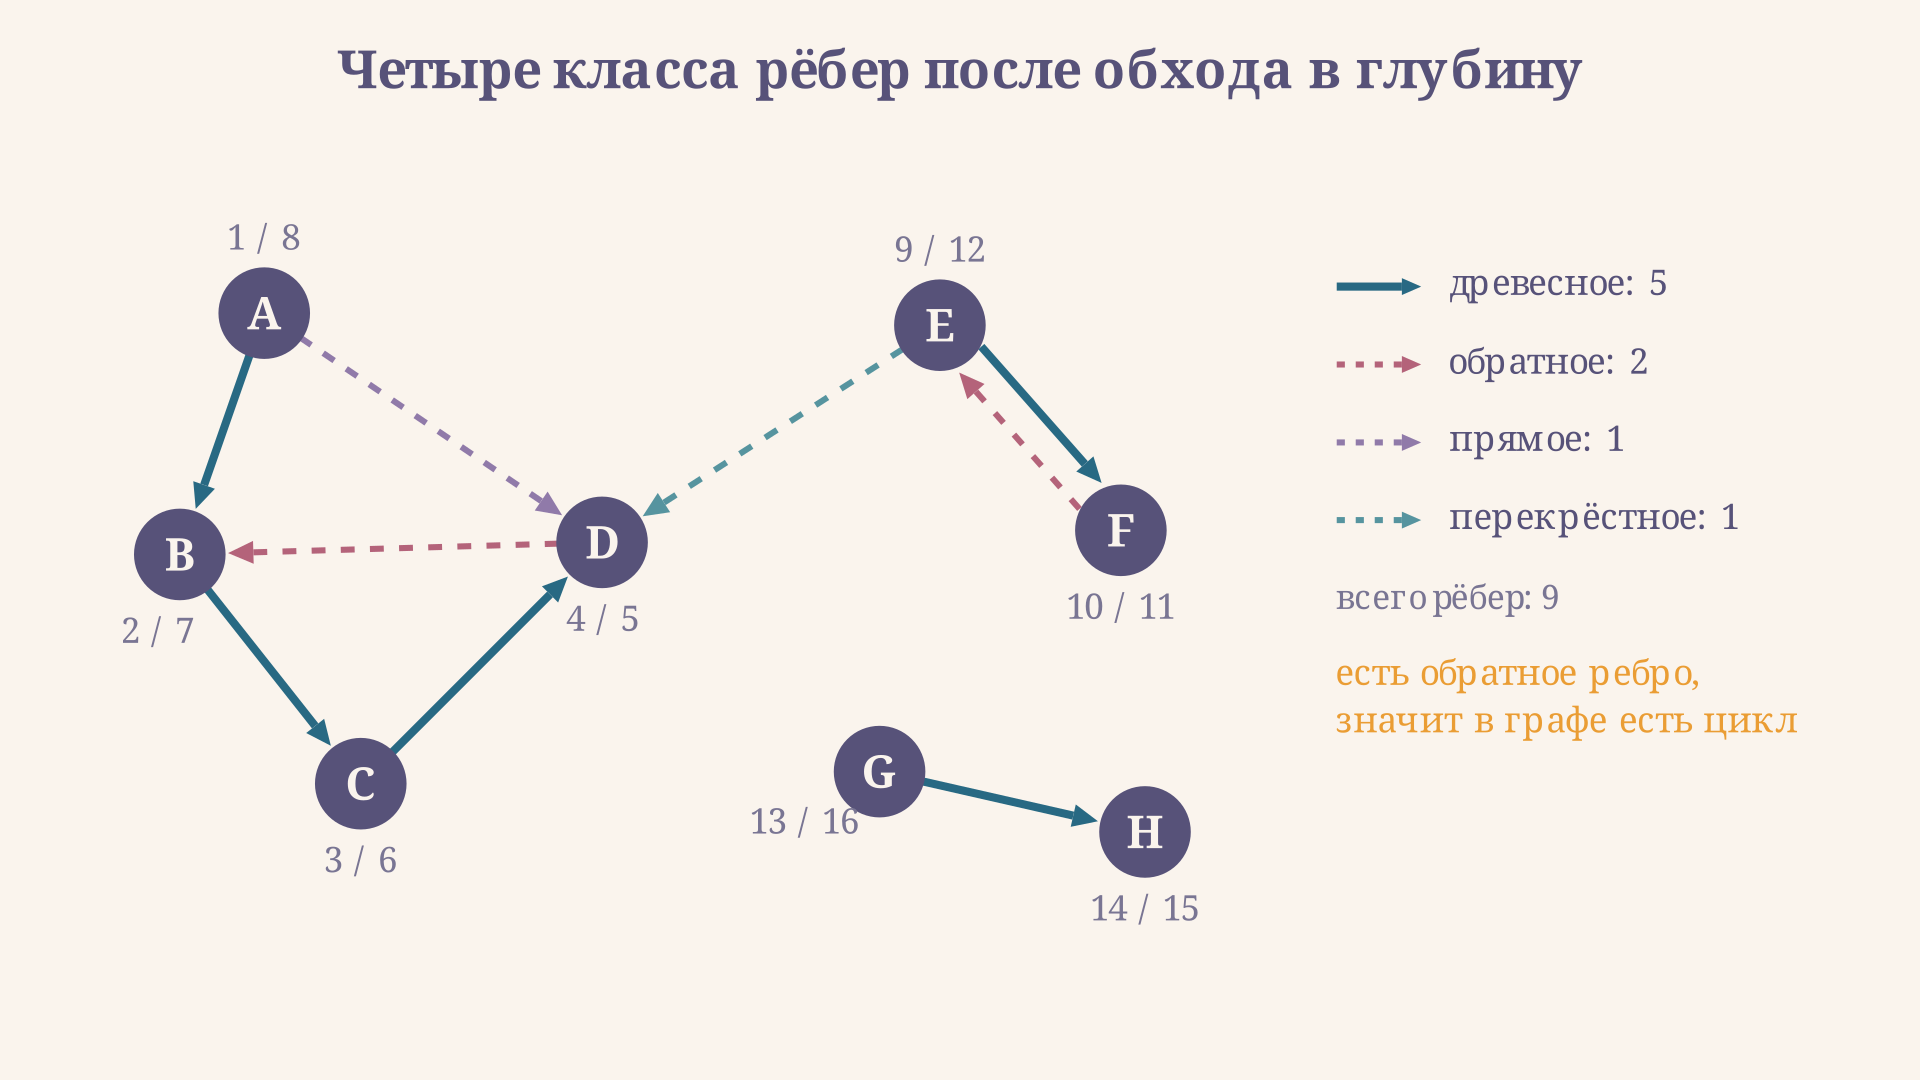
- Древесное: конец белый, по этому ребру обход и уходит вглубь. Таких рёбер ровно минус число деревьев леса, у нас .
- Обратное: конец серый, то есть ребро ведёт в предка, который ещё не завершён. У нас это и .
- Прямое: конец чёрный и является потомком текущей вершины (). Ребро ведёт к уже завершённому потомку.
- Перекрёстное: конец чёрный, но лежит в другой ветке или другом дереве (). Ребро уходит в уже закрытое первое дерево.
В неориентированном графе классов остаётся только два: древесные и обратные. Прямых и перекрёстных там не бывает, потому что каждое ребро рассматривается с обеих сторон, и та сторона, которую алгоритм увидит первой, всегда упрётся либо в белую, либо в серую вершину. Переключите тип графа в калькуляторе выше, чтобы это увидеть: девять ориентированных рёбер превращаются в восемь неориентированных, а классификация схлопывается до шести древесных и двух обратных.
Поиск цикла и компоненты связности
Из классификации сразу следуют два самых частых применения обхода. Третье применение выносится в отдельную задачу: если граф ациклический, порядок выхода из вершин, развёрнутый задом наперёд, даёт топологическую сортировку.
Цикл. Ориентированный граф ацикличен тогда и только тогда, когда обход в глубину не нашёл ни одного обратного ребра. Доказательство в одну сторону очевидно: обратное ребро вместе с путём из в по древесным рёбрам замыкает цикл. В обратную сторону: если цикл есть, то первая вершина цикла, в которую зашёл обход, остаётся серой, пока обход не вернётся к ней по циклу, и ребро в неё окажется обратным. В нашем графе обратных рёбер два, и один из циклов читается прямо со схемы: . Чтобы выписать сам цикл, достаточно запомнить массив предков и подняться по нему от до .
Компоненты. В неориентированном графе каждый запуск обхода из внешнего цикла накрывает ровно одну компоненту связности, поэтому число компонент равно числу запусков. В нашем графе их две: и . В ориентированном случае число деревьев леса зависит от порядка перебора вершин и компонентой не является: там нужны более тонкие схемы вроде алгоритма Тарьяна для сильно связных компонент, который тоже построен на одном проходе обхода в глубину и на временах входа.
Сложность обхода: почему O(V + E)
Каждая вершина становится серой ровно один раз, значит рекурсивный вызов делается раз. Ровно та же оценка выходит и у обхода в ширину: отличаются они порядком посещения и памятью, а не асимптотикой. Каждый список смежности просматривается ровно один раз целиком, значит суммарно рассматривается рёбер (в неориентированном графе каждое ребро попадается дважды, что даёт и ту же асимптотику). Итого:
Для нашего графа это элементарных действий. Оценка линейна именно потому, что граф хранится списками смежности. При хранении матрицей смежности просмотр соседей одной вершины стоит , и обход деградирует до . Память под цвета и времена - , плюс до на стек.
Частые ошибки
- Два цвета вместо трёх. С флагом «посещено» обход всё ещё обойдёт граф, но отличить обратное ребро от прямого или перекрёстного уже не получится, и проверка на цикл сломается: она начнёт находить «цикл» на ациклическом графе , , .
- Пометка при добавлении в стек. В итеративной версии вершину нужно красить в серый при извлечении, иначе она попадёт в стек по каждому входящему ребру и времена собьются.
- Ребро к родителю в неориентированном графе. Его нельзя считать обратным: иначе любое ребро объявит цикл. Пропускают по номеру ребра, а не по имени вершины, иначе кратные рёбра дадут ложный ответ.
- Рекурсия на больших данных. Глубина стека равна длине самого длинного пути в дереве обхода; на цепочке из вершин рекурсия падает. Итеративная версия или увеличенный лимит стека обязательны.
- Вывод о расстояниях. Порядок обхода в глубину ничего не говорит о длине пути: до вершины алгоритм добрался за три шага, хотя есть прямое ребро . Кратчайшие пути ищут другими алгоритмами, например алгоритмом Дейкстры.
FAQ
Чем обход в глубину отличается от обхода в ширину? Дисциплиной хранения ещё не обработанных вершин: в глубину работает стек, в ширину очередь. Отсюда разные результаты: DFS даёт структурную информацию (времена, классификация рёбер, циклы), а обход в ширину - расстояния в рёбрах от старта. Асимптотика у обоих .
Единственный ли порядок обхода у графа? Нет. Он зависит от стартовой вершины и от порядка соседей в списках смежности. Времена входа и выхода, число деревьев в лесу и даже классы отдельных рёбер меняются - в калькуляторе выше это видно при смене старта. Неизменным остаётся факт наличия или отсутствия обратных рёбер, то есть ответ про ацикличность.
Зачем нужны времена выхода, если вход уже всё нумерует? Времена выхода несут информацию о завершённости поддерева. Через них проверяется родство вершин, считается размер поддерева и строится порядок, обратный к порядку выхода. На временах выхода держится и разбор орграфа на сильно связные компоненты.
Коротко
Обход графа в глубину идёт по рёбрам вглубь до упора и возвращается по стеку вызовов, храня для каждой вершины цвет и пару меток времени и . Интервалы времени вкладываются друг в друга как скобки, из чего мгновенно читаются родство вершин и размеры поддеревьев. Рёбра распадаются на древесные, обратные, прямые и перекрёстные, причём наличие обратного ребра равносильно наличию цикла, а число запусков внешнего цикла в неориентированном графе равно числу компонент связности. Всё это обходится в при хранении графа списками смежности.
Читайте также
Алгоритм Тарьяна: поиск компонент связности орграфа
Алгоритм Тарьяна находит сильно связные компоненты орграфа за один проход DFS. Разбираем идею с disc и low, псевдокод и пример, чтобы вы научились раскладывать граф на SCC.
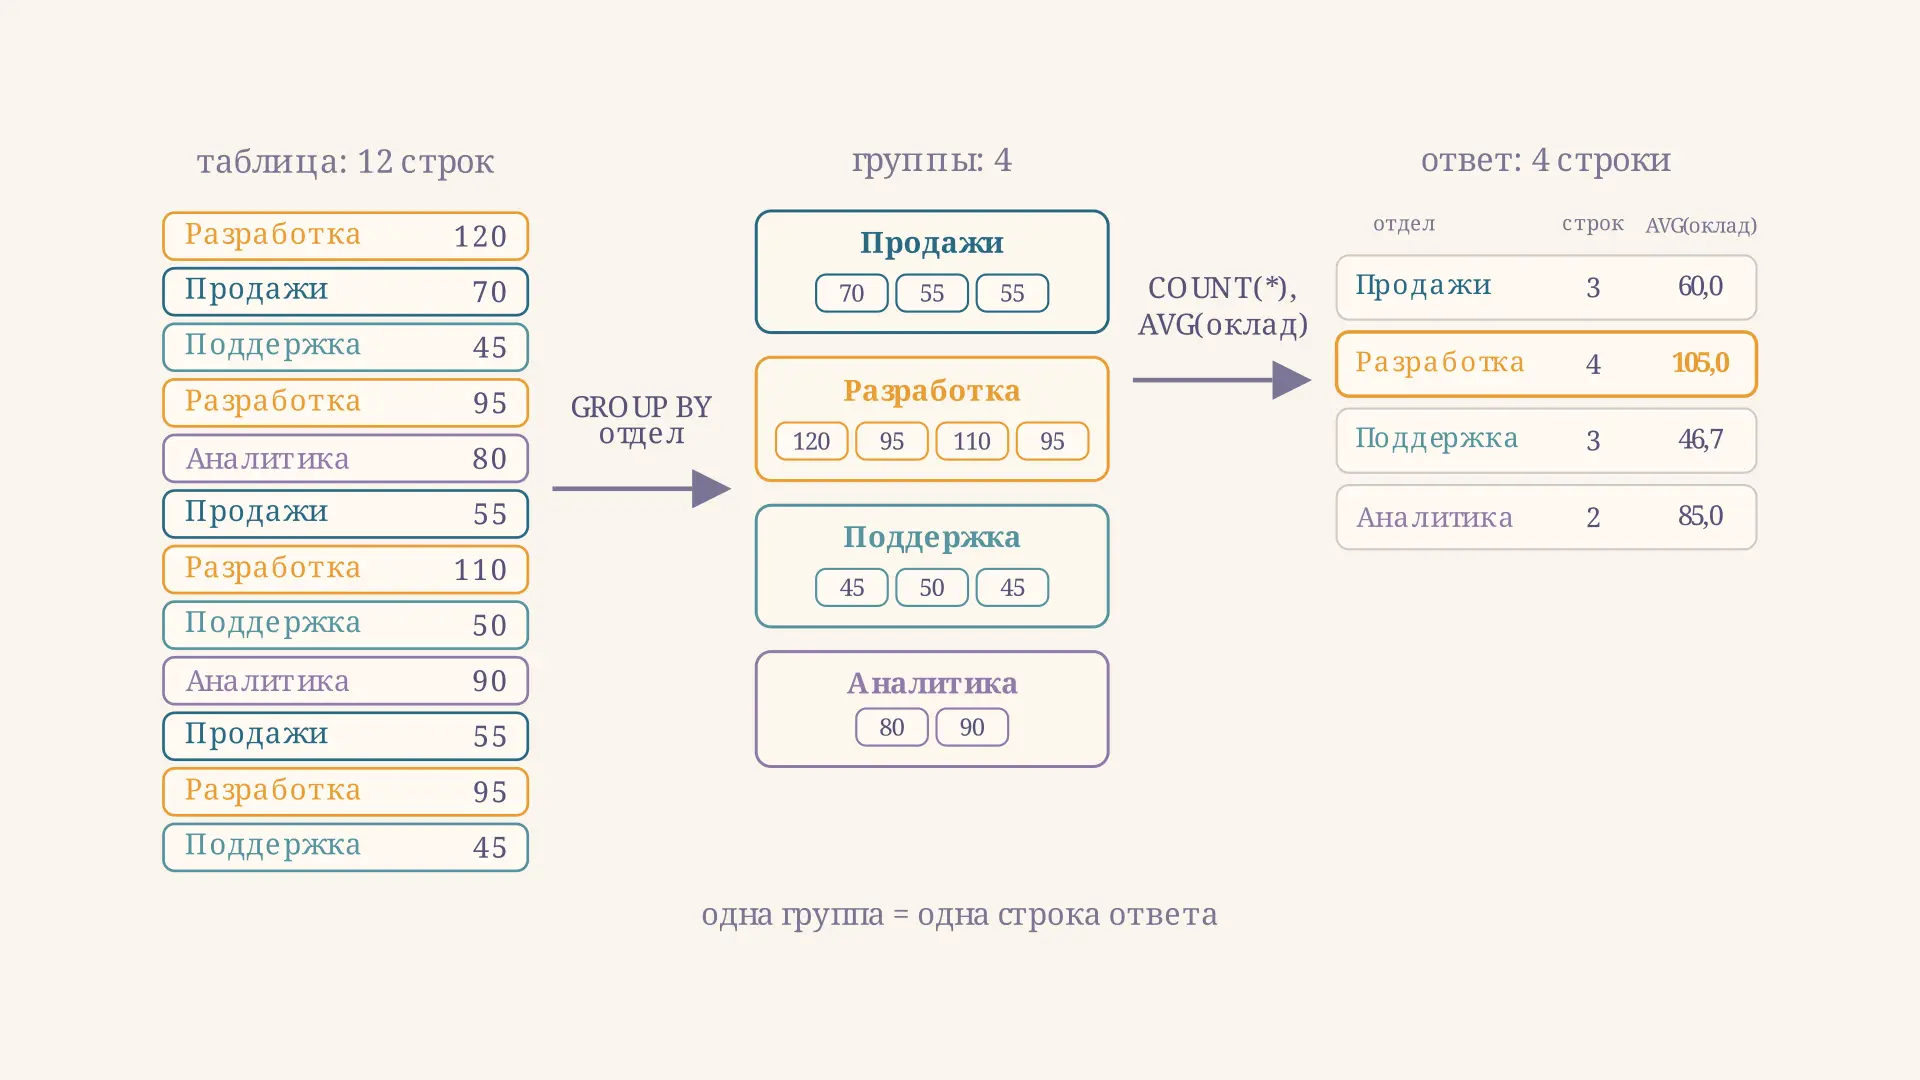
Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
Как работают агрегатные функции SQL: COUNT, SUM, AVG, MIN и MAX, группировка GROUP BY, порядок выполнения запроса, разница HAVING и WHERE и поведение NULL внутри агрегата.
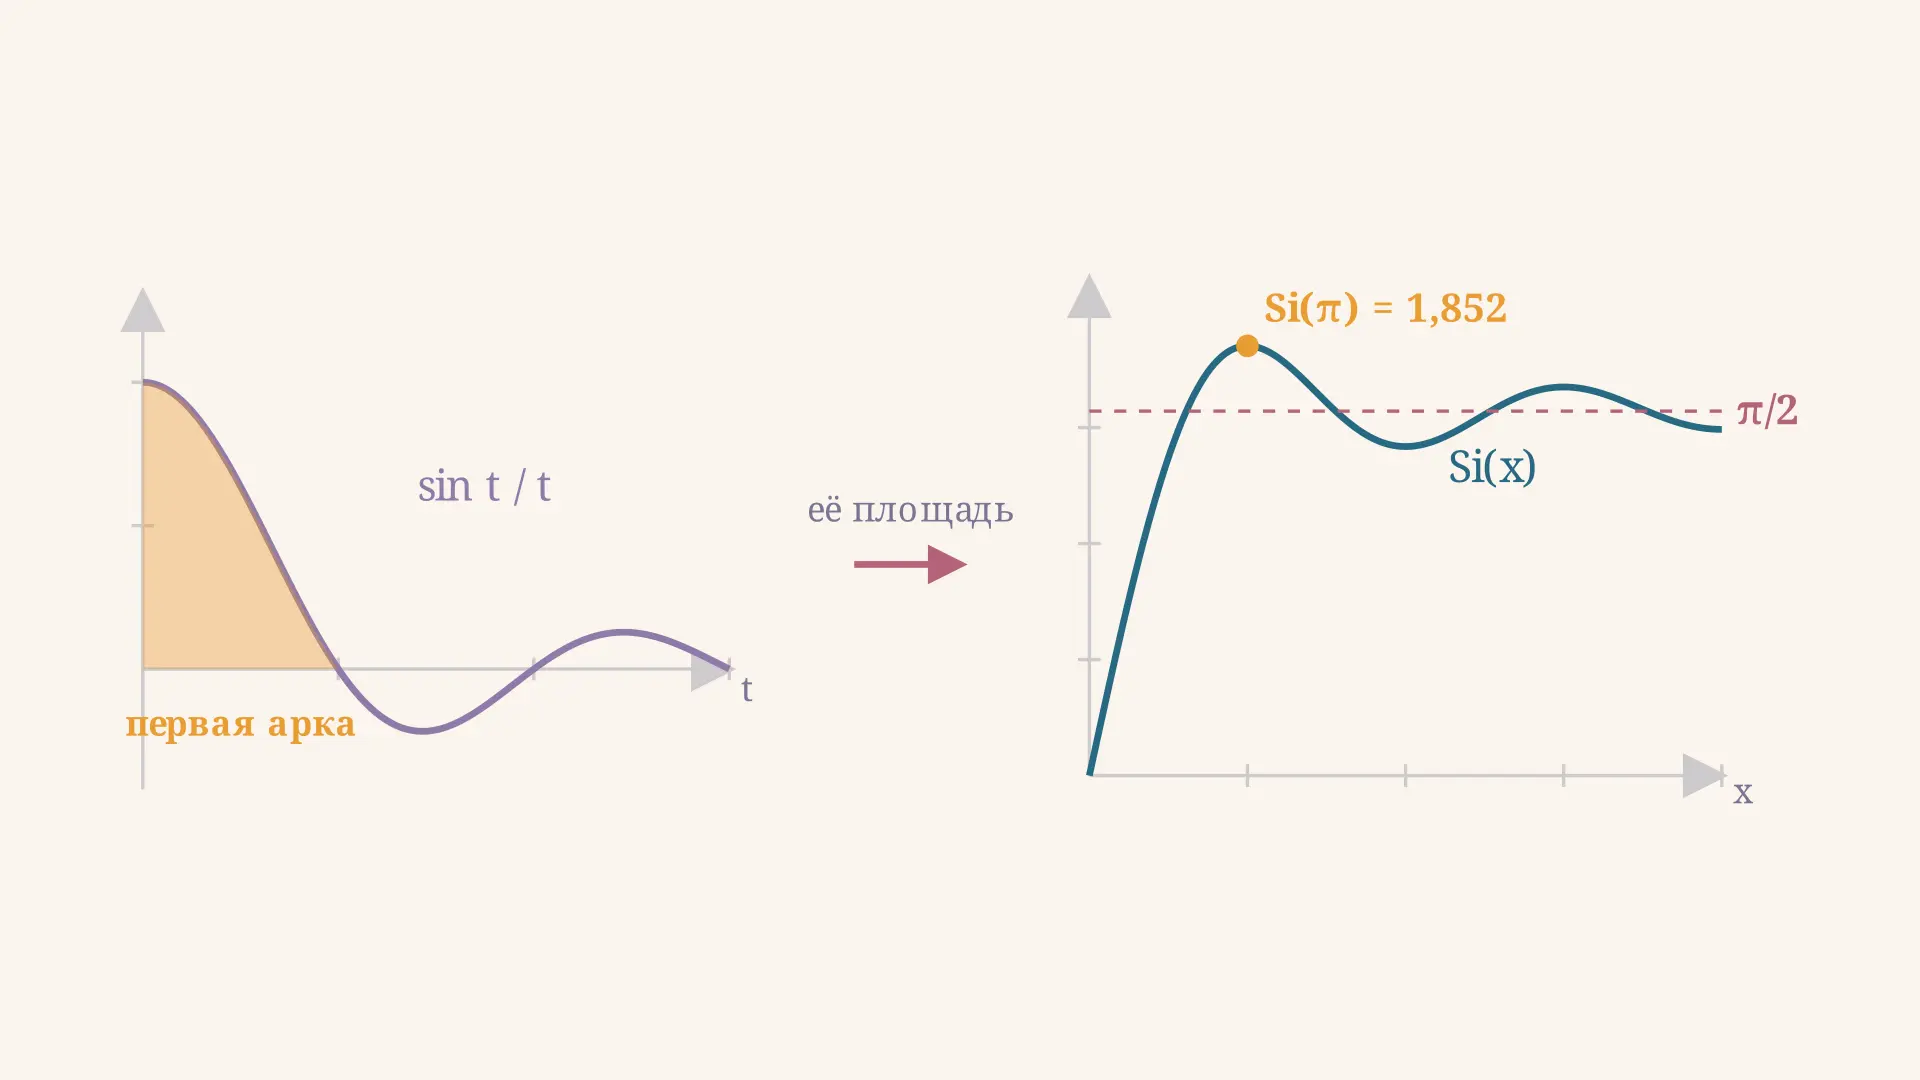
Интегральный синус Si(x): ряд Тейлора и максимум
Интегральный синус Si(x): почему интеграл sin t / t не берётся в элементарных функциях, разложение в ряд, предел π/2, максимум Si(π) и выброс Гиббса. С калькулятором.
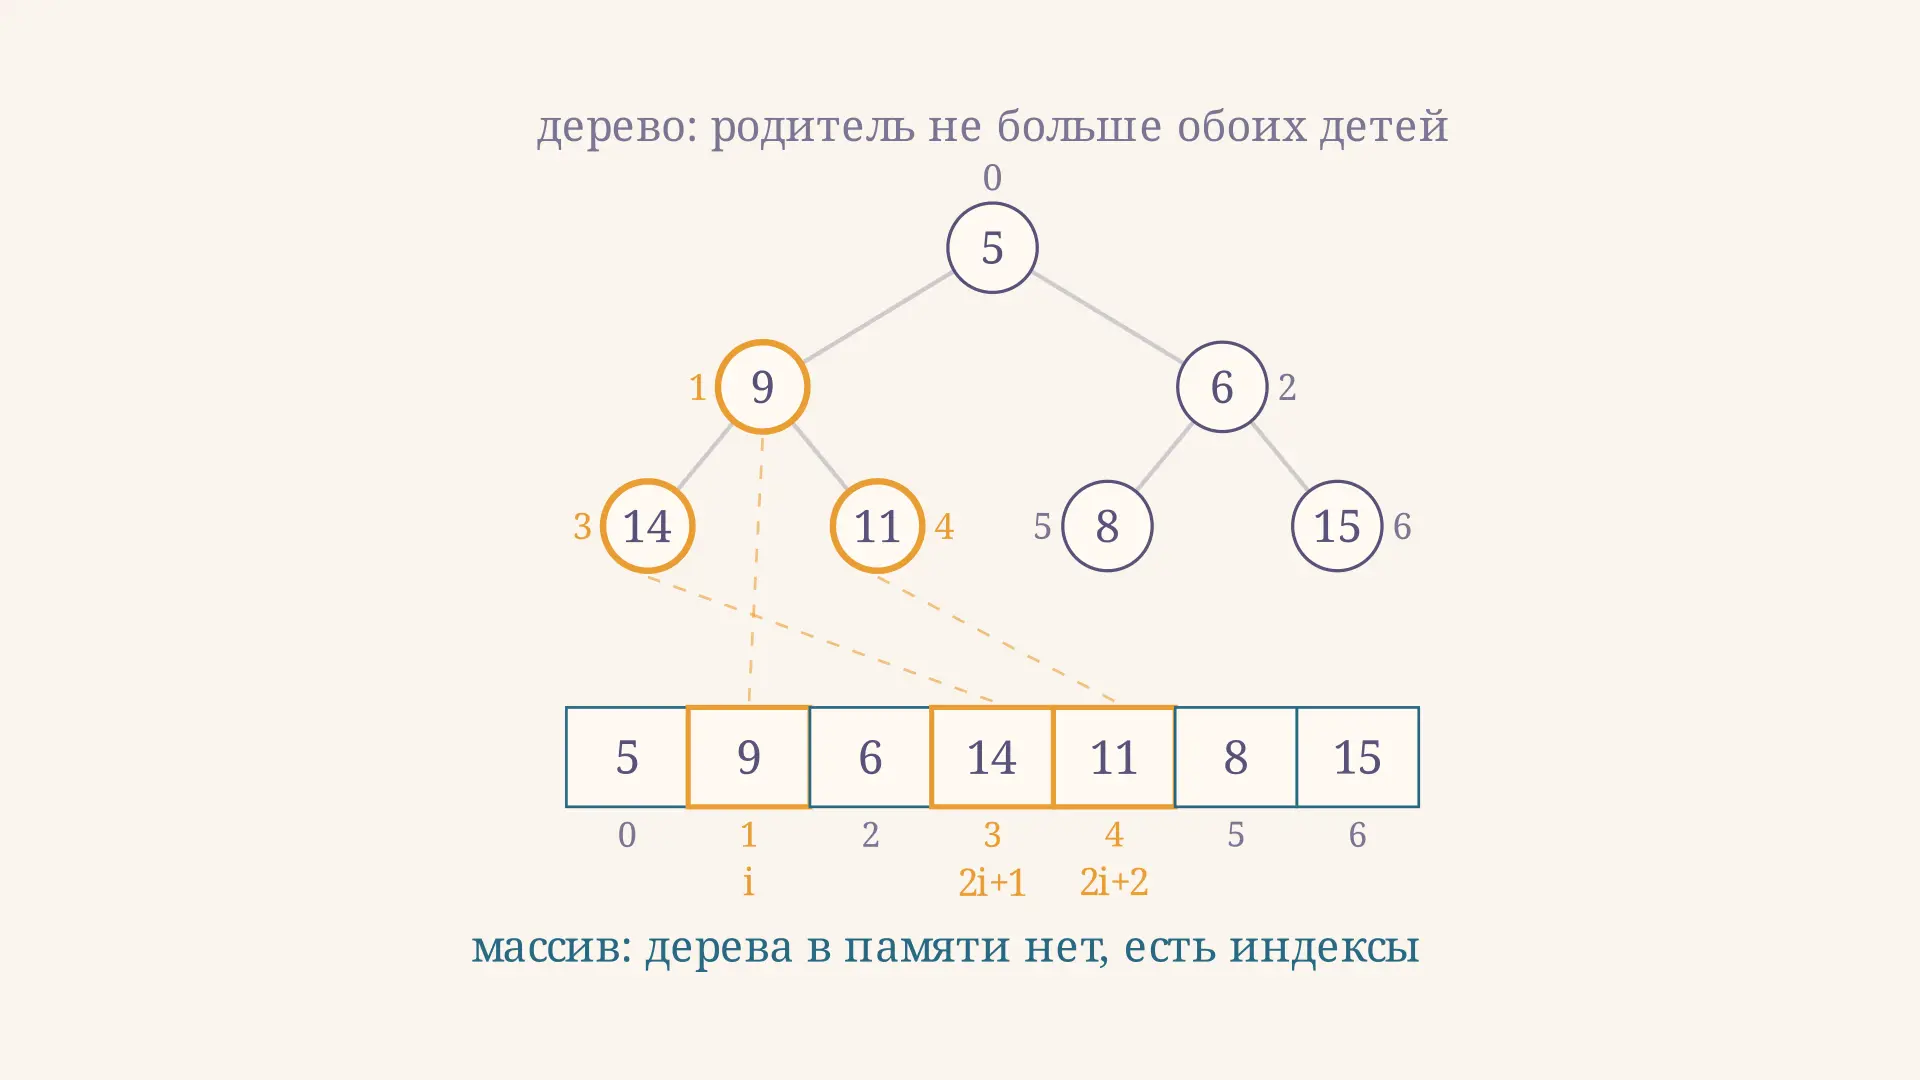
Куча как структура данных: массив и просеивание
Куча как структура данных: свойство кучи, хранение в обычном массиве и индексы 2i+1 и 2i+2, просеивание sift-up и sift-down, построение за O(n) и приоритетная очередь.
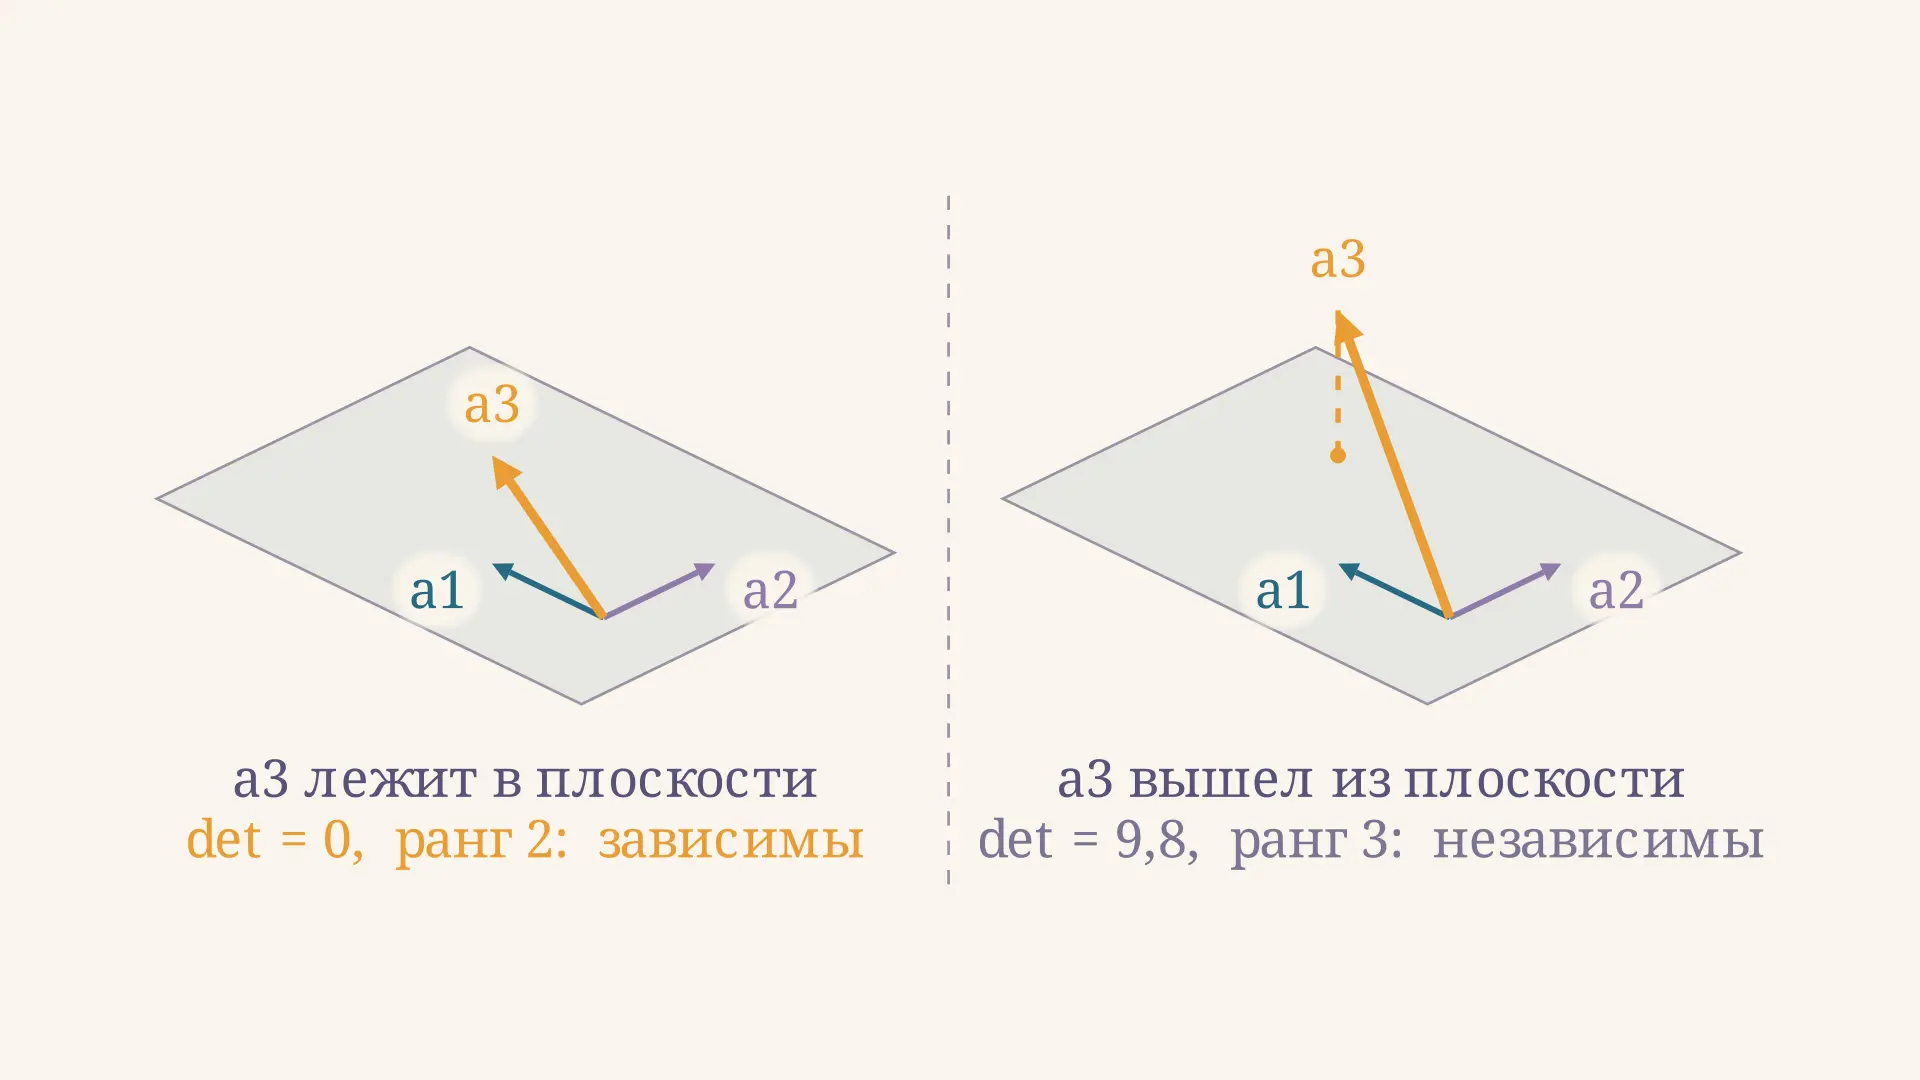
Линейная зависимость векторов: критерии и примеры
Что такое линейная зависимость векторов, как проверить её определителем и рангом матрицы, чем коллинеарность отличается от компланарности и как всё это связано с базисом.
Линейное уравнение второго порядка: общее решение
Как решить линейное однородное уравнение второго порядка с постоянными коэффициентами: характеристическое уравнение, три случая корней, фундаментальная система и задача Коши с разбором.