Тест Чоу: проверка структурного сдвига в регрессии
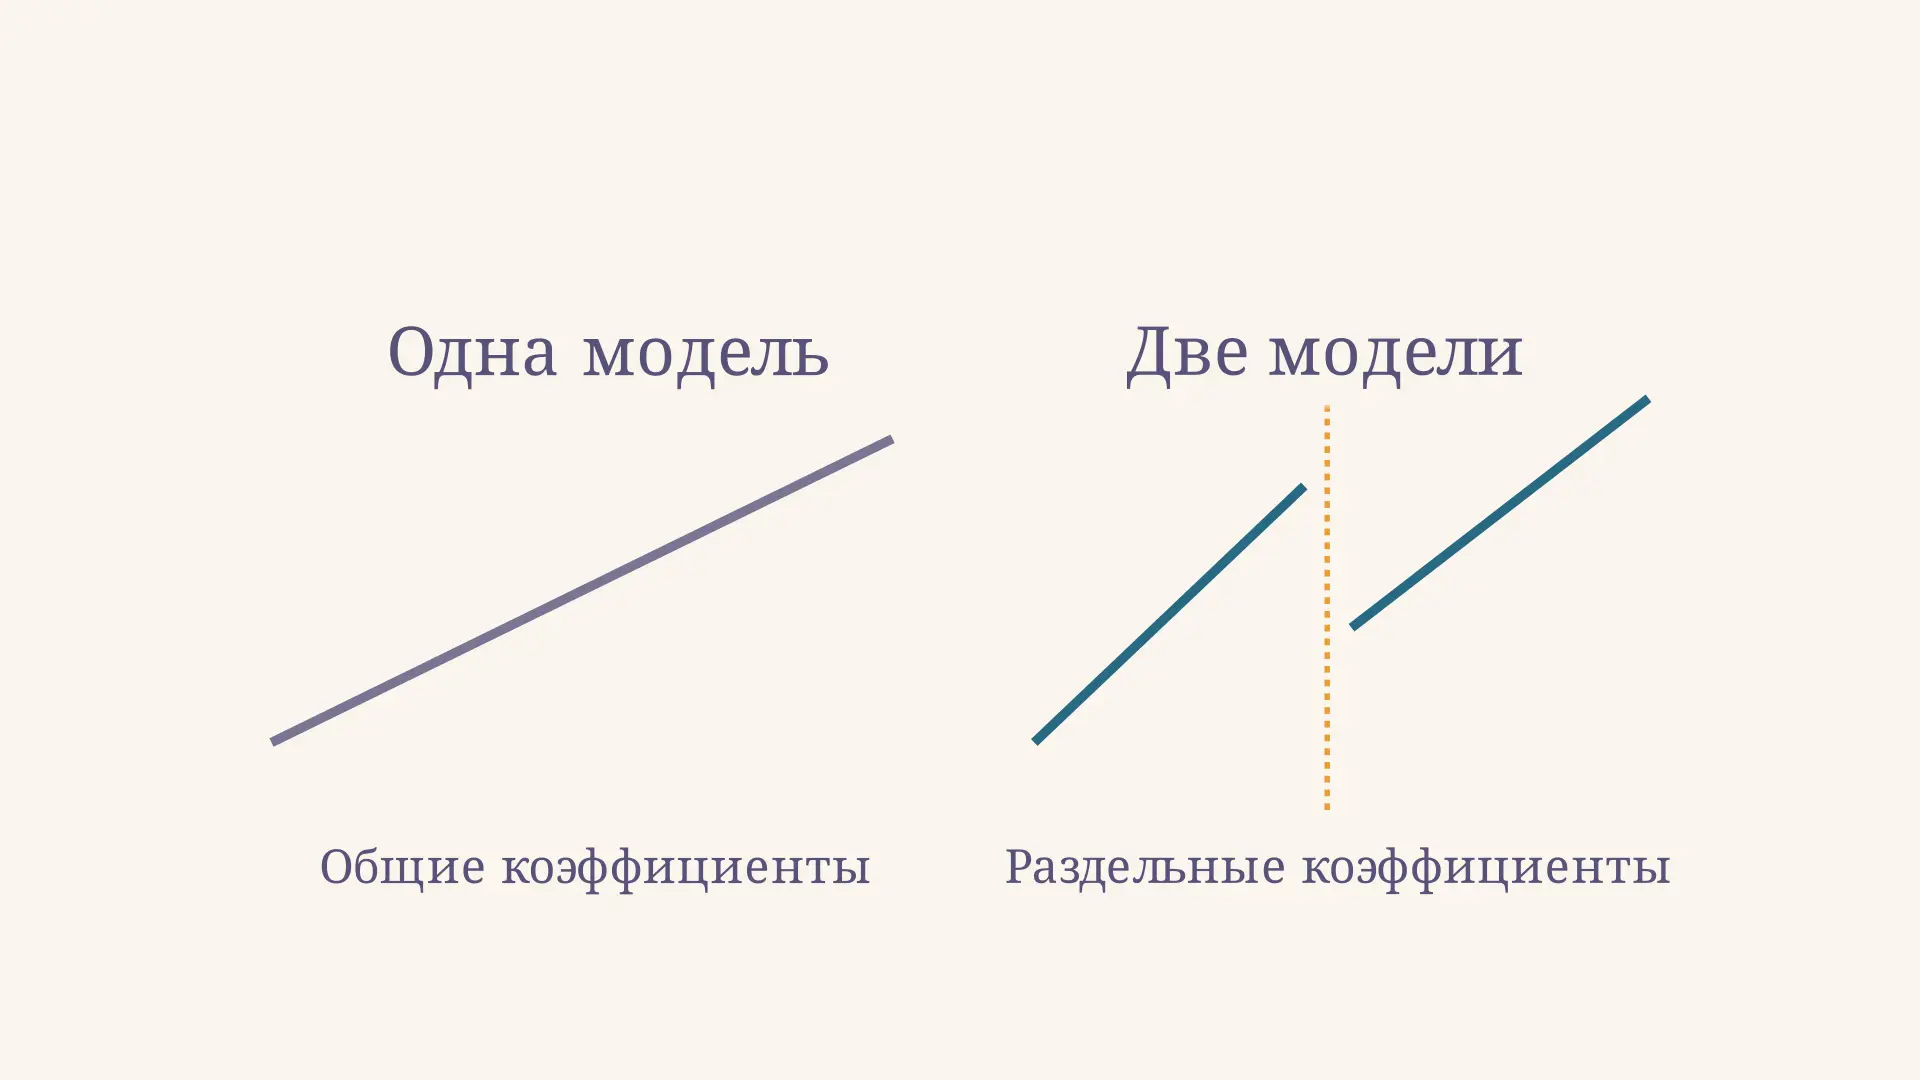
Тест Чоу проверяет, можно ли описать две группы наблюдений одной линейной регрессией или коэффициенты связи между переменными различаются. Например, исследователь предполагает, что после заранее известной даты изменения правил спрос стал иначе реагировать на цену. Тест сравнивает ошибки общей модели с ошибками двух раздельных моделей и показывает, насколько велик выигрыш от разделения с учётом числа дополнительных параметров.
В калькуляторе ниже две группы содержат по 20 наблюдений, а каждая регрессия включает константу и один фактор. Изменяйте сумму квадратов остатков общей модели и следите за статистикой и выводом. Это учебная иллюстрация, а не реальные данные.
Что проверяет тест Чоу
Пусть наблюдения разбиты на два периода: до и после события, дата которого определена до анализа данных. В каждом периоде оценивается одинаковая по составу линейная модель:
Нулевая гипотеза утверждает, что в двух группах одинаковы оба коэффициента: и . При альтернативе хотя бы одно равенство нарушено. Значимым может оказаться изменение константы, наклона или их сочетания; сам общий тест не указывает, какой именно коэффициент изменился.
Раздельные регрессии гибче: каждая подбирает свои коэффициенты, поэтому их суммарная RSS не может превысить RSS совместной модели, оценённой на тех же наблюдениях. Однако некоторое улучшение возникает даже при стабильных коэффициентах. Тест сопоставляет выигрыш с остаточной изменчивостью, чтобы оценить его статистическую убедительность.
Идея проверки равенства наборов коэффициентов изложена в работе Грегори Чоу. Тест является частным случаем сравнения вложенных моделей; общая логика рассмотрена в статье о частном F-критерии.
Формула и степени свободы
Обозначим через сумму квадратов остатков общей регрессии, а через и - остаточные суммы двух раздельных регрессий. Пусть и - размеры групп, - число оцениваемых коэффициентов в каждой модели, включая константу, если она есть. Тогда классическая статистика имеет вид:
В числителе стоит прирост RSS при наложении ограничений, делённый на их число. В знаменателе - оценка общей дисперсии ошибок по свободной модели. Чем больше потеря точности при объединении групп относительно фонового разброса, тем больше .
При выполнении классических предпосылок и нулевой гипотезе статистика имеет распределение . Числитель имеет степеней свободы, знаменатель - сумму наблюдений за вычетом оценённых коэффициентов. Каждая группа должна позволять оценить свою регрессию: матрица регрессоров в ней должна иметь полный ранг, а остаточные степени свободы свободной модели должны быть положительными.
Формула относится к проверке всего вектора коэффициентов. Если исследователь проверяет лишь часть равенств, число ограничений и свободная модель меняются; тогда используют общий частный F-тест с соответствующими ограничениями.
Пошаговый расчёт
Пусть , в каждой регрессии есть константа и один регрессор, поэтому . Предположим, что на одних и тех же 40 наблюдениях получены следующие учебные результаты:
| Модель | Сумма квадратов остатков |
|---|---|
| Общая для двух групп | |
| Первая группа | |
| Вторая группа | |
| Две раздельные модели вместе |
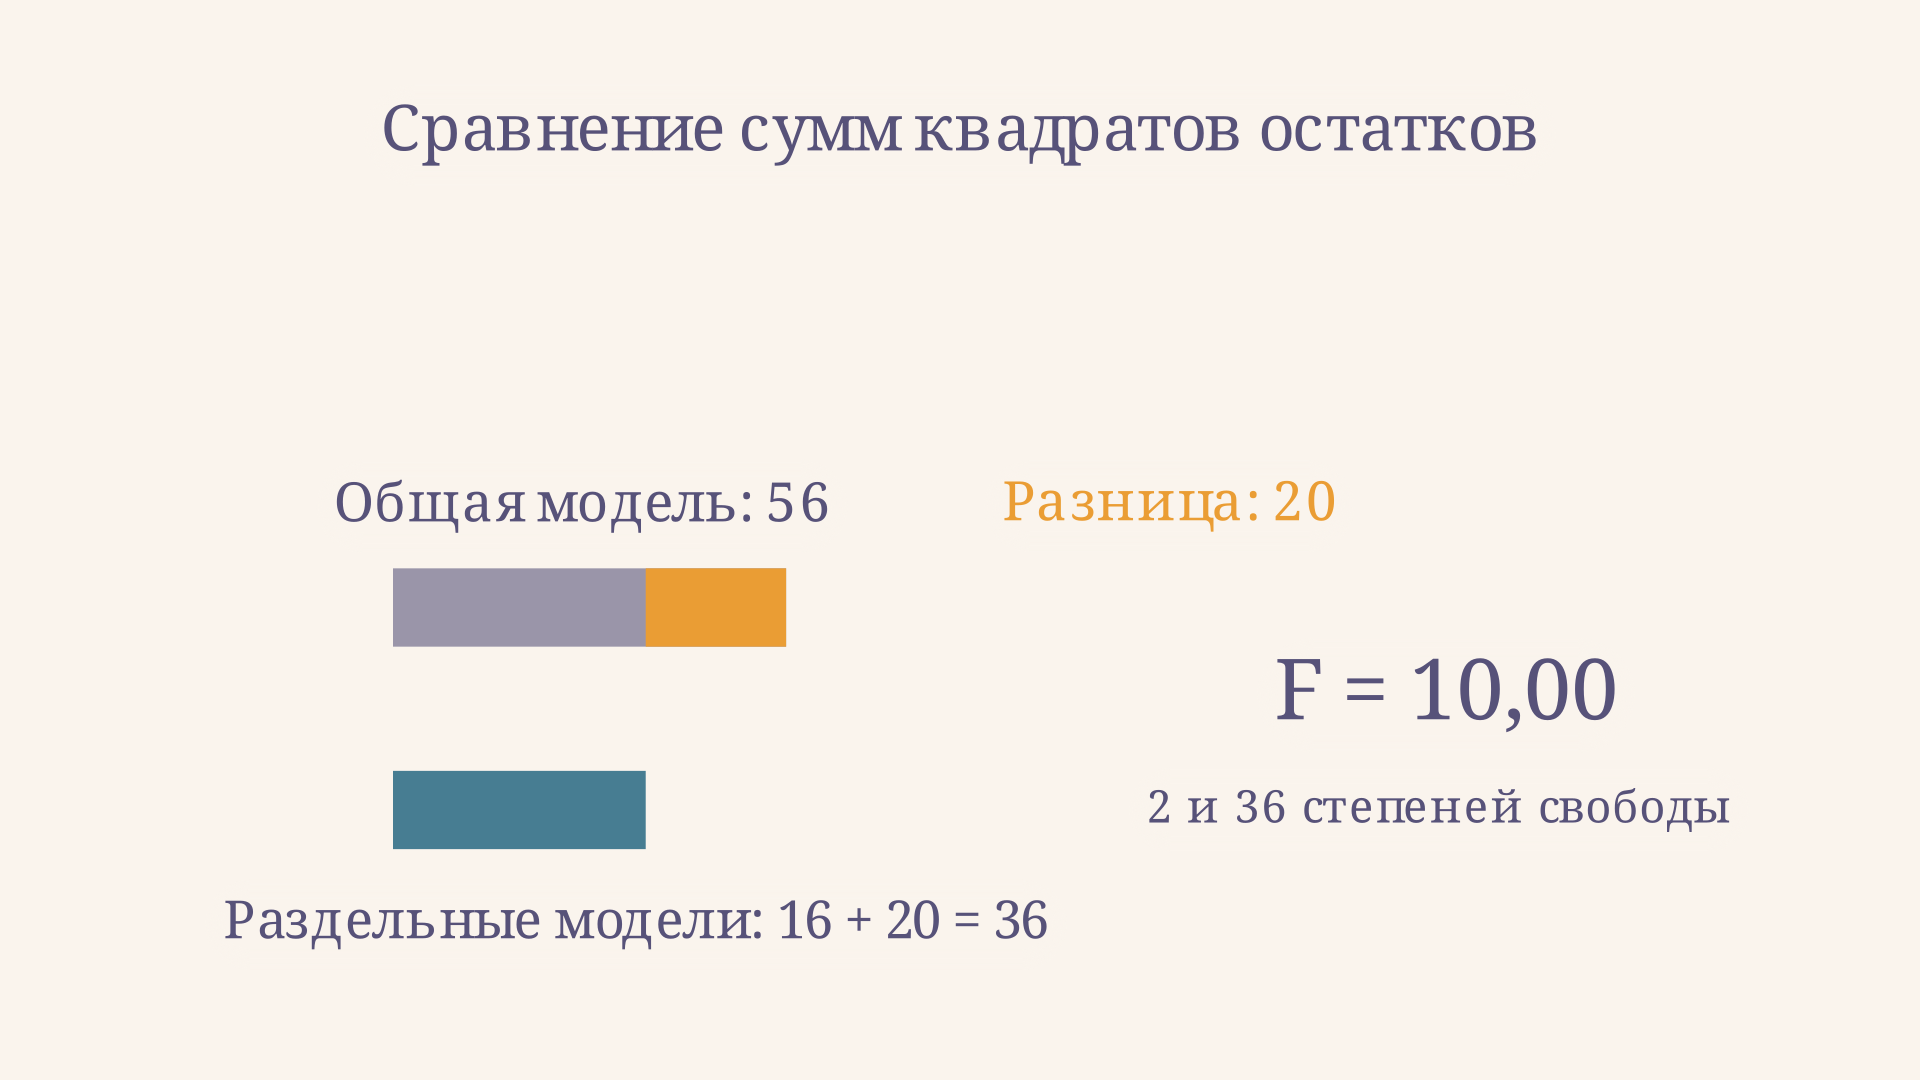
Разница между ограниченной и свободной моделями равна . У ограничений две степени свободы, а у знаменателя . Подстановка даёт:
Для уровня значимости верхнее критическое значение распределения примерно равно . Поскольку , нулевая гипотеза отклоняется. Эквивалентно, , что меньше 0,05. При допущениях теста данные дают основание считать, что хотя бы один коэффициент различается между группами.
Калькулятор оставляет раздельную RSS равной 36 и меняет общую RSS от 36 до 90. Это изолирует роль разницы в формуле: при RSS общей модели 36 статистика равна нулю, при 56 - десяти. Набор ползунка не является заново оценённой базой наблюдений; собственные данные необходимо сначала оценить регрессиями.
Как принять решение и объяснить результат
Сначала задайте уровень значимости и дату разделения, затем оцените общую регрессию и две раздельные на сопоставимых данных. Посчитайте и сравните с верхним критическим значением либо сравните с . Большое значение и малое говорят против равенства коэффициентов.
Отклонение гипотезы показывает статистические свидетельства нестабильности связи в выбранной модели. Оно не доказывает, что событие в точке разделения вызвало изменение: одновременно могли произойти другие изменения, а состав выборки или спецификация могут быть несовершенными. Для содержательного вывода исследуют оценки коэффициентов, их неопределённость и контекст.
Если гипотезу не отклонили, это не доказательство полного равенства. Различие может быть слишком малым для обнаружения в данной выборке, особенно когда одна из групп мала или факторы почти не меняются. Результат полезно сообщать вместе с размерами групп, оценками коэффициентов и уровнем значимости. Логика различия между отсутствием значимости и доказательством равенства важна и при проверке равенства двух средних.
Условия применения и выбор даты
Для точного классического F-вывода рассматривают линейную модель с корректной спецификацией, полным рангом регрессоров и условно независимыми нормальными ошибками с нулевым средним и одной дисперсией в обеих группах. Временные ряды могут нарушать независимость, а разные периоды - иметь разный разброс ошибок. В таких случаях обычное критическое значение может давать неверный уровень значимости.
Диагностика гетероскедастичности тестом Уайта и проверка автокорреляции остатков помогают изучить эти риски, хотя сами по себе не гарантируют выполнения всех условий. При нарушении постоянства дисперсии или независимости применяют подходящую устойчивую ковариационную матрицу и совместный тест ограничений; способ зависит от данных и размера выборки.
Точка разрыва в стандартной постановке выбирается заранее, например по известной дате изменения политики. Если перебрать все даты и выбрать ту, где максимальна, обычное критическое значение для одной заранее заданной даты неприменимо. Для неизвестной даты используют специальные процедуры поиска разрыва и соответствующие критические значения. Об этом различии говорит, например, руководство EViews по диагностике стабильности.
Как подготовить данные к сравнению
До оценки моделей проверьте, что зависимая переменная и каждый фактор измеряются одинаково в обеих частях выборки. Например, смена единиц измерения цены или пересмотр методики учёта выручки может выглядеть как изменение коэффициента, хотя содержательно сравниваются разные показатели. Пропущенные значения также следует обработать до разделения: иначе три регрессии могут незаметно использовать разные наблюдения и разница RSS перестанет выражать только влияние ограничений.
Полезно отдельно посмотреть число наблюдений и разброс факторов в каждой группе. Если в одном периоде цена почти не менялась, оценить её наклон с нужной точностью трудно, даже если общая выборка велика. Таблица оценок двух регрессий вместе с доверительными интервалами поможет понять направление различий после совместной проверки. При этом интервалы и сами оценки не превращают обнаруженный сдвиг в причинный эффект.
Для отчёта перечислите переменные, дату и её обоснование, размеры групп, значения трёх RSS, число ограничений и степени свободы. Затем приведите статистику, уровень значимости и вывод словами. Такая последовательность позволяет другому исследователю воспроизвести вычисление и увидеть, относится ли утверждение ко всем коэффициентам или только к их части.
Эквивалентная модель с фиктивной переменной
Тот же вопрос можно задать одной регрессией. Пусть в первой группе и во второй:
Здесь измеряет разницу констант, а - разницу наклонов. Совместная проверка при классической ковариационной матрице даёт ту же статистику, что сравнение трёх RSS. Такой подход удобен, когда нужно отдельно проверить только наклон или только константу. Но отдельные проверки не заменяют автоматически совместную проверку всей группы ограничений.
Частые ошибки
- Забывают константу в . При константе и одном факторе параметров два, а не один.
- Сравнивают RSS разных выборок. Общая модель должна использовать объединение именно тех наблюдений, что вошли в раздельные модели.
- Путают разрыв коэффициентов с ростом дисперсии. Классический тест предполагает одинаковую дисперсию ошибок; её изменение способно исказить вывод.
- Выбирают дату по максимальному , а затем используют обычную таблицу. Такой поиск требует другой калибровки.
- Приписывают значимому результату причинность. Тест устанавливает несовместимость с общей моделью при заданных условиях, а не причину изменения.
FAQ
Можно ли проверить только изменение наклона?
Да. В регрессии с фиктивной переменной проверьте ограничение , оставив различие констант допустимым. Это другая гипотеза, поэтому её статистика и степени свободы отличаются от общего теста.
Нужны ли одинаковые размеры групп?
Нет. Размеры и могут различаться, но в каждой группе должно хватать информации для оценки модели, а у свободной модели должны оставаться положительные степени свободы.
Что делать, если дата разрыва неизвестна?
Не выбирайте наиболее значимую дату с обычным порогом. Используйте процедуру для неизвестной точки разрыва, например максимальную статистику по допустимому диапазону с её специальным распределением, и укажите правила поиска.
Коротко
Тест Чоу сравнивает общую регрессию с двумя раздельными при заранее выбранном разделении. Нулевая гипотеза требует равенства проверяемых коэффициентов; статистика оценивает потерю точности от этого ограничения относительно остаточного разброса. В примере превышает критическое , поэтому гипотеза отклоняется при 5 %. Вывод зависит от спецификации, выбора даты и предпосылок об ошибках.
Читайте также
Модель с фиксированными эффектами: формула и пример
Модель с фиксированными эффектами для панельных данных: формула, расчёт на примере двух фирм, метод отклонений от средних, условия применения и ограничения.
Преобразование Бокса-Кокса: формула и пример
Преобразование Бокса-Кокса: формула, расчёт для положительных данных, выбор параметра λ и обратный переход. Как применять метод в эконометрической регрессии.
Пробит-модель: формула, пример и интерпретация
Пробит-модель для бинарного выбора: как получить вероятность через нормальное распределение, оценить коэффициенты и рассчитать предельный эффект на примере.
Теорема Гаусса-Маркова: условия и пример
Теорема Гаусса-Маркова объясняет эффективность МНК среди линейных несмещённых оценок. Разберём условия BLUE, доказательство, ограничения и пример сравнения оценок.
Индекс постоянного состава: формула и смысл
Индекс постоянного фиксированного состава в эконометрике: формула, отличие от переменного состава, разложение на структурный сдвиг и ценовой эффект, примеры расчёта.
Коэффициент автокорреляции остатков: формула и интерпретация
Коэффициент автокорреляции остатков первого порядка: формула AR(1), связь с тестом Дарбина-Уотсона, оценка по МНК и способы устранения автокорреляции в регрессии.