Теорема Гаусса-Маркова: условия и пример
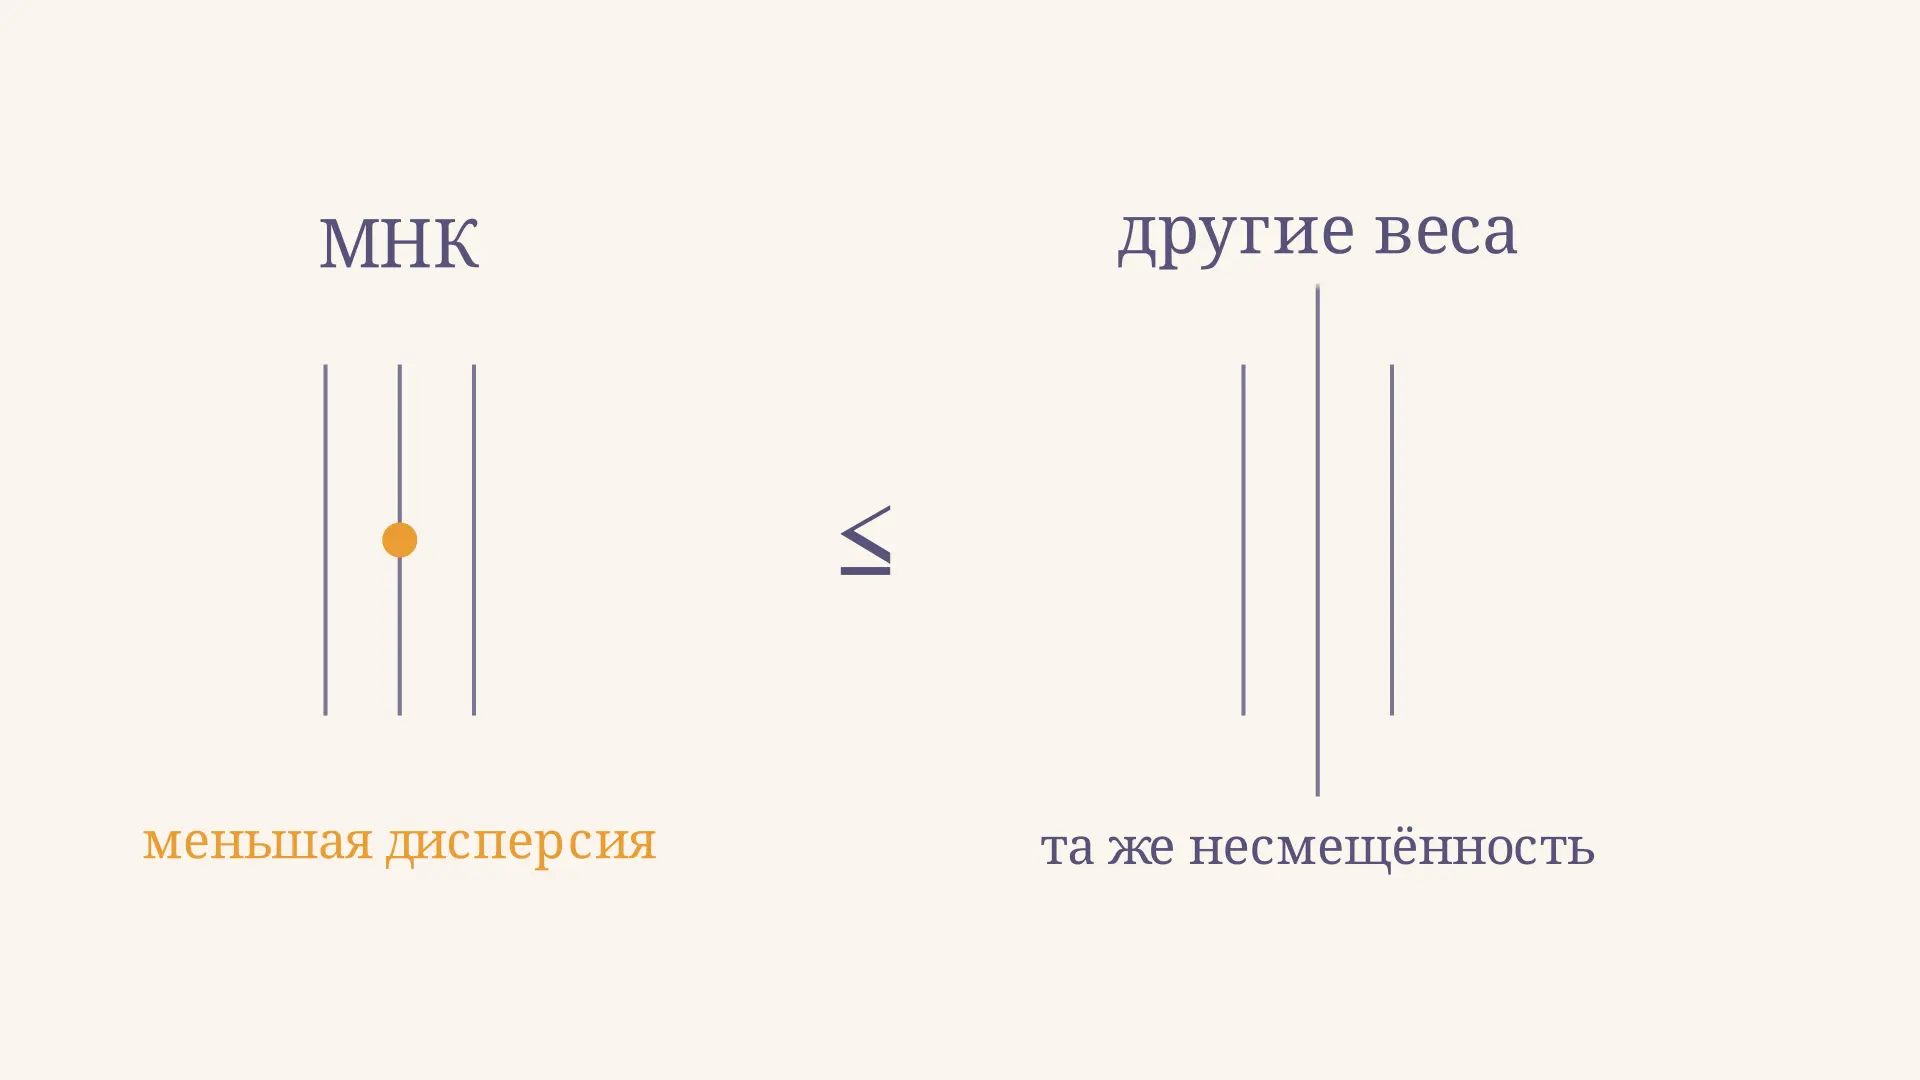
При оценке зависимости расходов от дохода разные выборки дадут немного разные коэффициенты. Можно ли среди разумных способов расчёта выбрать тот, который колеблется меньше других? Теорема Гаусса-Маркова отвечает утвердительно, но только при определённых предпосылках и внутри конкретного класса оценок. Калькулятор позволяет менять веса трёх наблюдений и сравнить полученную дисперсию с дисперсией метода наименьших квадратов (МНК).
Формулировка: что означает BLUE
Пусть наблюдения описываются моделью , где - вектор результатов, - матрица известных факторов, - неизвестные коэффициенты, а - случайные ошибки. При выполнении перечисленных ниже условий оценка
является BLUE: best linear unbiased estimator, или лучшей линейной несмещённой оценкой. «Лучшая» означает наименьшую дисперсию в классе оценок, линейных по и несмещённых для всех допустимых значений . Матрица здесь фиксирована; при случайных факторах утверждение можно формулировать условно при данном .
Это свойство относится к распределению оценок при повторении наблюдений, а не гарантирует близость результата к истине в каждой отдельной выборке. Конкурирующая оценка иногда окажется удачнее МНК просто из-за случайности. Сравнение охватывает каждый коэффициент и любую фиксированную линейную комбинацию коэффициентов. В матричной форме разность ковариационных матриц конкурента и МНК неотрицательно определена. Именно такую формулировку и доказательство приводит кафедра статистики UCLA.
На видео золотая точка перемещается между допустимыми весами. Каждый набор остаётся линейным и несмещённым, но его дисперсия достигает минимума в точке МНК. Это учебная модель, а не результаты реального экономического исследования.
Какие условия нужны
Для классического варианта достаточно следующих предпосылок при фиксированной матрице факторов:
- Линейность по параметрам: . Сами столбцы могут содержать, например, квадрат фактора; линейность нужна по неизвестным коэффициентам.
- Полный столбцовый ранг : ни один столбец не выражается точно через остальные. Иначе обратной матрицы нет и все коэффициенты нельзя однозначно определить этой формулой.
- Нулевое условное среднее ошибок: . При заданных факторах модель не пропускает систематическую составляющую ошибки, связанную с ними.
- Сферическая ковариация ошибок: , где . Дисперсии одинаковы, а ошибки разных наблюдений некоррелированы.
Нормальность ошибок для BLUE не требуется. Она может понадобиться для точных выводов о распределениях некоторых статистик в малой выборке, но не для самого сравнения дисперсий. Равенство дисперсий также отличается от независимости: для теоремы достаточно нулевых попарных ковариаций, а не независимости ошибок.
МНК вычисляют через нормальную систему уравнений. Теорема отвечает на другой вопрос: почему полученную по этой системе оценку можно считать эффективной в указанном классе. Наличие решения само по себе не подтверждает предпосылки о распределении ошибок.
Числовой пример: сравнение весов
Рассмотрим модель при . Пусть ошибки некоррелированы и имеют дисперсию . Ищем оценку наклона в виде . Чтобы она была несмещённой при любых и , нужны два условия:
Первое устраняет свободный член, второе сохраняет коэффициент наклона. Все решения записываются через один параметр:
Из некоррелированности следует, что дисперсия равна сумме квадратов весов: . При получаем веса МНК и дисперсию . При веса равны , а дисперсия - . Оба способа несмещённые, но второй имеет дисперсию на больше, то есть в раза выше.
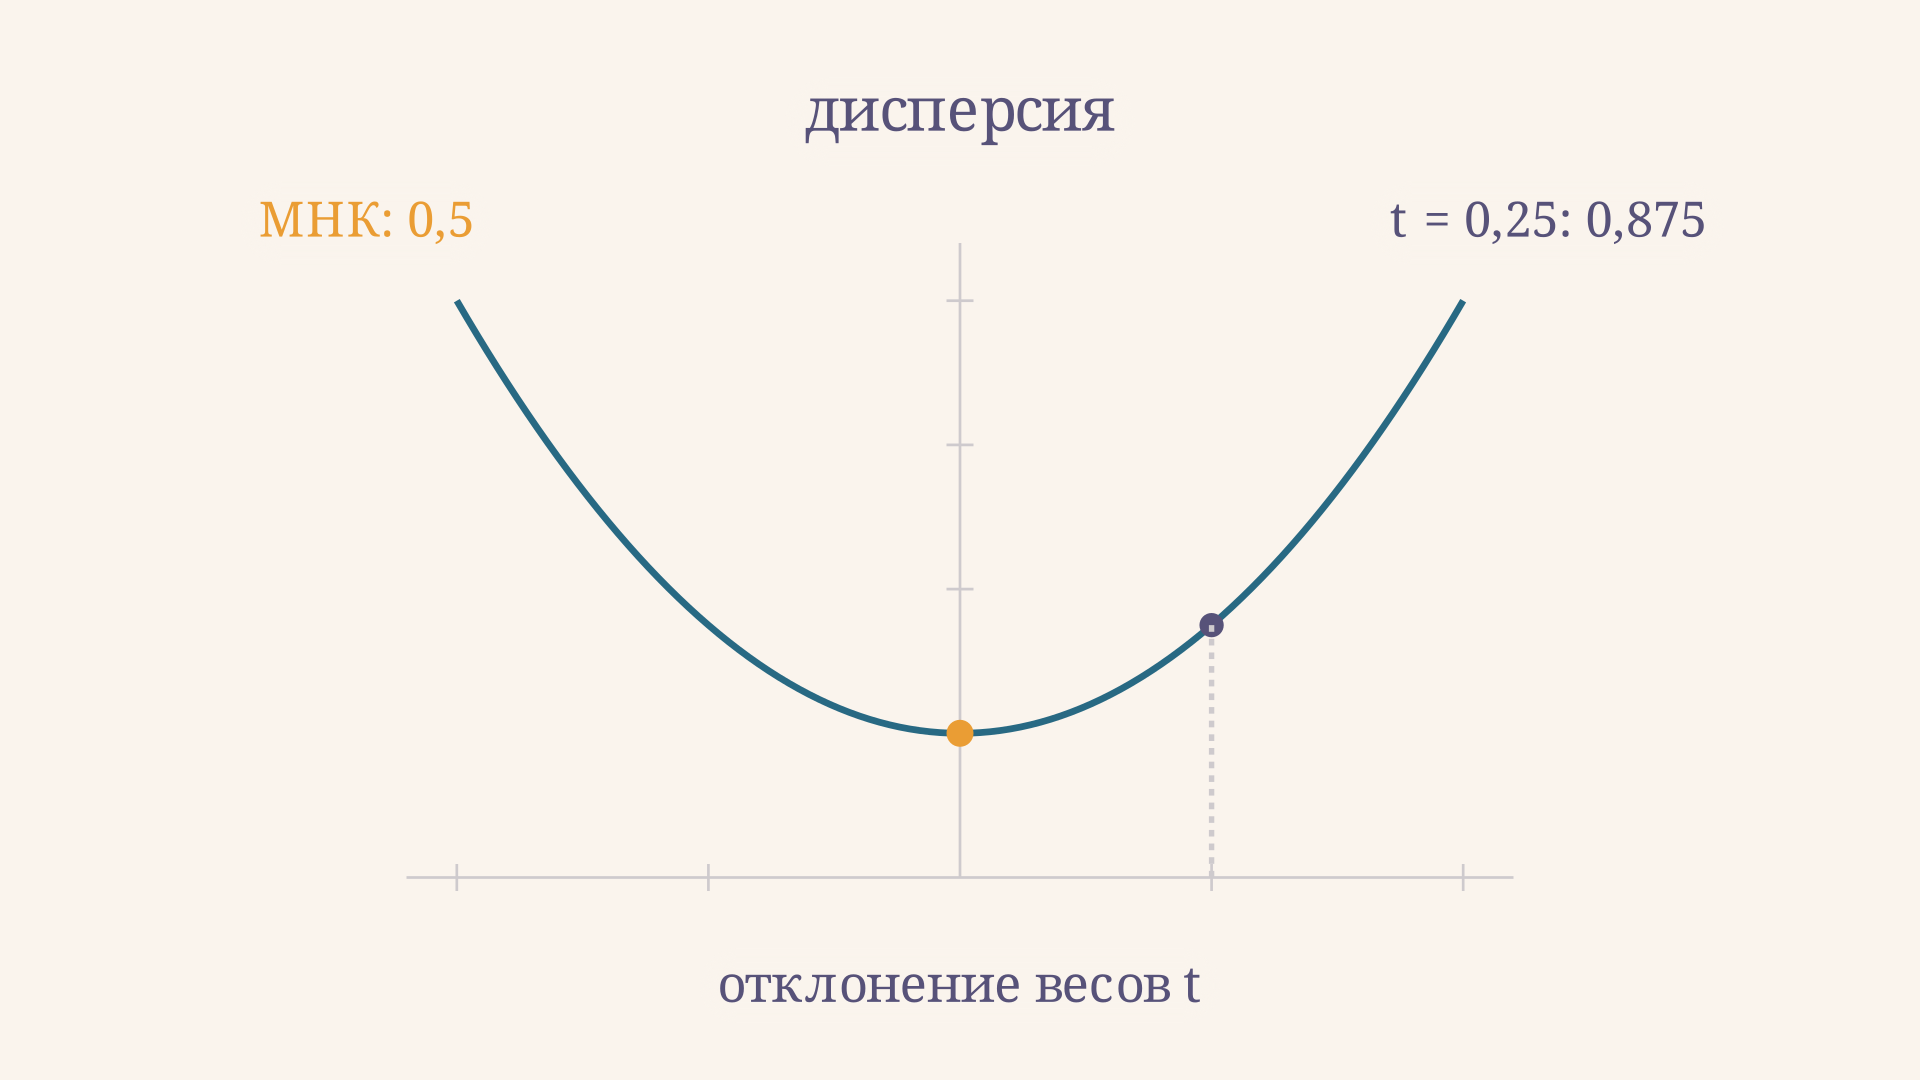
Для конкретного набора эти формулы дают соответственно и . Значения отличаются, хотя оба правила несмещённы: несмещённость говорит об их средних по возможным выборкам, а не о совпадении на одной выборке. Число в дисперсии ошибок здесь задано для простоты; при общей дисперсии обе дисперсии оценок умножатся на неё.
Почему доказательство работает
Обозначим . Любую другую линейную оценку коэффициентов можно записать как . Условие несмещённости для всех означает . Поскольку , получаем .
После подстановки ковариации ошибок смешанные члены исчезают: . Поэтому
Первое слагаемое - ковариационная матрица МНК. Второе неотрицательно определено: для любого вектора выражение неотрицательно. Следовательно, дисперсия не меньше дисперсии . Это и есть точный смысл слова «лучшая». Для некоторой комбинации дисперсии могут совпасть даже при ненулевой матрице .
Геометрически МНК выбирает веса с наименьшей длиной среди удовлетворяющих ограничениям несмещённости. Допустимое изменение весов ортогонально весам МНК, поэтому добавляет неотрицательный квадрат длины. Аналогичное матричное разложение рассматривается в конспекте Корнелльского университета.
Несмещённость и точность: два разных критерия
Представим множество повторных выборок при одних и тех же факторах и истинном коэффициенте. Несмещённая процедура в среднем попадает в этот коэффициент; дисперсия измеряет разброс её результатов вокруг среднего. Две процедуры могут иметь одинаковый центр и разную ширину разброса. Именно вторую характеристику сравнивает теорема, и потому её недостаточно для оценки качества одной уже полученной цифры.
В реальной работе истинная дисперсия ошибок обычно неизвестна. Её оценивают по данным, а затем вычисляют стандартные ошибки коэффициентов. Стандартная ошибка выражается в тех же единицах, что и коэффициент, и связана с квадратным корнем из дисперсии его оценки. Не следует отождествлять её с дисперсией исходных ошибок или с величиной конкретного остатка.
Смещение тоже важно при выборе метода. Среднеквадратичная ошибка складывается из дисперсии и квадрата смещения, поэтому намеренно смещённый метод иногда выигрывает по этому более широкому критерию. Это не опровергает результат Гаусса-Маркова: такой метод просто находится вне сравниваемого класса несмещённых оценок. Чтобы корректно сравнивать методы, нужно заранее назвать и допустимый класс, и меру качества.
Что происходит при нарушении условий
При гетероскедастичности дисперсия ошибок зависит от наблюдения. Если нулевое условное среднее и полный ранг сохраняются, МНК остаётся условно несмещённым, но гарантия минимальной дисперсии среди линейных несмещённых оценок больше не действует. Это не означает, что он обязательно неэффективен в каждом конкретном случае. О диагностике такого нарушения рассказывает статья про тест Уайта.
При корреляции ошибок между наблюдениями вывод об эффективности также может не выполняться. Если ковариационная матрица ошибок известна и положительно определена, обобщённый МНК использует её структуру и становится BLUE при соответствующих условиях. Робастные стандартные ошибки решают другую задачу: они меняют оценку неопределённости обычного МНК, но не сами коэффициенты и не делают МНК автоматически эффективным.
Если же , доказательство несмещённости рушится. Например, пропущенная характеристика работника может влиять на зарплату и одновременно быть связана с образованием. Тогда даже идеальная гомоскедастичность сама по себе не исправит смещение. Для понимания расчёта неопределённости отдельно полезно разобрать стандартную ошибку коэффициента регрессии.
Как применять теорему в задаче
Сначала выпишите оцениваемую модель и проверьте, какие величины входят в . Затем установите ранг матрицы и явно запишите условия на условное среднее и ковариацию ошибок. Если они даны в условии, вывод BLUE относится к этой модели и именно к условному распределению при заданном .
Далее уточните класс конкурентов: линейны ли оценки по наблюдаемому и несмещённы ли они для всех допустимых параметров? Для сравнения векторов удобно использовать разность ковариационных матриц, а для одного коэффициента - её соответствующий диагональный элемент. При нескольких факторах вычисление самой оценки разбирают нормальные уравнения множественной регрессии.
На практике предпосылки нельзя доказать одной таблицей остатков. Проверки способны выявить некоторые нарушения, но нулевое условное среднее зависит и от содержательного обоснования модели. Вывод стоит формулировать условно: «если предпосылки выполняются, оценка МНК является BLUE».
Частые ошибки
- Считать BLUE синонимом наилучшей оценки вообще. Смещённая или нелинейная оценка может иметь меньшую среднеквадратичную ошибку.
- Требовать нормального распределения ошибок для самой теоремы. Нормальность не входит в перечисленные условия BLUE.
- Путать ошибки модели и вычисленные остатки. Остатки зависят от оценённых коэффициентов и не являются непосредственно наблюдаемыми ошибками.
- Делать из несмещённости вывод, что каждая конкретная оценка равна истинному параметру. Речь идёт о математическом ожидании по повторным выборкам.
FAQ
Должна ли модель быть линейной по факторам? Нет. Например, столбец допустим, если модель линейна по неизвестным коэффициентам и матрица факторов имеет полный ранг.
BLUE означает минимальную ошибку прогноза? Нет. Теорема сравнивает дисперсии линейных несмещённых оценок параметров при заданных предпосылках; прогноз и среднеквадратичная ошибка требуют отдельного анализа.
Можно ли применять теорему к случайным факторам? Да, если её условия выполняются условно при данном почти наверное. Тогда сравнение дисперсий также формулируется условно на .
Коротко
Теорема Гаусса-Маркова утверждает, что при полном ранге, нулевом условном среднем и одинаковых некоррелированных ошибках МНК имеет минимальную дисперсию среди линейных несмещённых оценок. Это условный результат о классе процедур, а не гарантия точного результата на каждой выборке.
Читайте также
Стандартная ошибка коэффициента регрессии: формула и расчёт
Что такое стандартная ошибка коэффициента регрессии, как вывести формулу, рассчитать вручную и интерпретировать в эконометрике. Примеры и частые ошибки.
Тест Глейзера: проверка гетероскедастичности МНК
Тест Глейзера для выявления гетероскедастичности: три формы вспомогательной регрессии, t-критерий значимости, сравнение с тестом Уайта и Бройша-Пагана, пример расчёта.
Модель с фиксированными эффектами: формула и пример
Модель с фиксированными эффектами для панельных данных: формула, расчёт на примере двух фирм, метод отклонений от средних, условия применения и ограничения.
Преобразование Бокса-Кокса: формула и пример
Преобразование Бокса-Кокса: формула, расчёт для положительных данных, выбор параметра λ и обратный переход. Как применять метод в эконометрической регрессии.
Пробит-модель: формула, пример и интерпретация
Пробит-модель для бинарного выбора: как получить вероятность через нормальное распределение, оценить коэффициенты и рассчитать предельный эффект на примере.
Тест Чоу: проверка структурного сдвига в регрессии
Тест Чоу проверяет стабильность коэффициентов регрессии при известной точке разрыва. Разбираем формулу F, расчёт, условия применения и интерпретацию результата.