Пробит-модель: формула, пример и интерпретация
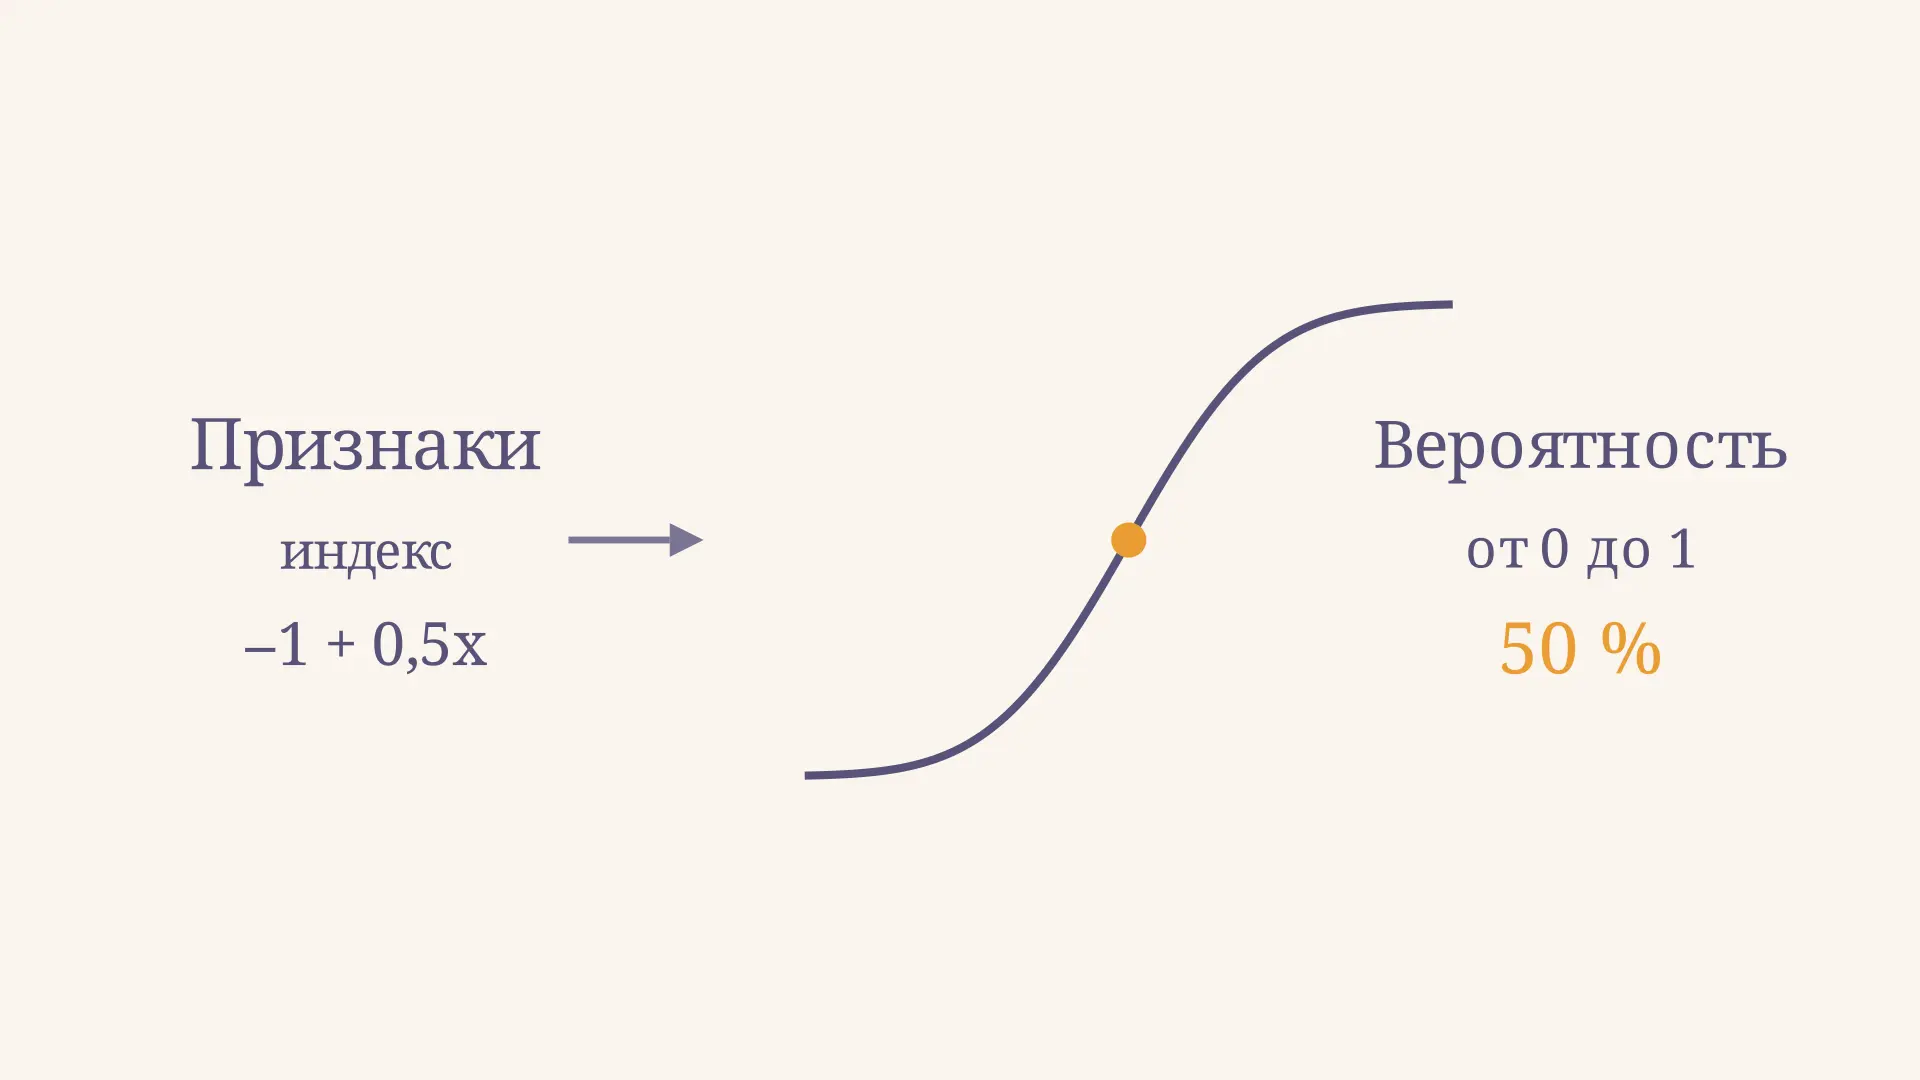
Пробит-модель помогает изучать исходы с двумя вариантами: получил человек кредит или нет, купила фирма оборудование или отказалась. Она связывает вероятность события с наблюдаемыми признаками, например доходом или ценой, через функцию стандартного нормального распределения. Результат всегда находится между нулём и единицей, а влияние признака на вероятность зависит от исходной точки. В калькуляторе можно проследить это на учебной модели: двигайте и смотрите на вероятность и предельный эффект.
Что описывает пробит-модель
Пусть означает наступление события, а - его отсутствие. Экономист может исследовать, связана ли занятость человека с образованием и опытом, или как характеристики заёмщика связаны с вероятностью просрочки. Для каждого наблюдения есть значения признаков и наблюдаемый исход. Модель описывает условную вероятность единицы при заданных признаках, а не гарантирует исход отдельного человека.
Линейная комбинация признаков называется индексом: . Пробит-модель преобразует его в вероятность через - функцию распределения стандартной нормальной случайной величины. Индекс может быть любым действительным числом, но соответствующая вероятность остаётся между нулём и единицей. На видео точка движется по кривой, когда меняется один признак; в центре вероятность растёт быстрее, чем на краях.
Если коэффициент признака положителен, вероятность возрастает при его увеличении и фиксированных остальных признаках; если отрицателен - убывает. При нулевом коэффициенте этот признак не меняет индекс в данной спецификации. Как и в других регрессиях, направление связи само по себе не доказывает причинное влияние: выборка, пропущенные факторы и способ измерения имеют значение.
Формула и скрытая переменная
Основная запись модели имеет вид
Здесь , где имеет стандартное нормальное распределение с математическим ожиданием ноль и дисперсией один. Например, , а . Функцию находят по таблице или программно; её аргумент - индекс, а не сама вероятность.
Полезная интерпретация строится через ненаблюдаемую склонность . Наблюдается единица, если , и ноль в остальных случаях. При условии симметрия нормального распределения даёт . Граница ноль и единичная дисперсия ошибки задают нормировку: по одним бинарным исходам нельзя отдельно восстановить произвольный масштаб скрытой переменной и коэффициентов. Это модельный способ описания выбора, а не доказательство существования измеримой психологической склонности.
Для линейной вероятностной модели вместо берут сам индекс. Её коэффициенты проще читать, однако прогноз может выйти за диапазон от нуля до единицы. Пробит этого ограничения избегает, ценой нелинейной интерпретации коэффициентов и предположения о форме связи. О том, почему регрессионные коэффициенты зависят от шкал признаков, рассказывает статья про стандартизованные коэффициенты регрессии.
Пример расчёта вероятности
Предположим, что учебная модель описывает вероятность покупки: . Пусть - условная оценка доступности товара; коэффициенты здесь заданы для иллюстрации, а не получены из опроса. При сначала находим индекс:
Затем обращаемся к нормальной функции распределения: , или 84,1 % после округления. На рисунке пунктир связывает значение признака с точкой кривой и соответствующей высотой вероятности.
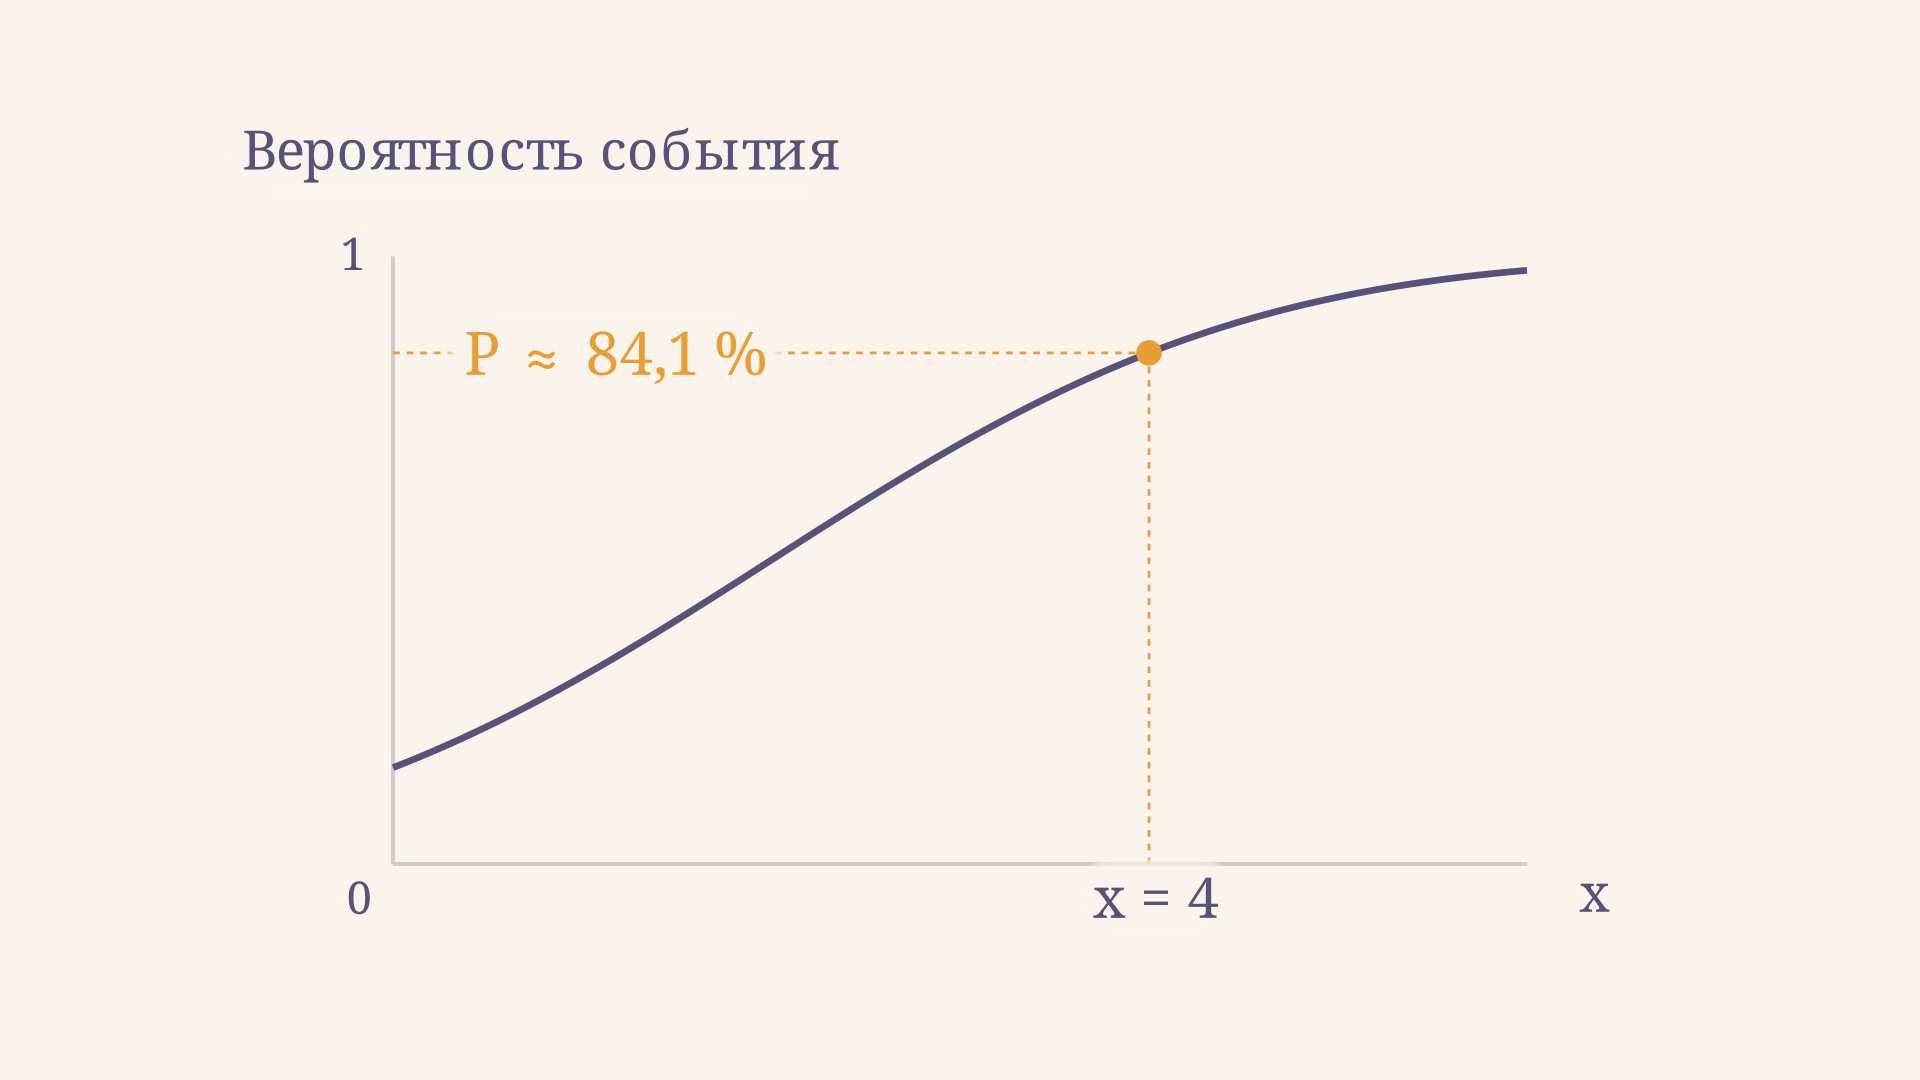
Для сравнения при индекс равен нулю, а вероятность - 50 %. При индекс равен , и вероятность около 15,9 %. Рост от 2 до 4 увеличивает прогноз на 34,1 процентного пункта. Это разность вероятностей, а не изменение на 34,1 процента от первоначального значения. При фиксированных коэффициентах любое значение на графике получают теми же двумя шагами: индекс, затем .
Если представить множество похожих ситуаций с одинаковым значением признака и правильно заданной моделью, вероятность описывает долю единиц в такой совокупности. Отдельное наблюдение при этом остаётся нулём или единицей. Утверждение о доле относится к модельным условиям: оно может не выполняться в другой популяции или после изменения обстоятельств. Поэтому при переносе модели на новых покупателей важно проверять, насколько их характеристики и механизм выбора похожи на исходные.
Как читать коэффициенты и предельные эффекты
Коэффициент показывает изменение индекса при увеличении непрерывного на единицу и неизменных остальных признаках. В нашем примере коэффициент 0,5 означает прирост индекса на 0,5, а не прирост вероятности на 50 процентных пунктов. Кривая нелинейна, поэтому одинаковый шаг по даёт разные изменения вероятности в разных точках.
Для малого изменения непрерывного признака используют предельный эффект:
где - плотность стандартного нормального распределения. При индекс равен нулю, , поэтому эффект равен . Это около 19,9 процентного пункта на единицу в данной точке, а не точный результат изменения на целую единицу. Для конечного шага надо вычесть две вычисленные вероятности.
Предельный эффект можно вычислить при выбранном наборе признаков или посчитать для каждого наблюдения и усреднить. Эти два результата вообще говоря различаются. Для бинарного признака, например наличия диплома, производная по нему не описывает реальный переход от нуля к единице: удобнее сравнить два прогноза с и , оставив остальные признаки неизменными. Такой контраст тоже не обязательно является причинным эффектом.
Как оценивают модель по данным
На практике коэффициенты обычно неизвестны. Исследователь задаёт исход, выбирает признаки и оценивает коэффициенты методом максимального правдоподобия. Если для наблюдения модель предсказывает , вклад единицы в правдоподобие равен , а вклад нуля - . Для независимых наблюдений логарифм правдоподобия записывают как
Численный алгоритм ищет коэффициенты, максимизирующие эту сумму. Это не означает, что модель идеально предсказывает каждый исход: она подбирает вероятности с учётом всей выборки. Формула и применение метода приведены в руководстве Stata по probit.
После оценки смотрят на стандартные ошибки, интервалы и содержательный размер эффектов. Проверка нулевой и альтернативной гипотез помогает оценить совместимость данных с гипотезой о коэффициенте, но статистическая значимость не заменяет анализа величины связи. Зависимость наблюдений внутри групп может потребовать соответствующей оценки стандартных ошибок. При полном разделении исходов некоторыми признаками конечные оценки максимального правдоподобия могут не существовать; предупреждения программы нельзя игнорировать.
До оценки необходимо проверить кодирование зависимой переменной: результат относится именно к тому событию, которому присвоена единица. Если поменять ноль и единицу местами, при той же спецификации знаки коэффициентов сменятся, а прогноз станет дополнением исходной вероятности до единицы. Следует также заранее определить единицы измерения признаков и правила работы с пропусками. Например, коэффициент при доходе в тысячах и коэффициент при доходе в отдельных денежных единицах имеют разные численные масштабы, хотя могут описывать одну и ту же связь.
Полезно отдельно сообщать размер выборки, долю наблюдений с событием и способ её формирования. Редкий исход может быть особенно труден для оценки при небольшом числе наблюдений. Доверительный интервал для вероятности или эффекта показывает неопределённость оценки при принятых предположениях; он не учитывает автоматически все возможные ошибки выбора модели и сбора данных.
Пробит, логит и качество прогноза
Логит-модель тоже описывает бинарный исход, но использует логистическую функцию распределения вместо стандартной нормальной. Обе дают S-образную зависимость и вероятности в допустимых границах; их коэффициенты измеряются в разных масштабах и напрямую не сравниваются. Прикладной выбор зависит от задачи и предположений, а сравнивать модели полезнее по прогнозам, предельным эффектам и качеству на отложенных данных. Различие функций связи описано в документации Stata.
Вероятность и классификация - разные результаты. Чтобы получить метку, можно выбрать порог, например 0,5, и отнести к единице прогнозы не ниже него. Другой порог меняет число ложных срабатываний и пропусков; выбор зависит от цены ошибок. Матрица ошибок показывает эти последствия, но сама по себе не проверяет, насколько хорошо откалиброваны вероятности. Для калибровки сравнивают прогнозы с фактическими частотами на независимых данных.
Частые ошибки
- Принимать коэффициент за изменение вероятности. Сначала найдите индекс, затем ; для изменения вероятности вычислите разность прогнозов или предельный эффект.
- Считать прогноз индивидуальной гарантией. Вероятность 84,1 % не означает, что конкретная покупка обязательно состоится.
- Переносить эффект между точками. Наклон кривой зависит от индекса и значений остальных признаков.
- Выводить причинность из знака. Пропущенные переменные, обратная связь и отбор могут искажать интерпретацию.
- Оценивать качество только на обучающей выборке. Нужна проверка на новых данных и анализ ошибок для выбранного порога.
FAQ
Обязаны ли сами признаки быть нормально распределены?
Нет. В стандартной модели нормальность относится к условному распределению ошибки в представлении скрытой переменной, а не к распределению каждого объясняющего признака.
Можно ли использовать категориальные признаки?
Да. Их обычно представляют индикаторами с выбранной базовой категорией. Для интерпретации удобно сравнивать предсказанные вероятности категорий при одинаковых остальных признаках.
Что означает отрицательный коэффициент?
При увеличении соответствующего признака индекс и условная вероятность единицы уменьшаются, если прочие признаки зафиксированы. Размер изменения вероятности зависит от точки и шага.
Коротко
Пробит-модель переводит линейный индекс признаков в вероятность бинарного события через стандартную нормальную функцию распределения. Коэффициенты относятся к индексу; вероятности, конечные разности и предельные эффекты помогают выразить результат в понятных единицах. Качество прогноза и причинная интерпретация требуют отдельных проверок.
Читайте также
Логит-модель: формула, пример и смысл коэффициентов
Как логит-модель описывает бинарный выбор: формула вероятности, шансы и отношение шансов, расчёт на примере дохода, оценивание и границы интерпретации.
Модель с фиксированными эффектами: формула и пример
Модель с фиксированными эффектами для панельных данных: формула, расчёт на примере двух фирм, метод отклонений от средних, условия применения и ограничения.
Преобразование Бокса-Кокса: формула и пример
Преобразование Бокса-Кокса: формула, расчёт для положительных данных, выбор параметра λ и обратный переход. Как применять метод в эконометрической регрессии.
Теорема Гаусса-Маркова: условия и пример
Теорема Гаусса-Маркова объясняет эффективность МНК среди линейных несмещённых оценок. Разберём условия BLUE, доказательство, ограничения и пример сравнения оценок.
Тест Чоу: проверка структурного сдвига в регрессии
Тест Чоу проверяет стабильность коэффициентов регрессии при известной точке разрыва. Разбираем формулу F, расчёт, условия применения и интерпретацию результата.
Коэффициент автокорреляции остатков: формула и интерпретация
Коэффициент автокорреляции остатков первого порядка: формула AR(1), связь с тестом Дарбина-Уотсона, оценка по МНК и способы устранения автокорреляции в регрессии.