Логит-модель: формула, пример и смысл коэффициентов
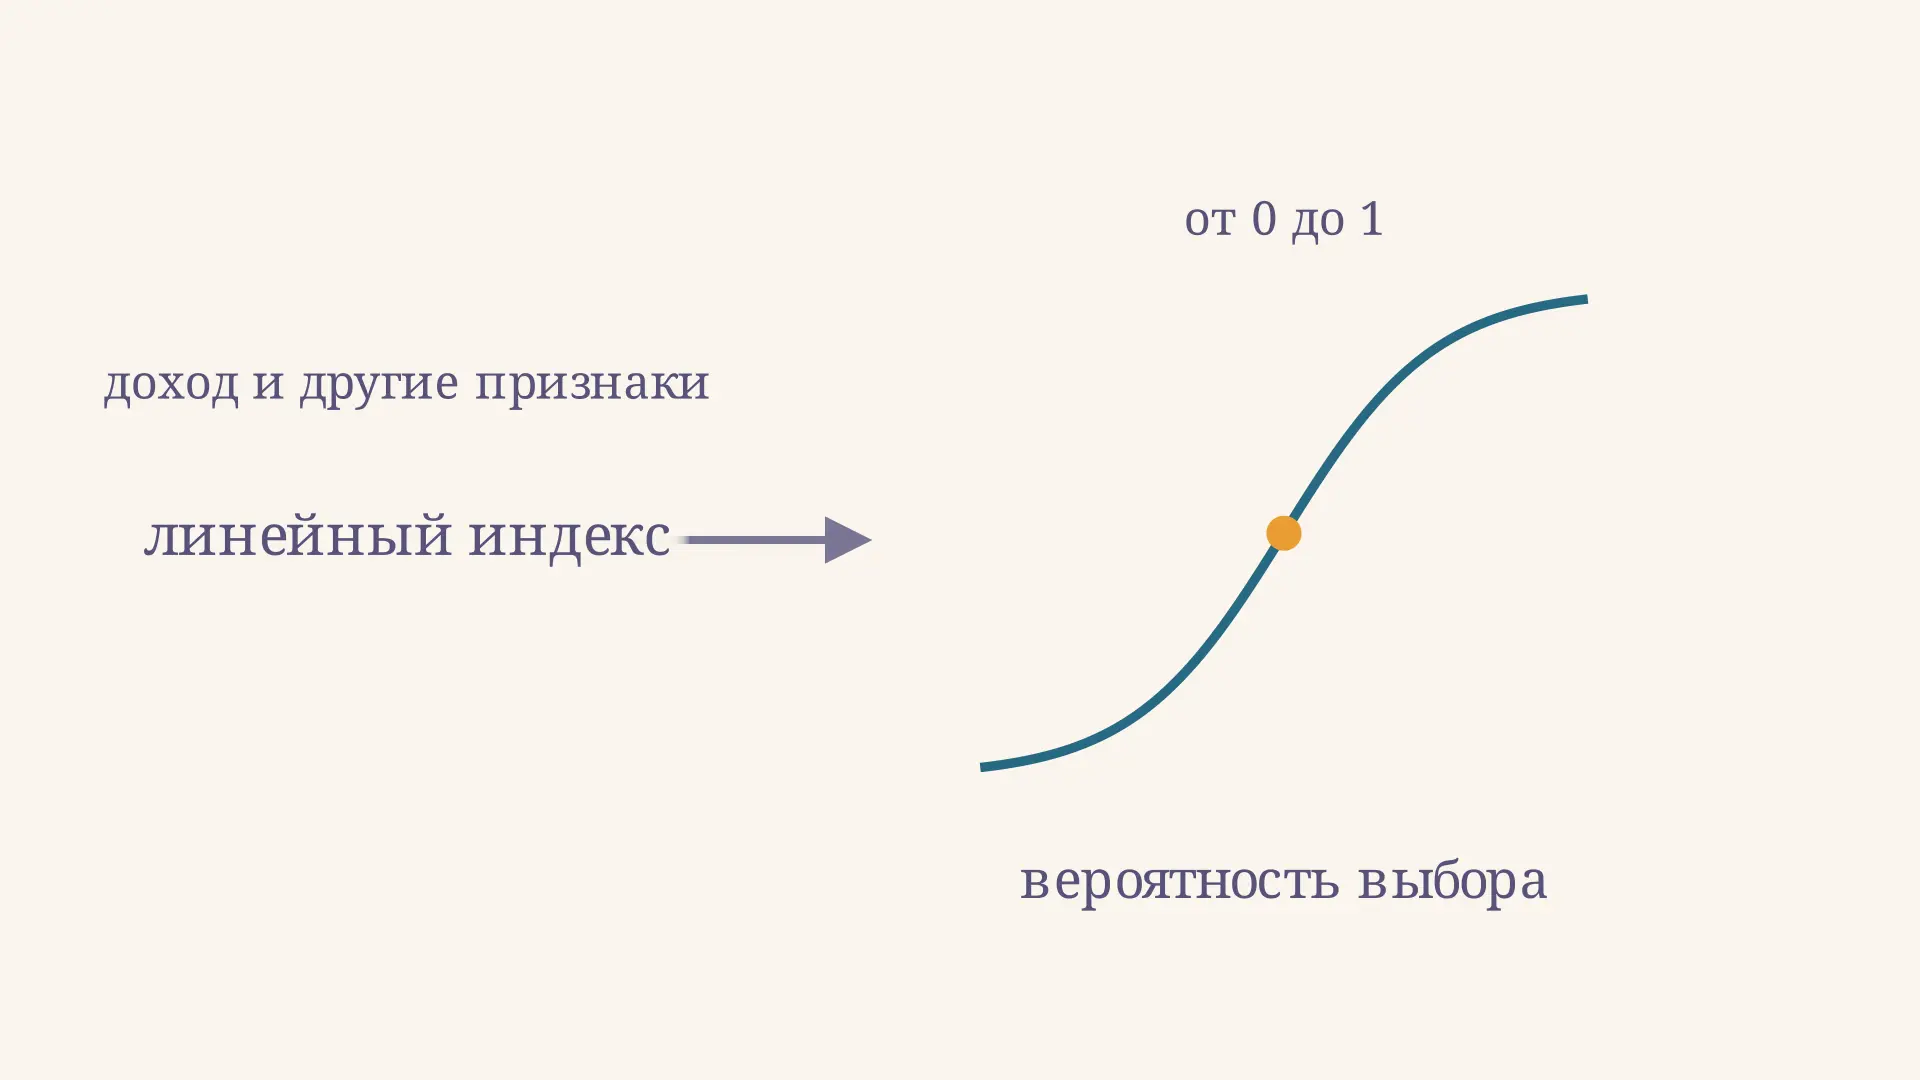
Логит-модель описывает вероятность события с двумя исходами: например, купит ли человек товар или откажется от покупки. Она связывает признаки наблюдения с вероятностью через S-образную логистическую функцию, поэтому расчёт всегда даёт значение между нулём и единицей. В эконометрике её используют для анализа участия в рынке труда, получения кредита и других решений типа «да или нет». В калькуляторе можно изменить доход в учебном примере и увидеть, как меняются вероятность и шансы.
От бинарного исхода к вероятности
Пусть , если человек совершил покупку, и , если нет. Модель не утверждает, что человек купил товар на 60 %. Она оценивает условную вероятность для наблюдений с заданными признаками . В учебном примере это доход; в исследовании могут учитываться цена, возраст, состав семьи и другие переменные.
Результаты отдельных людей остаются нулями и единицами, хотя предсказанная вероятность может быть любой между ними. Если для большой группы одинаковых по учтённым признакам людей модель хорошо откалибрована и назначает вероятность 0,6, примерно 60 % таких событий в среднем должны происходить. Это утверждение о частоте в группе, а не гарантия исхода для конкретного человека.
Прямая регрессия вероятности проста для чтения, но её прогнозы могут оказаться меньше нуля или больше единицы. Логистическая функция устраняет эту проблему для конечного набора коэффициентов и признаков. При этом корректный диапазон сам по себе ещё не доказывает качество прогноза.
Формула логита и обратное преобразование
Сначала признаки складывают с весами в линейный индекс:
Здесь - свободный член, а - коэффициент при признаке . Затем индекс переводят в вероятность события:
Обратное преобразование называется логитом: оно берёт натуральный логарифм шансов события. Именно логит, а не сама вероятность, в этой модели линеен по указанным признакам:
При вероятность равна 0,5; положительный индекс соответствует вероятности выше 0,5, отрицательный - ниже. При очень больших по модулю индексах кривая приближается к единице или нулю, но для конечного не достигает их. Линейность логита не требует линейной связи каждого исходного признака с ним: в индекс можно явно добавить, например, квадрат дохода или взаимодействие двух признаков.
Вероятность, шансы и отношение шансов
Вероятность сравнивает число событий со всеми исходами. Шансы сравнивают события с несобытиями. При шансы равны 1, то есть один к одному; при они равны 4, или четыре к одному. Значение шансов может быть больше единицы, в отличие от вероятности.
Если увеличился на единицу, а остальные признаки фиксированы, логит меняется на . Шансы при этом умножаются на . Это и есть отношение шансов для единичного изменения признака. Например, при коэффициенте 0,5 множитель равен : шансы растут примерно на 65 %, но вероятность не обязательно растёт на 65 % или на 65 процентных пунктов.
Смысл единицы измерения важен. Если доход выражен в десятках тысяч рублей, коэффициент относится к прибавке именно в 10 тысяч. Для изменения на две единицы множитель шансов составит . При взаимодействиях коэффициент одного признака нельзя интерпретировать без значения другого: соответствующее отношение шансов зависит от него. Различие шкал коэффициентов полезно учитывать и при чтении материала про стандартизованные коэффициенты регрессии.
Расчёт вероятности покупки
Возьмём искусственную модель, а не оценки по реальным покупателям. Пусть - месячный доход в десятках тысяч рублей, а индекс равен . При доходе 20 тысяч рублей , поэтому и
Вероятность покупки составляет около 26,9 %, а шансы - . Для 40 тысяч рублей : индекс равен нулю, вероятность 50 %, шансы 1. Для 60 тысяч рублей : индекс равен 1, вероятность около 73,1 %, шансы .
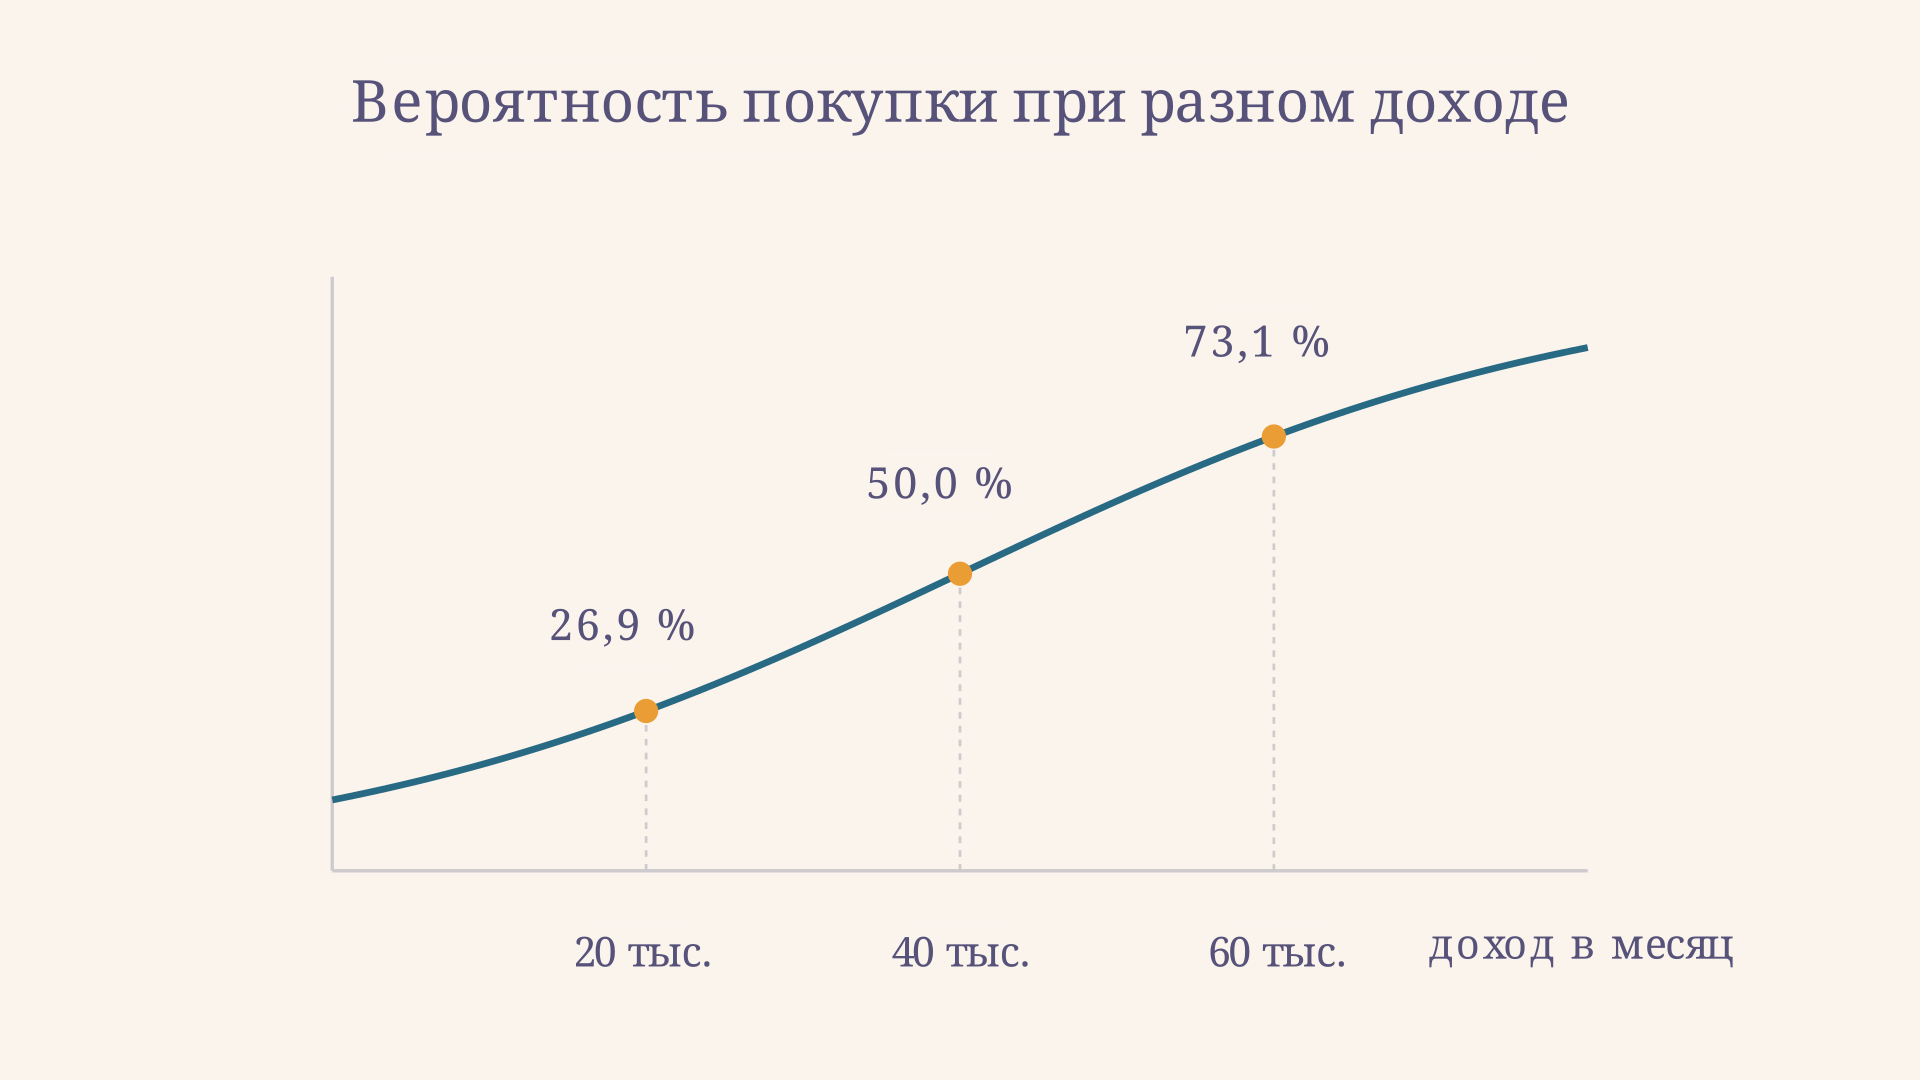
Переход от 40 к 50 тысячам рублей увеличивает индекс на 0,5: вероятность становится примерно 62,2 %, а шансы - 1,65. Калькулятор выше использует те же коэффициенты и единицы. Это иллюстрация механики модели, а не оценка влияния дохода на покупку в конкретной экономике.
Предельный эффект: почему прирост не постоянен
Для непрерывного признака без взаимодействий и нелинейных членов производная вероятности равна
При и она равна 0,125 на единицу : в этой точке очень малое увеличение дохода на 10 тысяч рублей соответствует локальному темпу 12,5 процентного пункта на единицу . Это производная, поэтому для конечной прибавки точнее пересчитать обе вероятности. От 40 до 50 тысяч фактическая разница составляет около 12,2 процентного пункта.
Ближе к нулю и единице множитель уменьшается. Поэтому один и тот же коэффициент логита даёт разные изменения вероятности в разных точках. Исследователь может сообщить эффект при выбранных признаках либо усреднить индивидуальные предельные эффекты по выборке. Для бинарного признака обычно понятнее вычислить конечную разность прогнозов при значениях 1 и 0, оставив прочие признаки фиксированными. Подробнее о различии отношения шансов и предельного эффекта пишет UCLA OARC.
Как оценивают и проверяют модель
Коэффициенты обычно находят методом максимального правдоподобия. Для наблюдения с вклад в правдоподобие равен , а для - . При независимых наблюдениях их произведение записывается так:
Численный алгоритм ищет коэффициенты, при которых наблюдённая комбинация нулей и единиц наиболее правдоподобна в рамках выбранной модели. Это не означает, что полученная модель истинна или что выборка представительна. Формулу правдоподобия и пример оценки приводит курс Penn State.
Перед оцениванием задают, какое событие кодируется единицей, и проверяют, в какой момент измерен каждый признак. Например, если нужно предсказать покупку до её совершения, сведения, появившиеся только после покупки, использовать нельзя: они создадут утечку информации. Полезно разделить данные так, чтобы итоговая проверка проходила на наблюдениях, не использованных для подбора модели. Для повторных наблюдений одного человека или данных за разные периоды способ разделения должен учитывать эту структуру.
Коэффициент представляет оценку с погрешностью: наряду с точечным значением рассматривают стандартную ошибку и доверительный интервал. Широкий интервал может означать, что данных недостаточно для точного определения величины связи. Отсутствие статистической значимости само по себе не доказывает, что связи нет; важно также проверить масштаб возможных эффектов.
После оценки смотрят на неопределённость коэффициентов, состав выборки и качество прогнозов на новых данных. Калибровка отвечает на вопрос, соответствуют ли прогнозируемые вероятности частотам событий; способность различать исходы - насколько модель ранжирует события выше несобытий. Это разные свойства. Если вероятности превращают в классы, порог выбирают с учётом цены ошибок: при пороге 0,5 значения не ниже него относят к единице. Последствия такого решения удобно изучать через матрицу ошибок.
Если признак идеально разделяет нули и единицы, обычные оценки максимального правдоподобия могут не иметь конечного решения. Малочисленные события, пропуски и сильная связь признаков друг с другом тоже осложняют оценивание. Нужны проверка данных и подходящий метод, а не механическое чтение одной таблицы коэффициентов.
Применение и ограничения
В экономике модель полезна, когда результат действительно бинарный и интерес представляет условная вероятность: одобрен кредит или нет, участвует человек в программе или нет. Для нескольких взаимоисключающих альтернатив применяют другие постановки, например мультиномиальный логит; связанная с преобразованием нескольких индексов функция softmax рассматривается отдельно.
Положительный коэффициент показывает условную связь признака с логитом при фиксированных остальных переменных. Он не доказывает причинного эффекта: доход может быть связан с ненаблюдаемыми предпочтениями, а отбор в выборку - с самим исходом. Для причинного вывода нужны дизайн исследования и дополнительные предпосылки. Прогнозы также могут ухудшаться за пределами диапазона данных или после изменения условий, в которых модель обучали. При большом числе взаимосвязанных признаков исследователь может отдельно рассмотреть метод главных компонент, учитывая, что преобразованные признаки сложнее интерпретировать.
Частые ошибки
- Принимать коэффициент за изменение вероятности: он выражен в единицах логита.
- Путать шансы с вероятностью и отношение шансов с отношением вероятностей.
- Использовать производную как точную разницу для большой прибавки признака.
- Называть связь причинной без обоснования и забывать единицы измерения признаков.
- Считать высокую долю верных классов достаточной проверкой вероятностей, особенно при редких событиях.
FAQ
Чем логит отличается от пробит-модели?
Обе модели применяют к бинарному исходу, но используют разные функции связи: логит основан на логистической функции, пробит - на функции распределения стандартной нормальной величины. Их коэффициенты имеют разные масштабы и не сравниваются напрямую.
Что означает отрицательный коэффициент?
При прочих равных увеличение соответствующего признака уменьшает логит и вероятность события. Отношение шансов тогда меньше единицы; сила изменения вероятности зависит от исходной точки.
Обязательно ли использовать порог 0,5?
Нет. Модель сначала выдаёт вероятность, а порог - отдельное решение для классификации. Его выбирают исходя из задачи, стоимости пропусков и ложных срабатываний и проверяют на подходящих данных.
Коротко
Логит-модель связывает линейный индекс с вероятностью бинарного события через логистическую функцию. Коэффициент меняет логарифм шансов, его экспонента даёт отношение шансов, а изменение самой вероятности зависит от исходной точки. Интерпретация требует ясных единиц измерения, проверки качества и осторожности с причинными выводами.
Читайте также
Пробит-модель: формула, пример и интерпретация
Пробит-модель для бинарного выбора: как получить вероятность через нормальное распределение, оценить коэффициенты и рассчитать предельный эффект на примере.
Бесповторный отбор: формулы и пример расчёта
Бесповторный отбор в статистике: как меняются вероятности, рассчитать состав случайной выборки и учесть конечную совокупность на примере контроля партии.
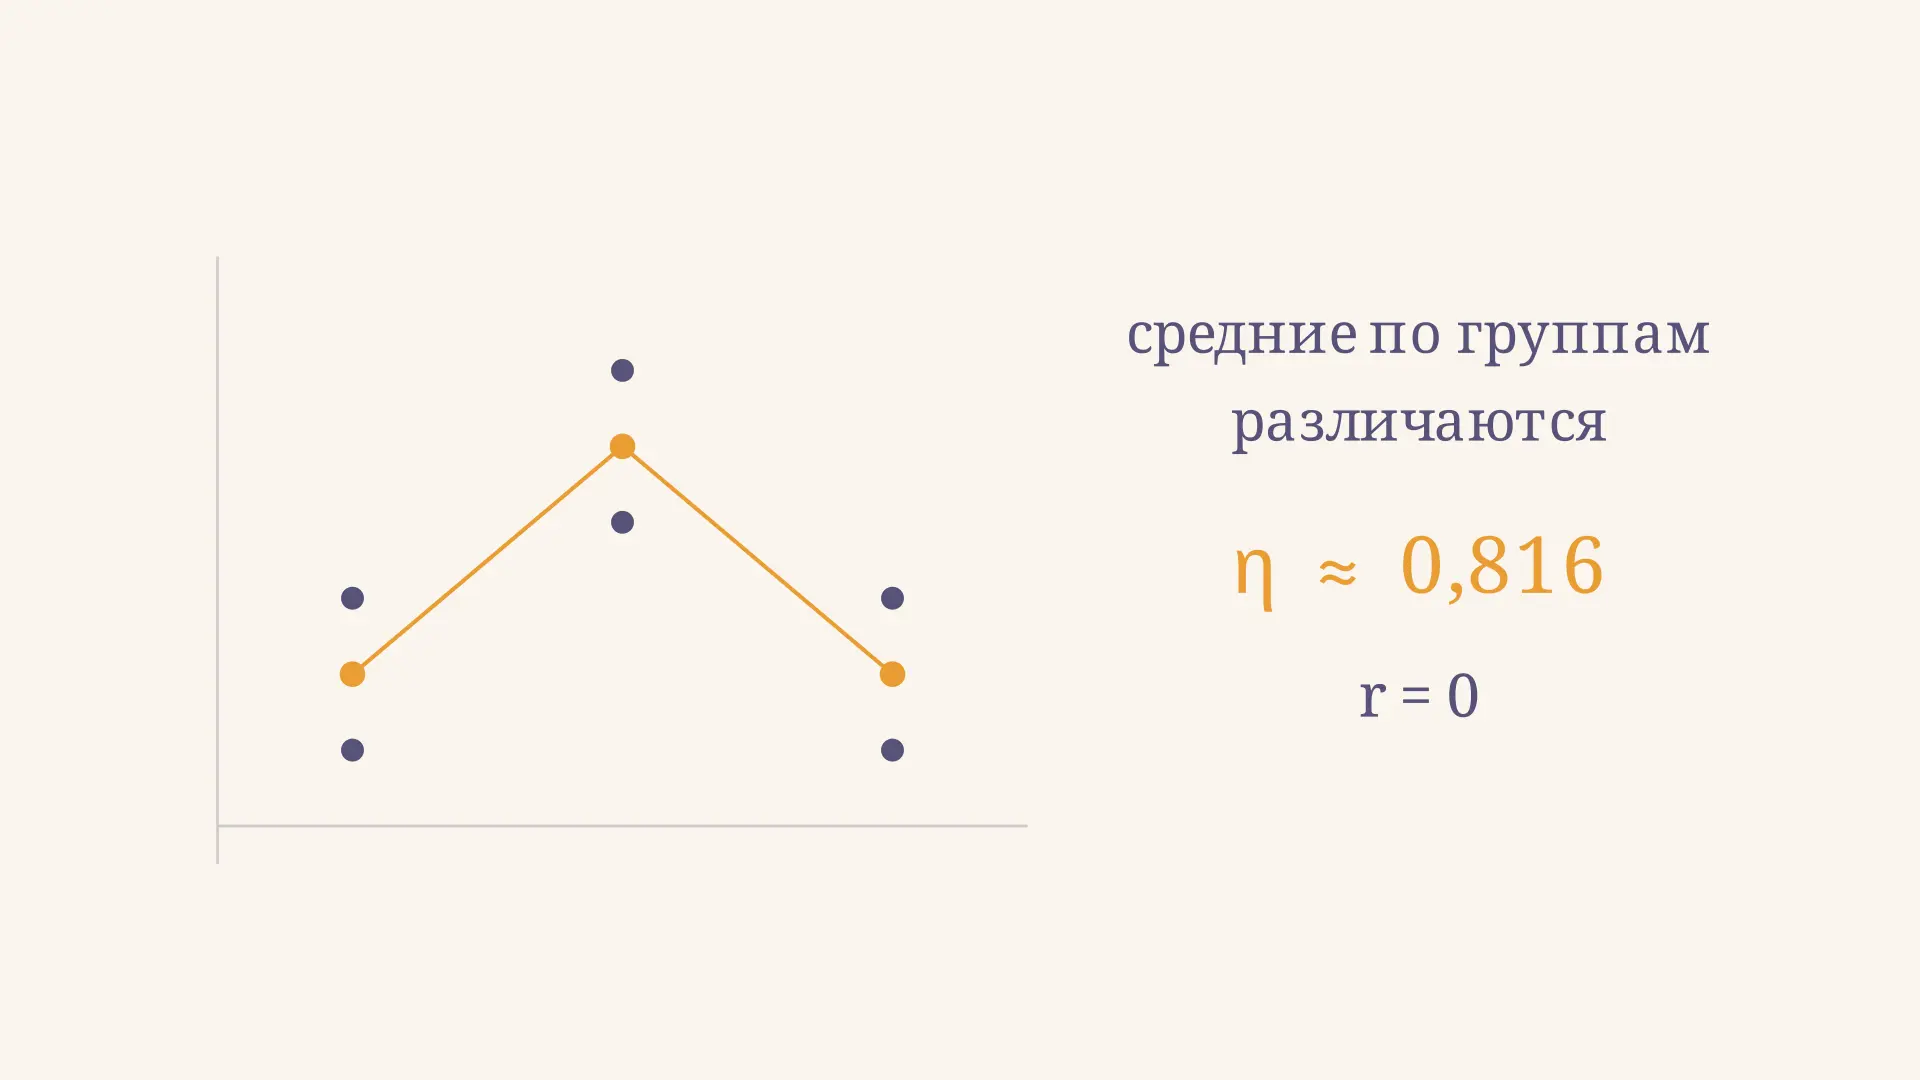
Индекс корреляции: формула и пример расчёта
Как рассчитать индекс корреляции по группам и остаткам модели, прочитать его квадрат и отличить нелинейную связь от коэффициента Пирсона: пример с таблицей.
Коинтеграция: как найти долгосрочную связь рядов
Коинтеграция временных рядов простыми словами: как проверить стационарность остатка, провести тест Энгла и Грейнджера и понять модель коррекции ошибки на примере.
Модель Хольта-Винтерса: формулы и пример прогноза
Модель Хольта-Винтерса для сезонного временного ряда: формулы уровня, тренда и сезонности, пошаговый расчёт прогноза по кварталам и способы проверки его точности.
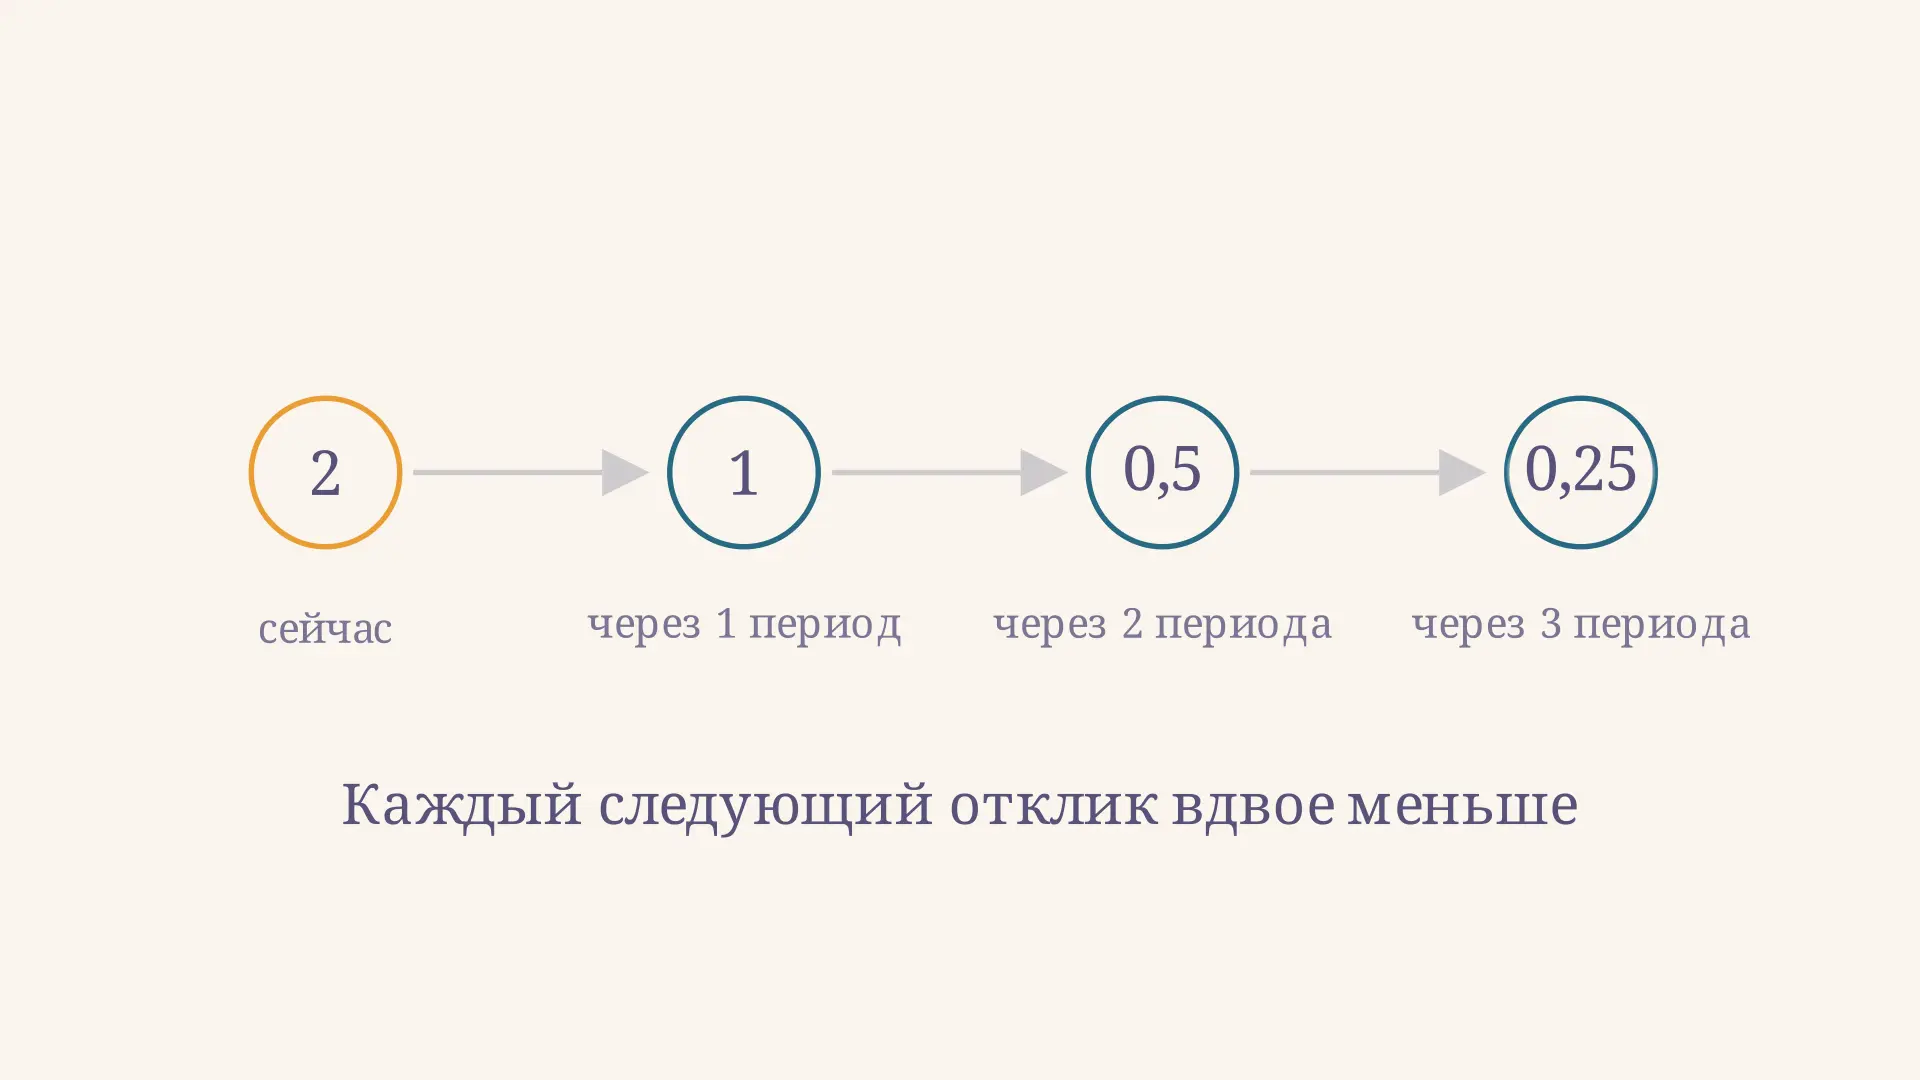
Модель Койка: формула распределённого лага и пример
Модель Койка в эконометрике: геометрическое убывание лагов, преобразование уравнения, краткосрочный и долгосрочный эффекты, средний лаг и пример расчёта.