Индекс корреляции: формула и пример расчёта
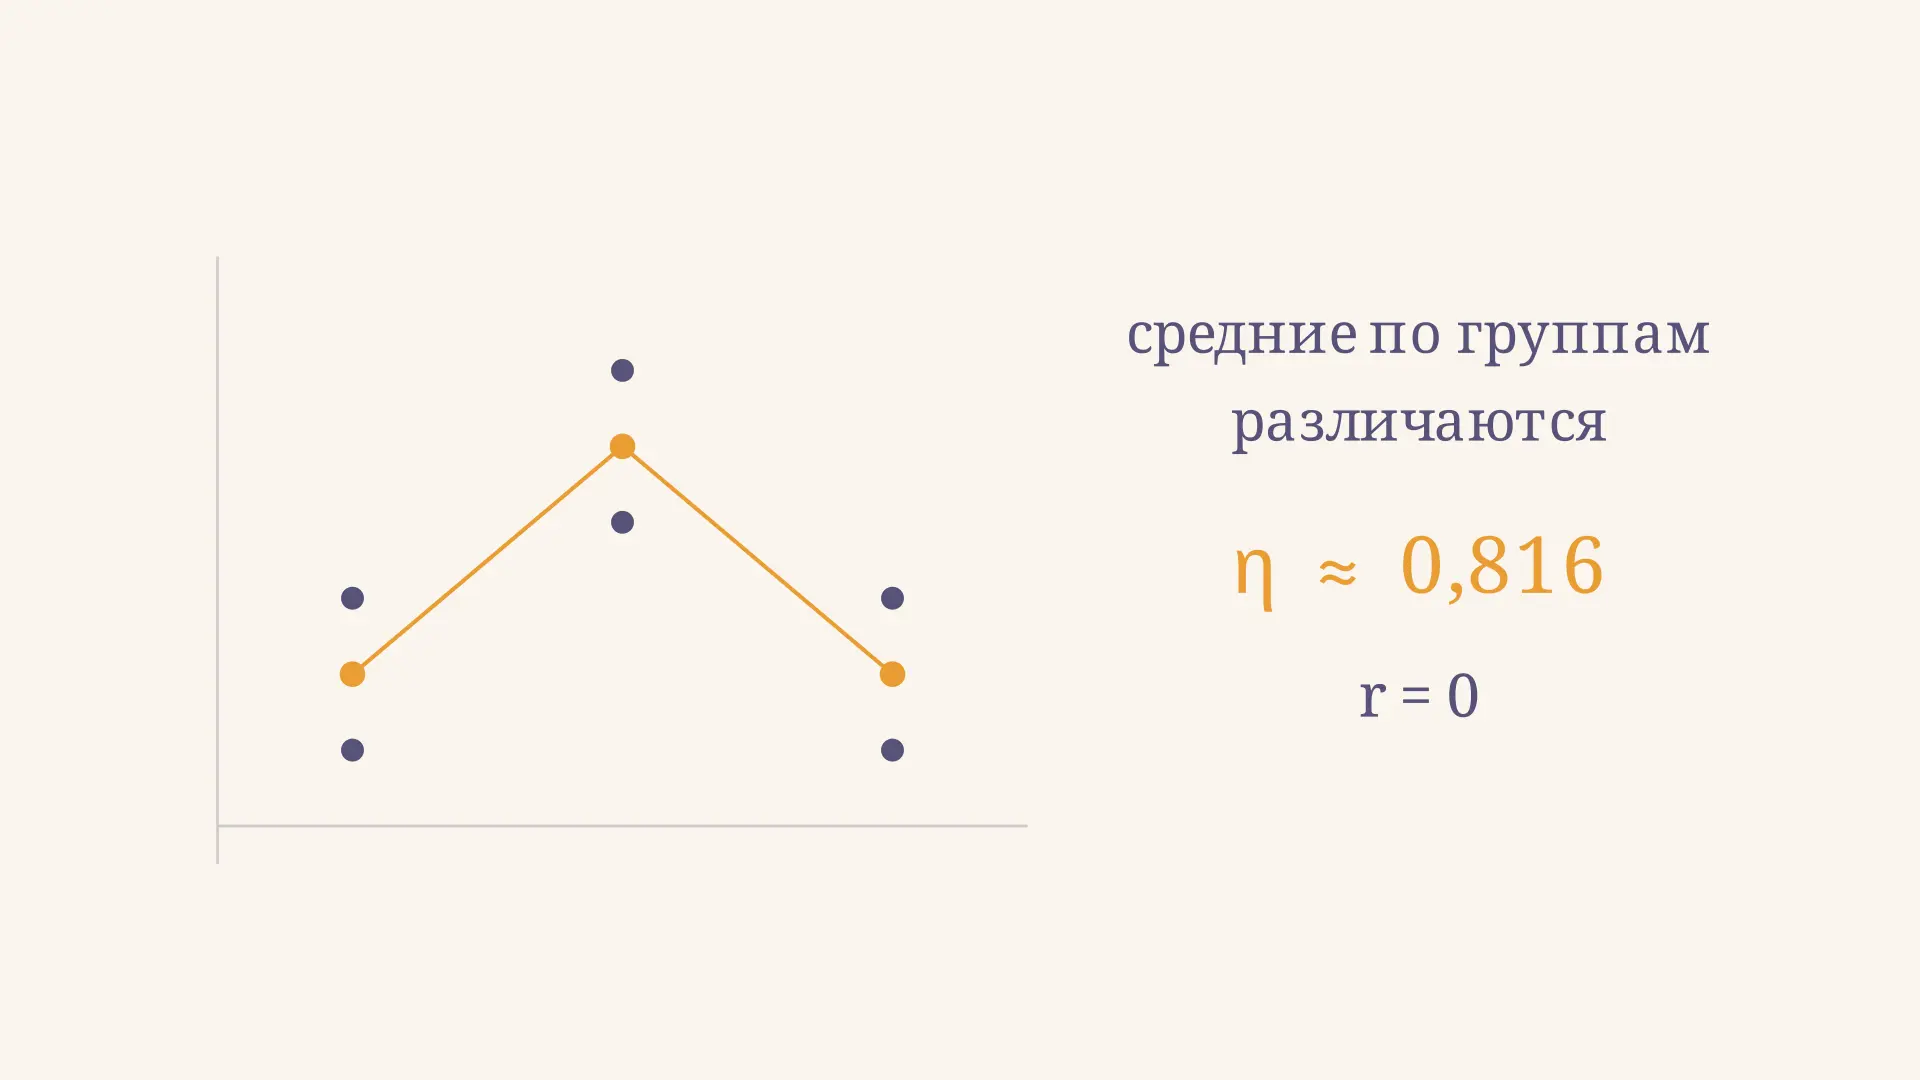
Индекс корреляции показывает, какая часть разброса результативного признака связана с выбранной моделью зависимости или группировкой по фактору. В отличие от коэффициента Пирсона, он может отражать и нелинейную форму связи. Его значение неотрицательно: направление изменения результата по одному числу не определить.
Разберём учебный пример связи затрат на рекламу и продаж. В калькуляторе можно менять разброс продаж внутри групп и наблюдать, как это влияет на индекс при неизменных групповых средних. Данные условные: они нужны для понимания расчёта, а не для вывода о реальном рынке.
Что измеряет индекс корреляции
Пусть обозначает фактор, а - результат. Если средние значения заметно различаются при разных значениях , группировка по фактору помогает описать изменчивость результата. Но даже внутри одной группы наблюдения могут отличаться: на продажи влияют и другие условия, и случайные колебания.
Индекс сопоставляет разброс, отражённый группами или моделью, с полным разбросом относительно общего среднего. Значение около единицы означает, что выбранное представление хорошо описывает вариацию в этой выборке. Значение около нуля означает, что оно почти не уменьшает разброс относительно простого прогноза общим средним. Это утверждение относится к конкретной группировке или модели, а не ко всем возможным зависимостям.
У термина есть особенности употребления. Для групповых средних часто пишут корреляционное отношение . Для подогнанной регрессии индекс нередко обозначают и находят как корень из коэффициента детерминации. Эти величины совпадают, если прогноз для каждого наблюдения равен среднему его группы. В других моделях результат зависит от выбранной функции; важно уточнять определение в условии задачи.
Формула через групповые средние
Разобьём наблюдения на групп по фактору . Пусть - число наблюдений в группе , - среднее результата в ней, - общее среднее, а - отдельное наблюдение. Тогда выборочное корреляционное отношение равно:
Числитель - межгрупповая сумма квадратов: насколько средние групп отклоняются от общего среднего с учётом численности каждой группы. Знаменатель - полная сумма квадратов отклонений всех наблюдений от общего среднего. Межгрупповая часть не превышает полную, поэтому при ненулевом знаменателе . Соответствующую формулу для группового отношения приводит NIST.
Если все значения одинаковы, знаменатель равен нулю и индекс не определён. Если каждое наблюдение выделить в отдельную группу, получится единица: это механический результат слишком подробной группировки, а не доказательство полезной зависимости. Поэтому размер и состав групп имеют значение.
Пример: затраты и продажи
Пусть три уровня затрат на рекламу обозначены числами 1, 2 и 3. Для каждого уровня есть два наблюдения продаж. Шесть пар образуют намеренно простой пример:
| Уровень затрат | Наблюдения | Число | Среднее |
|---|---|---|---|
| 1 | 1 и 3 | 2 | 2 |
| 2 | 4 и 6 | 2 | 5 |
| 3 | 1 и 3 | 2 | 2 |
Общее среднее равно . Взвешиваем отклонения групповых средних от него:
Внутри каждой группы наблюдения отклоняются от её среднего на и . Поэтому внутригрупповая сумма квадратов равна , а полная - . Отсюда:
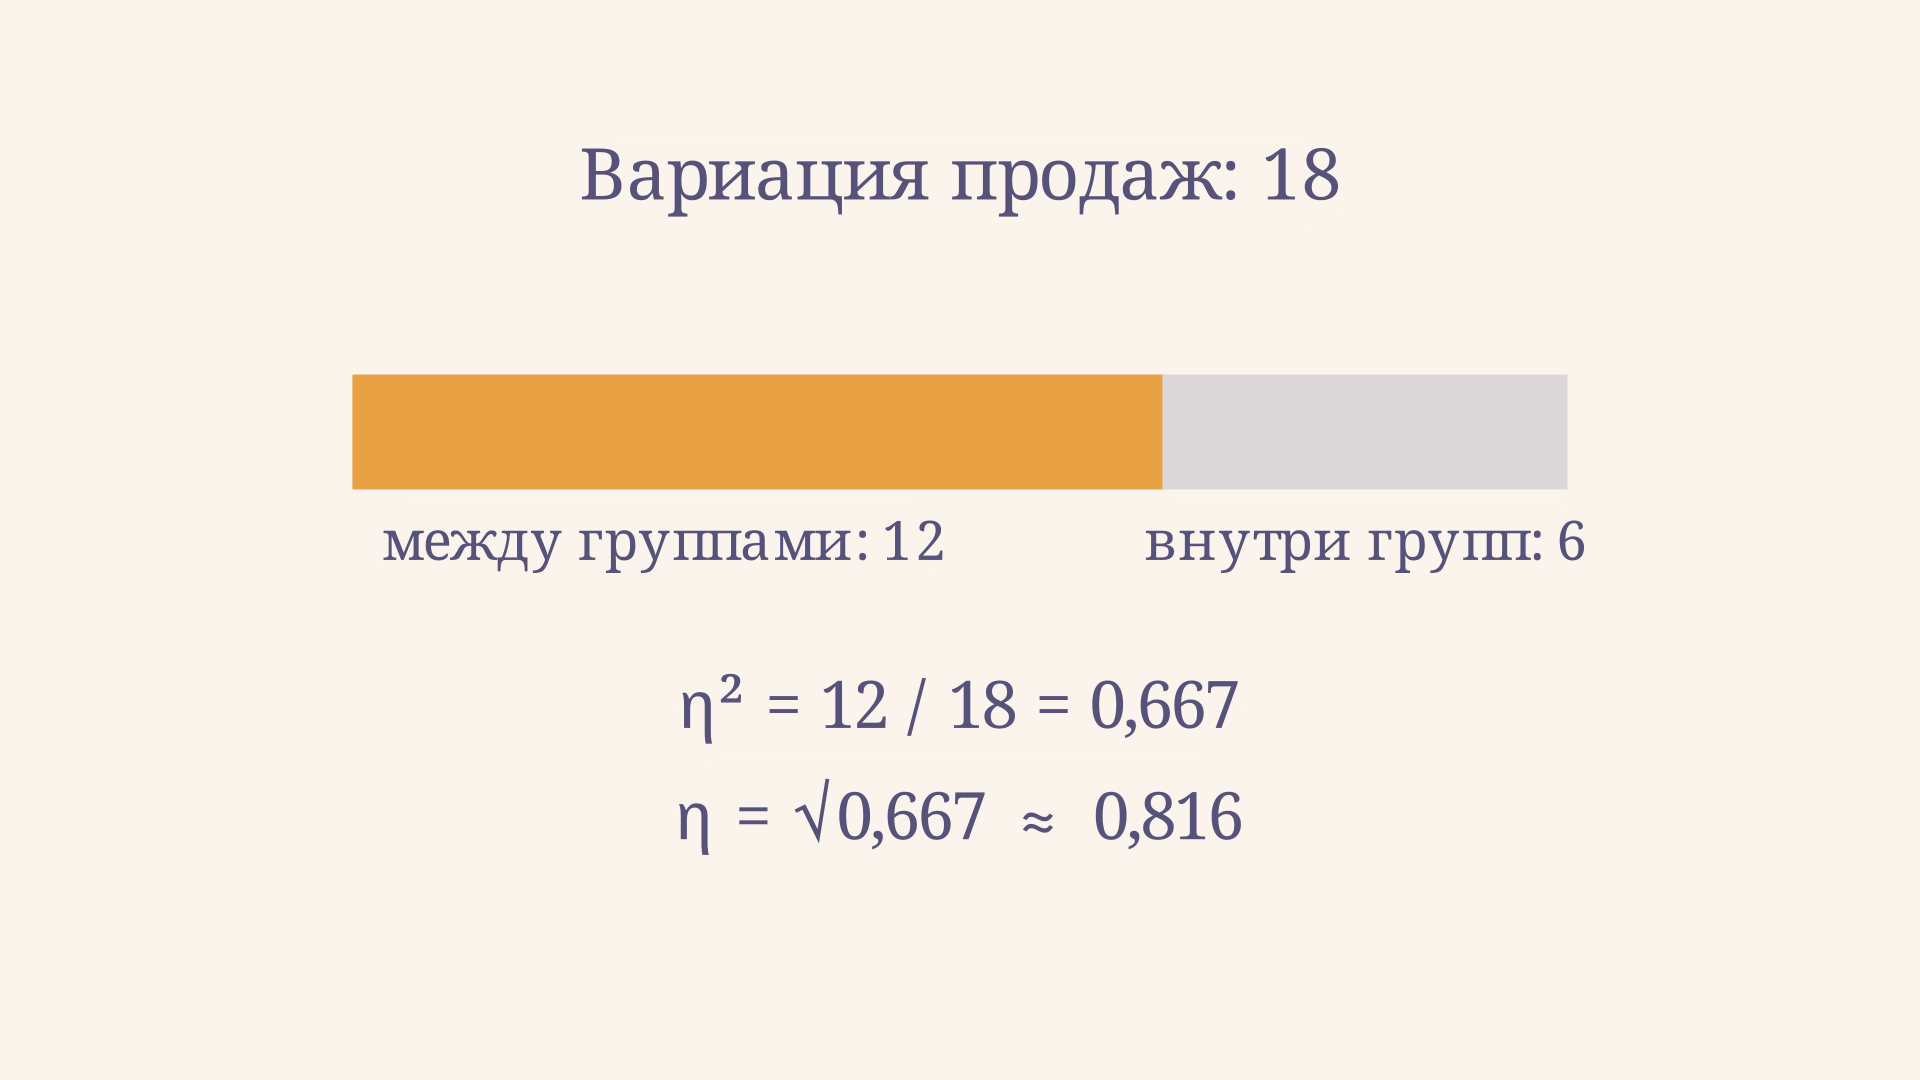
Интерпретация: около 66,7 % наблюдаемой вариации продаж относительно общего среднего приходится на различия средних трёх групп. Это не значит, что реклама вызвала 66,7 % продаж или что прогноз для нового магазина будет столь же точным. Доля относится к вариации в условной выборке, а не к сумме продаж.
Как связаны индекс и остатки регрессии
При наличии расчётных значений определим общую и остаточную суммы квадратов:
Для обычной регрессии методом наименьших квадратов с константой, в том числе с полиномиальными признаками, коэффициент детерминации лежит от нуля до единицы на обучающей выборке. Индекс модели в этом случае можно записать как . Если вместо регрессии использовать средние групп как прогнозы, остатки в примере дают и тот же результат . Разложение суммы квадратов и смысл разобраны в материале Penn State.
Но без константы, при произвольно заданных прогнозах или на новых данных может оказаться отрицательным. Тогда действительный корень из него не существует: нельзя автоматически применять формулу индекса. При сравнении моделей полезно смотреть не только на обучающий , но и на ошибки на отложенных данных. Подробнее о поправке на сложность модели - в статье про скорректированный коэффициент детерминации.
Чем индекс отличается от коэффициента Пирсона
Выборочный коэффициент Пирсона измеряет направление и тесноту линейной связи и принимает значения от до . Индекс не имеет знака и может учитывать изгиб, если его отражает модель или группировка.
В примере средняя продажа сначала растёт с 2 до 5, затем падает до 2. Симметрия относительно среднего уровня затрат даёт нулевую ковариацию, поэтому . При этом групповые средние различаются и . Нулевой не исключает нелинейную связь. Обратно, высокий индекс не сообщает, растёт результат или падает: для этого нужны график и вид зависимости.
В парной линейной регрессии с константой на тех же данных , а потому . В нашем примере линейная модель даёт ноль, но групповые средние описывают другую, нелинейную форму. Выбор формы модели обсуждается в статье о нелинейной регрессии.
Как выбрать группировку
Границы групп задают то, какие различия попадут в межгрупповую часть. Если затраты непрерывны, соседние значения можно объединить в интервалы, но широкие интервалы скроют изменения средних внутри них. Слишком узкие интервалы, напротив, оставят мало наблюдений в каждой ячейке: их средние будут чувствительны к отдельным магазинам. При сравнении нескольких расчётов желательно сохранять одинаковые границы и заранее объяснять их выбор.
Направление записи тоже существенно. В нашем расчёте группируют по затратам и измеряют разброс продаж, поэтому это . Если поменять признаки местами, потребуется заново группировать данные и считать разброс затрат. В общем случае полученное отношение не обязано совпасть с исходным. Коэффициент Пирсона, напротив, симметричен при перестановке двух признаков.
На краях диапазона калькулятора видно, что означает остаточная вариация. При отклонении ноль все две продажи в каждой группе совпадают со средним этой группы: остаток равен нулю, а индекс - единице. При отклонении два сумма квадратов внутри групп равна 24, полная - 36, поэтому индекс снижается до . Различия групповых средних при этом остаются прежними. Это сравнение специально меняет только разброс; реальная экономическая зависимость может меняться сразу по нескольким причинам.
Как использовать результат в экономической задаче
Сначала уточните единицу наблюдения, период и способ формирования групп: сравнение магазинов за месяц и сравнение одного магазина по месяцам отвечают на разные вопросы. Постройте диаграмму рассеяния и проверьте численности групп, выбросы и пропуски. Затем выберите группировку или модель, рассчитайте суммы квадратов и отдельно сообщите индекс и его квадрат.
Высокое значение на той же выборке, по которой подбирали сложную модель, может быть следствием переобучения. Сравните прогнозы с отложенными наблюдениями и проверьте устойчивость к разумному изменению группировки. Статистическая связь сама по себе не устанавливает причинность: например, успешные магазины могут одновременно больше тратить на рекламу и иметь выгодное расположение.
Если нужна оценка неопределённости или проверка гипотезы, выбирайте метод под план исследования и модель. Нельзя без обоснования применять к произвольному индексу формулу проверки линейного ; условия такой проверки отдельно описаны в статье о значимости коэффициента корреляции.
Частые ошибки
- Приписывать индексу знак. неотрицателен; о направлении судят по средним или графику.
- Путать индекс и его квадрат. В примере 0,816 - индекс, а 66,7 % - доля вариации, соответствующая его квадрату.
- Игнорировать размеры групп. При неравных средние взвешивают по числу наблюдений; простое среднее групповых средних обычно не равно общему.
- Объявлять связь причинной. Групповые различия могут отражать другие факторы или способ отбора наблюдений.
- Считать единицу гарантией прогноза. Чрезмерно детальная группировка способна точно описать имеющиеся данные и плохо работать на новых.
FAQ
Может ли индекс корреляции быть отрицательным? Нет, если он определён как неотрицательный квадратный корень из доли вариации. Отрицательным может быть коэффициент Пирсона или показатель на новых данных, но не действительный индекс в этом определении.
Всегда ли индекс больше модуля коэффициента Пирсона? Для корреляционного отношения по точным группам значений числового на одной выборке верно . Для произвольной регрессионной модели или другой группировки такое сравнение без дополнительных условий не гарантировано.
Что означает индекс, равный нулю? При положительной полной вариации групповой индекс равен нулю, когда все групповые средние совпадают с общим. При этом распределения внутри групп всё ещё могут различаться, а другая группировка - выявить иную картину.
Коротко
Индекс корреляции описывает тесноту связи результата с выбранными группами или моделью; его квадрат показывает соответствующую долю вариации. В примере , хотя : средние сначала растут, затем падают. Для вывода нужны определение индекса, данные, форма модели и проверка её качества за пределами обучающей выборки.
Читайте также
Правило сложения дисперсий: межгрупповая и внутригрупповая
Правило сложения дисперсий разбивает общую изменчивость на межгрупповую и внутригрупповую части. Формулы, пример расчёта, связь с ANOVA и эконометрикой.
Дисперсия альтернативного признака: формула и пример
Как найти дисперсию альтернативного признака по доле или частотам, почему её максимум равен 0,25 и чем разброс единичного признака отличается от ошибки доли.
Дисперсия интервального вариационного ряда: расчёт
Как найти дисперсию интервального вариационного ряда по серединам и частотам: подробная таблица, две формулы, исправленная оценка и ограничения группировки.
Коинтеграция: как найти долгосрочную связь рядов
Коинтеграция временных рядов простыми словами: как проверить стационарность остатка, провести тест Энгла и Грейнджера и понять модель коррекции ошибки на примере.
Логит-модель: формула, пример и смысл коэффициентов
Как логит-модель описывает бинарный выбор: формула вероятности, шансы и отношение шансов, расчёт на примере дохода, оценивание и границы интерпретации.
Модель Хольта-Винтерса: формулы и пример прогноза
Модель Хольта-Винтерса для сезонного временного ряда: формулы уровня, тренда и сезонности, пошаговый расчёт прогноза по кварталам и способы проверки его точности.