Дисперсия альтернативного признака: формула и пример
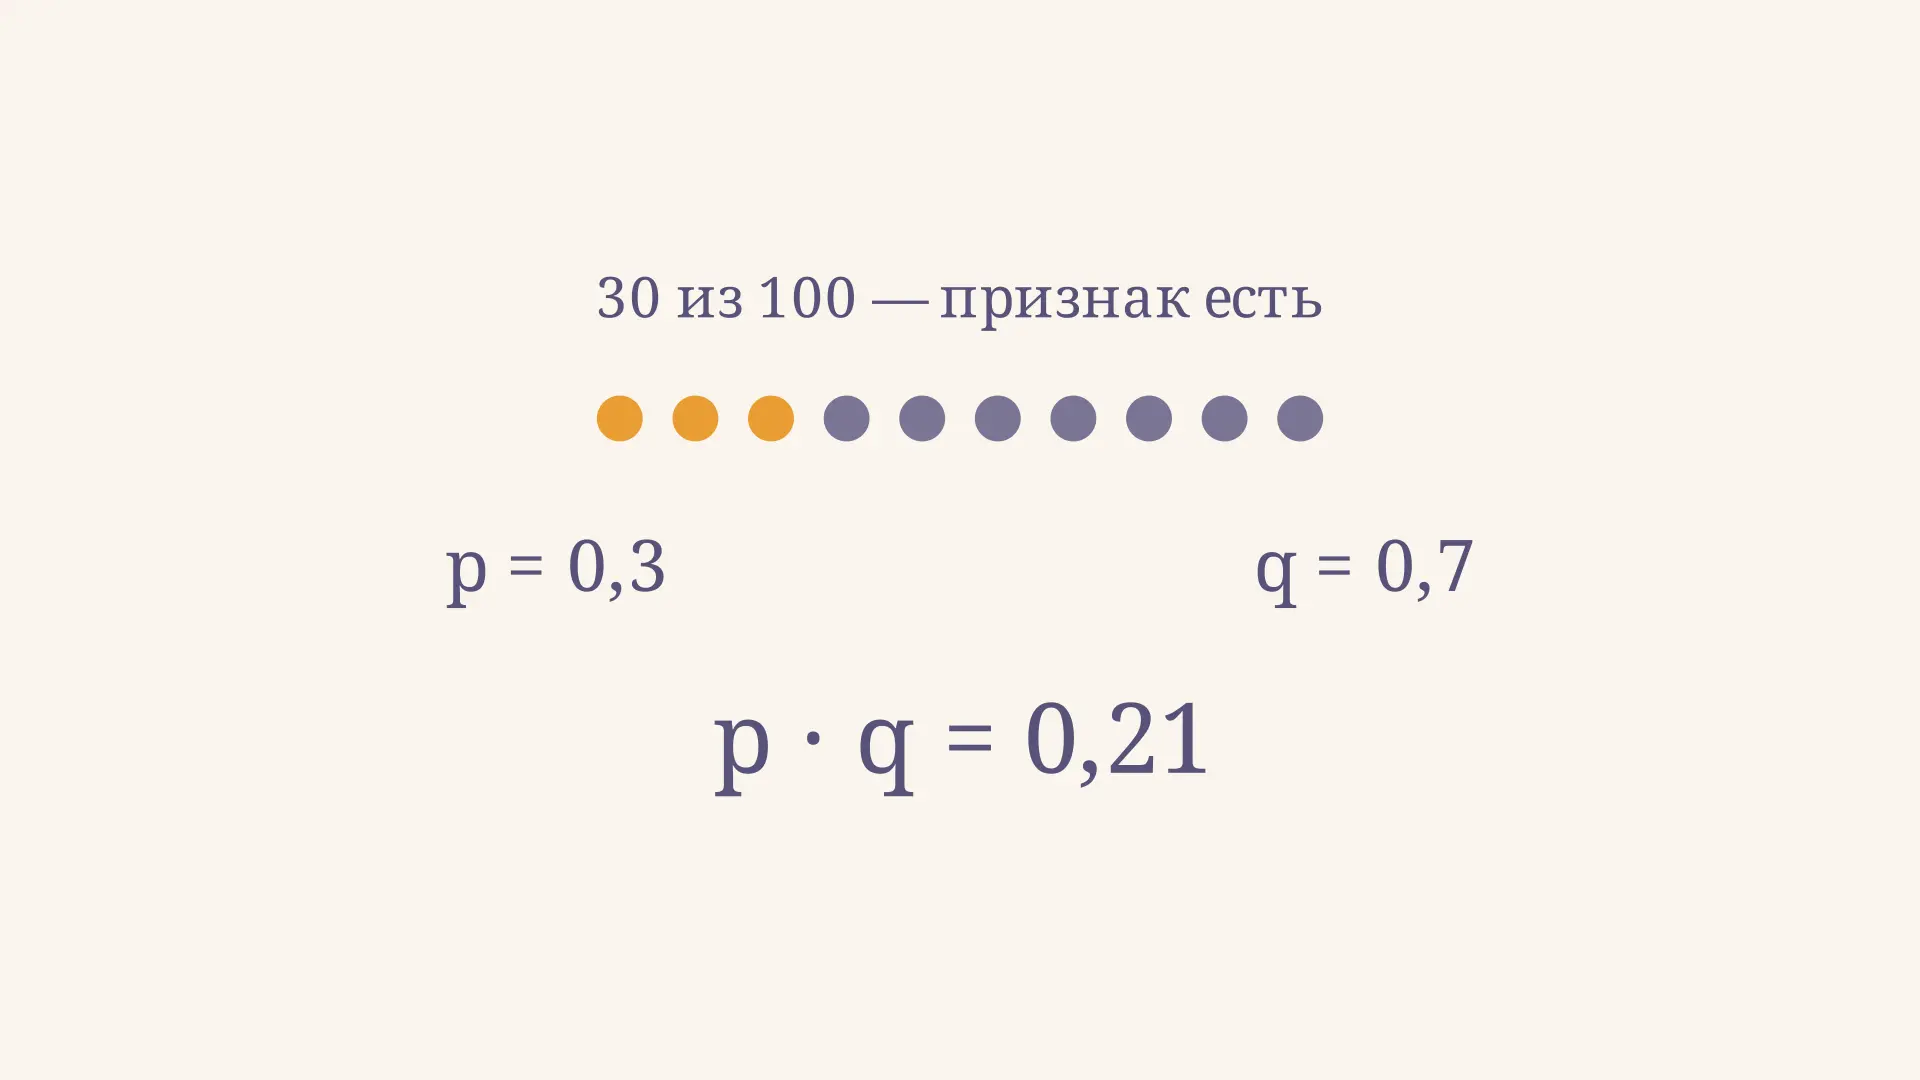
Дисперсия альтернативного признака показывает, насколько различаются объекты по свойству с двумя исходами: например, покупатель оформил доставку или нет. Если наличие свойства обозначить единицей, а отсутствие нулём, дисперсия равна произведению доли единиц на долю нулей: . Для доли 30 % она составляет . Измените долю в калькуляторе и обратите внимание, где разброс наибольший. Ниже разберём формулу, расчёт по данным и отличие разброса отдельных объектов от ошибки выборочной доли.
Что называют альтернативным признаком
Альтернативный признак делит изучаемую совокупность на две взаимоисключающие группы. У изделия есть дефект или его нет; сотрудник прошёл обучение или не прошёл; клиент выбрал доставку или самовывоз, если в задаче действительно предусмотрены только эти два варианта. Сначала нужно точно определить объект наблюдения, период и само свойство: иначе граница между группами останется неясной.
Положим для наличия признака и для отсутствия. Вероятность или долю единиц обозначим , а нулей - . Значения и лежат между нулём и единицей и вместе дают единицу. Проценты перед вычислением переводят в доли: 30 % - это , а не 30. К примеру, генеральная совокупность и выборка различаются тем, ко всем ли интересующим объектам относится доля или только к наблюдённой части.
Здесь «альтернативный» описывает способ кодирования, а не качество объекта: единица не обязана означать успех в бытовом смысле. Выбор метки влияет на название доли, но при замене нулей единицами значение дисперсии не изменится.
Формула и её вывод
Для случайного индикатора математическое ожидание равно . Дисперсия - средний квадрат отклонения от этого ожидания. Поэтому
Первое слагаемое учитывает единицы, второе - нули; их веса равны вероятностям соответствующих исходов. Получается и короткий вывод: поскольку для нуля и единицы , то , следовательно, . Такое распределение отдельного индикатора называют распределением Бернулли; формулы ожидания и дисперсии приведены в учебных материалах Penn State.
Если обозначить частоты единиц и нулей через и , то при общем числе наблюдений подставляют , . Важно, что дисперсия относится к числовому индикатору 0–1. Она не выражается в процентах покупателей и не равна доле единиц. Корень из неё, , - стандартное отклонение индикатора.
Расчёт по частотам: пример магазина
Пусть в учебном примере из 100 заказов 30 оформлены с доставкой, остальные 70 - без неё. В качестве единицы выбираем наличие доставки. Тогда , , и
Проверим результат через отклонения: у единиц отклонение от среднего , у нулей - . Их взвешенные квадраты дают . Среднее равно 0,3, хотя ни один заказ не принимает это значение: оно описывает среднюю долю единиц, а не отдельный заказ.
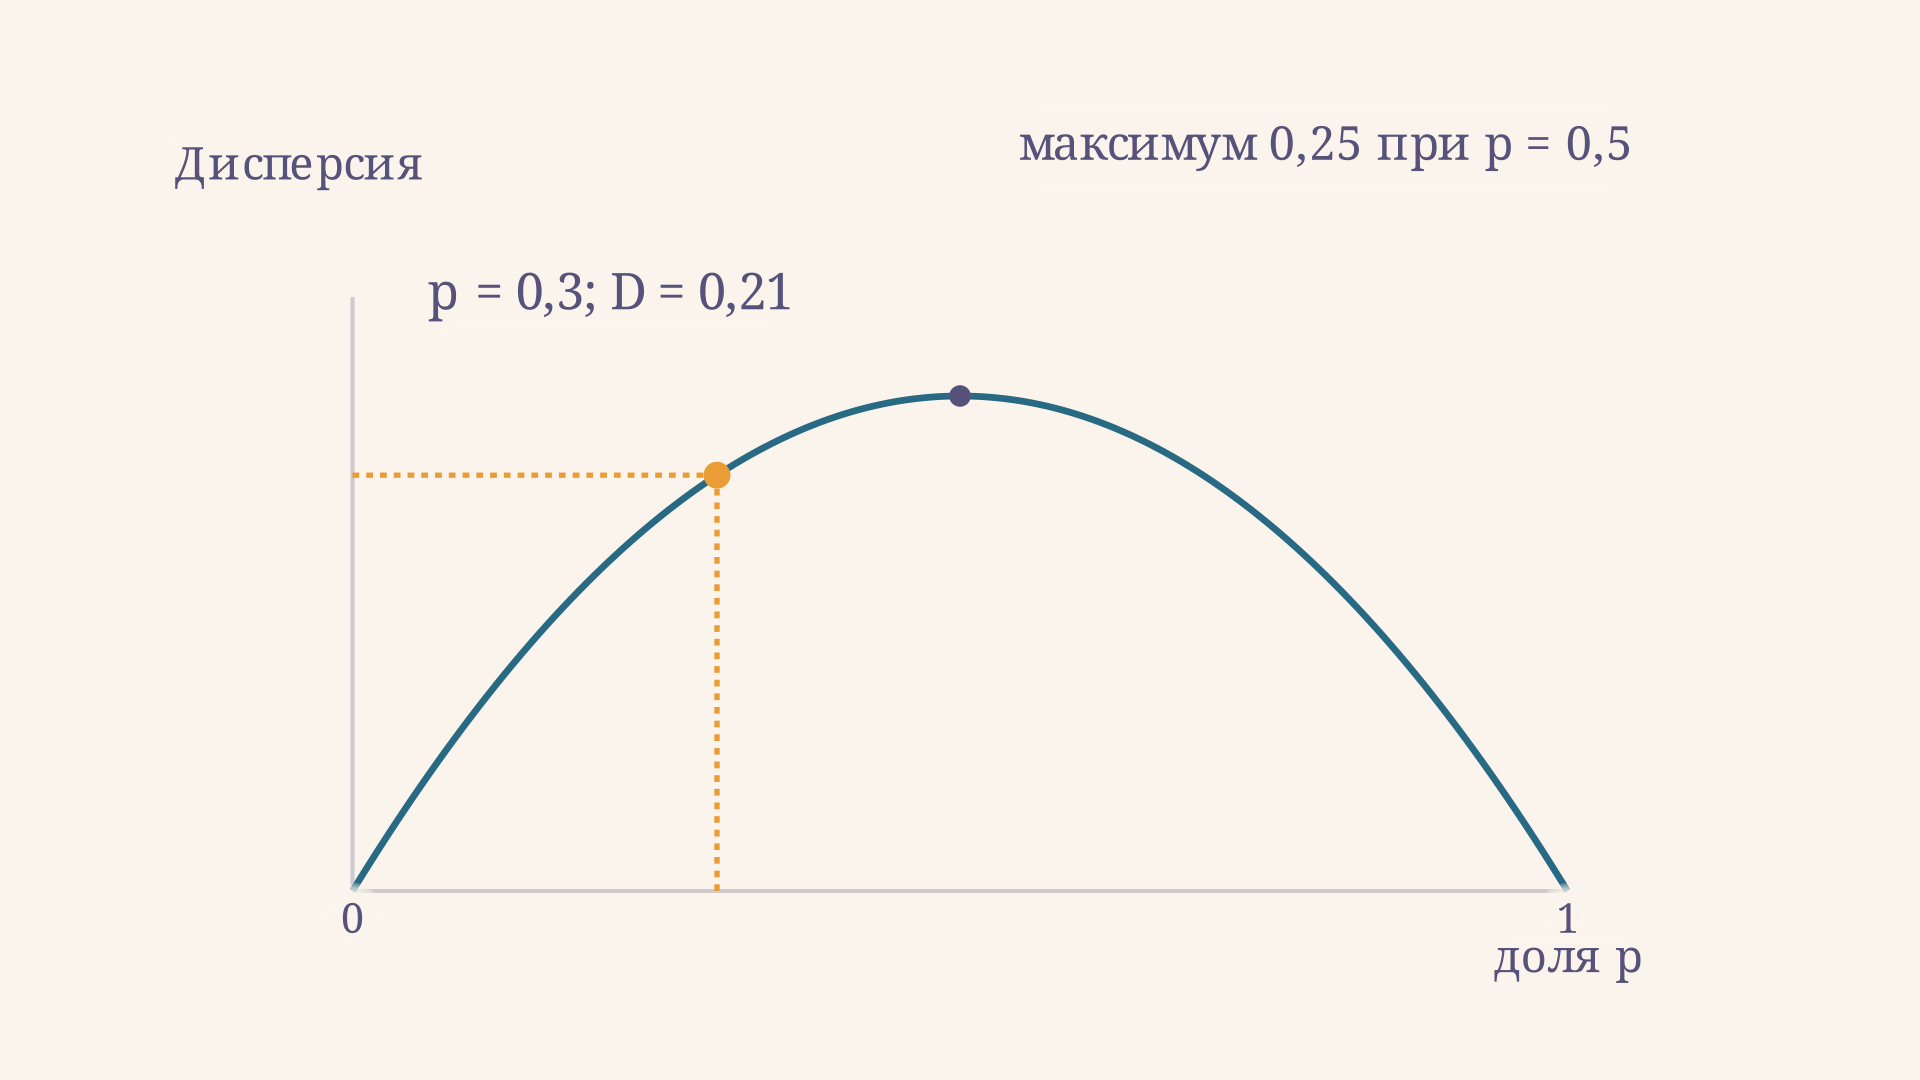
Этот расчёт описывает распределение признака в указанных 100 заказах с делением на . Он не доказывает, что в будущем ровно 30 % заказов будут с доставкой. Для вывода о более широкой совокупности нужно знать, как получены данные и насколько они представляют интересующих клиентов.
Почему максимум равен 0,25
Выражение можно записать как
Квадрат неотрицателен, поэтому дисперсия не превосходит . Равенство достигается при : обе категории одинаково представлены. При или дисперсия равна нулю, поскольку все значения индикатора одинаковы. Это не означает отсутствие неопределённости во всех других свойствах объектов: речь только о выбранном признаке.
График симметричен относительно половины: при и результат одинаков, . Если поменять смысл кодов и обозначить доставку нулём, доли поменяются местами, но произведение сохранится. Такая симметрия помогает проверить вычисление и объясняет, почему наиболее неоднородной по этому признаку является группа, разделённая поровну.
Выборочная дисперсия и дисперсия доли
Одно и то же произведение встречается в разных задачах, поэтому сначала выясняют, что именно измеряется. Описательная дисперсия наблюдённых нулей и единиц с делением на равна , где . В примере это . Если те же наблюдения рассматривают как выборку и требуется обычная исправленная выборочная дисперсия с делением на , для она равна
При 100 заказах получаем . Уточнение знаменателя важно в условии задачи: разные определения отвечают на разные вопросы. Если , исправленную дисперсию по этой формуле не вычисляют.
Дисперсия самой выборочной доли - другое понятие. Для независимых одинаково распределённых индикаторов с вероятностью она равна . При и это , а стандартная ошибка доли равна . Здесь предполагается известным параметром модели; на практике его часто оценивают выборочной долей. Эти формулы не следует автоматически переносить на зависимые наблюдения или любой способ отбора; при отборе без возвращения из конечной совокупности может потребоваться поправка. Различие разброса отдельных наблюдений и статистики выборки важно и при построении доверительного интервала.
Связь с числом событий
Пусть показывает наличие признака у объекта , а - число единиц. При независимости и одинаковой вероятности сумма имеет биномиальное распределение: , . Для модели со 100 независимыми заказами и ожидаемое число доставок равно 30, а дисперсия их числа - 21. Это модельные характеристики числа, а не дисперсия одного индикатора .
Деление суммы на даёт выборочную долю, поэтому её дисперсия равна . Условия независимости и одинаковой вероятности здесь существенны: например, заказы одного клиента могут быть связаны. Подробнее о последовательности испытаний см. схему Бернулли и математическое ожидание биномиального распределения.
Как использовать результат в экономической задаче
Результат удобно читать как показатель неоднородности по одному заранее определённому признаку. Допустим, аналитик сравнивает наличие безналичной оплаты в двух группах небольших магазинов. Если в первой группе такую оплату принимают 10 % магазинов, дисперсия индикатора составляет . Если во второй её принимают 50 %, дисперсия равна . Во второй группе ответы распределены ровнее между категориями, и именно в этом смысле разброс выше.
Однако сама дисперсия не отвечает, какой вариант оплаты выгоднее, сколько денег проходит через терминалы и почему магазины сделали тот или иной выбор. Доля в 10 % и доля в 90 % дают одинаковую дисперсию, хотя с точки зрения распространённости услуги это разные ситуации. Поэтому рядом с дисперсией всегда следует сообщать исходную долю и направление кодирования, а также численность и состав группы. Без них читателю трудно понять, какие данные стоят за одним числом.
Для сравнения периодов определение признака тоже должно оставаться одинаковым. Например, изменение в учёте временно закрытых точек может изменить наблюдаемую долю без реального изменения поведения действующих магазинов. Если используются данные опроса, стоит описать пропуски ответов: при удалении неответивших знаменатель относится только к ответившим, а не ко всем приглашённым. Правильная арифметика не устраняет смещение, возникшее при отборе или обработке данных.
Пошаговая проверка решения
Сначала запишите событие словами и проверьте, что каждому объекту можно присвоить ровно одно из двух значений. Затем найдите число единиц и число всех наблюдений, разделите первое на второе и получите долю. Вычтите её из единицы, перемножьте две доли и отдельно подпишите, какую дисперсию получили. При исходных частотах полезно проверить, что они в сумме дают общий объём: ошибка в знаменателе иначе испортит оба множителя.
В конце оцените правдоподобие результата. Отрицательная величина или значение выше 0,25 для кода 0–1 указывает на ошибку в данных либо вычислениях. Если единиц очень мало или почти все наблюдения равны единице, дисперсия должна быть близка к нулю. При исправленной выборочной дисперсии конечной выборки ограничение 0,25 уже не применяется напрямую из-за множителя с поправкой на знаменатель; поэтому проверку максимума используют именно для .
Частые ошибки
- Подставляют проценты вместо долей. При 30 % берут , а не ; результат обязательно находится от 0 до 0,25.
- Путают дисперсию и стандартное отклонение. Для примера это соответственно и примерно .
- Делят на без уточнения объекта. описывает отдельный индикатор; - дисперсию средней доли в указанной независимой модели.
- Смешивают описательную и исправленную дисперсию. При делителе появляется множитель .
- Игнорируют остальные варианты ответа. Если возможны доставка, самовывоз и отказ, сначала определите двоичное событие, например «доставка или не доставка».
FAQ
Может ли дисперсия быть больше 0,25?
Для индикатора, принимающего именно значения 0 и 1, нет. При другом числовом кодировании масштаб изменится: например, замена 1 на 100 увеличит дисперсию в раз.
Что делать, если дана только доля без числа наблюдений?
Для числа наблюдений достаточно не знать. Но для исправленной выборочной дисперсии и стандартной ошибки доли размер необходим; для последней нужны и предположения о способе получения данных.
Почему равные доли дают наибольшую дисперсию?
При половине единиц и половине нулей среднее равно 0,5, а каждое значение отстоит от него на 0,5. При движении доли к нулю или единице большинство значений сближается со средним, и взвешенный разброс уменьшается.
Коротко
Для альтернативного признака в кодировке 0–1 дисперсия равна : при доле 0,3 она составляет 0,21, а максимальное значение 0,25 достигается при доле 0,5. Уточняйте, описываете ли вы отдельные значения, исправленную выборочную дисперсию или неопределённость выборочной доли: их формулы и смысл различаются.
Читайте также
Дисперсия интервального вариационного ряда: расчёт
Как найти дисперсию интервального вариационного ряда по серединам и частотам: подробная таблица, две формулы, исправленная оценка и ограничения группировки.
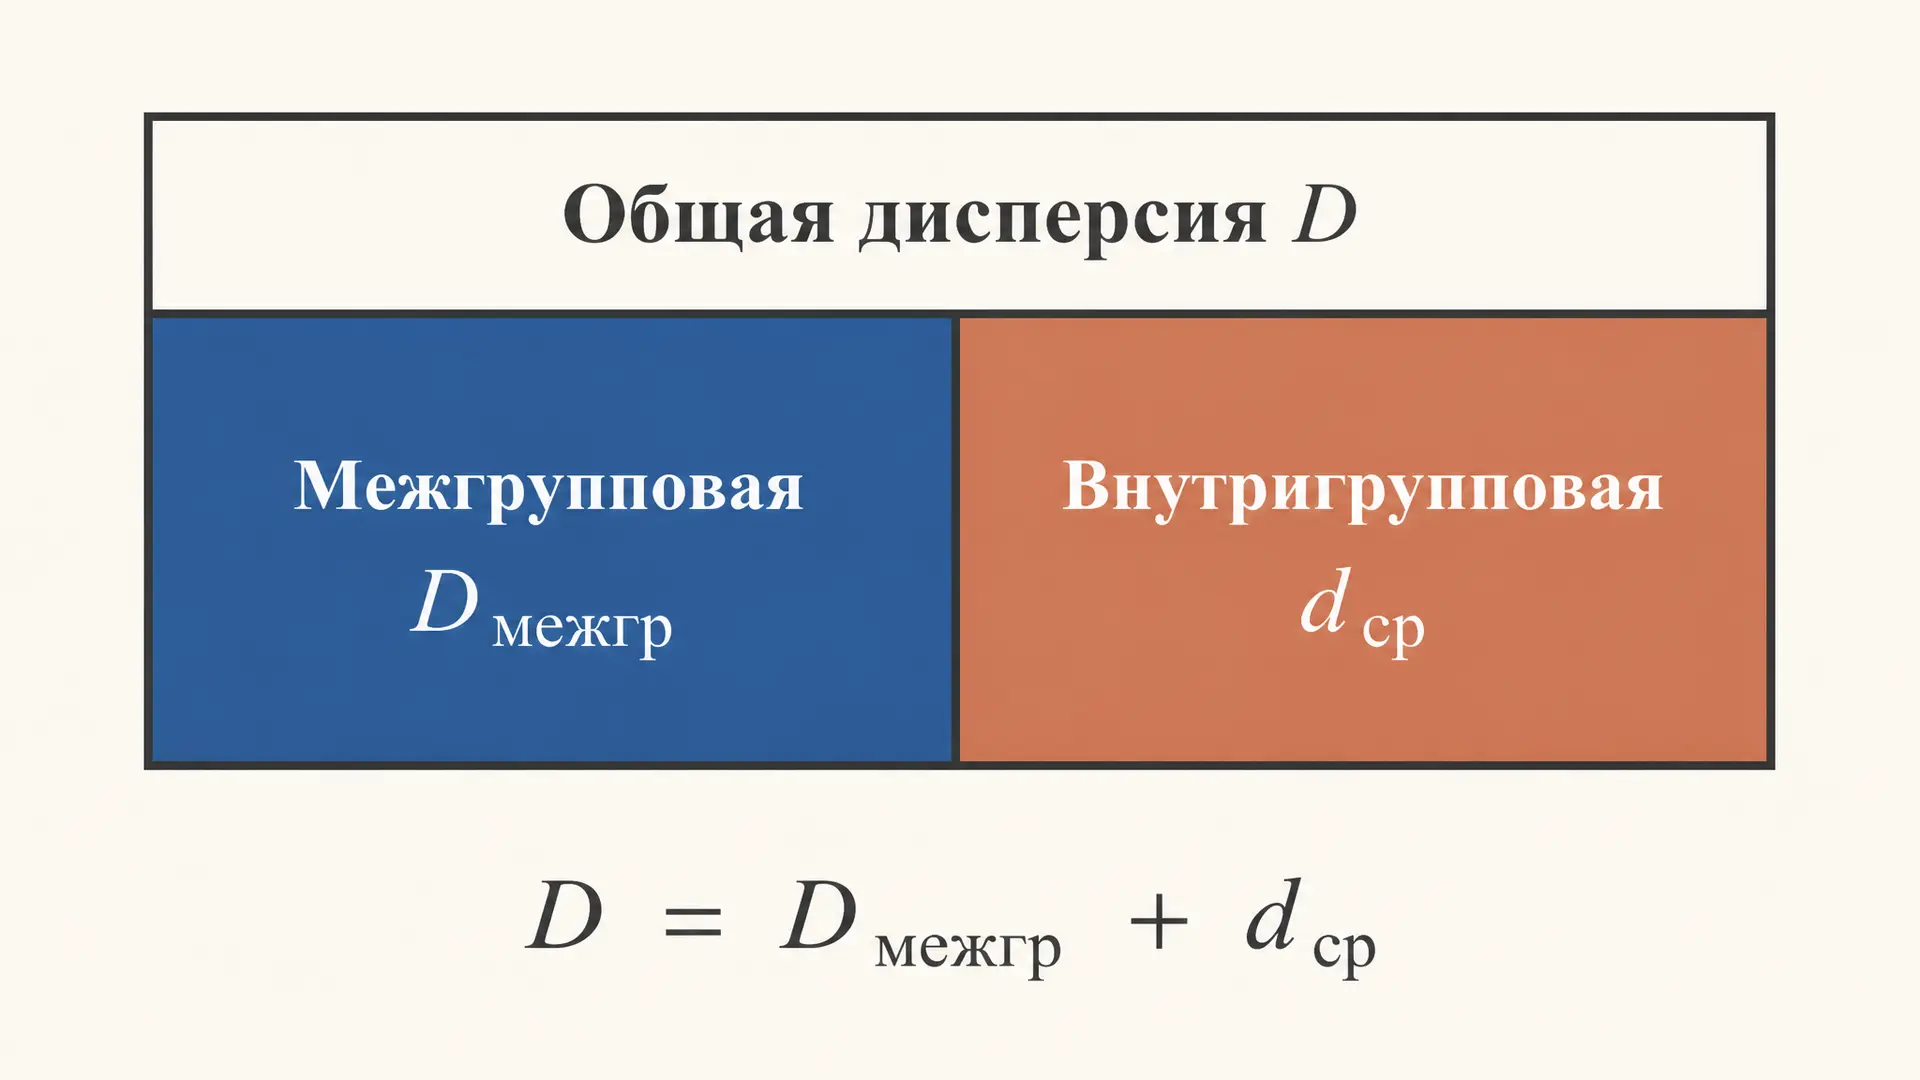
Правило сложения дисперсий: межгрупповая и внутригрупповая
Правило сложения дисперсий разбивает общую изменчивость на межгрупповую и внутригрупповую части. Формулы, пример расчёта, связь с ANOVA и эконометрикой.
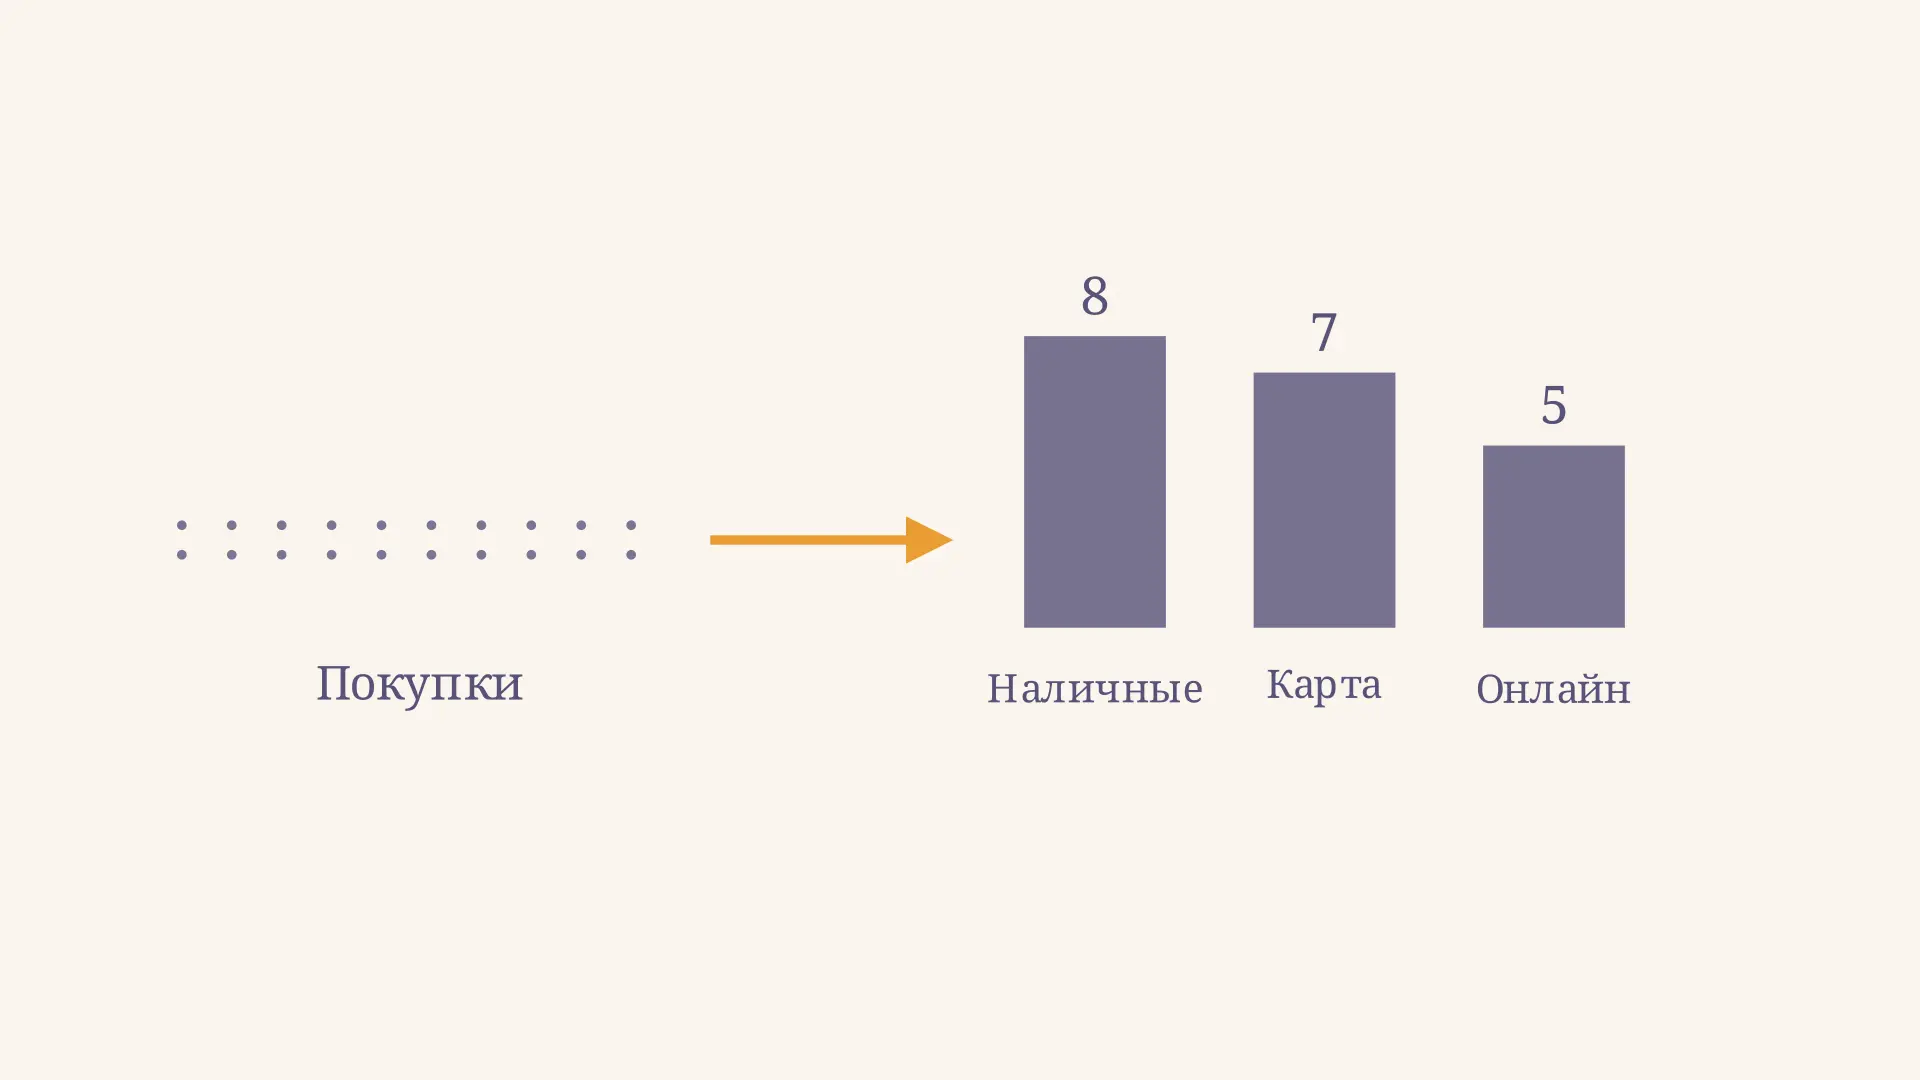
Атрибутивный ряд распределения: пример и расчёт
Атрибутивный ряд распределения в статистике: как выделить качественный признак, подсчитать частоты и доли, построить диаграмму и найти моду на примере покупок.
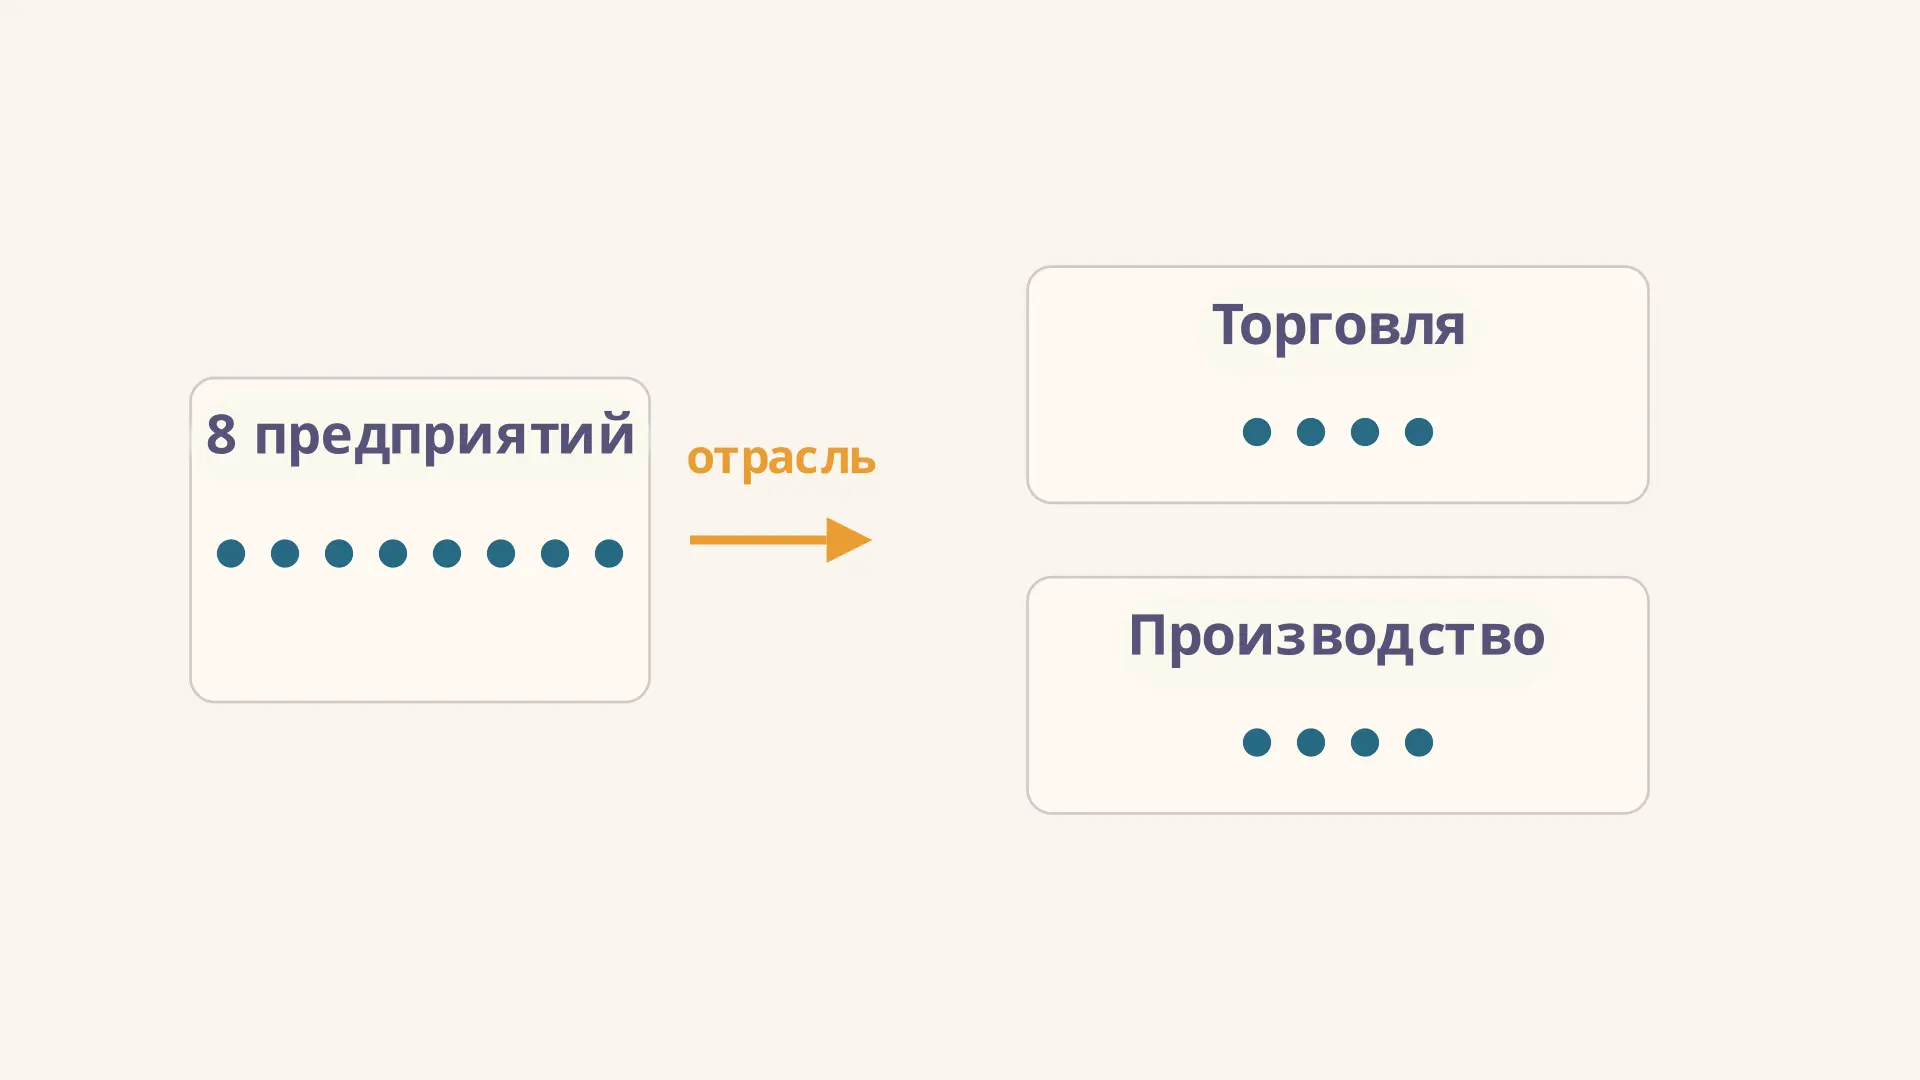
Группировочный признак: выбор и примеры в статистике
Что такое группировочный признак, как выбрать качественное или количественное основание группировки и проверить границы и состав групп на примере предприятий.
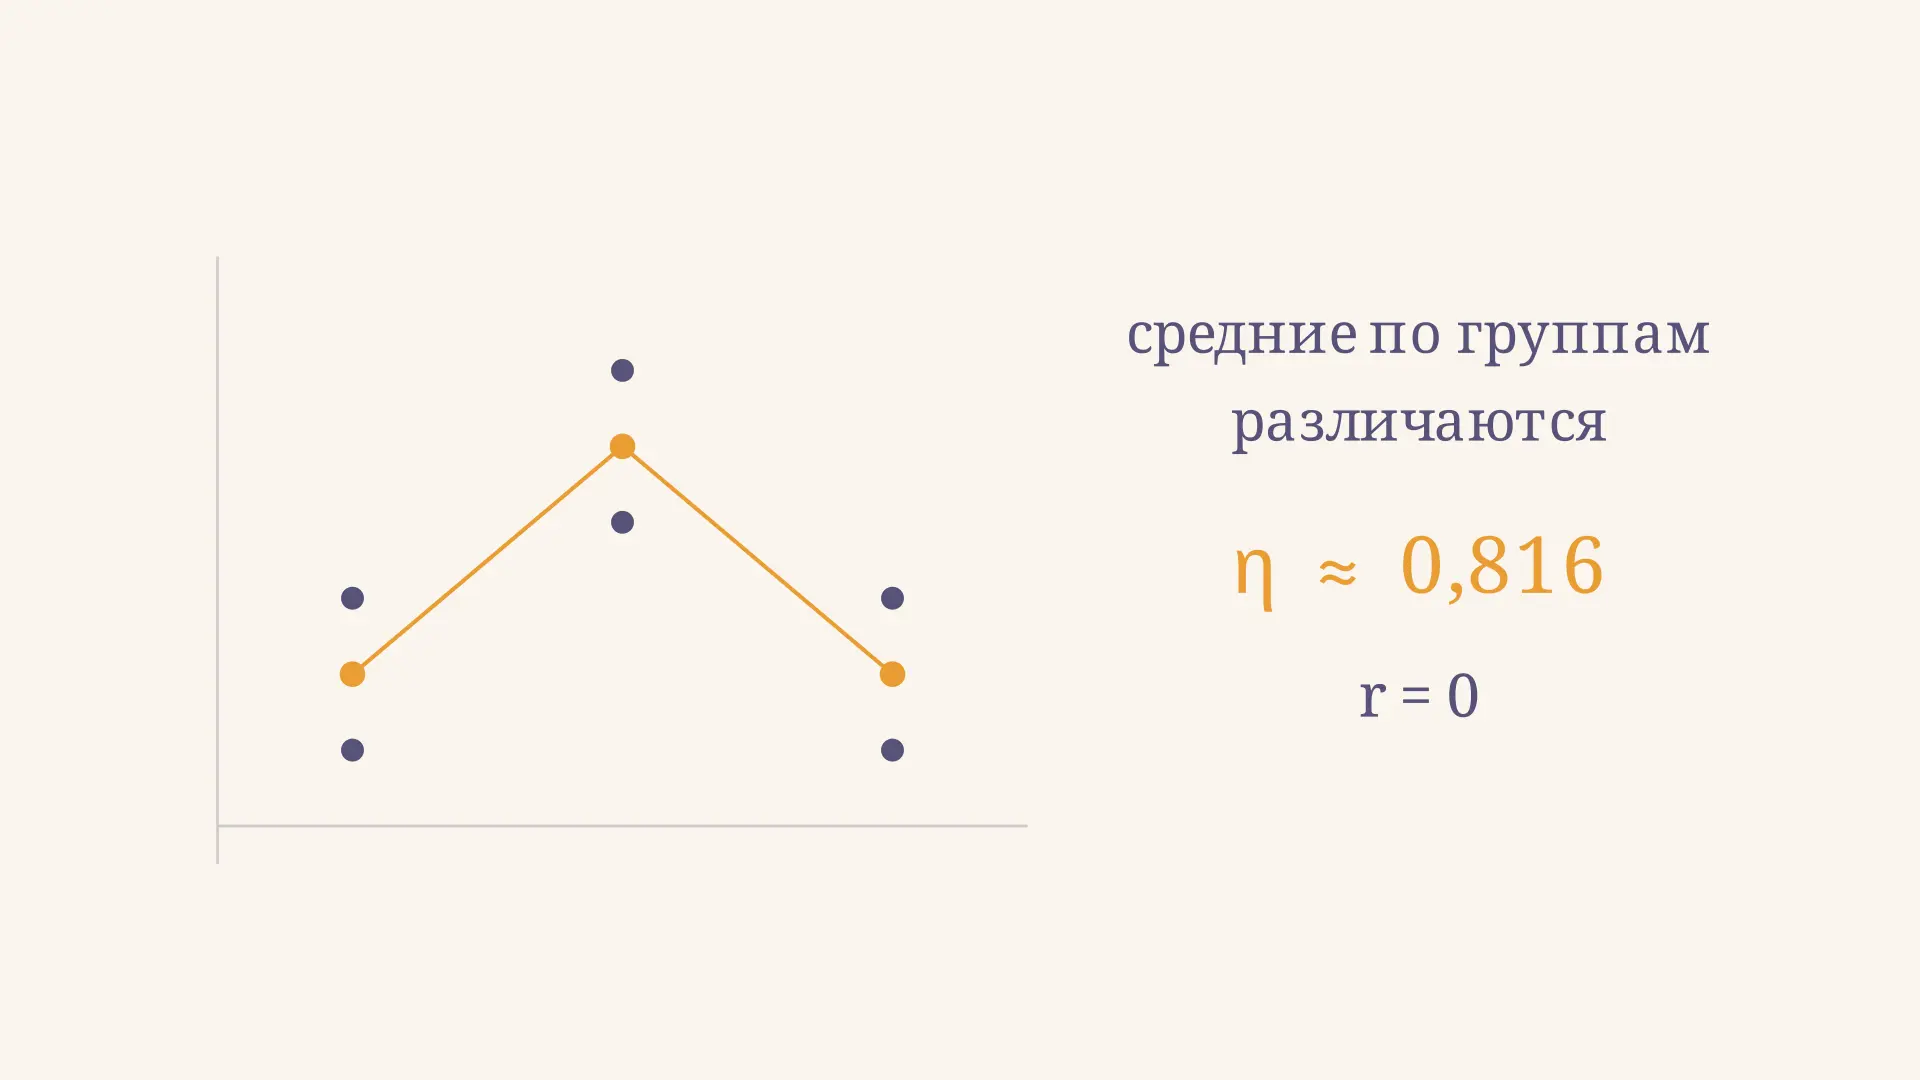
Индекс корреляции: формула и пример расчёта
Как рассчитать индекс корреляции по группам и остаткам модели, прочитать его квадрат и отличить нелинейную связь от коэффициента Пирсона: пример с таблицей.
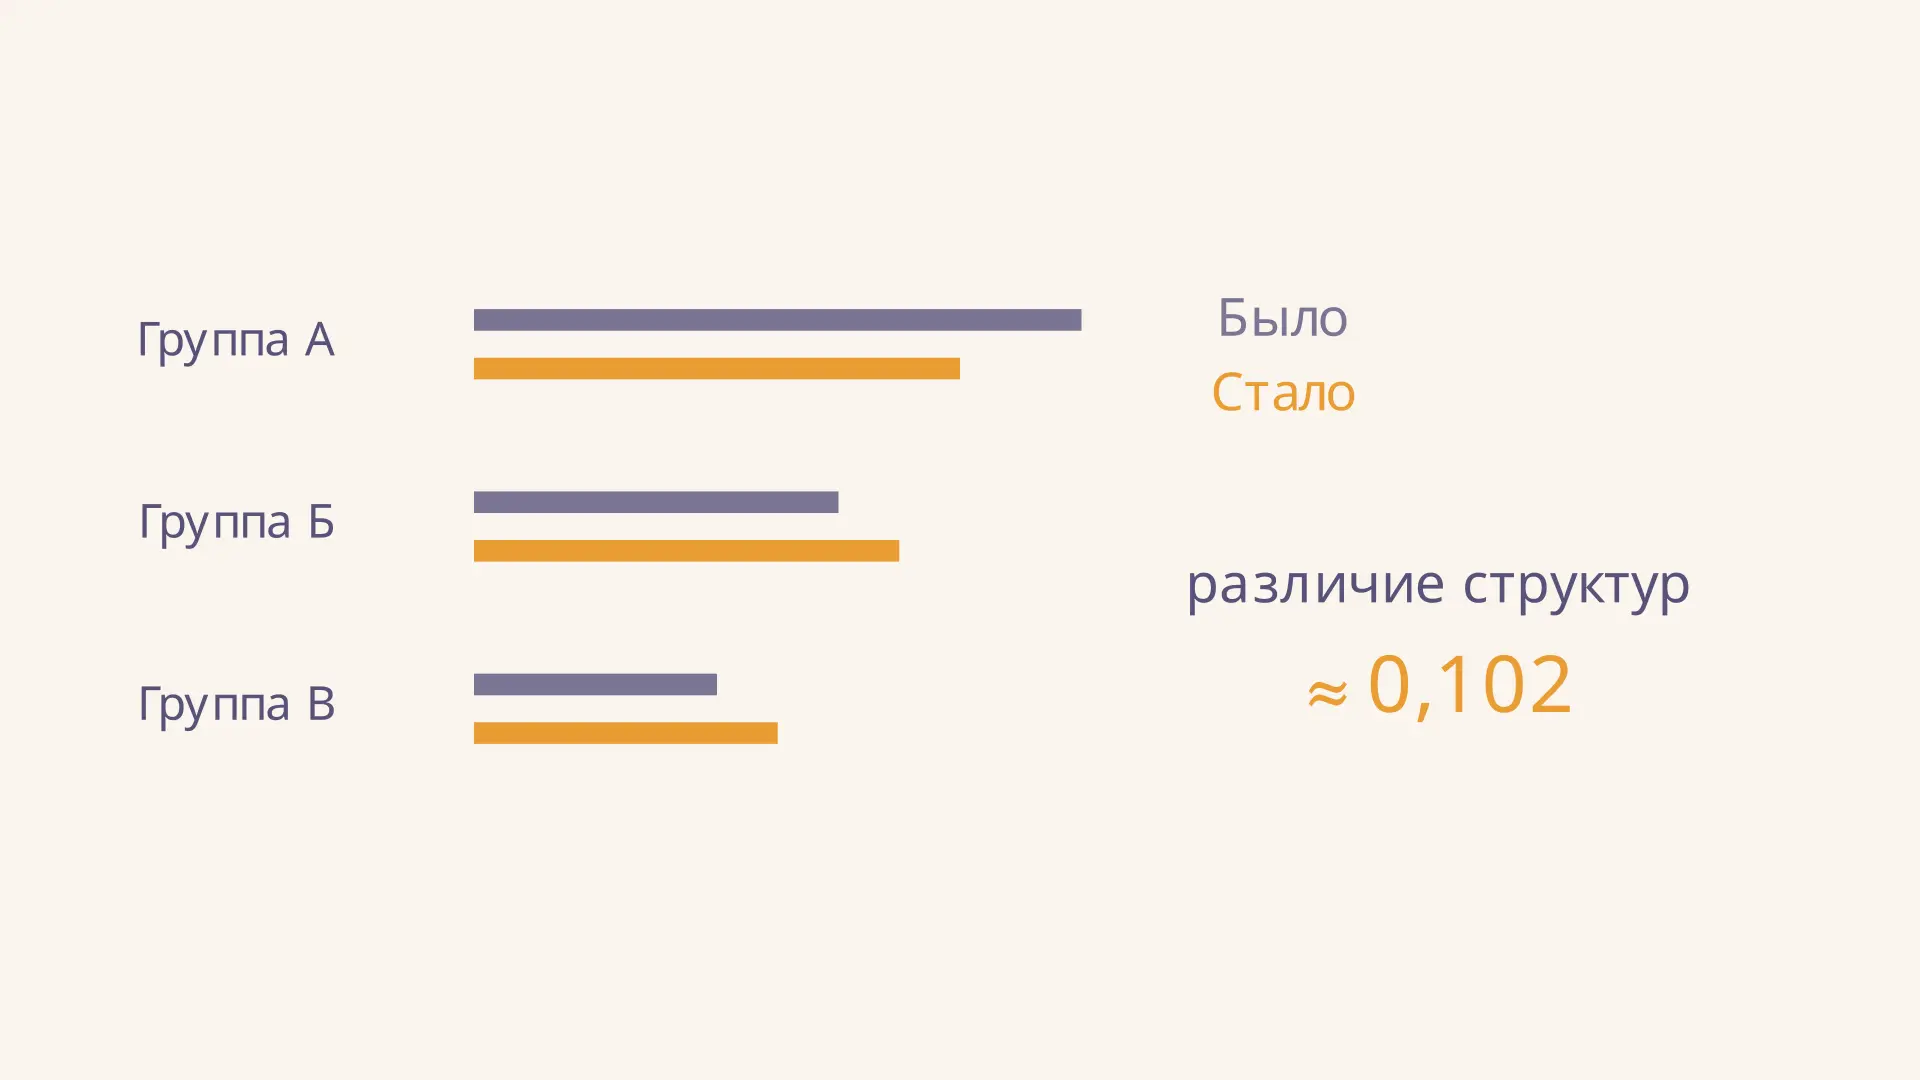
Индекс Рябцева: формула и расчёт структурных различий
Индекс Рябцева измеряет различие двух структур. Разбираем формулу, пошаговый расчёт по долям, шкалу интерпретации и ограничения метода на наглядном примере.