Таблица сопряжённости и критерий хи-квадрат Пирсона
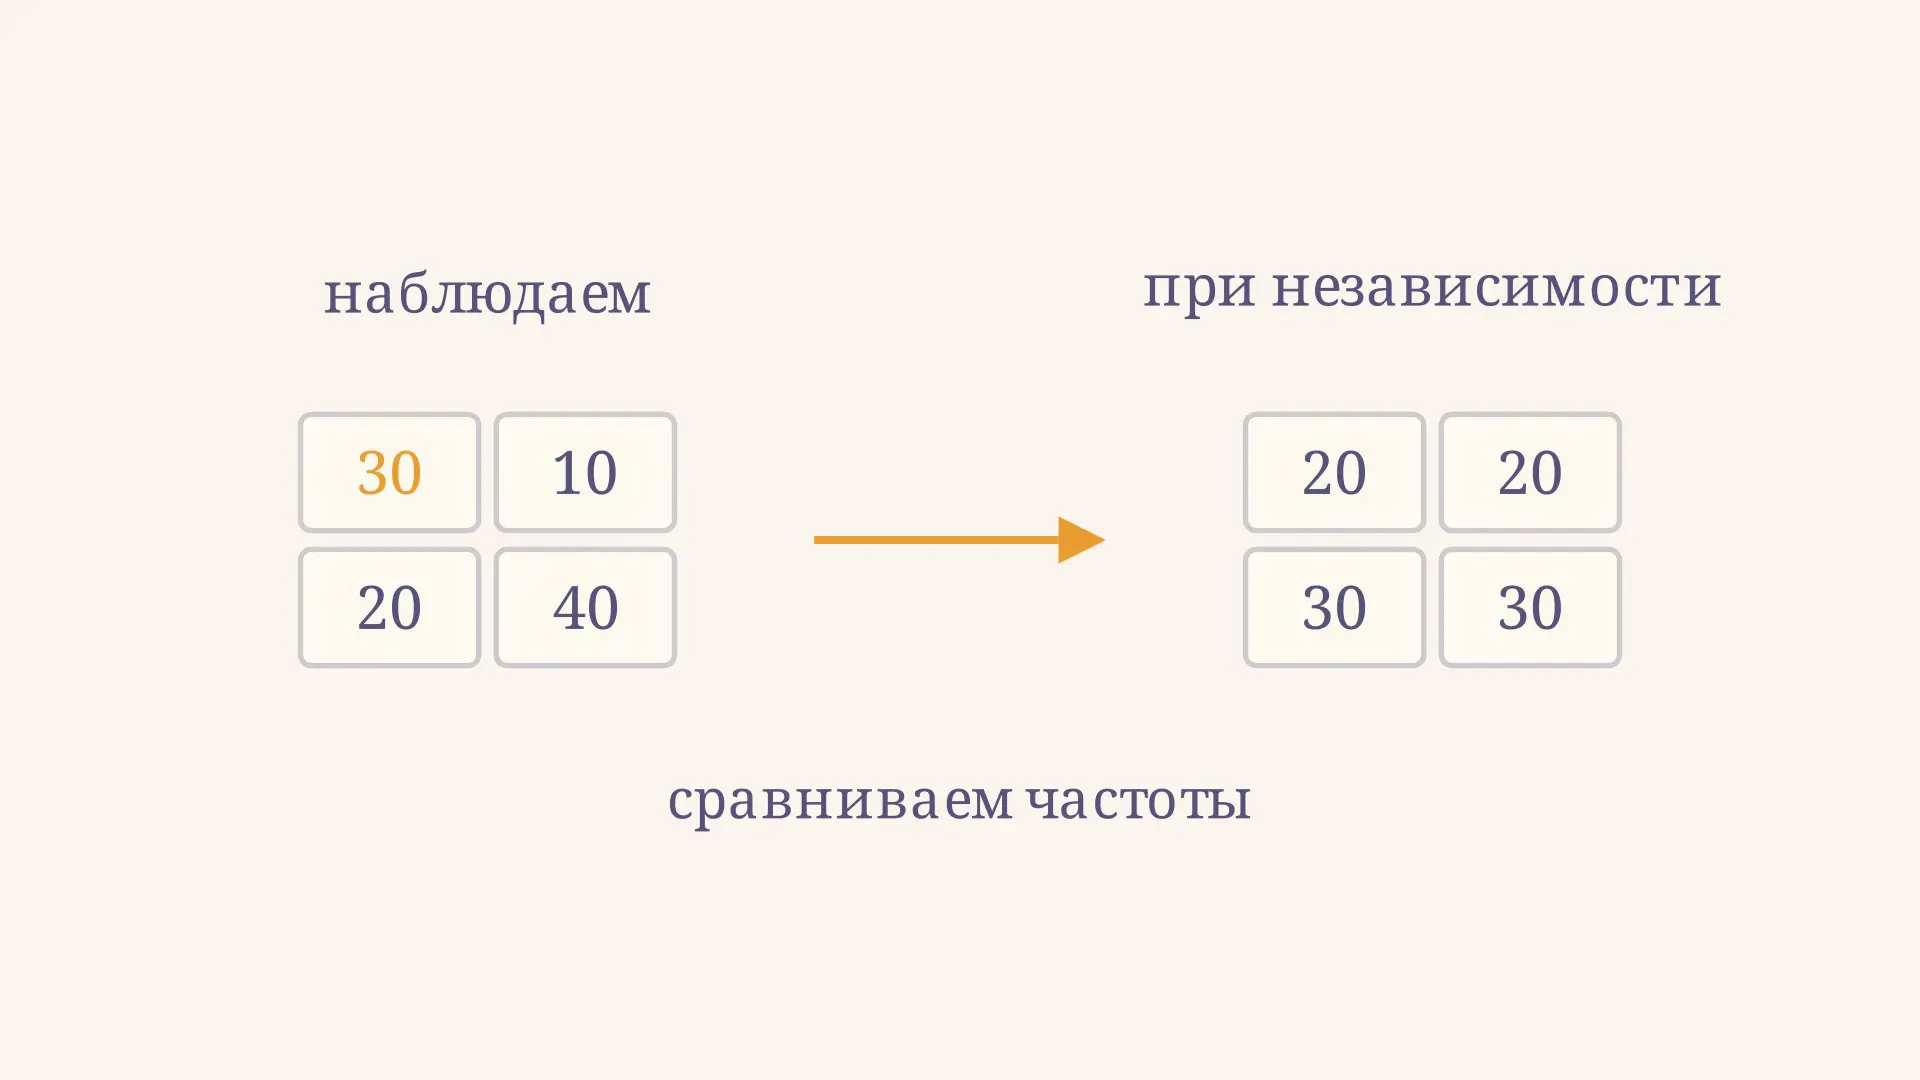
Критерий хи-квадрат Пирсона для таблицы сопряжённости помогает проверить, связаны ли два категориальных признака в генеральной совокупности. Например, можно сравнить доли ответов «да» и «нет» в двух группах. Критерий сопоставляет реальные числа наблюдений с ожидаемыми при независимости, а затем оценивает, насколько велико общее расхождение. В калькуляторе измените частоты при постоянных итогах и посмотрите, как меняется статистика.
Что показывает таблица сопряжённости
В таблице строки соответствуют категориям одного признака, столбцы - категориям другого. Каждое наблюдение относится ровно к одной паре категорий. Число в ячейке - частота, то есть количество объектов, а не процент. Итоги строк и столбцов называют маргинальными частотами. Они нужны для расчёта того, какая таблица получилась бы в среднем при независимости признаков.
Рассмотрим вымышленный учебный опрос 100 независимо выбранных людей. Группы А и Б различаются по одному категориальному признаку, ответ «да» или «нет» - по другому:
| Группа | Да | Нет | Всего |
|---|---|---|---|
| А | 30 | 10 | 40 |
| Б | 20 | 40 | 60 |
| Всего | 50 | 50 | 100 |
В группе А ответили «да» 30 из 40 человек, или 75 %, а в группе Б - 20 из 60, или примерно 33,3 %. Разница заметна, но сами проценты ещё не дают формального решения о гипотезе. Критерий учитывает объём выборки и все ячейки одновременно.
Движение в ролике задаётся параметром : частоты имеют вид , , , . При они совпадают с ожидаемыми, при получается таблица опроса. Это специально построенная модель: в реальных данных итоги могут быть любыми. Связь независимости с произведением вероятностей разобрана в статье об условной вероятности.
Гипотезы и ожидаемые частоты
Нулевая гипотеза утверждает, что признаки независимы в генеральной совокупности: распределение ответа одинаково в группах. Альтернативная гипотеза утверждает наличие связи, то есть хотя бы одно распределение отличается. Она не задаёт заранее направление различия и не утверждает, что принадлежность к группе вызвала ответ.
Обозначим наблюдаемую частоту через , итог строки - через , итог столбца - через , общее число наблюдений - через . При независимости ожидаемая частота равна
Смысл формулы таков: доля столбца во всей выборке равна ; умножив её на размер строки, получаем ожидаемое число в этой строке. В примере для ячейки «А, да» . Ожидаемые числа остальных ячеек рассчитываются точно так же:
| Группа | Да | Нет | Итого |
|---|---|---|---|
| А | 20 | 20 | 40 |
| Б | 30 | 30 | 60 |
Ожидаемые частоты могут быть дробными: они выражают расчёт по модели, а не фактически подсчитанных людей. Их итоги совпадают с итогами исходной таблицы. NIST приводит эту формулу и правило проверки независимости для таблиц произвольного размера.
Расчёт статистики по шагам
Статистика Пирсона суммирует расхождения по всем ячейкам:
Квадрат делает вклад неотрицательным, поэтому положительные и отрицательные отклонения не уничтожают друг друга. Деление на ожидаемую частоту учитывает масштаб ячейки. Для примера получаем:
- В ячейке «А, да» вклад равен .
- В ячейке «А, нет» вклад равен .
- В ячейках группы Б вклады равны и .
- Сумма без преждевременного округления составляет .
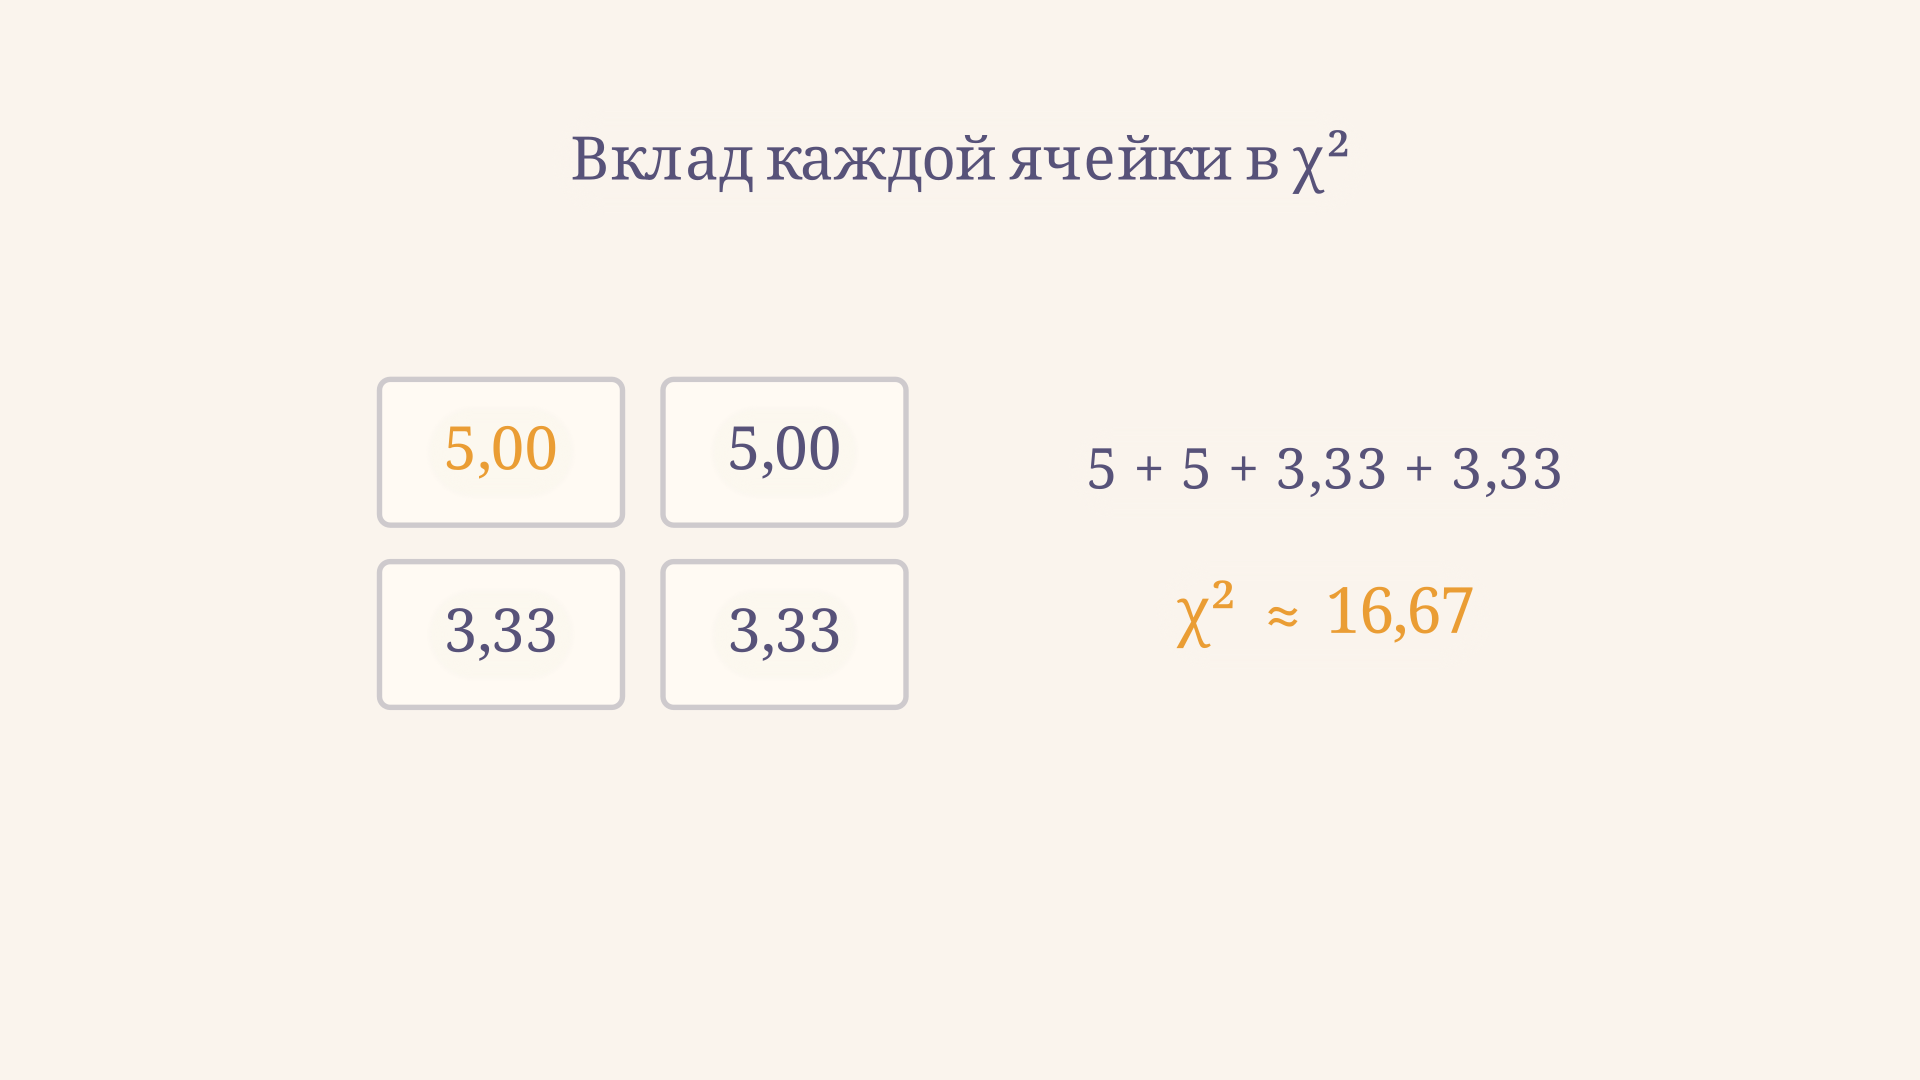
Расчёт использует обычную статистику Пирсона без поправки Йейтса. Некоторые программы автоматически включают эту поправку для таблицы , поэтому их статистика и p-значение могут отличаться. Сравнивая ответы, проверьте настройку программы. Округляйте только окончательный результат: сумма показанных округлённых вкладов составляет 16,66, но точная сумма ближе к 16,67.
Степени свободы и решение
Для таблицы из строк и столбцов число степеней свободы равно
При фиксированных итогах таблицы достаточно задать одну ячейку: остальные три определяются итогами. Поэтому здесь . Для таблицы степеней свободы было бы две. Статистика при верной и подходящих условиях приближённо имеет распределение хи-квадрат с найденным .
Заранее зададим уровень значимости . Для одной степени свободы критическое значение правого хвоста примерно 3,841. Наша статистика 16,667 больше порога, поэтому отвергают на этом уровне. Подробнее о поиске порога см. таблицу распределения хи-квадрат. Важно выбирать именно правый хвост: крупные значения статистики соответствуют большому расхождению с моделью независимости.
Тот же вывод следует из : это меньше 0,05. При верной нулевой гипотезе и допущениях метода p-значение характеризует вероятность получить статистику не меньше наблюдённой. Оно не равно вероятности истинности и не показывает вероятность ошибки именно в этом отдельном решении. Сравнение с порогом и p-значением - два способа принятия одного решения при одном и том же критерии.
Условия и малые частоты
До расчёта проверьте, что категории внутри каждого признака взаимоисключающие, а наблюдения независимы. Повторные ответы одного человека или участники одного кластера обычно нарушают простую схему независимых наблюдений. Таблица должна содержать именно частоты, полученные из подходящей выборки; суммарные проценты вместо чисел объектов использовать нельзя.
При малых ожидаемых частотах приближение распределением хи-квадрат может быть неточным. Распространённое правило Кохрена, приведённое NIST: ожидаемых частот меньше единицы быть не должно, а частот меньше пяти - не более 20 %. Это ориентир для приближения, а не гарантия точности при любой схеме выборки. В нашем примере минимум ожидаемых частот равен 20. Нулевая ожидаемая частота делает формулу неприменимой: следует разобраться с пустой категорией или структурным ограничением модели.
Для малой таблицы возможен точный критерий Фишера; его условная постановка и двустороннее p-значение требуют отдельного выбора. Объединять категории только ради преодоления порога частот нельзя без содержательного обоснования: так можно потерять важное различие.
Как интерпретировать связь
Результат примера указывает на статистическое свидетельство против независимости при принятых предпосылках. Вернитесь к исходным долям: в группе А «да» ответили 75 %, в группе Б - около 33,3 %. Они показывают направление различия и его величину в понятных единицах: примерно 41,7 процентного пункта. Но опрос сам по себе не устанавливает причинность, а состав групп может различаться и по другим признакам.
Значимая статистика не равна сильной связи: при большой выборке даже небольшое различие способно дать малое p. Для описания величины связи используют, например, коэффициент сопряжённости Пирсона, учитывая ограничения его шкалы. Если же , корректный вывод - недостаточно оснований отвергнуть независимость; это не доказательство её точного выполнения. На способность обнаружить отличие влияют объём выборки и размер эффекта.
Как оформить результат в работе
В отчёте сначала опишите единицу наблюдения и способ отбора: кто попал в выборку, что обозначают группы и как определены категории ответа. Затем приведите исходные частоты и итоги таблицы. Читатель должен суметь восстановить расчёт, не угадывая, относятся проценты к строкам или ко всей выборке. Для сравнения групп удобно показывать доли внутри строк вместе с абсолютными числами: одинаковый процент при разной численности групп может соответствовать разному количеству людей.
После этого укажите проверяемую гипотезу, выбранный уровень значимости и название теста. Для учебного примера запись может выглядеть так: «Критерий независимости Пирсона без поправки Йейтса: статистика 16,67, одна степень свободы, p приблизительно 0,000045». Добавьте содержательный вывод о различии долей и укажите, почему условия расчёта считаете выполненными. Если выборка не случайна или группы сформированы с отбором, это влияет на то, на какую совокупность можно распространять вывод.
Общий тест отвечает на вопрос о наличии расхождения во всей таблице. В таблице с несколькими строками и столбцами он сам по себе не устанавливает, какие именно пары категорий различаются. Дополнительные сравнения требуют отдельного плана и учёта множественных проверок: иначе вероятность хотя бы одного ложного обнаружения может возрасти. Даже после значимого общего результата важно показывать исходные частоты и оценку размера различия, а не ограничиваться одним словом «значимо».
Частые ошибки
- Сравнивать с порогом, выбранным для неверного числа степеней свободы. Используйте число непустых содержательных категорий и формулу для конкретной модели.
- Проверять условие частот по наблюдаемым вместо ожидаемых. Сначала вычислите все .
- Называть p вероятностью того, что гипотеза верна. Это характеристика результата при предположении .
- Делать причинный вывод по одной таблице. Критерий обнаруживает расхождение с независимостью, но не объясняет его механизм.
- Не указывать поправку Йейтса и уровень значимости. Из-за разных настроек воспроизвести расчёт иначе трудно.
FAQ
Можно ли использовать критерий для таблицы больше 2 × 2?
Да. Ожидаемую частоту и вклад вычисляют для каждой ячейки, затем складывают вклады и используют . Условия независимости наблюдений и достаточности ожидаемых частот сохраняются.
Что означает нулевая статистика?
Все наблюдаемые частоты точно совпали с ожидаемыми при рассчитанных итогах. Это свойство данной выборочной таблицы: само по себе оно не доказывает независимость признаков во всей совокупности.
Всегда ли нужно применять поправку Йейтса?
Нет. Для таблицы встречаются расчёты с поправкой и без неё; они дают разные результаты. Укажите выбранный вариант, а при малых ожидаемых частотах рассмотрите точный метод с подходящей схемой выборки.
Коротко
Таблица сопряжённости содержит совместные частоты двух категориальных признаков. Критерий Пирсона сравнивает их с частотами при независимости, суммирует взвешенные квадраты отклонений и сопоставляет результат с распределением хи-квадрат. В учебном примере , и : при уровне 0,05 гипотеза независимости отвергается, если выполнены условия метода.
Читайте также
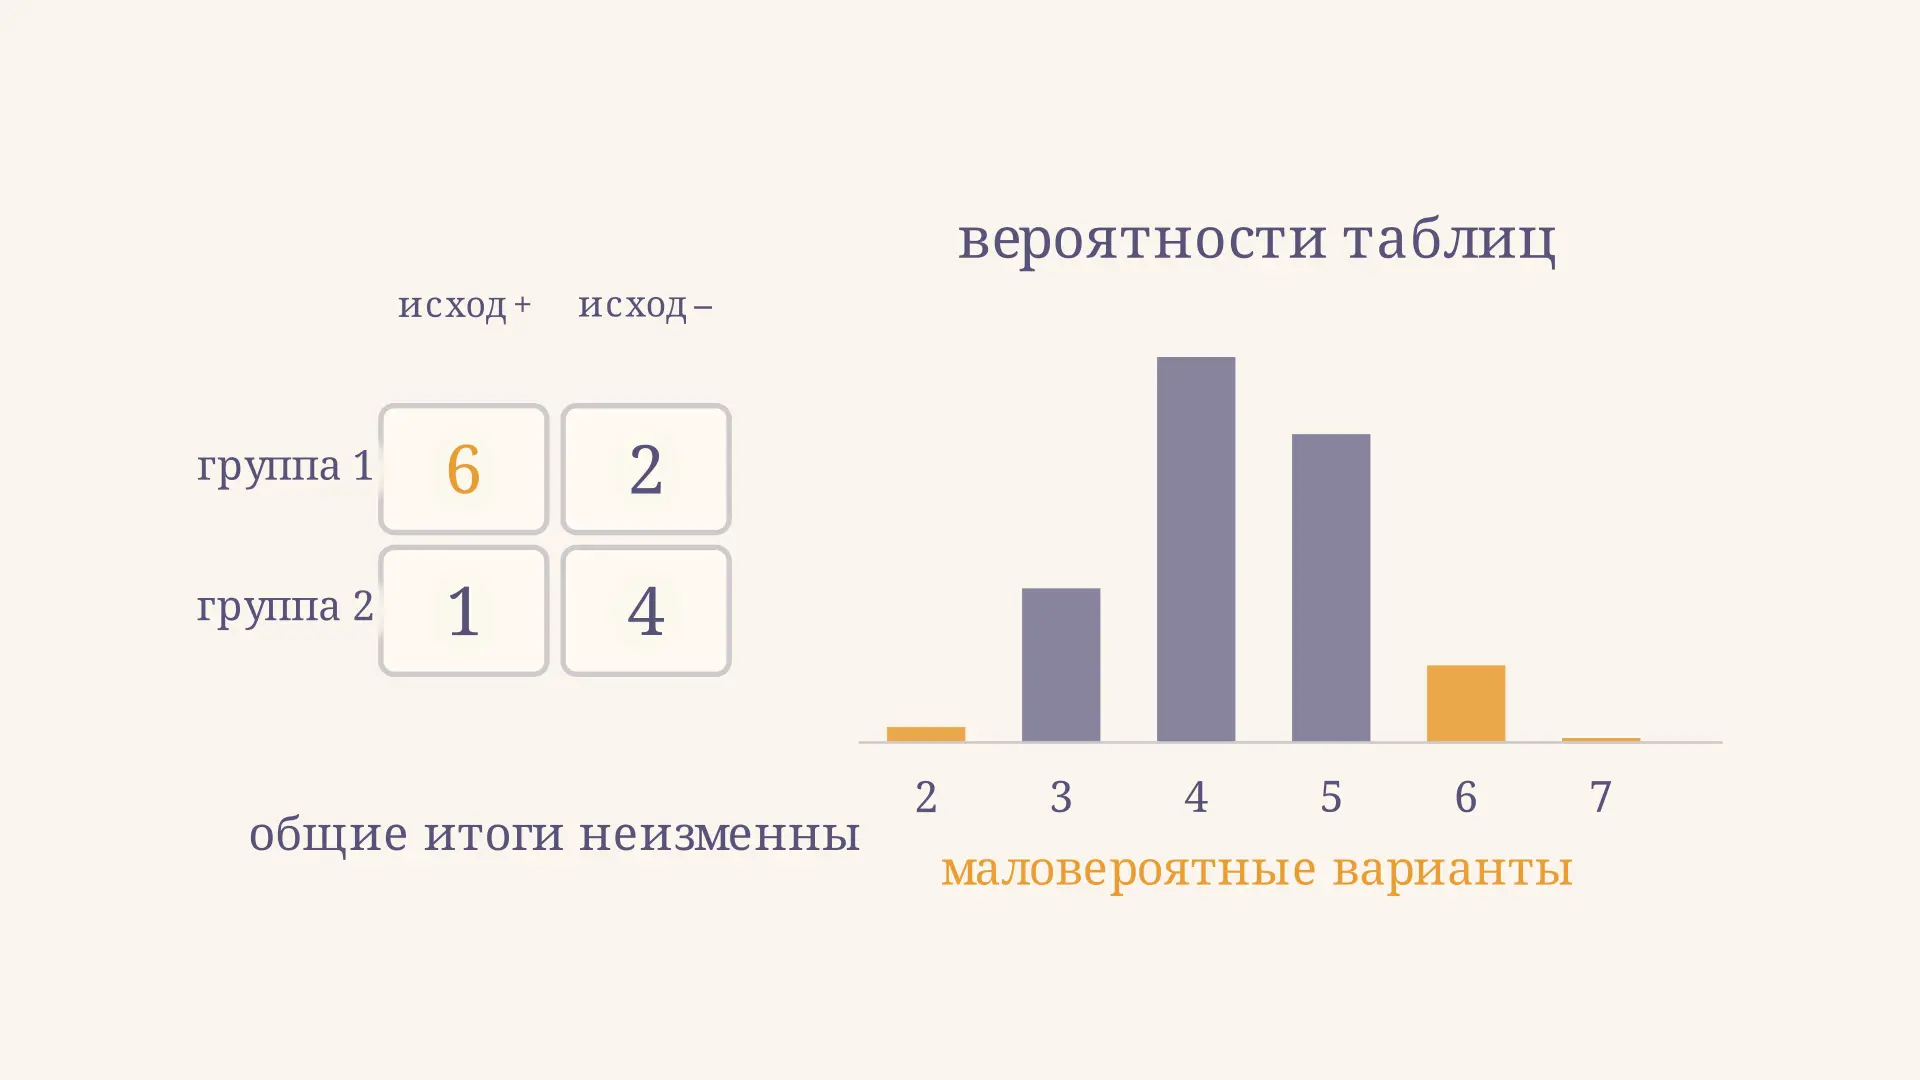
Точный критерий Фишера: таблица сопряжённости
Как применять точный критерий Фишера к таблице сопряжённости 2×2: условное распределение, одностороннее и двустороннее p, пример расчёта и интерпретация.
Доверительная вероятность и уровень значимости
Как связаны доверительная вероятность и уровень значимости: формула, смысл ошибок, пример доверительного интервала среднего и проверка двусторонней гипотезы.
Проверка гипотезы о среднем нормального распределения
Как проверить гипотезу о среднем нормального распределения: выбор Z- или t-критерия, формулы, пример расчёта, критические области и интерпретация результата.
Мощность статистического критерия: формула и расчёт
Мощность статистического критерия 1-beta: как рассчитать через ошибку II рода, объём выборки и эффект-сайз. Формула для z-теста, целевой порог 80 %, примеры.
Как работает ANOVA однофакторный дисперсионный анализ
ANOVA однофакторный дисперсионный анализ сравнивает средние в трёх и более группах. Разбираем суммы квадратов, F-критерий и условия применимости на примере с расчётом.
Коэффициент Чупрова: формула и пример расчёта
Как рассчитать коэффициент Чупрова по таблице сопряжённости: ожидаемые частоты, хи-квадрат, пример для экономики, интерпретация результата и ограничения прямоугольных таблиц.