Коэффициент Чупрова: формула и пример расчёта
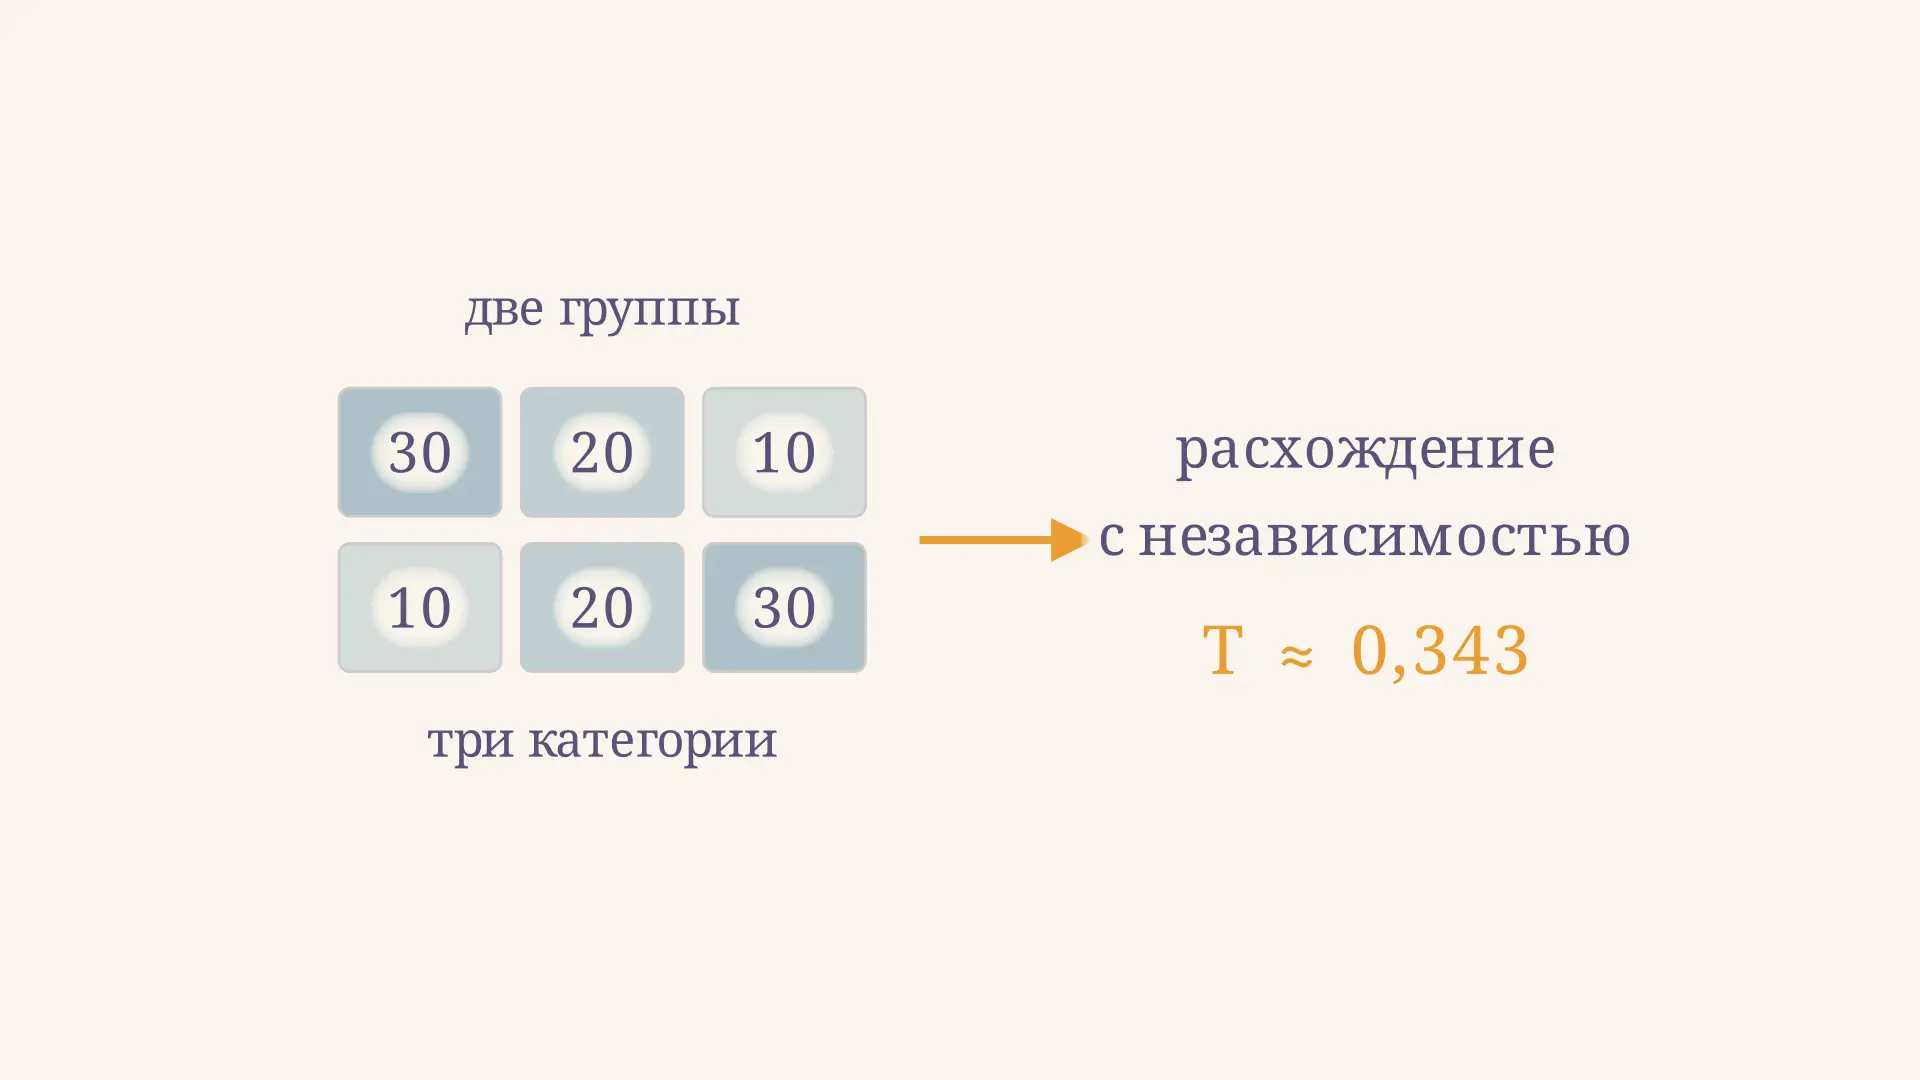
Коэффициент Чупрова измеряет тесноту связи двух категориальных признаков по таблице сопряжённости. Например, он помогает описать, различается ли распределение способов оплаты между группами покупателей. Показатель опирается на отклонение наблюдаемых частот от ожидаемых при независимости и учитывает количество строк и столбцов. В учебном калькуляторе измените отклонение, сохраняя итоги таблицы, и проследите за результатом.
Какие данные нужны для расчёта
Каждое наблюдение относят одновременно к одной категории первого и одной категории второго признака. В экономическом исследовании строками могут быть две группы покупателей, а столбцами - три способа оплаты. В ячейках стоят числа покупателей, выбравших соответствующие сочетания категорий. Их суммы образуют итоги строк и столбцов, а сумма всех ячеек - объём выборки .
При независимости распределение способов оплаты одинаково в группах. Если доли способов различаются, наблюдаемые частоты отклоняются от ожидаемых при независимости. Чем больше такое расхождение относительно ожидаемых частот, тем больше статистика хи-квадрат, а при фиксированном размере и форме таблицы - и .
Коэффициент симметричен: перестановка строк со столбцами не изменит его. Номинальные категории не нужно переводить в баллы или искусственно упорядочивать. В отличие от выборочного коэффициента корреляции, здесь нет знака, который описывал бы направление линейной связи количественных переменных.
Формула через хи-квадрат
Обозначим наблюдаемую частоту в ячейке через , итог строки через , итог столбца через . Ожидаемая при независимости частота находится из произведения соответствующих итогов:
Ожидаемые частоты могут быть дробными: это значения модели, а не фактические числа людей. Затем суммируют вклады всех ячеек и нормируют результат с учётом размеров таблицы:
Здесь - число непустых строк, - число непустых столбцов. Для расчёта нужны хотя бы две строки и два столбца с положительными итогами. Внутренний корень учитывает обе размерности таблицы, а внешний извлекается из всей дроби. Показатель безразмерен. Можно также сначала найти , а затем вычислить .
Использована обычная статистика Пирсона без поправки на непрерывность. Документация R описывает расчёт ожидаемых частот и отмечает, что для таблицы 2×2 программа по умолчанию может применять поправку; при сверке важно выбрать одинаковую версию статистики.
Пример: две группы и три способа оплаты
Возьмём вымышленные учебные данные. В каждой группе по 60 покупателей, всего 120. Способы оплаты обозначены условно: нас интересует совместное распределение, а не реальные рыночные доли.
| Группа | Способ 1 | Способ 2 | Способ 3 | Всего |
|---|---|---|---|---|
| А | 30 | 20 | 10 | 60 |
| Б | 10 | 20 | 30 | 60 |
| Всего | 40 | 40 | 40 | 120 |
- При независимости для каждой ячейки .
- Четыре крайние ячейки отличаются от ожидаемых на или ; каждая даёт вклад . Две средние совпадают с ожиданием и дают нулевой вклад.
- Сумма вкладов равна .
- При и получаем .
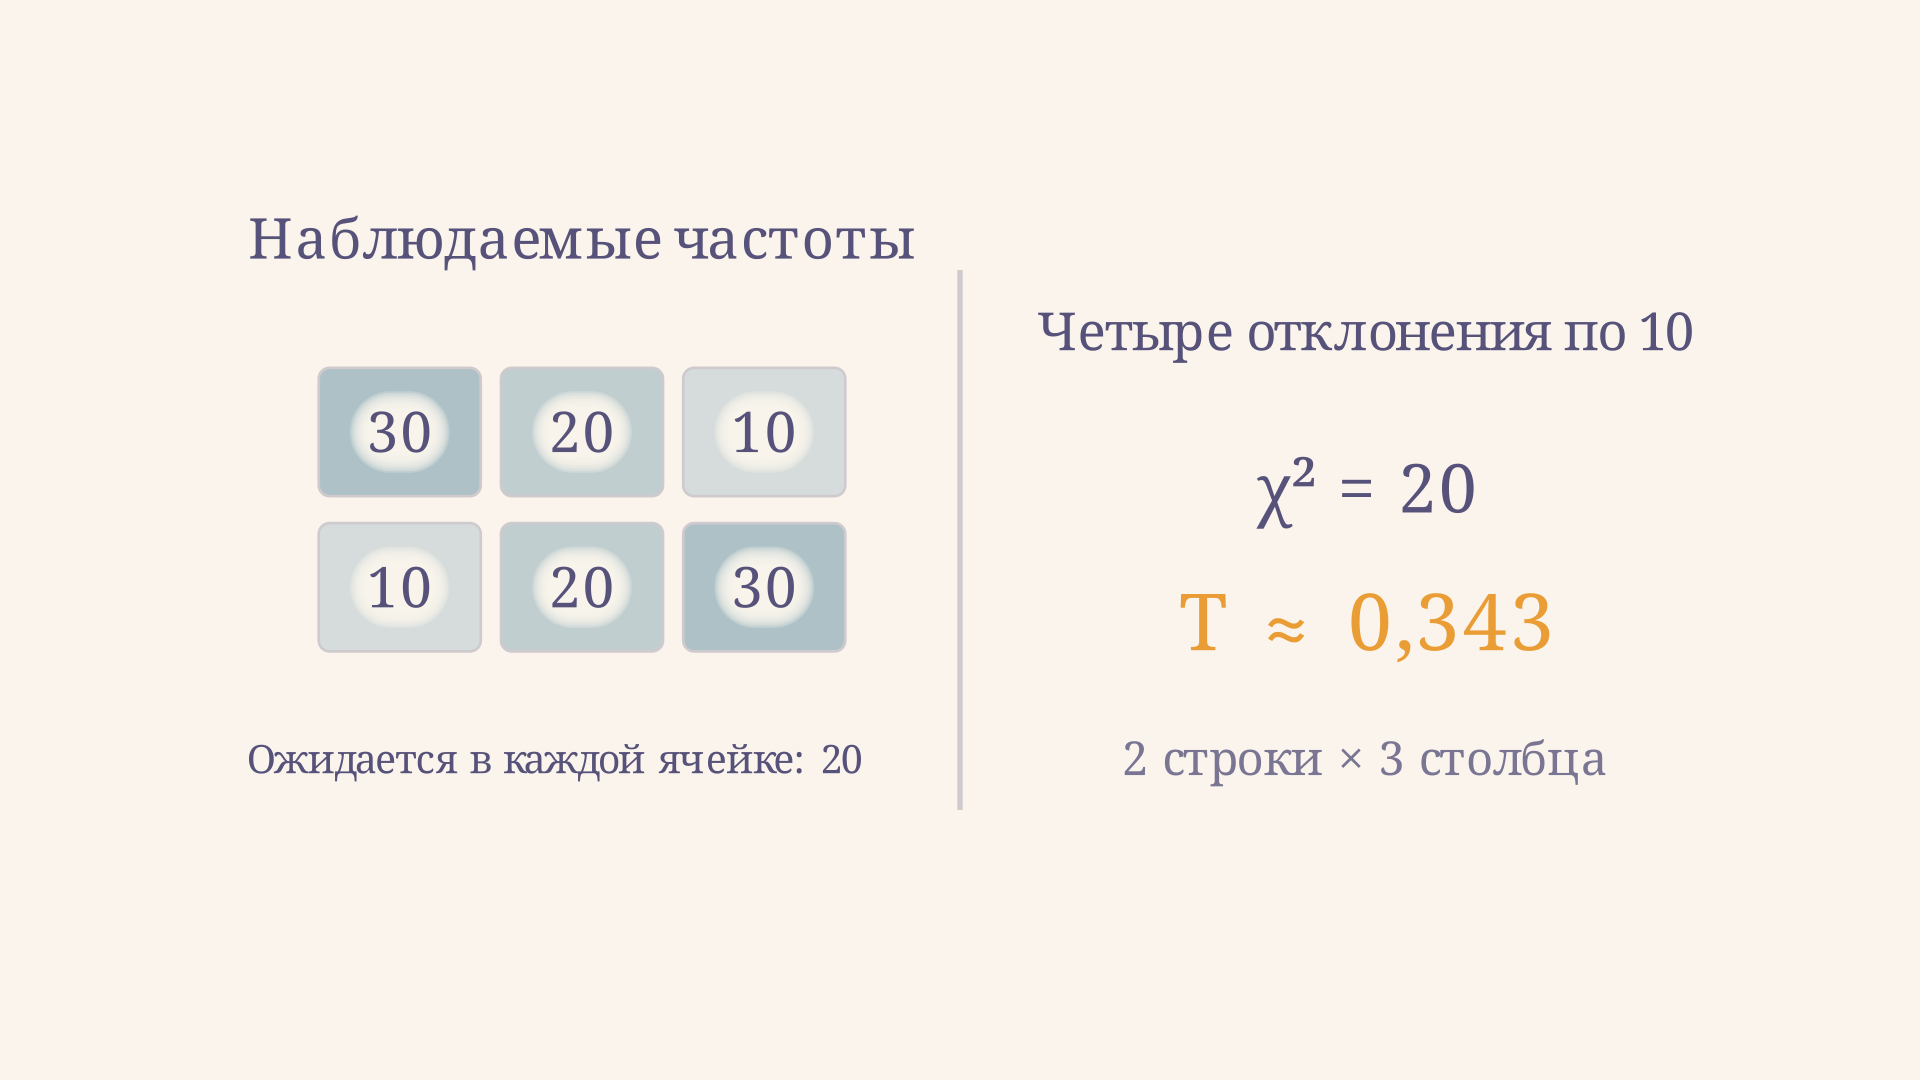
Результат показывает отклонение от независимости в этой таблице. В группе А способ 1 встречается чаще, чем способ 3, а в группе Б - наоборот. Само число не сообщает, какие ячейки ответственны за связь: для этого нужно вернуться к частотам, долям и остаткам . Если поменять названия способов 1 и 3, значение коэффициента останется тем же.
Как проверить расчёт вручную
Полезно сначала проверить контрольные суммы: сумма ожидаемых частот по каждой строке должна совпасть с её наблюдаемым итогом, и то же верно для каждого столбца. В примере три ожидаемых значения по 20 дают 60 в каждой строке, а два значения по 20 дают 40 в каждом столбце. Если эти суммы не сходятся, проверьте объём выборки и правильность умножения итогов.
Затем удобно записать вклады в отдельную таблицу того же размера. Здесь первая строка вкладов равна 5, 0, 5, а вторая также равна 5, 0, 5. Такое представление позволяет заметить, что средняя категория не участвует в расхождении, хотя в ней есть наблюдения. Квадрат убирает знак отклонения, поэтому для содержательного вывода следует сохранить и сами разности между наблюдаемыми и ожидаемыми частотами.
Для проверки в программе передавайте матрицу именно с наблюдаемыми частотами и убедитесь, что используется статистика без поправки. Округляйте только итог: раннее округление дробных ожидаемых значений способно изменить сумму вкладов. Сохраните число категорий вместе с результатом, иначе восстановить нормировку коэффициента будет невозможно.
Как интерпретировать значение и предел
При положительных итогах означает точное совпадение наблюдаемых частот с ожидаемыми во всей рассматриваемой таблице. Это независимость в наблюдаемом распределении, но не гарантия независимости в генеральной совокупности: другая выборка может дать иной результат. Большее указывает на большее отклонение, однако универсальных границ «слабая» или «сильная» связь для любой задачи нет. Сравнивайте результат с содержанием задачи, способом группировки, формой таблицы и неопределённостью оценки.
Теоретически лежит от нуля до единицы, но для прямоугольной таблицы единица недостижима. Верхняя граница по форме таблицы равна
Для 2×3 это . При заданных итогах строк и столбцов достижимый максимум может быть ниже. Так, в нашем ползунке даже крайнее отклонение даёт лишь : средний столбец остаётся распределён поровну. Поэтому 0,343 нельзя автоматически трактовать как 34,3 % связи или как долю объяснённой вариации.
Для таблиц одинаковой формы и сходного определения категорий сравнение коэффициентов понятнее, чем для таблиц разных размеров. Объединение или дробление категорий меняет исходные частоты и может изменить показатель. Документируйте правила группировки до сопоставления результатов.
Чем отличается от V Крамера и проверки гипотезы
Коэффициент Крамера использует ту же статистику, но другой знаменатель: . Для квадратной таблицы ; для прямоугольной . В примере . Разница возникает из нормировки, а не из другой таблицы. Справка пакета DescTools перечисляет оба показателя среди мер ассоциации.
Проверка независимости отвечает на другой вопрос: насколько наблюдаемое расхождение совместимо с гипотезой независимости при выбранной модели выборки. Для обычного критерия число степеней свободы равно , в примере - двум. О том, как сопоставляют статистику с критическими значениями, рассказывает статья про распределение хи-квадрат. Значимый результат сам по себе не говорит о практической важности эффекта: при большом даже малое отклонение может быть обнаружено.
Напротив, описывает величину связи в данных, но не является -значением. При удвоении всех частот и удвоятся, а не изменится. Точность и статистическая значимость при этом могут измениться. Для анализа влияния третьего количественного признака существует частная корреляция, но она не является заменой анализу категориальной таблицы с учётом смешивающих факторов.
Условия и ограничения
Наблюдения должны соответствовать дизайну исследования: обычный тест независимости предполагает независимые единицы наблюдения. Повторные покупки одного человека, взвешенная выборка или кластеризация требуют методов, учитывающих устройство данных. Нули в отдельных наблюдаемых ячейках допустимы, если ожидаемые частоты положительны; пустая целая строка или столбец делает обычную формулу неприменимой до пересмотра таблицы.
При малых ожидаемых частотах приближение распределением хи-квадрат может быть ненадёжным. Смотрите на ожидаемые, а не только на наблюдаемые значения; в зависимости от дизайна используют точный или имитационный тест. Структурные нули, то есть невозможные сочетания категорий, тоже требуют отдельной модели. Коэффициент рассчитывает описание таблицы, но не исправляет смещение выборки и не устанавливает причинность.
Например, если одни группы опрошены в интернете, а другие в магазине, различие способов оплаты может отражать способ отбора участников. Даже точно рассчитанный показатель не отделит этот эффект от различий самих групп. Исследователь должен заранее определить единицу наблюдения и объяснить, как собирались данные и обрабатывались пропущенные ответы.
Частые ошибки
- Путать два корня. В знаменателе стоит корень из произведения , а затем корень извлекается из всей дроби.
- Подставлять проценты вместо частот. Для и объёма используйте согласованные абсолютные частоты одних и тех же наблюдений.
- Считать единицу достижимой при любой форме. Для 2×3 общий предел по форме ниже единицы.
- Приравнивать связь к причине. Состав групп и другие факторы могут объяснять различия.
- Читать как вероятность или процент объяснения. Это мера расхождения распределений, а не доля дисперсии; о другом смысле квадрата корреляции см. связь корреляции и детерминации.
FAQ
Можно ли применять коэффициент к таблице 2×2?
Да. При он равен неотрицательной величине , то есть модулю коэффициента . Направление зависимости по одному не определить.
Что делать, если в ячейке стоит ноль?
Наблюдаемый ноль сам по себе допустим. Проверьте, что ожидаемая частота положительна и что модель допускает такое сочетание; отдельно оцените пригодность приближения критерия при малых ожидаемых частотах.
Можно ли сравнить показатели разных исследований?
Можно, но осторожно: проверьте одинаковость категорий и их числа, популяций и дизайна. Публикуйте также исходные частоты и размер выборки, чтобы различия можно было оценить содержательно.
Коротко
Коэффициент Чупрова нормирует статистику хи-квадрат по объёму и двум размерам таблицы. Для учебной таблицы 2×3 с и он равен примерно 0,343. Показатель описывает силу отклонения от независимости, не задаёт направление и не заменяет проверку гипотезы или анализ причин.
Читайте также
Таблица сопряжённости и критерий хи-квадрат Пирсона
Как проверить независимость признаков по таблице сопряжённости: ожидаемые частоты, расчёт хи-квадрат Пирсона, степени свободы, p-значение и ограничения метода.
Абсолютное преимущество Смита: пример и расчёт
Абсолютное преимущество Смита простыми словами: как сравнить затраты труда, рассчитать выигрыш от специализации и отличить его от сравнительного преимущества Рикардо.

Аддитивная факторная модель: формула и пример расчёта
Аддитивная факторная модель в экономике: как разложить показатель на слагаемые, рассчитать вклад каждого изменения и проверить результат на примере прибыли.
Автокорреляция уровней временного ряда: расчёт
Автокорреляция уровней временного ряда: как выбрать лаг, вычислить коэффициент на числовом примере и прочитать коррелограмму с учётом тренда и сезонности.
Базовый индекс потребительских цен: смысл и расчёт
Что показывает базовый индекс потребительских цен, какие компоненты исключают из расчёта, как сопоставить его с общим ИПЦ и правильно прочитать результат на примере.

Детерминированный факторный анализ: методы и пример
Детерминированный факторный анализ показывает вклад факторов в изменение показателя. Разбираем модели, цепные подстановки, абсолютные разницы и проверку расчёта.