Точный критерий Фишера: таблица сопряжённости
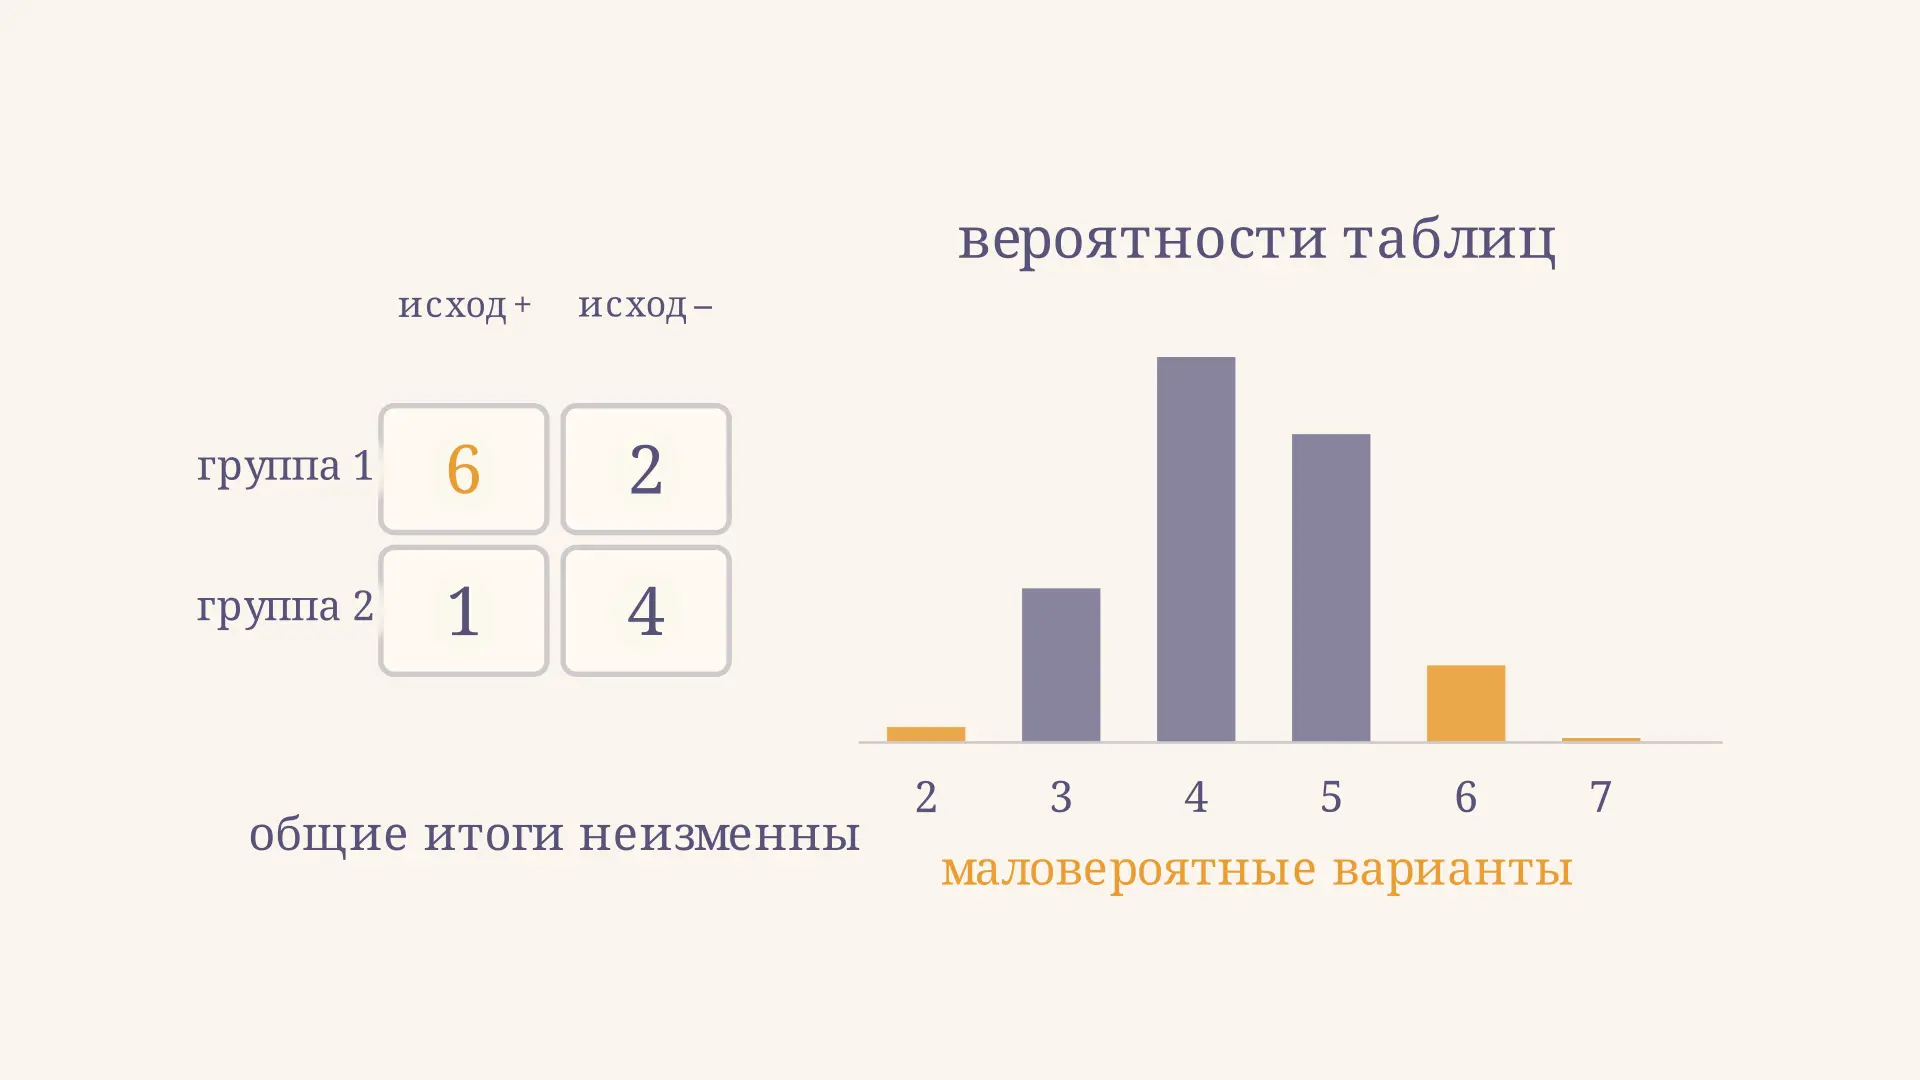
Точный критерий Фишера помогает проверить связь двух категориальных признаков в таблице сопряжённости, в том числе когда наблюдений мало и некоторые клетки редки или пусты. Для таблицы он сравнивает наблюдённое расположение частот с другими расположениями при тех же суммах строк и столбцов. Ниже разберём, какие таблицы участвуют в расчёте и почему двустороннее не всегда равно удвоенному одностороннему. В калькуляторе можно изменить четыре частоты и увидеть условное распределение.
Когда подходит точный критерий
Пусть независимые участники разделены на две группы, а у каждого отмечено наличие или отсутствие исхода. В клетках стоят числа наблюдений, а не проценты, ранги или средние. Тест применяют, чтобы проверить нулевую гипотезу об отсутствии связи между группой и исходом; для таблицы ей соответствует равенство отношения шансов единице, когда оно определено. Если сравниваются две независимые доли, та же гипотеза формулируется как равенство долей в генеральных совокупностях.
Условная модель сохраняет наблюдённые итоги обеих строк и обоих столбцов. Это позволяет получить точное распределение без приближения распределением хи-квадрат. Особенно полезен такой подход при малых ожидаемых частотах, хотя применять его можно и к большим выборкам. «Точный» относится к вычислению при принятой модели и фиксированных итогах: он не устраняет систематическую ошибку отбора, зависимость наблюдений или неверную разметку исходов.
Условия исследования важнее названия метода. В случайном распределении участников по группам и в наблюдательной выборке одинаковая таблица может возникнуть по разным причинам. Статистический тест сам по себе не превращает наблюдаемую связь в причинный эффект. Для повторных измерений одного человека, парных наблюдений или членов одной семьи независимость может нарушаться; тогда нужна модель, учитывающая соответствующую зависимость. Если категории выбраны после многократного просмотра данных, обычная интерпретация одного теста также может быть обманчивой.
Не путайте этот тест с критерием Фишера для сравнения дисперсий: у них общая фамилия, но разные данные и распределения. Точный тест работает с частотами категорий, а F-критерий - с отношением оценок дисперсий количественного признака.
Таблица и гипотезы
Обозначим частоты буквами:
| Исход есть | Исхода нет | Итого | |
|---|---|---|---|
| Группа 1 | |||
| Группа 2 | |||
| Итого |
Здесь . Каждый участник должен попасть ровно в одну клетку. При распределение исхода одинаково в обеих группах; двусторонняя альтернатива утверждает различие, не задавая его направление. Связь между формулировкой гипотез и решением подробнее разобрана в статье о нулевой и альтернативной гипотезах.
Одностороннюю альтернативу выбирают заранее. Если столбец «исход есть» первый, а первая строка - интересующая группа, вариант «в первой группе доля больше» соответствует большим значениям при фиксированных итогах. Перестановка строк или столбцов меняет направление хвоста; саму таблицу и смысл альтернативы нужно описывать вместе.
Как фиксированные итоги задают вероятность
Обозначим случайное значение верхней левой клетки через . При фиксированных итогах выбор автоматически определяет остальные три клетки: , и . Допустимы только целые , при которых ни одна клетка не отрицательна:
При условная вероятность такой таблицы задаётся гипергеометрической формулой:
Числитель считает способы поместить в первую группу наблюдений с исходом и остальные без исхода. Знаменатель считает все способы выбрать группу размера из наблюдений. Вероятности всех допустимых таблиц в сумме дают единицу. Это распределение условно: оно отвечает на вопрос о возможных таблицах при уже заданных итогах, а не о вероятности всех возможных исходов исследования.
Пример: расчёт двустороннего p
Рассмотрим учебные данные: в первой группе исход наблюдали у шести человек из восьми, во второй - у одного из пяти. Это иллюстрация метода, а не результаты исследования.
| Исход есть | Исхода нет | Итого | |
|---|---|---|---|
| Группа 1 | 6 | 2 | 8 |
| Группа 2 | 1 | 4 | 5 |
| Итого | 7 | 6 | 13 |
Итак, , суммы строк равны 8 и 5, столбцов - 7 и 6. Диапазон - от 2 до 7. Вероятность наблюдённой таблицы равна
Для стандартного двустороннего варианта, используемого в документации SciPy и R, складывают вероятности всех таблиц с вероятностью не больше наблюдённой. Здесь это :
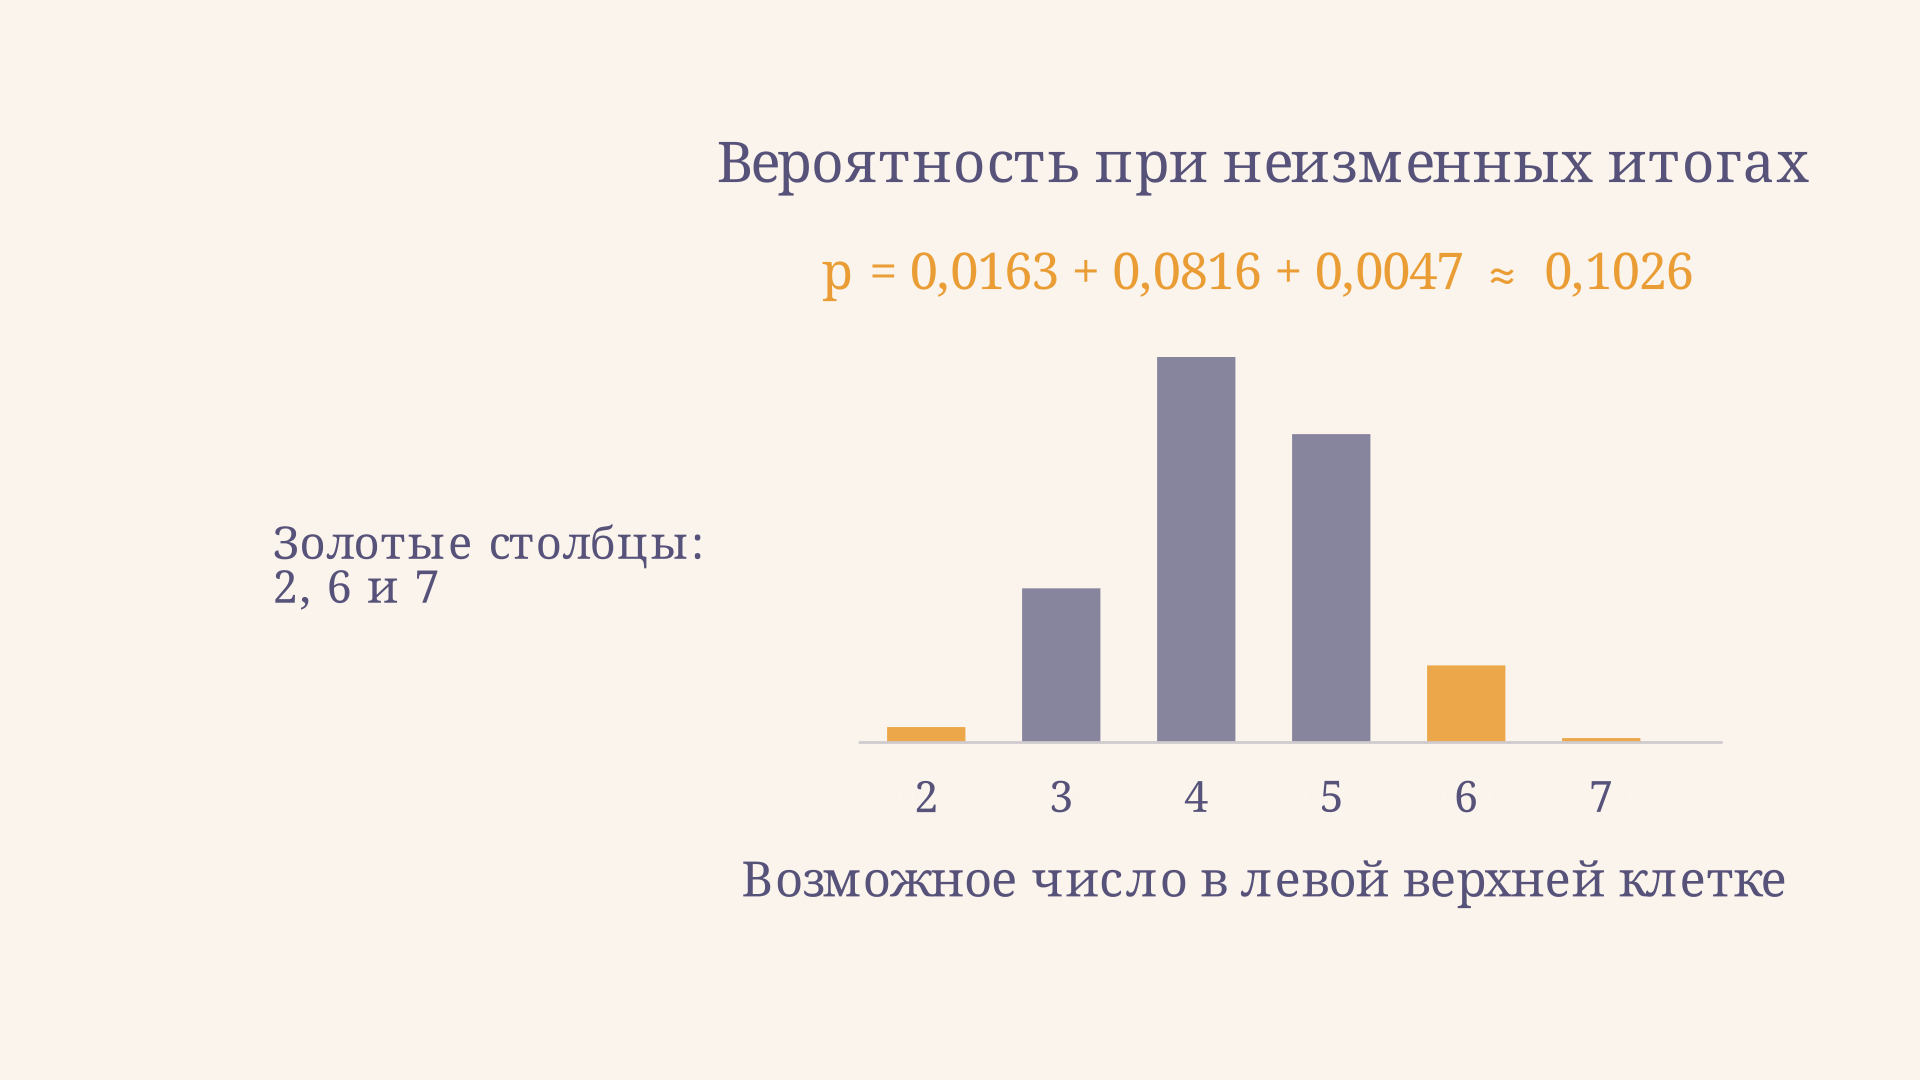
При выбранном заранее уровне значение , поэтому нулевую гипотезу не отвергают. Это не доказывает равенства долей: данные могут быть слишком малочисленны для обнаружения различия. Наблюдаемые доли и различаются, но вывод о статистической значимости учитывает разброс возможных таблиц при .
Односторонний и двусторонний варианты
Для альтернативы «доля в первой группе больше» правый хвост включает , то есть наблюдение и ещё более высокое значение . Его сумма равна . Для противоположной альтернативы левый хвост равен примерно . Наблюдённая таблица входит в каждый соответствующий хвост.
Заметим разницу между вероятностью одной таблицы и -значением. Число относится только к расположению частот, которое наблюдали. Для проверки гипотезы нужно включить и другие результаты, отвечающие заранее определённому правилу экстремальности. Поэтому само по себе малое значение вероятности одной таблицы ещё не является готовым двусторонним ответом. Даже при верной нулевой гипотезе одна из возможных таблиц обязательно реализуется.
Двусторонний результат здесь не равен удвоенному правому хвосту: он отбирает таблицы по их вероятности, в том числе таблицу с другого края распределения. Распределение дискретно и может быть несимметричным. Существуют и другие определения двустороннего точного , поэтому при сравнении программ важно указать правило расчёта. Про выбор порога и смысл ошибки первого рода см. уровень значимости и критическую область.
Что сообщать вместе с результатом
Укажите исходную таблицу, направление альтернативы, способ получения двустороннего и заранее выбранный уровень значимости. Отдельно полезно привести размеры групп и сами доли: не показывает величину эффекта. Для таблицы без нулевых клеток выборочное отношение шансов равно ; здесь это . Шансы не равны вероятностям, а оценка по маленькой выборке может быть очень неточной. Доверительный интервал помогает показать неопределённость эффекта; метод его построения нужно указывать отдельно.
При нуле в клетке выборочное отношение шансов может стать нулевым, бесконечным или неопределённым, но сам условный тест для допустимой таблицы остаётся вычислимым. Если целая строка или столбец пусты, распределение может выродиться в единственную таблицу, и сравнение не даёт информации о связи. Калькулятор показывает условные вероятности даже в таком граничном случае.
Практическое оформление вывода может выглядеть так: «В группе 1 исход отмечен у 6 из 8, в группе 2 - у 1 из 5; двусторонний точный критерий Фишера, ». После этого следует описать вывод при заданном и неопределённость оценки. Округлять стоит только конечные результаты: предварительное округление отдельных вероятностей способно изменить сравнение около границы значимости.
Для больших таблиц существуют обобщения точного теста, но перебор становится сложнее; нельзя автоматически применять формулу одной клетки ко всем размерам. Если интересует величина связи категориальных признаков, а не только проверка отсутствия связи, полезно также изучить коэффициент сопряжённости Пирсона: это другая характеристика, и она не заменяет описание таблицы.
Проверяя расчёт вручную, удобно сначала выписать крайние допустимые значения клетки, затем построить для каждого полную таблицу. Суммы строк и столбцов должны совпасть с исходными на каждом шаге. После этого можно вычислить вероятности и проверить, что они суммируются в единицу. Для двустороннего ответа сравнивают каждую вероятность с вероятностью наблюдённой таблицы без преждевременного округления. Это помогает не пропустить допустимый вариант на другом краю распределения.
Частые ошибки
- Подставлять проценты вместо частот. Условное распределение строится по целым числам независимых наблюдений; проценты теряют размер выборки.
- Выбирать хвост после просмотра данных. Направление гипотезы задают до анализа и привязывают к порядку строк и столбцов.
- Считать вероятностью истинности . Это вероятность выбранного множества таблиц при принятой нулевой модели и фиксированных итогах.
- Принимать отсутствие значимости за доказательство равенства. Небольшое исследование может давать широкий диапазон совместимых эффектов.
- Смешивать разные двусторонние правила. Удвоение меньшего хвоста и сумма вероятностей не более наблюдённой могут дать разные ответы.
FAQ
Можно ли использовать тест при нулевой клетке? Да, нулевая частота сама по себе не запрещает тест. Важно, чтобы данные были целыми частотами и модель независимых наблюдений подходила задаче.
Нужен ли критерий только при малых выборках? Нет. Он применим и при больших частотах, но особенно полезен, когда приближение хи-квадрат вызывает сомнения. Точность условного расчёта не гарантирует отсутствие смещения данных.
Почему равно 1 при пустой строке? При фиксированных итогах остаётся лишь одна допустимая таблица с вероятностью 1. Такой результат не подтверждает независимость: данных для сравнения групп здесь нет.
Коротко
Точный критерий Фишера для таблицы использует условное гипергеометрическое распределение при фиксированных суммах. Двустороннее по правилу вероятностей суммирует все таблицы, не более вероятные, чем наблюдённая. Для таблицы оно равно примерно ; при уровне 0,05 оснований отвергнуть нулевую гипотезу нет. Для содержательного вывода нужны также направление проверки, размер эффекта и контекст сбора данных.
Читайте также
Таблица сопряжённости и критерий хи-квадрат Пирсона
Как проверить независимость признаков по таблице сопряжённости: ожидаемые частоты, расчёт хи-квадрат Пирсона, степени свободы, p-значение и ограничения метода.
Доверительная вероятность и уровень значимости
Как связаны доверительная вероятность и уровень значимости: формула, смысл ошибок, пример доверительного интервала среднего и проверка двусторонней гипотезы.
Проверка гипотезы о среднем нормального распределения
Как проверить гипотезу о среднем нормального распределения: выбор Z- или t-критерия, формулы, пример расчёта, критические области и интерпретация результата.
Уровень значимости и критическая область
Как связаны уровень значимости и критическая область: односторонний и двусторонний критерии, критические значения, p-значение и пример расчёта Z-критерия.
Мощность статистического критерия: формула и расчёт
Мощность статистического критерия 1-beta: как рассчитать через ошибку II рода, объём выборки и эффект-сайз. Формула для z-теста, целевой порог 80 %, примеры.
Как работает ANOVA однофакторный дисперсионный анализ
ANOVA однофакторный дисперсионный анализ сравнивает средние в трёх и более группах. Разбираем суммы квадратов, F-критерий и условия применимости на примере с расчётом.