Проверка гипотезы о среднем нормального распределения
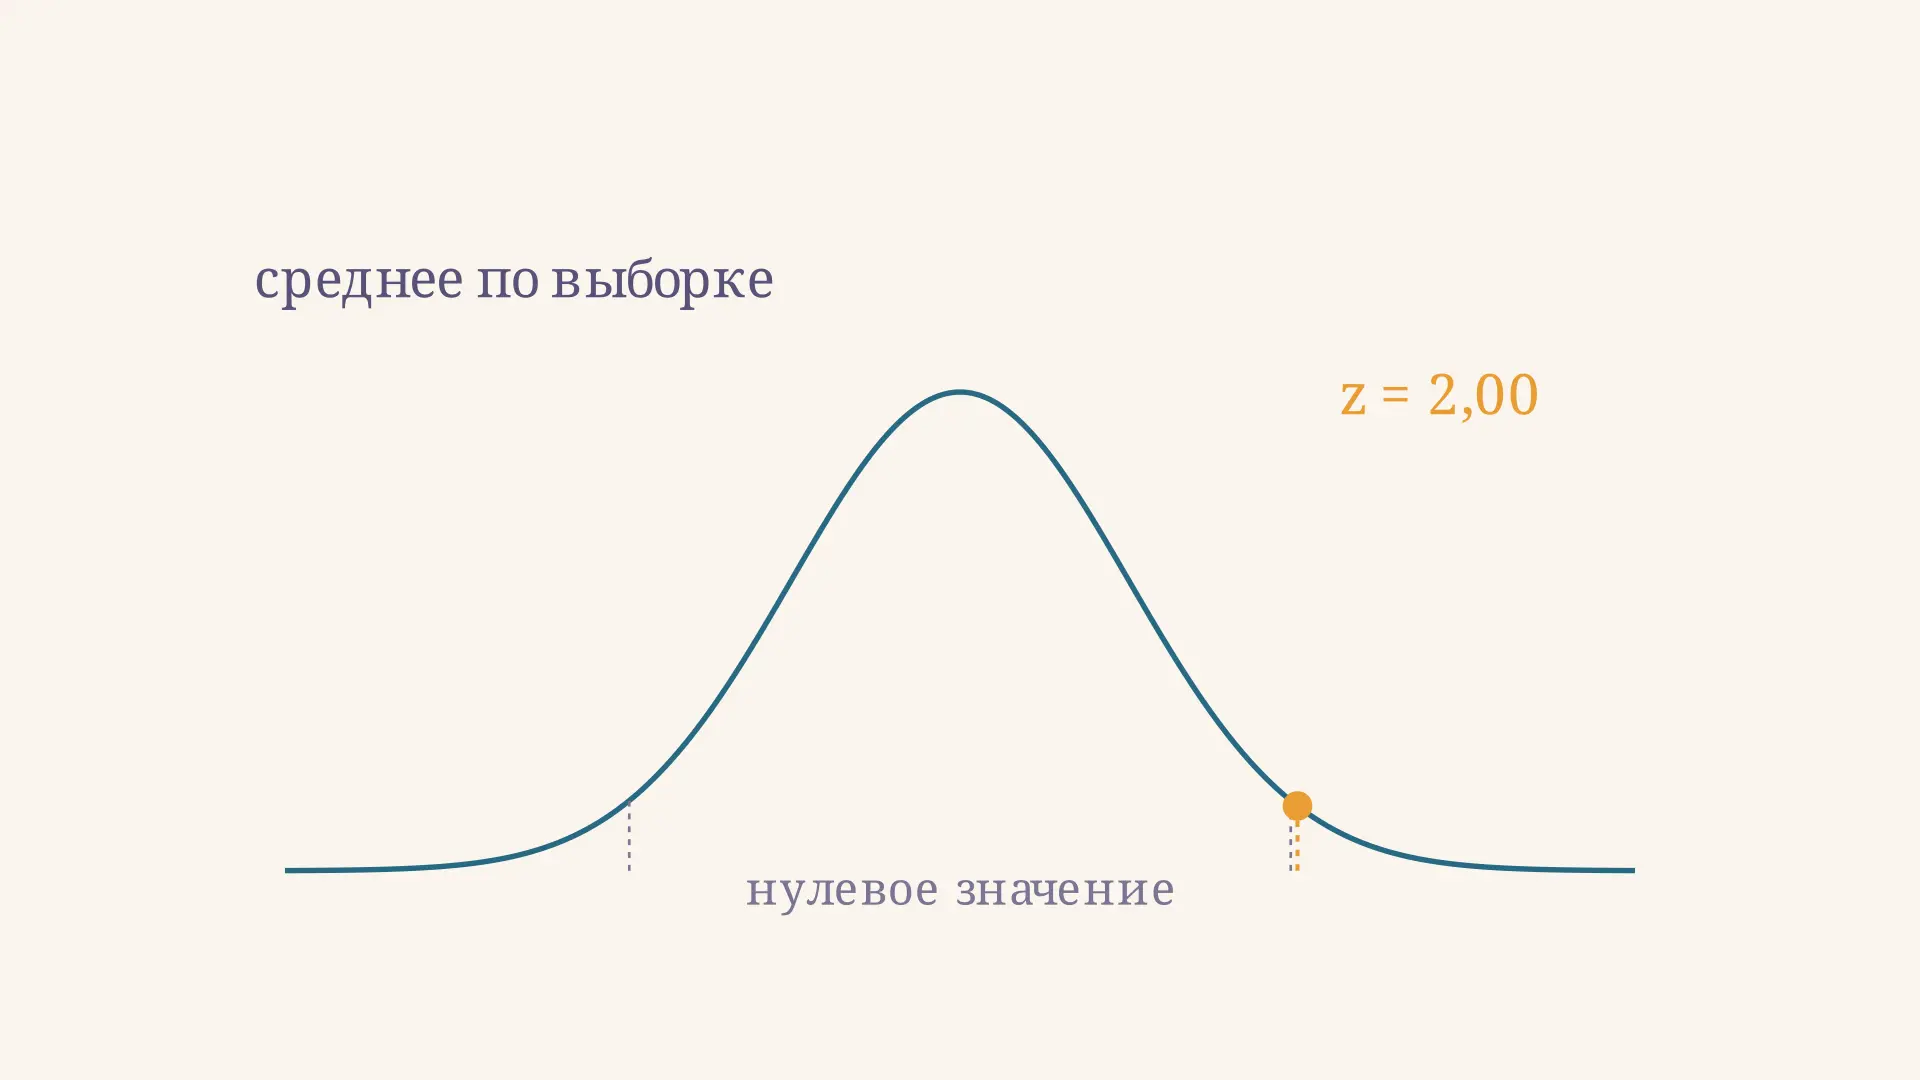
Проверка гипотезы о среднем нормального распределения помогает решить, совместимо ли среднее одной выборки с заданным значением генеральной совокупности. Разница между ними почти всегда не равна нулю: из-за случайного отбора выборочное среднее меняется от выборки к выборке. Чтобы оценить отклонение, его сравнивают со стандартной ошибкой и учитывают, известно ли стандартное отклонение всей совокупности.
Калькулятор показывает двусторонний Z-критерий для гипотезы . Например, при , и известном он получает и . Попробуйте изменить среднее или объём выборки: точка переместится относительно критических границ.
Что именно проверяется
Пусть независимые наблюдения получены из нормального распределения . Параметр - неизвестное среднее всей совокупности, а - среднее конечной выборки. В задаче заранее задают проверяемое значение и формулируют, например,
Это одновыборочная задача: она сопоставляет одну совокупность с фиксированным числом. Для сравнения двух независимых групп применяют другие формулы: см. проверку равенства двух средних. Значение и направление альтернативы выбирают до знакомства с результатом, исходя из вопроса исследования.
На видео маркер движется вслед за средним выборки при неизменных и . По мере удаления среднего от 100 статистика приближается к правой критической границе и пересекает её. Кривая показывает распределение статистики при условии , а не распределение исходных наблюдений.
Известная дисперсия: Z-критерий
При известном среднее независимой нормальной выборки имеет распределение . Поэтому при величина
подчиняется стандартному нормальному распределению. Знаменатель - стандартное отклонение распределения выборочного среднего, или стандартная ошибка. Деление на неё показывает, сколько таких ошибок отделяет наблюдаемое среднее от значения по нулевой гипотезе. Само характеризует разброс отдельных наблюдений; заменять им стандартную ошибку нельзя.
Этот результат точен для независимой нормальной выборки любого объёма. При других распределениях нормальное приближение иногда возможно для больших выборок, но его качество зависит от формы распределения и условий отбора. Нормальность и независимость не следуют автоматически из размера данных. Например, систематическая погрешность или последовательные измерения одного объекта могут нарушать модель; о форме распределения измерительных ошибок рассказано в статье про нормальный закон погрешности.
Неизвестная дисперсия: критерий Стьюдента
На практике часто неизвестно. Тогда вычисляют исправленное выборочное стандартное отклонение :
Для независимой выборки из нормального распределения при статистика имеет распределение Стьюдента с степенями свободы. Нужно и . Хвосты этого распределения тяжелее нормальных, поскольку разброс оценивается по тем же данным. При увеличении числа степеней свободы распределение приближается к нормальному; подробнее об этом - в статье о распределении Стьюдента.
Ключевой вопрос - действительно ли известно извне и может считаться фиксированным параметром модели. Если дано только выборочное , подстановка его в Z-формулу с нормальными критическими значениями не превращает задачу в точный Z-тест. Калькулятор выше предназначен именно для известного .
Как проверить предпосылки на практике
Сначала уточните единицу наблюдения и способ отбора. Если несколько измерений сделаны на одном объекте, они могут быть зависимыми: считать каждое отдельной независимой единицей нельзя без обоснования. При парном плане иногда анализируют разности внутри пар как одну выборку, но нормальность и независимость тогда относятся именно к этим разностям. Заранее проверьте также, не исключались ли наблюдения по правилу, зависящему от их значения.
Для оценки формы данных полезны график наблюдений и нормальный квантильный график. Они помогают заметить выраженную асимметрию и выбросы, но небольшой набор данных не позволяет надёжно подтвердить идеальную нормальность. Особое внимание уделяют происхождению экстремального значения: ошибка записи и реальное редкое наблюдение требуют разных действий. Решение об исключении должно опираться на независимые основания и быть описано вместе с результатом.
Если модель существенно нарушена, стоит пересмотреть дизайн, изучить природу данных или выбрать подходящий альтернативный метод. Простая замена теста не исправит зависимость, систематическую ошибку измерения или нерепрезентативный отбор. В отчёте указывают объём выборки, среднее, используемую оценку разброса, альтернативу и уровень значимости, а также саму статистику и её распределение. Так читатель сможет воспроизвести решение и увидеть границы вывода.
Границы и уровень значимости
Для двустороннего критерия заранее задают уровень значимости . При под нулевым стандартным нормальным распределением в каждом хвосте остаётся по . Границы равны приблизительно и : нулевую гипотезу отвергают, когда с учётом округления. Точное сравнение выполняют с неокруглённым квантилем .
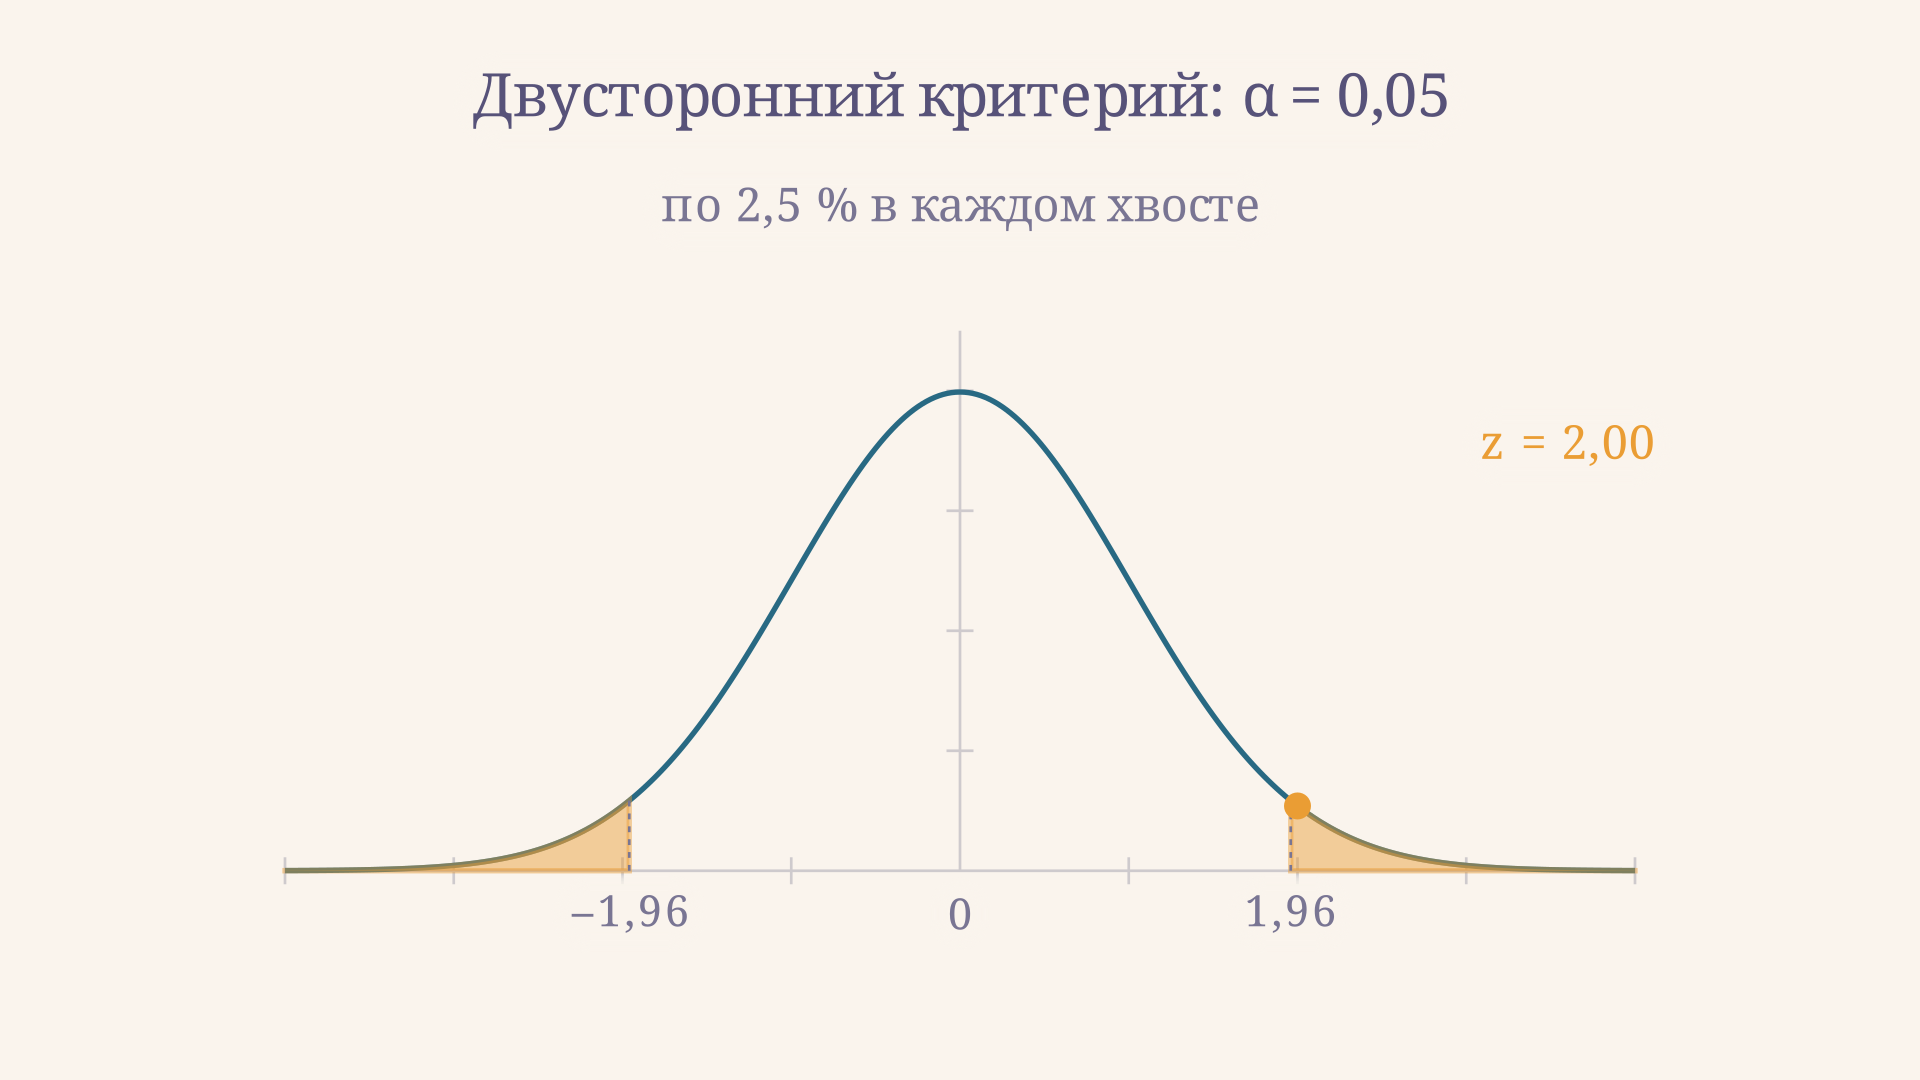
Для альтернативы вся критическая область лежит справа; для - слева. При том же односторонняя нормальная граница составляет около по модулю. Нельзя выбирать сторону после просмотра знака разности: это меняет заранее заданную процедуру. Общий смысл нулевой и альтернативной гипотез полезно отделять от выбора конкретной статистики.
Пример: средний результат 104
Рассмотрим учебные данные без единиц измерения: , , , известное . Проверяем двустороннюю альтернативу при . Подставляем числа:
Наблюдаемое среднее находится на две стандартные ошибки выше предполагаемого. Поскольку , результат попадает в критическую область. Двустороннее значение тоже меньше : нулевую гипотезу отвергают на выбранном уровне.
При тех же числах, но если 10 - выборочное , а не известное , статистика численно останется равна 2. Однако её сравнивают с распределением Стьюдента при 24 степенях свободы. Здесь двустороннее , критическое значение около : оснований отвергнуть на уровне 0,05 недостаточно. Изменился не набор чисел, а информация о разбросе и потому распределение статистики. Формулы обоих случаев и сравнение с критическими значениями приведены в руководстве NIST.
Как размер выборки меняет решение
Посмотрим на те же учебные данные с известным стандартным отклонением десять и наблюдаемым средним 104. Если объём выборки уменьшить до четырёх, стандартная ошибка вырастет до пяти, а статистика станет равна 0,8. Такое отклонение гораздо ближе к центру нулевого распределения, поэтому двусторонний тест на пяти процентах не отвергнет исходную гипотезу. В калькуляторе можно проверить это, передвинув ползунок числа наблюдений.
Если же при том же среднем и стандартном отклонении рассмотреть 100 независимых наблюдений, стандартная ошибка составит единицу, а статистика достигнет четырёх. Она окажется далеко за критической границей. Это сравнение показывает роль размера выборки при фиксированных остальных числах; оно не утверждает, что среднее останется неизменным после реального добавления наблюдений. Новые данные могут изменить и среднее, и вывод.
При планировании исследования объём выборки лучше определять до сбора данных. Для этого задают практически существенное отклонение, предполагаемый разброс, уровень значимости и желаемую мощность. Мощность - вероятность обнаружить заданное отличие при условии, что оно существует и принятая модель верна. Расчёт для известного разброса отличается от расчёта для неизвестного, а пропуски и зависимость наблюдений могут уменьшить фактическую информативность данных. Запас наблюдений сам по себе не делает нерепрезентативную выборку случайной.
Что означает вывод
Значение - вероятность при условии нулевой модели получить статистику не менее экстремальную, чем наблюдаемая, в обе стороны для двустороннего теста. Оно не является вероятностью истинности и не измеряет величину эффекта. В примере разница средних составляет 4 единицы, а её практическая значимость зависит от предметной задачи.
Неотклонение гипотезы тоже не доказывает точного равенства: данные могут быть недостаточно чувствительными к небольшому отличию. При фиксированных разнице и увеличение уменьшает стандартную ошибку, но размер выборки не устраняет смещение отбора. Вероятность ошибочно отвергнуть верную нулевую гипотезу контролируется уровнем при выполнении модели; об остальных исходах читайте в статье об ошибках первого и второго рода.
Для двустороннего Z-теста соответствующий 95%-й доверительный интервал равен . В нашем примере это примерно : значение 100 вне интервала, что согласуется с отклонением . Интервал одновременно показывает диапазон совместимых с моделью значений и точность оценки.
Частые ошибки
- Сравнивают с отдельное наблюдение вместо выборочного среднего или используют вместо .
- Применяют нормальные критические значения, когда известна только выборочная оценка и требуется точный t-критерий.
- Берут один хвост для двусторонней альтернативы или меняют направление после наблюдения данных.
- Объявляют вероятностью истинности гипотезы или считают незначимый результат доказательством равенства.
- Игнорируют зависимость наблюдений, выбросы и способ формирования выборки: формула не исправит неподходящую модель.
FAQ
Можно ли применять t-критерий к малой выборке?
Да, если независимые наблюдения происходят из нормального распределения и . Для малой выборки отклонения от нормальности и сильные выбросы особенно важны для оценки применимости.
Что делать, если выборочное среднее равно ?
При положительной стандартной ошибке статистика равна нулю, а двустороннее . Это не доказывает точного равенства параметра заданному значению.
Всегда ли большая выборка означает практически важный результат?
Нет. Большой объём способен выявить малое отличие; оцените его размер, доверительный интервал и значимость в контексте задачи.
Коротко
Для одной нормальной независимой выборки сравнивайте среднее с заданным в единицах стандартной ошибки. При известном используйте Z-критерий, при неизвестном - t-критерий с степенями свободы. Вывод зависит от альтернативы, уровня значимости и выполнения предпосылок.
Читайте также
Доверительная вероятность и уровень значимости
Как связаны доверительная вероятность и уровень значимости: формула, смысл ошибок, пример доверительного интервала среднего и проверка двусторонней гипотезы.
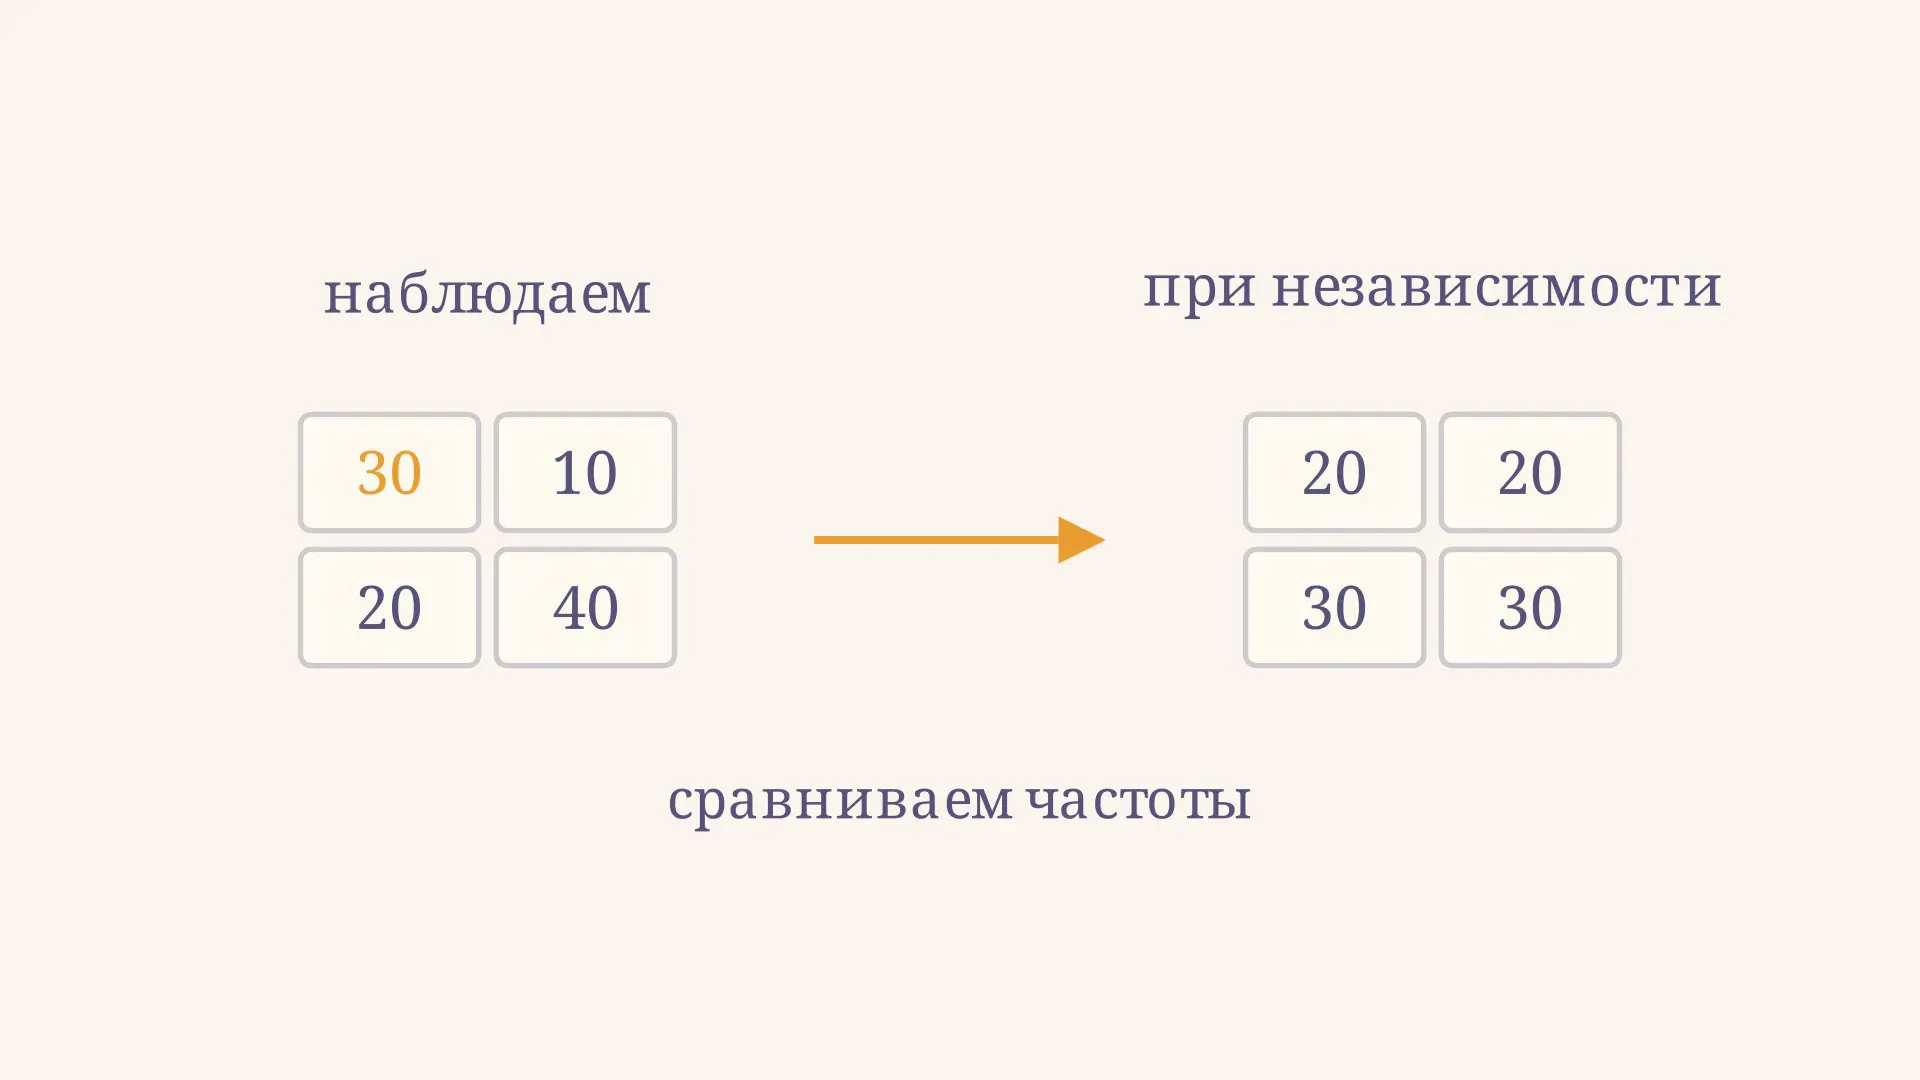
Таблица сопряжённости и критерий хи-квадрат Пирсона
Как проверить независимость признаков по таблице сопряжённости: ожидаемые частоты, расчёт хи-квадрат Пирсона, степени свободы, p-значение и ограничения метода.
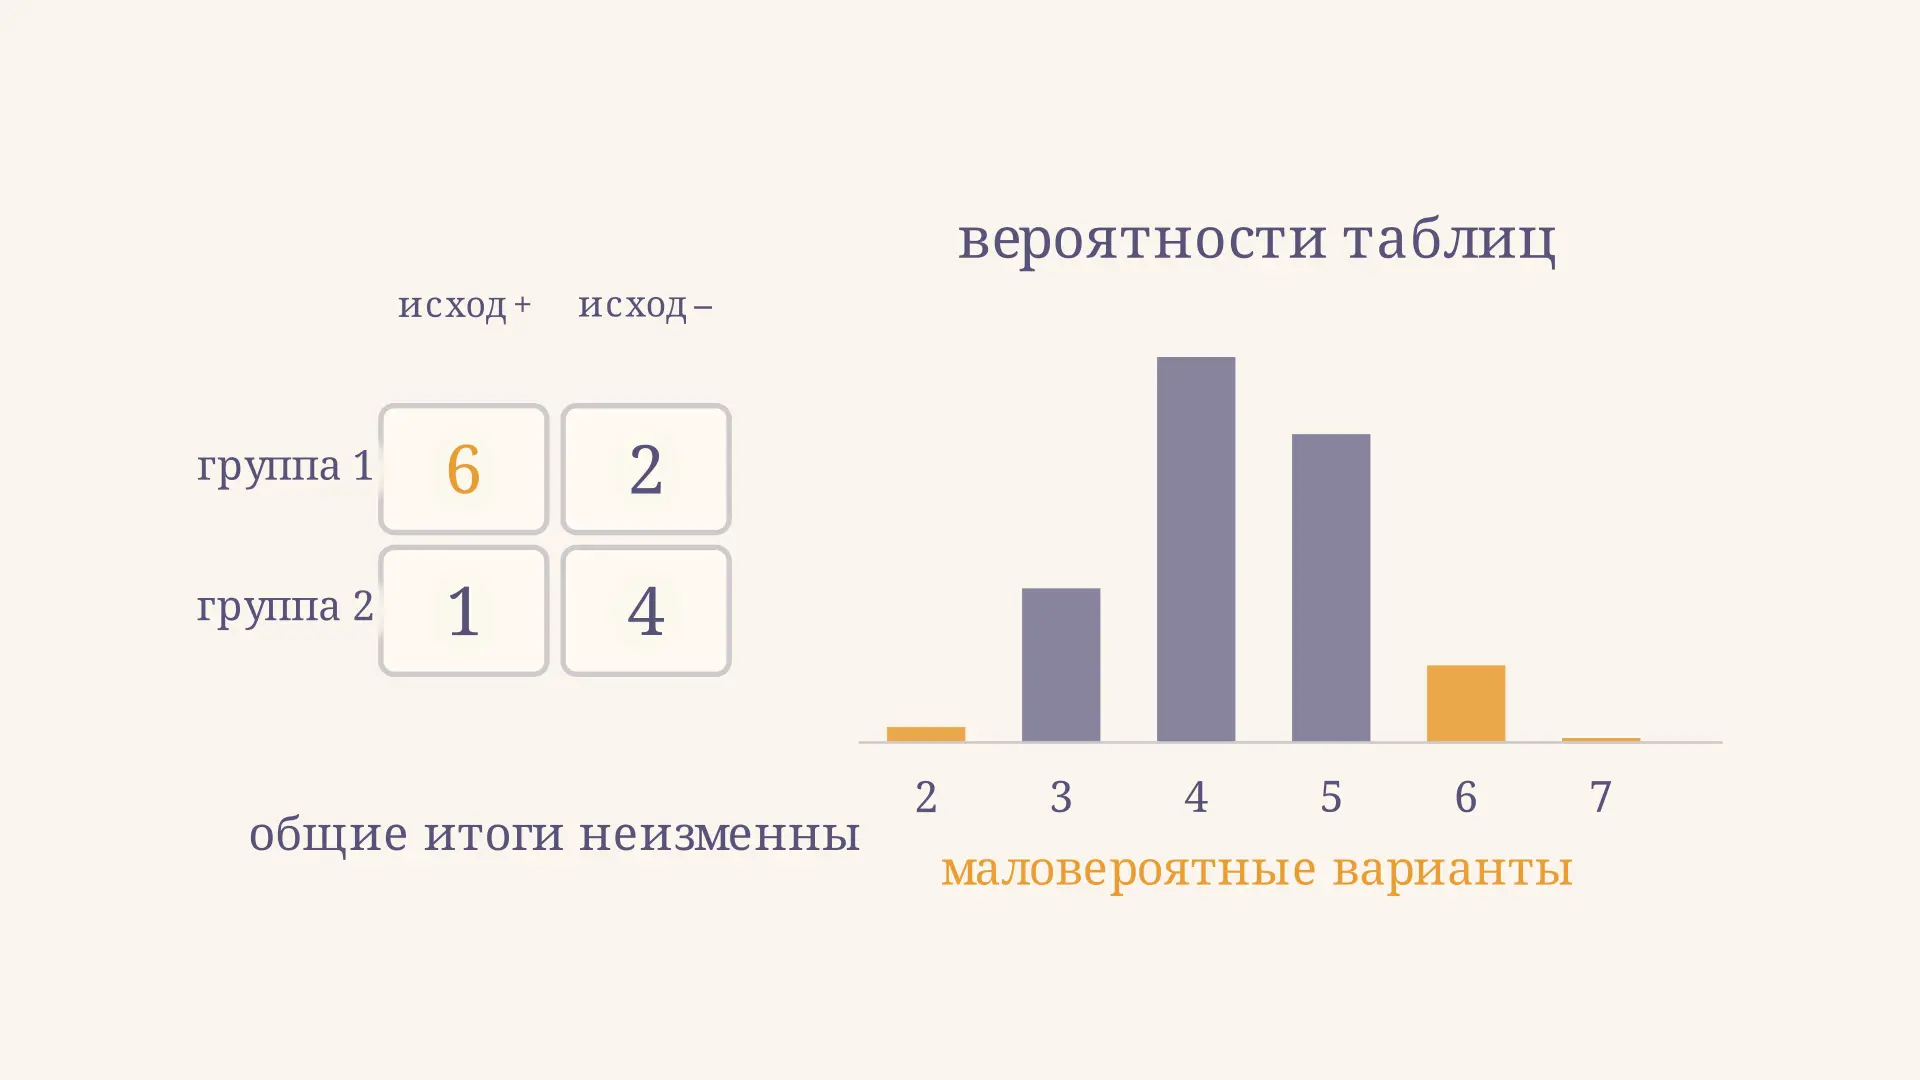
Точный критерий Фишера: таблица сопряжённости
Как применять точный критерий Фишера к таблице сопряжённости 2×2: условное распределение, одностороннее и двустороннее p, пример расчёта и интерпретация.
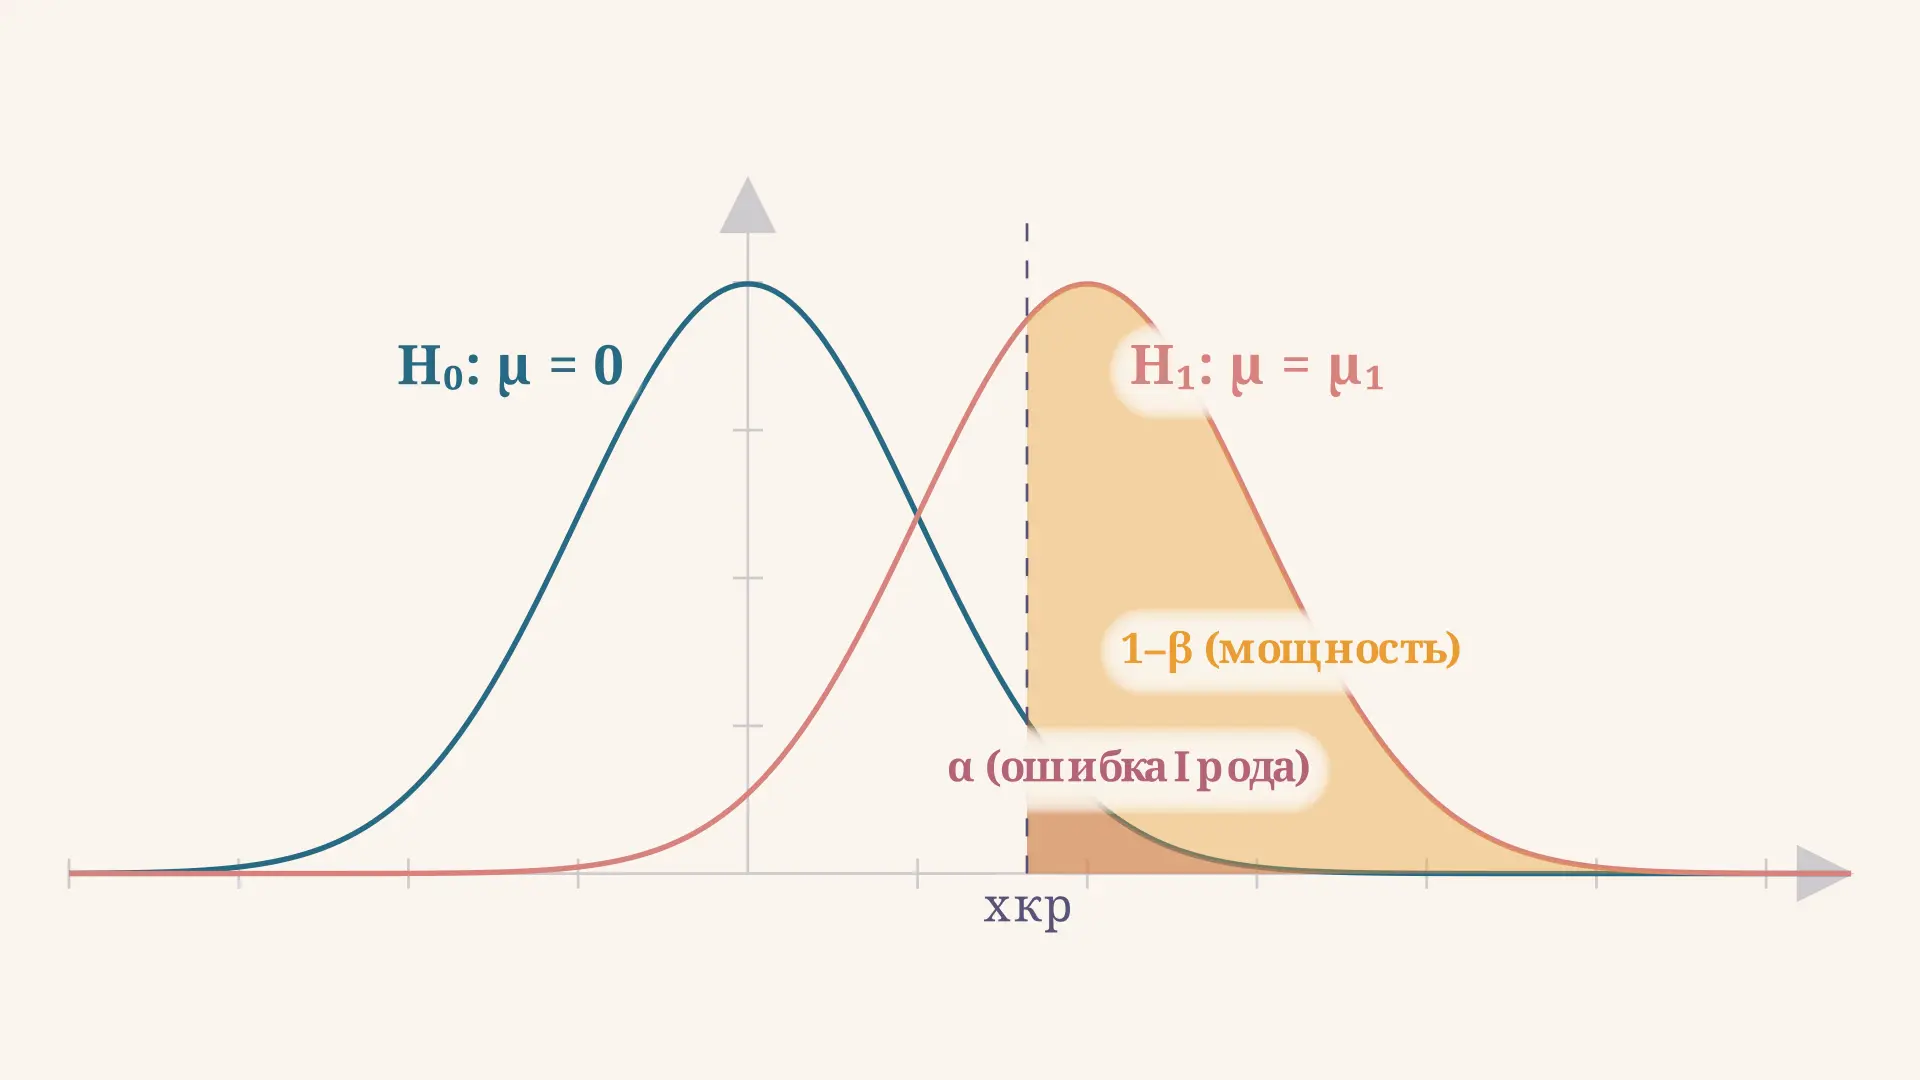
Мощность статистического критерия: формула и расчёт
Мощность статистического критерия 1-beta: как рассчитать через ошибку II рода, объём выборки и эффект-сайз. Формула для z-теста, целевой порог 80 %, примеры.
Распределение Стьюдента: роль степеней свободы
Распределение Стьюдента и его степени свободы: что такое параметр df, как он меняет форму t-распределения, как считать критические значения и применять в t-тестах и доверительных интервалах.
Как работает ANOVA однофакторный дисперсионный анализ
ANOVA однофакторный дисперсионный анализ сравнивает средние в трёх и более группах. Разбираем суммы квадратов, F-критерий и условия применимости на примере с расчётом.