Ошибки первого и второго рода при проверке гипотез
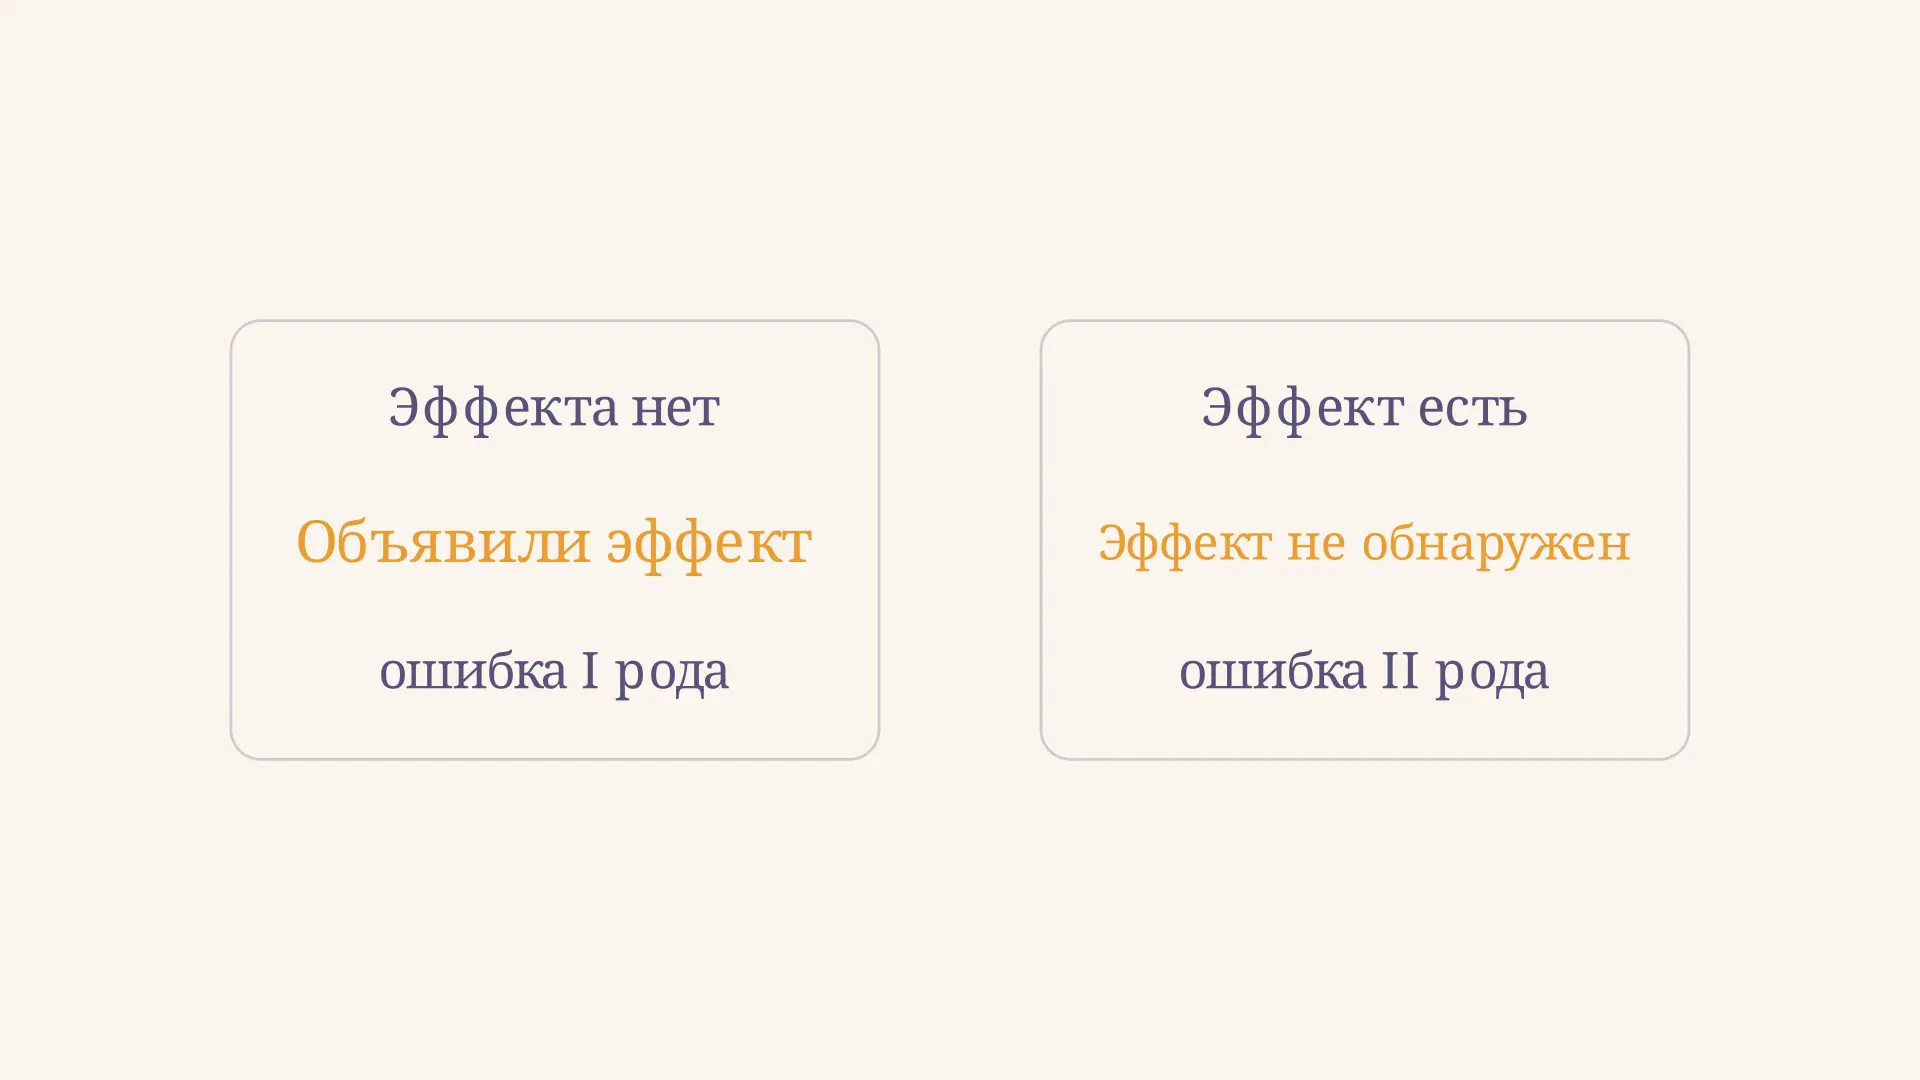
Статистический критерий превращает данные в решение: отвергнуть нулевую гипотезу или пока не отвергать её. Из-за случайности выборки оба решения иногда оказываются ошибочными. Можно объявить эффект, которого нет, или пропустить существующий эффект. Это ошибки первого и второго рода. Калькулятор показывает, как связаны порог решения и вероятность пропуска в конкретной модели; попробуйте изменить уровень значимости или объём выборки.
Четыре исхода одного решения
Пусть проверяют, увеличила ли новая настройка среднюю производительность процесса. Нулевая гипотеза утверждает, что увеличения нет, а альтернатива допускает увеличение. Подробно формулировка пары разобрана в статье про нулевую и альтернативную гипотезы. Здесь важнее сопоставить решение с неизвестным истинным положением дел.
| Решение по выборке | Увеличения нет | Увеличение есть |
|---|---|---|
| Отвергнуть | Ошибка I рода | Верное обнаружение |
| Не отвергать | Верное решение | Ошибка II рода |
Ошибка первого рода - ложная тревога: критерий показал увеличение, хотя его нет. В производстве это может привести к ненужной перенастройке оборудования. Вероятность такой ошибки при верной обозначают . Уровень значимости задаёт допустимую верхнюю границу этого риска; в приведённом ниже непрерывном z-критерии на границе нулевой гипотезы вероятность равна выбранному уровню.
Ошибка второго рода - пропуск: увеличение действительно существует, но критерий не отвергает . Его вероятность обозначают . При этом надо указать, какое именно увеличение существует: слабый и сильный эффекты обнаруживаются с разной вероятностью. Так же определяет ошибки и мощность NIST в техническом руководстве.
Почему порог меняет обе ошибки
Для правостороннего критерия решение определяется порогом: если статистика выше него, отвергают. При верной значения статистики иногда случайно оказываются выше порога - это ложные тревоги. При заданном положительном эффекте распределение статистики смещается вправо, но его часть может оставаться левее порога - это пропуски.
Повысим порог при неизменных распределениях. Ложных тревог станет меньше: при статистике труднее попасть в область отвержения. Но больше результатов при реальном эффекте останется ниже порога. Поэтому при фиксированных объёме выборки, модели и величине эффекта уменьшение увеличивает . Обратный сдвиг порога меняет риски в противоположных направлениях.
Это не универсальный закон о любых двух процедурах: если одновременно увеличить выборку или изменить план эксперимента, можно уменьшить вероятность пропуска при том же или более строгом уровне значимости. Сначала нужно задать, что именно остаётся фиксированным.
Расчёт ошибки второго рода на примере
Рассмотрим учебную модель независимых нормальных наблюдений с известным стандартным отклонением . Проверяем против . На границе статистика
имеет стандартное нормальное распределение. При критический порог равен , где - функция распределения стандартной нормали. Отвергаем , если .
Пусть , а интересующее нас истинное увеличение равно . Тогда среднее статистики при этом эффекте сдвигается на . Её распределение становится нормальным со средним 2 и стандартным отклонением 1. Ошибка второго рода - вероятность остаться левее порога при этом конкретном эффекте:
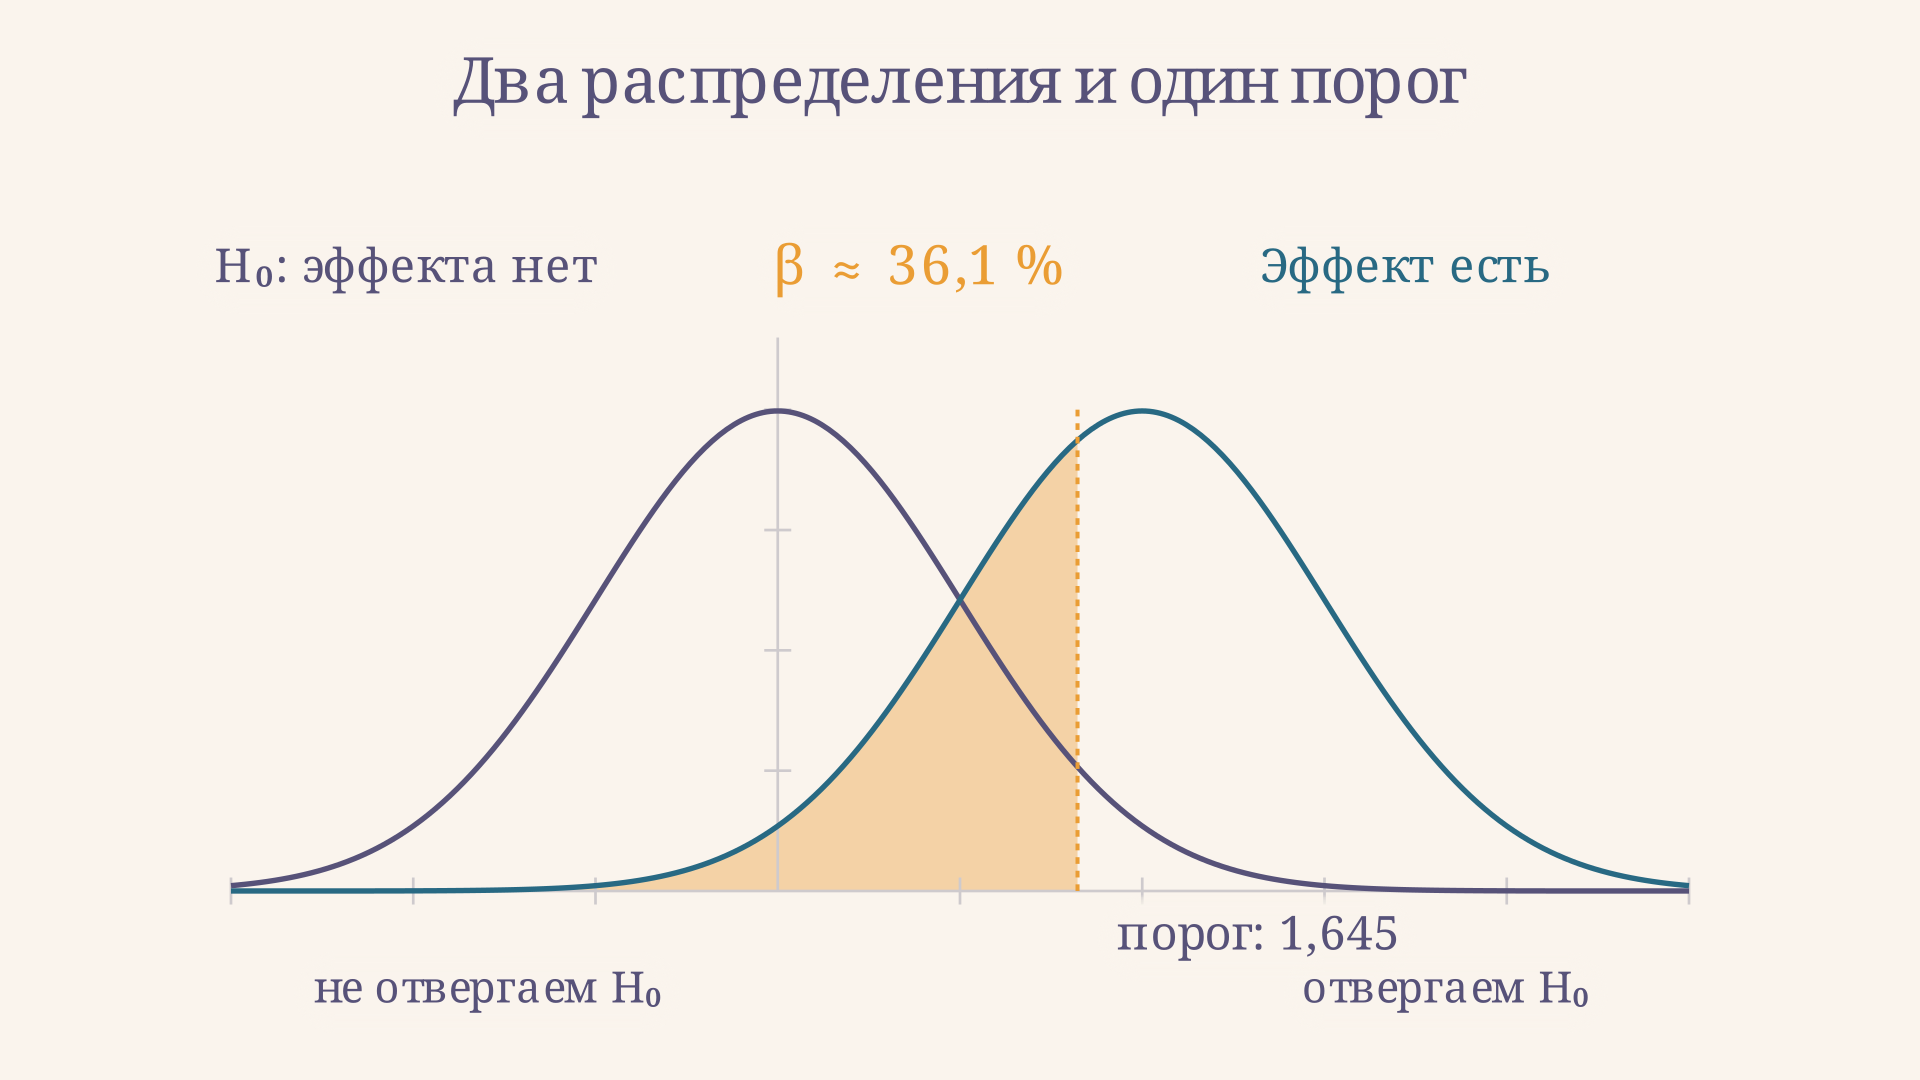
Значит, при многократном повторении такого эксперимента примерно в 36,1 % случаев критерий не обнаружит заданное увеличение. В оставшихся 63,9 % он его обнаружит. Это частоты в модели повторных выборок, а не вероятность того, что эффект существует в одном конкретном исследовании.
Если при том же и эффекте установить , порог возрастёт до , а - примерно до . Снижение вероятности ложной тревоги здесь оплачивается более частым пропуском. Нормальная модель является предположением примера; свойства реальных измерений и способ отбора нужно проверять отдельно. О роли нормального распределения при измерениях читайте в материале о нормальном законе погрешности.
При чтении графика важно различать две кривые. Левая описывает поведение статистики, если среднее находится на границе нулевой гипотезы. Правая относится к одному заранее выбранному увеличению среднего. Их горизонтальная координата - значение статистики, а не отдельное наблюдение и не вероятность. Вероятность соответствует площади под кривой на нужном участке. Высота кривой в одной точке сама по себе не является вероятностью этой точки.
Порог одинаков для обеих ситуаций, поскольку правило решения устанавливают до того, как узнают истинное среднее. Он делит возможные значения на две области, но не делит людей или устройства на две группы. Если фактическое увеличение меньше выбранного для расчёта, распределения окажутся ближе и пропуск станет вероятнее. Если увеличение больше, они разойдутся, и мощность вырастет. Поэтому одну цифру пропуска нельзя переносить на все возможные размеры эффекта.
Мощность и размер выборки
Мощность при заданном эффекте - вероятность правильно отвергнуть :
Для первого варианта примера она составляет , или около 63,9 %. Мощность зависит от величины эффекта, разброса, числа независимых наблюдений, уровня значимости и выбранного критерия. Поэтому выражение «мощность равна 80 %» без указания эффекта и остальных условий неполно.
Если сохранить и эффект , но увеличить выборку с 25 до 100 независимых наблюдений, сдвиг среднего статистики вырастет с 2 до 4. Теперь , а мощность - около 99,1 %. Калькулятор воспроизводит эти значения. В другом исследовании тот же объём не гарантирует такой результат: например, меньший эффект труднее различить на фоне шума.
Увеличение числа записей само по себе не всегда означает увеличение числа независимых наблюдений. Повторные измерения одного объекта или данные из связанных групп требуют учёта зависимости. Принцип отбора и его последствия рассмотрены в статье про собственно-случайную выборку.
При проектировании исследования удобно начать с практически значимого изменения: например, определить минимальное увеличение производительности, которое оправдывает стоимость перенастройки. Затем оценивают разброс на основе доступной информации и задают желаемую мощность для этого изменения. Полученный объём выборки зависит от качества исходных предположений. Если реальный разброс больше ожидаемого, фактическая мощность при прочих равных будет ниже расчётной.
Высокая мощность не делает любой обнаруженный эффект полезным на практике. Она лишь описывает вероятность обнаружения конкретного эффекта по заданному правилу. После анализа полезно отдельно сообщить оценку величины изменения и её неопределённость, чтобы читатель мог оценить масштаб результата. Для этой цели используют, например, доверительный интервал; его построение должно соответствовать модели и дизайну исследования.
Как применять понятия в задаче
Сначала сформулируйте и альтернативу в терминах измеряемой величины. Затем для каждого решения опишите последствия в обычных словах. В задаче о настройке оборудования ошибка I рода означает ненужное внедрение, а ошибка II рода - отказ от действительно полезной настройки. В задаче о безопасности цена каждого промаха может быть иной, поэтому выбор уровня значимости зависит от контекста.
Далее установите уровень до анализа, выберите модель и задайте эффект, который важно обнаружить. Только после этого осмысленно считать и мощность. Для нашей модели формула при эффекте такова:
Она относится к одному среднему и правостороннему тесту с известной . Для двух независимых групп формула и стандартная ошибка другие: их постановка рассмотрена в статье о проверке равенства двух средних. Подстановка этих данных в одновыборочный калькулятор даст неверный результат.
При планировании полезно сравнить несколько правдоподобных эффектов, а не полагаться на одну оценку. Для каждого значения можно рассчитать мощность и построить кривую: она покажет, какие эффекты выбранный дизайн обнаруживает достаточно часто. Если нужная мощность недостижима, пересматривают размер выборки или точность измерений с учётом доступных ресурсов. Важно сохранить заранее выбранное правило анализа: изменение порога после знакомства с результатами нарушает обещанный уровень ложных тревог. Расчёт мощности также не устраняет систематические ошибки измерения и смещение отбора: они требуют отдельных мер на этапе дизайна исследования.
Частые ошибки
- Менять местами виды ошибок. Первый род относится к отвержению верной , второй - к неотвержению неверной.
- Считать . Эти вероятности вычисляют при разных истинных значениях параметра; дополнение к - мощность для заданной альтернативы.
- Объявлять отсутствие эффекта после незначимого результата. Он может быть малым, а исследование - недостаточно мощным.
- Считать вероятностью истинности . Уровень значимости относится к повторным данным при верной нулевой гипотезе, а не к вероятности гипотезы после наблюдения данных.
- Переносить расчёт на любую задачу. Направление альтернативы, неизвестный разброс и зависимость наблюдений меняют расчёт.
FAQ
Может ли ошибка второго рода быть равна нулю?
В некоторых идеализированных задачах - да, если распределения полностью разделены. В нашей нормальной модели с конечной выборкой их хвосты перекрываются, поэтому вероятность пропуска положительна.
Всегда ли уменьшение ухудшает мощность?
Для одного и того же правостороннего критерия при фиксированных выборке и эффекте да: порог поднимается, а мощность падает. При одновременном изменении плана или объёма выборки результат может быть иным.
Что означает мощность 80 %?
При заданном истинном эффекте и выполнении модели критерий отвергнет примерно в 80 % повторных независимых экспериментов. Это не вероятность истинности эффекта после одного эксперимента.
Коротко
Ошибка I рода - ложное отвержение верной нулевой гипотезы; ошибка II рода - пропуск заданного реального эффекта. Их вероятности относятся к разным условиям. Мощность равна , а её расчёт требует конкретного эффекта и модели данных.
Читайте также
Доверительная вероятность и уровень значимости
Как связаны доверительная вероятность и уровень значимости: формула, смысл ошибок, пример доверительного интервала среднего и проверка двусторонней гипотезы.
Уровень значимости и критическая область
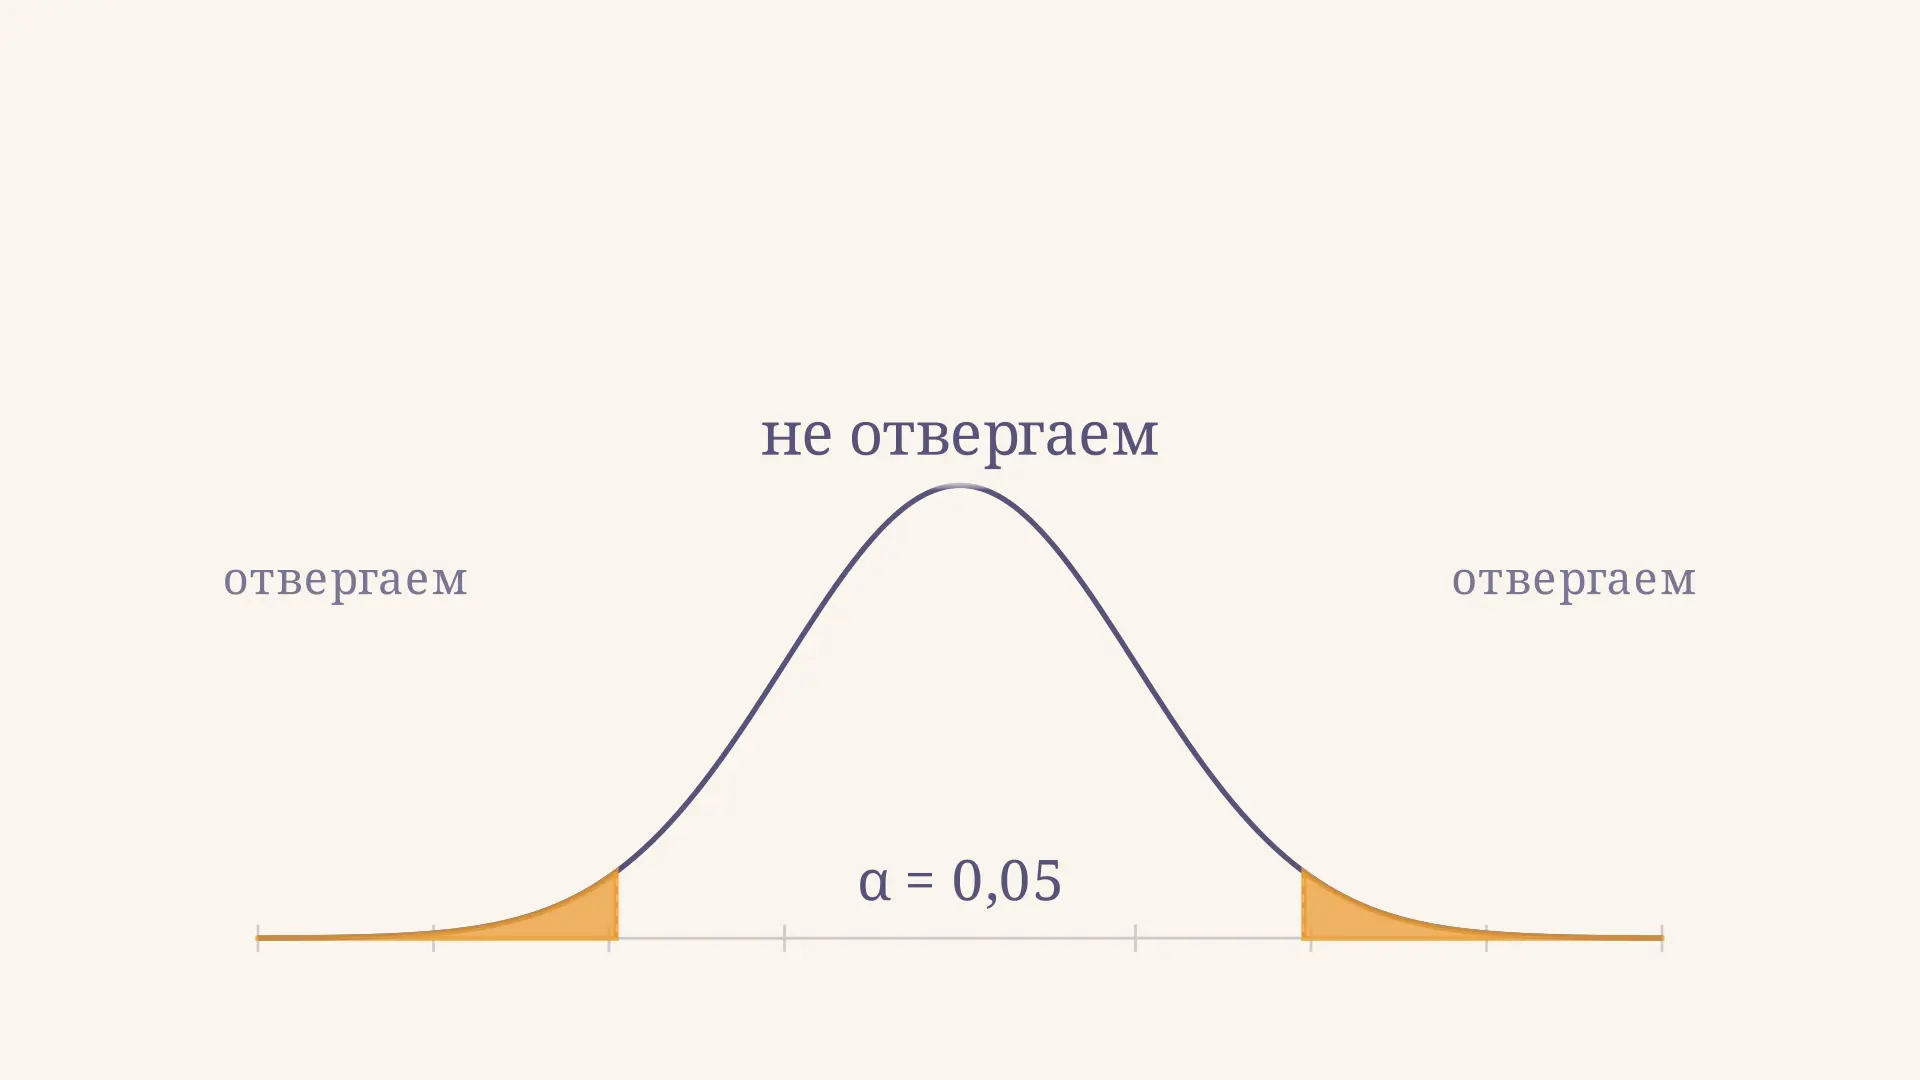
Как связаны уровень значимости и критическая область: односторонний и двусторонний критерии, критические значения, p-значение и пример расчёта Z-критерия.
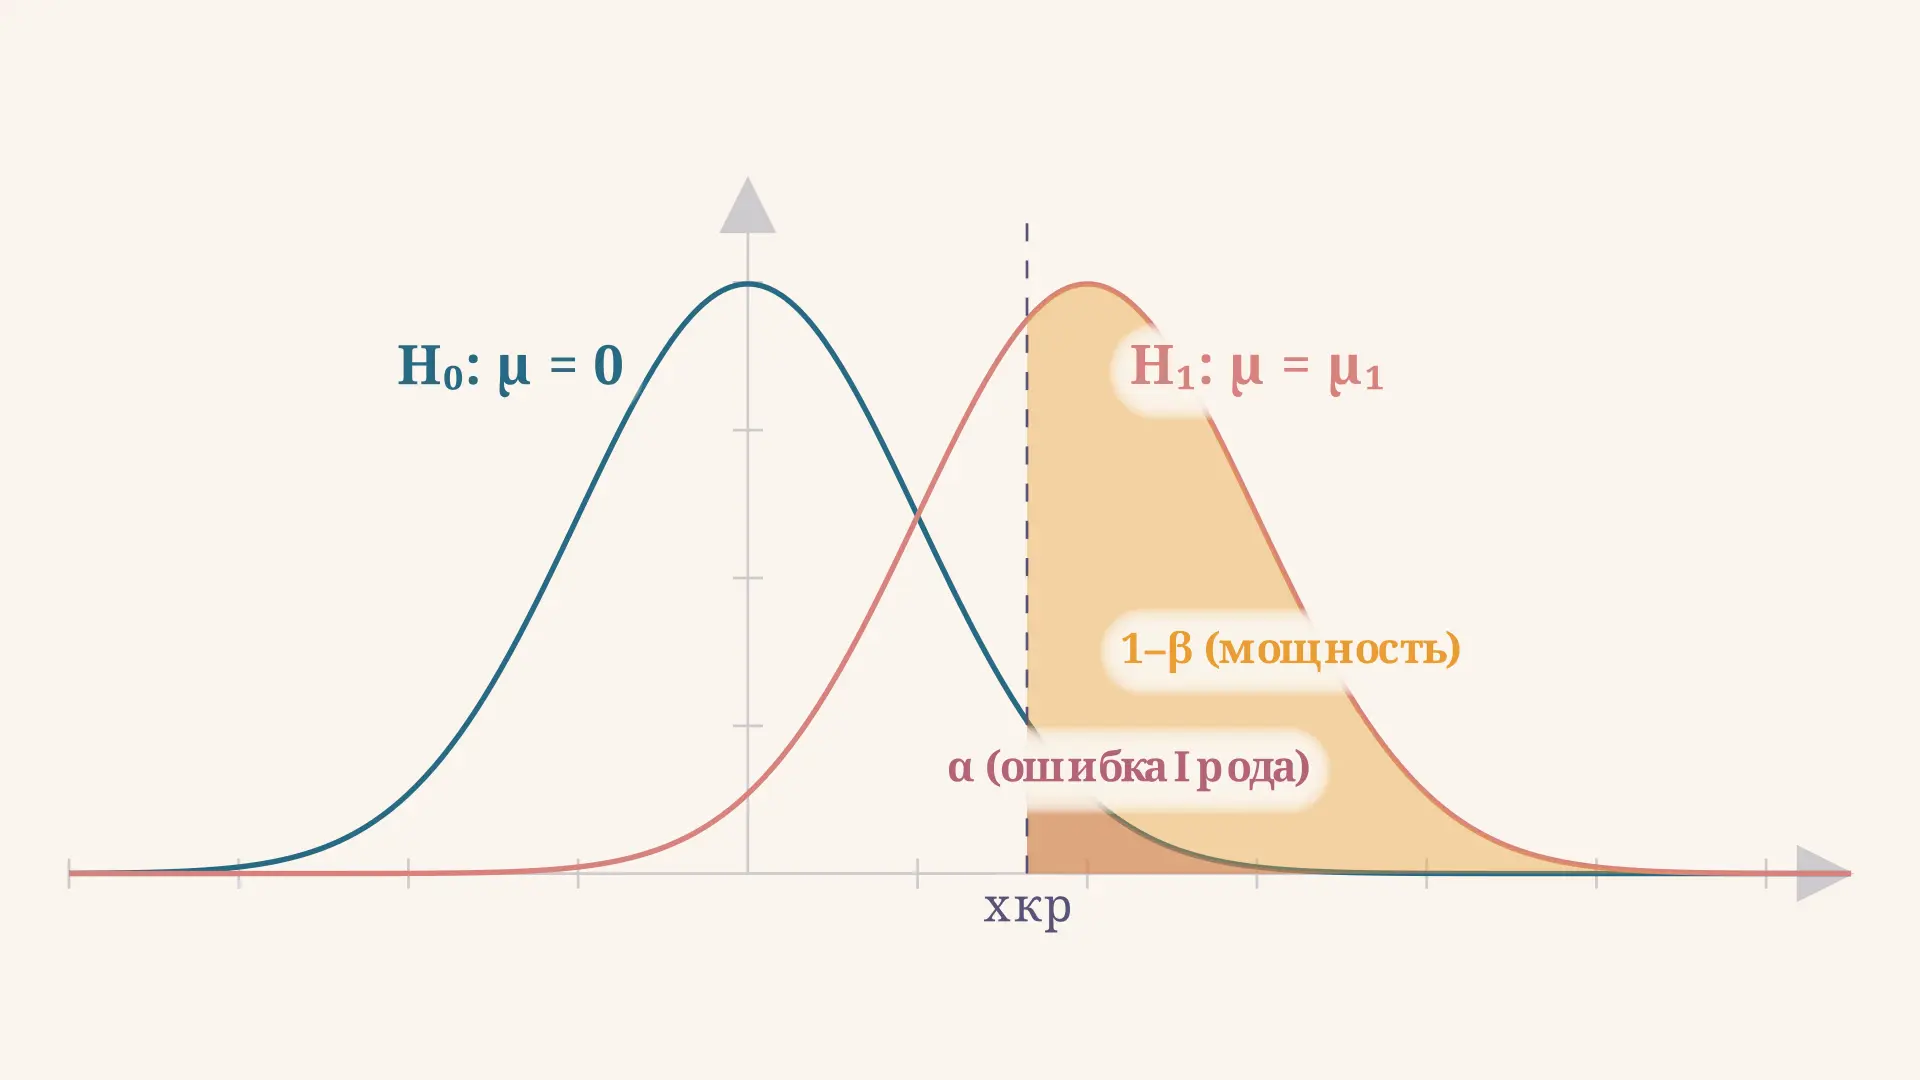
Мощность статистического критерия: формула и расчёт
Мощность статистического критерия 1-beta: как рассчитать через ошибку II рода, объём выборки и эффект-сайз. Формула для z-теста, целевой порог 80 %, примеры.
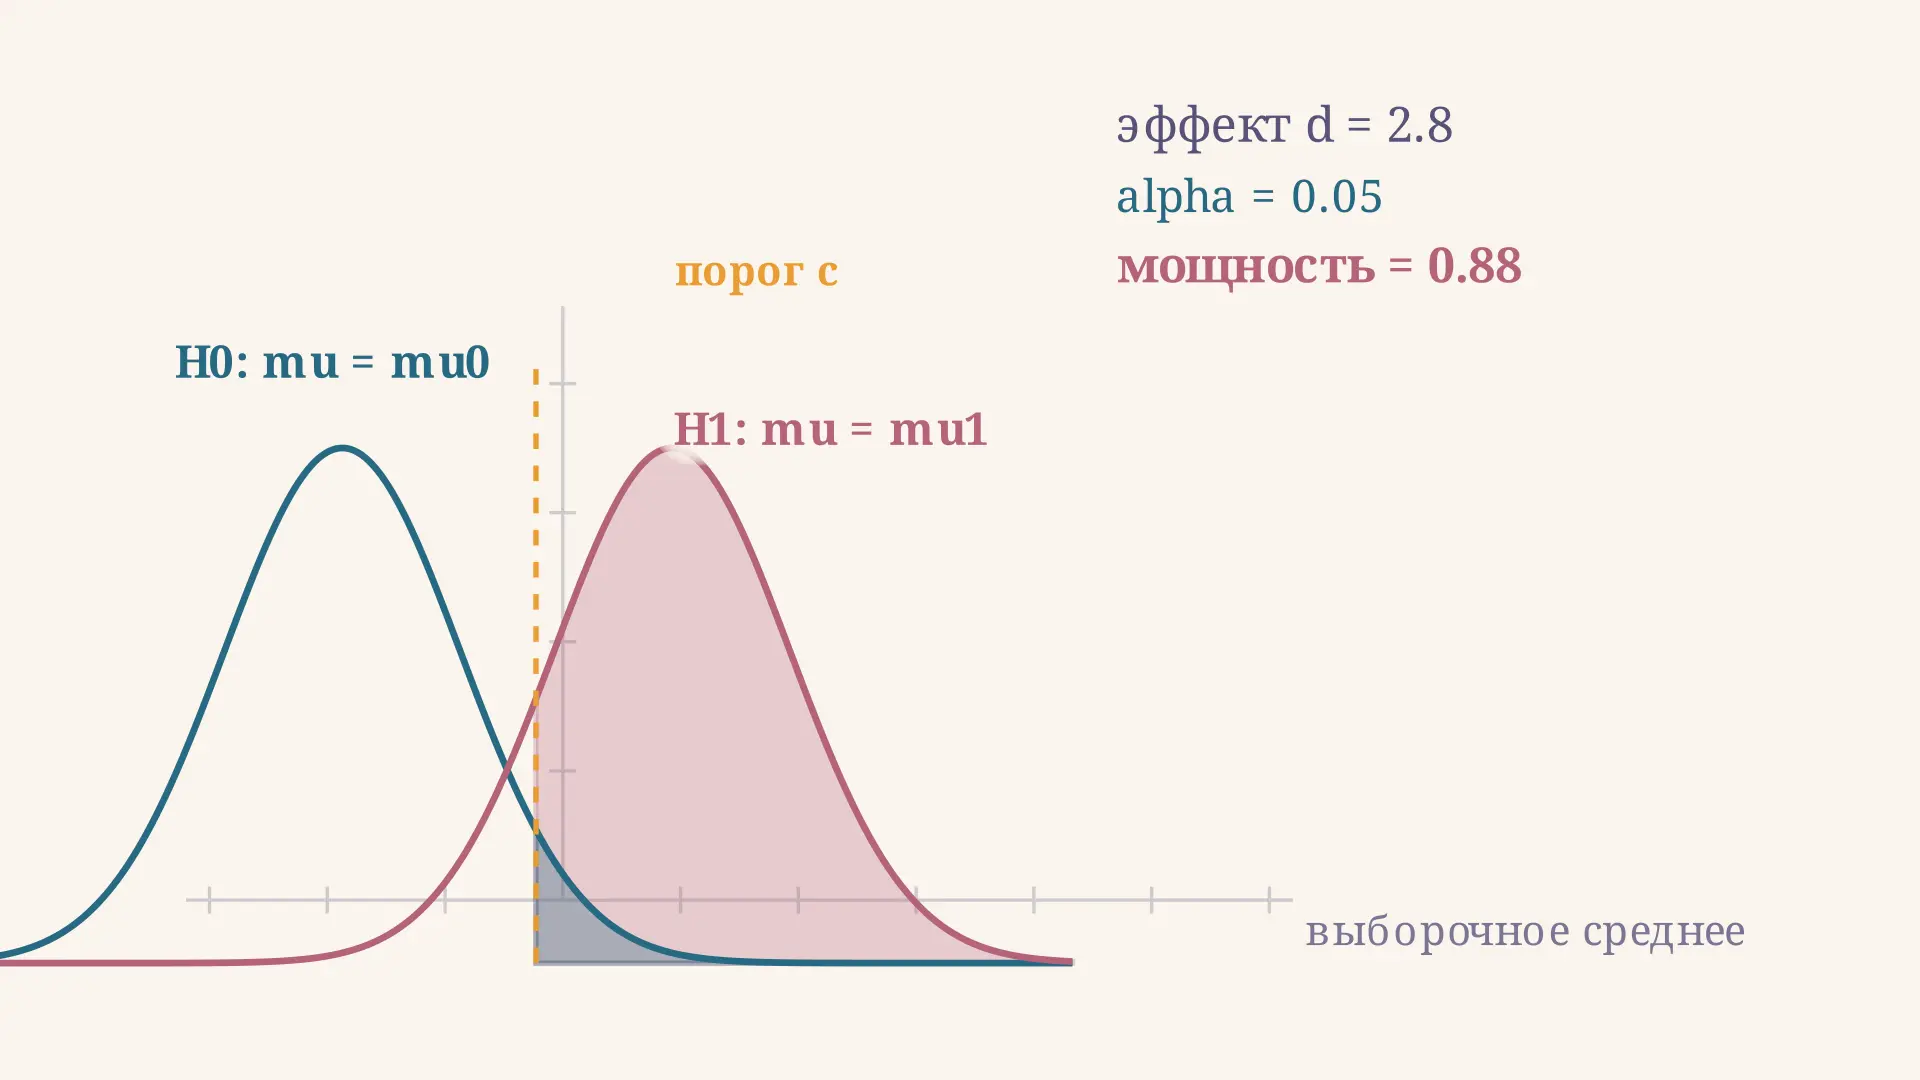
Лемма Неймана-Пирсона: наиболее мощный критерий
Лемма Неймана-Пирсона простыми словами: что утверждает, как через отношение правдоподобия построить наиболее мощный критерий, найти критическую область и мощность теста.
Критерий знаков непараметрический: расчёт и пример
Непараметрический критерий знаков: как проверить медиану или изменения в парных данных, исключить нули и рассчитать точное двустороннее p-значение на примере.
Проверка гипотезы о среднем нормального распределения
Как проверить гипотезу о среднем нормального распределения: выбор Z- или t-критерия, формулы, пример расчёта, критические области и интерпретация результата.