Собственно-случайная выборка: отбор и расчёт
Экономист хочет оценить средние расходы предприятий небольшого города. Обследовать все организации дорого, а выбрать первые сто из списка удобно, но опасно: порядок списка может быть связан с размером или датой регистрации. Собственно-случайный отбор предлагает другое правило: сначала составить список всех подходящих единиц, затем выбрать их с помощью случайного механизма.
Такой план позволяет не только получить среднее по наблюдаемым предприятиям, но и оценить его случайную ошибку. В калькуляторе ниже можно менять объём бесповторной выборки из 1000 единиц и наблюдать, как меняется стандартная ошибка при фиксированном стандартном отклонении 20. Это учебная модель, а не данные реального обследования.
Что означает собственно-случайный отбор
Собственно-случайная выборка, или простая случайная выборка, строится так, что каждая возможная выборка заданного размера из списка имеет одинаковую вероятность. При бесповторном отборе одна и та же единица не может попасть в неё дважды. Список должен соответствовать изучаемой совокупности: если предприятия не включены в него, случайный механизм не сможет их выбрать.
Равенство вероятностей целых наборов сильнее, чем равенство шансов отдельных единиц. Например, если из четырёх объектов всегда выбирать либо пару 1 и 2, либо пару 3 и 4 с одинаковой вероятностью, у каждого шанс включения равен половине. Но пары 1 и 3 никогда не возникнут: это не простая случайная выборка. Определение и способы отбора подробно описывает статистическое ведомство Канады.
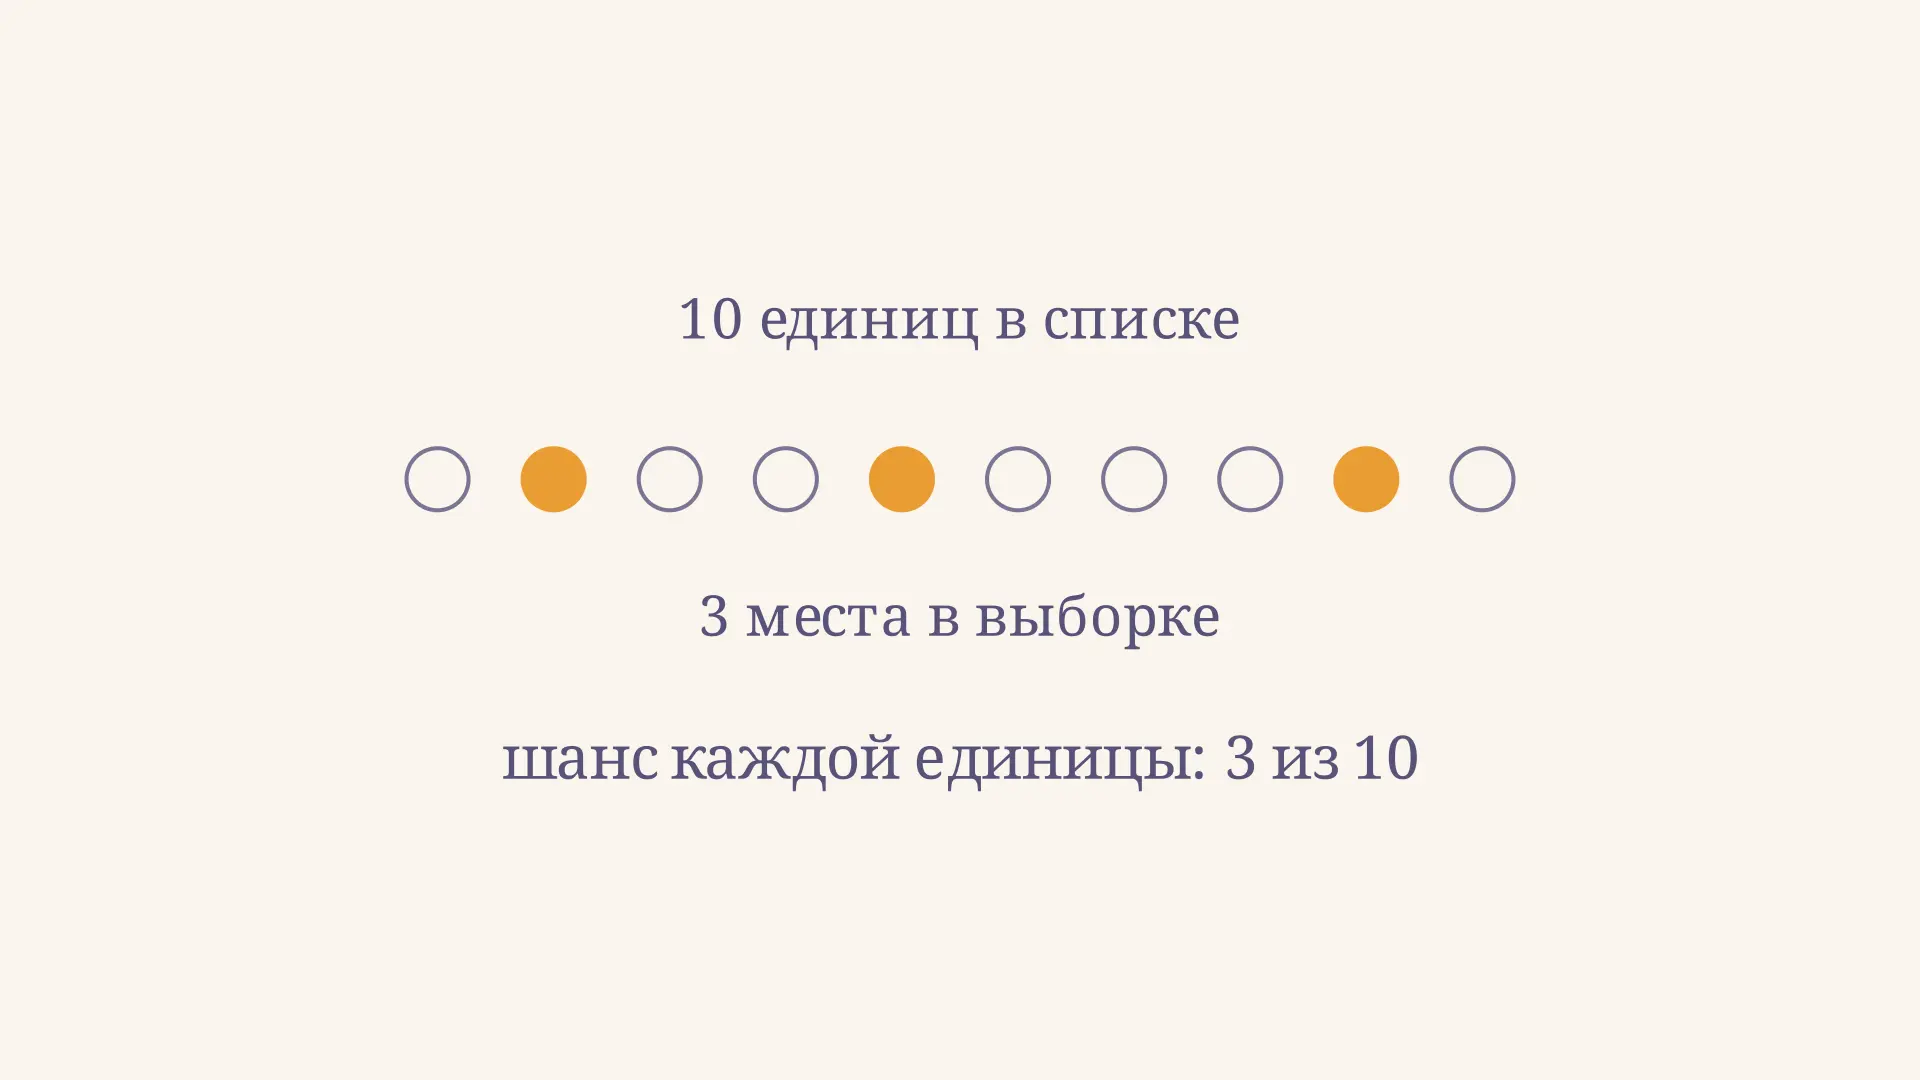
В ролике показаны лишь несколько возможных результатов, а не процедура генерации случайных чисел. В действительности при десяти объектах и трёх местах есть 120 различных троек; ни одна не должна быть исключена правилом отбора. Разницу между списком исследования и всей интересующей группой помогает уточнить статья о генеральной совокупности и выборке.
Как провести бесповторный отбор
Сначала определите единицу наблюдения: предприятие, работник, покупка или иной объект. Затем задайте границы совокупности и дату списка. Нумерация сама по себе не создаёт случайность: она лишь позволяет связать случайное число с конкретной записью.
- Подготовьте список из разных единиц, проверьте дубликаты и исключите тех, кто не соответствует условиям исследования.
- Присвойте каждой единице уникальный номер от 1 до .
- Задайте объём и с помощью генератора случайных чисел выберите различных номеров без возвращения. Сохраните алгоритм и начальное состояние генератора, чтобы отбор можно было воспроизвести.
- Найдите соответствующие записи и попытайтесь получить данные от всех отобранных единиц. Зафиксируйте недоступность, отказы и причины исключения.
При и вероятность включения любого конкретного предприятия равна , то есть 10 %. Вероятность конкретного набора из 100 предприятий равна : таких наборов очень много. Случайный номер нужен для отбора, а не для последующего решения, кого удобнее опросить.
Если вместо генератора используют случайные числа из таблицы, правило то же: недопустимые номера и уже выбранные повторы пропускают. Систематический выбор каждого десятого номера даже со случайным стартом устроен иначе: не все сочетания единиц могут появиться. План отбора следует описывать по тому, как он реально работает.
С возвращением и без возвращения
При бесповторном отборе после каждого шага число доступных единиц уменьшается. Это обычный вариант опроса предприятий: повторно измерять тот же объект ради второго места в выборке часто не имеет смысла. Для фиксированного объёма каждая единица имеет вероятность включения .
При отборе с возвращением после каждого извлечения объект возвращают в список возможных исходов. Результаты извлечений независимы, один объект может встретиться несколько раз. Шанс конкретной единицы на каждом шаге равен , но вероятность встретить её хотя бы раз за шагов составляет , а не . Поэтому число извлечений и число разных объектов здесь могут отличаться.
Выбирая формулу для ошибки, нужно знать схему. При бесповторном отборе учитывают сокращение неопределённости по мере охвата конечного списка; при независимом отборе с возвращением соответствующей поправки нет. Смешение двух схем меняет ответ, особенно когда обследуют заметную часть совокупности.
Как оценить среднее и стандартную ошибку
Пусть по 100 отобранным предприятиям средние условные расходы составили , а выборочное стандартное отклонение в тех же условных единицах. Оценка среднего по всей совокупности - выборочное среднее. При корректном простом случайном отборе оно несмещённо: если многократно повторять весь отбор, среднее таких оценок будет равно истинному среднему списка. Это свойство не означает, что каждая отдельная оценка точна.
Оценка стандартной ошибки среднего для бесповторного отбора:
Здесь вычисляют по выборке с делением суммы квадратов отклонений на . Множитель под вторым корнем - поправка на конечную совокупность. При , и получаем . Формула и её условия приведены в курсе теории выборочного метода Пенсильванского университета.
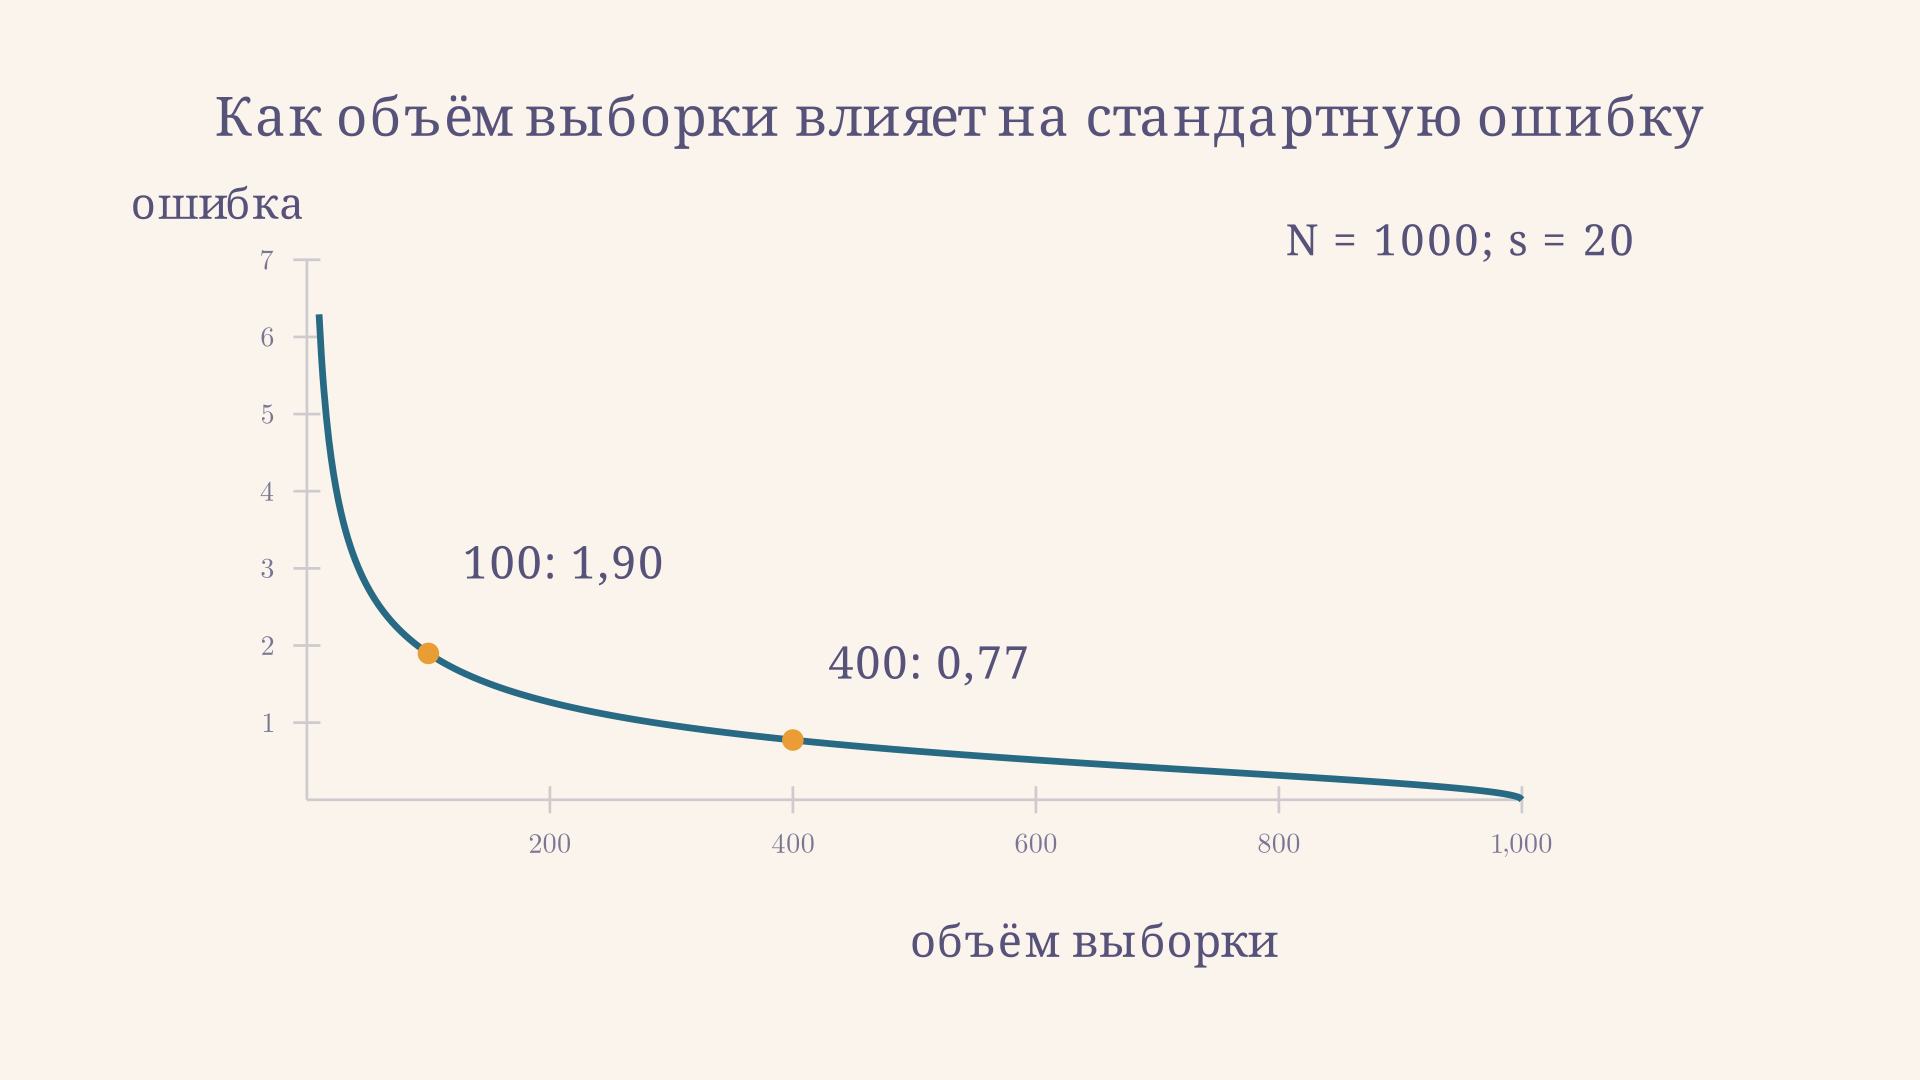
Если увеличить до 400 и оставить для сравнения, ошибка снизится примерно до . На практике новая выборка может дать другое значение . При полном обследовании списка поправка обнуляется: случайной ошибки именно из-за отбора больше нет, хотя ошибки измерения и пропуски всё ещё возможны.
Как читать интервал и выбирать объём
При подходящем нормальном приближении ориентировочный 95-процентный доверительный интервал для среднего записывают как . В примере это , или примерно от 96,28 до 103,72 условной единицы. Множитель 1,96 - приближение: при малой выборке, редких или сильно асимметричных значениях оно может работать плохо и нужен подходящий метод построения интервала.
Уровень 95 % относится к процедуре: при многократном повторении отбора и построения интервалов по тому же правилу около 95 % таких интервалов накроют фиксированное среднее при выполнении условий метода. Он не измеряет вероятность ошибки конкретного ответа и не исправляет неполный список.
Объём выбирают до отбора, исходя из желаемой точности, ожидаемого разброса, размера совокупности и доступных ресурсов. При малой доле охвата ошибка приблизительно обратно пропорциональна : чтобы уменьшить её вдвое при прочих равных, нужно примерно вчетверо больше наблюдений. При большой доле охвата поправка на конечную совокупность становится существенной. Планируйте также неответы: 100 приглашений не гарантируют 100 ответов.
Что может нарушить вывод
Случайный отбор работает в рамках списка, а не устраняет все проблемы исследования. Если в базе нет новых фирм, вывод непосредственно относится к охваченной списком группе. Если крупные предприятия чаще отказываются, ответившие могут систематически отличаться от выбранных. Произвольная замена отказавшегося ближайшим доступным предприятием нарушает исходный план; лучше заранее описать повторные контакты и способ работы с неответами.
Не стоит путать этот подход с квотной выборкой: совпадение долей по заданным признакам ещё не делает отбор внутри групп случайным. При гнездовой выборке сначала могут отбираться целые группы, поэтому для ошибки нужна формула, учитывающая такой дизайн. Практические проблемы охвата и отказов подробнее разобраны в статье о выборке в социологии.
В отчёте укажите целевую совокупность, источник и дату списка, единицу отбора, и , схему с возвращением или без него, способ генерации номеров и число полученных ответов. Отдельно опишите пропуски и то, как они могут влиять на вывод. Тогда читатель сможет отличить случайность плана от качества реально собранных данных.
Частые ошибки
- Выбирать «наугад» вручную. Личный выбор не обеспечивает равной вероятности каждого возможного набора.
- Считать одинаковые шансы единиц достаточными. Нужно равенство вероятностей всех наборов заданного размера.
- Использовать формулу бесповторного отбора для выборки с возвращением. Повторы и поправка на конечную совокупность требуют разных расчётов.
- Принимать ошибку выборки за полную ошибку исследования. Неответы, неполный список и ошибки измерения в неё автоматически не входят.
FAQ
Чем собственно-случайная выборка отличается от простой случайной?
В данном контексте это два названия одной схемы: каждый возможный набор фиксированного размера равновероятен. Нужно дополнительно уточнять, допускается ли возвращение.
Обязательно ли случайная выборка повторяет структуру совокупности?
Нет. Равные вероятности обеспечиваются планом отбора; в конкретной выборке доли групп могут отличаться от долей в списке из-за случайных колебаний.
Можно ли вычислить ошибку без стандартного отклонения?
Для приведённой оценки ошибки среднего необходимо оценить разброс. До сбора данных его можно предположить по прошлым исследованиям или пилотной выборке, обозначив это предположение.
Коротко
Собственно-случайная бесповторная выборка даёт каждому возможному набору одинаковый шанс и позволяет оценивать случайную ошибку среднего. Для практического вывода нужны полный список, прозрачный отбор, учёт неответов и формула, соответствующая выбранной схеме.
Читайте также
Индекс Рябцева: формула и расчёт структурных различий
Индекс Рябцева измеряет различие двух структур. Разбираем формулу, пошаговый расчёт по долям, шкалу интерпретации и ограничения метода на наглядном примере.
Коэффициент изобретательской активности: расчёт
Коэффициент изобретательской активности: формула числа патентных заявок на 10 тысяч жителей, пример расчёта, сравнение регионов и ограничения показателя.
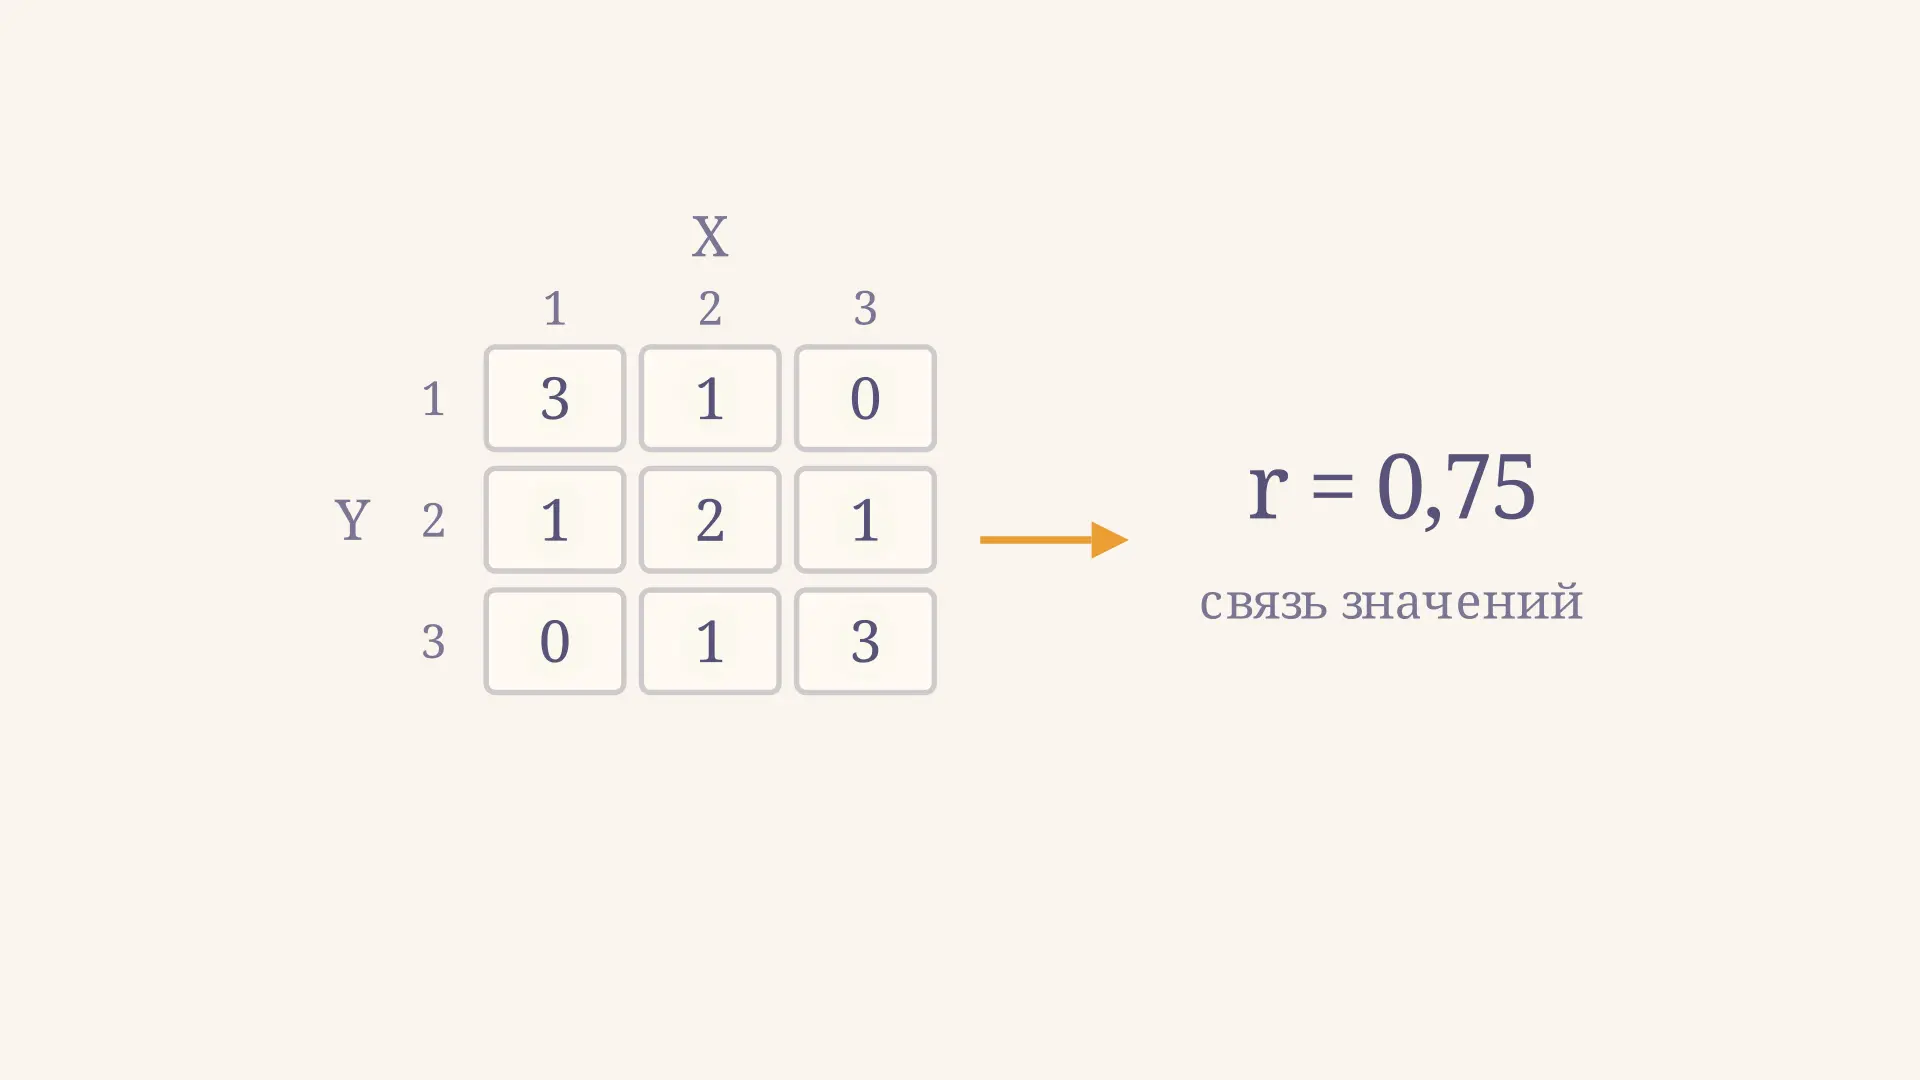
Корреляционная таблица: построение и расчёт
Корреляционная таблица показывает совместное распределение двух признаков. Разберём построение частот, суммы по строкам и столбцам и расчёт коэффициента Пирсона.
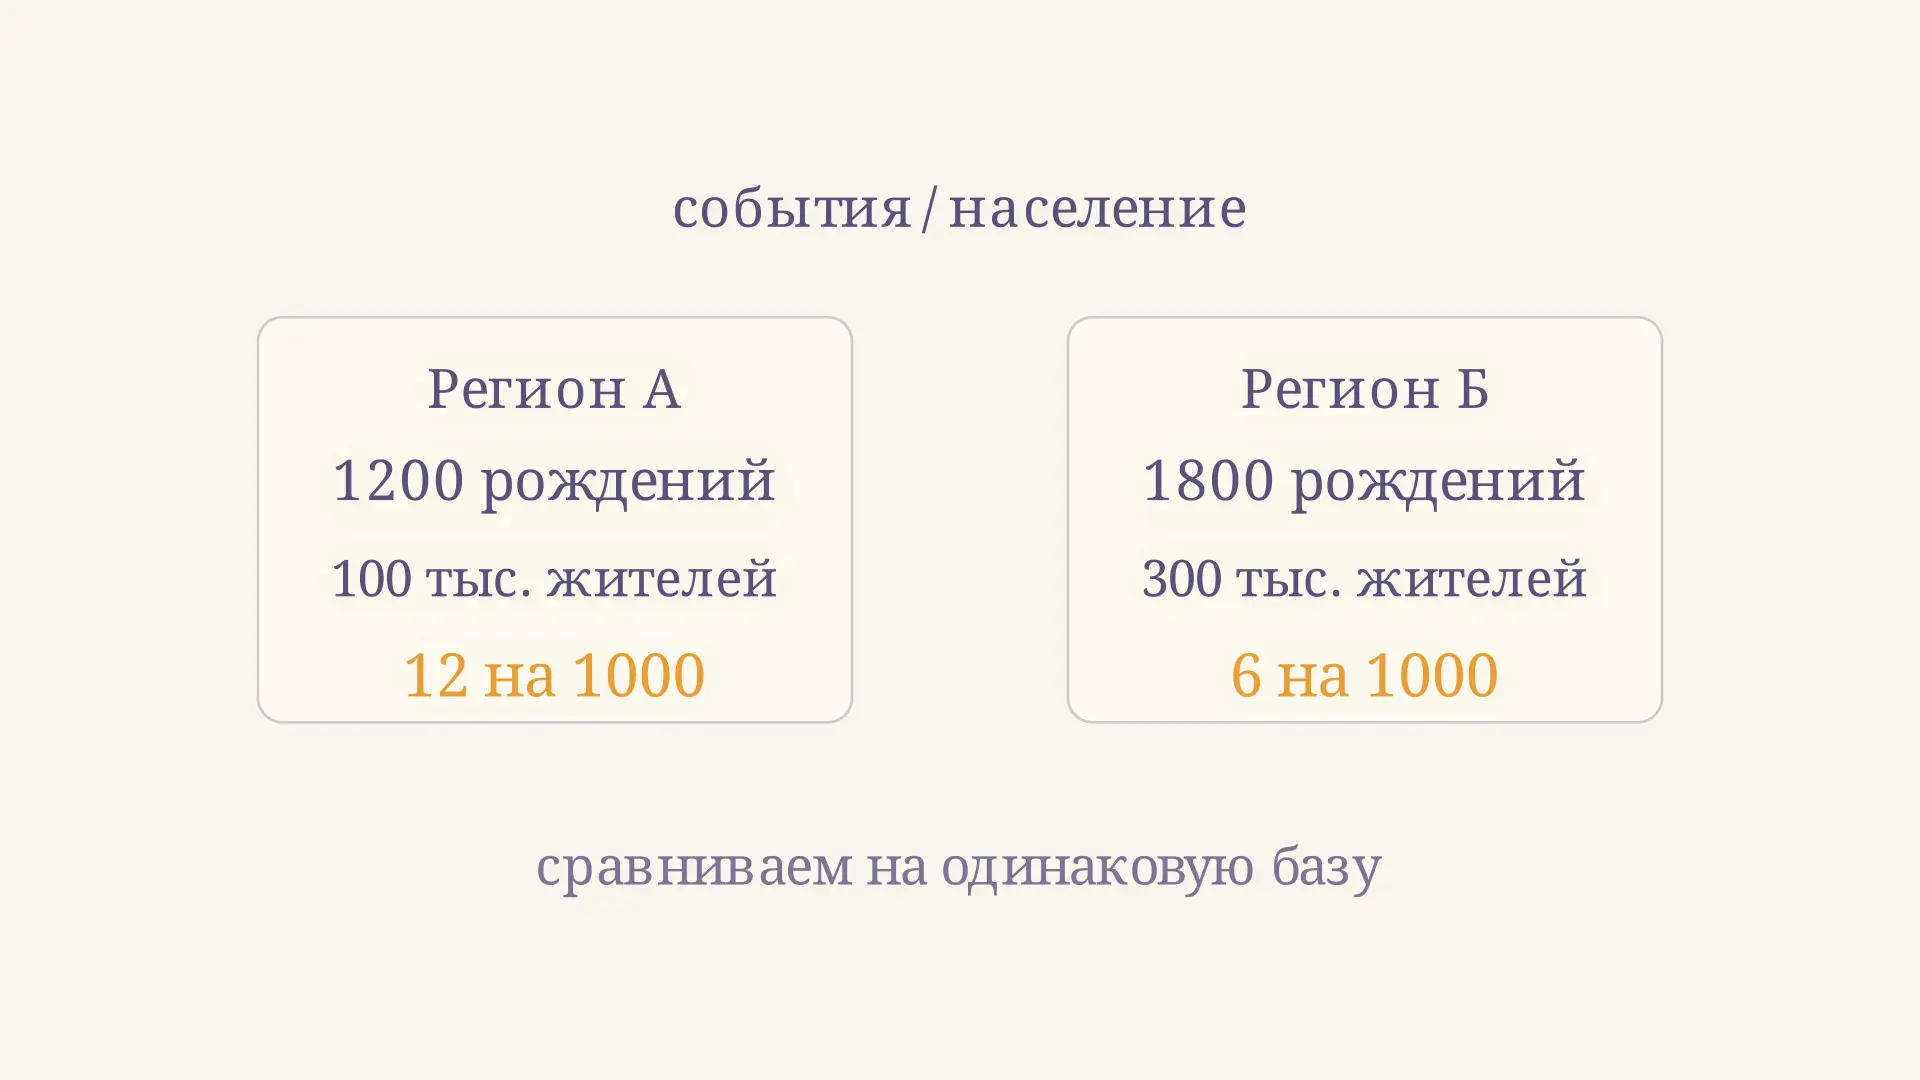
Относительная величина интенсивности: формула и примеры
Относительная величина интенсивности показывает распространённость явления в среде. Разбираем формулу, единицы измерения и сравнение регионов на примерах.
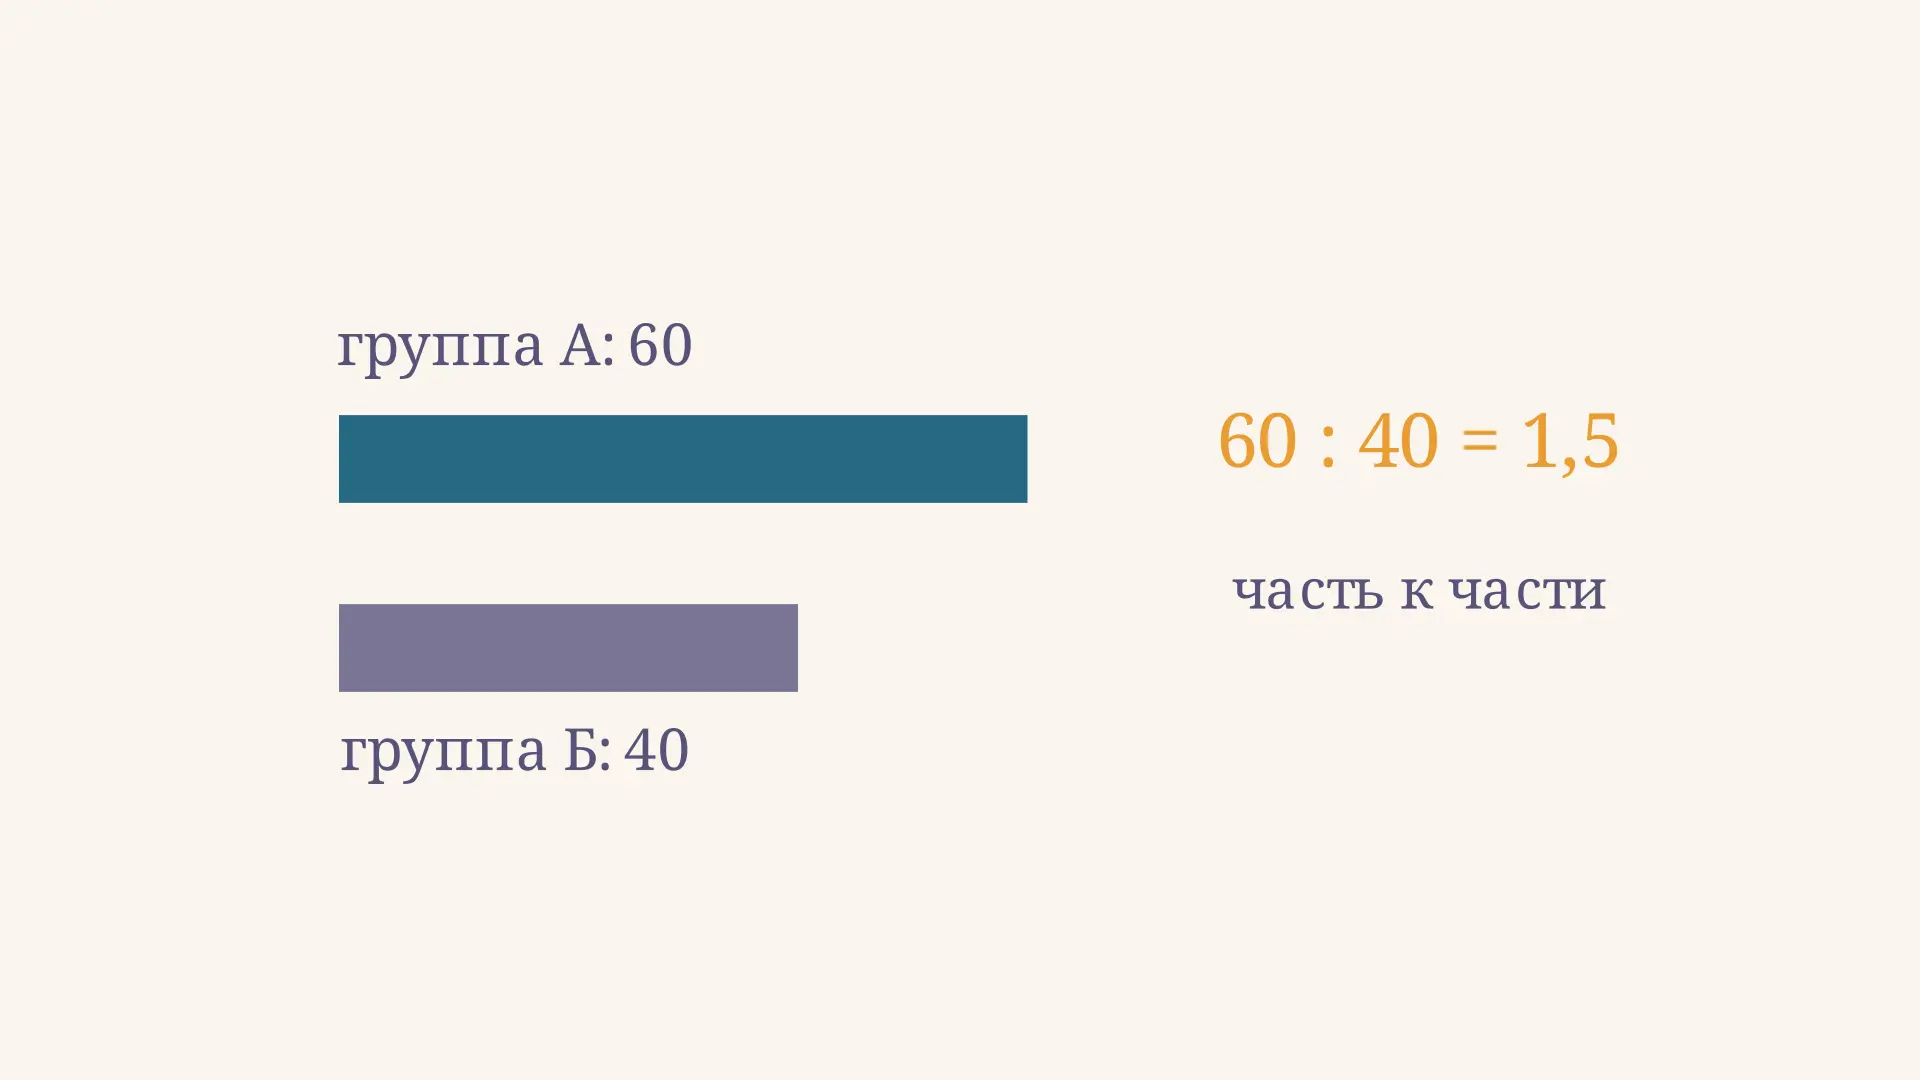
Относительная величина координации: формула и пример
Относительная величина координации сравнивает части одной совокупности. Разбираем формулу, выбор базы, обратное отношение и отличие от доли на примерах.
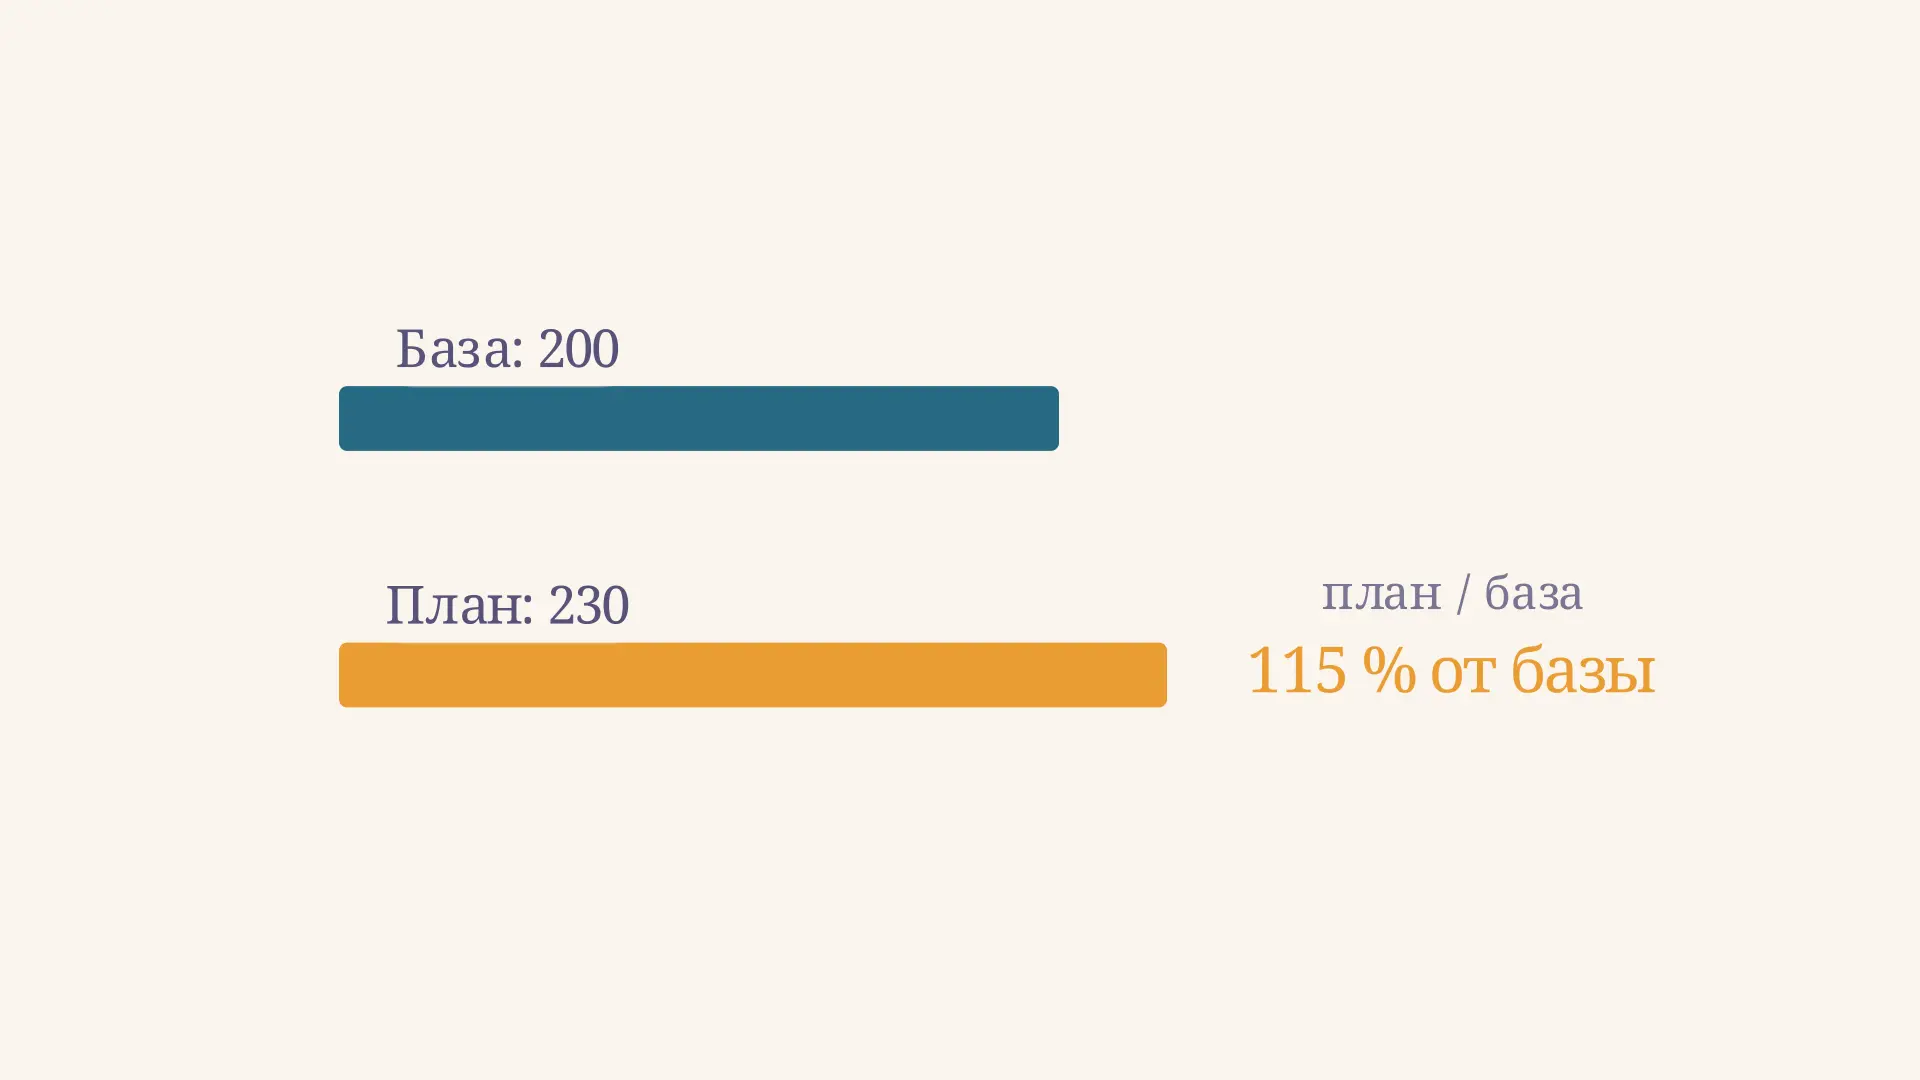
Относительная величина планового задания: формула
Как рассчитать относительную величину планового задания, отличить её от выполнения плана и динамики, перевести в плановый прирост и решить типовые задачи.