Выборка в социологии: как отобрать респондентов
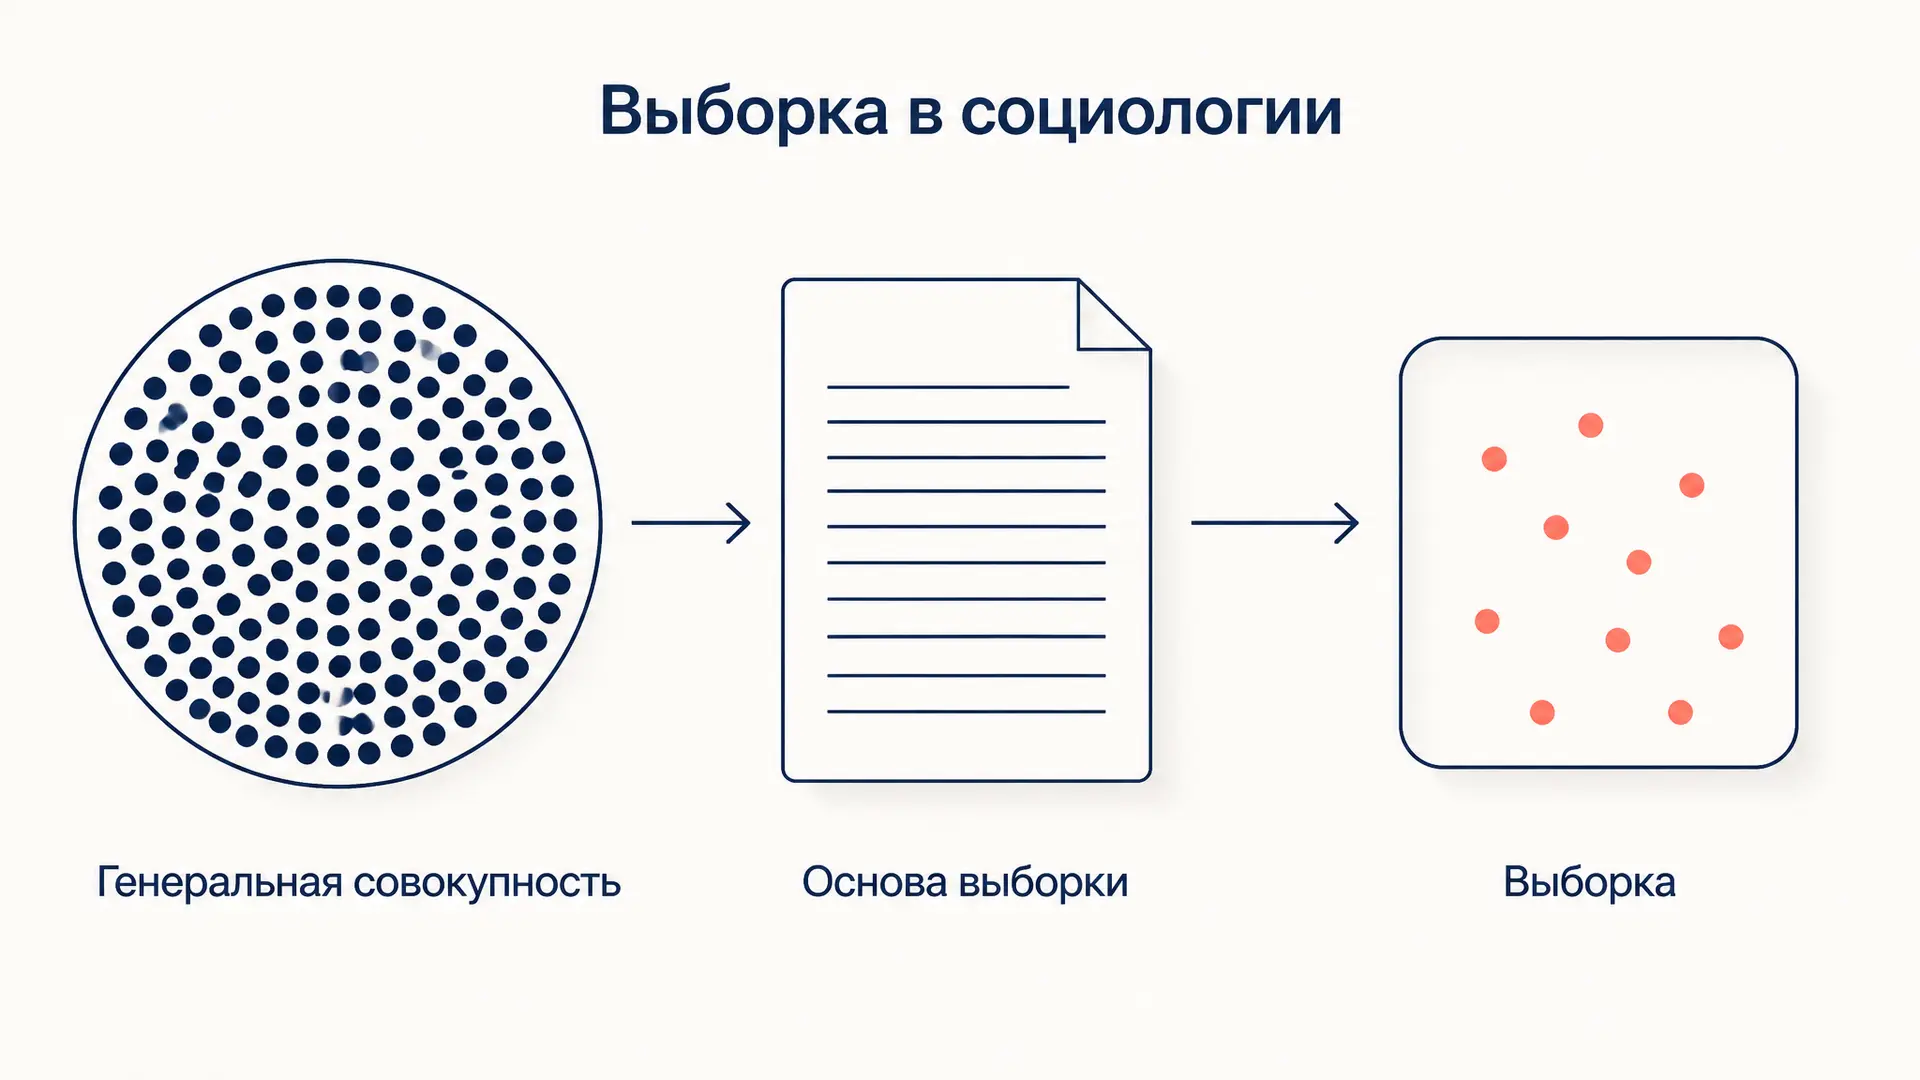
Опросить всех жителей города, всех студентов вуза или всех работников отрасли невозможно: не хватит ни денег, ни времени, ни интервьюеров. Поэтому социолог изучает часть, а выводы делает обо всём множестве. Эта часть и называется выборкой, а правила, по которым она собрана, решают, будет ли вывод честным или превратится в мнение случайных прохожих. Ниже разберём, из чего складывается выборка в социологии, какие бывают виды отбора, как посчитать объём и ошибку и что именно пишут о выборке в программе исследования. Конструктор ниже соберёт разбор под ваш объект и вид отбора.
Что такое выборка в социологии
Выборка (выборочная совокупность) - это множество людей или иных объектов, реально попавших в исследование, отобранное из генеральной совокупности по заданным правилам. Генеральная совокупность - все объекты, о которых исследователь хочет говорить: например, все студенты очной формы конкретного вуза, все избиратели региона, все семьи с детьми до трёх лет.
Ключевых понятий три. Единица отбора - то, что отбирают на очередном шаге (человек, квартира, учебная группа, населённый пункт). Единица наблюдения - то, о чём собирают данные (обычно респондент). Объём выборки - сколько единиц наблюдения попало в итоговый массив. Отношение , где - объём генеральной совокупности, называют долей отбора: в массовых опросах она обычно ничтожна, и это нормально - точность оценки почти не зависит от размера генеральной совокупности.
Формальная сторона отбора (оценка среднего, доверительный интервал, стандартная ошибка) подробно описана в разборе про генеральную совокупность и выборку в статистике; здесь важнее методическая часть, из-за которой социологические опросы чаще всего и рассыпаются.
Основа выборки: без неё отбор не случайный
Основа выборки - это перечень, из которого физически производится отбор: список студентов из деканата, база абонентов, реестр адресов, список организаций. Случайный отбор возможен только там, где такой перечень есть; иначе исследователь отбирает не из генеральной совокупности, а из того, до чего дотянулся.
Основа порождает две системные проблемы. Недопокрытие: часть генеральной совокупности в списке отсутствует (люди без стационарного телефона, работники неформального сектора, жильцы новостроек без прописки). Избыточность: в списке есть лишние или дублирующиеся записи (выбывшие студенты, два номера у одного человека). Прежде чем считать ошибку выборки, честнее описать основу и признать, кого она заведомо не видит.
Вероятностные виды выборки
Вероятностный (случайный) отбор означает, что у каждой единицы известна ненулевая вероятность попасть в выборку. Только для таких выборок статистические формулы ошибки вообще имеют смысл.
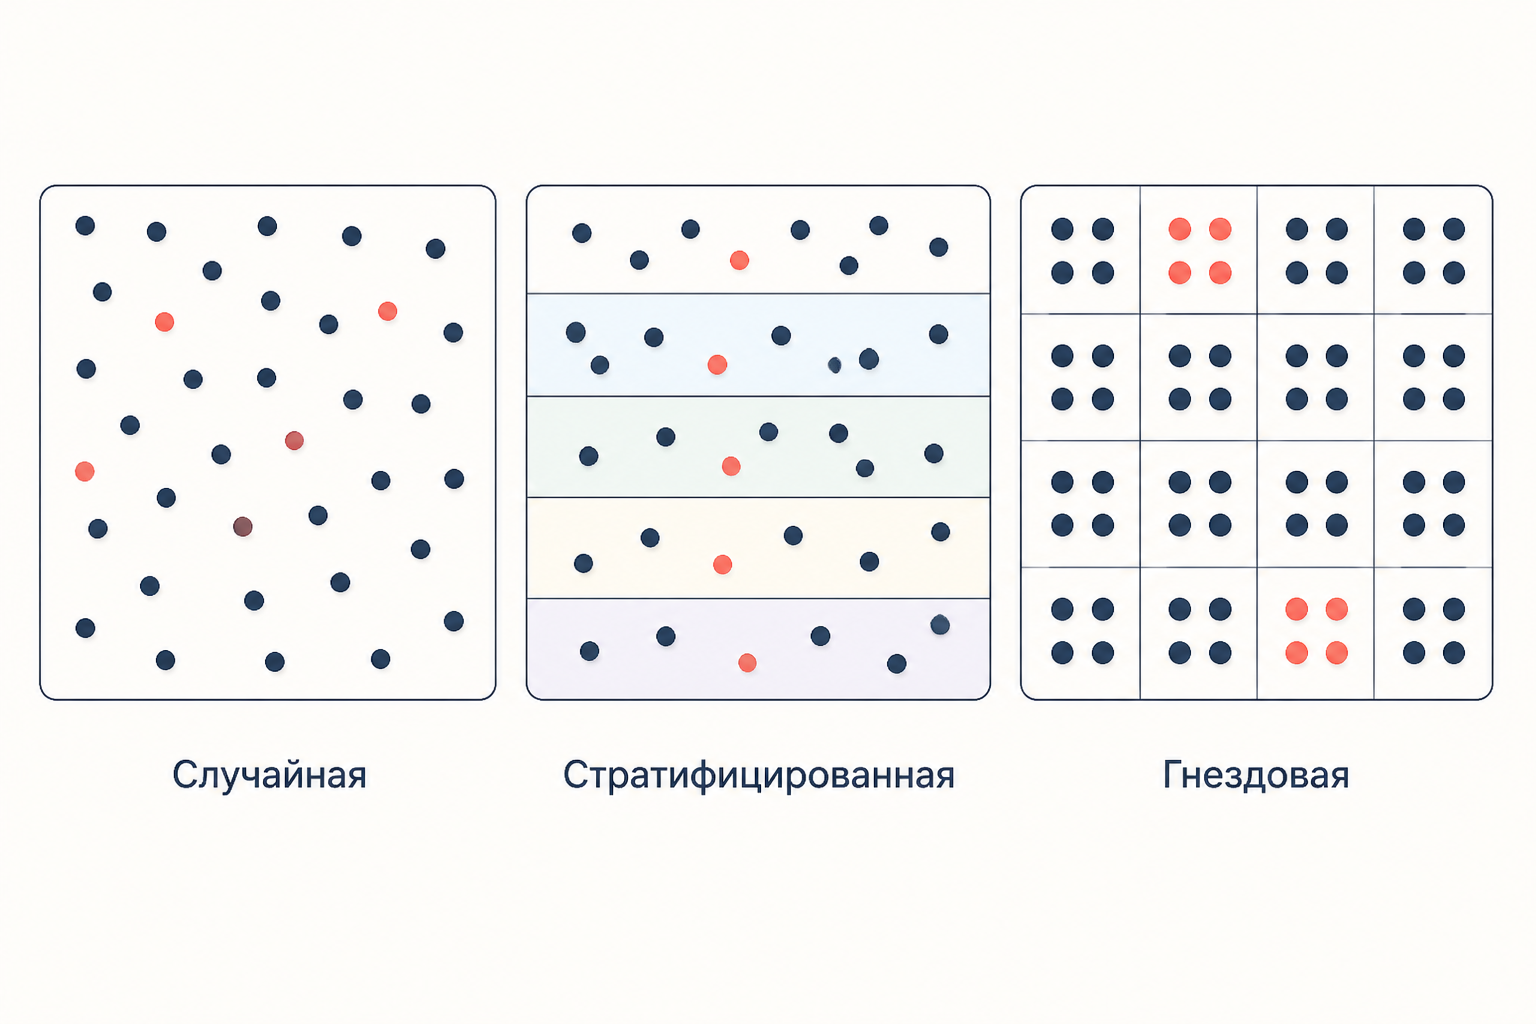
Простая случайная. Из пронумерованной основы отбирают номера генератором случайных чисел. Идеал по чистоте, но требует полного списка и разбросан географически: интервьюеру придётся ехать по всему региону ради одного респондента.
Систематическая. Из списка берут каждый -й элемент, где шаг , а старт задан случайно. Дешевле и проще, но опасна скрытая периодичность списка: если каждый десятый в перечне - староста группы, шаг соберёт выборку из одних старост.
Стратифицированная (районированная). Генеральную совокупность делят на однородные слои (факультеты, курсы, типы поселений), внутри каждого отбирают случайно. При пропорциональном размещении доля слоя в выборке равна его доле в совокупности. Стратификация уменьшает ошибку, если внутри слоёв люди похожи, а между слоями различаются.
Гнездовая (кластерная). Отбирают не людей, а готовые группы - учебные группы, дома, бригады - и опрашивают их целиком. Экономит деньги, но увеличивает ошибку: внутри гнезда люди похожи друг на друга, и это удорожание точности описывают дизайн-эффектом , где - средний размер гнезда, а - внутриклассовая корреляция. Итоговый объём приходится увеличивать в раз.
Многоступенчатая. Реальные всероссийские опросы комбинируют перечисленное: сначала случайно отбирают регионы, внутри них - населённые пункты, затем участки, дома и уже потом респондентов.
Невероятностные виды выборки
Когда основы выборки нет, применяют целенаправленный отбор. Формулы ошибки к нему строго говоря неприменимы, и в тексте работы это нужно оговаривать.
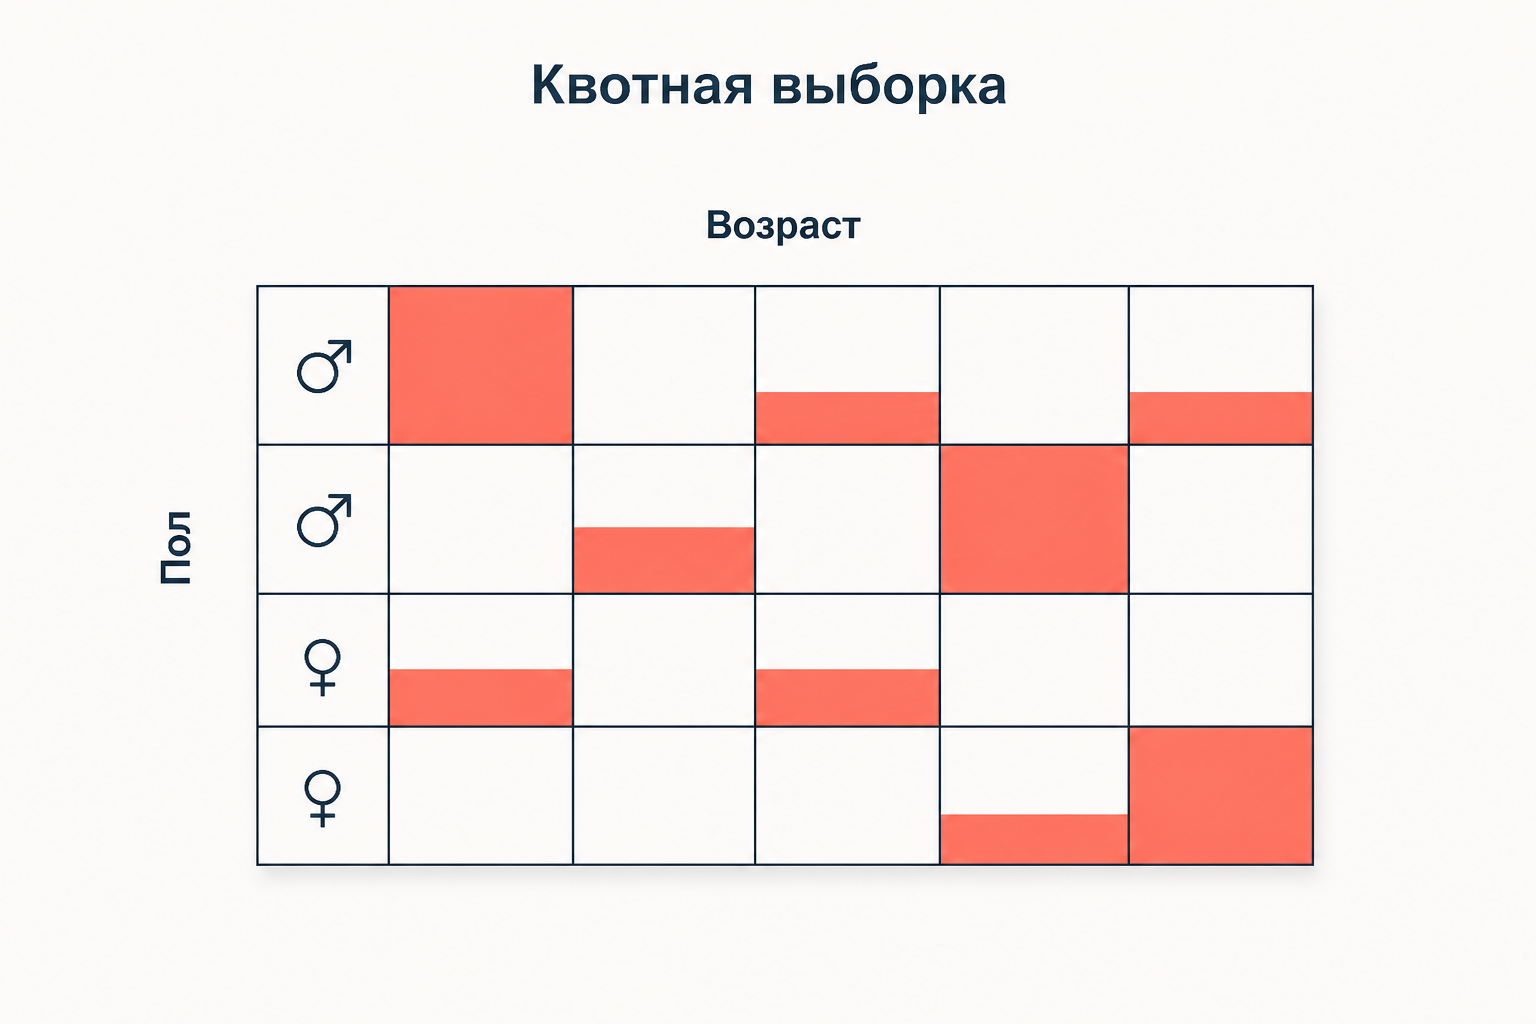
Квотная - самая частая в студенческих работах. Известно распределение генеральной совокупности по нескольким признакам (пол, возраст, курс, тип занятости), и интервьюер обязан набрать столько же людей в каждой ячейке. Структура выборки повторяет структуру совокупности по контролируемым признакам - но только по ним: по всему остальному смещение никак не контролируется, потому что внутри квоты интервьюер берёт наиболее доступных.
Стихийная - опрос прохожих у метро, анкета в открытом доступе, голосование в паблике. Отвечают самые заинтересованные, поэтому распространять такие данные на всю совокупность нельзя; это разведочный материал.
Метод снежного кома - каждый опрошенный приводит следующих. Единственный работающий подход к редким и закрытым группам (коллекционеры, мигранты определённой общины, люди с редким диагнозом), но выборка растёт по связям и переоценивает включённых в сообщество.
Целевая и метод основного массива. В первом случае отбирают типичных или, наоборот, крайних представителей ради глубины понимания; во втором опрашивают почти всю небольшую совокупность - например 90 работников из 100.
Репрезентативность: что она означает на самом деле
Репрезентативность - это свойство выборки воспроизводить структуру генеральной совокупности по признакам, существенным для задачи исследования. Три уточнения, которые чаще всего теряют.
Репрезентативность не равна размеру: тысяча подписчиков одного сообщества хуже трёхсот случайно отобранных жителей района. Она всегда относительна к признаку: выборка может быть репрезентативной по полу и возрасту и полностью смещённой по доходу. И она не гарантируется автоматически большими числами - при систематическом смещении рост лишь уменьшает случайную ошибку вокруг неверного значения.
Объём выборки и ошибка репрезентативности
Для доли признака предельная ошибка при вероятностном отборе считается так:
где - ожидаемая доля, а - коэффициент доверия ( при доверительной вероятности 95 %). Обратная задача - расчёт объёма:
При максимально осторожном , доверии 95 % и ошибке 5 процентных пунктов получается - отсюда и берутся привычные «около 400 человек». Для конечной совокупности объём уменьшают поправкой:
Так, для вуза с студентов достаточно примерно 341 анкеты. А для гнездового отбора результат ещё нужно умножить на дизайн-эффект.
Считайте объём не «на всю выборку», а на самую мелкую группу, по которой планируете вывод: если сравниваете четыре курса, в каждом должно набраться не меньше нескольких десятков анкет.
Недостижимость, отказы и самоотбор
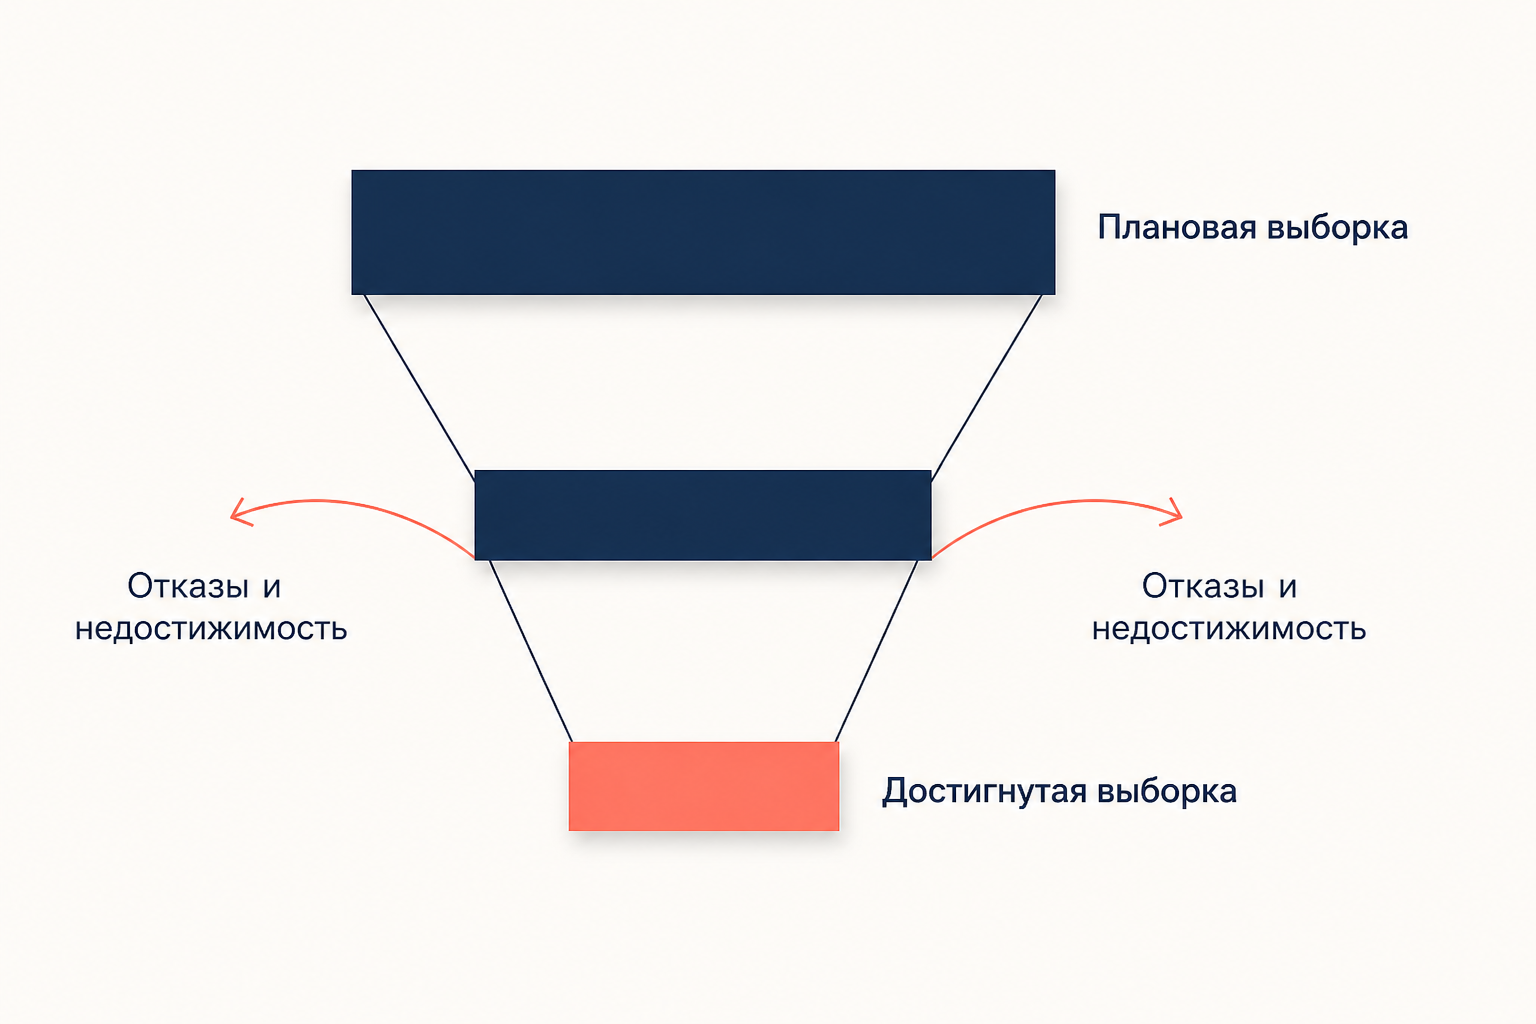
Спроектированная выборка и полученный массив - разные вещи. Часть людей не удаётся застать, часть отказывается, часть заполняет анкету наполовину. Доля ответивших (response rate) - обязательный показатель отчёта.
Опасны не сами потери, а их избирательность: отказываются не случайные люди, а более занятые, менее лояльные, реже бывающие дома. Это и есть смещение от неответов, и оно не лечится добором «кого удалось» - так выборка ещё сильнее сдвигается к самым доступным. Рабочие меры: несколько попыток контакта в разное время, замены строго внутри той же квоты или страты, взвешивание данных по известной структуре совокупности и честное описание того, кто в массив не попал. В повторных опросах к этому добавляется истощение состава - подробнее в разборе про панельное исследование.
Как описать выборку в программе исследования
В курсовой или дипломе раздел о выборке - это семь пунктов: генеральная совокупность и её объём; основа выборки и её пробелы; тип и процедура отбора; единицы отбора и наблюдения; расчёт объёма с формулой и подставленными числами; ожидаемая ошибка при заданном доверии; ограничения выводов. Формулировка «опрошено 100 человек методом случайной выборки» без основы и процедуры отбора - не описание, а его имитация.
Частые ошибки
- Называть случайной стихийную выборку. Опрос прохожих или анкета в соцсети - не вероятностный отбор, и считать для него ошибку выборки некорректно.
- Наращивать объём вместо исправления процедуры. Тысяча анкет из одного паблика не точнее ста: смещение не уменьшается с ростом .
- Считать квотную выборку репрезентативной по всем признакам. Она репрезентативна только по тем, по которым заданы квоты.
- Забывать дизайн-эффект в гнездовом отборе. Опросив три учебные группы целиком, нельзя считать ошибку по формуле простой случайной выборки.
- Замалчивать долю ответивших. Без неё непонятно, чем достигнутая выборка отличается от запланированной.
FAQ
Сколько человек опросить для курсовой? Если генеральная совокупность - вуз или факультет, ориентир 300–400 анкет при 5 % ошибки, а с поправкой на конечность совокупности обычно меньше. Но защищает работу не число, а прописанная процедура отбора: 60 анкет с обоснованной схемой лучше 500 стихийных.
Чем выборочная совокупность отличается от генеральной? Генеральная - все объекты, о которых делается вывод; выборочная - те, кого реально изучили. Выборка описывается фактически, генеральная совокупность - через границы: территория, время, критерии включения.
Можно ли в дипломе использовать квотную выборку? Можно, это законная практика прикладной социологии. Требуется указать источник данных о структуре совокупности, перечислить контролируемые признаки, привести таблицу квот с плановым и фактическим заполнением и оговорить, что за пределами квот смещение не контролируется.
Коротко
Выборка в социологии - не «сколько людей опросили», а описанная процедура: генеральная совокупность, основа выборки, тип отбора, единицы, расчёт объёма и ошибка. Вероятностные схемы (простая случайная, систематическая, стратифицированная, гнездовая, многоступенчатая) допускают статистическую оценку точности; квотная, стихийная и снежный ком дают доступность вместо строгости и требуют оговорок. Объём считают по формуле через , и , поправляя на конечность совокупности и дизайн-эффект, а достигнутую выборку всегда сопровождают долей ответивших и описанием тех, кто в неё не попал.
Читайте также
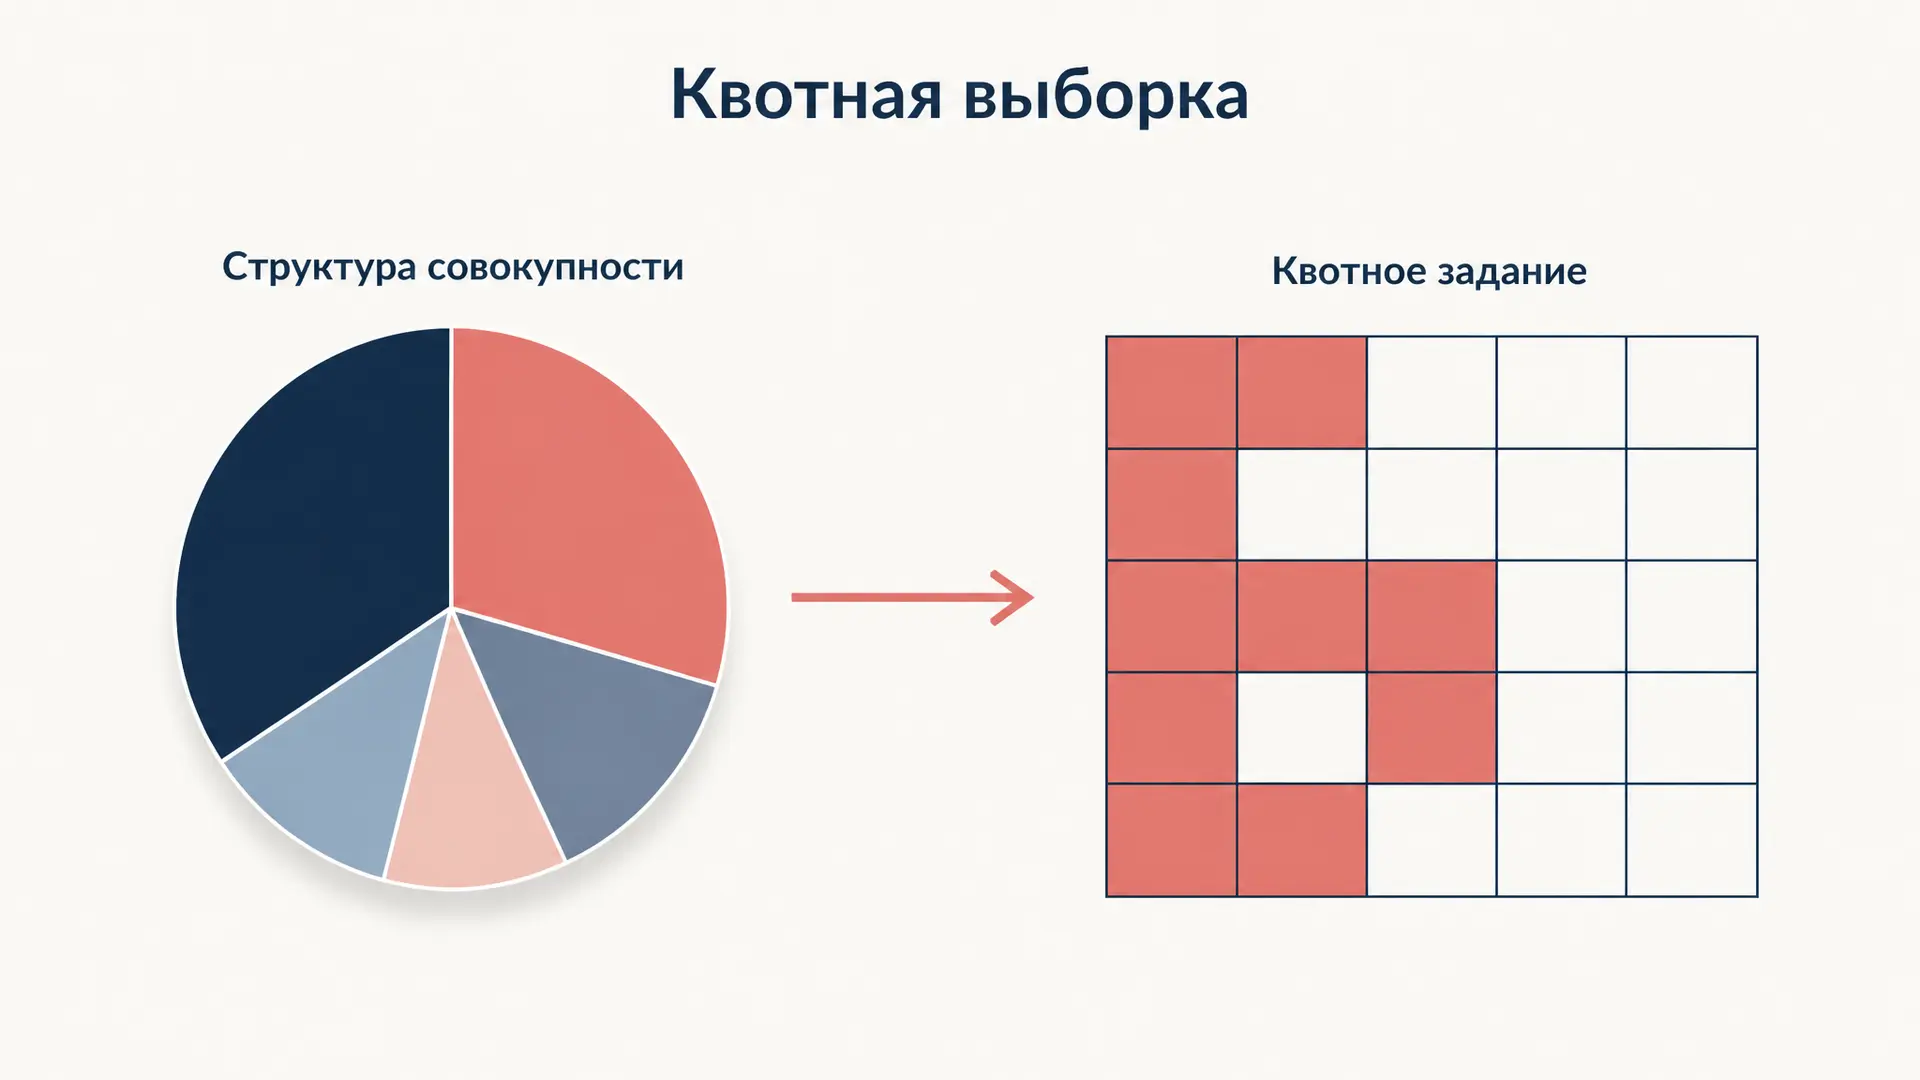
Квотная выборка: как построить квотное задание
Квотная выборка: как выбрать признаки и рассчитать ячейки квотного задания, чем маргинальные квоты отличаются от связанных, почему это неслучайный отбор и какие смещения он даёт.
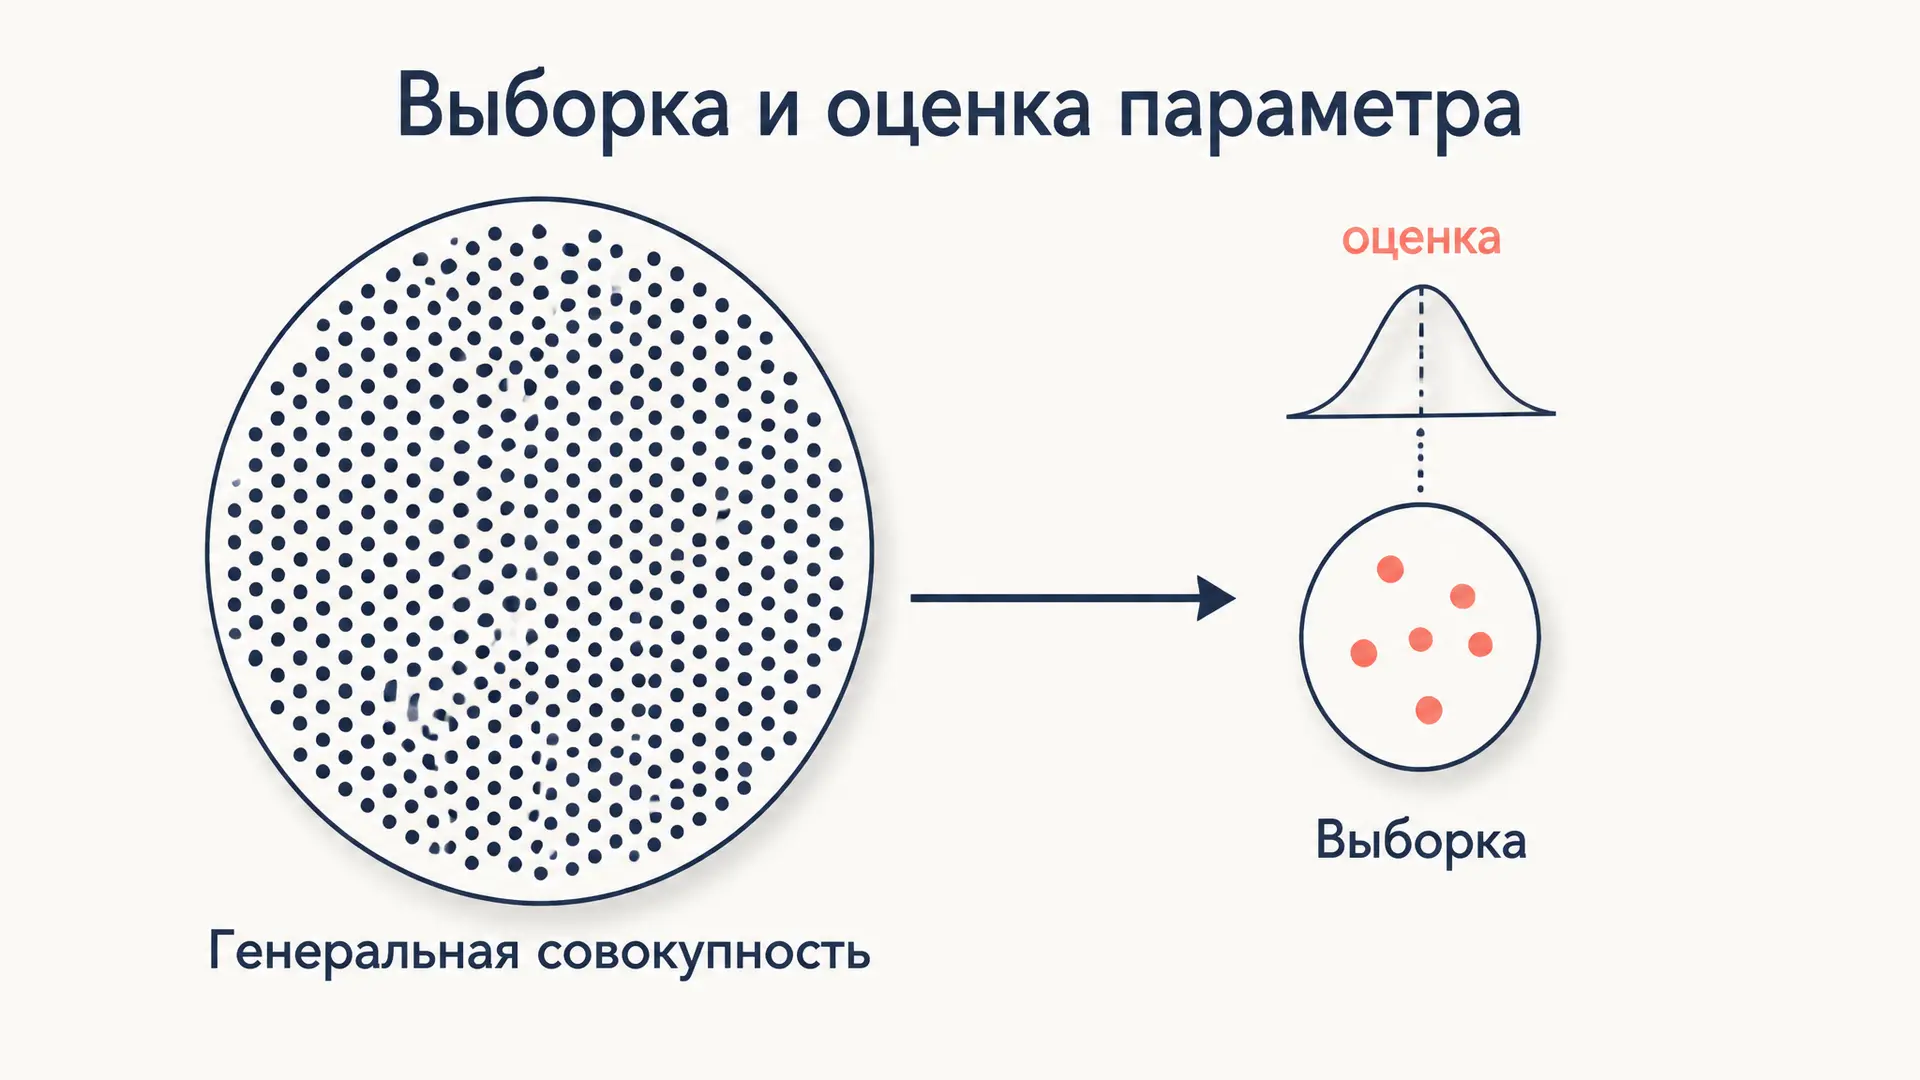
Генеральная совокупность и выборка в статистике
Генеральная совокупность и выборка в статистике: чем отличаются, как выборка оценивает параметры всей совокупности, виды выборок, репрезентативность, стандартная ошибка и доверительный интервал.
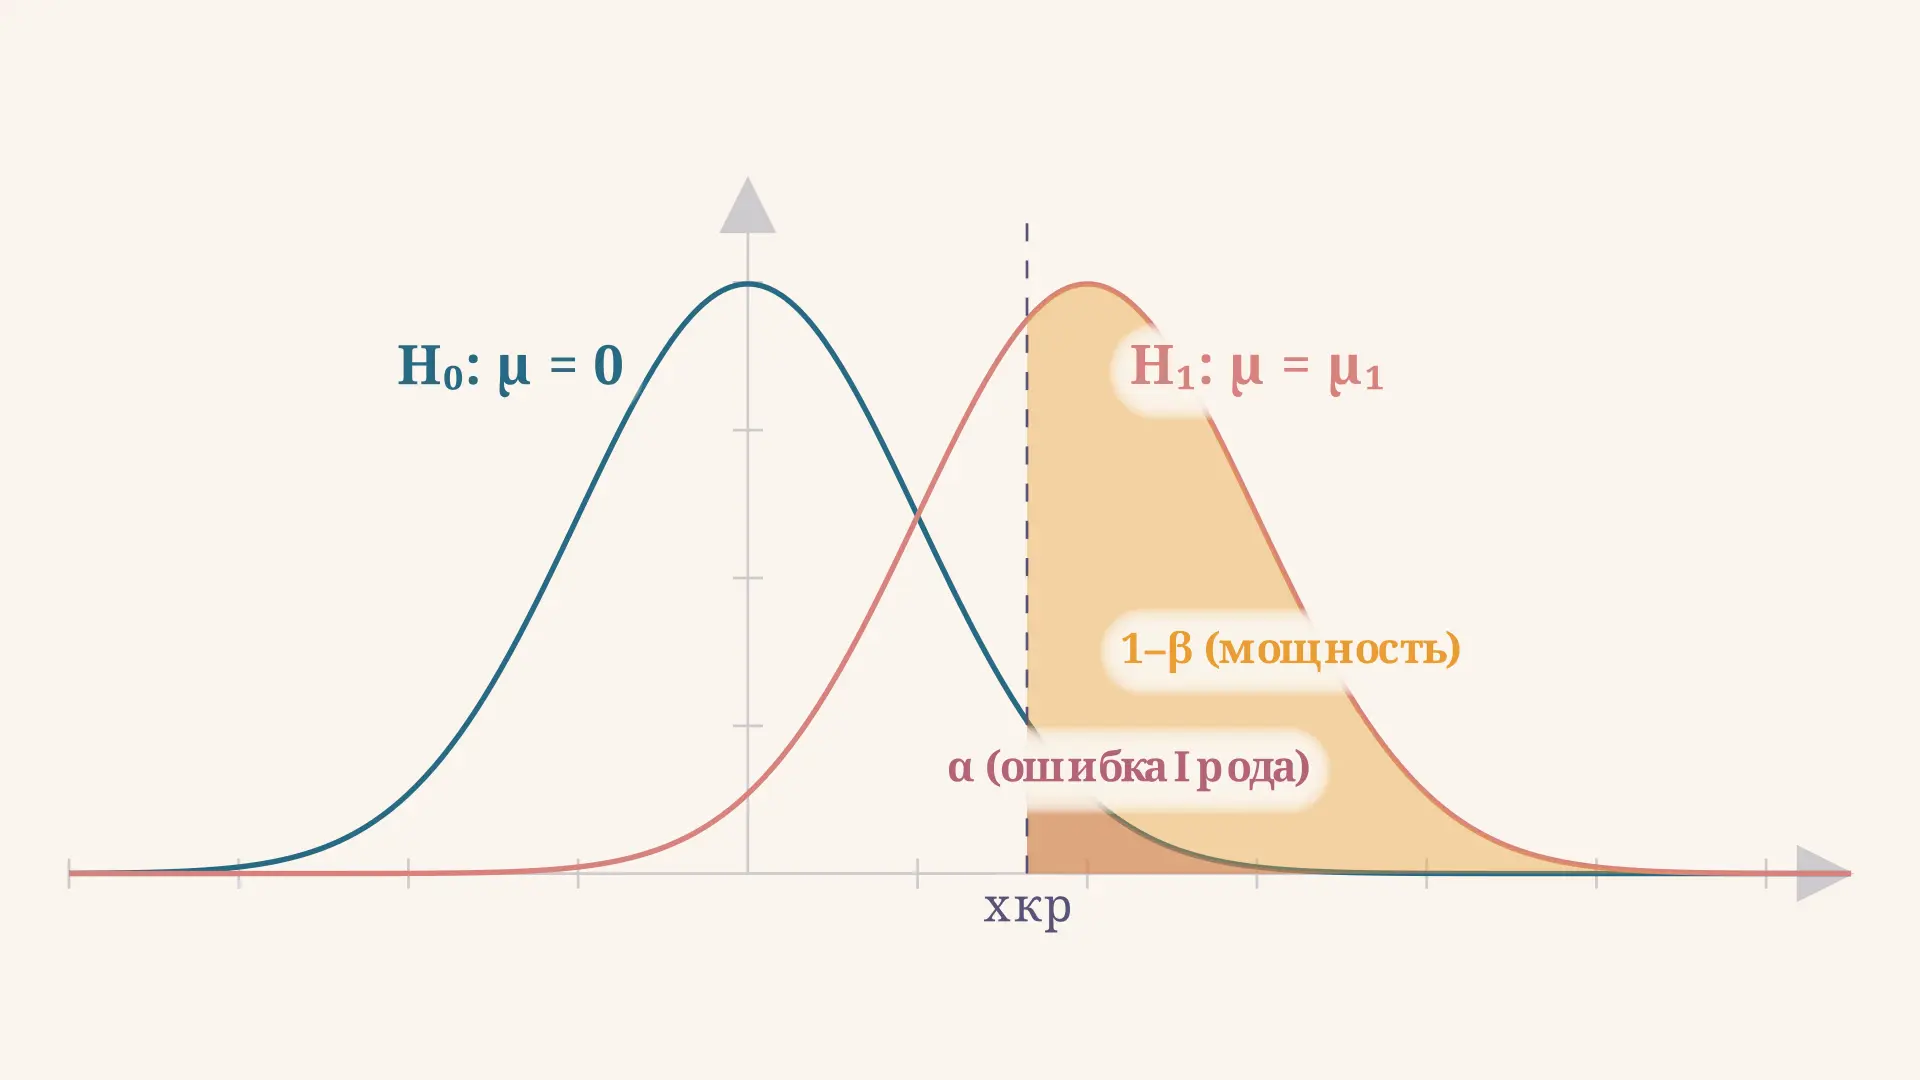
Мощность статистического критерия: формула и расчёт
Мощность статистического критерия 1-beta: как рассчитать через ошибку II рода, объём выборки и эффект-сайз. Формула для z-теста, целевой порог 80 %, примеры.
Адаптация первокурсников к вузу
Адаптация первокурсников к вузу: виды трудностей, этапы вхождения в учебную и социальную среду, роль куратора и тьютора, методы оценки и практические рекомендации.
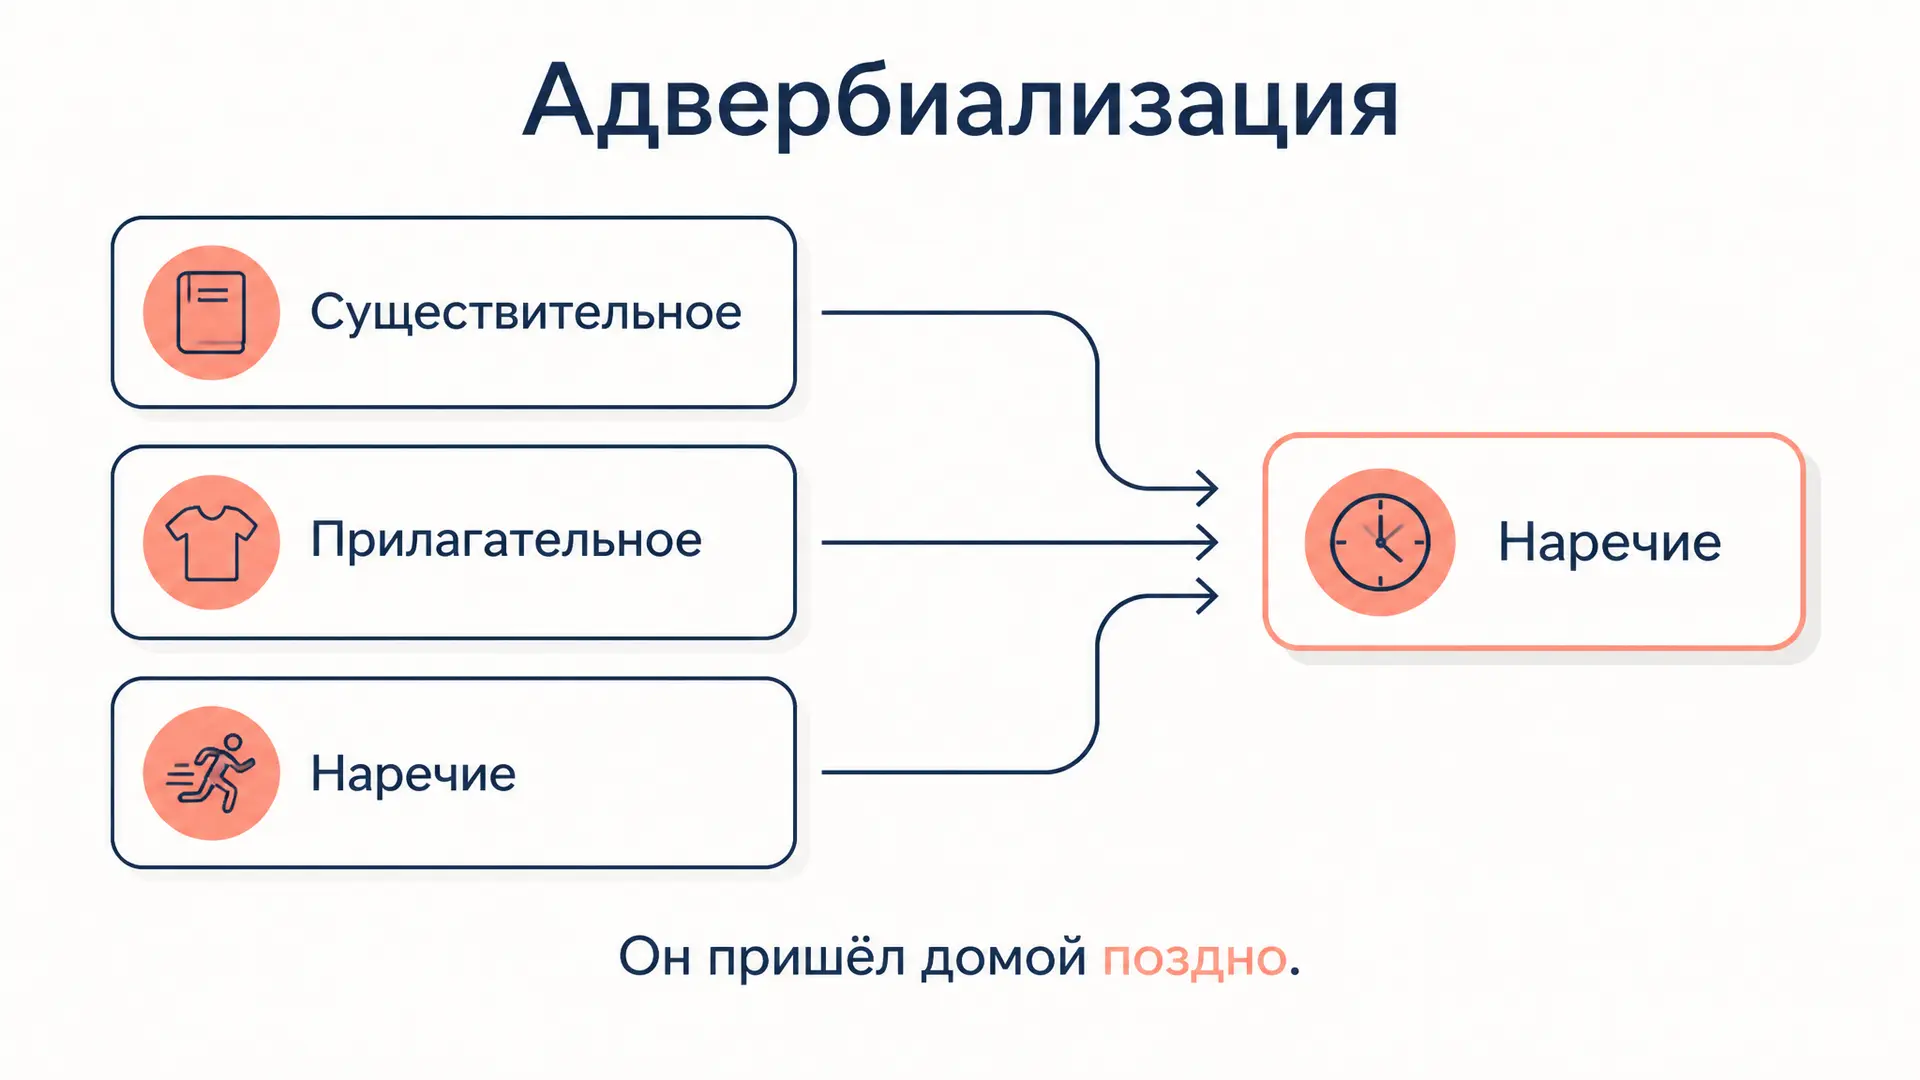
Адвербиализация: как слова становятся наречиями
Адвербиализация в русском языке: переход существительных, прилагательных и деепричастий в наречия, критерии, спорные случаи и правила слитного написания.
Акт о супрематии 1534: церковь и власть
Акт о супрематии 1534 года: почему Генрих VIII стал главой церкви Англии, как присяга привела к казни Мора и Фишера, роспуску монастырей и появлению англиканства.