Квотная выборка: как построить квотное задание
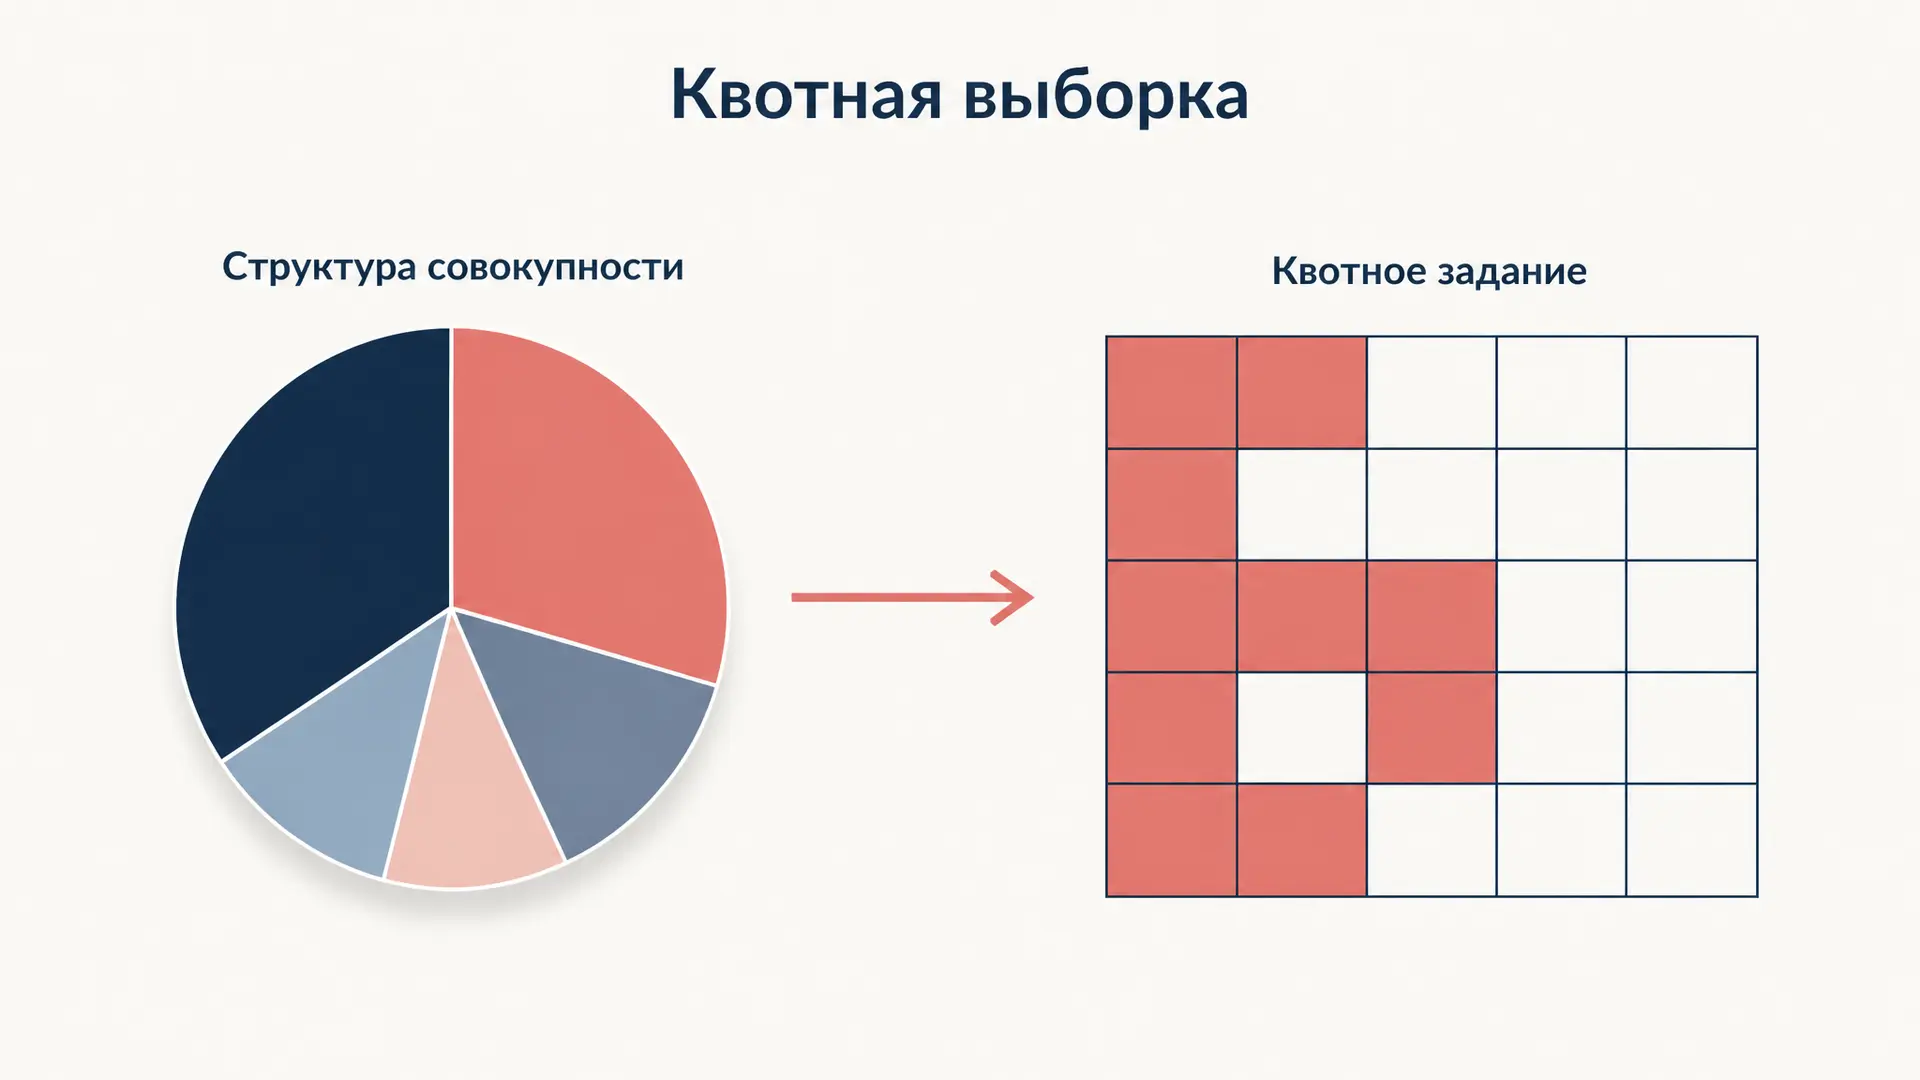
Квотная выборка - самый частый способ отбора в прикладных и студенческих опросах: структуру генеральной совокупности берут из готовой статистики, списки респондентов не нужны, поле закрывается за неделю. Отсюда и главная ловушка: таблица квот выглядит как гарантия репрезентативности, хотя контролирует лишь два-три признака, а внутри каждой ячейки отбор остаётся произвольным. Разберём, как строится квотное задание, чем маргинальные квоты отличаются от связанных, почему такой отбор не считается случайным и какие смещения он даёт. Конструктор ниже соберёт квотное задание под вашу совокупность.
Что такое квотная выборка и чем она не является
Квотная выборка - невероятностный отбор, при котором известную структуру генеральной совокупности по нескольким признакам воспроизводят в выборке принудительно: интервьюер получает задание набрать заданное число анкет в каждой группе и закрывает его теми, кого удалось опросить. Общий обзор схем отбора, расчёта объёма и ошибки - в разборе про выборку в социологии; здесь речь идёт только о квотном методе.
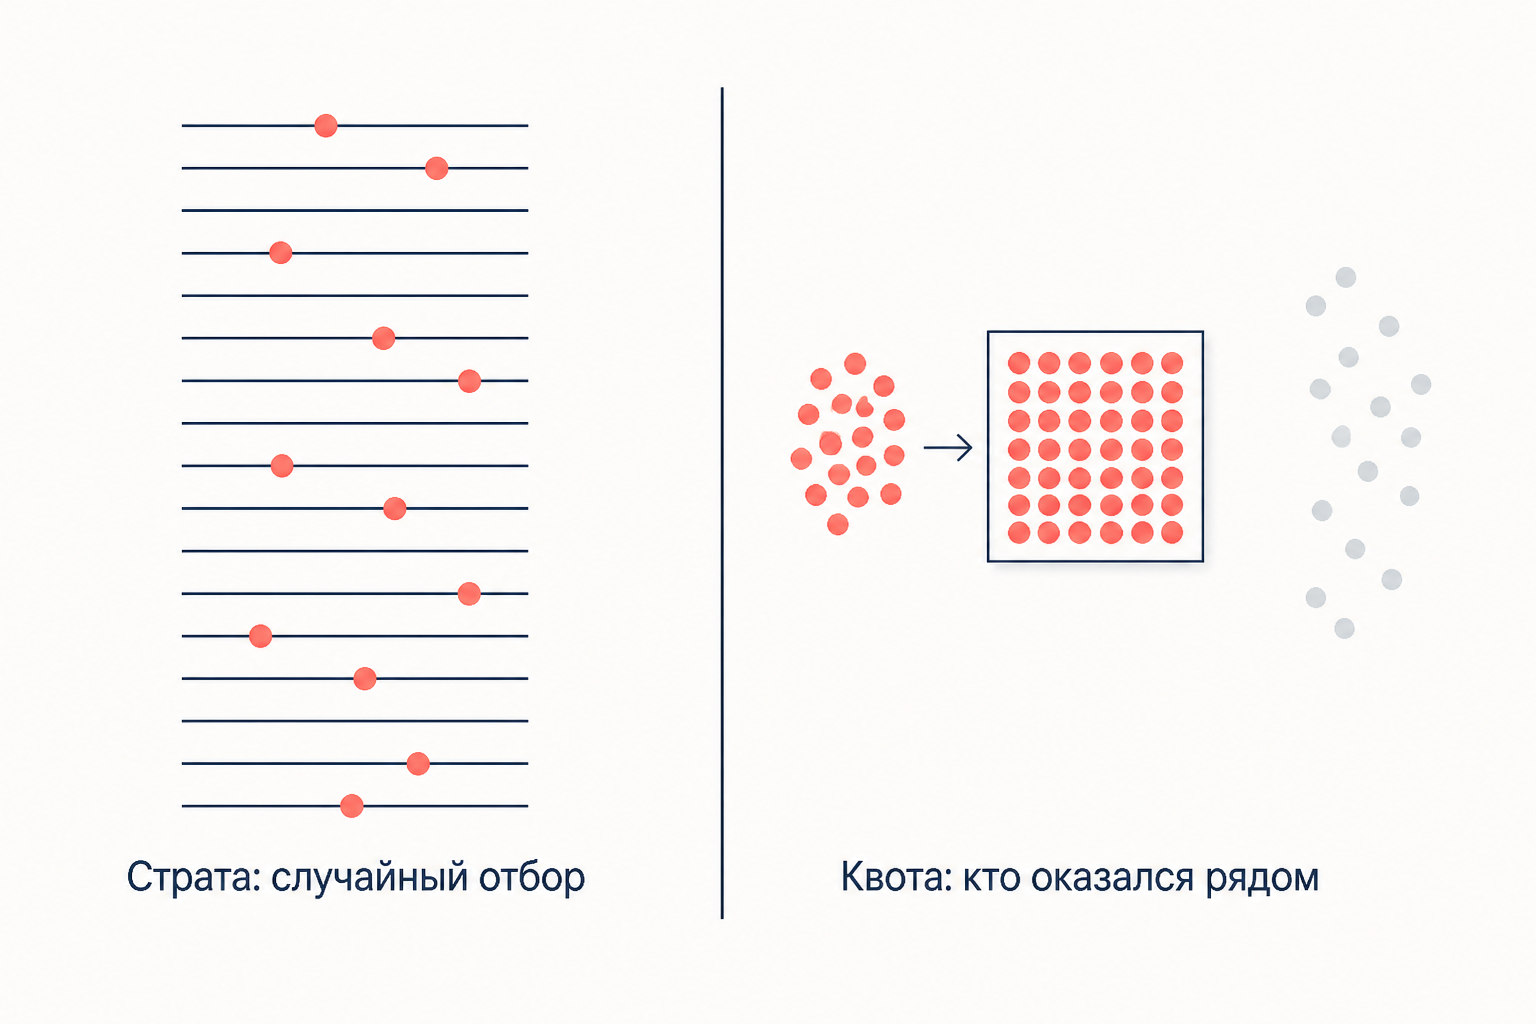
Чаще всего квотную выборку путают со стратифицированной, и на защите это стоит вопросов. Внешне схемы совпадают: совокупность делится на группы, у каждой своя доля в выборке. Различие - внутри группы. В стратифицированной внутри страты идёт случайный отбор из основы выборки, и вероятность включения известна для каждого человека. В квотной ячейку заполняют целенаправленно: берут первого подходящего, кто согласился, а вероятности попасть в выборку у людей одной ячейки разные и неизвестные.
Квотное задание: выбор признаков и расчёт ячеек
Признаки для квотирования выбирают по трём условиям сразу. Признак должен быть связан с изучаемым мнением - квотировать по тому, что на ответы не влияет, бессмысленно. Его распределение должно быть известно из надёжного источника: перепись, данные Росстата, отчёт отдела кадров, справка деканата, и ссылка на источник обязательна в тексте работы. И признак должен опознаваться на месте: пол и возрастную группу интервьюер видит, доход и политические взгляды - нет.
Плановое число анкет в ячейке считается прямо:
где - общий объём выборки, а - доля соответствующей группы в генеральной совокупности. Если совместное распределение неизвестно и признаки принимают независимыми, доли перемножают: .
Пример. На факультете 58 % женщин и 42 % мужчин; по ступеням - 45 % на первом-втором курсе, 40 % на третьем-четвёртом, 15 % в магистратуре. При объёме ячейка «женщины, первый-второй курс» получает анкеты, а ячейка «мужчины, магистратура» - всего .
Число ячеек растёт мультипликативно: , где - количество градаций -го признака. Три признака с 2, 3 и 3 градациями дают 18 ячеек, при 400 анкетах в средней ячейке остаётся около 22 человек, а в самой редкой - единицы.
Держите плановое наполнение ячейки не ниже 15 - 20 анкет: иначе задание невыполнимо в поле, а сравнивать группы между собой всё равно не получится. Практический предел для студенческого опроса - три квотируемых признака.
Маргинальные и связанные квоты
Одно и то же задание записывается двумя способами, и они дают разное качество данных.
Маргинальные (независимые) квоты фиксируют распределение по каждому признаку отдельно: 232 женщины и 168 мужчин, 180 анкет с младших курсов, 160 со старших, 60 из магистратуры. Заданы суммы по строкам и столбцам, содержимое клеток свободно. Выполнить такое задание легко, но интервьюер вправе набрать женщин преимущественно с младших курсов, а мужчин - со старших. По каждому признаку в отдельности структура выборки будет идеальной, а совместное распределение окажется перекошенным - притом что интересный эффект обычно живёт именно на пересечениях.
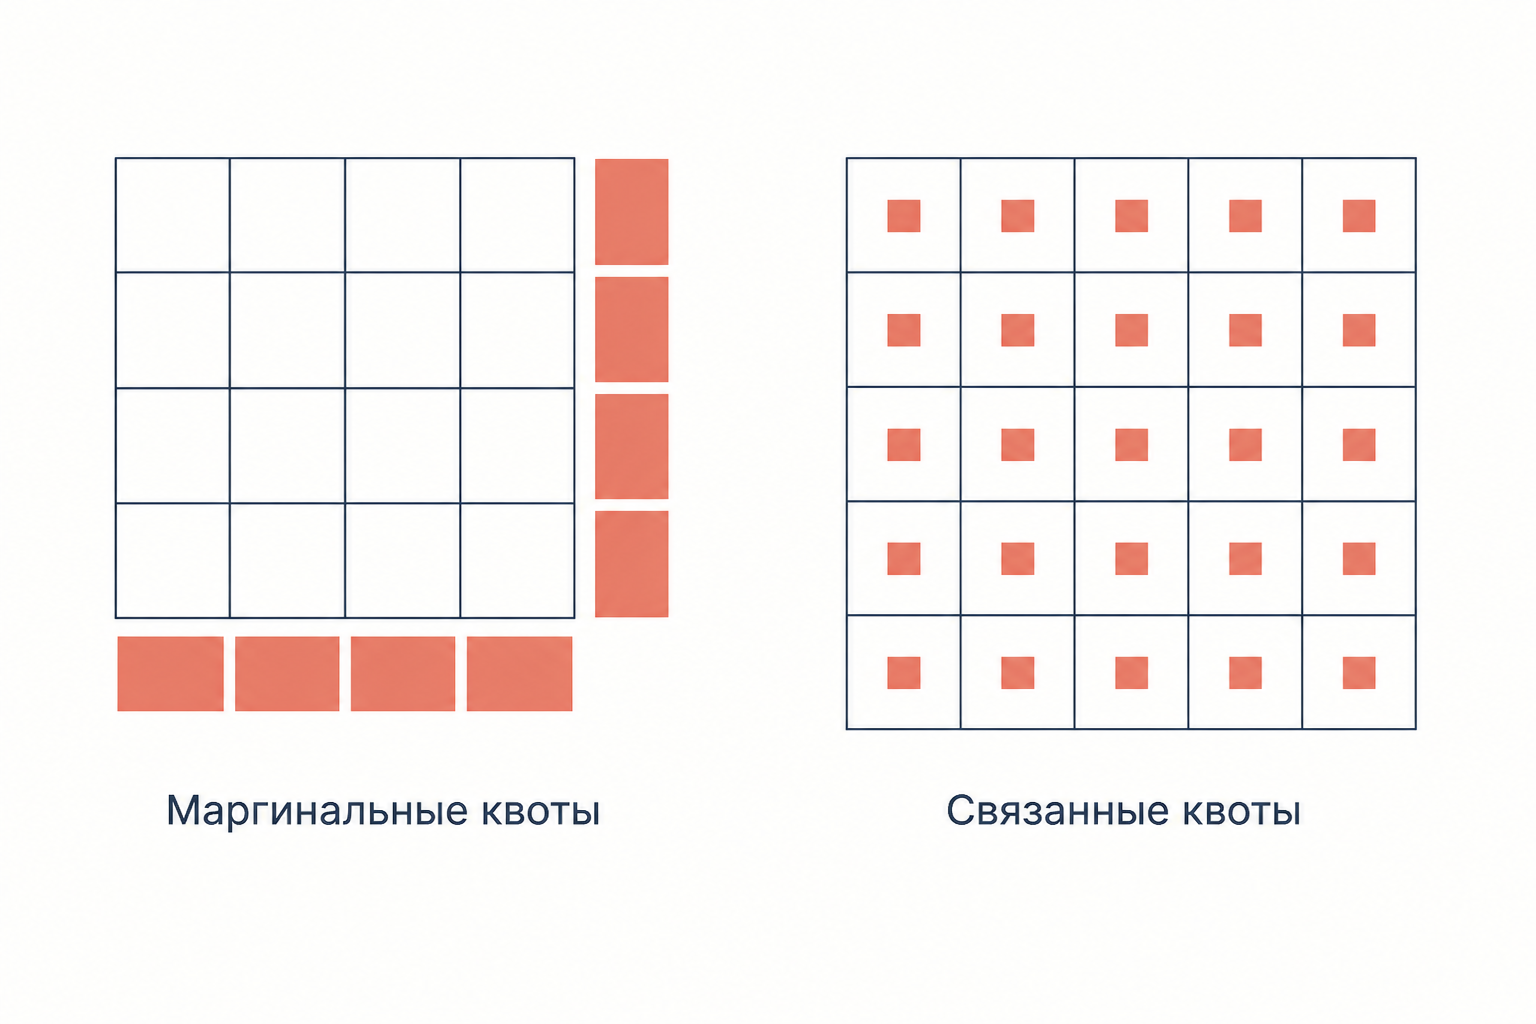
Связанные (комбинированные, взаимозависимые) квоты задают число анкет прямо в каждой клетке: 104 женщины с первого-второго курса, 93 женщины со старших, и так далее по всей сетке. Свобода интервьюера сужается, структура воспроизводится по совместному распределению. Плата - жёсткость задания: редкие ячейки закрываются последними и обходятся дороже всей остальной выборки. Рабочий компромисс - связать два самых важных признака, а остальные оставить маргинальными.
Почему квотный отбор не случайный
Формула предельной ошибки выведена для вероятностного отбора: она опирается на известную вероятность включения и на случайность её реализации. В квотной выборке эти вероятности неизвестны, поэтому доверительный интервал формально не определён. На практике его всё равно приводят, но обязательно как условную величину: «ошибка при вероятностном отборе такого же объёма не превысила бы 5 процентных пунктов». Разница не косметическая: заявляя точность, вы отвечаете за процедуру, которой не было.
Второе следствие важнее для планирования: наращивание объёма квотную выборку не чинит. Смещение внутри ячейки не убывает с ростом , поэтому тысяча анкет с одного удобного маршрута не точнее четырёхсот. Классический пример - выборы в США 1948 года: службы, работавшие на квотах, недооценили поддержку Трумэна, потому что интервьюеры внутри своих квот чаще выходили на более обеспеченных и доступных респондентов. После этого провала американские институты перешли на вероятностные схемы.
Смещения внутри ячейки
Ячейка заполняется теми, до кого проще дотянуться, и это порождает набор предсказуемых искажений.
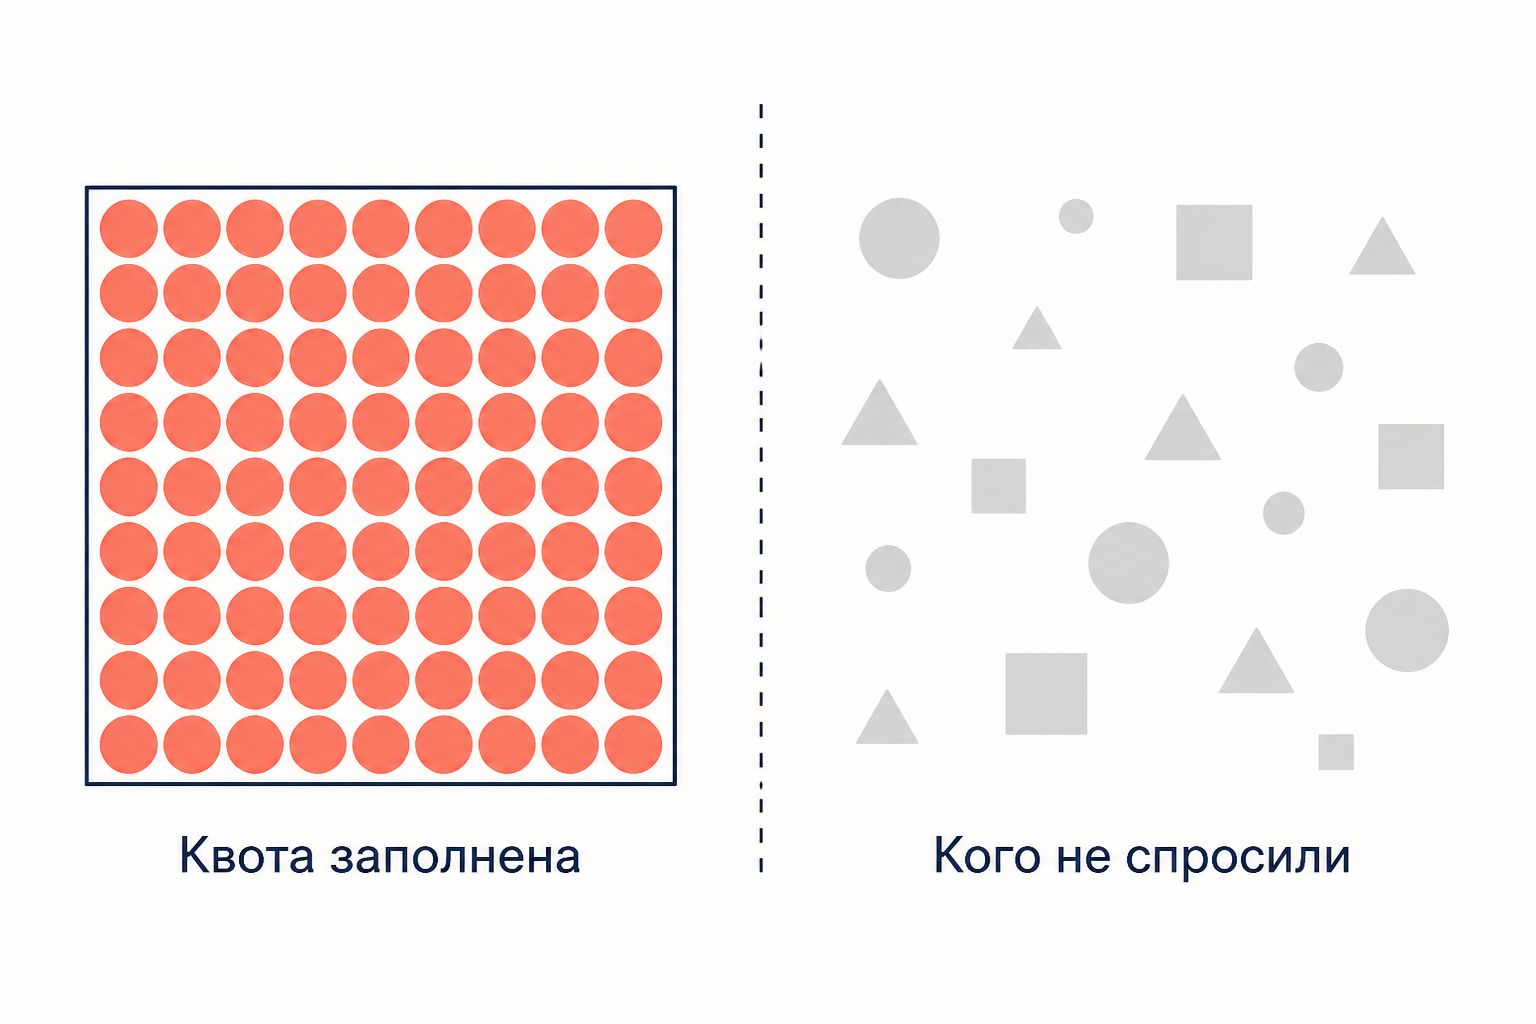
Смещение доступности: днём в будний день дома находятся неработающие, у метро - те, кто им пользуется, в корпусе университета - те, кто не ушёл после пары. Самоотбор: соглашаются более разговорчивые, менее занятые и лояльные к теме. Отдельно стоит невидимость отказов - главное методическое отличие квотного отбора: получив отказ, интервьюер просто идёт к следующему подходящему человеку, и потеря нигде не фиксируется. Доля ответивших здесь не считается в принципе, поэтому по отчёту не понять, скольких перебрали ради одной анкеты. Добавьте удобство самого интервьюера - знакомые, соседи, коллеги - и прямую фальсификацию анкет, к которой квотное задание располагает сильнее других схем: проверить по списку, кого опросили, невозможно.
Что с этим делают: разносят точки и время сбора, ведут дневник маршрута, дублируют квотируемые признаки вопросами анкеты и проверяют повторным контактом 10 - 20 % анкет каждого интервьюера.
Квоты и веса: постстратификация
Квота выравнивает структуру до сбора данных, вес - после. Если фактическая доля группы разошлась с известной долей в генеральной совокупности, каждому респонденту этой группы приписывают вес
и дальше считают взвешенные оценки. Когда известны только краевые распределения, применяют итеративное пропорциональное выравнивание (рейкинг): веса последовательно подгоняют под маргиналы по каждому признаку по очереди, пока процедура не сойдётся.
Границу метода нужно понимать честно: взвешивание правит структуру по тем же контролируемым признакам и ничего не делает со смещением по доступности внутри ячейки. Если в квоте «женщины 30 - 39 лет» опрошены только неработающие, никакой вес не сделает их работающими. Вдобавок крупные веса раздувают дисперсию оценок.
Как описать квотную выборку в курсовой
Раздел о методе складывается из пяти пунктов: источник данных о структуре совокупности с годом и ссылкой; перечень квотируемых признаков с обоснованием их связи с темой; тип квот и таблица задания с плановым числом анкет по ячейкам; процедура поиска респондентов - где, когда, как отбирали внутри ячейки, что делали при отказе; таблица «план и факт» с оговоркой, что за пределами квотируемых признаков смещение не контролируется. Фраза «применялась квотная выборка, опрошено 100 человек» без таблицы и источника структуры описанием метода не является.
Частые ошибки
- Называть квотную выборку случайной. Это невероятностный отбор, и статистическая ошибка для него приводится только как условная оценка с оговоркой.
- Путать квоты со стратификацией. В страте внутри слоя отбор случайный из списка, в квоте - по доступности; совпадает только деление на группы.
- Квотировать по признаку без известной структуры. Доли «на глаз» или по данным другого региона превращают задание в декорацию.
- Дробить сетку на десятки ячеек. Четыре признака дают наполнение по три анкеты в клетке: задание невыполнимо, а группы несопоставимы.
- Считать заполненную квоту доказательством репрезентативности. Выборка воспроизводит совокупность только по контролируемым признакам, по остальным - как получится.
FAQ
Чем квотная выборка отличается от стратифицированной? Делением на группы они похожи, но в стратифицированной внутри каждого слоя идёт случайный отбор из основы выборки и вероятность включения известна, а в квотной ячейку заполняют доступными респондентами. Поэтому стратифицированная выборка вероятностная и допускает расчёт ошибки, а квотная - нет.
Можно ли считать ошибку выборки при квотном отборе? Строго - нет, вероятности включения неизвестны. В отчётах и курсовых её обычно приводят как ориентир для вероятностной выборки того же объёма, обязательно сопровождая оговоркой. Выдавать такое число за измеренную точность нельзя.
Сколько признаков квотировать и где взять их структуру? Как правило, два-три: пол, возрастная группа и один содержательный признак (курс, тип занятости, район). Источники - итоги переписи и данные Росстата для населения, кадровая отчётность для предприятия, справка деканата для вуза; нужны год данных и точные доли, а не округлённое «примерно поровну».
Коротко
Квотная выборка воспроизводит структуру совокупности по нескольким известным признакам: доли берут из статистики, умножают на объём выборки и получают плановое число анкет в каждой ячейке квотного задания. Маргинальные квоты фиксируют только краевые распределения и допускают перекос на пересечениях, связанные задают наполнение каждой клетки и потому надёжнее. Отбор внутри ячейки остаётся неслучайным, вероятности включения неизвестны, отказы не фиксируются, поэтому формулы ошибки применимы лишь условно, а рост объёма смещение не лечит. Постстратификация и рейкинг правят структуру после сбора данных, но не спасают от смещения по доступности, поэтому таблицу квот всегда сопровождают описанием процедуры, сравнением плана с фактом и списком ограничений.
Читайте также
Метод фокус-групп: как провести исследование
Метод фокус-групп в социологии и маркетинге: состав участников, роль модератора, гайд беседы, запись и тематический анализ. Отличия от интервью, ошибки и пример исследования.
Социологический эксперимент: метод и дизайн
Социологический эксперимент: как устроены гипотеза, группы и воздействие, чем отличаются лабораторный, полевой и естественный дизайн, как оценить валидность и этику.
Шкала Гуттмана: скалограмма и коэффициент воспроизводимости
Шкала Гуттмана по шагам: кумулятивные суждения, таблица-скалограмма, подсчёт ошибок, коэффициенты воспроизводимости и масштабируемости на примере 10 респондентов.
Контент-анализ в социологии: от категорий до каппы Коэна
Контент-анализ в социологии по шагам: определение Берельсона, единицы анализа и счёта, кодировочный бланк, качественный вариант и проверка надёжности через каппу Коэна.
Анкетирование: правила составления анкеты
Анкетирование и правила составления анкеты: структура из трёх частей, типы вопросов, правило воронки, шкалы Лайкерта и семантического дифференциала, пилотаж и разбор типичных ошибок формулировок.
Панельное исследование: одни и те же люди по волнам
Панельное исследование в социологии: чем отличается от трендового и когортного, как устроены волны и панельная матрица, что такое истощение панели и панельный эффект, как описать дизайн.