Контент-анализ в социологии: от категорий до каппы Коэна
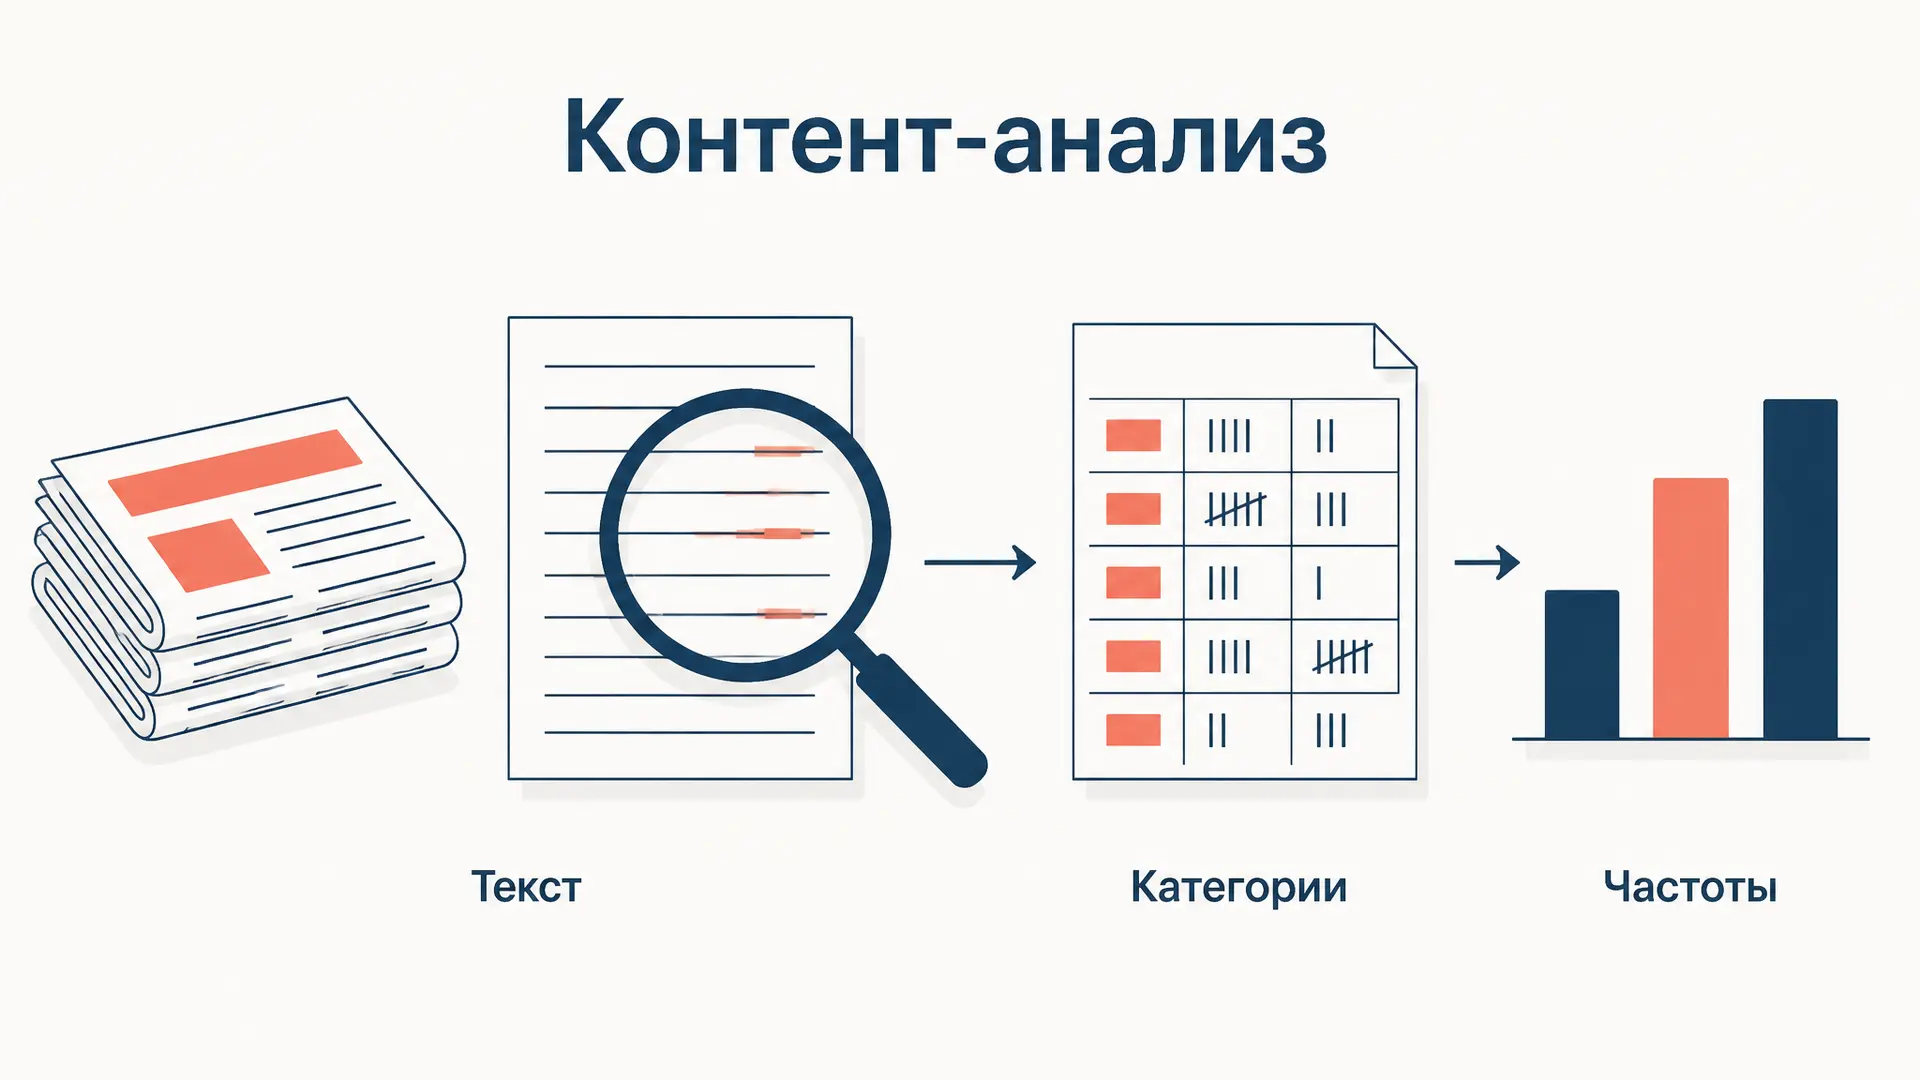
Контент-анализ в социологии превращает тексты в данные: газетные заметки, посты, речи и интервью раскладываются по заранее заданным категориям, а затем считаются. Метод кажется простым, пока не выясняется, что два человека по-разному кодируют одну и ту же заметку. Поэтому серьёзное исследование сообщает не только частоты, но и надёжность кодирования. Калькулятор ниже считает её по таблице согласия двух кодировщиков: впишите, как каждый из них разметил одни и те же тексты.
Что такое контент-анализ
Классическое определение дал Бернард Берельсон в книге Content Analysis in Communication Research (1952): контент-анализ есть исследовательская техника объективного, систематического и количественного описания явного содержания коммуникации. Каждое слово здесь несёт требование. Объективность означает, что правила кодирования записаны так подробно, что другой исследователь получит по ним те же цифры. Систематичность: в анализ попадает весь отобранный массив, а не удобные цитаты. Количественность: результат выражается частотами и долями. Явное содержание: кодируется то, что написано, а не то, что исследователь вычитал между строк.
Позже Клаус Криппендорф расширил определение: контент-анализ даёт воспроизводимые и обоснованные выводы от текстов к контексту их использования. Тексты считают не ради подсчёта, а чтобы судить об авторах, аудитории и времени. В терминах формулы Лассуэлла метод отвечает прежде всего на вопрос «что сказано», а через него выходит на «кто говорит» и «с каким эффектом».
Откуда метод: Лассуэлл и анализ пропаганды
Подсчёты газетных тем встречались ещё в начале XX века: в 1910 году Макс Вебер предлагал Немецкому социологическому обществу систематически обследовать прессу. Но как метод контент-анализ сложился в работах Гарольда Лассуэлла. В книге «Техника пропаганды в мировой войне» (1927) он сравнивал символы и темы, которыми воюющие стороны объясняли войну своим гражданам.
Во время Второй мировой Лассуэлл руководил при Библиотеке Конгресса группой по изучению военных коммуникаций. Она систематически кодировала вражеские и нейтральные издания, а результаты использовались даже как доказательства в судебных делах о пропаганде. Параллельно шёл проект по символам мировой политики: в передовицах ведущих газет нескольких стран за полвека подсчитывали упоминания ключевых символов вроде «демократии» и «свободы». Из этой практики вышли кодировочные инструкции, проверка согласия кодировщиков и сама идея, что символ можно считать как единицу. Берельсон, работавший рядом с Лассуэллом, обобщил этот опыт в учебнике 1952 года. В советской социологии метод развивался в 1960-1970-х при изучении прессы и массовой информации, в том числе в Таганрогском проекте Бориса Грушина.
Единицы анализа и единицы счёта
Первый технический выбор: что кодировать и что считать. Это разные вещи, и их путают чаще всего.
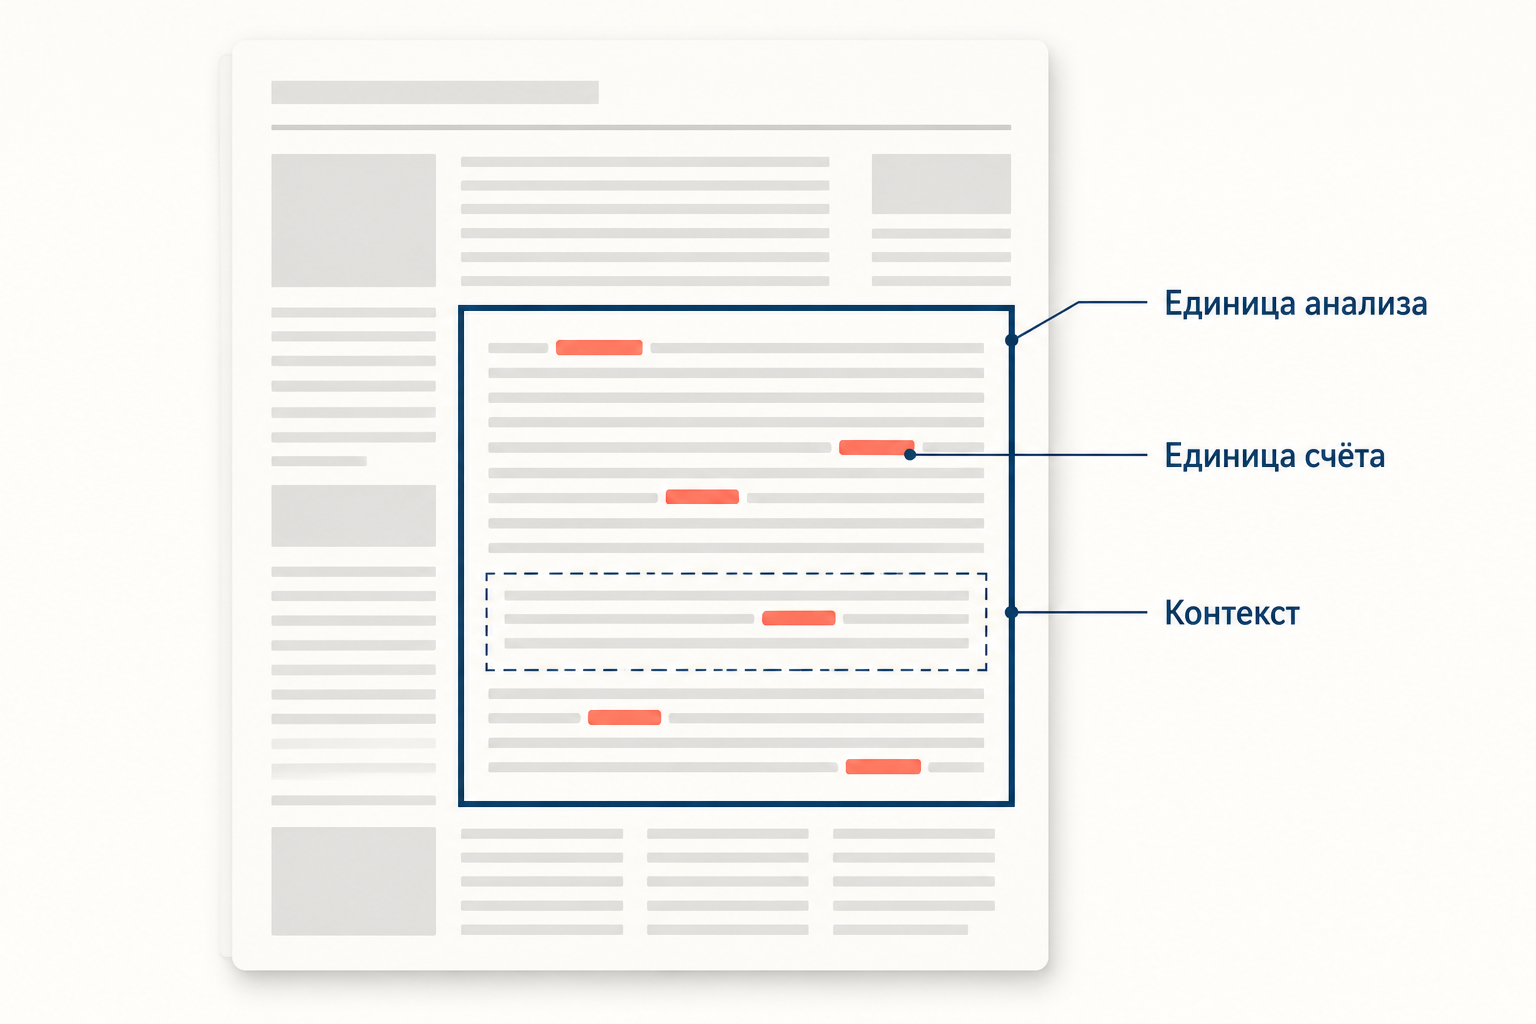
Единица анализа (смысловая единица) - фрагмент текста, который относят к категории: слово, тема, суждение, персонаж или целая публикация. Единица счёта - мера, которой фиксируют присутствие единицы анализа: число упоминаний, число публикаций, площадь в квадратных сантиметрах, секунды эфира. Если единица анализа - тема «коррупция», единицей счёта может быть и частота упоминаний, и доля газетной площади, отданной теме. Контекстная единица - фрагмент, который кодировщик читает, чтобы понять смысл: слово «реформа» в абзаце про пенсии и в абзаце про школу кодируется по-разному.
До выбора единиц идёт выборка: сначала источники и период, затем номера или выпуски, и только потом единицы внутри них. Как задать объём и не перекосить массив, разобрано в статье про выборку в социологии.
Категории и кодировочный бланк
Категории - рубрики, по которым раскладываются единицы анализа: тема, тональность, тип источника, главный актор. Они не придумываются на ходу, а выводятся из понятий исследования. Как понятие вроде «доверия к власти» распадается на измерения и индикаторы, показано в разборе операционализации понятий; в контент-анализе индикаторы становятся категориями.
К системе категорий три требования. Она исчерпывающая: любая единица куда-то попадает, и для этого почти всегда нужна категория «другое». Категории взаимоисключающие: по одному признаку единица попадает только в одну рубрику. И у каждой категории есть правило отнесения с примерами и пограничными случаями.
Правила собираются в кодировочную инструкцию, а решения заносятся в кодировочный бланк: одна строка на единицу анализа, один столбец на признак.
| № | Издание | Дата | Тема | Тональность | Главный актор |
|---|---|---|---|---|---|
| 017 | Городская газета | 12.03 | Благоустройство | Нейтральная | Администрация |
| 018 | Городская газета | 14.03 | Транспорт | Негативная | Жители |
Бланк заполняется одинаково разными людьми и сразу превращается в таблицу для SPSS или R. Отсюда и проверка: если два кодировщика заполняют его по-разному, виновата чаще инструкция, чем люди.
Количественный и качественный контент-анализ
Определение Берельсона описывает количественный вариант. Уже в 1952 году Зигфрид Кракауэр возразил, что подсчёт слов теряет смысл, который создаётся связями между ними, и предложил качественный анализ. В 1980-х Филипп Майринг превратил его в процедуру с правилами: категории выводятся из материала или берутся из теории, а текст пересматривается, пока система не устоится.
| Признак | Количественный | Качественный |
|---|---|---|
| Содержание | явное | явное и латентное |
| Категории | заданы до кодирования | уточняются по ходу |
| Результат | частоты, доли, связи | типология, интерпретация |
| Материал | большие массивы | десятки текстов, интервью |
| Проверка | согласие кодировщиков | прозрачность процедуры |
На практике варианты сочетают: качественно разбирают пилотную выборку, строят категории, затем количественно кодируют весь массив. Для курсовой по публикациям СМИ обычно хватает количественного варианта, для интервью лучше подходит качественный.
Надёжность кодирования: каппа Коэна
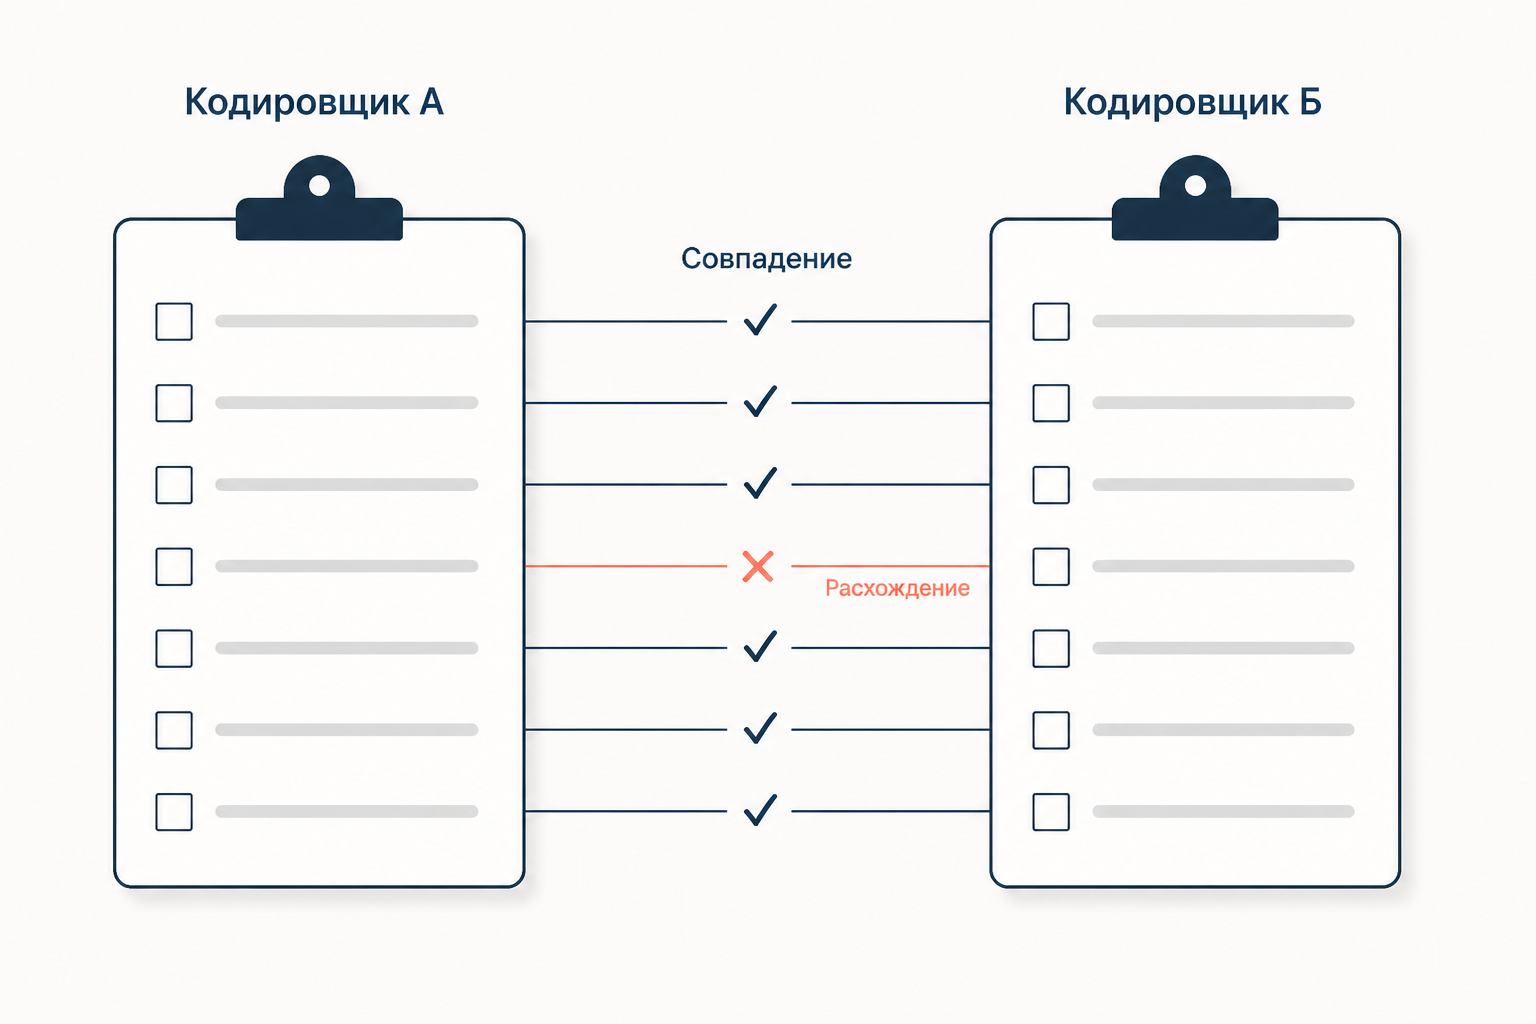
Надёжность проверяют так: два кодировщика независимо размечают одни и те же единицы, обычно 10-20% массива, и их решения сводят в таблицу согласия. Строки - категории кодировщика А, столбцы - кодировщика Б, на диагонали совпадения.
Простая доля совпадений (коэффициент Холсти) завышает надёжность: даже случайно расставленные метки иногда совпадают. Якоб Коэн в 1960 году предложил вычитать случайное согласие:
где - совпадения в категории , и - суммы строки и столбца, - число единиц.
Пример из калькулятора: 100 новостей, три категории тональности. Кодировщик А отнёс к позитивным 28, к нейтральным 46, к негативным 26; кодировщик Б - 27, 46 и 27. Совпали 82 раза. Тогда
По шкале Лэндиса и Коха значения 0,61-0,80 означают значительное согласие, выше 0,80 почти полное. Для альфы Криппендорфа, которая работает с любым числом кодировщиков и пропусками, автор задаёт порог 0,80 для надёжных выводов и 0,667 для предварительных; на каппу его обычно переносят по аналогии. Пи Скотта отличается только способом считать , по общим для двоих долям категорий, и на этих данных тоже даёт 0,72.
Каппа капризна при перекошенных долях. Если признака нет в 94-95% текстов, совпадение в 91% даёт каппу всего 0,13: случайное согласие и так равно 0,896. Это не ошибка расчёта, а сигнал, что редкую категорию надо проверять на большей выборке.
Пример исследования по шагам
Условный вопрос: как городская пресса освещает благоустройство. Гипотеза: в изданиях, учреждённых администрацией, доля негативных материалов ниже, чем в независимых.
- Выборка. Три издания, январь-июнь, все материалы с упоминанием благоустройства: 420 публикаций.
- Единицы. Единица анализа - публикация, единица счёта - число публикаций; для отдельной задачи считают упоминания конкретных парков и улиц.
- Категории. Тема (парки, дворы, транспорт, другое), тональность (позитивная, нейтральная, негативная), главный актор (администрация, жители, эксперты, бизнес). Для каждой записаны правило и пограничные примеры.
- Пилот и надёжность. Два кодировщика размечают 100 публикаций. Первая версия инструкции даёт , и половина расхождений, 9 из 18, приходится на границу позитивной и нейтральной тональности. Правило уточняют: позитивная только при явной оценке, а не при перечислении сделанного. Повторный пилот на новой партии проверяет, поднялась ли каппа выше 0,80.
- Кодирование. Весь массив размечают по уточнённой инструкции.
- Анализ. Таблица сопряжённости «учредитель × тональность» и критерий хи-квадрат; доли считаются от числа публикаций издания, а не от всего массива.
- Интерпретация. Разницу в тональности соотносят с контекстом: её может давать не только учредитель, но и жанр, ведь независимые издания чаще печатают письма жителей.
Частые ошибки
- Смешивать единицу анализа и единицу счёта: считать «упоминания», не решив, что считается упоминанием.
- Строить категории без «другого» и без правил для пограничных случаев: кодировщики решают каждый по-своему.
- Сообщать долю совпадений вместо каппы: 91% совпадений при каппе 0,13 выглядят надёжно, но это иллюзия.
- Проверять надёжность на тех же текстах, на которых обсуждали инструкцию: каппа завышается.
- Делать выводы о намерениях авторов по частотам: из явного содержания прямо следует только то, что написано.
FAQ
Чем контент-анализ отличается от анализа документов? Анализ документов - широкий класс методов. Традиционный анализ интерпретирует отдельный документ целиком, а контент-анализ формализован: он считает признаки в массиве по категориям и единицам счёта и проверяет надёжность кодирования.
Сколько текстов нужно для контент-анализа? Зависит от задачи и числа категорий. Для курсовой обычно берут 100-300 единиц; на проверку надёжности уходит 10-20% массива, но не меньше 50 единиц, иначе каппа слишком неустойчива.
Можно ли кодировать одному? Можно, но тогда надёжность проверяют повторным кодированием той же выборки через две-три недели и честно пишут об этом в методике. Отдать часть текстов второму кодировщику всё равно надёжнее.
Коротко
Контент-анализ в социологии - формализованный метод, который превращает тексты в частоты: из понятий выводятся категории, для них выбираются единицы анализа и единицы счёта, решения заносятся в кодировочный бланк по письменной инструкции. Метод вырос из анализа пропаганды у Лассуэлла и получил определение у Берельсона; качественный вариант добавил латентное содержание. Результатам можно верить, только если два кодировщика независимо приходят к одному: это проверяют каппой Коэна, которая вычитает случайное согласие из доли совпадений, и добиваются значений выше 0,80.
Читайте также
Метод фокус-групп: как провести исследование
Метод фокус-групп в социологии и маркетинге: состав участников, роль модератора, гайд беседы, запись и тематический анализ. Отличия от интервью, ошибки и пример исследования.
Социологический эксперимент: метод и дизайн
Социологический эксперимент: как устроены гипотеза, группы и воздействие, чем отличаются лабораторный, полевой и естественный дизайн, как оценить валидность и этику.
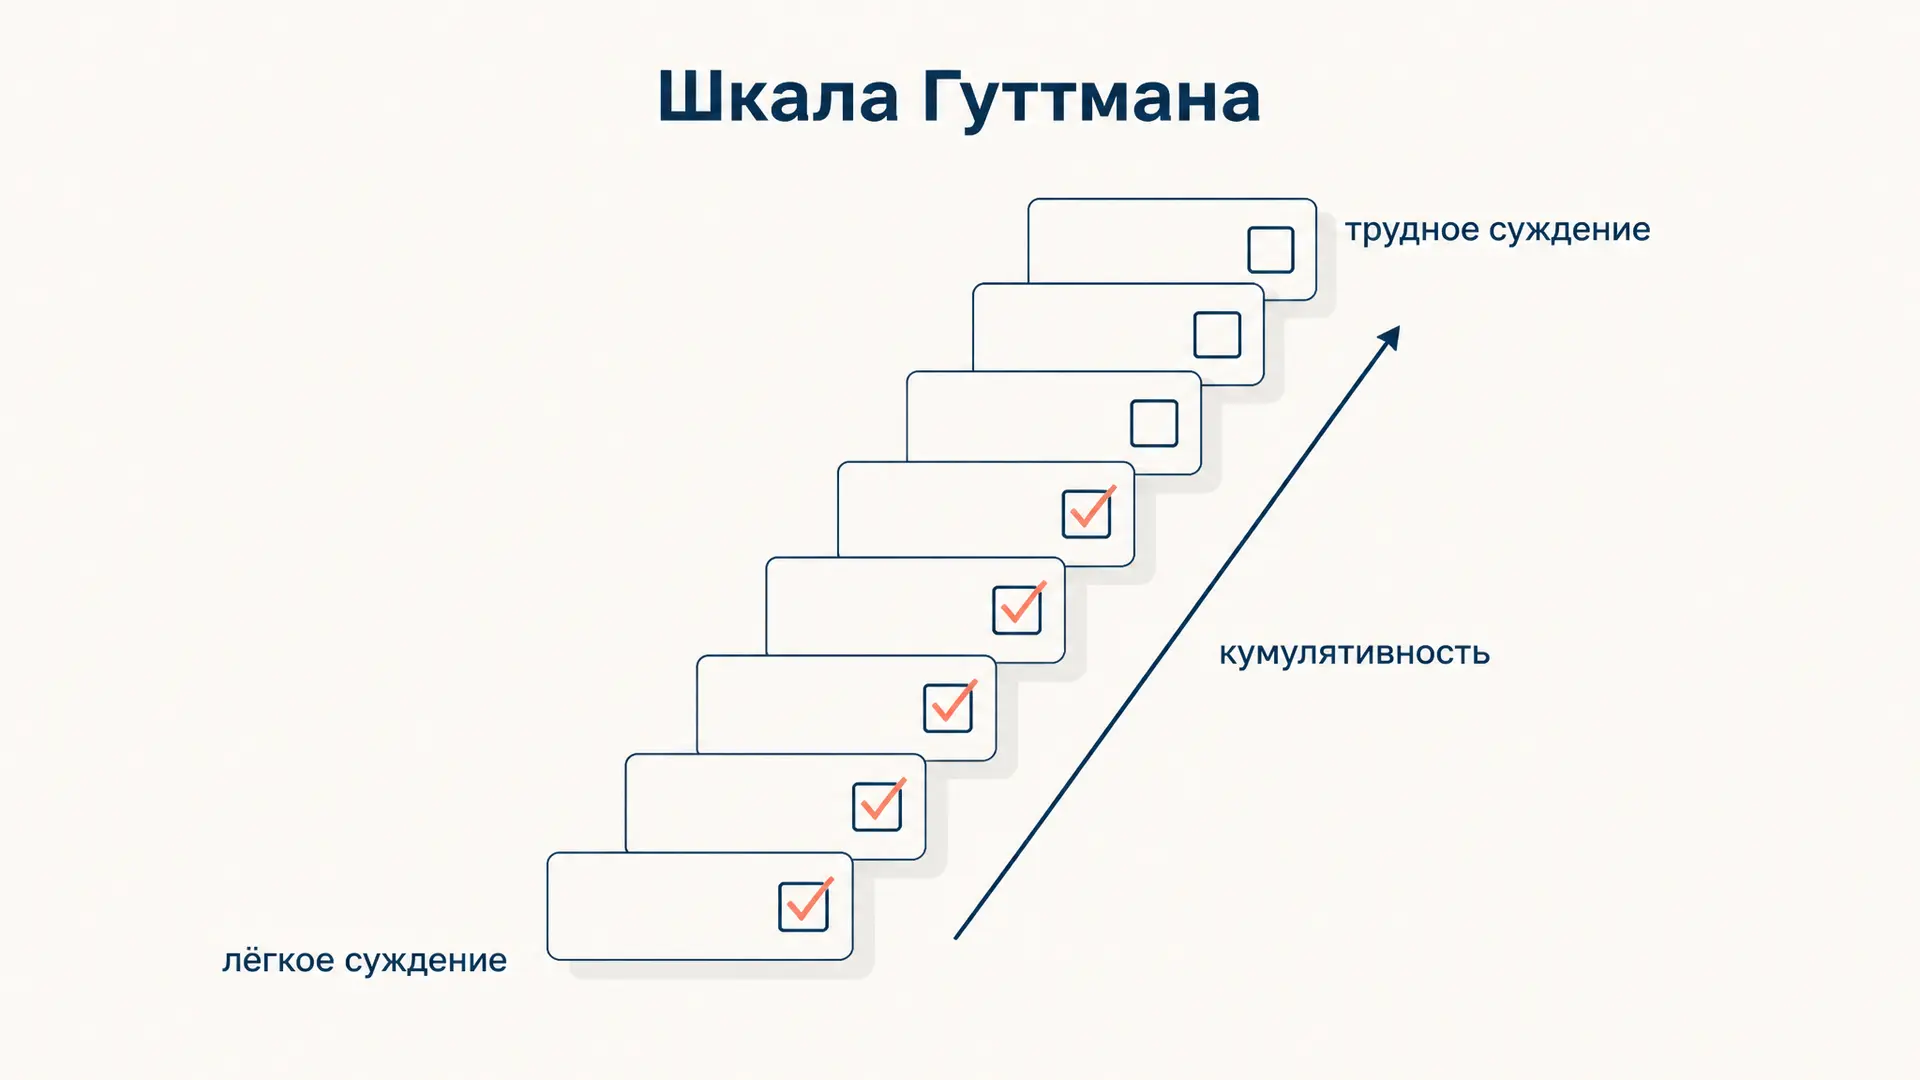
Шкала Гуттмана: скалограмма и коэффициент воспроизводимости
Шкала Гуттмана по шагам: кумулятивные суждения, таблица-скалограмма, подсчёт ошибок, коэффициенты воспроизводимости и масштабируемости на примере 10 респондентов.
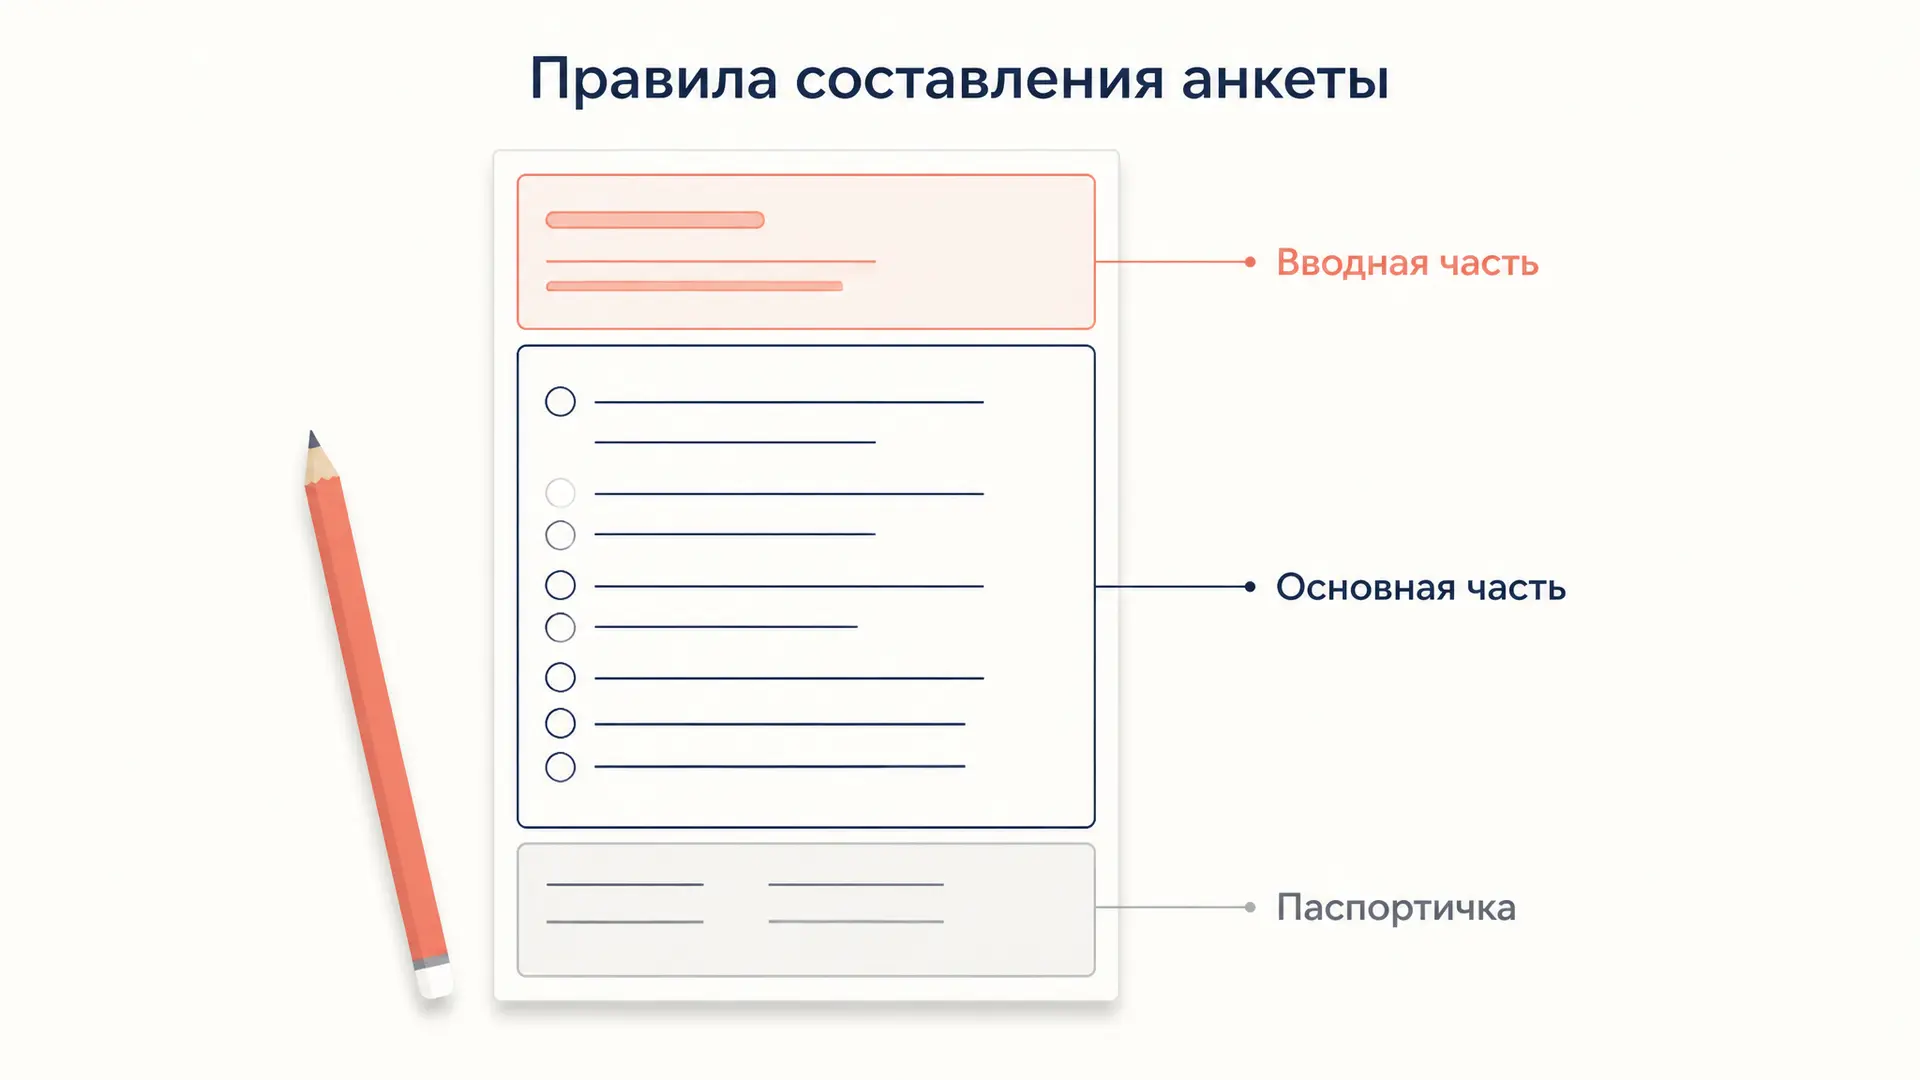
Анкетирование: правила составления анкеты
Анкетирование и правила составления анкеты: структура из трёх частей, типы вопросов, правило воронки, шкалы Лайкерта и семантического дифференциала, пилотаж и разбор типичных ошибок формулировок.
Квотная выборка: как построить квотное задание
Квотная выборка: как выбрать признаки и рассчитать ячейки квотного задания, чем маргинальные квоты отличаются от связанных, почему это неслучайный отбор и какие смещения он даёт.
Панельное исследование: одни и те же люди по волнам
Панельное исследование в социологии: чем отличается от трендового и когортного, как устроены волны и панельная матрица, что такое истощение панели и панельный эффект, как описать дизайн.