Шкала Гуттмана: скалограмма и коэффициент воспроизводимости
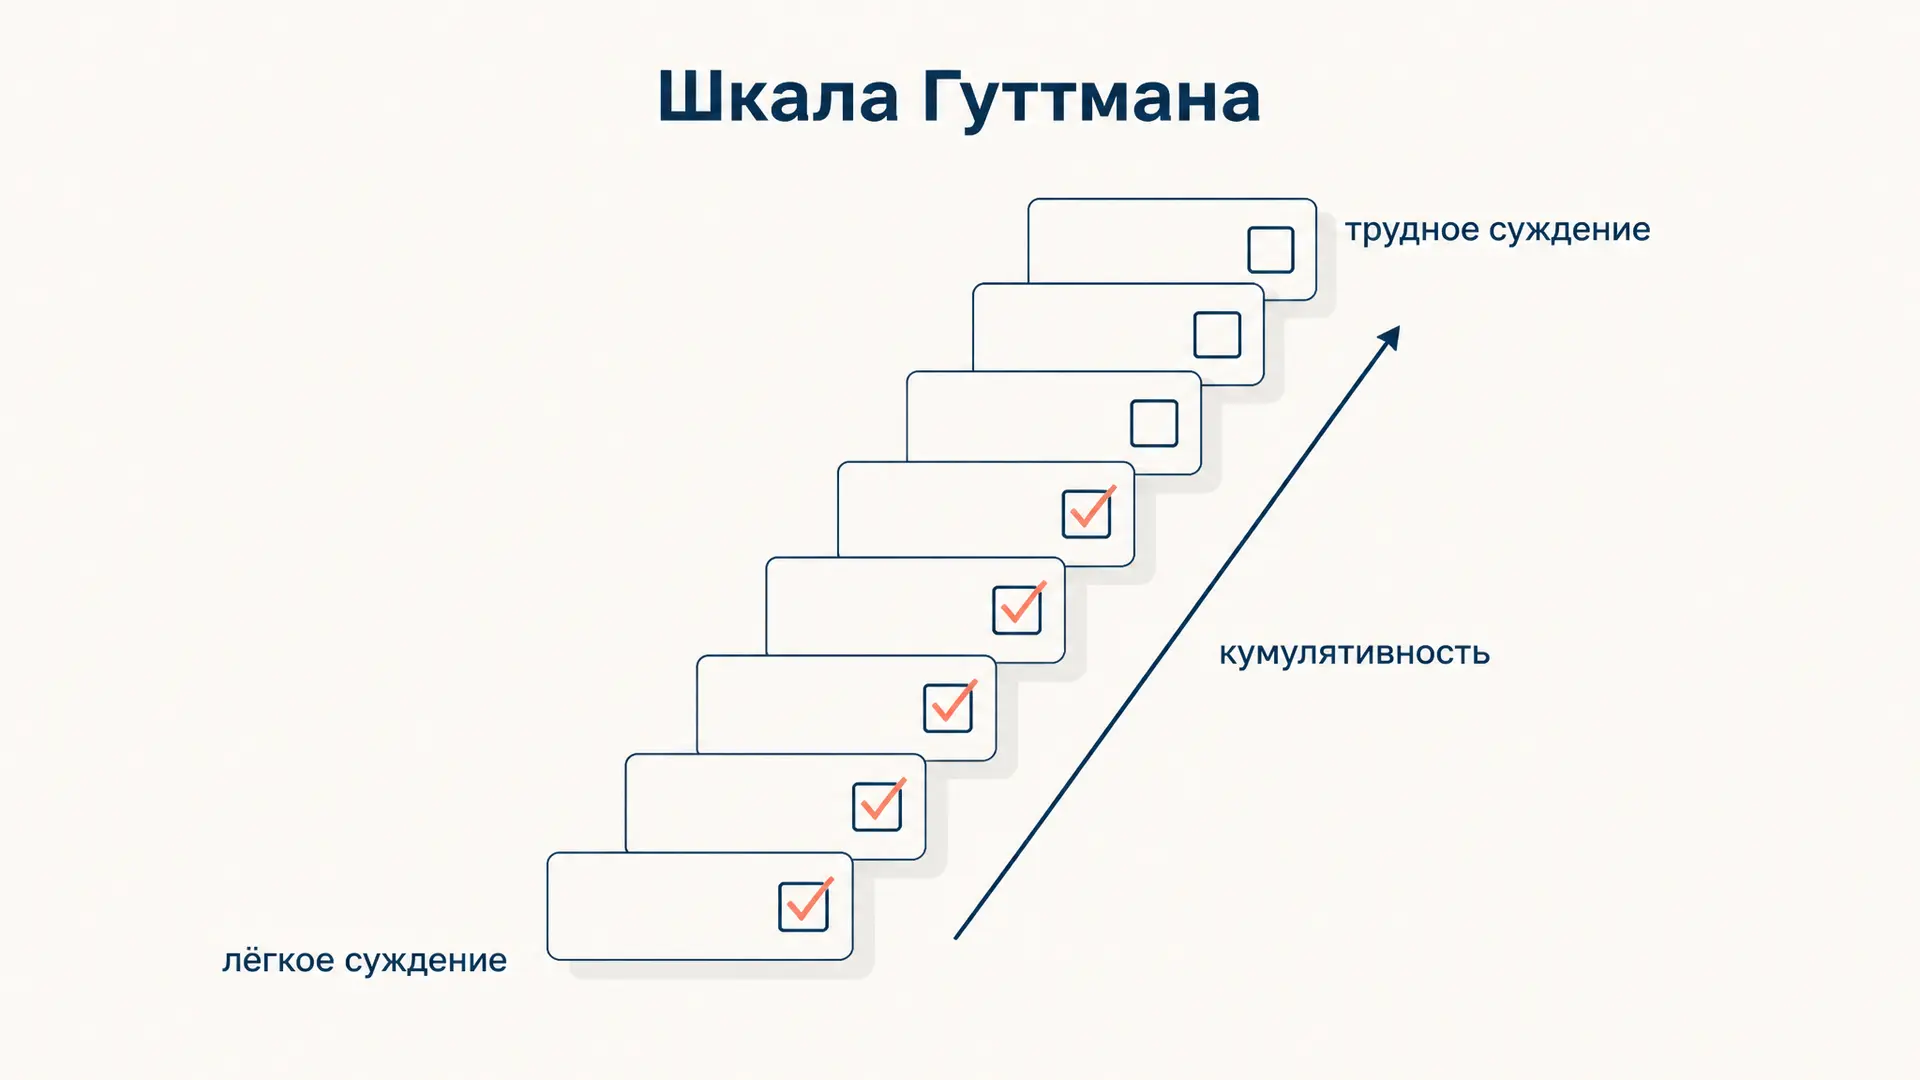
Шкала Гуттмана устроена как лестница: суждения выстроены от самого лёгкого к самому трудному, и человек, согласный с трудным, по модели согласен со всеми более лёгкими. Поэтому по одному числу, баллу респондента, можно восстановить весь его набор ответов. Но это обещание модели, а не свойство любой анкеты: кумулятивность нужно проверить на реальных данных. Проверку называют скалограммным анализом, и её итог сводится к двум коэффициентам. Посчитать их для своей таблицы можно в калькуляторе ниже, а дальше разберём, откуда они берутся.
Что такое шкала Гуттмана
Шкала Гуттмана, или кумулятивная шкала, это набор дихотомических суждений («да/нет», «согласен/не согласен»), упорядоченных по трудности. Трудность здесь означает, насколько сильно должно быть выражено свойство, чтобы человек ответил «да». Сказать «слежу за новостями города» легко почти любому, а «организовал местную инициативу» скажет только очень активный горожанин.
Из порядка следует ключевое понятие: идеальный профиль ответов. Если суждения пронумерованы от лёгкого к трудному, допустимы только профили вида «да на первые пунктов, нет на остальные». Для пяти суждений из возможных комбинаций модели соответствуют всего шесть: 00000, 10000, 11000, 11100, 11110 и 11111. Балл от 0 до 5 однозначно указывает, какие именно пункты приняты. В шкале Лайкерта сумма 3 может получиться десятком способов, здесь только одним.
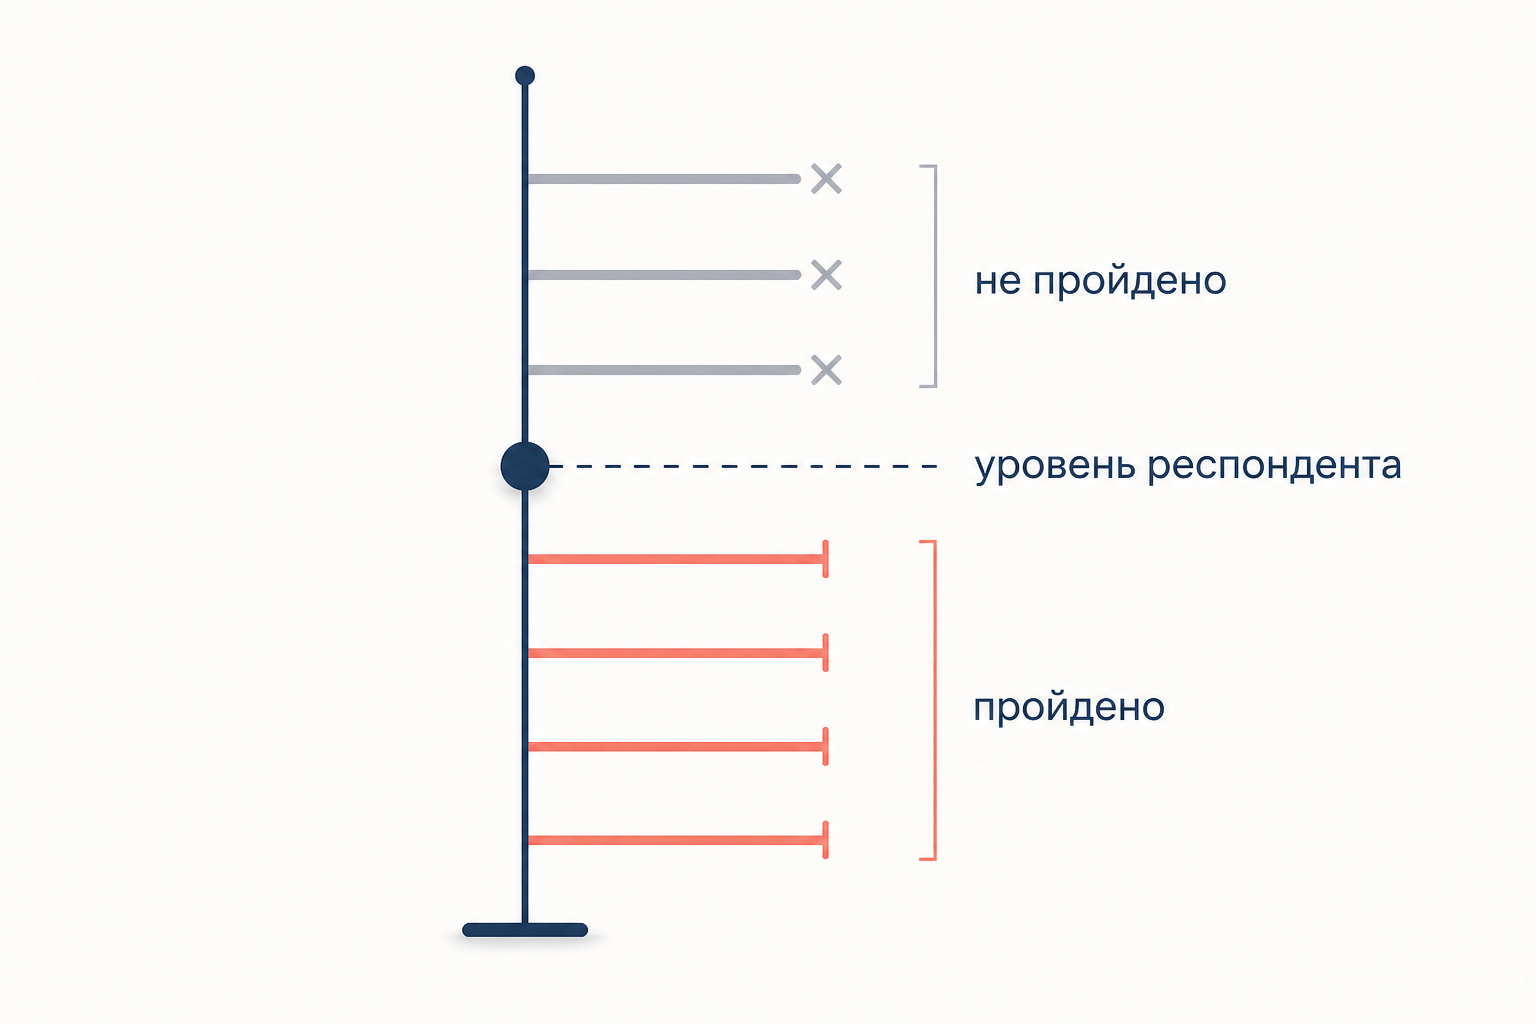
Удобная метафора: прыжок в высоту. У каждого суждения своя высота планки, у каждого респондента своя высота прыжка. Кто взял планку на 150 см, взял и все ниже. Этот же принцип заложен в шкалу социальной дистанции: подробный разбор её семи ступеней есть в статье про шкалу Богардуса, которую считают историческим прообразом гуттмановской конструкции.
Луис Гуттман и «Американский солдат»
Луис Гуттман (1916-1987), американский социолог и статистик, изложил идею в статье «A Basis for Scaling Qualitative Data» (American Sociological Review, 1944). Практическую проверку она прошла в годы Второй мировой войны в исследовательском отделе армии США, которым руководил Сэмюэл Стауффер. Отдел опросил сотни тысяч военнослужащих о боевом духе, страхе, отношении к службе и командирам. Итоги вышли в серии «Американский солдат» (The American Soldier, 1949-1950), а методологический том «Measurement and Prediction» (1950) почти целиком посвящён скалограммному анализу.
Задача была прикладной: военным нужны были короткие анкеты, по которым можно сравнивать подразделения. Гуттман предложил не складывать ответы механически, а сначала проверить, выстраиваются ли вопросы в одну лестницу. Классический пример из этих материалов: солдаты, сообщавшие о тяжёлых проявлениях страха в бою, почти всегда отмечали и более частые, лёгкие реакции вроде учащённого сердцебиения. Такой набор симптомов вёл себя как кумулятивная шкала.
Скалограммный анализ: как построить шкалу по шагам
Скалограммой называют таблицу «респонденты × суждения», переставленную так, чтобы проявилась лестница. Построение идёт в семь шагов.
- Определите одно измерение. Шкала Гуттмана одномерна по определению. Сначала понятие проходит операционализацию, и из его измерений выбирается одно.
- Составьте 8-12 суждений разной трудности. В итоговой шкале обычно остаётся 4-7 пунктов, поэтому кандидатов берут с запасом. Каждое суждение должно описывать ступень того же свойства.
- Дихотомизируйте ответы. Если вопрос с пятью вариантами, заранее решите, что считать «да» (например, «скорее согласен» и «полностью согласен»).
- Проведите пилотный опрос и занесите ответы в таблицу нулей и единиц.
- Упорядочите столбцы по числу ответов «да»: слева самое популярное суждение, справа самое редкое.
- Упорядочите строки по баллу респондента: сверху те, у кого больше всего «да».
- Посчитайте ошибки и коэффициенты, уберите пункты, которые дают больше всего ошибок, и пересчитайте.
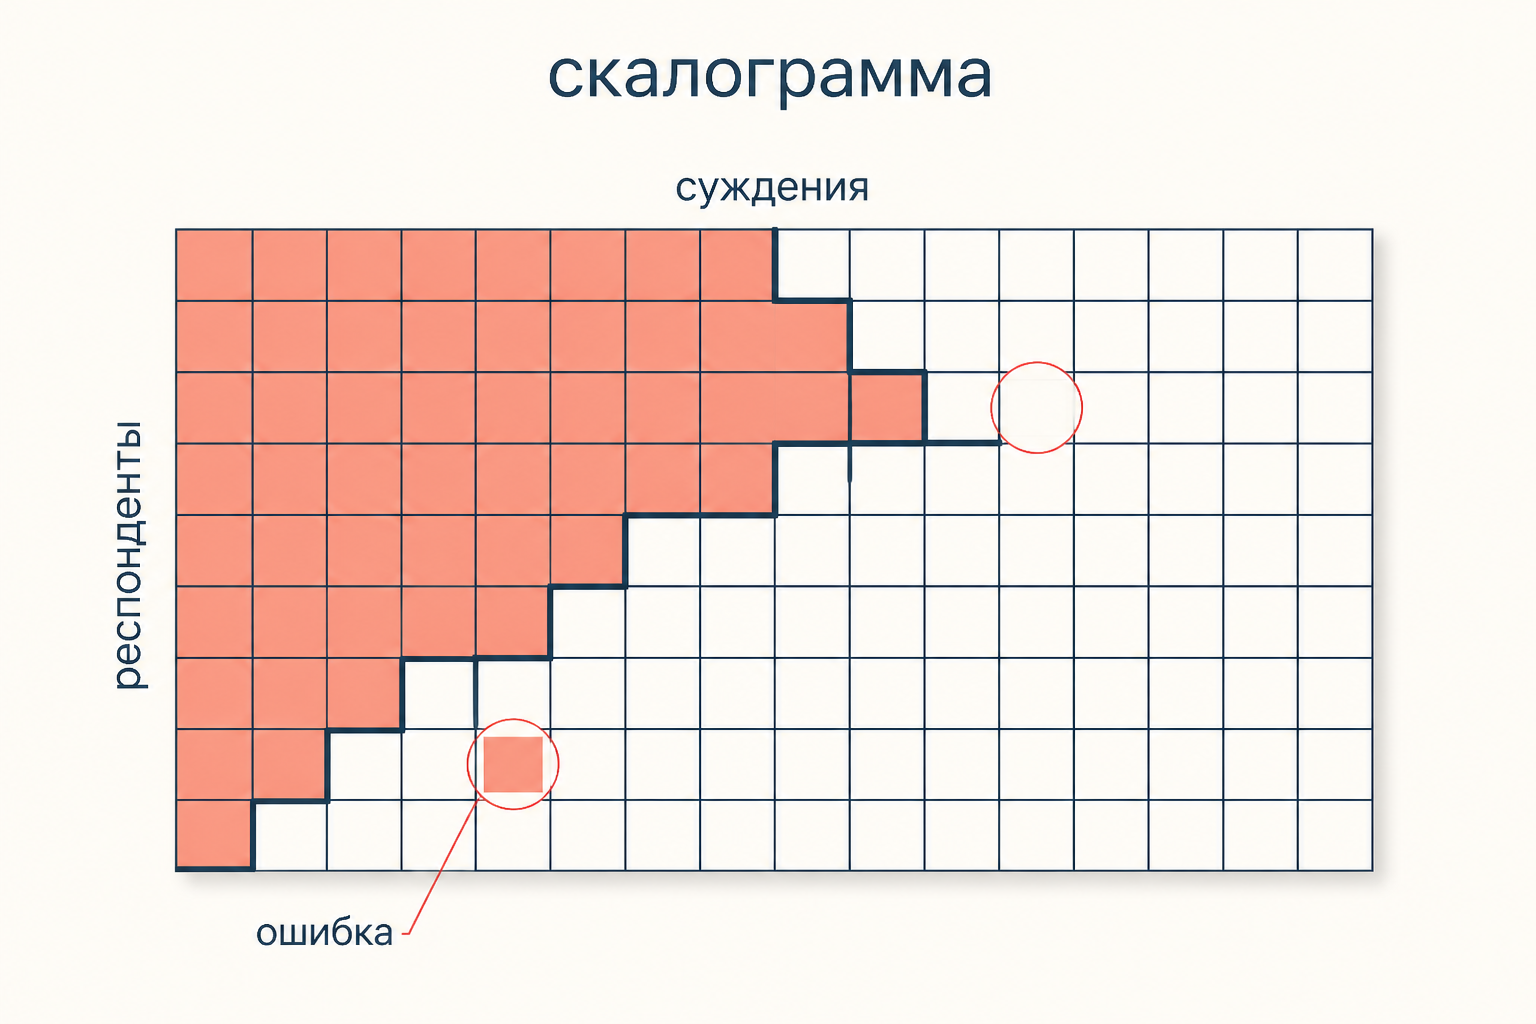
В идеальной скалограмме единицы образуют ровный треугольник-лестницу в левом верхнем углу. Каждая единица за границей лестницы и каждый ноль внутри неё означают отклонение от модели.
Сквозной пример: 5 суждений и 10 респондентов
Измеряем гражданскую активность студентов пятью суждениями, уже упорядоченными по трудности:
- А. Слежу за новостями своего города.
- Б. Подписывал(а) онлайн-петицию или коллективное обращение.
- В. Приходил(а) на собрание жильцов или публичные слушания.
- Г. Писал(а) обращение депутату или в администрацию.
- Д. Участвовал(а) в организации местной инициативы.
Ответы десяти респондентов после сортировки:
| Респондент | А | Б | В | Г | Д | Балл | Идеальный профиль | Ошибки |
|---|---|---|---|---|---|---|---|---|
| Р1 | 1 | 1 | 1 | 1 | 1 | 5 | 11111 | 0 |
| Р2 | 1 | 1 | 1 | 1 | 0 | 4 | 11110 | 0 |
| Р3 | 1 | 1 | 1 | 1 | 0 | 4 | 11110 | 0 |
| Р4 | 1 | 1 | 1 | 0 | 0 | 3 | 11100 | 0 |
| Р5 | 1 | 1 | 1 | 0 | 0 | 3 | 11100 | 0 |
| Р6 | 1 | 1 | 0 | 1 | 0 | 3 | 11100 | 2 |
| Р7 | 1 | 1 | 0 | 0 | 0 | 2 | 11000 | 0 |
| Р8 | 1 | 0 | 1 | 0 | 0 | 2 | 11000 | 2 |
| Р9 | 1 | 0 | 0 | 0 | 0 | 1 | 10000 | 0 |
| Р10 | 0 | 0 | 0 | 0 | 0 | 0 | 00000 | 0 |
| Ответов «да» | 9 | 7 | 6 | 4 | 1 | 4 |
Ошибки считаем по методу Гуденафа и Эдвардса: для каждого респондента берём идеальный профиль с тем же баллом и сравниваем клетку за клеткой. У Р6 балл 3, идеал 11100, а фактически 11010: расходятся столбцы В и Г, две ошибки. У Р8 балл 2, идеал 11000, фактически 10100: расходятся Б и В, тоже две. Остальные восемь профилей идеальны. Всего ошибки на ответов.
Коэффициент воспроизводимости: формула и порог 0,90
Коэффициент воспроизводимости показывает, какую долю ответов можно точно восстановить по баллу респондента:
где - число ошибок, - число респондентов, - число суждений. Для примера:
Гуттман предложил считать набор шкалой при , то есть когда не больше 10% ответов расходятся с моделью. Наш результат 0,92 проходит порог с небольшим запасом: при 50 ответах допустимо не больше 5 ошибок, а шестая уже опустила бы до 0,88.
Способ подсчёта ошибок надо указывать в работе. В исходном варианте Гуттмана ошибкой считают минимальное число клеток, которые надо исправить, чтобы профиль стал идеальным. Тогда у Р6 и Р8 будет по одной ошибке, E = 2 и CR = 0,96. Метод Гуденафа и Эдвардса строже, он засчитывает каждую перестановку как две ошибки.
Коэффициент масштабируемости: защита от лёгких пунктов
У есть слабость: он завышается, если суждения слишком лёгкие или слишком трудные. Пункт, с которым согласны 9 из 10, почти не может дать много ошибок, даже если ответы на него случайны. Чтобы отделить заслугу шкалы от заслуги маргиналов, Херберт Мензель в 1953 году предложил коэффициент масштабируемости.
Сначала считают минимальную маргинальную воспроизводимость: сколько ответов угадал бы тот, кто по каждому пункту ставит самый частый ответ:
где - число ответов «да» на суждение . В примере по столбцам: , , , , . Сумма 37, значит . Затем:
Принятый порог около 0,60, так что шкала проходит и вторую проверку. Но картина скромнее, чем показывал : из 92% воспроизведённых ответов 74% дали бы одни маргиналы, сама лестница добавляет меньше. Если бы пункты А и Д заменили на суждения средней трудности, снизился бы, и та же доля ошибок сказалась бы на сильнее.
Ограничения и связь с моделью Раша
У шкалы Гуттмана четыре известных ограничения:
- Одномерность. Если суждения задевают два свойства (например, активность и доверие к властям), лестница рассыпается.
- Детерминизм. Модель не допускает случайности: любой сбой в ответах считается ошибкой, хотя реальные люди отвечают с шумом.
- Мало пунктов. С ростом числа суждений ошибки накапливаются, поэтому рабочие шкалы редко длиннее 7-8 пунктов, а короткую шкалу трудно сделать чувствительной.
- Зависимость от выборки. Лестница, найденная у студентов, может не воспроизвестись у пенсионеров: порядок трудности пунктов не гарантирован для другой совокупности.
Ответом на детерминизм стали вероятностные модели. В модели Раша (1960) вероятность ответа «да» плавно зависит от разницы между уровнем респондента и трудностью суждения :
Шкала Гуттмана получается из неё как предельный случай, когда кривая превращается в ступеньку: при ответ «да» с вероятностью 1, иначе «нет». Непараметрическую версию той же идеи даёт шкалирование Мокена с коэффициентом Левинджер . Для курсовой обычно достаточно классического и , но упомянуть вероятностные модели в разделе об ограничениях полезно.
Частые ошибки
- Называть шкалой Гуттмана любой набор вопросов с суммарным баллом. Без скалограммы и это просто индекс; различие подробно разобрано в статье про социологический индекс.
- Приводить без . Высокая воспроизводимость на очень лёгких и очень трудных пунктах почти ничего не доказывает.
- Не указывать способ подсчёта ошибок. По Гуттману и по Гуденафу и Эдвардсу одна таблица даёт разные .
- Упорядочивать суждения по замыслу автора, а не по фактическим долям «да» в данных.
- Проверять шкалу на 10-20 анкетах и переносить вывод на генеральную совокупность. Учебный пример иллюстрирует расчёт, для реальной шкалы нужна выборка в сотни человек.
FAQ
Чем шкала Гуттмана отличается от шкалы Лайкерта?
Лайкерт суммирует степень согласия с независимыми утверждениями, и одинаковый балл может получиться из разных ответов. У Гуттмана пункты образуют лестницу, и балл однозначно задаёт профиль. Поэтому для Лайкерта проверяют внутреннюю согласованность, а для Гуттмана воспроизводимость порядка.
Сколько суждений нужно для шкалы Гуттмана?
В итоговой шкале обычно 4-7 суждений. На этапе пилота берут 8-12 кандидатов и отсеивают те, что дают больше всего ошибок. Меньше четырёх пунктов делают почти автоматически высоким, больше восьми редко удаётся удержать в одной лестнице. Требования к формулировкам пунктов общие для любой анкеты, их удобно сверить с правилами анкетирования.
Что делать, если CR ниже 0,90?
Найдите суждения, на которые приходится больше всего ошибок, и проверьте формулировки: двусмысленный пункт или пункт про другое свойство ломает лестницу. Удалите или перепишите его и пересчитайте. Если после чистки всё равно ниже порога, набор честнее описывать как индекс.
Коротко
Шкала Гуттмана это кумулятивный набор суждений, упорядоченных по трудности, где балл респондента однозначно восстанавливает его ответы. Идею Луис Гуттман развил в 1940-е годы в проекте «Американский солдат» под руководством Стауффера. Проверка идёт через скалограмму: столбцы сортируют по доле «да», строки по баллу, считают отклонения от идеальных профилей. Коэффициент воспроизводимости должен быть не ниже 0,90, коэффициент масштабируемости не ниже 0,60; в нашем примере с 4 ошибками на 50 ответов вышло 0,92 и 0,69. Ограничения модели (одномерность, детерминизм, короткие шкалы) снимают вероятностные подходы вроде модели Раша.
Читайте также
Метод фокус-групп: как провести исследование
Метод фокус-групп в социологии и маркетинге: состав участников, роль модератора, гайд беседы, запись и тематический анализ. Отличия от интервью, ошибки и пример исследования.
Социологический эксперимент: метод и дизайн
Социологический эксперимент: как устроены гипотеза, группы и воздействие, чем отличаются лабораторный, полевой и естественный дизайн, как оценить валидность и этику.
Контент-анализ в социологии: от категорий до каппы Коэна
Контент-анализ в социологии по шагам: определение Берельсона, единицы анализа и счёта, кодировочный бланк, качественный вариант и проверка надёжности через каппу Коэна.
Анкетирование: правила составления анкеты
Анкетирование и правила составления анкеты: структура из трёх частей, типы вопросов, правило воронки, шкалы Лайкерта и семантического дифференциала, пилотаж и разбор типичных ошибок формулировок.
Квотная выборка: как построить квотное задание
Квотная выборка: как выбрать признаки и рассчитать ячейки квотного задания, чем маргинальные квоты отличаются от связанных, почему это неслучайный отбор и какие смещения он даёт.
Панельное исследование: одни и те же люди по волнам
Панельное исследование в социологии: чем отличается от трендового и когортного, как устроены волны и панельная матрица, что такое истощение панели и панельный эффект, как описать дизайн.