Корреляционная таблица: построение и расчёт
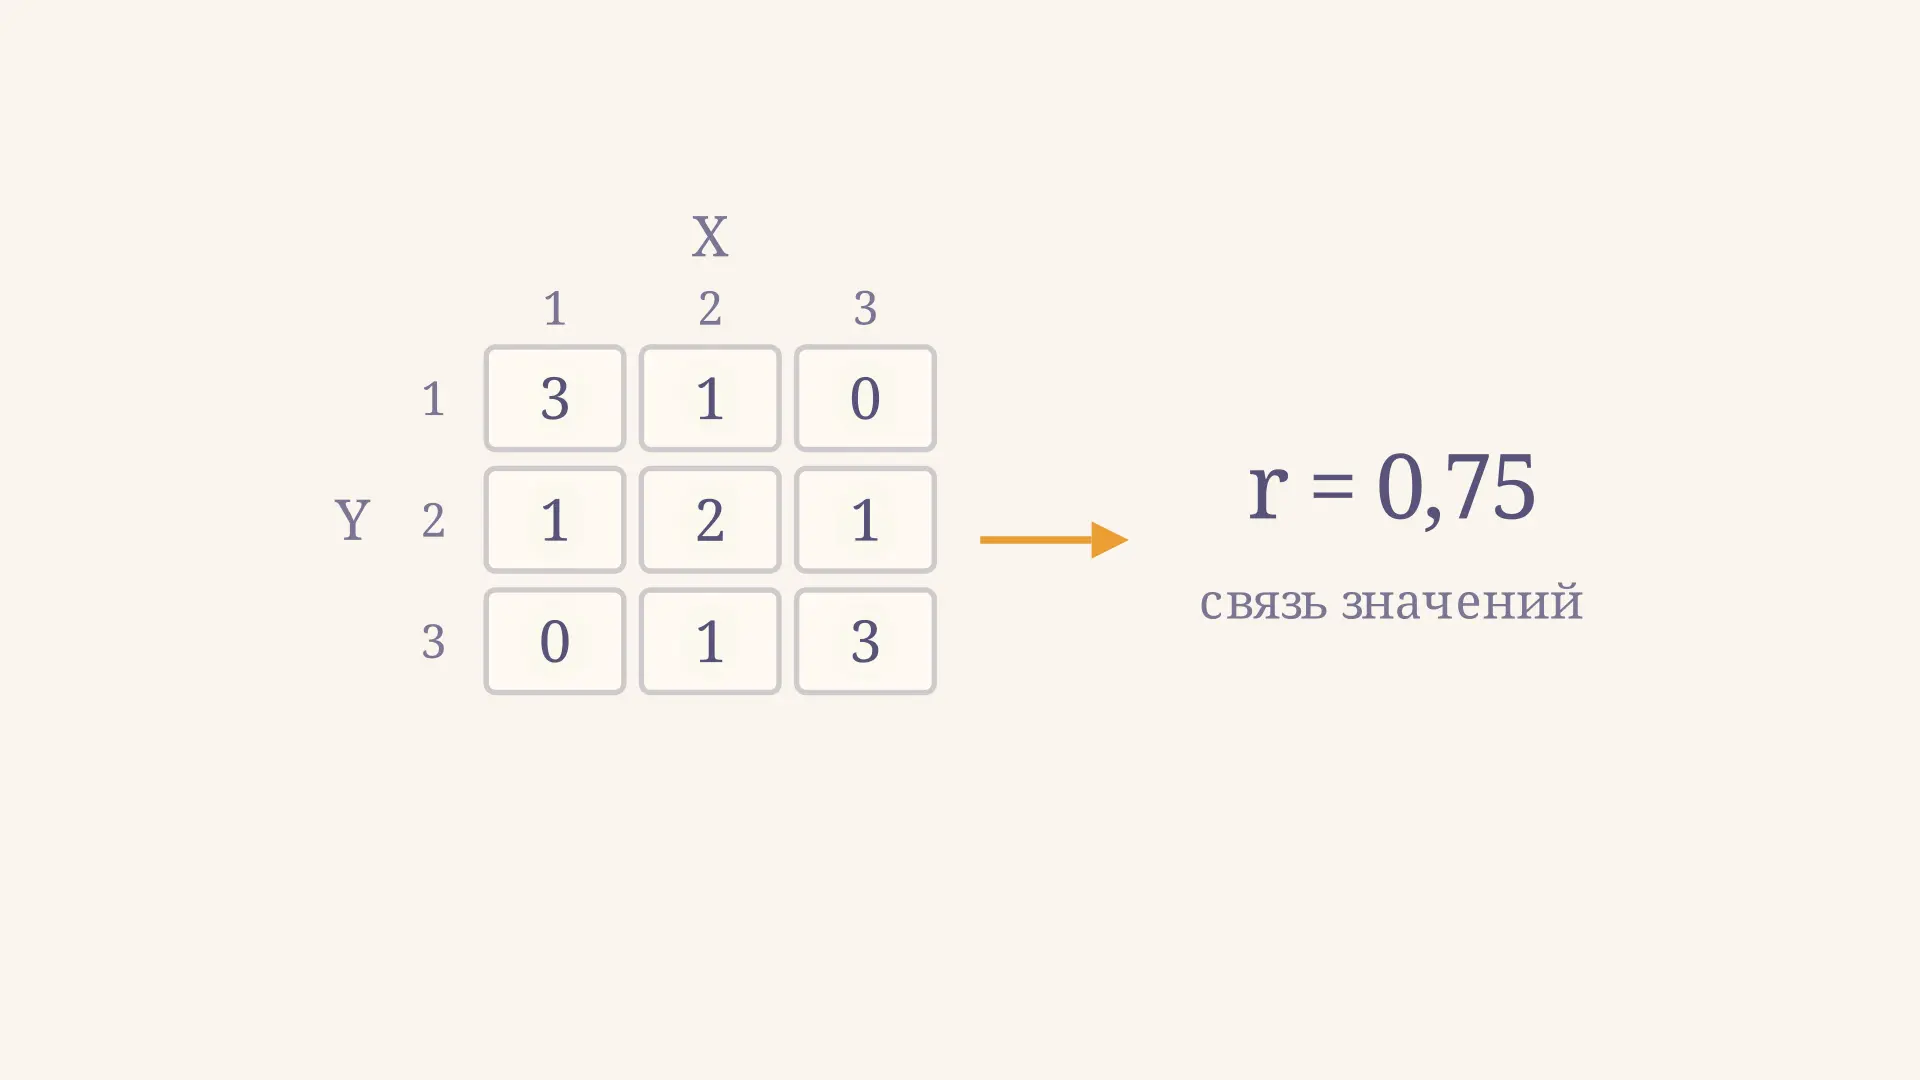
Корреляционная таблица показывает, как совместно распределены два признака: например, объём рекламы и продажи в нескольких магазинах. В каждой ячейке стоит число наблюдений с заданной парой значений. По таблице удобно проверить структуру данных, найти средние и оценить линейную связь. Попробуйте изменить одну частоту в калькуляторе: число наблюдений и коэффициент пересчитаются вместе.
Что показывает корреляционная таблица
Пусть у каждого объекта измерены два числовых признака и . Столбцам соответствуют значения , строкам - значения . Частота показывает, сколько объектов одновременно имеют значение и значение . Это совместная частота: один и тот же объект попадает ровно в одну ячейку, если группы заданы без пересечений и покрывают все наблюдения.
Сумма частот в строке показывает распределение по независимо от , а сумма в столбце - распределение по независимо от . Их называют маргинальными частотами. Сложив все ячейки, получим объём выборки . Подробное описание совместных и маргинальных распределений есть в материале Университета штата Пенсильвания.
Термин иногда используют и для матрицы корреляций, где строки и столбцы - названия признаков, а ячейки - уже рассчитанные коэффициенты. Такая матрица решает другую задачу: она сравнивает несколько пар признаков. Здесь строим именно таблицу частот для двух признаков и затем вычисляем коэффициент по ней.
Учебный пример: продажи и реклама
Рассмотрим вымышленные данные 12 магазинов. Пусть - расходы на рекламу в условных единицах, а - продажи в условных единицах. Оба признака принимают точные значения 1, 2 или 3; это не реальные наблюдения и не интервальные середины.
| Продажи / реклама | 1 | 2 | 3 | Сумма строки |
|---|---|---|---|---|
| 1 | 3 | 1 | 0 | 4 |
| 2 | 1 | 2 | 1 | 4 |
| 3 | 0 | 1 | 3 | 4 |
| Сумма столбца | 4 | 4 | 4 | 12 |
Например, число 3 в верхней левой ячейке означает, что у трёх магазинов и реклама, и продажи равны 1. В верхней правой ячейке стоит ноль: в нашей выборке нет магазина с рекламой 3 и продажами 1. Ноль - это наблюдённая частота, а не пропуск в данных.
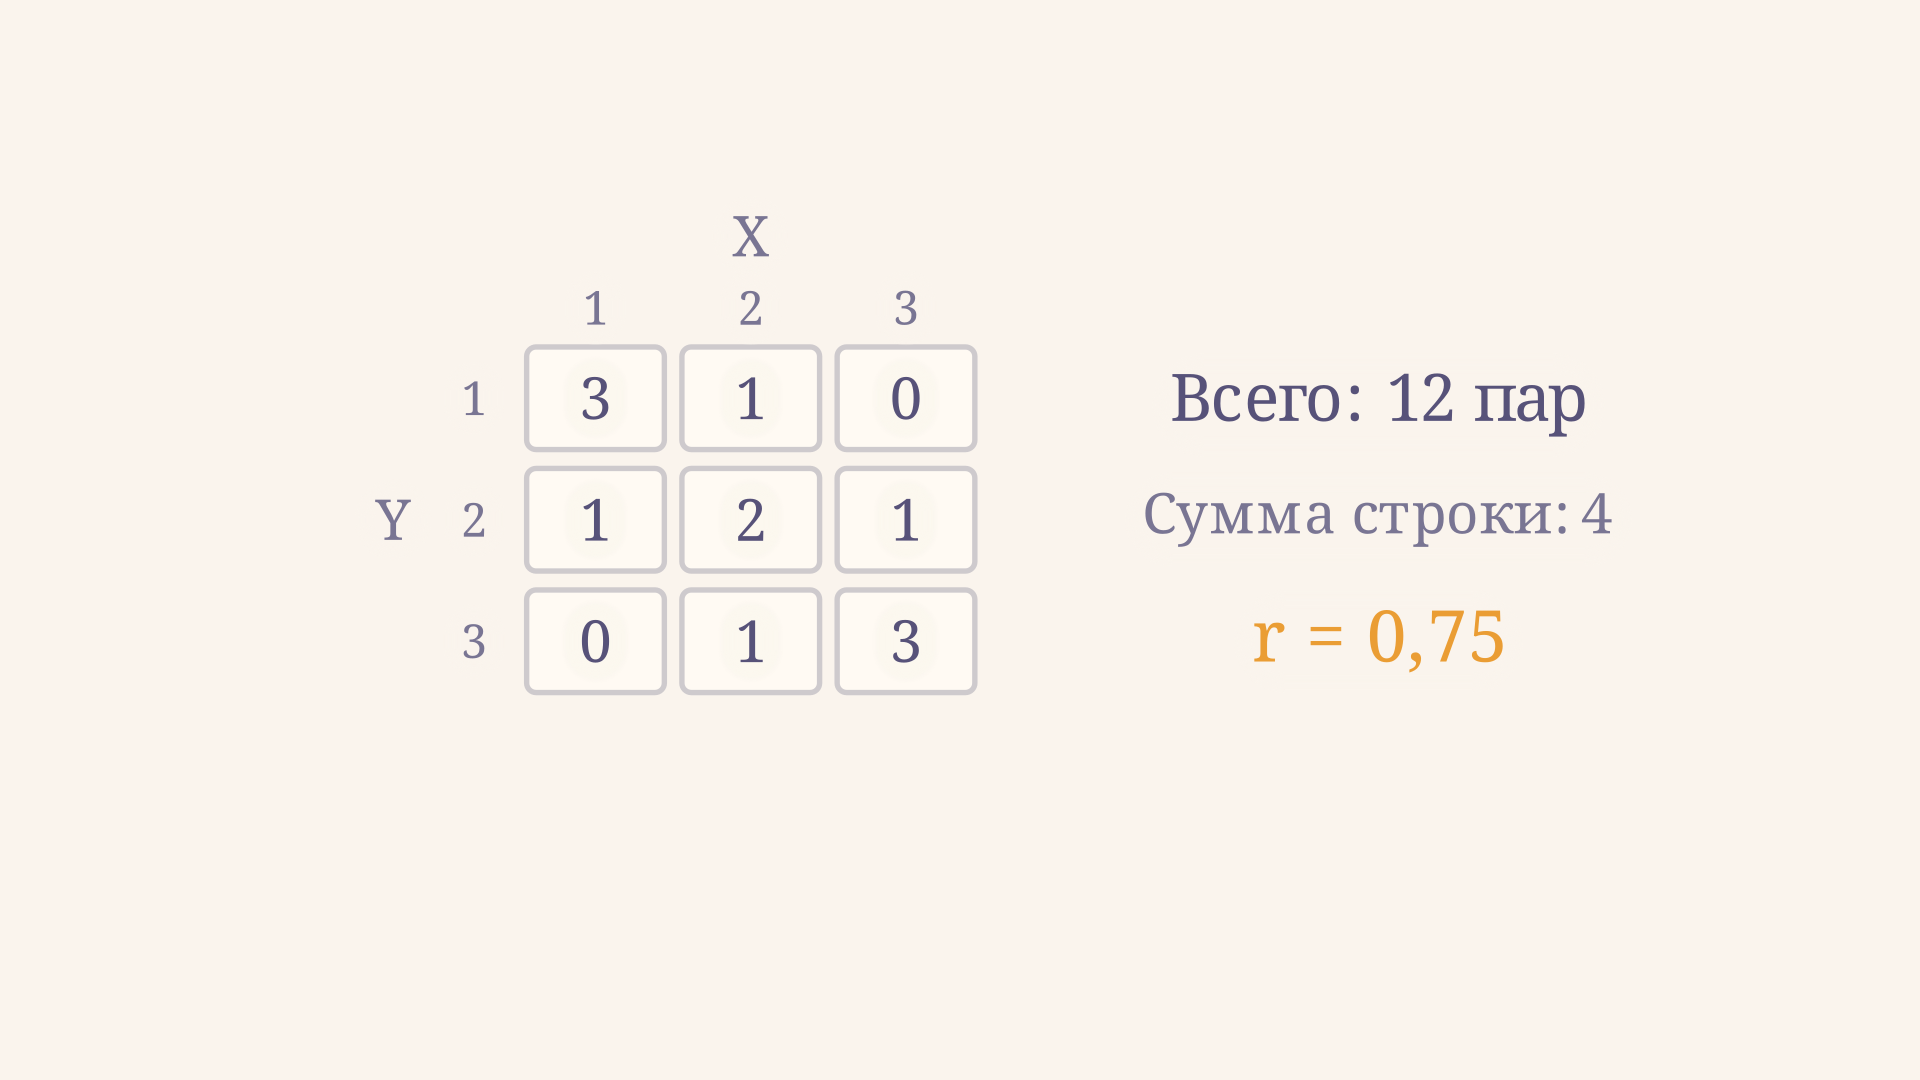
По диагонали от малых к большим значениям сосредоточено восемь наблюдений из 12: . Это подсказывает положительную связь, но диагональ сама по себе не заменяет расчёт. В таблице с другими масштабами или неодинаковыми группами визуальное впечатление может быть обманчивым.
Как построить таблицу по исходным данным
- Подготовьте пары для одних и тех же объектов и периода. Несопоставимые данные, например продажи одного магазина и реклама другого, не образуют корректной пары.
- Запишите возможные значения в заголовках столбцов, а значения - в строках. Для большого числа различных значений можно заранее задать интервалы.
- Для каждой пары увеличьте частоту на пересечении нужных строки и столбца на единицу. При интервальной группировке заранее определите границы: например, левый край включается, правый нет, кроме последнего интервала.
- Сложите строки и столбцы. Обе суммы итогов должны совпасть с количеством использованных пар. Отдельно укажите, сколько записей исключено из-за пропусков.
Проверка суммы ловит потерянные и посчитанные дважды наблюдения, но не гарантирует правильность каждой ячейки. Полезно дополнительно сверить несколько исходных пар с таблицей и подписать единицы измерения. Если в одном магазине несколько месяцев данных, сначала решите, считается ли наблюдением магазин или месяц магазина: от этого зависит смысл и последующий анализ.
Предположим, таблицу строят по отчётам магазинов за один квартал. Прежде чем подсчитывать частоты, стоит привести суммы к одной валюте и убедиться, что реклама и продажи относятся к одному кварталу. Если данные относятся к разным периодам, связь может отражать задержку реакции или сезонный сдвиг. Это уже другая постановка: лаг нужно определить заранее и явно описать.
При работе в электронной таблице удобно сначала вывести список пар, затем создать сводную таблицу с подсчётом строк. После этого сравните общий итог с числом записей без пропусков. Проверьте также, не попала ли одна и та же запись в исходный файл дважды: арифметически верная сумма не обнаружит такую ошибку.
Средние по строкам и столбцам
Среднее признака - это взвешенная сумма значений, где весом служит соответствующая маргинальная частота. Обозначим сумму столбца через , а сумму строки через . Тогда
В учебной таблице все три суммы столбцов и все три суммы строк равны 4. Поэтому и точно так же . У этих сумм разный смысл: первая сворачивает таблицу по строкам, вторая - по столбцам. Использовать частоту ячейки как сумму целого столбца нельзя.
Маргинальные распределения не сохраняют всю информацию о связи. Например, можно переставить частоты внутри таблицы так, чтобы итог каждой строки и каждого столбца остался прежним, но совпадение больших значений с большими стало реже. Средние при этом не изменятся, а корреляция изменится. Именно поэтому нужны совместные частоты.
Расчёт коэффициента по частотам
Для числовых значений вычислим выборочный коэффициент корреляции Пирсона, учитывая, что каждая пара встречается раз:
В нашем примере сумма произведений отклонений равна 6: три пары дают вклад 3, три пары дают ещё 3, а остальные вклады равны нулю. Каждая сумма квадратов отклонений равна 8. Следовательно, . Если развернуть таблицу обратно в 12 отдельных пар и применить обычную формулу, результат будет тем же.
Знак плюс указывает на преобладание совместного роста в этой выборке; значение 0,75 характеризует линейную связь. Оно не означает, что реклама вызвала рост продаж. Для исследования причины понадобятся дизайн исследования, учёт других факторов и предметные знания. NIST отдельно подчёркивает, что наблюдаемая связь сама по себе не доказывает причинность.
Интервалы и точность результата
Если точные значения заменены интервалами, для приближённого расчёта часто используют их середины как представители групп. Тогда каждая частота получает координаты центра своей ячейки. Например, для диапазона от 10 до 20 берут 15, хотя отдельные наблюдения внутри него могут быть другими. Полученный коэффициент относится к сгруппированному приближению и может отличаться от расчёта по исходным парам.
Чем шире группы, тем больше деталей скрыто. Открытый интервал вроде «100 и более» не имеет определённой середины: её нельзя подставить без дополнительного допущения. Для сравнения результатов сохраняйте одинаковые границы групп и по возможности рассчитывайте по исходным данным, а таблицу используйте для обзора. Если один признак постоянен, знаменатель формулы равен нулю и коэффициент не определён.
Группировку стоит выбирать до просмотра желаемого результата. Слишком мелкая сетка создаёт много пустых ячеек и затрудняет чтение, слишком крупная объединяет заметно разные значения. Покажите границы интервалов вместе с таблицей и сохраните правило включения крайних значений: тогда другой исследователь сможет воспроизвести распределение и сравнить его со своим.
При оценке неопределённости одного значения коэффициента недостаточно: важны размер и способ отбора выборки, независимость наблюдений и предпосылки выбранного метода. Небольшая учебная таблица показывает арифметику, но не позволяет без дополнительного обоснования переносить вывод на все магазины.
Как читать результат и что проверить дальше
Значение около нуля означает отсутствие выраженной линейной связи в выбранной мере, но не доказывает независимость или отсутствие криволинейной зависимости. Постройте диаграмму рассеяния по исходным парам: она поможет заметить выбросы, отдельные группы и нелинейную форму. Корреляция чувствительна к составу выборки и может измениться после добавления нескольких наблюдений.
Для порядковых данных или монотонной связи может пригодиться ранговая корреляция Спирмена. Если важно учесть третий количественный признак, изучите частный коэффициент корреляции. При анализе нескольких факторов рядом с результатом можно рассмотреть множественный коэффициент корреляции. Выбор метода зависит от вопроса и природы данных, а не только от величины полученного числа.
Частые ошибки
- Путают частоту и коэффициент. Число в ячейке нашей таблицы - количество объектов, а не сила связи.
- Не проверяют итоги. Суммы строк и столбцов должны давать одно и то же число использованных пар.
- Принимают групповые середины за исходные значения. При интервальной группировке расчёт по центрам обычно приближённый.
- Делают причинный вывод по знаку . Общий фактор, сезонность или способ отбора могут влиять на оба признака.
- Игнорируют структуру наблюдений. Повторные измерения одного объекта не всегда можно считать независимыми при проверке статистической значимости.
FAQ
Чем корреляционная таблица отличается от таблицы сопряжённости?
Обе могут содержать совместные частоты. Таблица сопряжённости особенно распространена для категориальных признаков; для неё не следует автоматически вычислять Пирсона по произвольным числовым кодам категорий.
Можно ли посчитать корреляцию, если есть только суммы строк и столбцов?
Нет: маргинальные суммы не показывают, какие значения и встретились вместе. Нужны ячейки совместных частот или исходные пары.
Почему коэффициент изменился после группировки?
Замена значений центрами интервалов теряет различия внутри групп. Кроме того, результат зависит от границ и числа интервалов; сравните его с расчётом по исходным данным, если они доступны.
Коротко
Корреляционная таблица частот связывает значения двух признаков через число наблюдений в каждой ячейке. Сначала проверьте итоги и средние, затем рассчитайте подходящую меру связи и укажите, использованы точные значения или интервальные приближения. В учебном примере 12 пар дают , но этот результат сам по себе не устанавливает причину связи.
Читайте также
Дисперсия интервального вариационного ряда: расчёт
Как найти дисперсию интервального вариационного ряда по серединам и частотам: подробная таблица, две формулы, исправленная оценка и ограничения группировки.
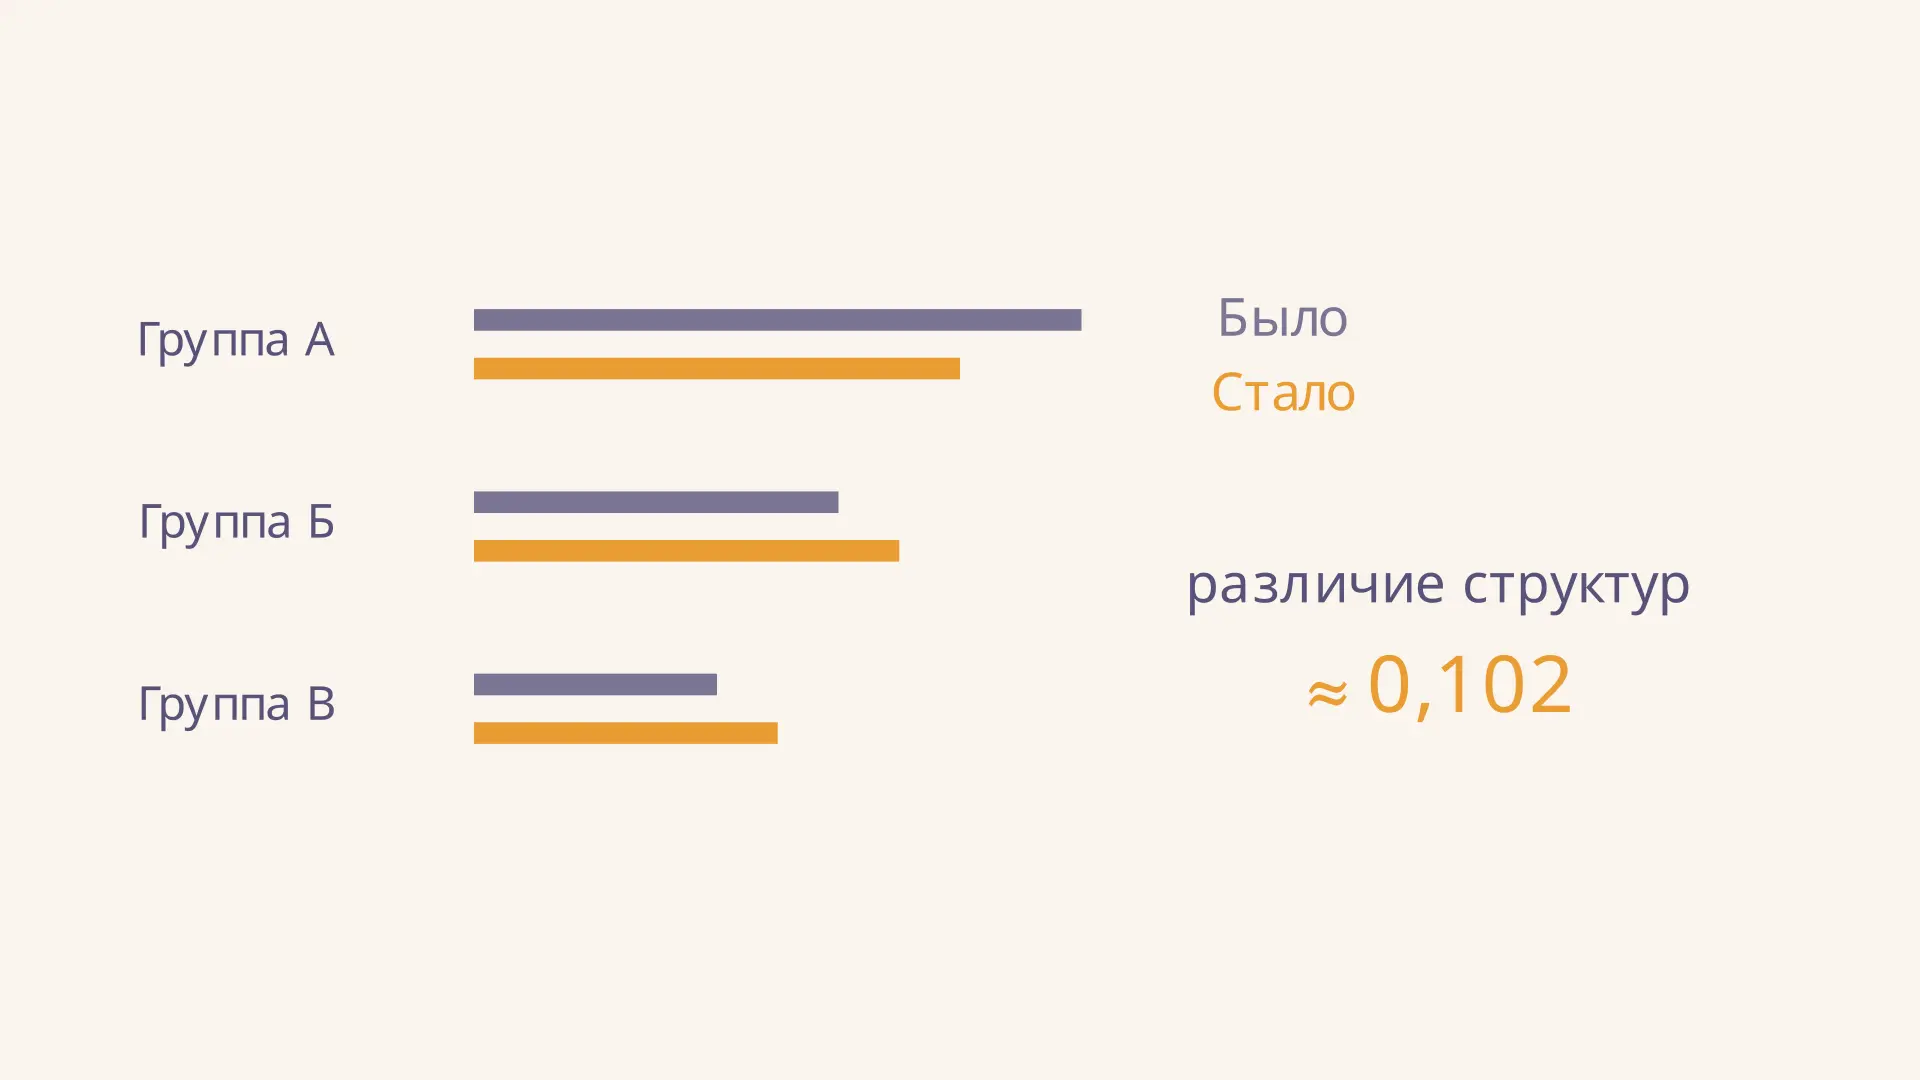
Индекс Рябцева: формула и расчёт структурных различий
Индекс Рябцева измеряет различие двух структур. Разбираем формулу, пошаговый расчёт по долям, шкалу интерпретации и ограничения метода на наглядном примере.
Коэффициент изобретательской активности: расчёт
Коэффициент изобретательской активности: формула числа патентных заявок на 10 тысяч жителей, пример расчёта, сравнение регионов и ограничения показателя.
Относительная величина интенсивности: формула и примеры
Относительная величина интенсивности показывает распространённость явления в среде. Разбираем формулу, единицы измерения и сравнение регионов на примерах.
Относительная величина координации: формула и пример
Относительная величина координации сравнивает части одной совокупности. Разбираем формулу, выбор базы, обратное отношение и отличие от доли на примерах.
Относительная величина планового задания: формула
Как рассчитать относительную величину планового задания, отличить её от выполнения плана и динамики, перевести в плановый прирост и решить типовые задачи.