Уровень значимости и критическая область
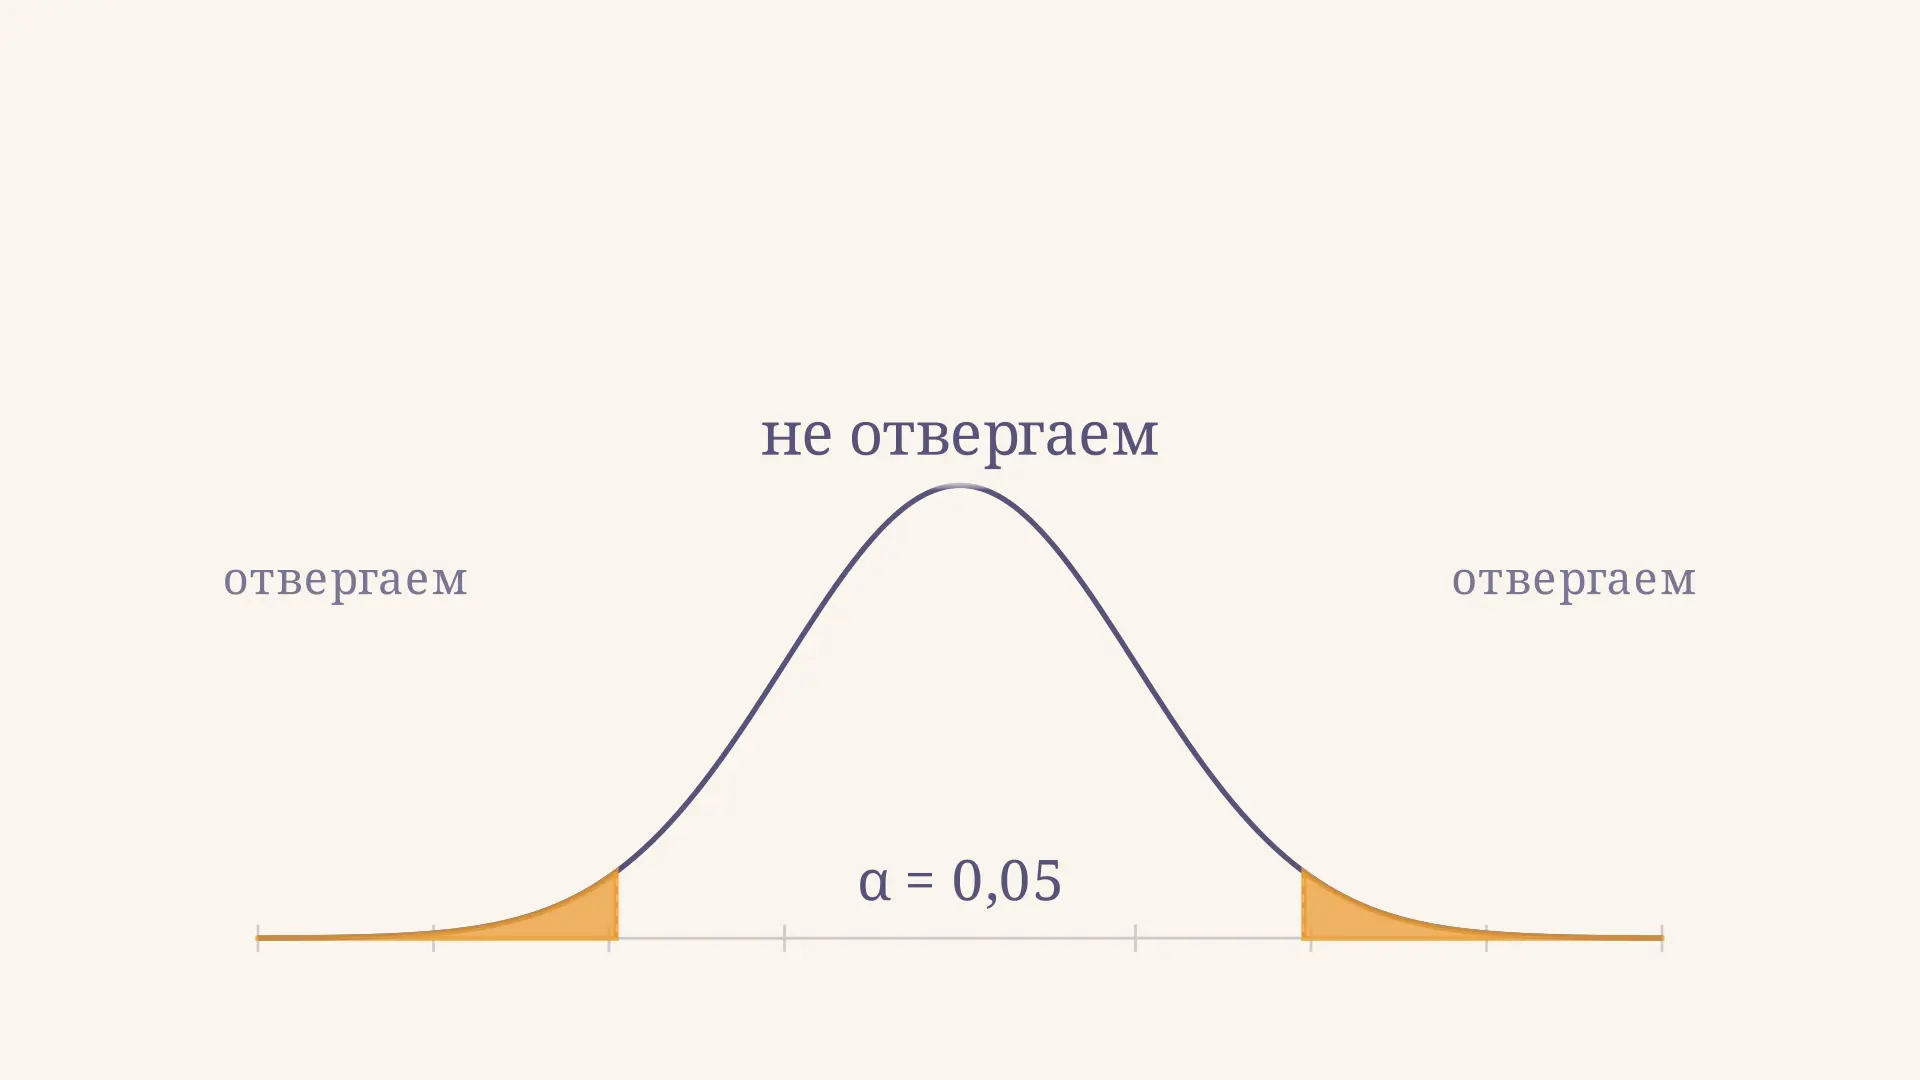
Уровень значимости задаёт допустимую вероятность ошибочно отклонить нулевую гипотезу при выполнении предпосылок теста. Критическая область - это множество значений статистики, при попадании в которое нулевую гипотезу отклоняют. Связь между ними видна на распределении статистики при : границы области выбирают так, чтобы вероятность попасть в неё при верной не превышала .
Калькулятор показывает эту связь для двустороннего Z-критерия. Меняйте уровень и наблюдаемое значение: границы сдвигаются, а решение зависит от положения точки. Ниже разберём, откуда берутся границы и что именно означает вывод.
Зачем нужна критическая область
Пусть исследователь сравнивает среднее измерений с заданным значением . Даже при точном равенстве выборочное среднее обычно немного отличается от : состав выборки случаен. Поэтому сам факт отличия ещё не говорит, что исходное предположение следует отвергнуть.
Сначала формулируют нулевую и альтернативную гипотезы, затем выбирают статистику и изучают её распределение при . Критическая область выделяет результаты, достаточно необычные при этой модели в направлении альтернативы. Правило принимают до просмотра результата: если попала в область, отклоняют; иначе оснований для отклонения недостаточно.
На видео распределение при остаётся прежним. Меняется правило решения: чем больше разрешённая вероятность ложного отклонения, тем больше доля распределения, отведённая критической области. Отдельная наблюдаемая точка для этого объяснения не нужна.
Что означает уровень значимости
Ошибка I рода - отклонение верной нулевой гипотезы. Уровень - заранее выбранная верхняя граница вероятности такой ошибки в повторениях процедуры при выполнении и остальных предпосылок модели. В простом непрерывном примере вероятность равна точно; для некоторых дискретных тестов она может быть меньше. Для составной нулевой гипотезы контроль обычно формулируют для всех допустимых при ней значений параметра.
Так, при корректная процедура ошибочно отклоняет верную не более чем в 5 % повторений при тех же условиях. Это не вероятность того, что именно данная гипотеза истинна или ложна. Вероятность относится к случайности данных и правилу тестирования, а не к неизвестной истинности гипотезы после наблюдения. Порог выбирают с учётом последствий ошибки и плана исследования; значения 0,05 и 0,01 распространены, но не являются универсальными законами. NIST связывает выбор уровня с критическими значениями и p-значением.
Как найти критические значения
Критические значения - границы области отклонения. Их находят по распределению статистики при , выбранному и направлению альтернативы. Для иллюстрации возьмём при и обозначим функцию распределения через .
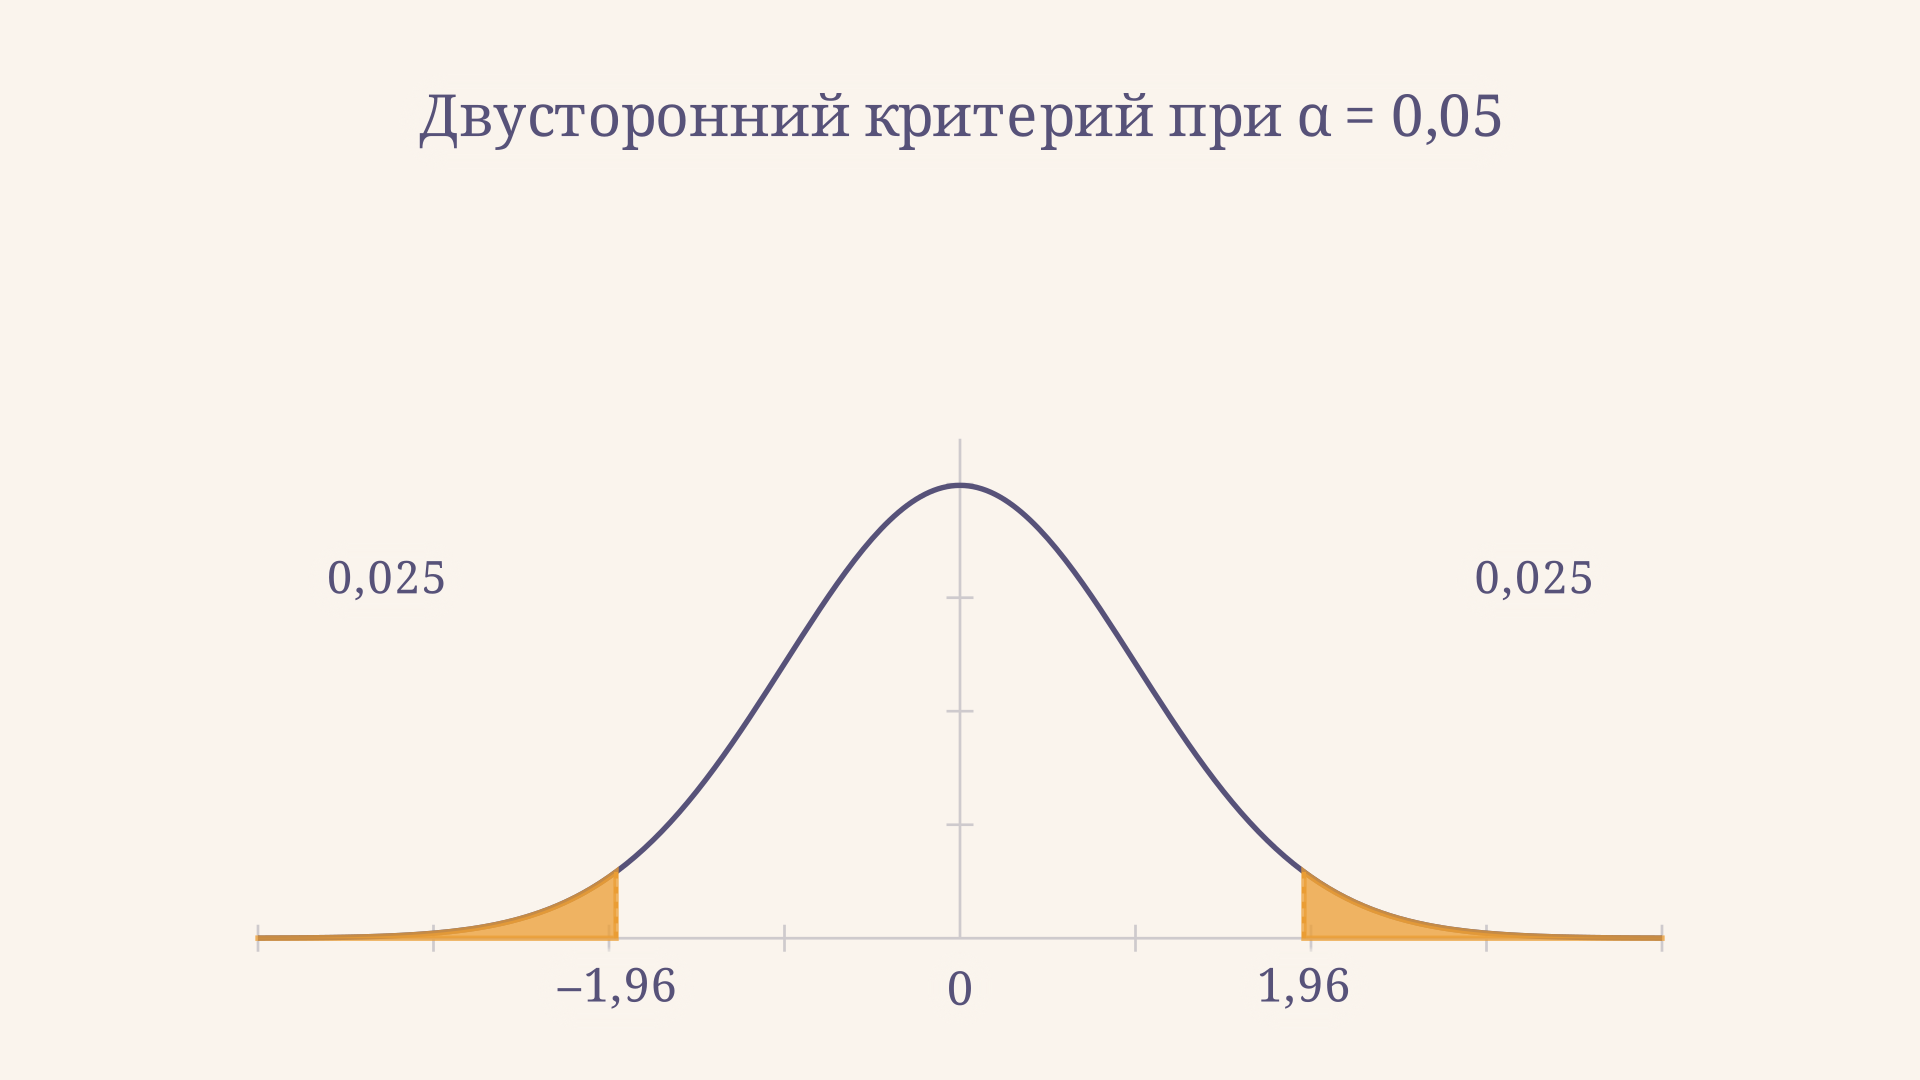
При правосторонней альтернативе критическая область находится справа: , где . При левосторонней она расположена слева: . При двусторонней альтернативе одинаково экстремальными считают отклонения в обе стороны и делят вероятность поровну:
При в каждом хвосте по 0,025, поэтому границы равны примерно и . Знак равенства на границе для непрерывного распределения не меняет вероятность: попадание в точку имеет вероятность ноль. Для дискретной статистики правило на границе необходимо оговорить явно.
Квантиль выбирают из распределения именно той статистики, которую использует тест. Например, при неизвестной дисперсии и соответствующих предпосылках вместо нормального закона может потребоваться распределение Стьюдента с числом степеней свободы; для других задач используются другие распределения. В статье о распределении Фишера показано, как читать критические значения с учётом степеней свободы.
Односторонняя или двусторонняя проверка
Направление критической области определяется альтернативой, а не желанием получить значимый результат. Если заранее интересует любое отличие , используют двустороннюю альтернативу: область состоит из двух хвостов. Если содержательно имеет значение только увеличение и уменьшение не считается подтверждением этой альтернативы, возможна проверка с правым хвостом. Аналогично для уменьшения используют левый хвост.
При одном и том же правый порог равен примерно , а правый порог двусторонней проверки - . Первый ниже, потому что вся вероятность ошибки выделена одному хвосту. Зато сильное отклонение в противоположную сторону не попадёт в правостороннюю область. Менять направление после знакомства с данными некорректно: заявленный контроль ошибки больше не описывает такую процедуру. Выбор альтернативы нужно обосновать до анализа.
Пример: проверяем среднее
Предположим, независимые наблюдения взяты из нормальной совокупности с известным стандартным отклонением . Проверяем против при . В учебной выборке объёмом получено среднее . Эти числа условные, а не результаты исследования.
Стандартная ошибка равна . Статистика и правило таковы:
Значение 2,2 находится правее границы 1,960, поэтому оно попадает в критическую область. Нулевую гипотезу отклоняют на уровне 5 % в пользу двусторонней альтернативы. При уровне 1 % границы были бы примерно : то же наблюдение уже не попало бы в область. Данные не изменились, изменилось заранее установленное правило.
В реальной задаче сначала проверяют уместность модели, независимость наблюдений и способ получения . Если подставить выборочное стандартное отклонение вместо известного без изменения распределения статистики, полученное правило может быть неверным. Само отклонение также не измеряет практическую важность эффекта: полезно отдельно сообщить величину разницы и её неопределённость.
Связь критической области с p-значением
Для принятого теста p-значение - вероятность при получить статистику не менее экстремальную, чем наблюдаемая, по правилу выбранной альтернативы. В нашем симметричном двустороннем примере:
Так как , результат совпадает с решением по критическим границам. При имеем , поэтому не отклоняют. В непрерывной модели при согласованном определении экстремальности сравнение с и сравнение статистики с соответствующими границами дают одно решение. Это не означает, что - вероятность истинности или вероятность ошибки конкретного вывода. Подробное описание критических значений и p-значений приводит справочник NIST.
Как записать решение в задаче
Удобно оформить решение в пять шагов. Сначала запишите обе гипотезы с указанием направления альтернативы. Затем назовите статистику, её распределение при нулевой гипотезе и условия, при которых это распределение применимо. После этого укажите выбранный заранее уровень значимости и найдите по нему границу или границы. Только теперь подставьте данные, вычислите наблюдаемую статистику и сравните её с областью отклонения.
В заключении вернитесь к смыслу задачи: напишите, есть ли на выбранном уровне основания утверждать отличие, увеличение или уменьшение исследуемого параметра. Одной фразы «результат значим» недостаточно, если из неё неясно, какая гипотеза проверялась и в какую сторону. Если приводится p-значение, рядом стоит указать и саму оценку эффекта: одинаковое решение теста может соответствовать разным по величине изменениям.
Для дискретных данных достижимые вероятности хвостов идут отдельными ступенями. Например, при подсчёте числа успехов не всегда существует граница, дающая в точности заданные пять процентов. Тогда выбирают допустимую область с вероятностью не выше выбранного уровня; из-за этой ступенчатости она может оказаться консервативной. Важно использовать распределение, соответствующее конкретной задаче, а не автоматически брать непрерывную нормальную кривую из примера выше.
Ошибки и мощность
Уменьшение сокращает вероятность ложного отклонения при , но при фиксированных остальных условиях может уменьшить вероятность обнаружить реальное отличие: границы удаляются от центра, и часть результатов при альтернативе уже не попадает в критическую область. Эта вероятность обнаружения называется мощностью критерия; её значение зависит от конкретной альтернативы, объёма выборки и модели.
Неотклонение поэтому не доказывает равенство параметров: данных могло быть недостаточно для обнаружения небольшого отличия. Обратная задача - при заданном ограничении на ошибку выбрать наиболее мощное правило для конкретных гипотез - рассматривается в лемме Неймана - Пирсона.
Частые ошибки
- Считать вероятностью истинности . Это характеристика процедуры при условии, что нулевая гипотеза верна.
- Помещать все 5 % в каждый хвост двустороннего теста. Тогда суммарная вероятность составит 10 %, а не 5 %.
- Выбирать хвост после расчёта статистики. Направление альтернативы задают до анализа.
- Считать неотклонение доказательством . Оно лишь означает, что по выбранному правилу данных недостаточно для отклонения.
- Переносить порог 1,96 на любой критерий. Он относится к стандартному нормальному распределению и двустороннему уровню 5 %.
FAQ
Чем критическое значение отличается от критической области?
Значение задаёт границу, а область содержит все значения статистики, ведущие к отклонению . У двустороннего Z-критерия обычно две границы и два хвоста.
Можно ли сравнивать p-значение сразу с ?
Да, если p-значение рассчитано для той же статистики и той же альтернативы. При принятом правиле гипотезу отклоняют; в дискретных задачах соглашение о границе особенно важно.
Почему при уменьшении область сужается?
Ей выделяют меньшую вероятность при , поэтому в стандартном двустороннем Z-тесте границы уходят дальше от нуля. При этом влияние на мощность зависит от альтернативы и остальных условий.
Коротко
Уровень значимости задаёт допустимую вероятность ошибки I рода, а критическая область превращает этот предел в правило решения. Её строят по распределению статистики при и заранее выбранной альтернативе. Для двустороннего стандартного Z-критерия при границы равны приблизительно ; результат вне области не доказывает истинность нулевой гипотезы.
Читайте также
Доверительная вероятность и уровень значимости
Как связаны доверительная вероятность и уровень значимости: формула, смысл ошибок, пример доверительного интервала среднего и проверка двусторонней гипотезы.
Ошибки первого и второго рода при проверке гипотез
Ошибки первого и второго рода в проверке гипотез: как различать ложную тревогу и пропуск эффекта, рассчитать вероятность ошибки и повысить мощность критерия.
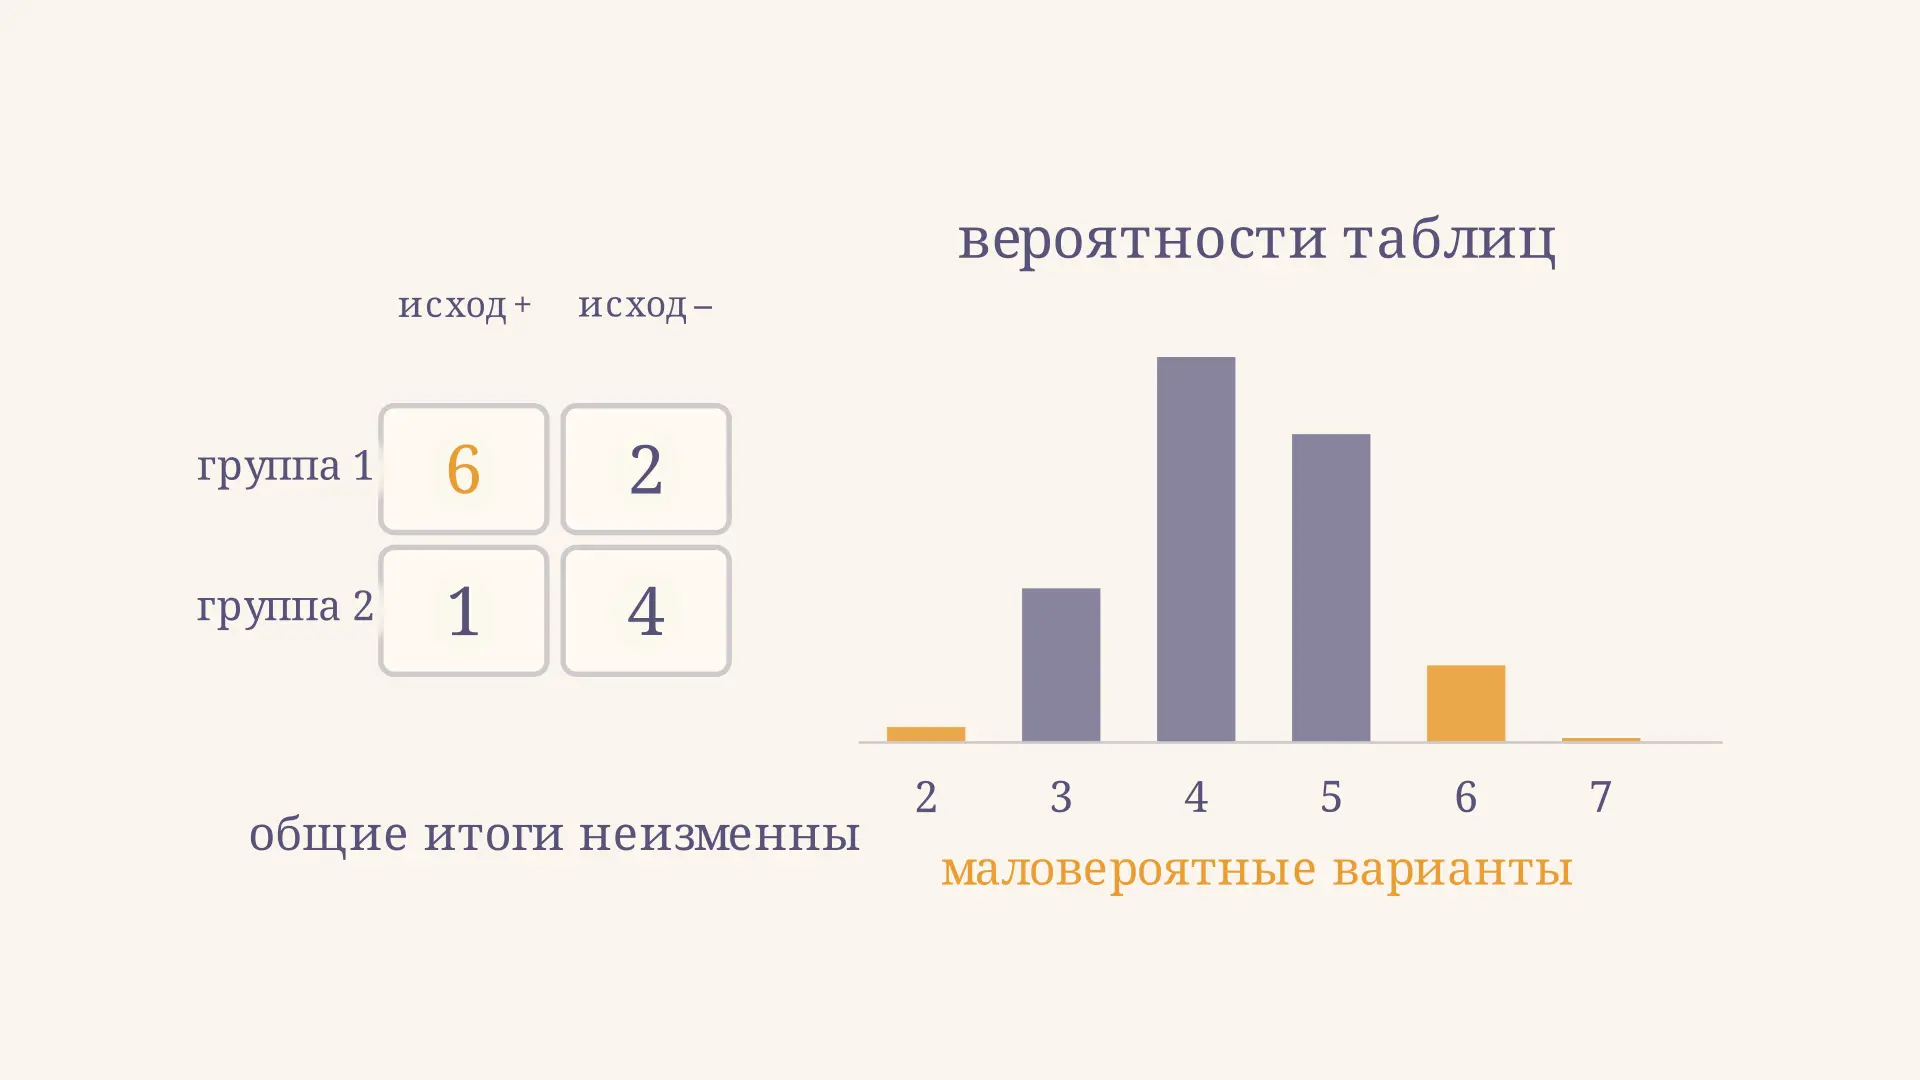
Точный критерий Фишера: таблица сопряжённости
Как применять точный критерий Фишера к таблице сопряжённости 2×2: условное распределение, одностороннее и двустороннее p, пример расчёта и интерпретация.
Критерий Шапиро-Уилка: проверка нормальности
Как работает критерий Шапиро-Уилка, что означают статистика W и p-значение, как проверить выборку и правильно сформулировать вывод на числовом примере.
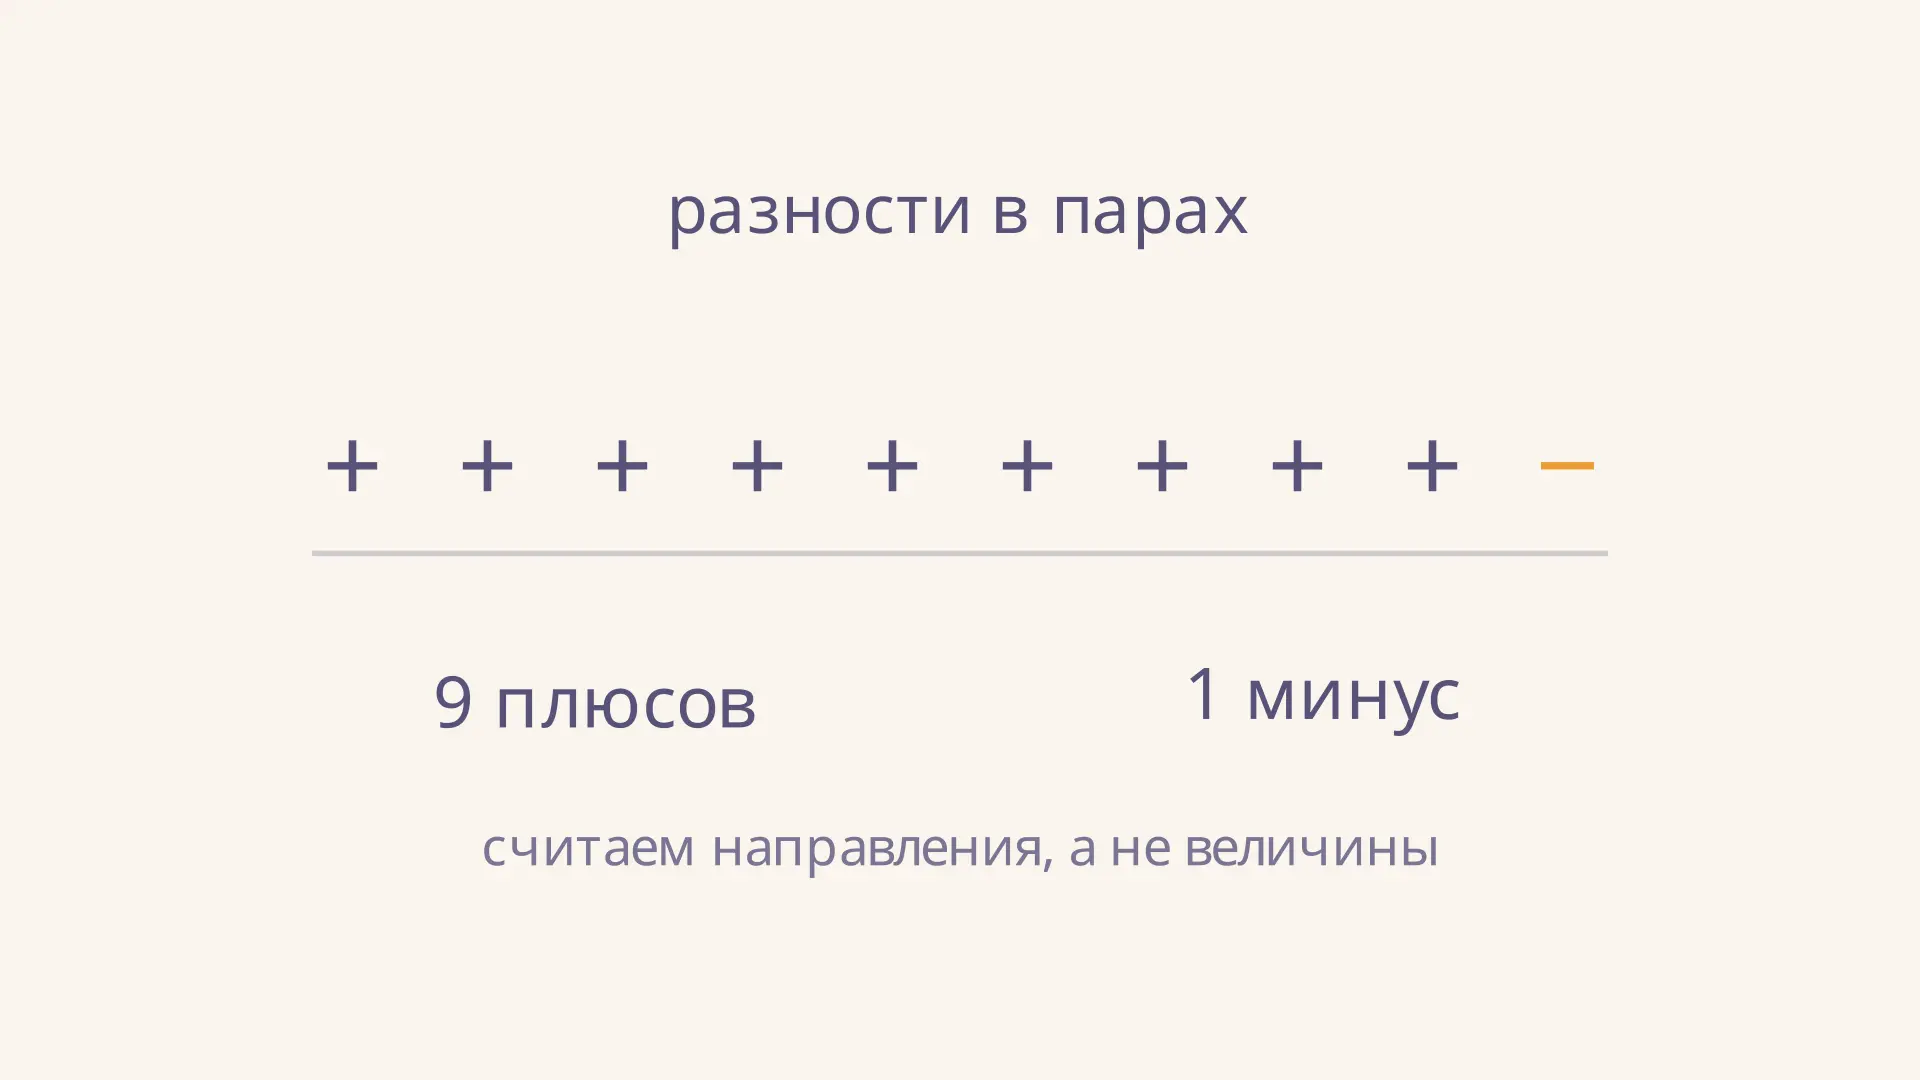
Критерий знаков непараметрический: расчёт и пример
Непараметрический критерий знаков: как проверить медиану или изменения в парных данных, исключить нули и рассчитать точное двустороннее p-значение на примере.
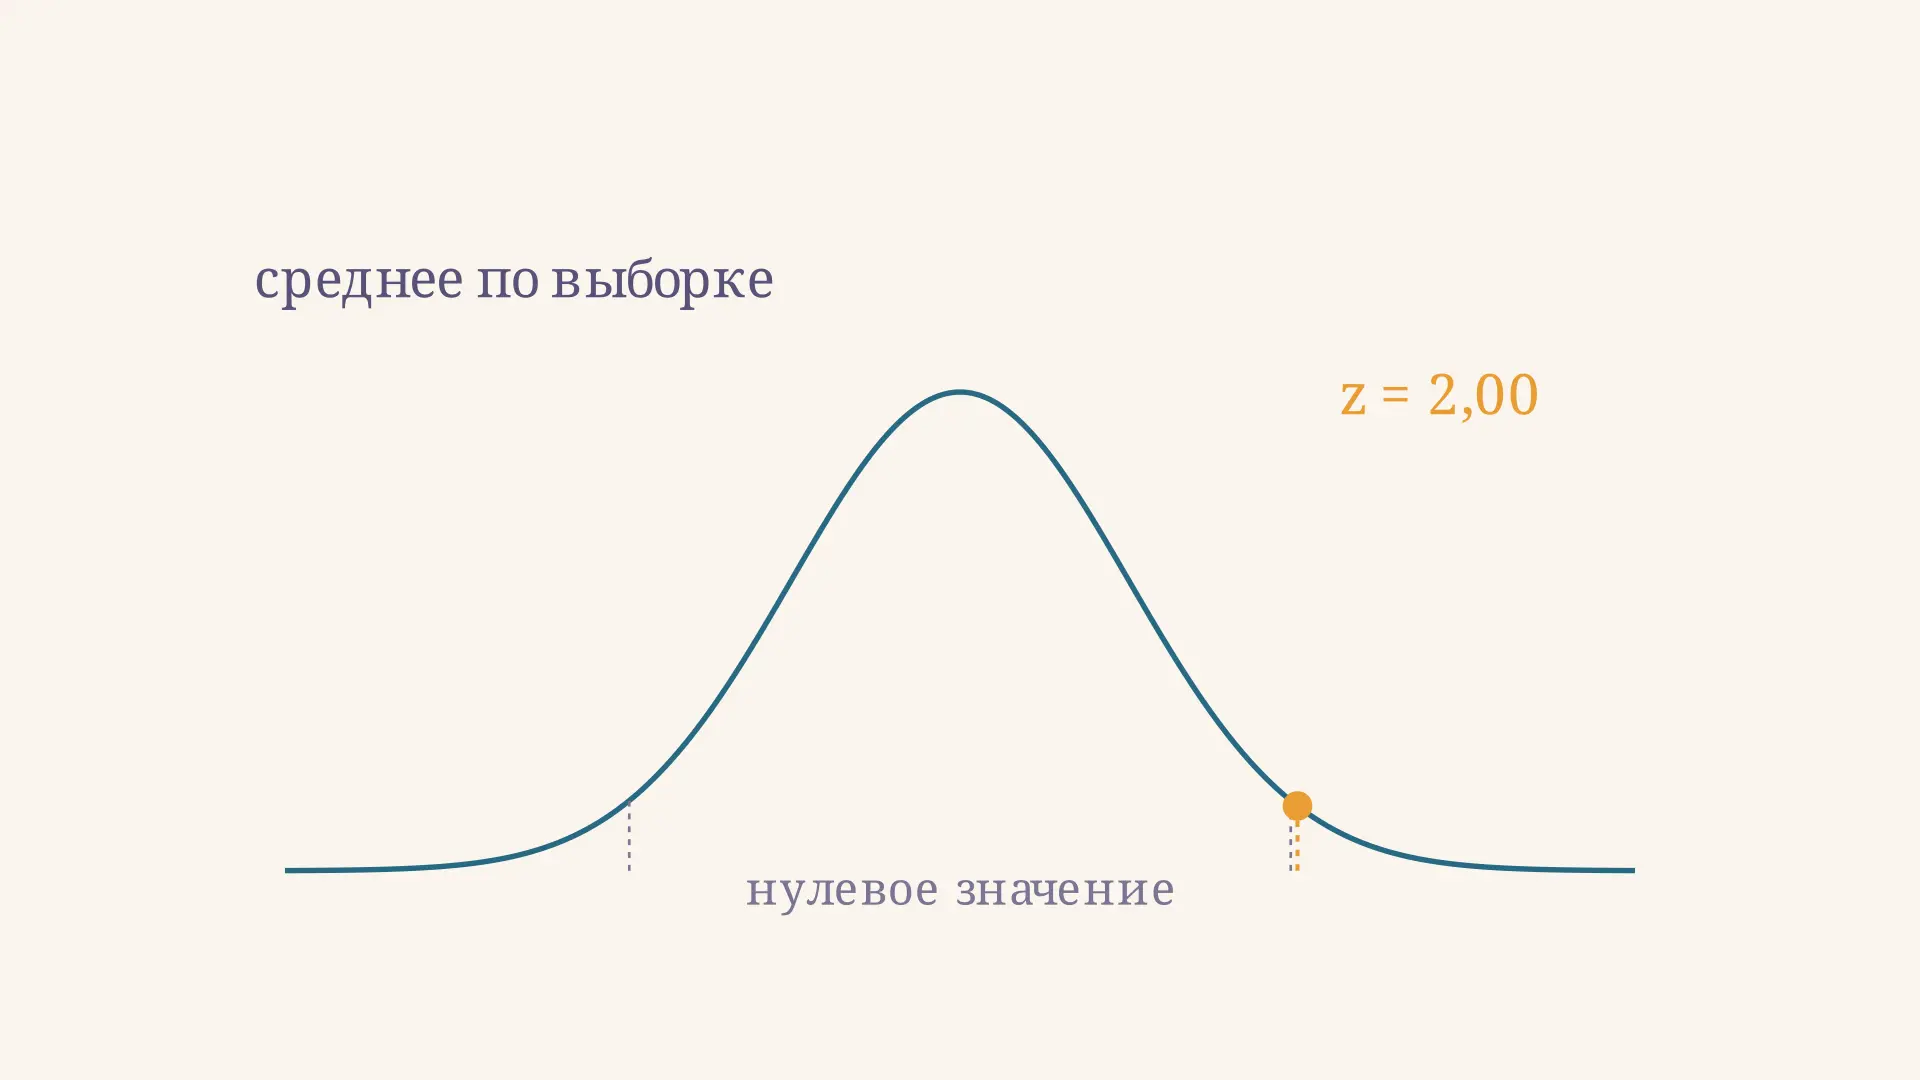
Проверка гипотезы о среднем нормального распределения
Как проверить гипотезу о среднем нормального распределения: выбор Z- или t-критерия, формулы, пример расчёта, критические области и интерпретация результата.