Критерий Шапиро-Уилка: проверка нормальности
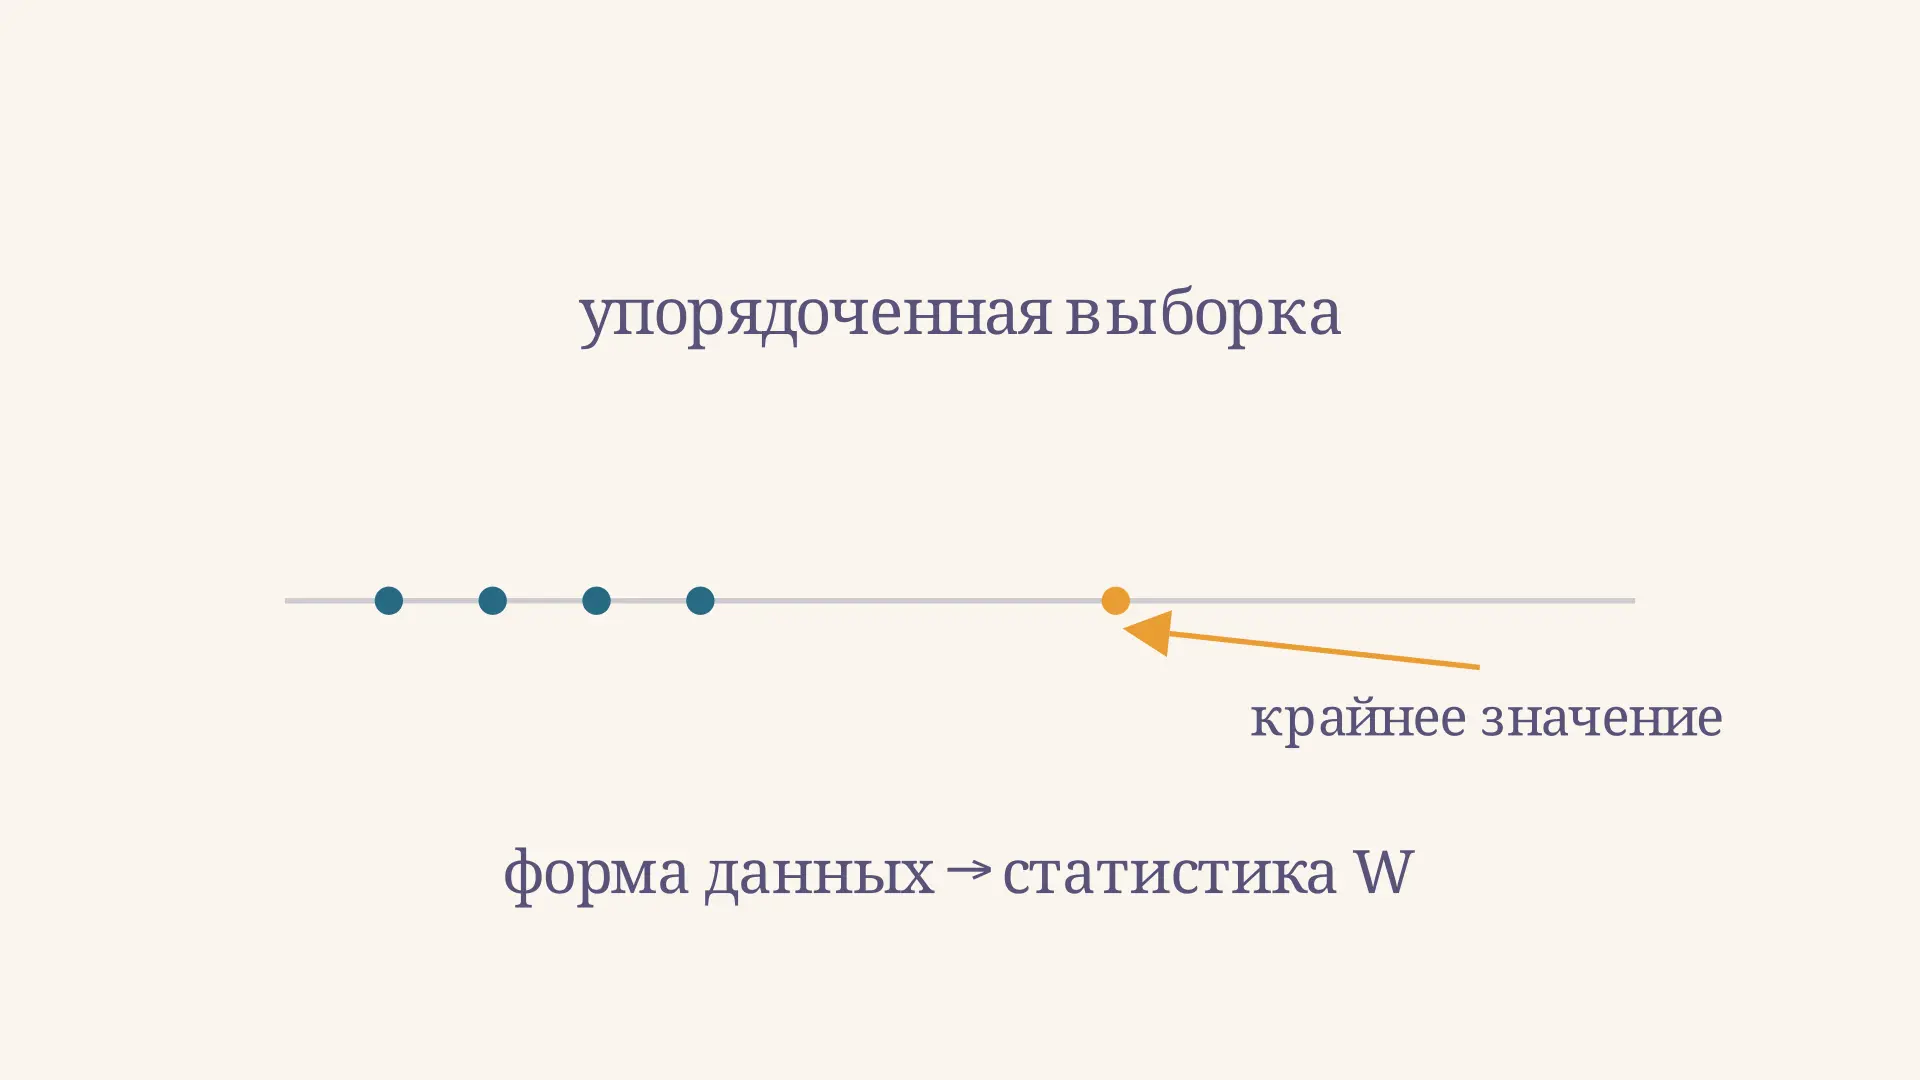
Критерий Шапиро - Уилка помогает проверить, совместимы ли наблюдения с предположением о нормальном распределении. На входе - числовая выборка, на выходе - статистика и соответствующее ей -значение. Результат не превращает данные в нормальные и не устанавливает закон распределения с абсолютной уверенностью: он показывает, насколько необычна наблюдаемая статистика при принятой модели.
Попробуйте изменить последнее число в учебной выборке ниже. Первые четыре остаются фиксированными, поэтому видно, как один удаляющийся край влияет на . Затем разберём формулу и решение с учётом размера выборки.
Какую гипотезу проверяет критерий
Пусть есть независимые наблюдения из одной совокупности. Нулевая гипотеза состоит в том, что распределение этой совокупности нормально с некоторыми неизвестными средним и дисперсией . Альтернатива шире: распределение не принадлежит этому семейству. Вопрос о том, как данные попали в исследование, важен не меньше вычисления: зависимость, смешение разных групп и систематический отбор нарушают простую модель случайной выборки.
Например, пять результатов одного прибора, полученные подряд при дрейфе температуры, могут зависеть друг от друга. Сам по себе тест нормальности такую зависимость не исправит. Различие между генеральной совокупностью и имеющимися наблюдениями разобрано в статье о генеральной совокупности и выборке; логика сравнения и - в материале о статистических гипотезах.
Перед проверкой задайте единицу наблюдения и убедитесь, что каждое число соответствует одной и той же измеряемой величине. Например, измерения разных пациентов и повторные измерения одного пациента требуют разных моделей зависимости. Если выборка состоит из нескольких групп, сначала решите, какая совокупность интересует исследователя: объединение групп способно иметь необычную форму даже тогда, когда каждая группа по отдельности выглядит близкой к нормальной. Делить данные или объединять их только по итогам теста означает менять исследовательский вопрос после просмотра результата.
Что измеряет статистика W
Сначала наблюдения сортируют: . Затем вычисляют
Коэффициенты зависят от : их получают с учётом ожидаемых порядковых статистик стандартного нормального распределения и их ковариаций. Знаменатель - сумма квадратов отклонений от среднего, числитель - квадрат специальной взвешенной комбинации отсортированных значений. Это отношение инвариантно к сдвигу и ненулевому изменению масштаба всех наблюдений. Если все значения одинаковы, знаменатель равен нулю и статистика не определена.
Интуитивно сравнивает форму упорядоченной выборки с формой, ожидаемой при нормальности. Обычно значения ближе к единице соответствуют меньшему обнаруженному отклонению, а малые значения дают больше оснований против . Но не является долей нормальности или вероятностью гипотезы. Её надо оценивать относительно распределения статистики при соответствующем . Формула и происхождение весов описаны в исходной работе Шапиро и Уилка и в справочнике NIST.
На видео крайнее наблюдение отдаляется от остальных и возвращается. Изменение расстояния между точками показывает, почему один выброс способен заметно изменить форму выборки и результат критерия.
Пример расчёта для пяти чисел
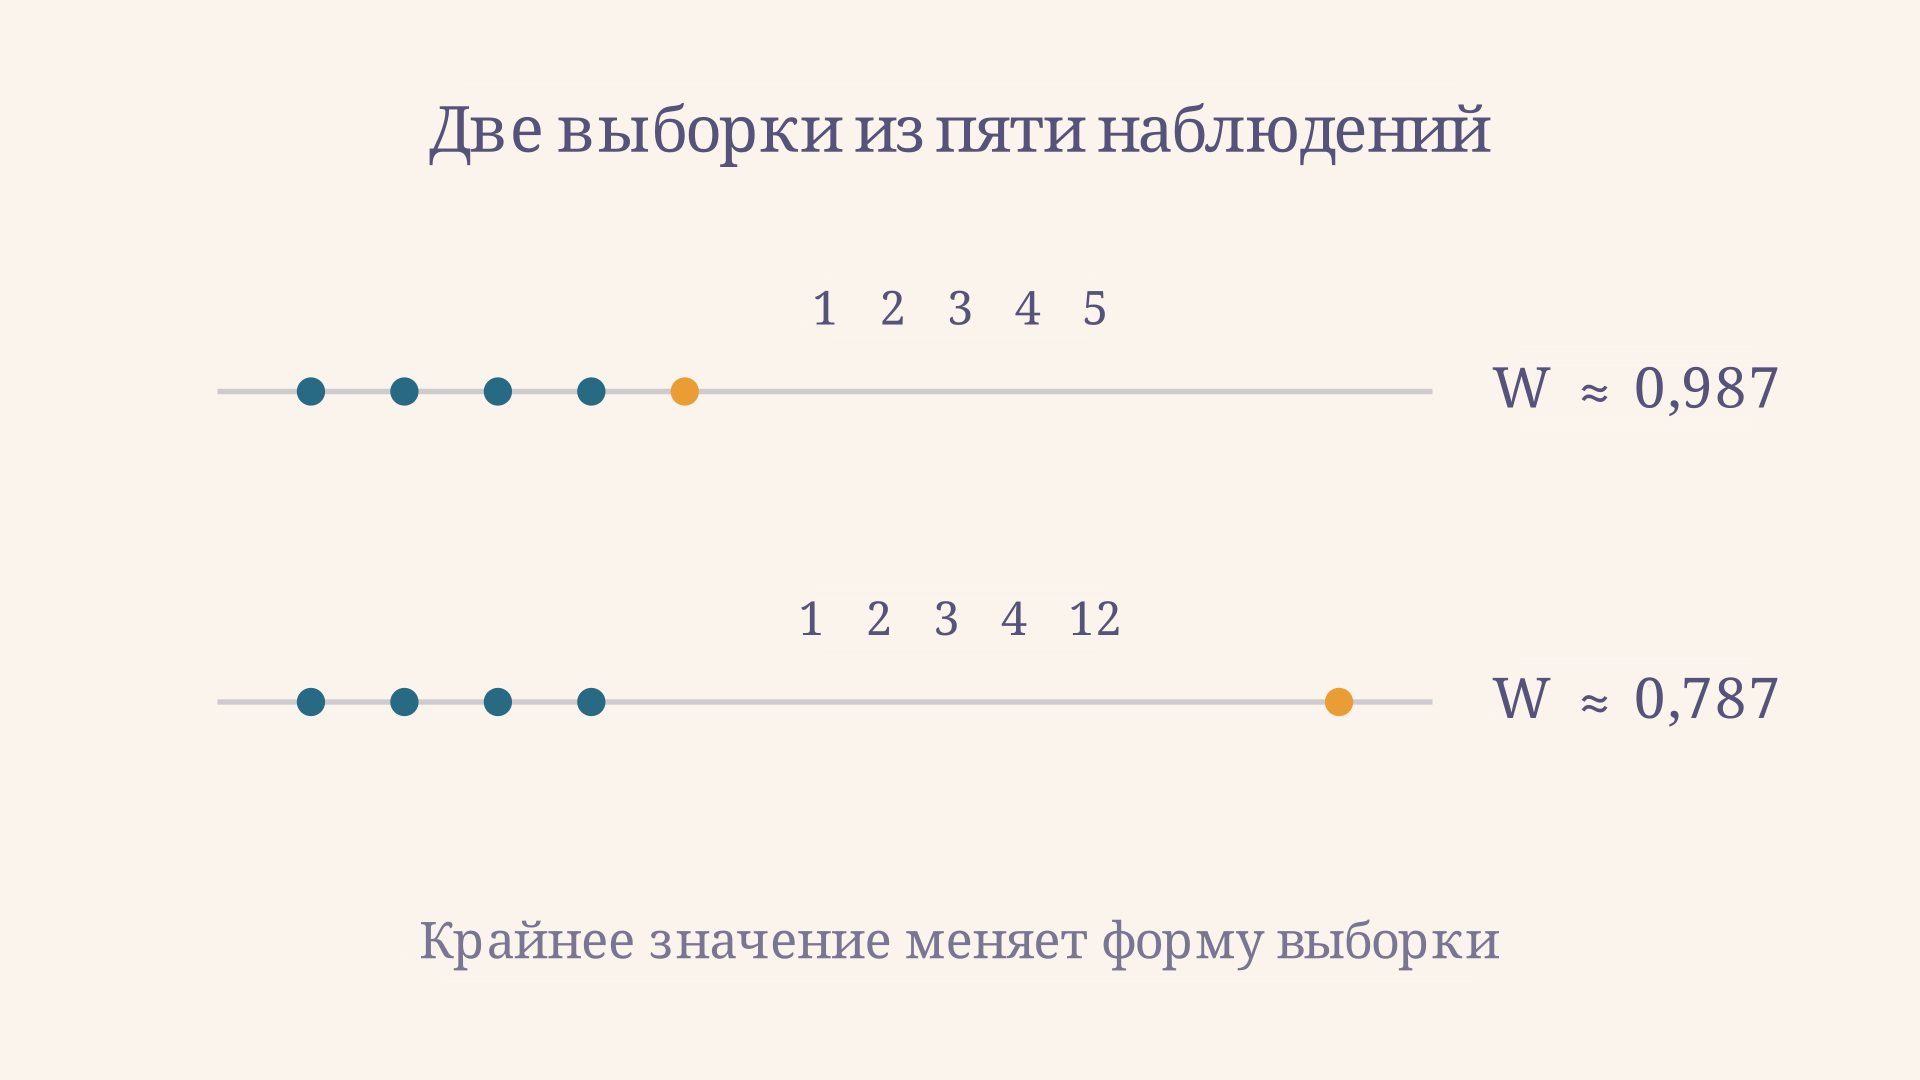
Возьмём учебную выборку . Она уже упорядочена, , среднее равно , сумма квадратов отклонений равна . Для пяти наблюдений можно записать числитель через две пары крайних значений. Округлённые коэффициенты равны и :
Вычисление в SciPy даёт . При заранее выбранном уровне значимости оснований отвергнуть нормальность нет: . Это не доказательство, что распределение действительно нормально. При пяти наблюдениях тест может не распознать существенное отклонение.
Теперь заменим пятёрку на . Среднее становится , сумма квадратов отклонений - , а и . Значение заметно снизилось, но при том же пороге нулевую гипотезу по-прежнему не отвергают. Это полезное напоминание: визуально заметный край и формальное решение не обязаны совпадать. Оба набора искусственные и служат только для иллюстрации; удалять точку без изучения причины нельзя.
Вручную этот расчёт полезен для понимания, но для произвольного объёма выборки веса не берут из примера с пятью точками. Они меняются вместе с количеством наблюдений. Для получения решения необходимо дополнительно вычислить или найти распределение статистики при нулевой гипотезе: одной формулы для самого отношения недостаточно. В опубликованном анализе желательно указать не только итоговое решение, но и размер данных и точность вычисления. Тогда читатель сможет отличить слабую информативность маленького набора от уверенного обнаружения отклонения в большом исследовании.
Как читать p-значение и принимать решение
-значение здесь - вероятность при условии получить значение не больше наблюдаемого, то есть настолько же или сильнее указывающее на отклонение по статистике теста. Уровень выбирают до просмотра результата; часто используют , но он зависит от задачи и цены ошибок.
Если , нулевую гипотезу отвергают на выбранном уровне. Если , данных недостаточно для её отклонения. Нельзя заключать, что вероятность нормальности равна , или что вероятность ошибки именно этого вывода равна . Уровень значимости описывает долгосрочную частоту ложных отклонений при выполнении условий теста, а не вероятность конкретной гипотезы.
Статистика и решение отвечают на разные вопросы. характеризует наблюдаемую форму с учётом весов, тогда как связывает её с распределением статистики для данного объёма выборки. Поэтому сравнивать только у наборов разного размера и объявлять один «нормальным» по универсальному порогу некорректно.
Как выполнить проверку в программе
Для воспроизводимого анализа сохраните исходные данные, способ обработки пропусков, уровень значимости, размер выборки, и . Например, в Python функция scipy.stats.shapiro принимает массив наблюдений и возвращает статистику и -значение. Для примера выше вызов shapiro([1, 2, 3, 4, 5]) даёт приведённые округлённые числа. Программа требует минимум три наблюдения; ограничения и особенности обработки пропусков описаны в документации SciPy.
В отчёте можно написать: «Для учебной выборки из пяти наблюдений , ; при гипотеза нормальности не отвергается». Укажите версию программы и достаточно знаков, чтобы результат можно было проверить; не округляйте до нуля. Для больших наборов SciPy отдельно предупреждает: при его приближение может быть неточным.
Когда одного теста недостаточно
При малом мощность может быть низкой: отсутствие значимости не исключает асимметрию или тяжёлые хвосты. При большом тест, наоборот, способен обнаружить очень малые отклонения, практически несущественные для последующего анализа. Полезно рассмотреть нормальный Q–Q график, источник необычных наблюдений и влияние отклонений на конкретный вывод. По графику судят о характере отклонения, а не получают автоматически второй независимый тест.
Проверяйте величину, для которой требуется предположение. Например, в модели регрессии часто интересует условное распределение ошибок, а не общий набор значений отклика. Остатки помогают его изучить, но они оценены по тем же данным и обычно зависимы; формальное обычного теста остатков может не иметь стандартной калибровки. В сложной модели полезны диагностика и моделирование с повторной оценкой параметров. Само построение регрессии рассмотрено в статье о нормальной системе МНК.
У других критериев согласия другая статистика и условия. Например, критерий Колмогорова - Смирнова сравнивает функции распределения; при оценке параметров по тем же данным его стандартная калибровка требует внимания. Выбор теста зависит от модели, типа данных и цели исследования.
Содержательный вывод зависит также от того, зачем нужна нормальность. Если цель - описать данные, полезно сообщить медиану, диапазон и форму распределения вместе с результатом теста. Если цель - интервальная оценка или сравнение групп, проверьте предположения именно выбранного метода и устойчивость ответа к их нарушению. Тест не выбирает метод автоматически: асимметрия, отдельное ошибочное измерение и смесь двух популяций требуют разных объяснений. При необходимости исследователь может сравнить выводы нескольких обоснованных моделей и честно описать чувствительность результата.
Частые ошибки
- Принимать за доказательство нормальности. Это лишь недостаток оснований отвергнуть при выбранном пороге.
- Называть вероятностью. Статистика и -значение имеют разные определения.
- Удалять выброс ради значимости. Сначала проверьте запись, измерение и исследовательский протокол; фиксируйте обоснование любого исключения.
- Игнорировать зависимость и округление. Повторы, дискретность и связанные измерения могут сделать обычную калибровку неприменимой.
- Выбирать тест после просмотра результата. Заранее определите гипотезу, уровень и способ обработки данных.
FAQ
Какое значение W считается нормальным? Универсальной границы нет: распределение зависит от объёма выборки. Для вывода используют корректное -значение или критическое значение для данного и уровня значимости.
Можно ли применять критерий к малой выборке? Да, начиная с трёх наблюдений в реализации SciPy, но малая выборка может давать слабую мощность. Неотклонение гипотезы при этом особенно далеко от доказательства нормальности.
Что делать, если нормальность отвергнута? Изучить график, данные и причину отклонения, затем выбрать метод с подходящими предположениями. Возможны робастный анализ, корректная трансформация или другая модель; решение зависит от цели, а не только от .
Коротко
Критерий Шапиро - Уилка сравнивает упорядоченную выборку с ожидаемой формой нормальных данных с помощью статистики . Малое даёт основание отвергнуть нормальность на выбранном уровне; большое не доказывает её. Для надёжного вывода учитывают размер и способ получения выборки, графики и задачу дальнейшего анализа.
Читайте также
Критерий Лиллиефорса: проверка нормальности выборки
Критерий Лиллиефорса проверяет нормальность при неизвестных среднем и дисперсии. Разбираем статистику D, расчёт на примере, критические значения и вывод.
Информация Фишера: формула и пример расчёта
Что такое информация Фишера и как она связана с правдоподобием: вывод формулы для испытаний Бернулли, подробный числовой пример и граница Крамера-Рао для оценки вероятности.
Оценка максимального правдоподобия: метод и пример
Как найти оценку максимального правдоподобия: функция и логарифм правдоподобия, вывод для испытаний Бернулли, пример нормального распределения и границы метода.
Точный критерий Фишера: таблица сопряжённости
Как применять точный критерий Фишера к таблице сопряжённости 2×2: условное распределение, одностороннее и двустороннее p, пример расчёта и интерпретация.
Уровень значимости и критическая область
Как связаны уровень значимости и критическая область: односторонний и двусторонний критерии, критические значения, p-значение и пример расчёта Z-критерия.
Достаточная статистика: что это и критерий факторизации
Достаточная статистика простыми словами: строгое определение через условное распределение и критерий факторизации Неймана-Фишера, разбор связи с правдоподобием и примеры.