Критерий Лиллиефорса: проверка нормальности выборки
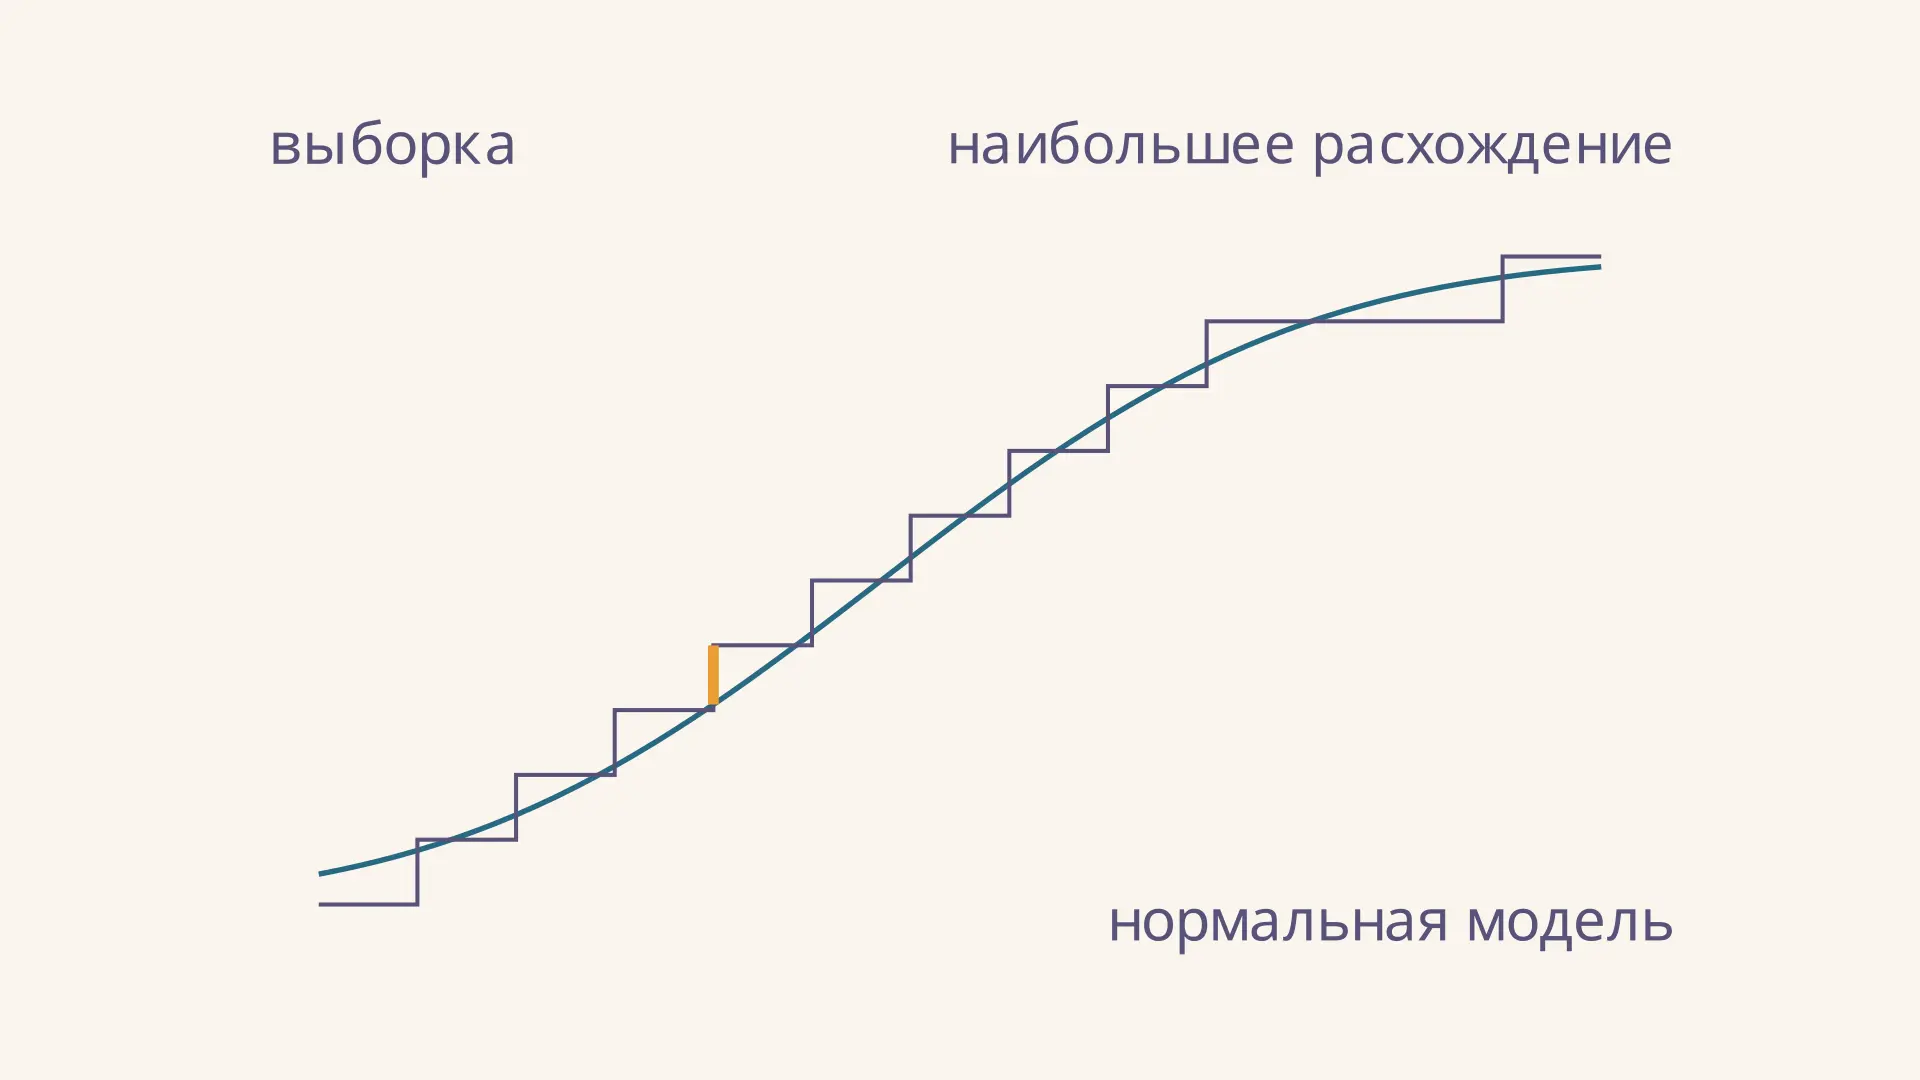
Критерий Лиллиефорса помогает проверить нормальность данных, когда среднее и стандартное отклонение генеральной совокупности неизвестны и оценены по той же выборке. Он сравнивает накопленные доли наблюдений с нормальной моделью и измеряет самое большое вертикальное расхождение между ними. Важная особенность - для решения используют распределение статистики с учётом оценки параметров, а не обычную таблицу Колмогорова.
В учебной модели ниже первые девять наблюдений фиксированы. Измените десятое и посмотрите, как одновременно меняются оценённая нормальная кривая и максимальное расхождение. Калькулятор показывает статистику, а решение о значимости требует отдельного критического значения.
Какую гипотезу проверяет тест
Пусть есть независимые наблюдения одной непрерывной величины. Нулевая гипотеза утверждает, что они получены из нормального распределения с некоторыми неизвестными и . Альтернатива означает, что распределение не принадлежит этому семейству. Вопрос касается формы закона в генеральной совокупности, а не того, похожа ли гистограмма конкретных чисел на идеальный колокол.
Из данных вычисляют среднее и исправленное стандартное отклонение . По ним строят функцию распределения , где относится к стандартной нормальной модели. Эмпирическая функция показывает долю значений, не превосходящих . Она растёт скачками в точках наблюдений.
На видео золотой отрезок последовательно показывает расхождение у каждого скачка. Тест сохраняет наибольшее из таких расстояний: важно проверить и верхнюю, и нижнюю сторону ступеньки.
Чем отличается от критерия Колмогорова
Статистика здесь устроена так же, как в одновыборочном критерии согласия Колмогорова - Смирнова: это максимум расстояния между двумя функциями распределения. Разница в том, как определена нормальная кривая и по какому распределению оценивают значимость.
В обычной постановке параметры проверяемого непрерывного закона полностью заданы до знакомства с выборкой. Если же оценить их по тем же наблюдениям, кривая приспосабливается к данным. Стандартная калибровка больше не подходит: применение обычного порога обычно делает проверку слишком консервативной. Лиллиефорс учитывает именно эту оценку параметров. NIST отдельно указывает, что обычная критическая область теста Колмогорова - Смирнова недействительна при оценивании параметров по данным.
Поэтому сначала задайте себе вопрос: параметры известны независимо или получены из проверяемой выборки? Не следует выбирать таблицу только по внешнему виду формулы . Есть также вариант Лиллиефорса для показательного распределения, но его калибровка отличается от нормальной; здесь рассматривается только нормальность.
Формула статистики и обе стороны скачка
Упорядочим наблюдения: . Используем оценки
Затем для каждого ранга найдём . Эмпирическая функция непосредственно перед скачком равна , а в самой точке - . Две составляющие и итоговая статистика имеют вид
измеряется в долях от нуля до единицы, а не в единицах исходной величины. Большое значение означает сильное расхождение с подогнанной моделью. Проверка только после скачка может пропустить максимум непосредственно перед ним. Здесь использовано с делителем ; например, такую нормировку применяет реализация statsmodels. При другой оценке масштаба нужна соответствующая калибровка.
Пошаговый расчёт на выборке
Возьмём учебные данные . Это иллюстрация метода, а не результаты измерений. Объём , сумма равна 57, поэтому . Сумма квадратов отклонений равна , и .
Для четвёртого значения стандартизованная величина около . Соответствующая нормальная функция равна , тогда верхняя сторона ступеньки даёт . Для первого значения , а доля слева равна нулю.
| Сравнение | Результат |
|---|---|
| Максимум | 0,0914 при |
| Максимум | 0,0835 при |
| Статистика | 0,0914 |
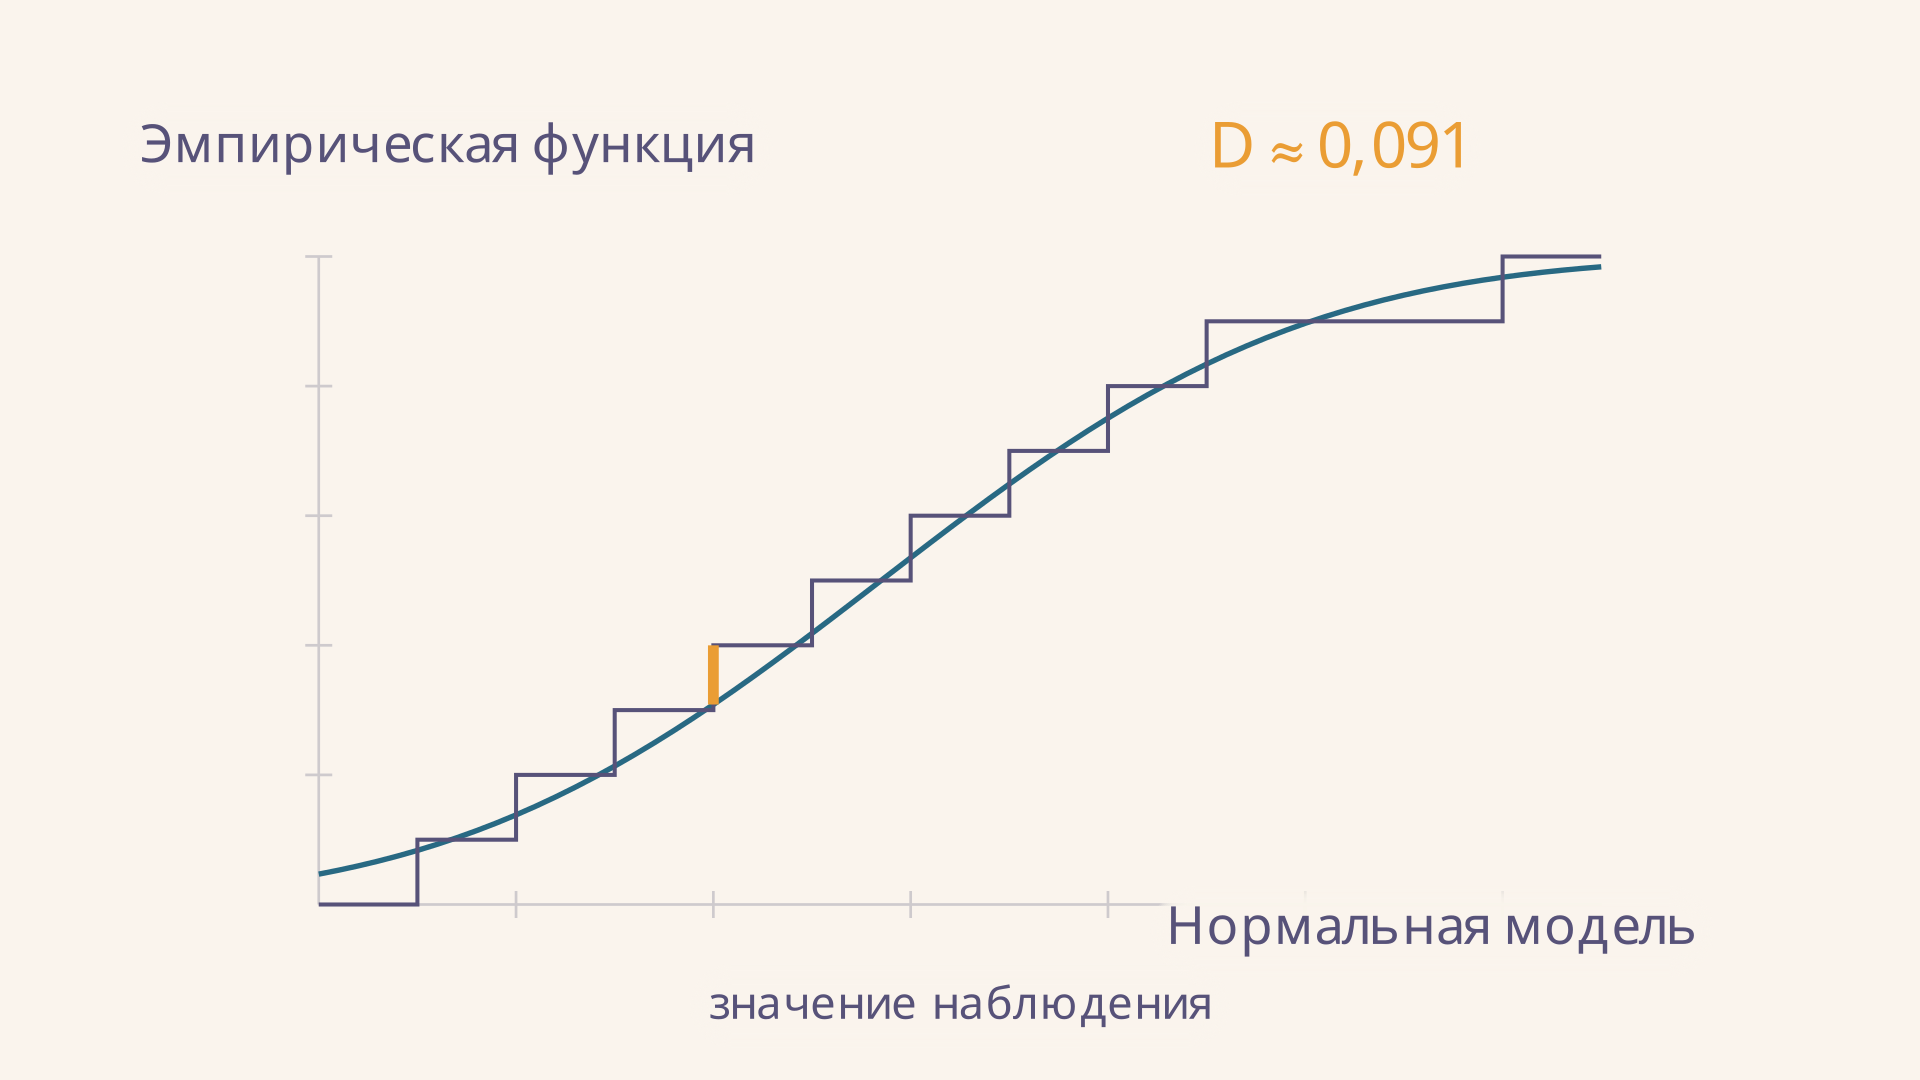
Золотой отрезок показывает именно разницу по вертикали. Он не является разностью между соседними наблюдениями и не измеряет расстояние по оси . Если изменить последнее наблюдение в калькуляторе, нужно заново оценить и среднее, и : сравнение со старой кривой уже отвечало бы на другой вопрос.
Критическое значение и решение
Выберите уровень значимости до просмотра результата. По таблице именно для нормального варианта Лиллиефорса находят критическое значение, соответствующее и . В опубликованной таблице, приведённой в материалах statsmodels, для и указано приблизительно . Другие таблицы или симуляционные реализации могут немного отличаться из-за способа калибровки и округления.
В нашем примере : на уровне 5% оснований отвергнуть нет. Это не доказательство нормальности. Выборка из десяти наблюдений может не дать тесту достаточно информации, чтобы заметить некоторые отклонения. И наоборот, в больших массивах даже слабые отклонения могут оказаться статистически значимыми.
Если результат близок к табличной границе, сохраняйте больше знаков при промежуточных расчётах: раннее округление может изменить решение. Уточните также, какая версия таблицы и какой способ оценки масштаба использованы. При сообщении результата полезно указать объём выборки, статистику, уровень значимости и источник критического значения. Так другой исследователь сможет воспроизвести сравнение и понять, какие предположения стоят за выводом.
Вместо таблицы программа может вернуть -значение: при верной нулевой модели это вероятность получить статистику не меньше наблюдаемой с учётом процедуры оценки параметров. Если , гипотезу отвергают; иначе не отвергают. Это не вероятность истинности и не мера практической важности отклонения.
Как воспроизвести проверку в программе
Перед запуском сохраните исходные наблюдения и заранее определите уровень значимости. Укажите, что проверяется нормальное распределение с двумя неизвестными параметрами. В программе проверьте не только название функции, но и её документацию: разные пакеты могут использовать различные приближения для вероятности и ограничивать диапазон возвращаемых значений. Округлённое значение на границе диапазона не следует трактовать как точную вероятность.
Сверьте промежуточные результаты: объём, среднее, стандартное отклонение и статистику. Для учебной выборки выше они составляют соответственно 10, 5,7, около 3,401 и около 0,091. Если программа выдаёт другое расстояние, проверьте порядок данных, делитель в формуле отклонения и обе стороны каждого скачка. Различие в последнем знаке может быть связано с округлением функции нормального распределения; крупное расхождение требует найти причину до интерпретации.
При подготовке отчёта полезно указать также, как выбирались наблюдения и были ли они округлены. Если проверено много групп по отдельности, серия решений увеличивает вероятность хотя бы одного случайного отклонения нулевой гипотезы. План анализа должен учитывать множественные сравнения, а не выбирать для обсуждения только наименьшее значение .
Условия применения и работа с результатом
Классическая калибровка предполагает независимую одинаково распределённую выборку из непрерывного закона. При сильном округлении и большом числе одинаковых значений ступени приобретают другую структуру; стандартное табличное решение может быть ненадёжным. Все одинаковые наблюдения также дают , и стандартизация невозможна. Для зависимых данных или остатков регрессии обычная таблица не обязана сохранять заявленный уровень ошибки: схему зависимости и оценку модели нужно учитывать при калибровке.
Проверяйте происхождение данных до вычислений: различие между генеральной совокупностью и выборкой определяет, к чему относится вывод. Дополните тест графиком квантилей и изучением способа измерения. Один экстремальный результат стоит проверить на ошибку записи, однако удалять его только ради желаемого нельзя; формальная диагностика выбросов, например критерий Граббса, имеет собственные предпосылки.
При анализе регрессии нормальность остатков и независимость ошибок - разные вопросы. Для последнего существует, например, диагностика автокорреляции. Сам по себе результат Лиллиефорса не устанавливает причин отклонения и не говорит, какая модель будет лучшей заменой.
Частые ошибки
- Подставлять выборочные и , а затем сравнивать с обычным порогом Колмогорова. Для составной нормальной гипотезы нужна соответствующая калибровка.
- Вычислять отклонение только с одной стороны ступеньки. Максимум может оказаться перед скачком.
- Читать как доказанную нормальность или как вероятность ошибки гипотезы. Это только отсутствие достаточных оснований для её отклонения при выбранном пороге.
- Применять таблицу к сильно округлённым или зависимым наблюдениям без проверки её применимости.
FAQ
Сколько наблюдений нужно для теста?
У конкретной реализации есть минимальный допустимый объём: например, statsmodels для нормального варианта требует минимум четыре наблюдения. Технический минимум не гарантирует высокую способность обнаруживать отклонения. На малой выборке особенно полезно показывать данные и ограничения вывода.
Обязательно ли строить гистограмму?
Нет. Статистика рассчитывается по упорядоченным наблюдениям, без группировки по интервалам. Гистограмма помогает исследовать форму данных, но зависит от выбора интервалов и не заменяет проверку условий.
Можно ли использовать тест для остатков?
Остатки могут быть зависимы и получены после оценки параметров регрессии. Поэтому стандартные критические значения для независимой выборки не всегда применимы. Для конкретной модели используют подходящую модельную калибровку, учитывающую и этап оценки.
Коротко
Критерий Лиллиефорса сравнивает эмпирическую функцию с нормальной моделью, параметры которой оценены по тем же данным. Статистика - наибольшее вертикальное расхождение с учётом обеих сторон скачков. Её сравнивают с критическим значением Лиллиефорса для нужных объёма и уровня значимости, а не с обычной таблицей Колмогорова. Отсутствие значимости оставляет нормальность допустимой моделью, но не доказывает её.
Читайте также
Критерий Шапиро-Уилка: проверка нормальности
Как работает критерий Шапиро-Уилка, что означают статистика W и p-значение, как проверить выборку и правильно сформулировать вывод на числовом примере.
Информация Фишера: формула и пример расчёта
Что такое информация Фишера и как она связана с правдоподобием: вывод формулы для испытаний Бернулли, подробный числовой пример и граница Крамера-Рао для оценки вероятности.
Оценка максимального правдоподобия: метод и пример
Как найти оценку максимального правдоподобия: функция и логарифм правдоподобия, вывод для испытаний Бернулли, пример нормального распределения и границы метода.
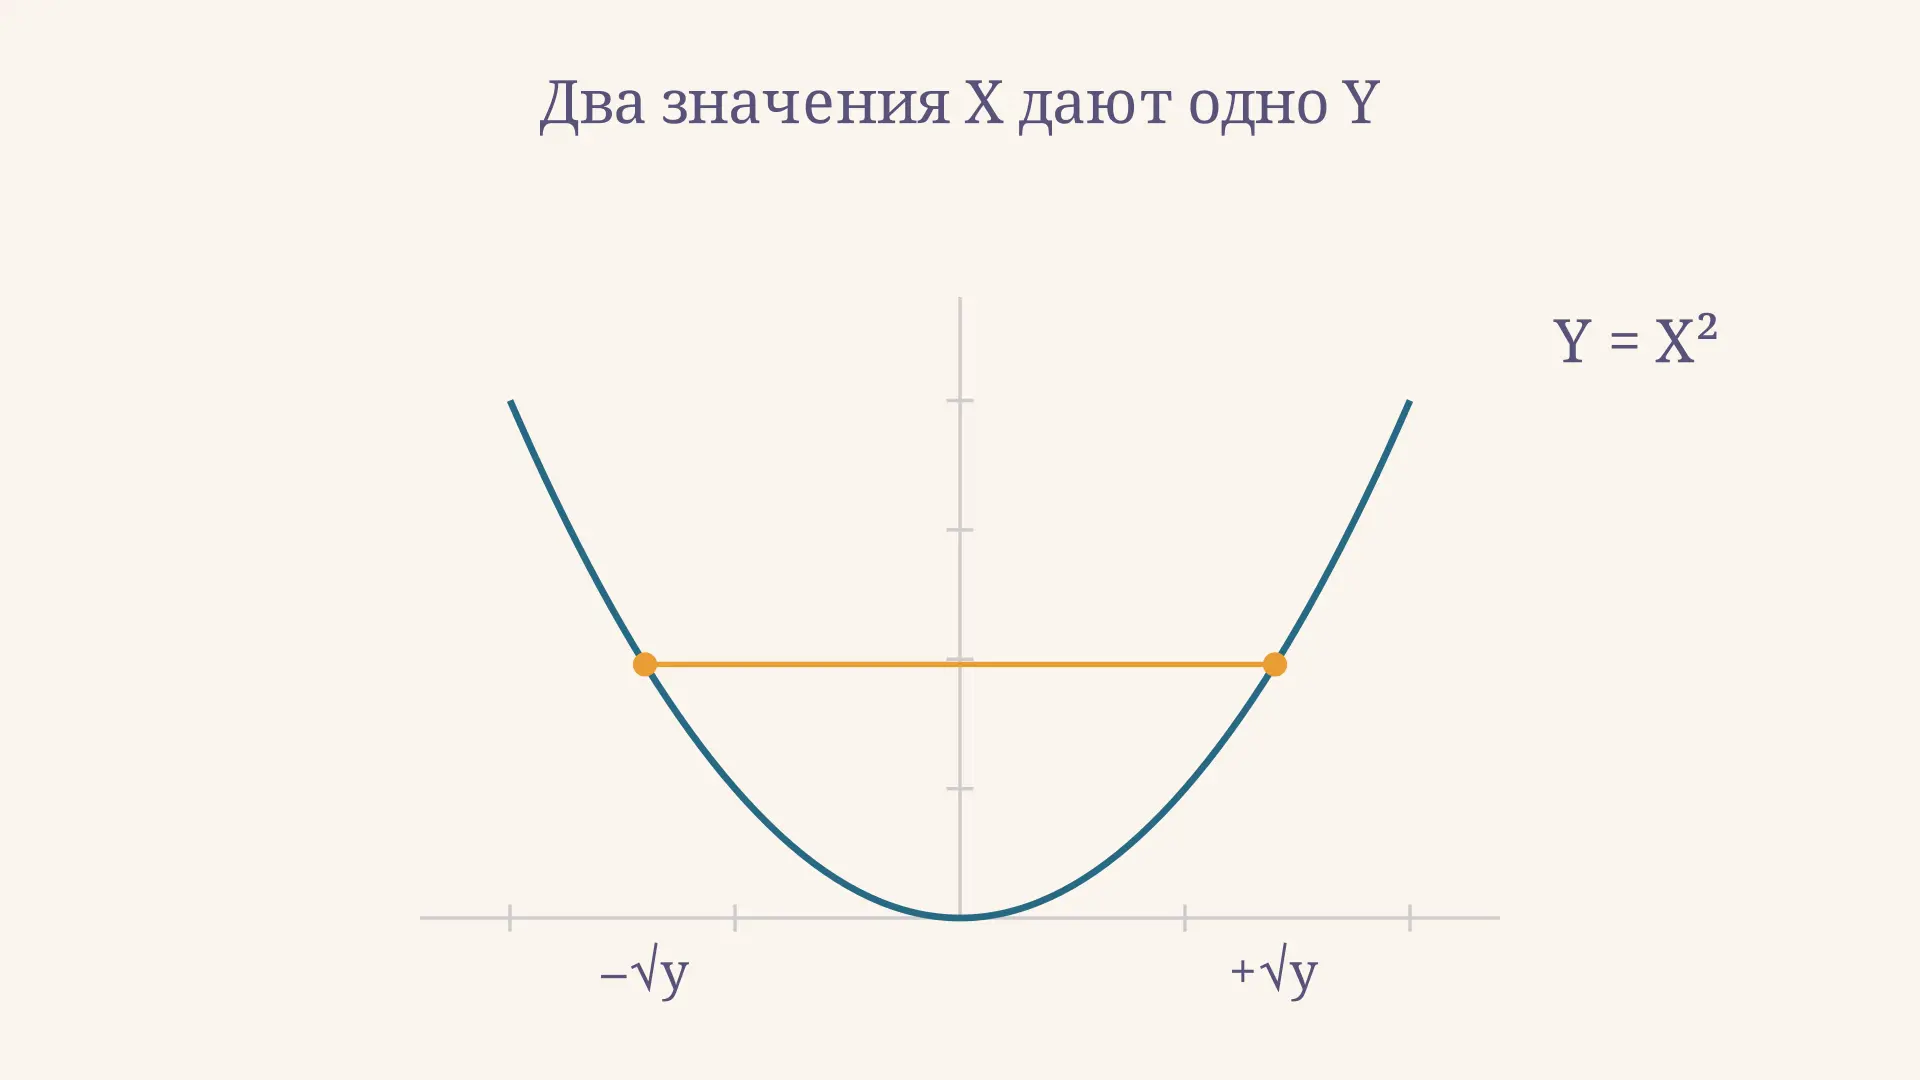
Распределение функции случайной величины: метод
Как найти распределение функции случайной величины через прообраз события и плотность: алгоритм, пример с квадратом, несколько обратных ветвей и проверка ответа.
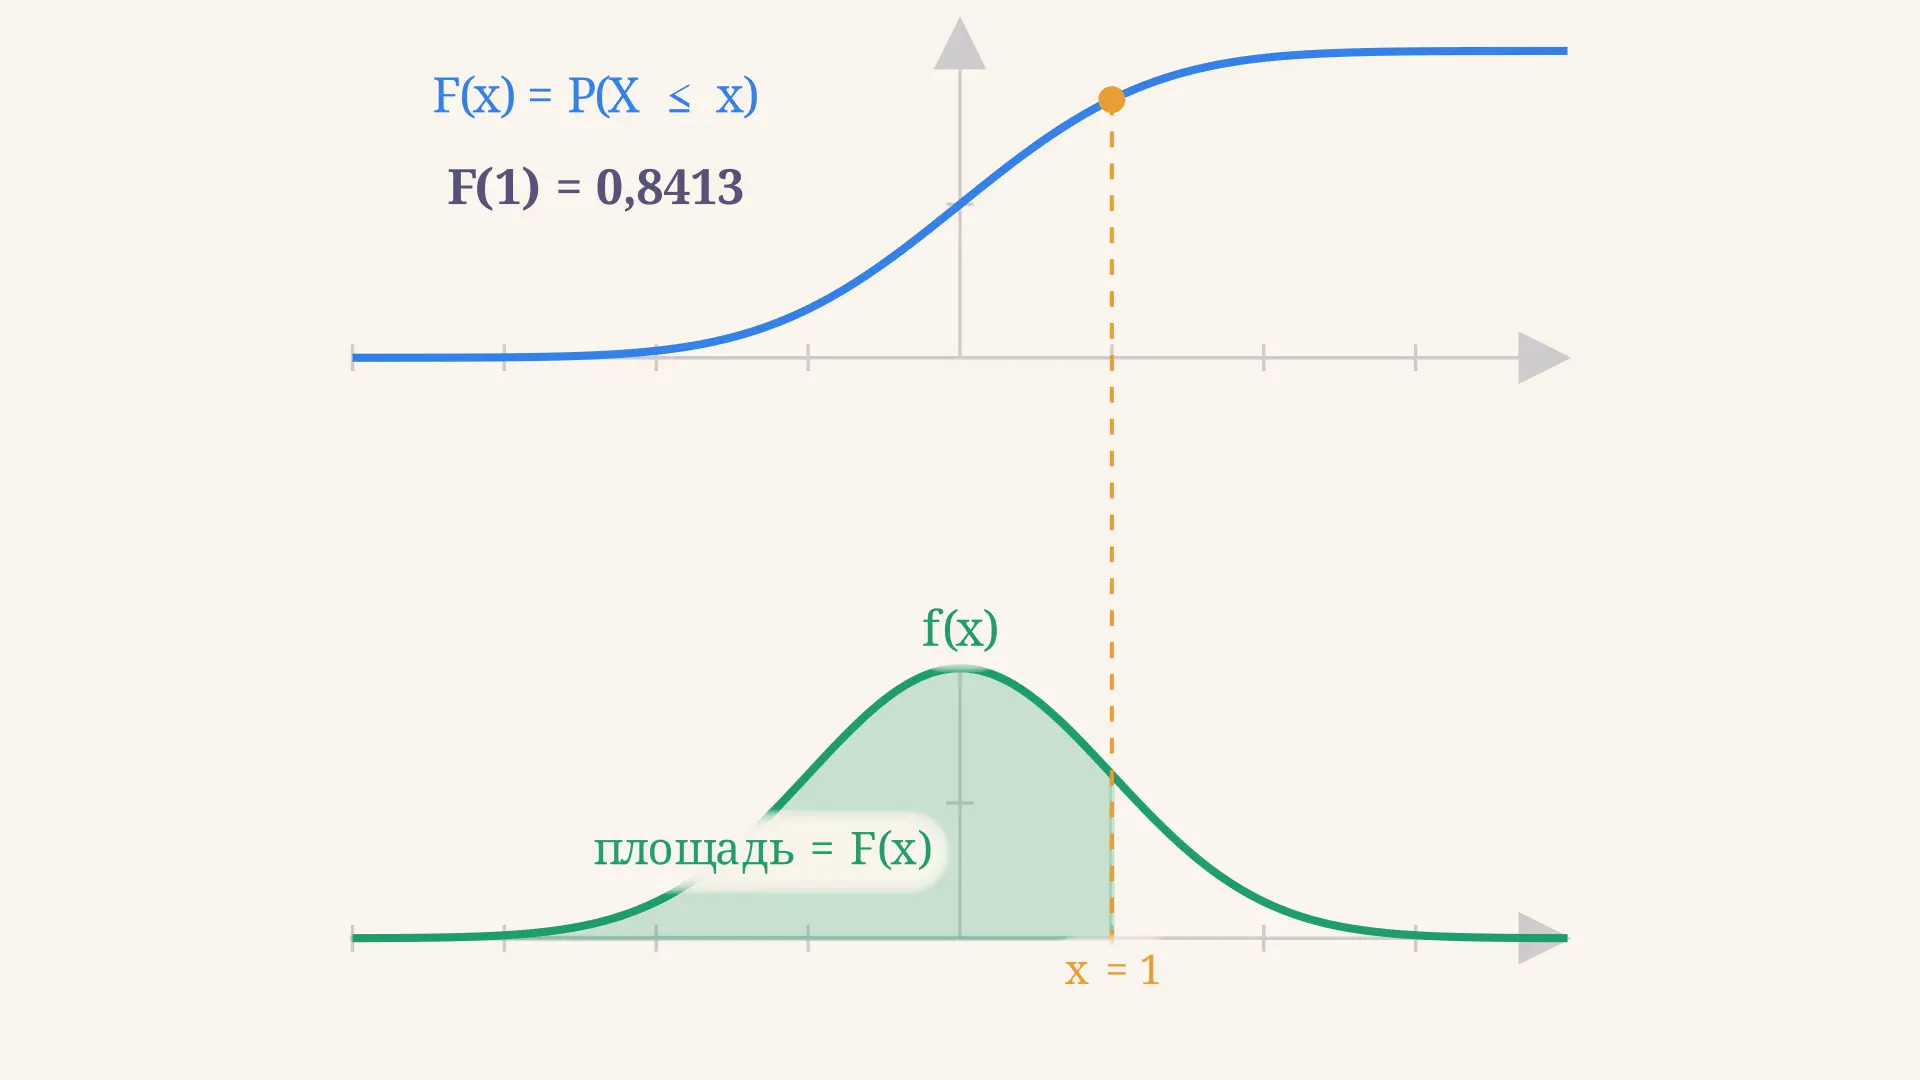
Функция распределения случайной величины: свойства
Функция распределения F(x) = P(X меньше или равно x): определение, все свойства, как строить для дискретной и непрерывной величины, связь с плотностью и расчёт вероятности на интервале.
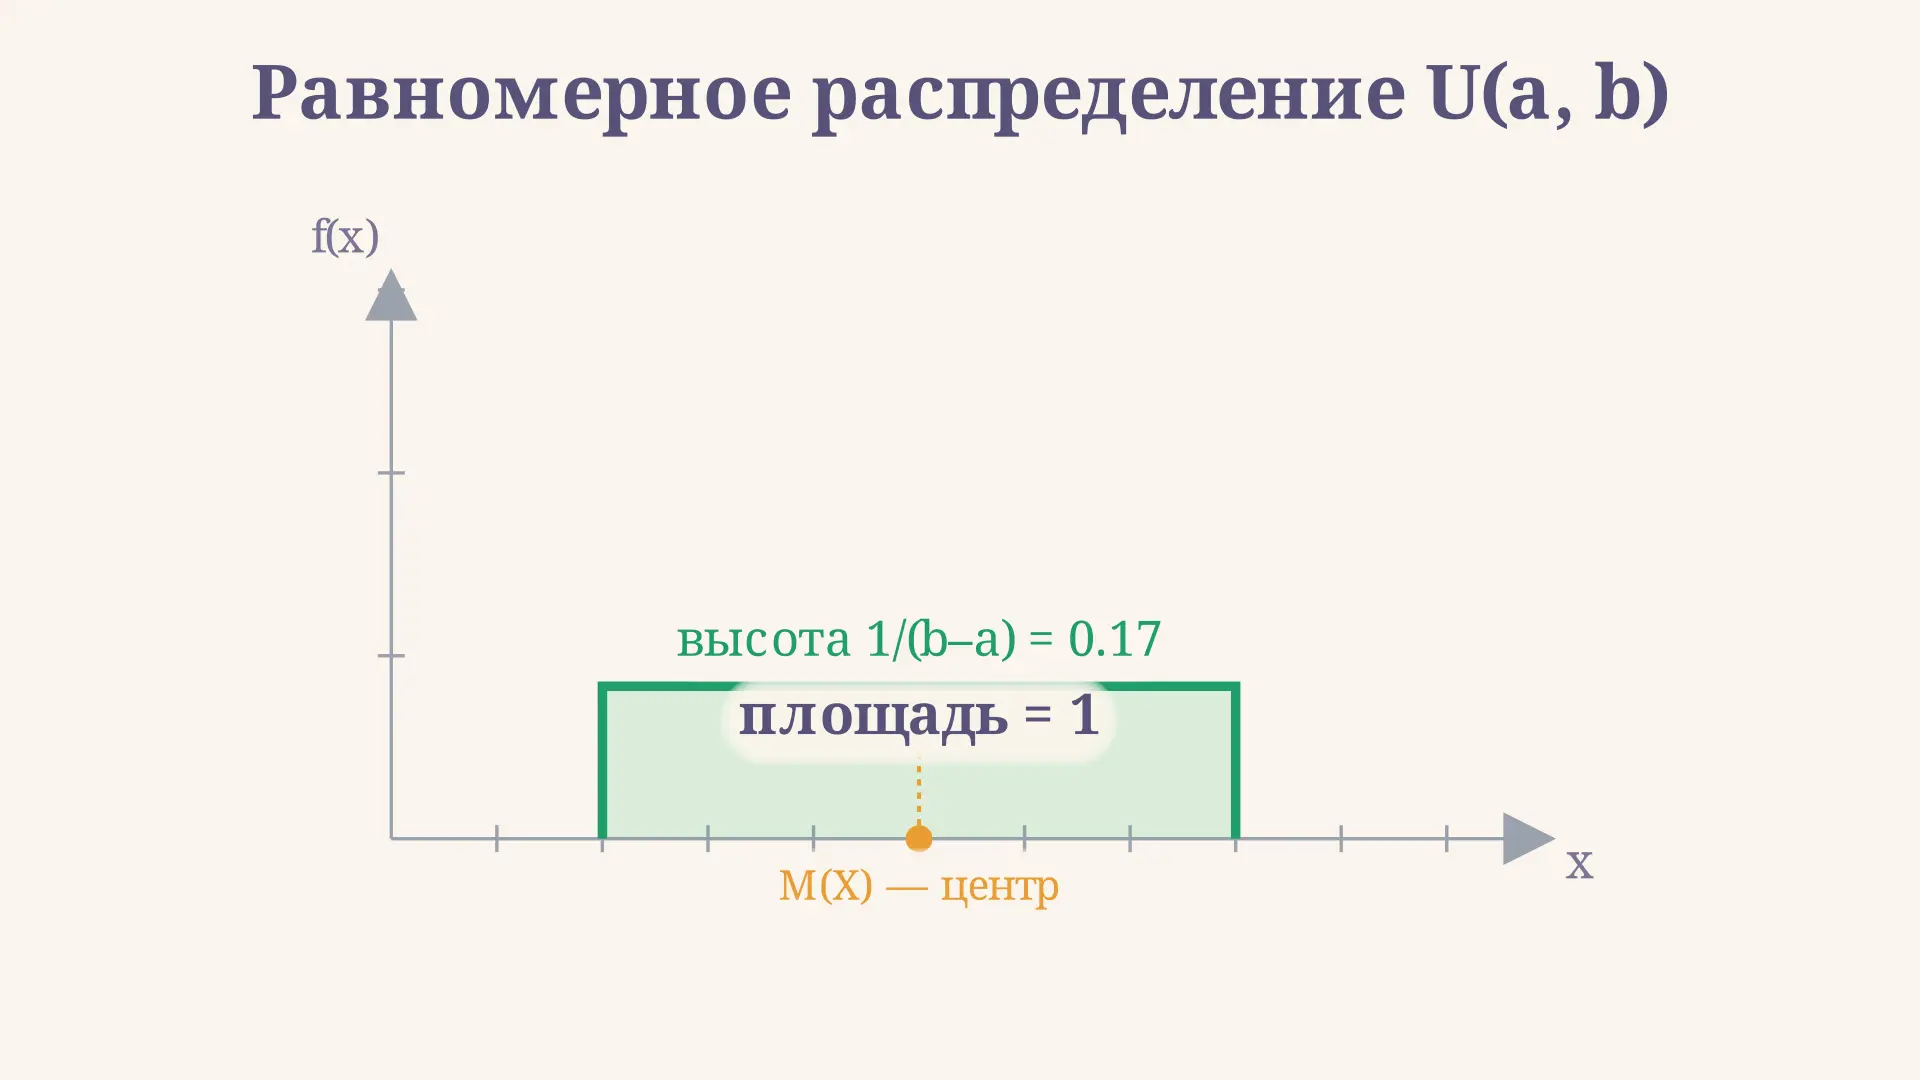
Равномерное распределение случайной величины: формулы
Равномерное распределение непрерывной случайной величины простыми словами: плотность и функция распределения, мат. ожидание, дисперсия и вероятность попадания на отрезок с примером решения.