Коэффициент сопряжённости Пирсона: формула и расчёт
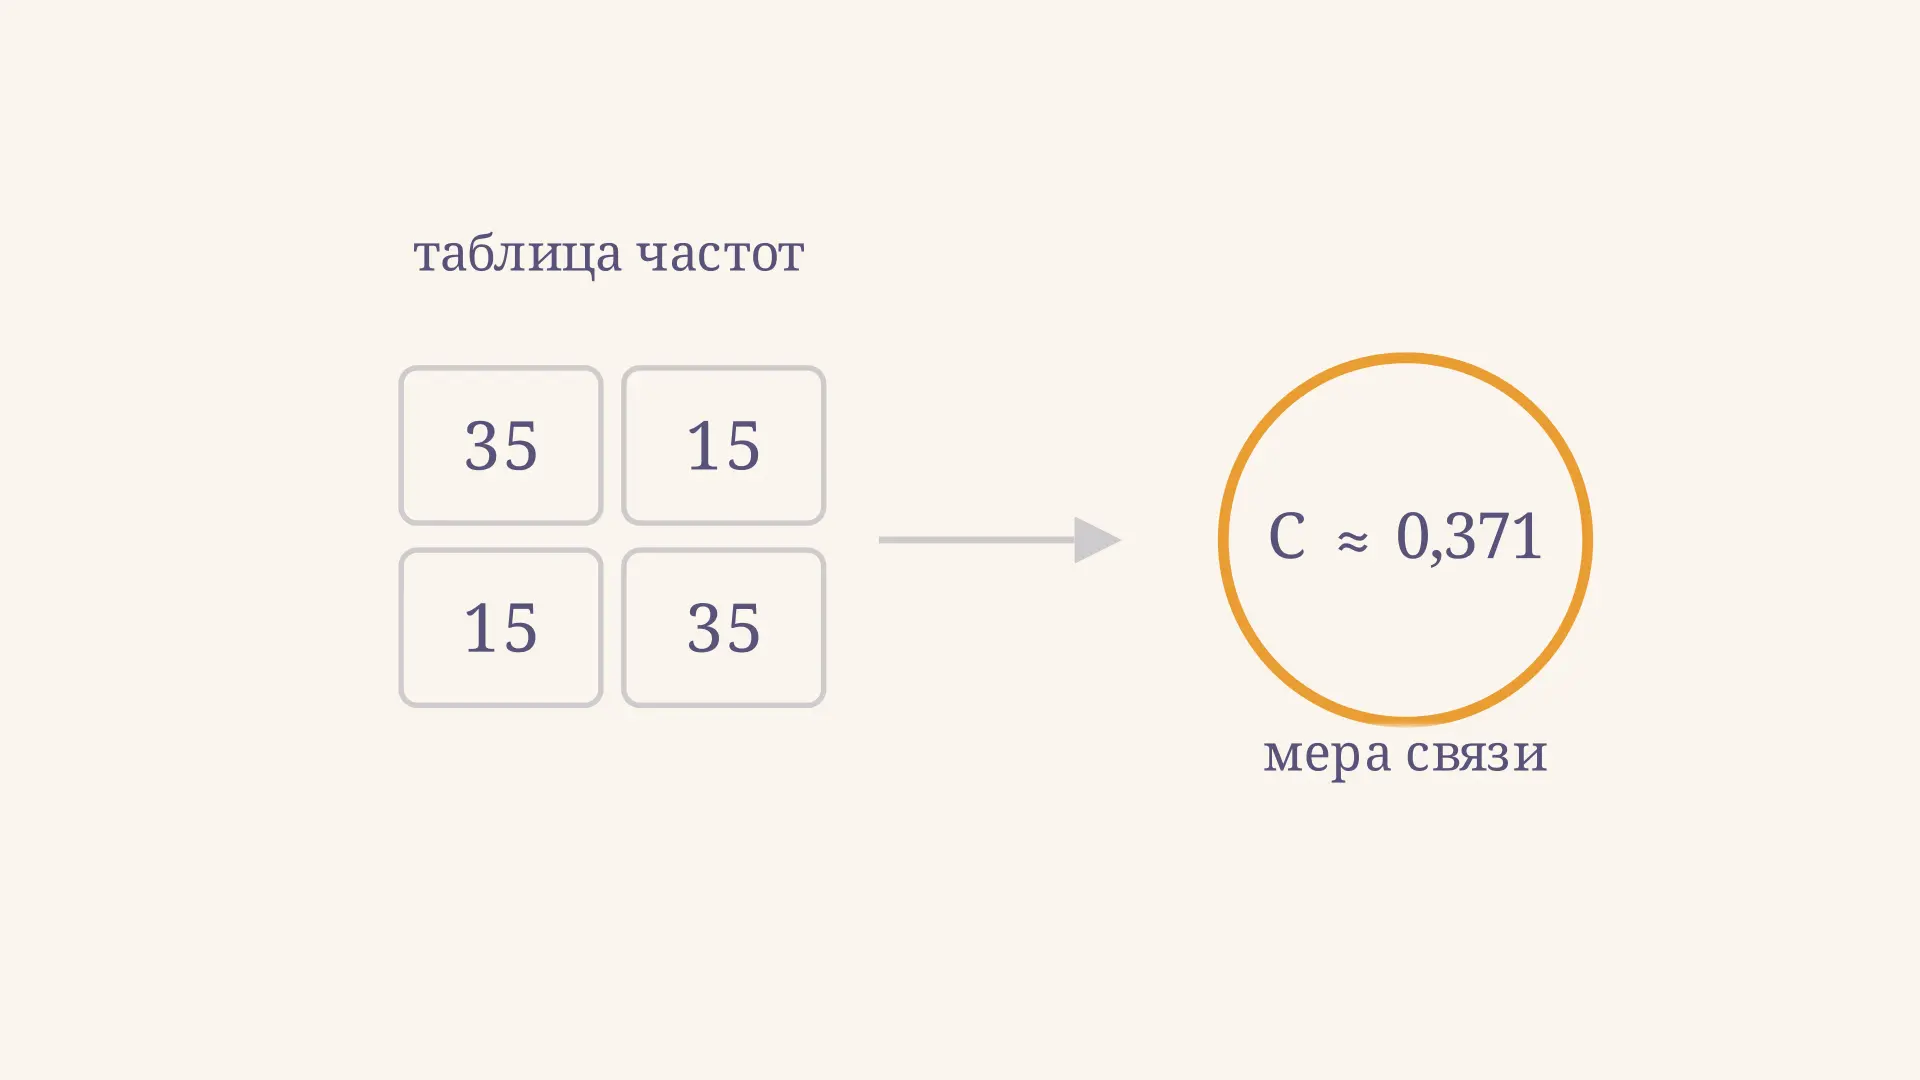
Коэффициент сопряжённости Пирсона измеряет силу статистической связи между двумя категориальными признаками по таблице частот. Он строится из статистики : чем сильнее наблюдаемые частоты отклоняются от ожидаемых при независимости, тем больше . Например, экономист может сопоставить тип магазина и решение о покупке, не присваивая категориям произвольные числовые оценки. Ниже разберём расчёт, предел показателя и его отличие от проверки гипотезы. В учебной модели измените отклонение и посмотрите, как перестраивается таблица.
Когда применяют показатель
Таблица сопряжённости классифицирует одни и те же наблюдения сразу по двум признакам. Строки могут обозначать тип магазина А и Б, а столбцы - покупку и отсутствие покупки. В каждой ячейке записывают число наблюдений, а не проценты. Один покупатель в нашем примере попадает ровно в одну ячейку. Условимся, что данные вымышленные и нужны только для демонстрации вычислений.
Вопрос состоит в том, одинаковы ли распределения результата покупки по типам магазинов. При независимости доля покупок в каждой строке равна общей доле покупок. Совпадение наблюдаемых и ожидаемых частот даёт ; расхождение увеличивает показатель. Это описание связи в таблице, а не доказательство того, что тип магазина вызвал покупку: состав посетителей и другие обстоятельства тоже могут различаться.
Категориям не нужен естественный порядок, поэтому метод подходит, например, для групп по способу оплаты и типу товара. Для количественных переменных иной вопрос решает выборочный коэффициент корреляции: он характеризует линейную связь числовых значений и может иметь знак. Одноимённость не делает эти показатели взаимозаменяемыми.
Формула и ожидаемые частоты
Пусть - наблюдаемая частота в строке и столбце , и - соответствующие итоги, - общий объём. При гипотезе независимости ожидаемая частота равна
Она показывает, сколько наблюдений ожидалось бы в ячейке при тех же итогах строк и столбцов и независимости признаков. Ожидаемое значение может быть дробным: это расчётная величина, а не фактическое число людей. По всем ячейкам считают статистику Пирсона без поправки на непрерывность:
Каждый вклад неотрицателен: отклонения разных знаков не гасят друг друга. Деление на ожидаемую частоту учитывает масштаб ячейки. Формула требует положительных ожидаемых частот; пустую строку или столбец сначала следует исключить из рассмотрения или пересмотреть категории. Порядок вычисления ожидаемых частот и статистики также описан в справочнике NIST.
Пример расчёта по шагам
Пусть в двух типах магазинов рассмотрели по 50 независимых покупательских посещений. Результаты учебного примера:
| Тип магазина | Покупка | Нет покупки | Всего |
|---|---|---|---|
| А | 35 | 15 | 50 |
| Б | 15 | 35 | 50 |
| Всего | 50 | 50 | 100 |
- Общее число наблюдений . Итоги каждого столбца и строки равны 50.
- Для любой ячейки .
- Четыре отклонения равны , , и . Вклад каждой ячейки равен .
- Следовательно, , а .
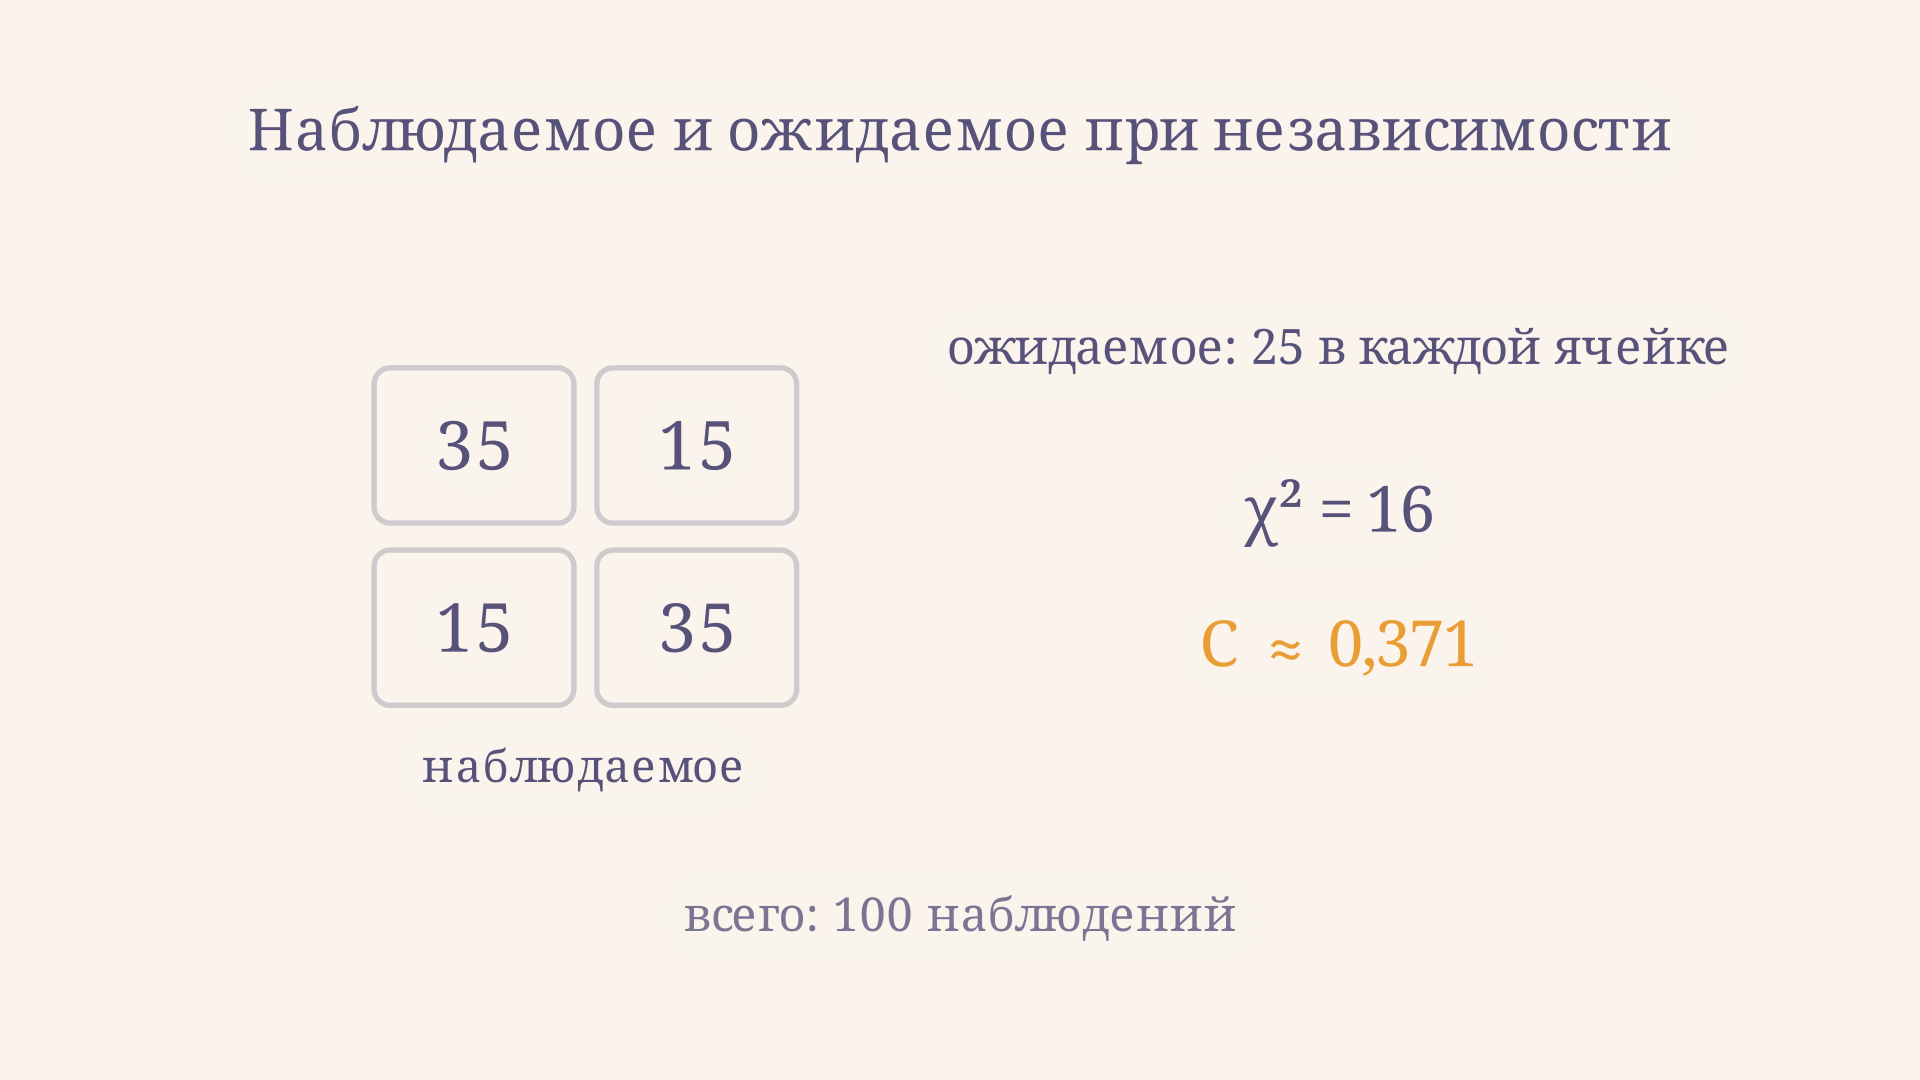
В магазине А покупки составляют 35 из 50 посещений, в Б - 15 из 50. Именно эти исходные доли позволяют понять, как различаются группы; сам содержит только сводную величину расхождения и не показывает, в какой строке доля выше. При замене местами строк или столбцов значение не изменится. Поэтому после расчёта всегда полезно вернуться к таблице и сравнить доли по строкам.
Калькулятор выше задаёт частоты как , , , . При он воспроизводит пример. При все четыре значения равны 25, и . При диагональные ячейки равны 50, остальные нулю: , . Эта симметричная модель полезна для понимания формулы, но не заменяет произвольную таблицу данных.
Как интерпретировать значение и его максимум
не бывает отрицательным: это мера величины связи без направления. Нуль означает точное совпадение наблюдаемых частот с ожидаемыми в данной таблице. В выборке значение, близкое к нулю, само по себе не доказывает независимость во всей генеральной совокупности. Для вывода о ней нужны дизайн выборки, проверка гипотезы и оценка неопределённости.
В отличие от привычной шкалы от нуля до единицы, верхняя граница зависит от размера таблицы. Если - меньшее из числа строк и столбцов, общая верхняя граница равна
Для таблицы это ; для - . При заданных неравных итогах таблицы достижимый максимум может быть ниже общей границы. Поэтому нельзя автоматически читать как «связь на 70,7 %» или сравнивать такие значения в таблицах разной размерности без оговорок. Нет универсального порога «сильной» связи: важны контекст, распределение и цель анализа.
Для сравнения таблиц разного размера часто используют Крамера, который нормирует с учётом меньшего числа категорий. Для таблицы 2×2 также используют коэффициент . У каждой меры свои условия и смысл; при выборе важно назвать точную формулу. Описания показателей на основе приведены в документации SAS.
Что проверить до расчёта
Начните с единицы наблюдения. Если изучается решение посетителя, нужно определить, что именно считается посещением и может ли один человек появиться в таблице несколько раз. Затем заранее задайте категории и убедитесь, что они не пересекаются: каждое наблюдение должно попадать только в одну ячейку. Пропущенные ответы нельзя автоматически приравнивать к отсутствию покупки. Их число и способ обработки стоит сообщить отдельно, поскольку исключение может изменить состав сравниваемых групп.
Далее проверьте итоги строк и столбцов. Ожидаемые частоты рассчитывают именно по ним, а не по предположению, что все ячейки всегда одинаковы. В нашем симметричном примере в каждой получается 25 только потому, что все четыре итога равны 50. Например, если в одной строке 60 из 100 наблюдений, а в столбце 40, то соответствующее ожидаемое значение составит . Ожидаемые значения в других ячейках нужно посчитать отдельно.
Сохраните исходную таблицу вместе с результатом. Одинаковый коэффициент может возникнуть при разных распределениях по категориям, поэтому одного числа недостаточно для содержательного вывода. Полезная форма отчёта включает названия признаков, наблюдаемые частоты, объём, размер таблицы и вычисленный ; если проводился тест, отдельно указывают статистику, степени свободы и -значение. Для экономического решения дополнительно важен масштаб различия долей и то, насколько выборка представляет интересующую совокупность.
Если категории объединяют ради устойчивости расчёта, объединение должно иметь предметный смысл и быть обосновано до интерпретации результата. Разные способы группировки могут изменить и таблицу, и коэффициент. Не стоит выбирать вариант только потому, что он даёт более выразительное значение: лучше показать правило группировки и при необходимости сравнить разумные варианты как анализ чувствительности.
Связь с проверкой гипотезы
Коэффициент описывает величину расхождения, тогда как критерий независимости отвечает на другой вопрос: насколько такие данные совместимы с гипотезой независимости при принятой вероятностной модели. Для обычного критерия Пирсона статистику сравнивают с распределением хи-квадрат со степенями свободы , где и - число строк и столбцов. О чтении критических значений см. таблицу распределения хи-квадрат.
Для нашего примера степень свободы равна 1; статистика 16 даёт малое -значение при стандартной модели независимых наблюдений. Однако значимость не означает существенный практический эффект, а отсутствие значимости не доказывает независимость. Если пропорционально увеличить все частоты, останется прежним, но вырастет вместе с объёмом: одинаковая описательная связь может давать разную убедительность свидетельств.
При применении критерия нужны независимые наблюдения и достаточно большие ожидаемые частоты для приближения распределением . При малых ожидаемых значениях следует рассмотреть точный метод, например тест Фишера для таблицы 2×2, и учитывать схему отбора. NIST отдельно отмечает важность достаточных ожидаемых частот. Повторные покупки одного человека нельзя просто считать независимыми без подходящей модели.
Частые ошибки
- Подставлять проценты вместо частот. Для нужен объём наблюдений: одинаковые проценты при разных дают разную статистику.
- Путать с линейным коэффициентом Пирсона. У нет знака; он относится к таблице категорий.
- Считать единицу обязательным максимумом. Граница зависит от числа категорий, а при фиксированных итогах может быть ещё ниже.
- Выводить причинность из связи. Таблица показывает совместное распределение, но не устраняет влияние третьих факторов.
- Округлять каждый промежуточный шаг. Сохраняйте точность ожидаемых частот и округляйте итог в конце.
FAQ
Можно ли получить отрицательный коэффициент?
Нет. Квадратный корень в формуле неотрицателен. Чтобы увидеть характер различий, изучают доли и отклонения отдельных ячеек от ожидаемых частот.
Можно ли применять коэффициент к порядковым категориям?
Да, если рассматривать их как категории, но не использует информацию об их порядке. Для ранговых данных может быть полезна корреляция Спирмена при подходящей постановке задачи. Другой вариант для порядковых данных - коэффициент Кендалла, основанный на сравнении пар наблюдений.
Равен ли нулю при независимости?
В точном распределении независимость даёт нулевое значение меры. В конечной случайной выборке частоты обычно немного отклоняются от ожидаемых даже при независимости, поэтому выборочный может быть больше нуля.
Коротко
Коэффициент сопряжённости Пирсона превращает расхождение наблюдаемых и ожидаемых частот в неотрицательную меру связи. Для примера с 100 посещениями и . При интерпретации смотрите на размер таблицы, исходные доли, схему сбора данных и отдельно решайте задачу статистической значимости.
Читайте также
Таблица сопряжённости и критерий хи-квадрат Пирсона
Как проверить независимость признаков по таблице сопряжённости: ожидаемые частоты, расчёт хи-квадрат Пирсона, степени свободы, p-значение и ограничения метода.
Выборочный коэффициент корреляции: формула и расчёт
Разбираем, как вычислить выборочный коэффициент корреляции Пирсона по формуле r = Sxy / sqrt(Sxx * Syy): таблица отклонений, пример расчёта, связь с регрессией и коэффициентом детерминации.
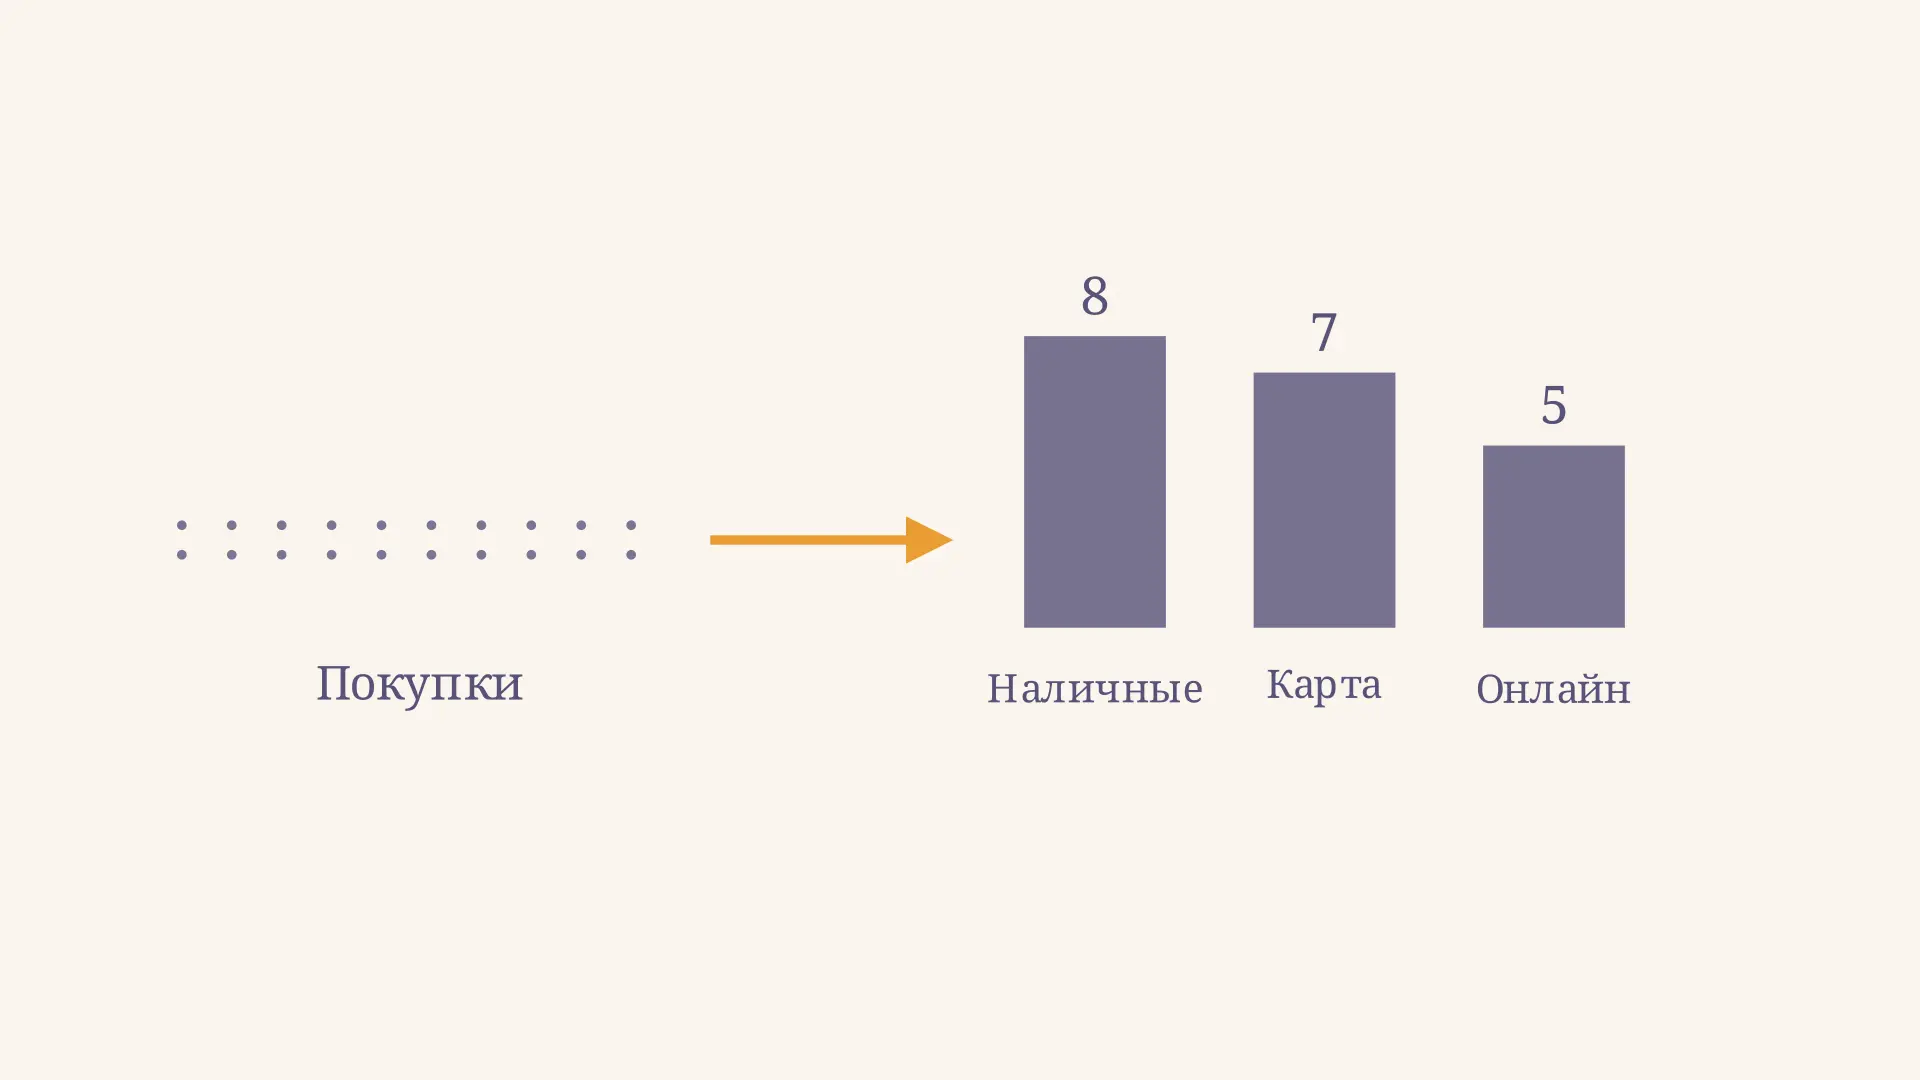
Атрибутивный ряд распределения: пример и расчёт
Атрибутивный ряд распределения в статистике: как выделить качественный признак, подсчитать частоты и доли, построить диаграмму и найти моду на примере покупок.
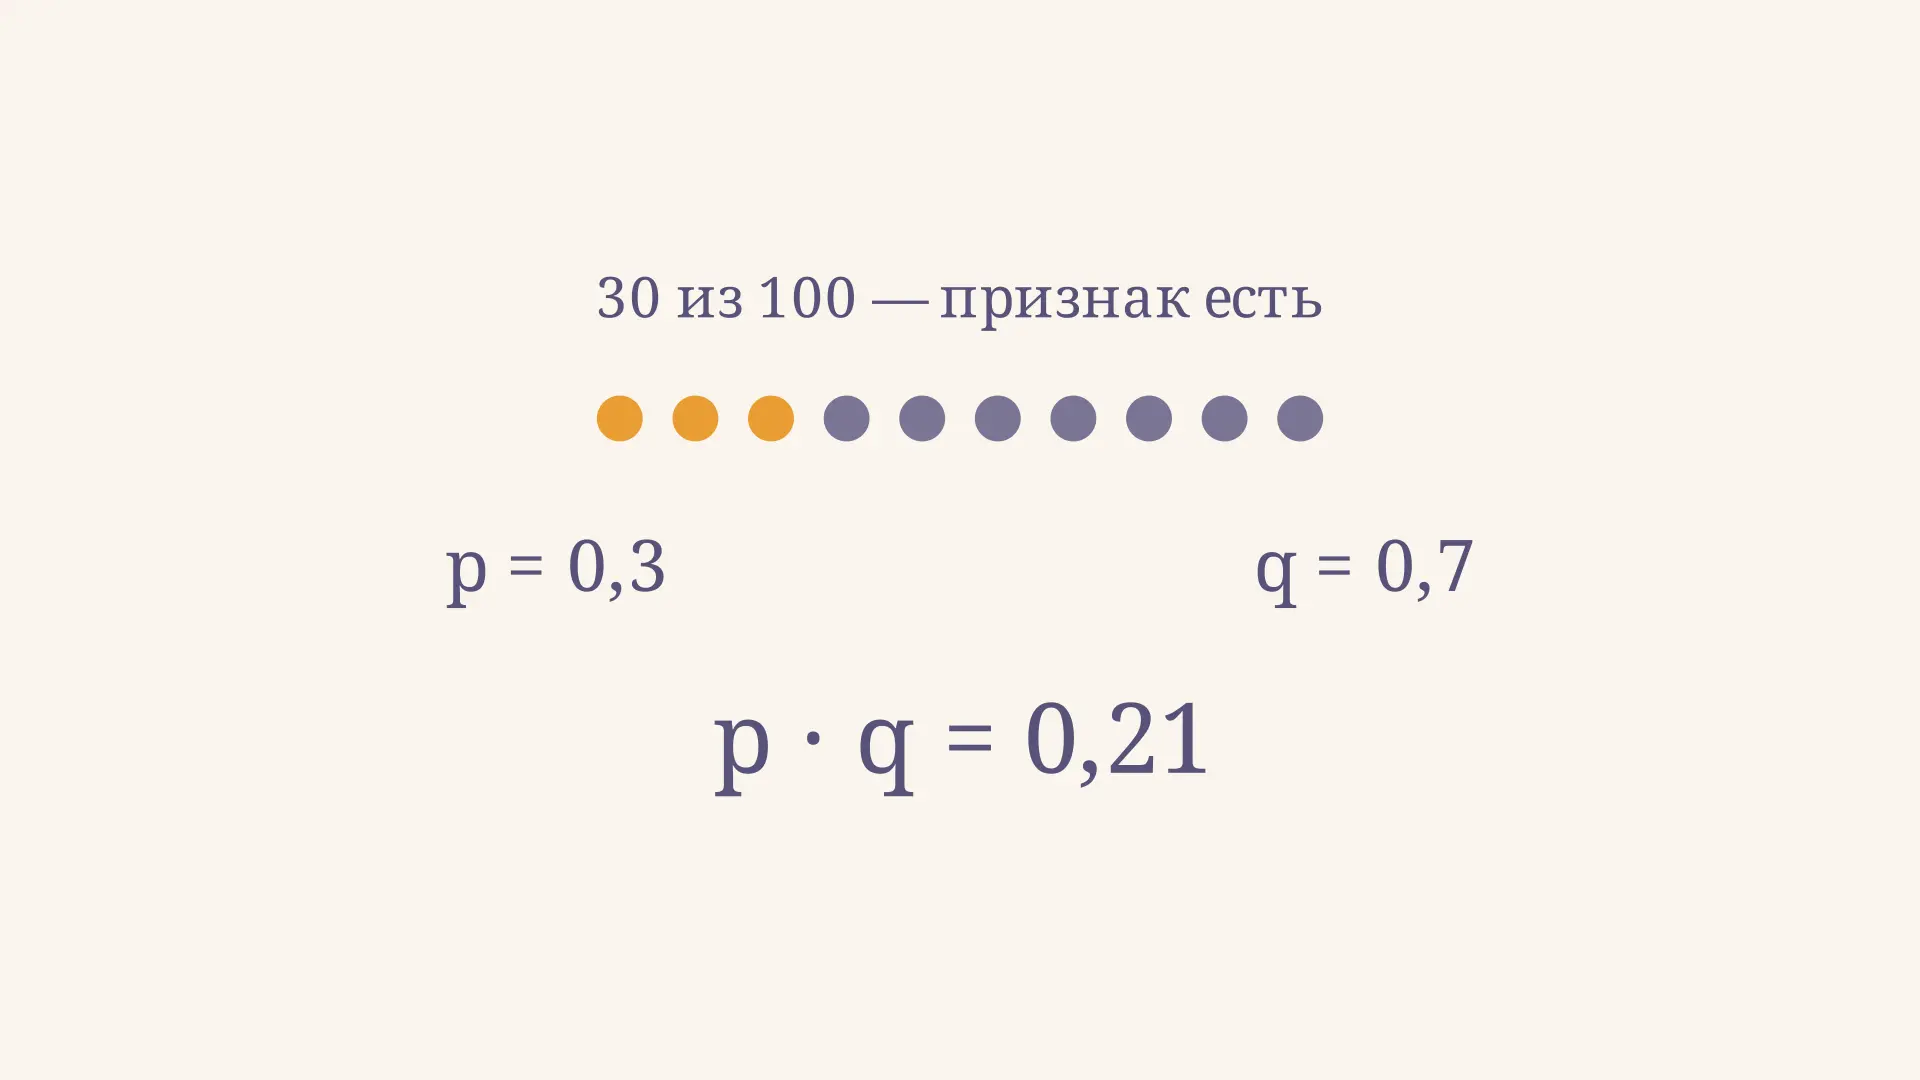
Дисперсия альтернативного признака: формула и пример
Как найти дисперсию альтернативного признака по доле или частотам, почему её максимум равен 0,25 и чем разброс единичного признака отличается от ошибки доли.
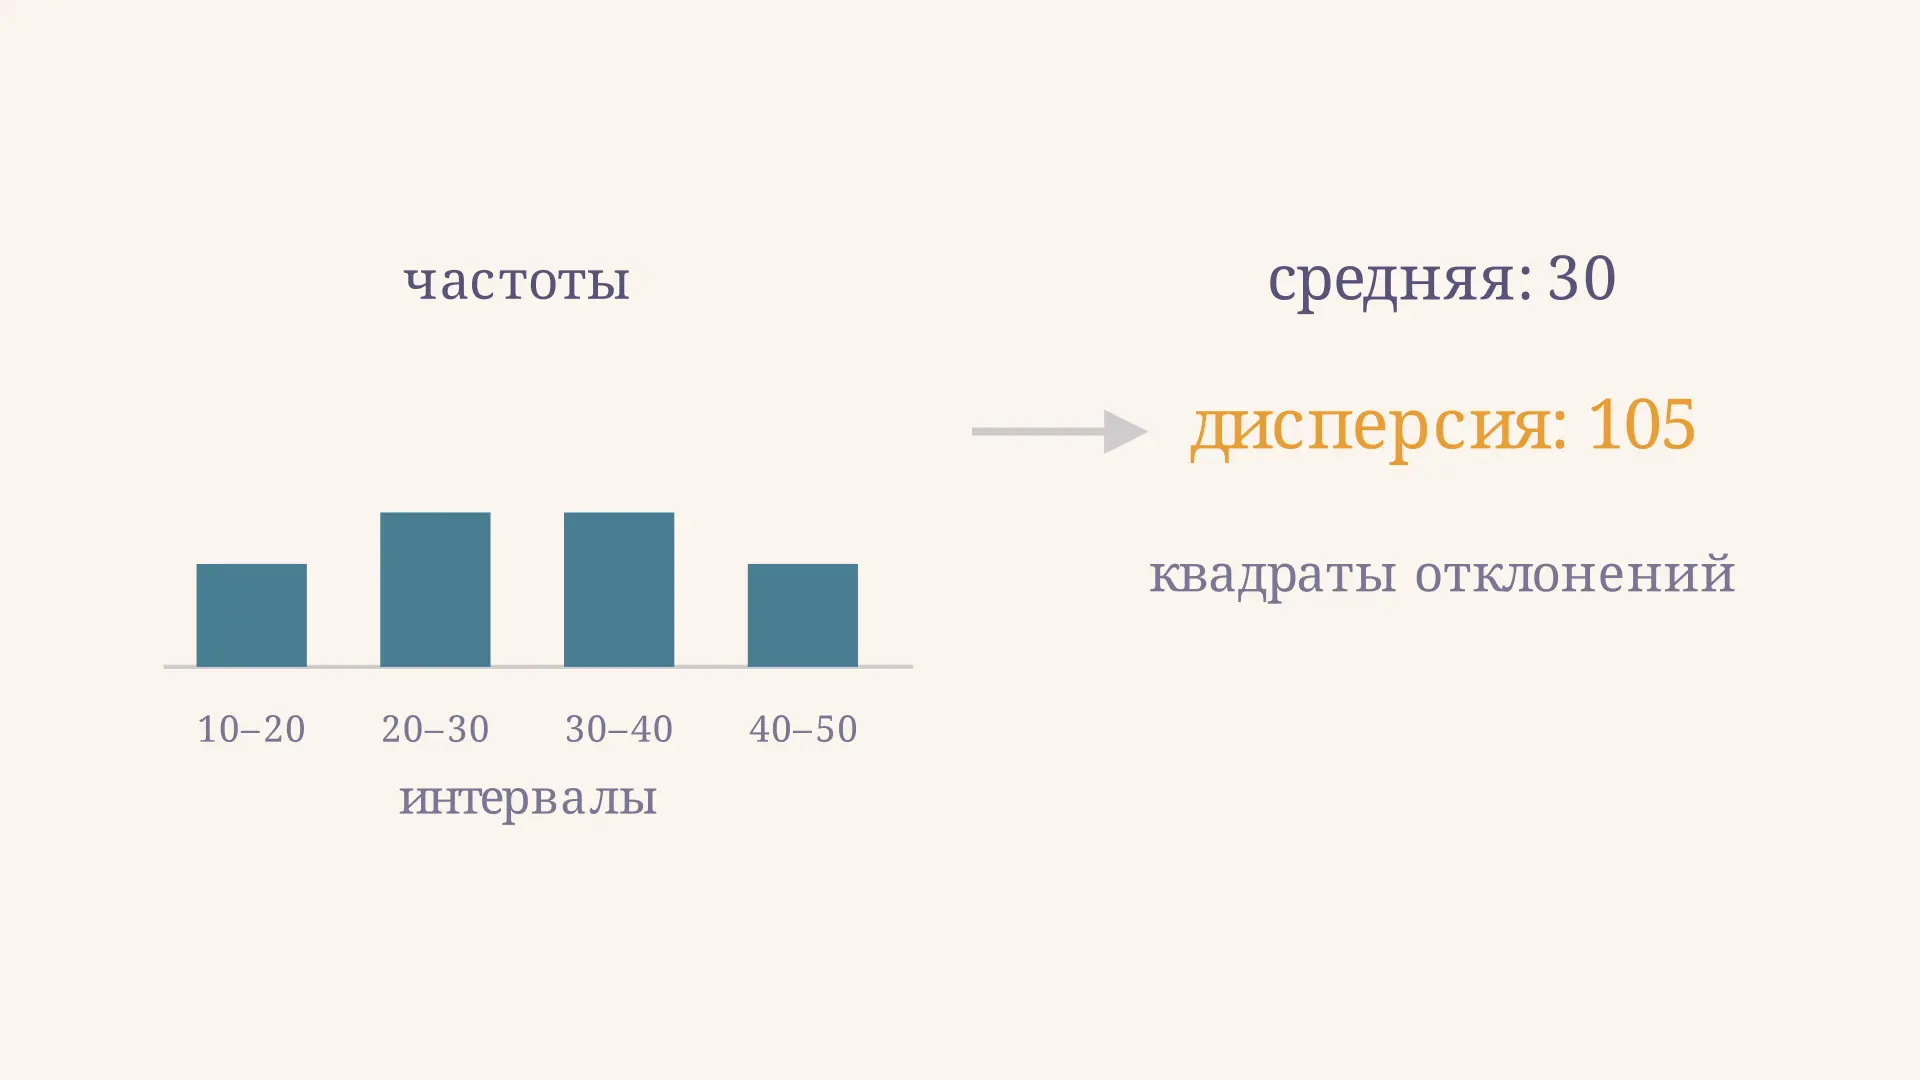
Дисперсия интервального вариационного ряда: расчёт
Как найти дисперсию интервального вариационного ряда по серединам и частотам: подробная таблица, две формулы, исправленная оценка и ограничения группировки.
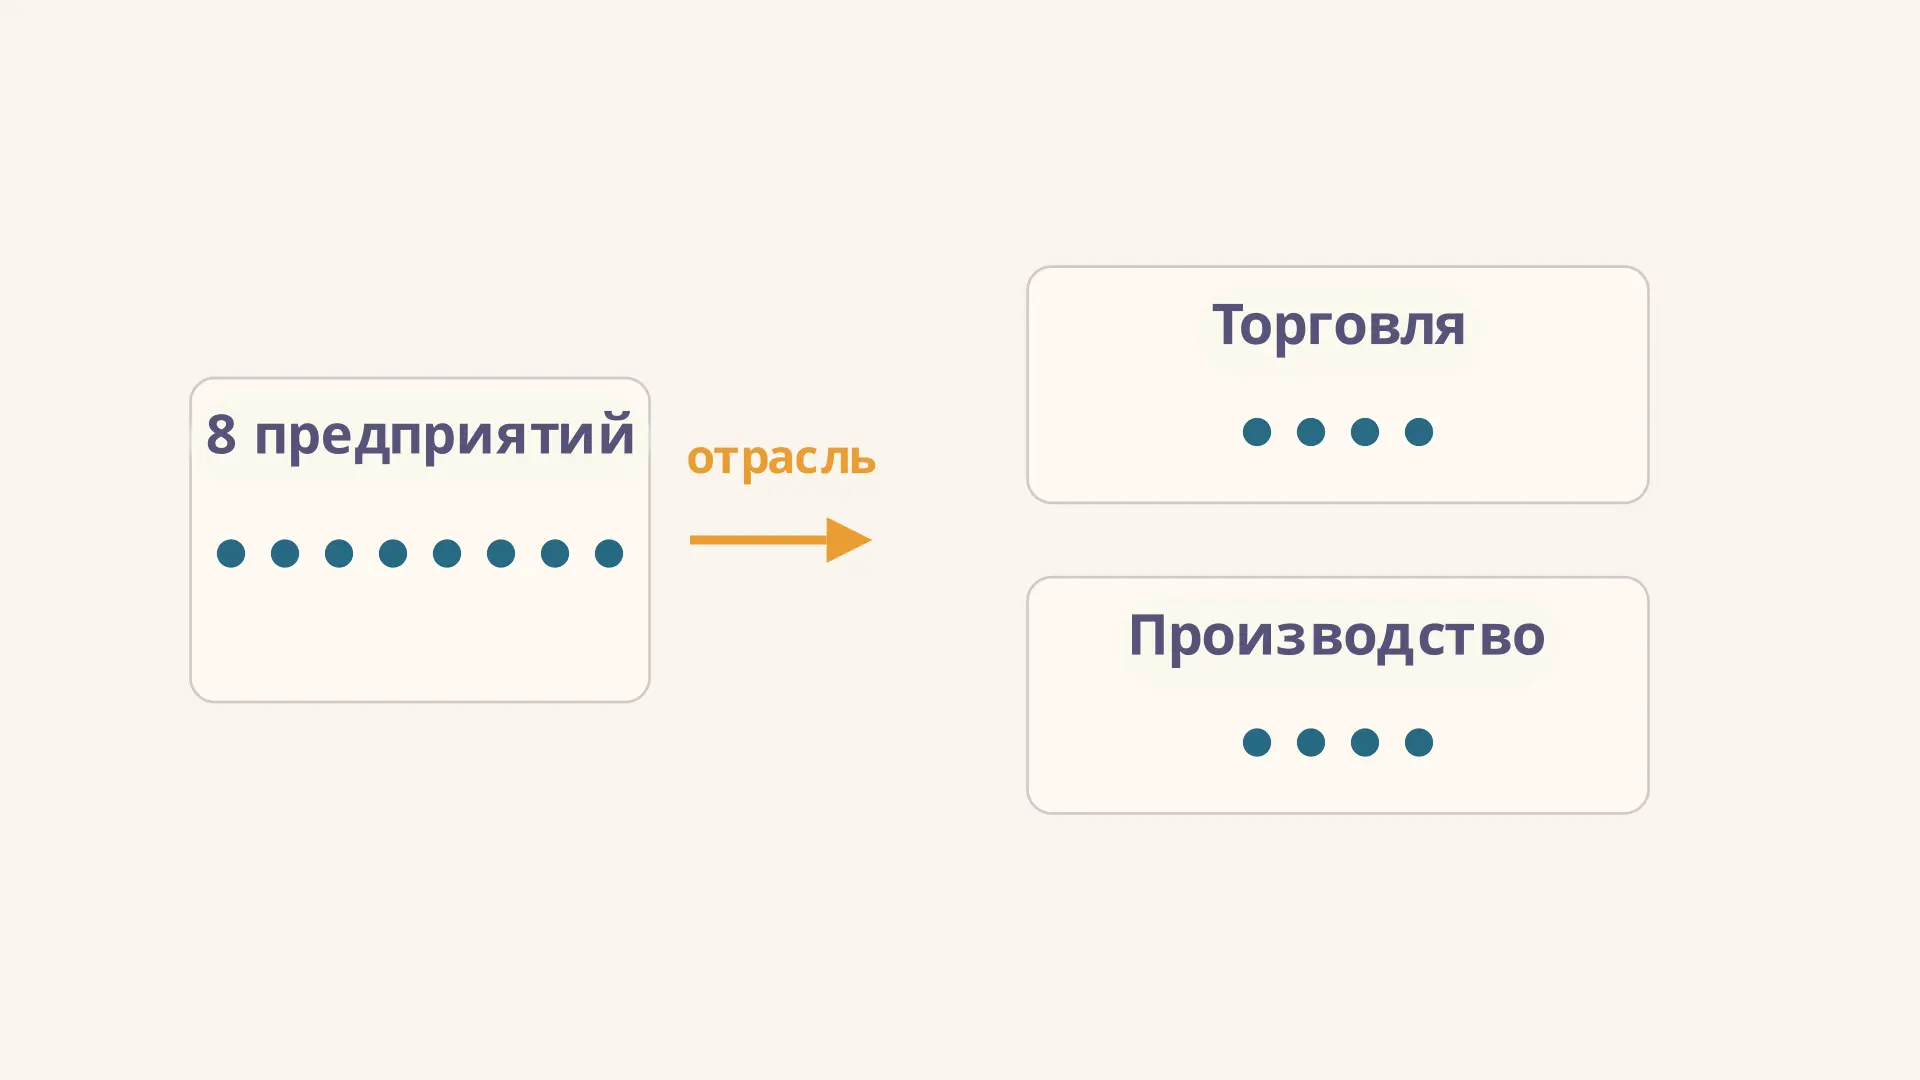
Группировочный признак: выбор и примеры в статистике
Что такое группировочный признак, как выбрать качественное или количественное основание группировки и проверить границы и состав групп на примере предприятий.