Алгоритм k-means: кластеризация по шагам
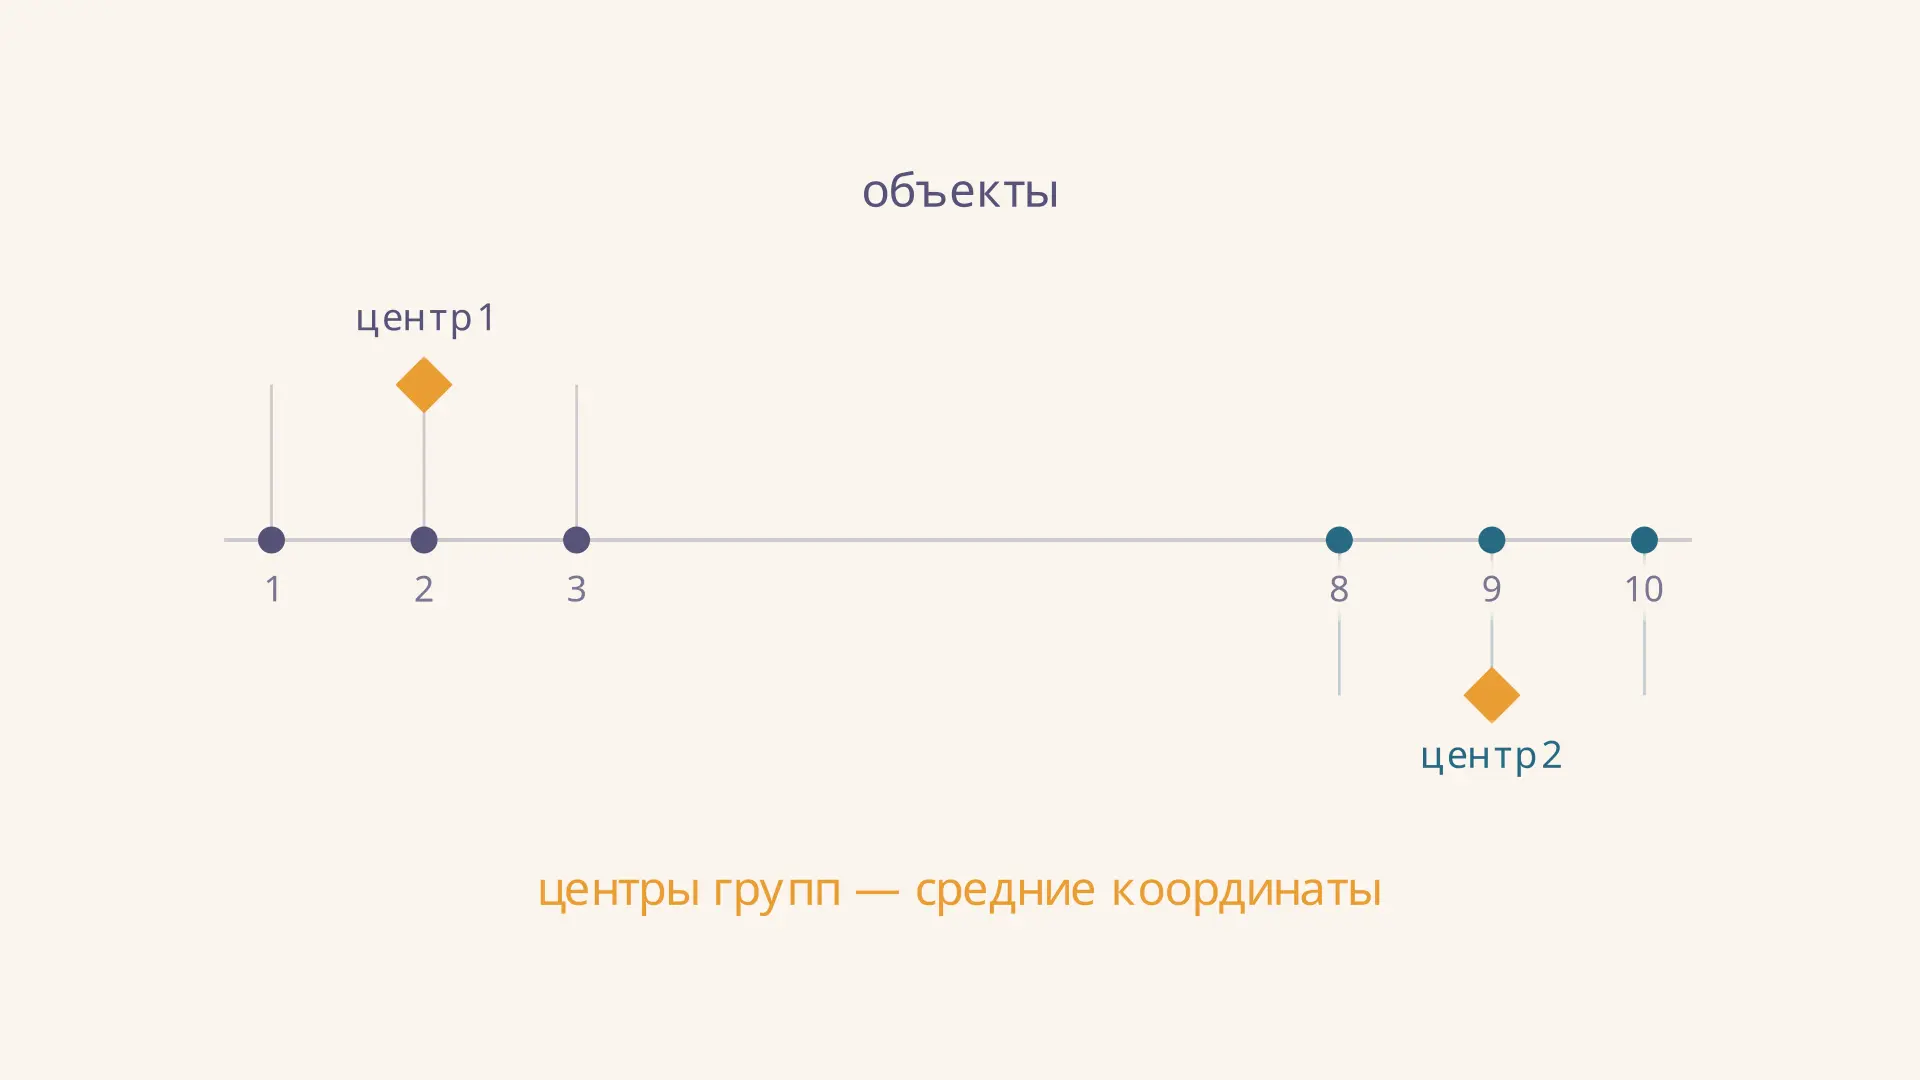
Алгоритм k-means, или метод средних, разбивает числовые объекты на заранее заданное число групп. Он попеременно относит каждую точку к ближайшему центру и сдвигает центры в среднее положение своих групп. Так можно, например, исследовать похожие профили покупателей или сжать палитру изображения. Ниже разберём вычисления на шести точках, а в интерактивном примере можно самому переключить этапы и увидеть, как меняется сумма квадратов расстояний.
Что ищет метод k средних
Пусть каждый объект задан вектором числовых признаков , например частотой и суммой покупок. Выбираем число групп и обозначаем их центры через . Для разбиения метод стремится уменьшить сумму квадратов евклидовых расстояний от объектов до центров:
Эту величину называют внутрикластерной суммой квадратов или инерцией. Меньшее означает, что точки ближе к назначенным центрам в выбранных единицах измерения. Само по себе оно не доказывает, что группы полезны или соответствуют реальным категориям. Центроид - средний вектор группы; он не обязан совпадать с одним из исходных объектов.
Кластеризация относится к обучению без учителя: готовые правильные метки групп алгоритму не передают. Это отличается, например, от AdaBoost, который строит ансамбль классификаторов по размеченным данным. Названия групп в k-means условны: перестановка номеров ничего не меняет.
Два шага одной итерации
Сначала выбирают начальных центров. Затем повторяют два действия. На шаге назначения каждая точка получает номер ближайшего центра. На шаге обновления центр каждой непустой группы заменяют средним её точек. Останавливаются, когда назначения перестали меняться, центры сдвигаются меньше заданного допуска или достигнут лимит итераций.
Почему процедура улучшает критерий? При фиксированных центрах назначение ближайшему из них не увеличивает вклад ни одной точки. При фиксированных непустых группах именно среднее минимизирует сумму квадратов расстояний до их точек. Поэтому каждый из двух шагов не увеличивает . Но у задачи может быть несколько локальных решений: сходимость не гарантирует, что найден лучший результат среди всех возможных разбиений. Это свойство и зависимость результата от старта описаны в конспекте Стэнфордского университета.
Если группа опустела, её среднее не определено. Реализация должна явно обработать такую ситуацию, например переинициализировать центр; конкретное правило зависит от программы. При равных расстояниях также нужно постоянное правило выбора, иначе результаты на границе могут различаться.
Пример расчёта вручную
Возьмём учебные точки на одной прямой: . Положим , начальные центры равны и . Точку, равноудалённую от центров, относим к первому. При таком назначении получаем группы и . Начальный критерий равен
Теперь найдём среднее каждой группы: и . При прежних назначениях сумма квадратов становится . Это ещё не конец: точка теперь ближе к , чем к , и переходит в первую группу. При неизменных центрах критерий уменьшается до .
Пересчитываем средние для групп и : центры равны и . Получаем . Повторное назначение ничего не меняет, значит в этом примере алгоритм сошёлся.
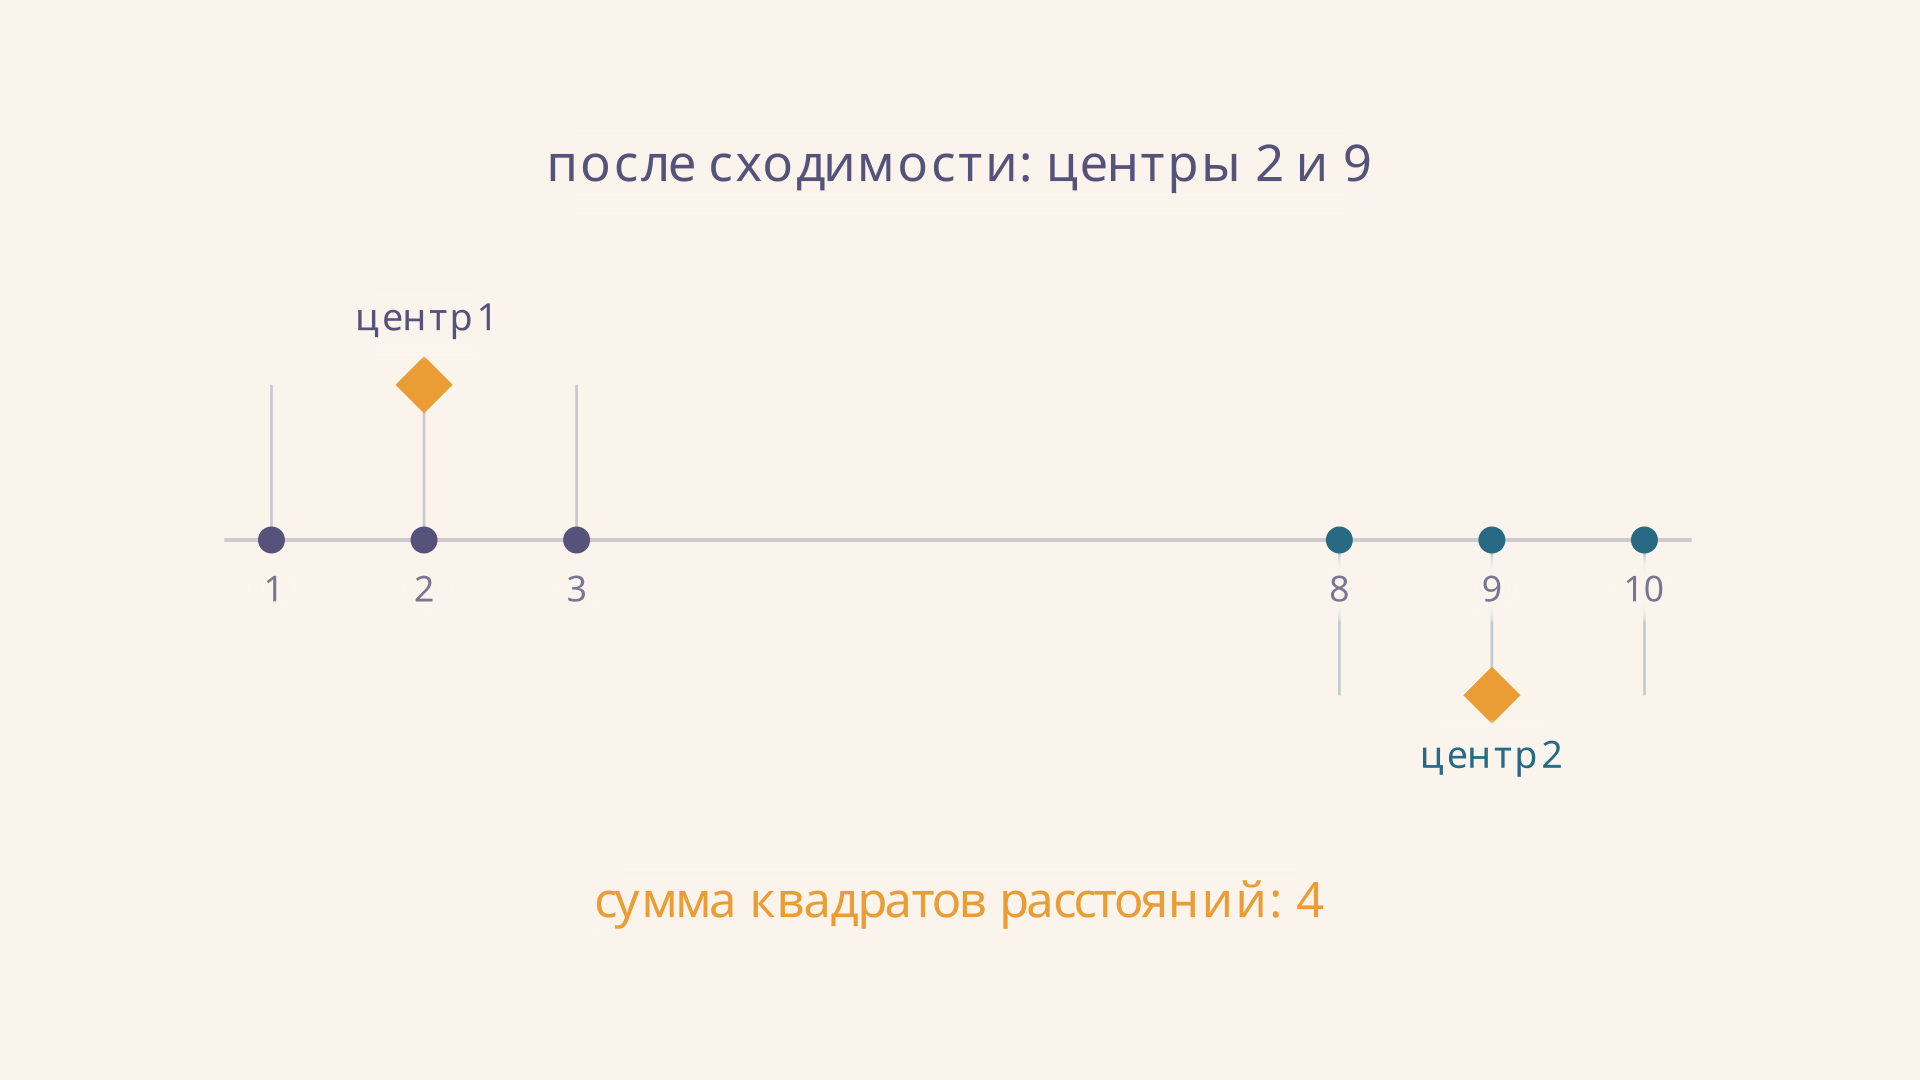
Важна последовательность: после перемещения центров состав групп обновляется заново. Поэтому число относится к новым центрам и старым назначениям, а - к тем же центрам после переназначения. В интерактиве это разные положения ползунка.
Как выбрать начальные центры
Случайный старт прост, но два центра могут оказаться рядом и привести алгоритм к неудачному локальному решению. Обычно запускают процедуру несколько раз с разными начальными центрами и оставляют результат с наименьшей инерцией. Это повышает шансы найти хороший ответ, хотя не даёт универсальной гарантии глобального оптимума.
Метод k-means++ выбирает первый центр случайно, а следующие - случайно с вероятностями, зависящими от квадрата расстояния до ближайшего уже выбранного центра. Так удалённые точки чаще становятся кандидатами на центр. Инициализация подробнее разобрана в оригинальной работе о k-means++. Для воспроизводимости фиксируют генератор случайных чисел, число запусков, правило остановки и подготовку признаков.
Как выбрать число кластеров
задаёт исследователь: обычный k-means не определяет его автоматически. Часто сравнивают результаты для нескольких значений. В методе локтя строят график от и ищут место, после которого добавление группы даёт заметно меньший выигрыш. Локоть может быть невыразительным, а инерция сама по себе благоприятствует большему числу центров: при оптимальном решении она не возрастает с ростом .
Другой ориентир - силуэт: он сопоставляет среднее расстояние точки до членов своей группы со средним расстоянием до ближайшей другой группы. Значения ближе к единице указывают на хорошее разделение по выбранной метрике, около нуля - на пограничное положение, отрицательные - на возможное неверное назначение. Силуэт имеет смысл при наличии хотя бы двух и менее чем непустых групп и тоже не заменяет предметную проверку.
Сравнивайте устойчивость групп между запусками и их интерпретируемость. Если важна вся иерархия объединений, а не одно разбиение при фиксированном , полезно рассмотреть иерархическую кластеризацию и дендрограмму.
Как интерпретировать найденные группы
После обучения недостаточно посмотреть только на номера кластеров. Для каждой группы полезно вывести число объектов, средние и медианные значения исходных признаков, а также разброс. Сравнение с показателями всей выборки показывает, чем группа выделяется. Например, кластер с высокой средней суммой покупки может содержать несколько очень крупных заказов; медиана и квантили помогут это заметить. Для описания людей или событий лучше вернуться к исходным единицам, даже если алгоритм работал со стандартизированными признаками.
Затем проверьте несколько объектов около каждого центра и около границ групп. Близкий к центру объект иллюстрирует типичный профиль лишь в смысле выбранного расстояния; пограничный может легко перейти в другую группу после небольшого изменения данных. Если признаки или их веса меняются, повторите анализ и сравните состав групп, а не только значения инерции. При сравнении независимых запусков номера центров могут поменяться местами, поэтому сопоставлять нужно сами группы.
Для новых наблюдений сохраняют параметры подготовки, рассчитанные на обучающей выборке, и применяют то же преобразование к новым данным. Затем каждую новую точку можно отнести к ближайшему сохранённому центру. Но если данные со временем заметно изменились, старые центры могут перестать описывать их структуру. Тогда полезно заново оценить масштаб признаков, качество разбиения и необходимость переобучения. Группы остаются исследовательским инструментом: их названия и практические выводы следует проверять на предметном материале.
Подготовка данных и ограничения
Евклидово расстояние чувствительно к масштабу. Если доход измеряется тысячами, а возраст десятками, первый признак может доминировать только из-за единиц. Стандартизация по среднему и стандартному отклонению часто делает вклады признаков сопоставимее, но выбор преобразования зависит от задачи. Посмотрите на пропуски, выбросы и распределения до расчёта: квадрат расстояния особенно усиливает влияние удалённых точек.
K-means наиболее естественно описывает компактные группы вокруг средних. Изогнутые, вложенные друг в друга группы или сильно различающиеся плотности могут разделиться не так, как ожидает исследователь. Категориальные значения нельзя просто закодировать числами и считать, что расстояние между кодами имеет содержательный смысл. При большом числе признаков полезно изучить представление данных; метод главных компонент помогает исследовать направления изменчивости, хотя проекция в две координаты может скрыть часть структуры.
Для точек, центров и признаков прямое назначение стоит порядка за итерацию; полная стоимость зависит ещё от числа итераций и запусков. Для очень больших наборов применяют варианты с мини-пакетами, понимая, что их результат и траектория могут отличаться. Визуальные проекции, например UMAP, полезны для исследования, но расстояния на двумерной картинке не всегда сохраняют расстояния исходного пространства.
Частые ошибки
- Считать центроид обязательным объектом выборки. Среднее может находиться между наблюдениями и даже не описывать возможный реальный объект.
- Выбирать только по минимальному . При добавлении центров критерий обычно падает; нужна проверка качества разделения и пользы групп.
- Забывать о масштабе и выбросах. Изменение единиц или одна далёкая точка способны заметно сдвинуть центры.
- Принимать один запуск за окончательный ответ. Сравните несколько инициализаций и проверьте устойчивость состава групп.
FAQ
Можно ли использовать k-means для категориальных данных?
Обычная формулировка рассчитана на числовые векторы, среднее и евклидово расстояние. Для категорий нужны осмысленное представление признаков и подходящая мера сходства либо другой метод.
Обязательно ли кластеры имеют одинаковый размер?
Нет, ограничение на одинаковое число точек не задано. Однако критерий суммы квадратов может плохо отражать структуру групп с сильно различающейся плотностью и формой.
Что означает ?
Все точки попадают в одну группу, а её центр - среднее всей выборки. Это полезная базовая точка для сравнения инерции с разбиениями на большее число групп.
Коротко
K-means чередует назначение ближайшему центру и пересчёт средних, уменьшая сумму квадратов расстояний. Результат зависит от числа групп, масштаба признаков и начальных центров. Проверка нескольких запусков, структуры данных и смысла полученных групп делает выводы надёжнее.
Читайте также
Алгоритм ID3: как построить дерево решений
Алгоритм ID3 строит дерево решений по информационному выигрышу. Разбираем энтропию, выбор признака, пример расчёта, условия остановки и ограничения метода.
Метрика precision recall: точность и полнота
Метрики precision и recall показывают качество положительных ответов классификатора. Разбираем формулы, выбор порога, PR-кривую и влияние редкого класса на примерах.
Регуляризация Elastic Net: формула и пример расчёта
Регуляризация Elastic Net объединяет L1 и L2: разберём формулу, расчёт коэффициентов, настройку параметров, масштабирование данных и работу с коррелирующими признаками.
ROC-кривая и AUC: построение и смысл метрики
Как построить ROC-кривую по оценкам классификатора, вычислить AUC методом трапеций, выбрать порог и понять ограничения метрики на несбалансированных данных.
Классификация снимков: этапы, методы и оценка
Как работает классификация снимков: выбор классов, подготовка данных, обучение модели и оценка ошибок. Учебный пример для проверки качества классификатора.
Дивергенция Кульбака-Лейблера: смысл и расчёт
Дивергенция Кульбака-Лейблера простыми словами: формула и пример расчёта для двух исходов, асимметрия, нулевые вероятности и связь с энтропией и обучением моделей.