Классификация снимков: этапы, методы и оценка
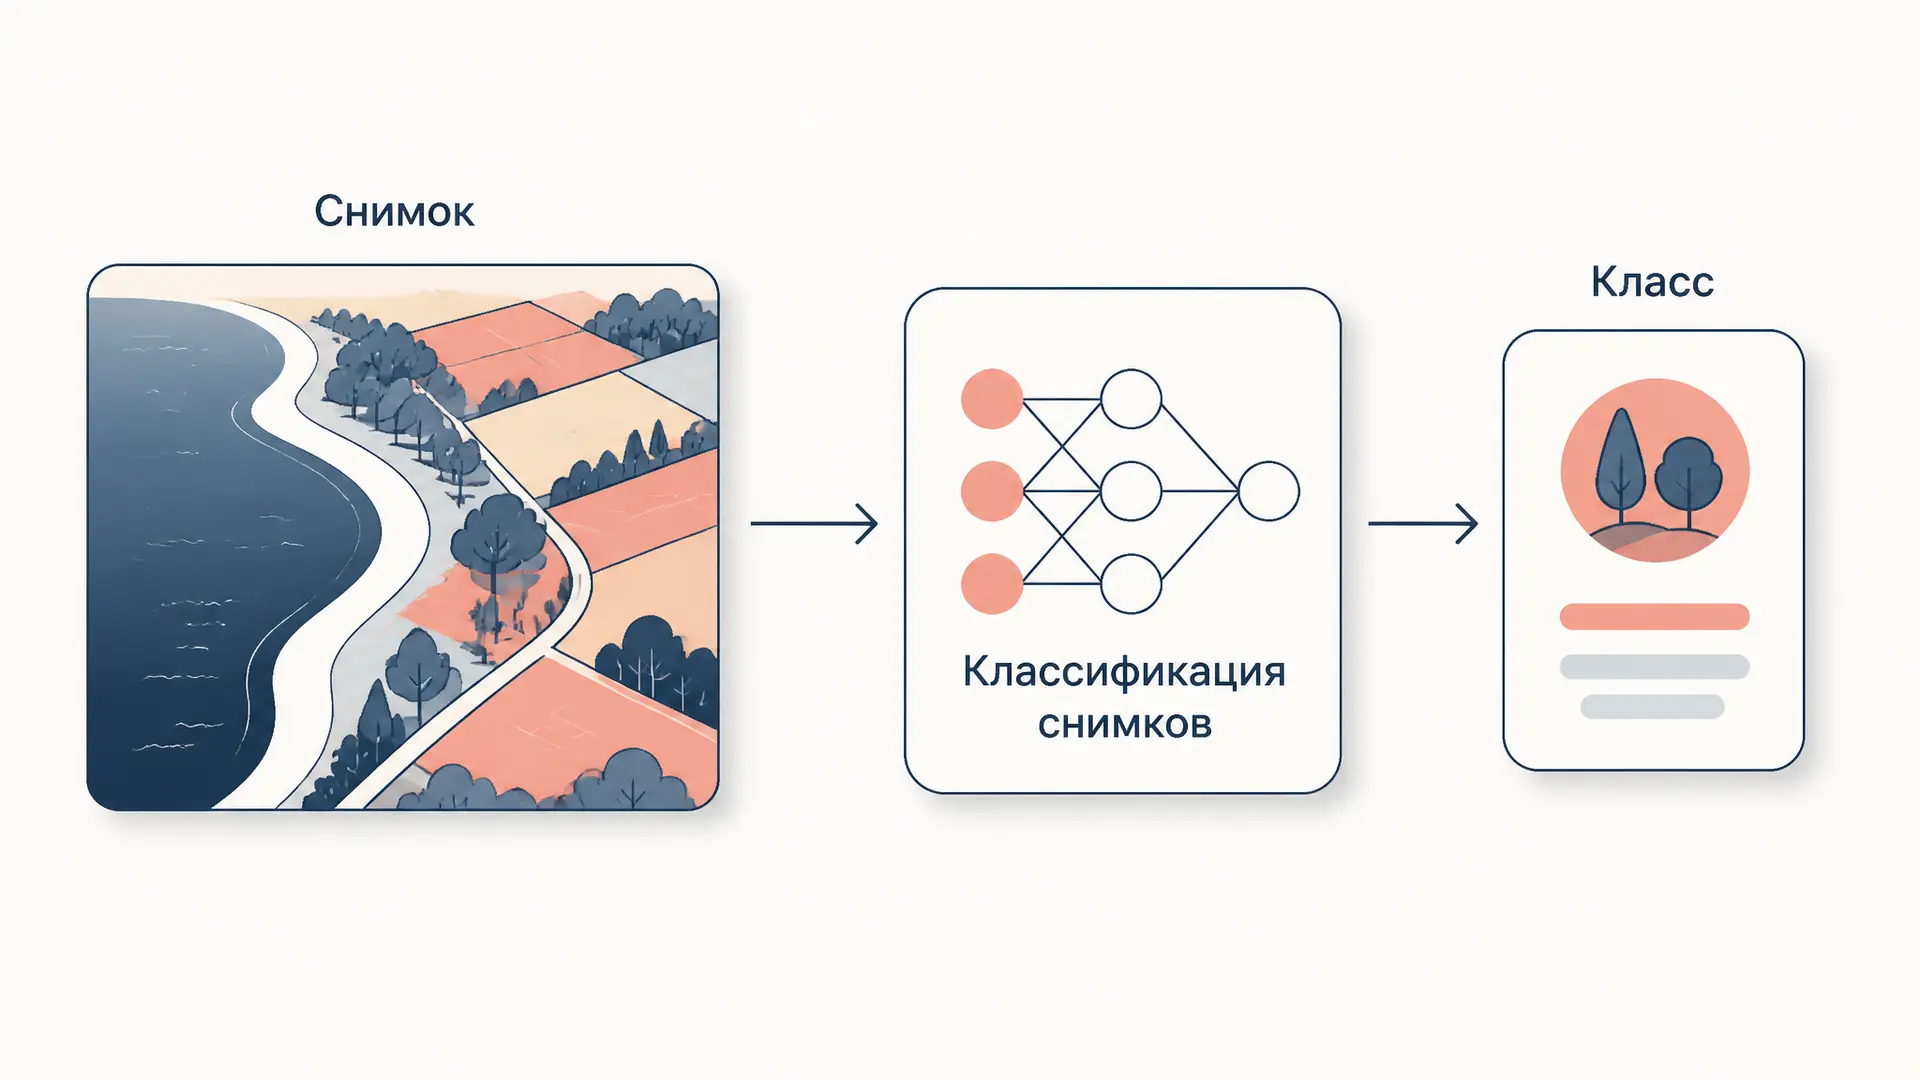
Классификация снимков отвечает на вопрос: к какому из заранее заданных классов относится изображение? На производстве это может быть снимок исправной детали или детали с дефектом, в дистанционном зондировании - фрагмент территории с водой, лесом или застройкой. Модель получает массив значений пикселей и возвращает оценку принадлежности к классам. Полезность результата зависит не только от алгоритма, но и от того, как заданы классы, собраны примеры и проверены ошибки.
Как сформулировать задачу
Сначала определяют единицу анализа: весь снимок, вырезанный участок или отдельный пиксель. Допустим, камера снимает каждую деталь отдельно, а задача - направить подозрительные детали на проверку. Тогда каждому снимку можно присвоить одну метку: «дефект есть» или «дефекта нет». Это бинарная классификация. Если классов больше двух и выбирается один, задача многоклассовая; если на одном снимке одновременно допустимы несколько независимых меток, она многометочная.
Классификация целого снимка не говорит, где расположен дефект. Для рамки вокруг него нужна детекция объектов, для контура или карты дефектных пикселей - сегментация. В спутниковом снимке тоже могут соседствовать лес и вода: одна метка на большую сцену скроет эту неоднородность. Выбор масштаба участка и постановки зависит от решения, которое должен принять пользователь.
Границы классов описывают до разметки. Например, нужно установить, считать ли царапину дефектом, что делать с бликом и как пометить снимок, на котором поверхность закрыта. Неопределённые случаи можно выделять для ручной проверки, а не принудительно записывать в один из классов. Если разметчики расходятся, правила уточняют и проверяют на примерах.
Из чего состоит снимок
Цифровой снимок представлен сеткой пикселей. В цветном изображении каждый пиксель обычно содержит несколько каналов; о том, как три канала задают цвет, рассказывает статья про модель RGB. Для других датчиков число и смысл каналов могут отличаться. Важны также пространственное разрешение, освещение, ракурс, формат и возможные искажения.
Одинаковый физический объект при разных условиях выглядит по-разному. Поэтому учебная выборка должна отражать изменения, ожидаемые при работе: например, разные партии деталей, камеры и условия освещения. Если все дефектные детали сняты на тёмном фоне, а исправные - на светлом, модель может выучить фон вместо признаков дефекта. Высокая оценка на похожих снимках тогда не гарантирует успеха на новой линии.
Предобработка приводит данные к ожидаемому формату: например, меняет размер кадра и масштабирует значения каналов. Она не должна случайно уничтожить важную деталь: при слишком сильном уменьшении тонкая трещина может исчезнуть. Правила предобработки сохраняют и применяют одинаково при обучении и использовании модели.
Данные и независимая проверка
Размеченный набор обычно делят на обучающую, валидационную и тестовую части. На первой модель подбирает параметры, на второй выбирают настройки и порог решения, на третьей оценивают итоговый вариант. Руководство Google подчёркивает, что тест должен быть представительным и не содержать дубликатов обучающих примеров.
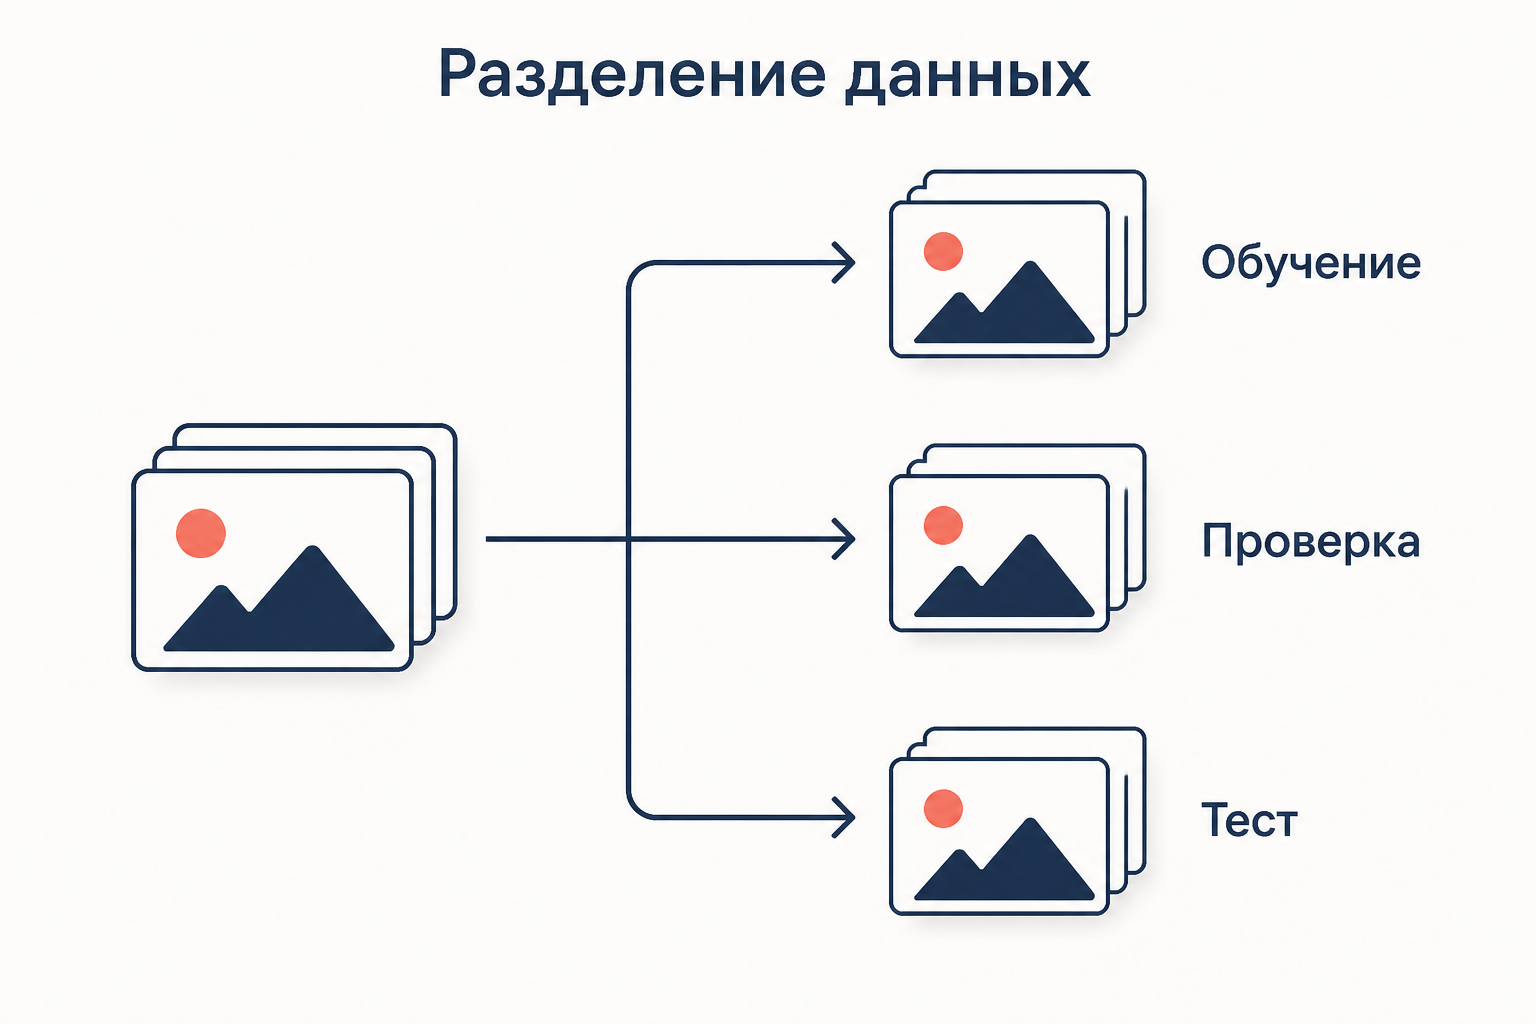
Случайного деления отдельных кадров бывает недостаточно. Если соседние кадры одной детали попадут и в обучение, и в тест, модель встретит почти тот же объект дважды. Группируйте такие кадры по детали до разделения. Для снимков местности аналогично учитывают пересекающиеся участки, время съёмки и территорию: способ деления должен имитировать будущую задачу, например проверку на ранее не виденной области.
Преобразования для расширения обучающей выборки - повороты, изменения яркости, небольшие сдвиги - применяют только когда метка при этом остаётся верной. Не стоит переворачивать изображение, если ориентация имеет значение. Сначала разделяют исходные группы, затем создают варианты внутри обучения: иначе почти одинаковые изображения могут оказаться по разные стороны границы.
При подготовке меток полезно вести журнал происхождения снимков: какая камера использована, когда и где получен кадр, какой объект на нём показан и на каком основании присвоен класс. Эти сведения помогают найти дубликаты и осмысленно сгруппировать данные. Часть разметки можно независимо проверить вторым специалистом, особенно на границе классов. Несогласие не всегда означает чью-то ошибку: иногда оно показывает, что инструкция недостаточно определённа или качество кадра не позволяет уверенно ответить.
В тестовой выборке нужны примеры каждого важного класса и условий съёмки. Если редких дефектов мало, отдельно собранная проверочная подборка поможет изучить такие случаи, но её состав следует указать при интерпретации метрик: частота классов в ней может отличаться от реальной.
Как модель получает ответ
Один подход строит признаки вручную: измеряет цвет, текстуру или форму, а затем передаёт их классификатору. Другой использует нейронную сеть, которая учится извлекать полезные признаки по размеченным примерам. В свёрточной нейронной сети фильтры обрабатывают локальные области и последующие слои объединяют полученную информацию.
При обучении предсказание сравнивается с меткой, функция потерь измеряет расхождение, а параметры модели обновляются. Один из способов обновления описан в статье про оптимизатор Adam. Можно начать с модели, заранее обученной на большом наборе изображений, и дообучить её на своей задаче. Однако сходство исходных и целевых данных, объём разметки и условия применения нужно проверять экспериментально: готовая модель не гарантирует качества.
На выходе модель может давать оценки для каждого класса. В многоклассовом случае softmax преобразует числа в набор значений с суммой один. Наибольшее значение позволяет выбрать класс, но его величина сама по себе не доказывает, что модель правильно оценивает вероятность ошибки: для этого нужна отдельная проверка калибровки.
Как читать матрицу ошибок
Для бинарной задачи выберем положительным классом «дефект есть». После выбора порога сравним ответ модели с проверенной разметкой. Возможны четыре исхода: верно найденный дефект (), ложная тревога (), пропущенный дефект () и верно распознанная исправная деталь (). Матрица ошибок сводит эти количества вместе.
Рассмотрим условный учебный пример, а не результаты эксперимента. В тесте 100 снимков: 20 с дефектом и 80 без него. Модель нашла 18 дефектных, пропустила 2 и ошибочно отметила 8 исправных. Значит, , , , .
| Фактический класс | Модель: дефект | Модель: без дефекта |
|---|---|---|
| Дефект | 18 | 2 |
| Без дефекта | 8 | 72 |
Доля всех верных ответов, accuracy, равна . Но она не показывает отдельно стоимость пропуска дефекта и ложной тревоги. При редком дефекте даже ответ «все исправны» может давать высокую долю совпадений, хотя полезных обнаружений не будет.
Для положительного класса precision и recall отвечают на разные вопросы:
Из всех 26 снимков, отмеченных моделью, 18 действительно содержат дефект; из 20 настоящих дефектов найдены 18. Если пропуск особенно дорог, целесообразно следить за полнотой и выбирать порог с учётом допустимого числа ложных тревог. Порог подбирают на валидации, после чего фиксируют и оценивают на тесте. Результаты также полезно разбить по типам дефектов, камерам и партиям: среднее значение может скрывать слабую группу.
От прототипа к применению
Сначала сравните модель с простым базовым решением и определите, кто проверит спорные случаи. Затем проверьте качество на независимых снимках из условий, близких к реальным. Для небольшого теста сами оценки могут заметно меняться при добавлении нескольких примеров; рядом с метрикой сообщайте размер выборки и, когда возможно, интервал неопределённости.
После запуска следят за изменениями камеры, освещения и состава изделий, а также собирают новые проверенные метки. Если условия изменились, прежняя оценка может перестать отражать качество. Результаты системы контроля разумно связывать с процессом повторной проверки и обновления модели, а не считать разовую точность постоянным свойством алгоритма.
Частые ошибки
- Путать класс и положение объекта. Метка «дефект» не заменяет координаты или маску дефекта.
- Допускать утечку между выборками. Почти одинаковые кадры одной детали следует держать в одной группе.
- Оценивать только accuracy. При дисбалансе классов отдельно смотрят на пропуски и ложные тревоги.
- Подбирать порог по тесту. Для выбора настроек нужна валидация; тест оставляют для итоговой проверки.
- Игнорировать условия съёмки. Камера и фон могут стать случайной подсказкой вместо полезного признака.
FAQ
Чем классификация отличается от сегментации?
Классификация присваивает метку изображению или заранее выбранному участку. Сегментация назначает классы пикселям и показывает, где проходят области.
Можно ли обучить модель без размеченных снимков?
Неразмеченные данные могут помочь получить представления, но для обучения или проверки конкретных целевых классов обычно нужны примеры с надёжными метками. Их объём зависит от задачи и способа обучения.
Что важнее: precision или recall?
Зависит от последствий ошибок. При дорогом пропуске дефекта особенно важна полнота; при дорогих ложных проверках - точность положительных ответов. Компромисс выбирают по условиям применения.
Коротко
Классификация снимков связывает изображение с заданной меткой. Надёжный процесс начинается с определения классов и единицы анализа, продолжается независимым разделением данных и обучением, а заканчивается оценкой нужных ошибок на представительной тестовой выборке. Качество модели зависит от данных и условий её использования не меньше, чем от выбранной архитектуры.
Читайте также
Алгоритм ID3: как построить дерево решений
Алгоритм ID3 строит дерево решений по информационному выигрышу. Разбираем энтропию, выбор признака, пример расчёта, условия остановки и ограничения метода.
Алгоритм k-means: кластеризация по шагам
Алгоритм k-means простыми словами: как точки попадают в кластеры, как пересчитываются центроиды и сумма квадратов, как выбрать число групп и подготовить признаки.
Метрика precision recall: точность и полнота
Метрики precision и recall показывают качество положительных ответов классификатора. Разбираем формулы, выбор порога, PR-кривую и влияние редкого класса на примерах.
Регуляризация Elastic Net: формула и пример расчёта
Регуляризация Elastic Net объединяет L1 и L2: разберём формулу, расчёт коэффициентов, настройку параметров, масштабирование данных и работу с коррелирующими признаками.
ROC-кривая и AUC: построение и смысл метрики
Как построить ROC-кривую по оценкам классификатора, вычислить AUC методом трапеций, выбрать порог и понять ограничения метрики на несбалансированных данных.
Дивергенция Кульбака-Лейблера: смысл и расчёт
Дивергенция Кульбака-Лейблера простыми словами: формула и пример расчёта для двух исходов, асимметрия, нулевые вероятности и связь с энтропией и обучением моделей.