Дивергенция Кульбака-Лейблера: смысл и расчёт
Дивергенция Кульбака - Лейблера показывает, насколько распределение вероятностей отличается от опорного распределения , если усреднять логарифм отношения вероятностей по . Её также называют относительной энтропией и обозначают . Эта величина помогает сравнивать вероятностные модели, но у неё есть особенность: порядок распределений важен. Ниже разберём формулу, пример и случаи, когда ответ становится бесконечным. В калькуляторе можно менять вероятности двух исходов и сразу сравнивать оба направления.
Зачем сравнивать распределения
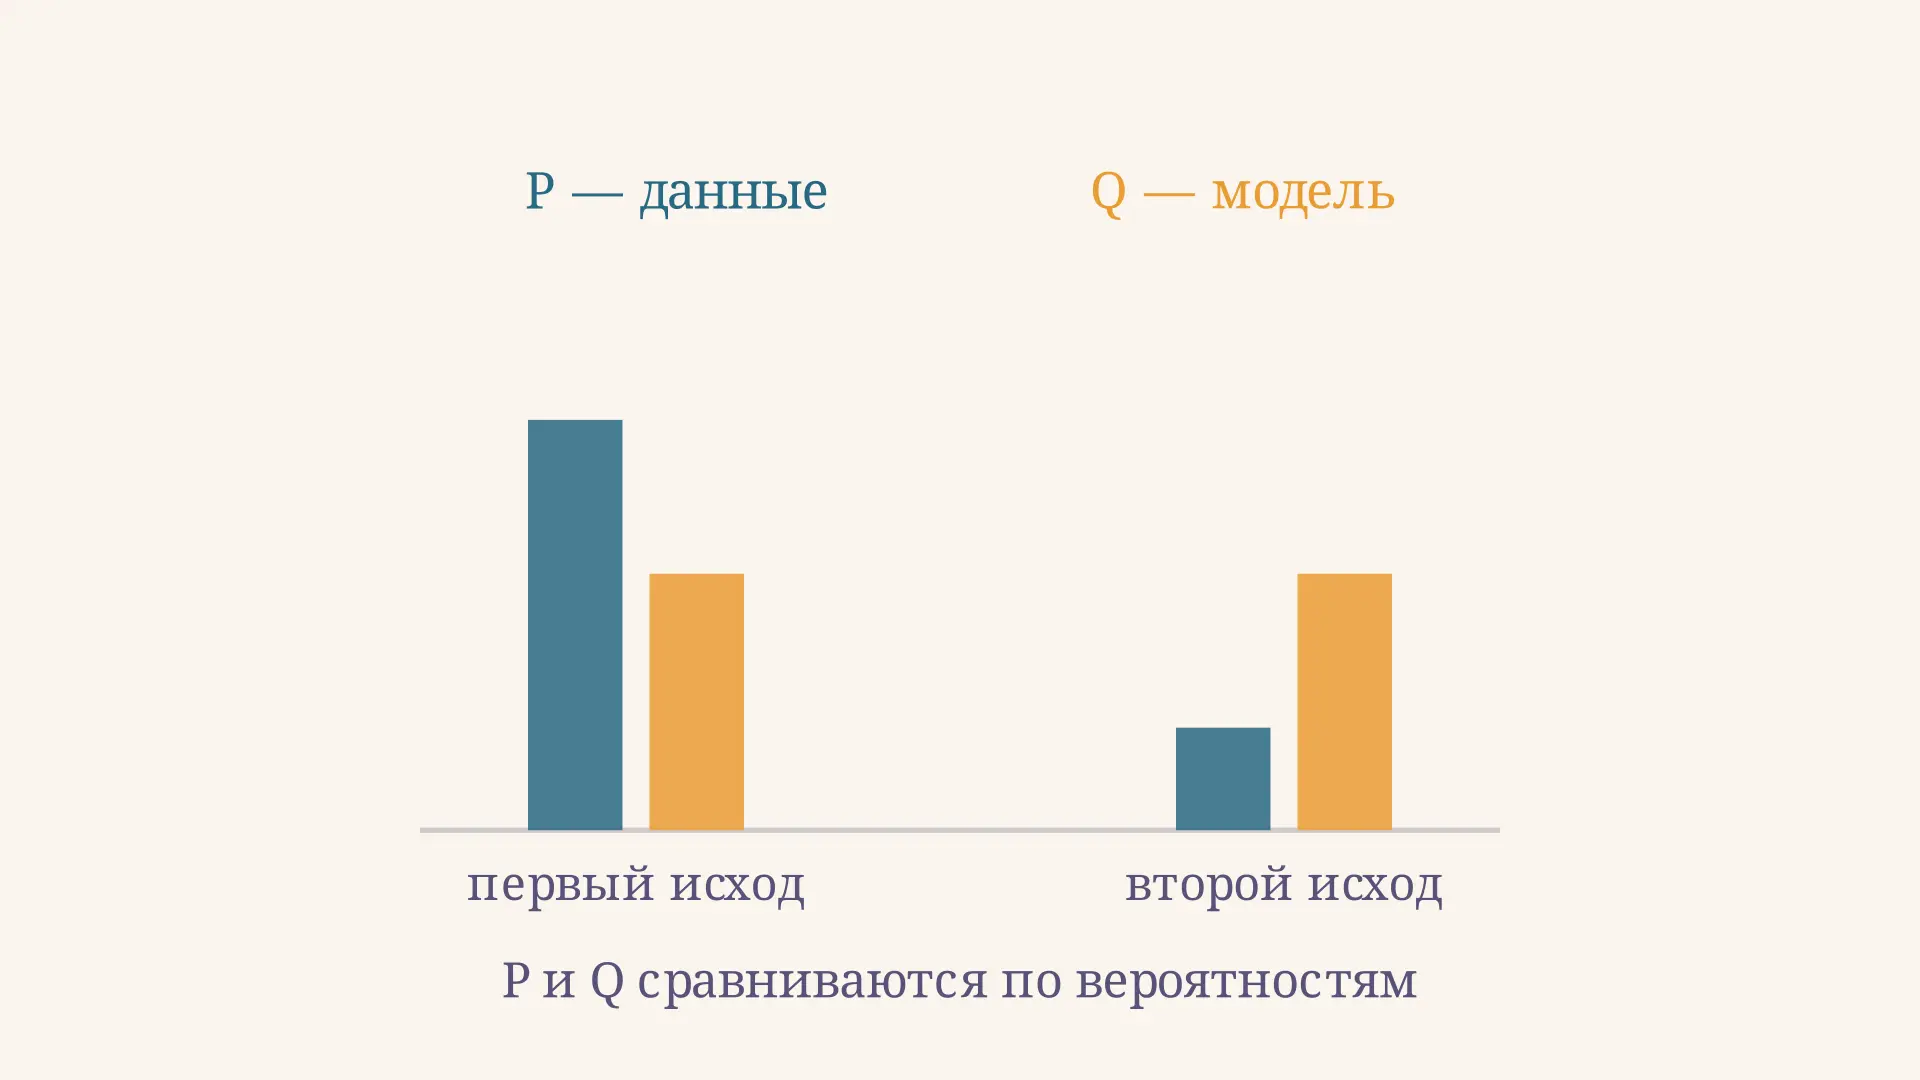
Пусть событие может закончиться одним из двух исходов. По распределению первый исход имеет вероятность , второй - . Модель считает оба исхода равновероятными: и . Нас интересует не ошибка отдельного прогноза, а расхождение между двумя полными распределениями.
Зафиксируем и будем менять . Когда вероятность первого исхода в модели приближается к , вероятность второго автоматически приближается к . Дивергенция убывает до нуля: модель совпадает с опорным распределением. На видео затем происходит обратное движение, чтобы цикл можно было наблюдать снова.
Распределение здесь задано как учебная модель данных, а не как результат измерений. В реальной задаче сначала нужно определить, откуда берутся вероятности и что именно означает каждое распределение. Например, для прогноза погоды может описывать частоты исходов в выбранных условиях, а - вероятности, назначенные моделью. Оценка по конечной выборке сама связана с неопределённостью.
Формула и смысл слагаемых
Для дискретных распределений на одинаковом наборе исходов формула имеет вид
Здесь , , а сумма берётся по всем исходам. Логарифм отношения сравнивает вероятности одного и того же исхода, а множитель задаёт вес этого сравнения. Иными словами, KL-дивергенция - математическое ожидание величины при исходах, распределённых по .
Натуральный логарифм даёт результат в натах. Если использовать логарифм по основанию 2, результат будет выражен в битах: для перевода нужно разделить значение в натах на . Выбор основания меняет масштаб, но не порядок сравнения моделей. Напомним свойства натурального и десятичного логарифмов, если преобразование оснований вызывает затруднение.
Отдельное слагаемое может быть отрицательным: это происходит, когда . Однако вся сумма неотрицательна. Поэтому нельзя оценивать качество модели по знаку одного слагаемого, не учитывая остальные исходы.
Пример расчёта по шагам
Подставим и :
Первый вклад равен примерно , второй - примерно . Их сумма составляет ната, или около после округления до тысячных. Отрицательный вклад второго исхода не противоречит неотрицательности всей дивергенции.
Теперь поменяем распределения местами. Веса тоже изменятся: ими станут вероятности из :
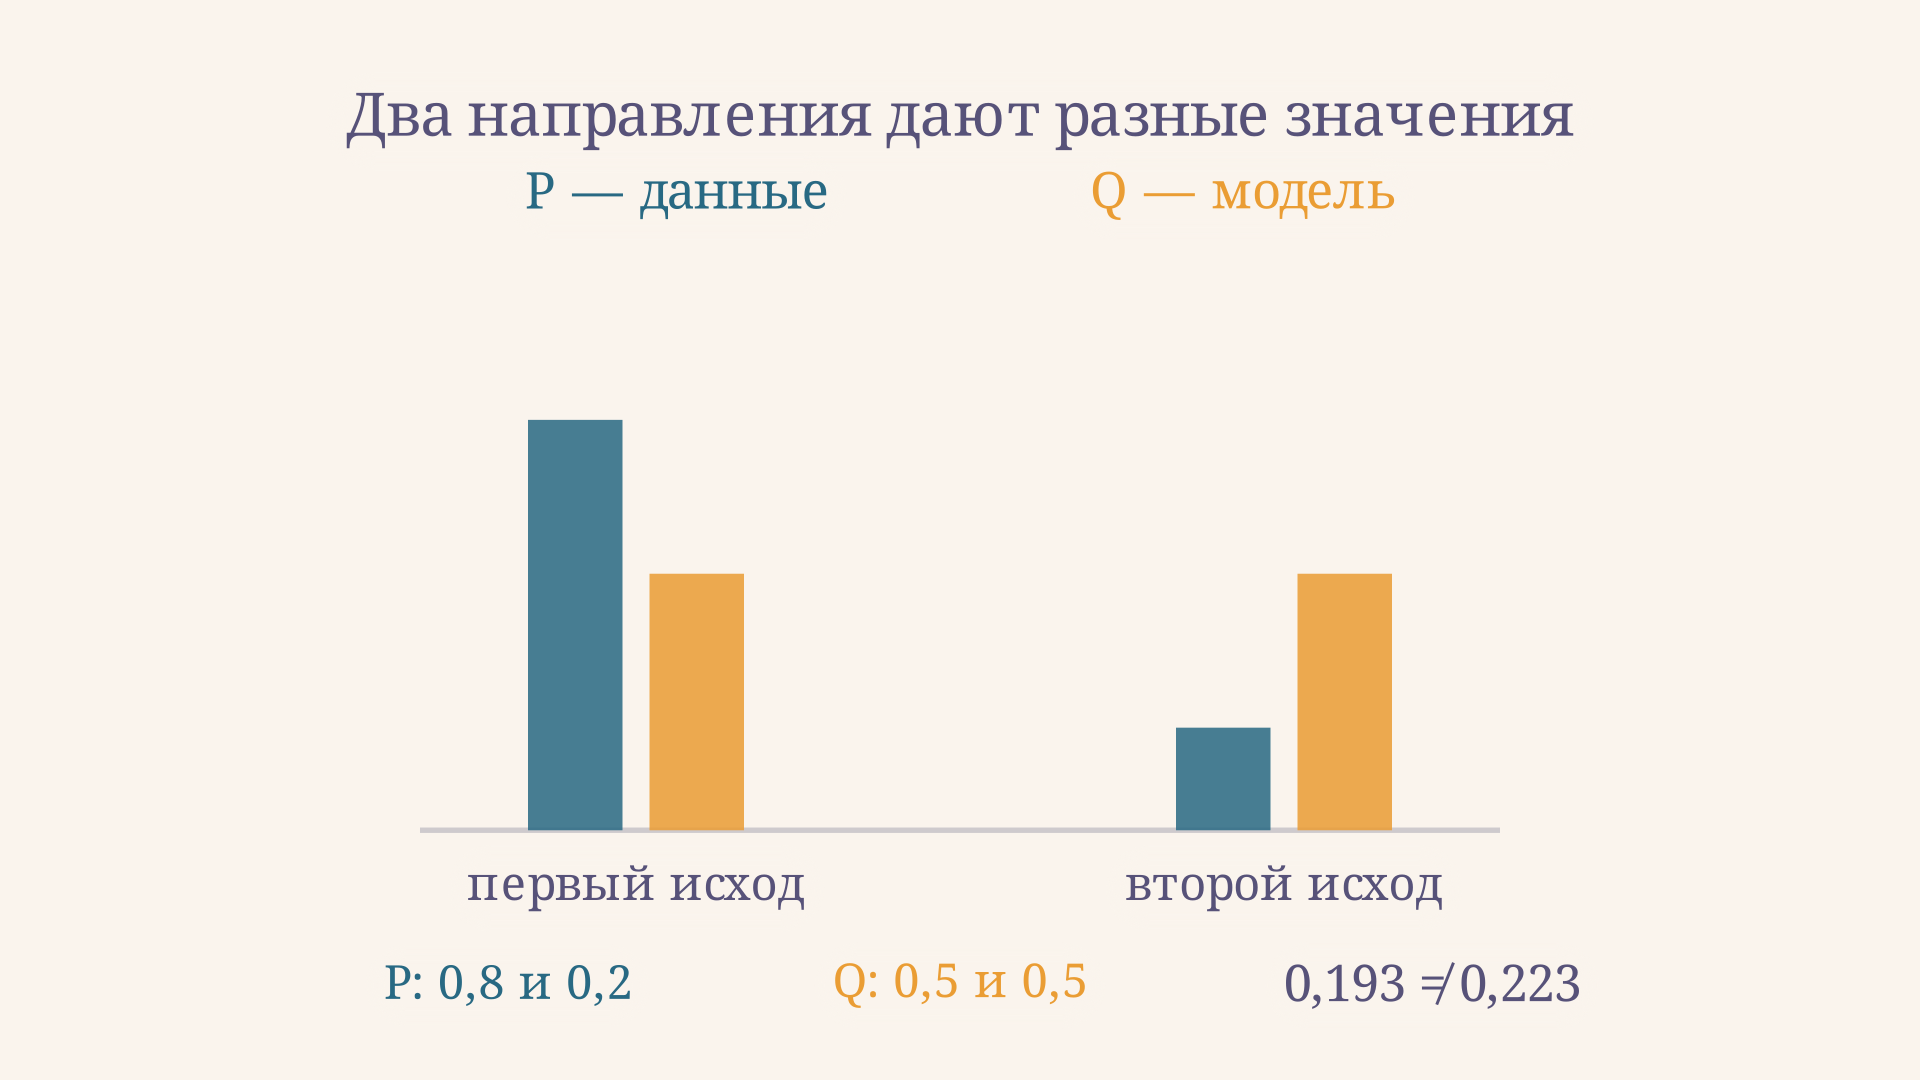
Результаты различны: . Калькулятор в начале статьи использует те же исходные числа. Попробуйте передвинуть оба ползунка к одному значению: столбцы попарно совпадут, а оба результата станут нулевыми.
Почему дивергенция не является расстоянием
Обычное расстояние между двумя точками одинаково в обоих направлениях. Для KL-дивергенции симметрия в общем случае не выполняется, как показывает расчёт выше. Она также не обязана удовлетворять неравенству треугольника, поэтому называть её метрикой нельзя.
Причина асимметрии видна прямо в формуле: при перестановке меняется не только отношение внутри логарифма, но и распределение весов. В усреднение идёт по , а в - по . Один и тот же исход может получать разный вес в двух вычислениях. При этом для некоторых пар значения случайно совпадают, поэтому один симметричный пример не доказывает симметрии правила.
Порядок записи нужно выбирать по смыслу задачи. Например, если минимизируется ожидаемая по потеря от применения модели , целевая величина имеет вид . Если же алгоритм явно задаёт обратное направление, менять его на привычное без обоснования нельзя: получится другая задача оптимизации.
Почему результат неотрицателен
Для положительного справедливо . Предположим сначала, что все и положительны. Подставим , умножим на и сложим по исходам:
Равенство достигается, когда соответствующие вероятности совпадают для всех исходов. С нулевыми вероятностями используют предельные соглашения, описанные ниже; неотрицательность сохраняется и для бесконечного результата. Другой путь к тому же выводу связан с неравенством Йенсена для выпуклой функции .
Ноль означает совпадение распределений, а положительное значение - их различие в выбранном направлении. Само число не является вероятностью ошибки: например, значение ната нельзя читать как вероятность ошибки . Для практической интерпретации полезно сравнивать значения, полученные для одной задачи, одного и одного основания логарифма.
Нули, бесконечность и непрерывный случай
Если , вклад исхода принимают равным нулю по пределу: при фиксированном положительном выражение стремится к нулю. При вклад также считают нулевым. Но если , а , то : модель объявила невозможным событие, которое по возможно.
Например, для и второй исход порождает бесконечный вклад. Калькулятор ограничивает ползунки диапазоном от до , чтобы вычисления оставались конечными; граничные случаи нужно анализировать отдельно. При оценивании модели по данным сглаживание может убрать нули в оценках, но его выбор меняет модель и требует обоснования.
Для непрерывных распределений вместо суммы используют интеграл по плотностям:
Плотность должна быть положительна почти всюду там, где положительна ; иначе дивергенция бесконечна. Формула предполагает общую меру интегрирования и корректно заданные плотности. Плотность в точке сама по себе не является вероятностью этой точки, поэтому дискретные и непрерывные расчёты нельзя смешивать без уточнения модели.
Связь с энтропией и обучением моделей
Энтропия зависит только от . Перекрёстная энтропия оценивает среднюю логарифмическую потерю модели при исходах из . Из определений следует
При фиксированном минимизация перекрёстной энтропии по эквивалентна минимизации : первое слагаемое не зависит от модели. В интерпретации кодирования дивергенция показывает дополнительную среднюю длину идеального кода при использовании вероятностей вместо , в выбранных единицах логарифма.
KL-дивергенция встречается и в других задачах. В алгоритме t-SNE она сравнивает вероятности близости пар точек до и после снижения размерности. Сравнение распределений также полезно отличать от вычисления отдельной условной вероятности: последняя описывает вероятность события при условии, тогда как KL суммирует вклады по исходам.
Как применять формулу в задаче
Сначала выпишите все возможные исходы и сопоставьте вероятности в одинаковом порядке. Если одно распределение задано в процентах, переведите их в доли. Проверьте, что каждая вероятность неотрицательна, а сумма по каждой строке равна единице. В задачах с несколькими категориями нельзя просто исключить неудобную категорию: после исключения остальные вероятности придётся нормировать, и получится уже другая постановка.
Затем определите направление сравнения по условию. Подставьте в числитель и в веса вероятности из первого аргумента, а в знаменатель - из второго. Для каждого положительного веса найдите отношение вероятностей, вычислите логарифм и умножьте его на вес. Сложите результаты и округляйте только в конце: раннее округление может заметно повлиять на маленькое итоговое значение.
Наконец, оцените ответ. Он не должен быть отрицательным с учётом погрешности вычислений. При полном совпадении распределений каждое отношение положительных вероятностей равно единице и сумма равна нулю. Если модель присвоила ноль возможному по опорному распределению исходу, вместо деления на ноль укажите бесконечную дивергенцию и объясните причину.
Важна и сопоставимость данных: категории должны обозначать одни и те же события при одинаковых условиях. Сравнивать распределение исходов за один сезон с прогнозом для другого сезона без дополнительных оговорок некорректно. Сначала проверьте смысл вероятностей, затем вычисляйте показатель и интерпретируйте его в контексте задачи.
Частые ошибки
- Меняют и местами. Перед подстановкой определите распределение, по которому берётся среднее.
- Забывают второй исход. Для корректной суммы нужны все исходы и нормированные вероятности каждого распределения.
- Приравнивают KL к проценту ошибок. Единица зависит от основания логарифма; это не доля неверных ответов.
- Игнорируют нули модели. Если , но , конечного результата нет.
- Считают каждое слагаемое неотрицательным. Такое свойство относится к сумме, а не к отдельному вкладу.
FAQ
Может ли дивергенция быть отрицательной?
Нет. При корректных вероятностных распределениях она неотрицательна или равна положительной бесконечности. Отрицательный численный результат иногда появляется из-за округления или неверной подстановки.
Когда она равна нулю?
Когда распределения совпадают на всех исходах с положительной вероятностью; в непрерывном случае - почти всюду относительно соответствующей меры. Простое совпадение среднего значения не гарантирует совпадения распределений.
Зависит ли результат от основания логарифма?
Да, меняется единица измерения. При натуральном логарифме результат выражается в натах, при двоичном - в битах; для перехода от натов к битам делят на .
Коротко
Дивергенция Кульбака - Лейблера усредняет по логарифм отношения вероятностей и . Она равна нулю при совпадении распределений, неотрицательна и обычно меняется при перестановке аргументов. Проверяйте полный набор исходов, порядок распределений, основание логарифма и случаи нулевой вероятности модели.
Читайте также
Цепь Маркова: стационарное распределение
Как найти стационарное распределение цепи Маркова по матрице переходов: пример для двух состояний, проверка баланса и условия сходимости с разбором ошибок.
Геометрическая вероятность: задача о встрече
Как решить задачу о встрече через геометрическую вероятность: квадрат времён прихода, область встречи, расчёт для ожидания 15 минут и варианты условий.
Неравенство Маркова и Чебышёва: сравнение оценок
Неравенства Маркова и Чебышёва оценивают вероятность по среднему и дисперсии. Сравним границы одного события, проверим условия и разберём примеры равенства.
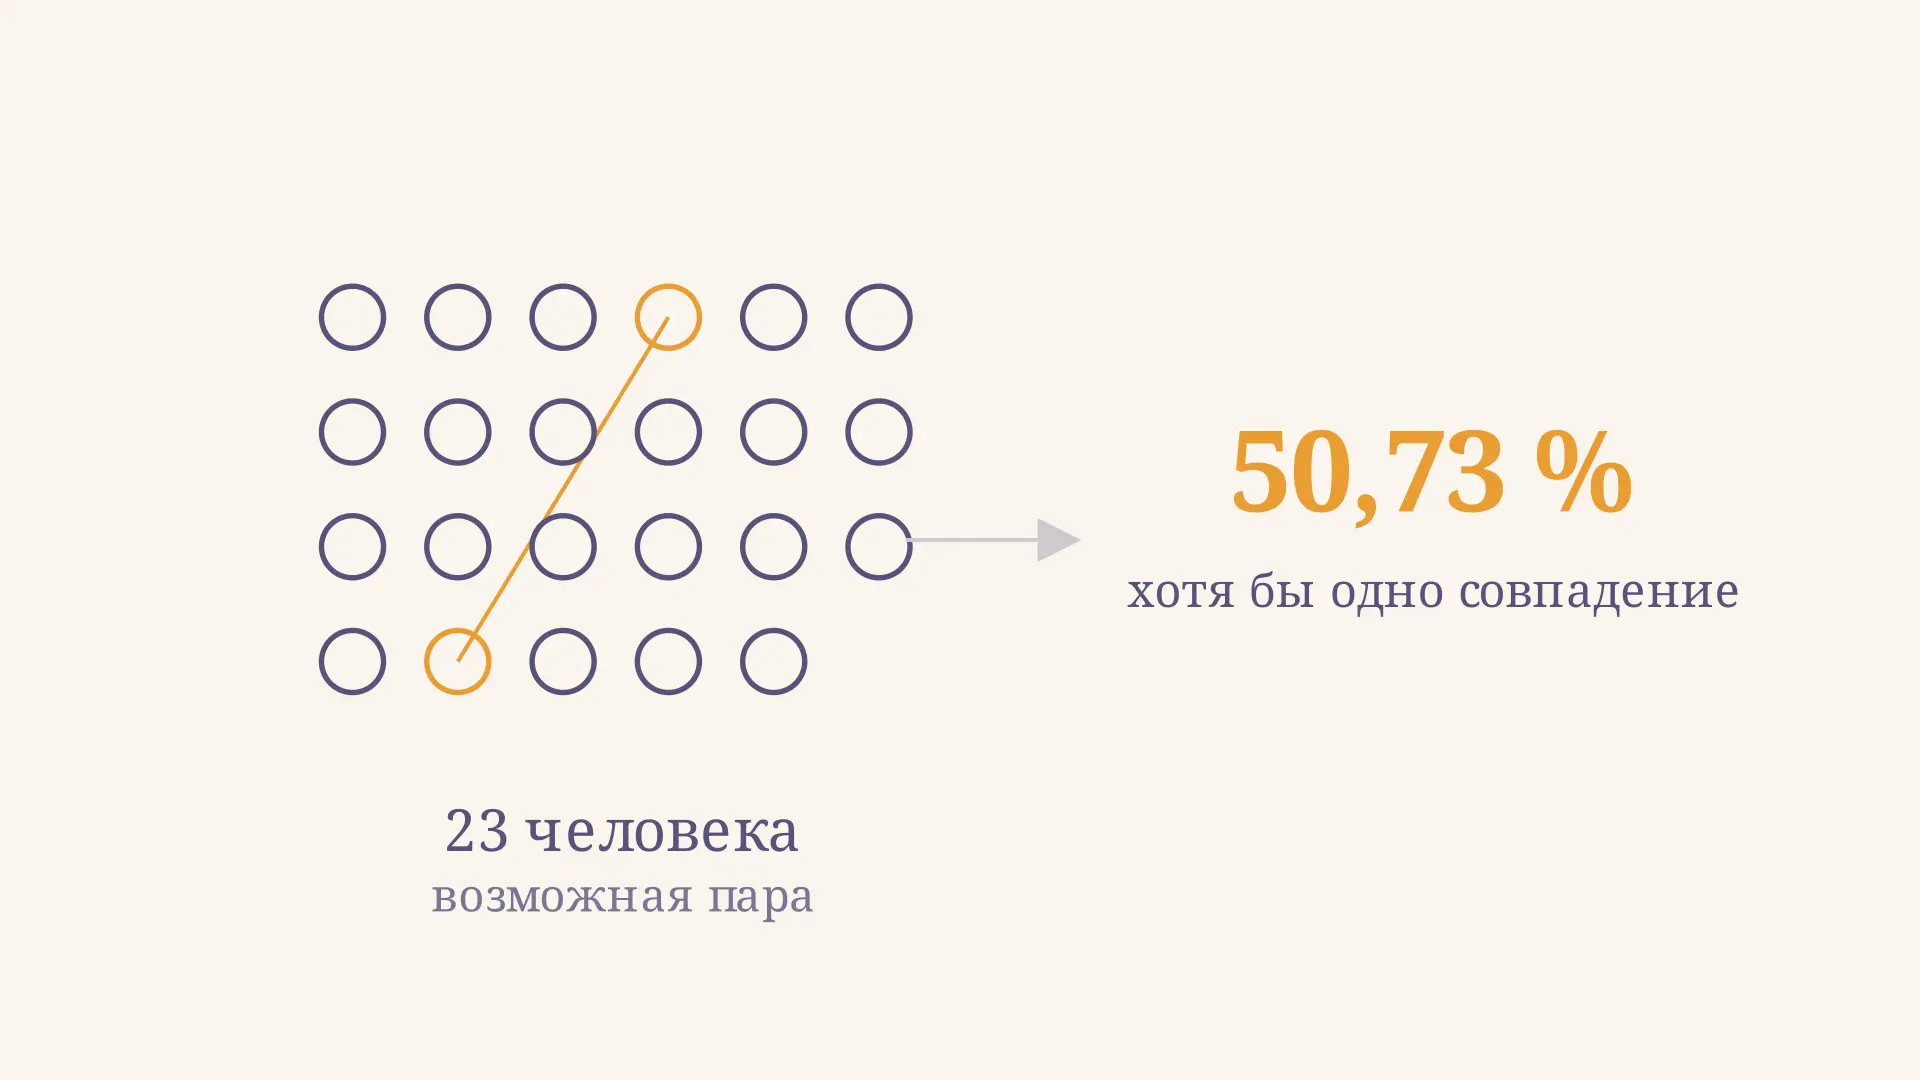
Парадокс дней рождения: вероятность совпадения
Парадокс дней рождения объясняет, почему уже в группе из 23 человек вероятность общей даты превышает 50 %. Выведем формулу, сравним случаи и проверим ограничения модели.
Процесс восстановления: теория и примеры
Процесс восстановления в теории вероятностей: интервалы между событиями, функция и уравнение восстановления, предельная теорема и пример расчёта замен.
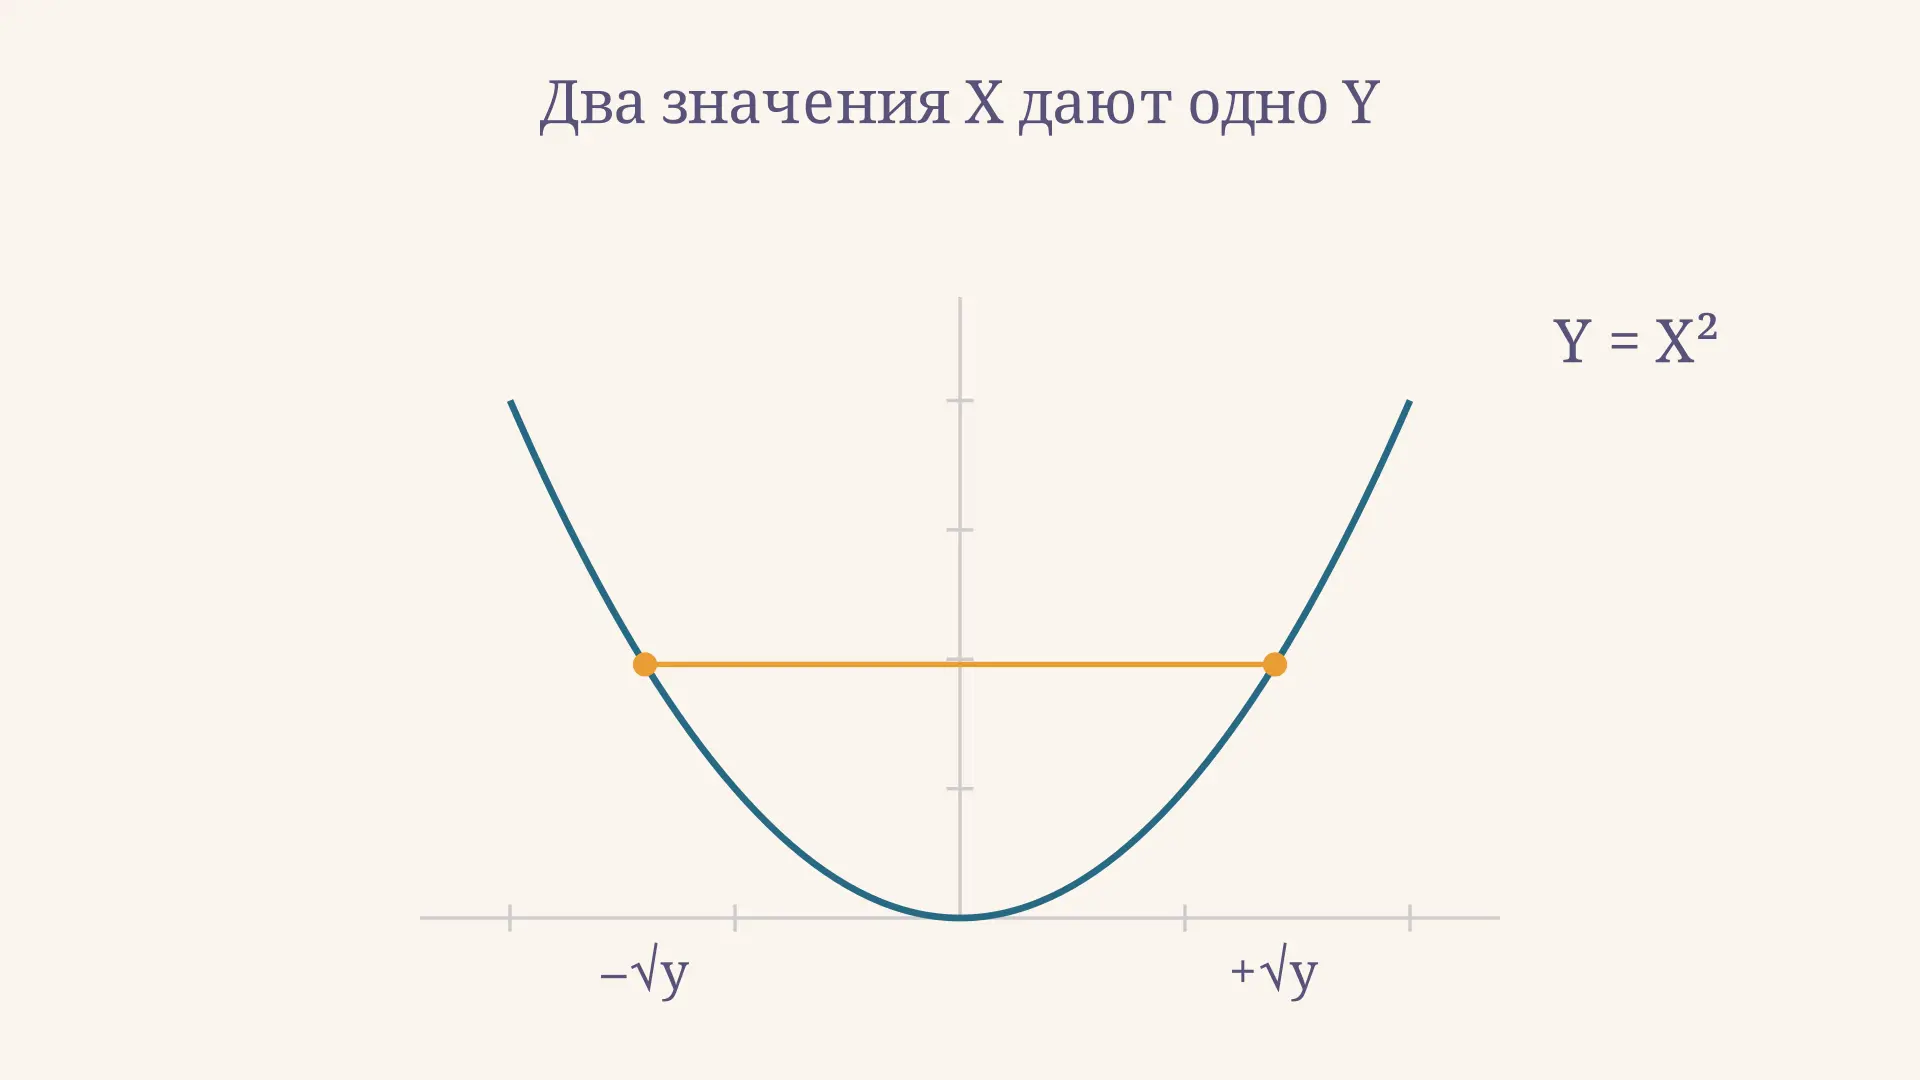
Распределение функции случайной величины: метод
Как найти распределение функции случайной величины через прообраз события и плотность: алгоритм, пример с квадратом, несколько обратных ветвей и проверка ответа.