Метрика precision recall: точность и полнота
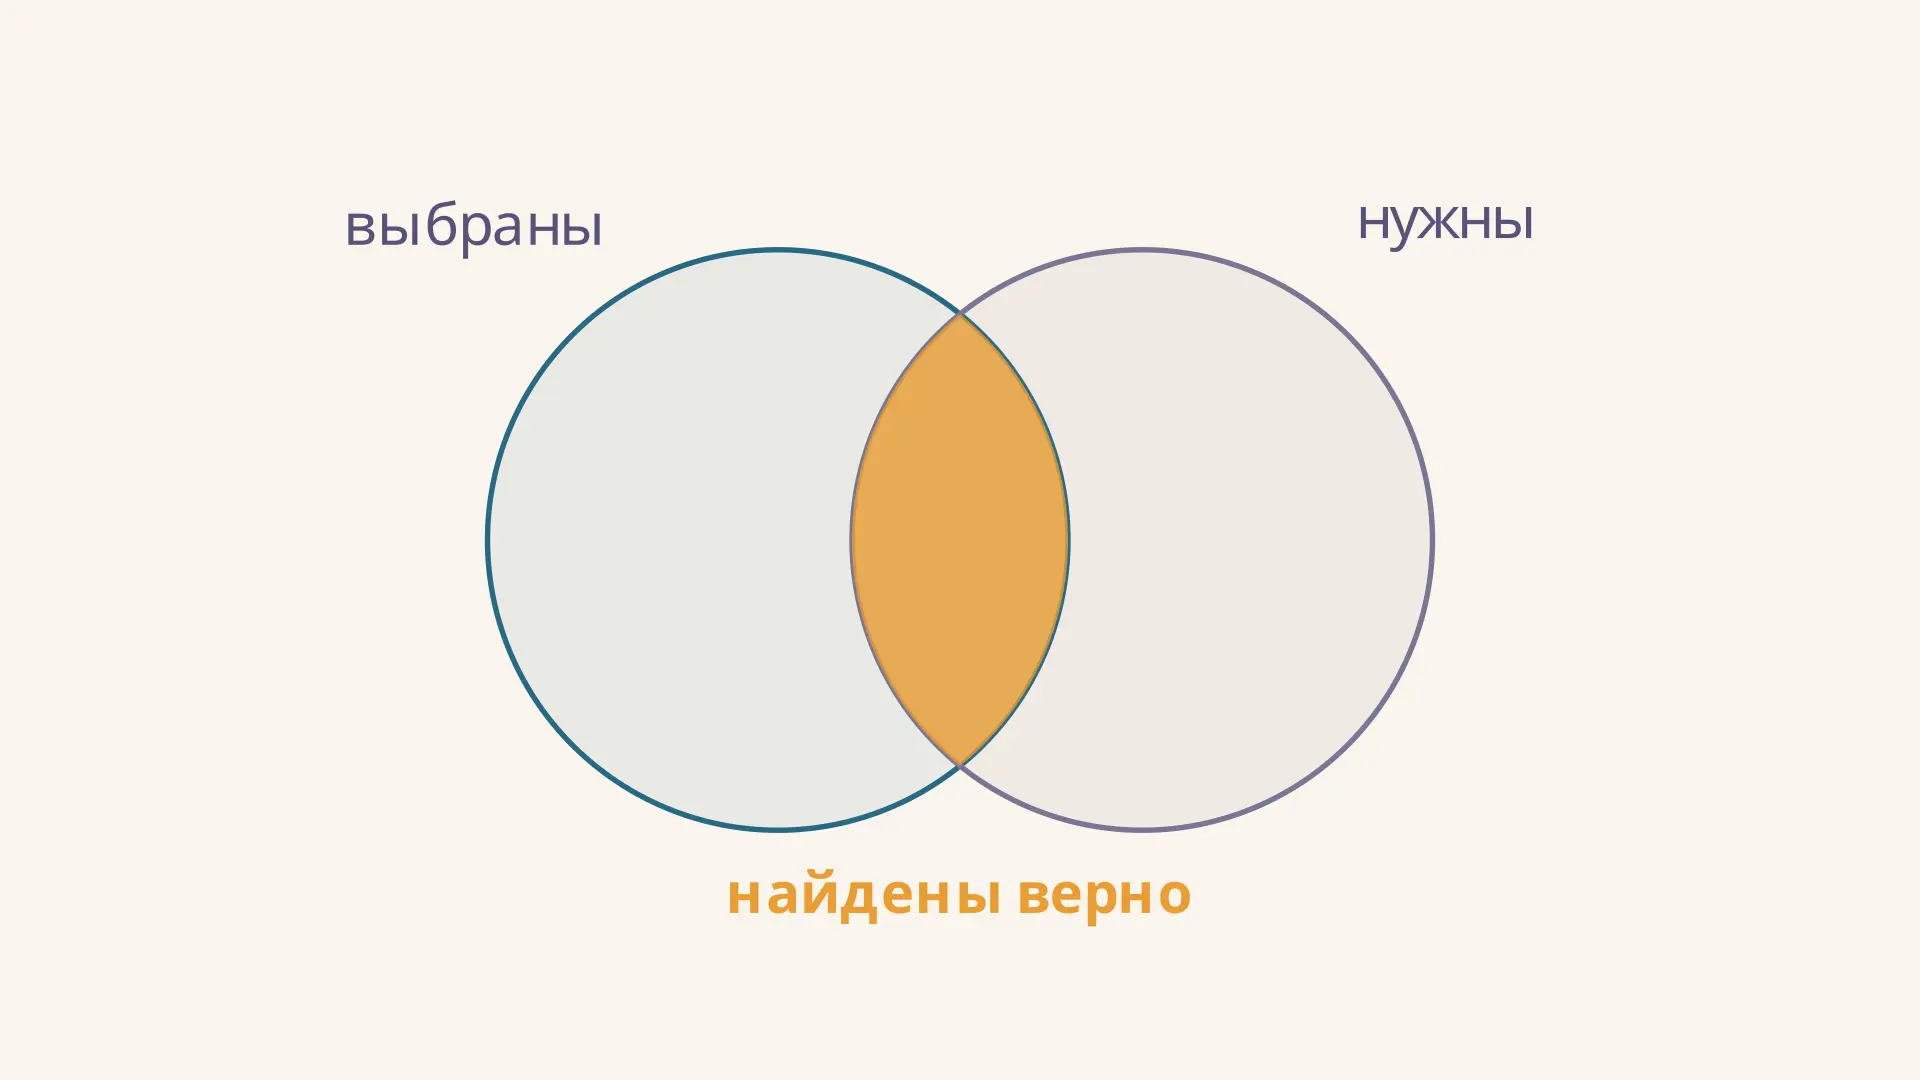
Модель нашла подозрительные письма, релевантные документы или потенциальный брак. Как понять, хорошо ли она справилась? Можно спросить, какая доля выбранных объектов действительно нужна. А можно поставить другую задачу: какую долю всех нужных объектов модель сумела найти. На первый вопрос отвечает precision, на второй - recall. Это разные доли: общие у них только верно найденные объекты.
Ниже калькулятор показывает десять учебных объектов с фиксированными оценками модели. Меняйте порог: точка на графике и обе метрики пересчитаются. Так можно проверить, почему один показатель не заменяет другой и зачем вместе с результатом сообщать порог.
Два вопроса к одному результату
Пусть положительный класс - документы, подходящие поисковому запросу. Модель отобрала часть коллекции; затем эксперт проверил предсказания по истинным меткам. Обозначим верно выбранные документы как , ошибочно выбранные как , а пропущенные подходящие как . Четвёртая группа, , содержит правильно отвергнутые неподходящие документы. Подробнее устройство таблицы показано в статье про матрицу ошибок.
Precision обычно переводят как точность положительных предсказаний. Это доля действительно подходящих среди всех выбранных:
Recall, или полнота, показывает долю найденных среди всех действительно подходящих документов:
Числитель один и тот же, но в первом знаменателе стоит результат отбора, а во втором - все объекты целевого класса. Обе метрики лежат от 0 до 1, если знаменатели не равны нулю. Значение 0,8 можно выразить как 80 %, но важно уточнить: 80 % чего? Высокая precision означает мало лишнего среди выбранного; высокая recall - мало пропусков среди нужного.
Не путайте precision с accuracy: последняя делит число всех правильных ответов на размер выборки и учитывает . При редком положительном классе множество верно отвергнутых объектов может скрыть то, что модель почти ничего нужного не находит.
Как считать на десяти объектах
В учебном примере оценки по убыванию равны 0,95; 0,85; 0,75; 0,65; 0,55; 0,45; 0,35; 0,25; 0,15; 0,05. Их истинные метки в том же порядке: 1, 0, 1, 1, 0, 1, 0, 1, 0, 0. Единица означает нужный объект. Всего таких объектов пять. Это искусственная последовательность для упражнения, а не результат эксперимента: такой пример помогает увидеть возможности и границы моделирования.
При правиле «выбрать оценку не ниже 0,5» отбираются первые пять объектов. Среди них три нужных и два лишних, а ещё два нужных остаются за порогом. Значит, , , и . Подстановка даёт , .
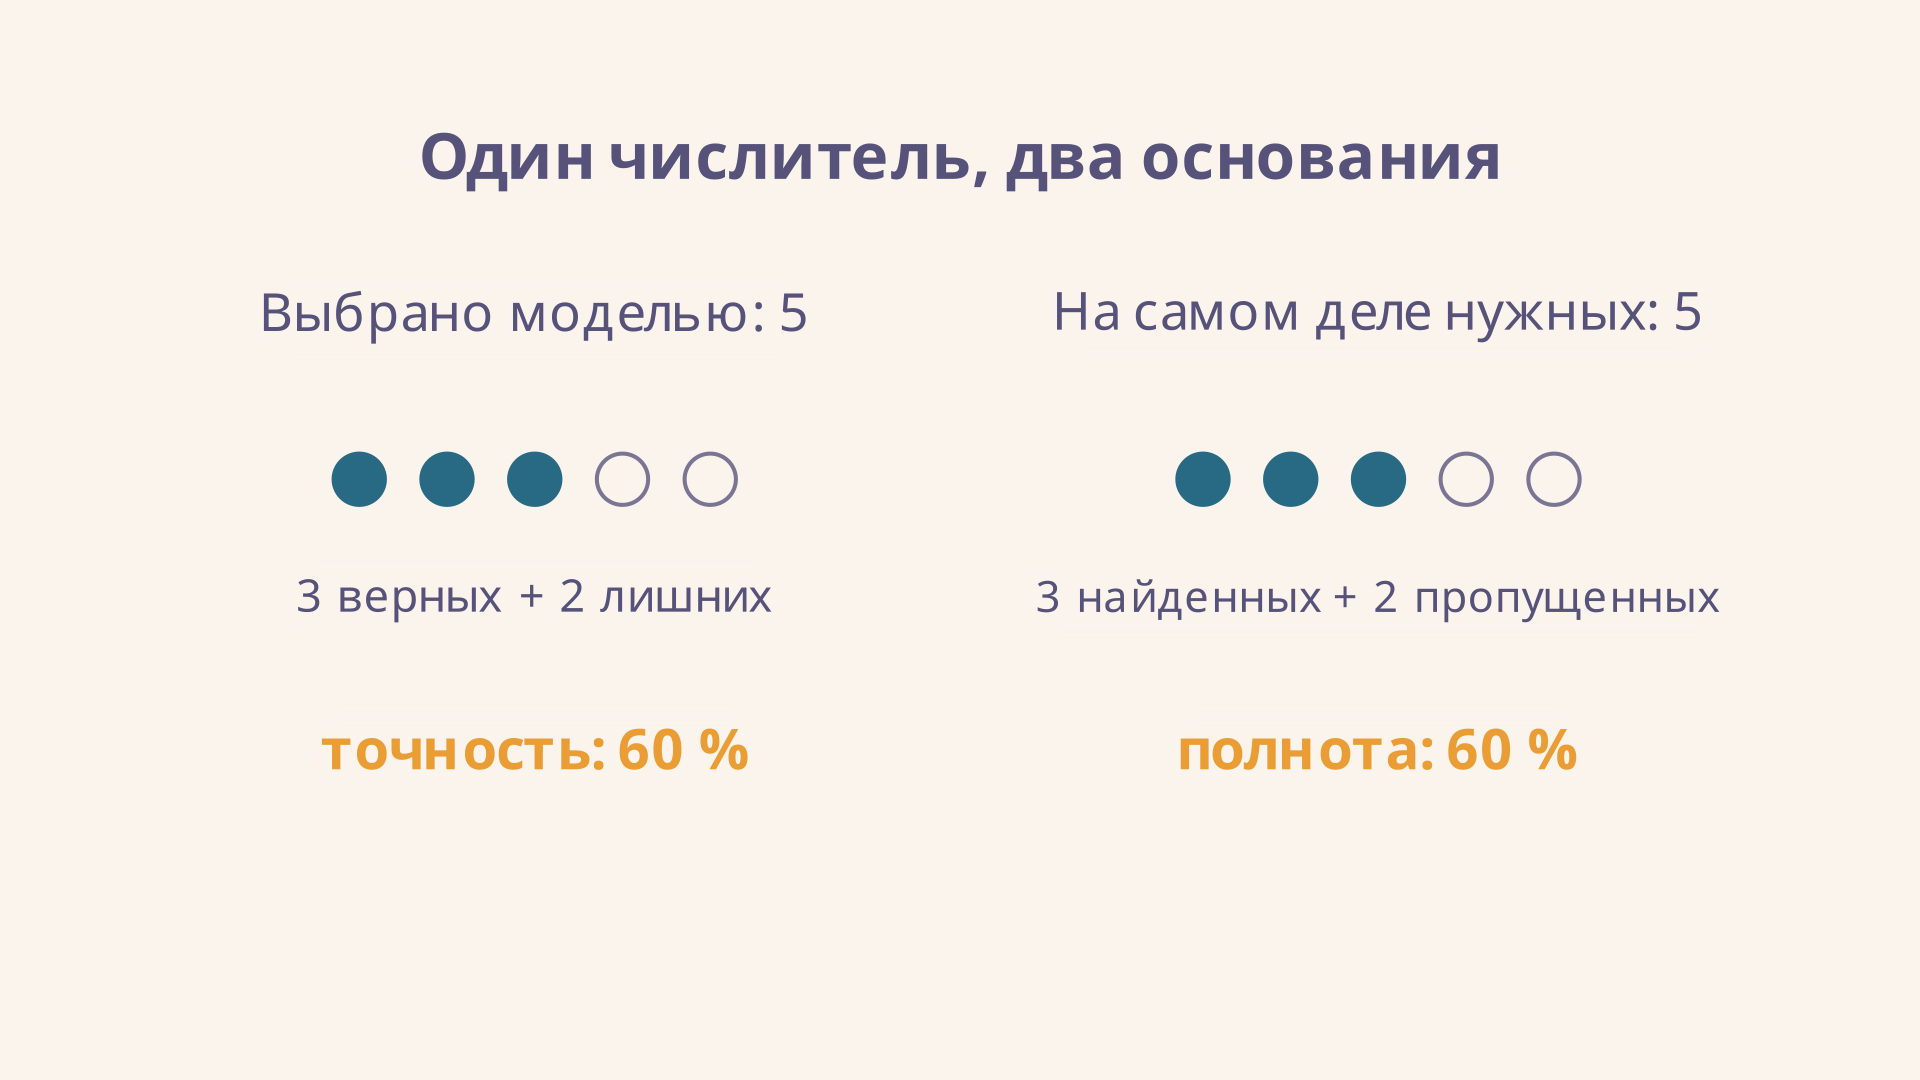
Знаменатели совпали случайно: в общем случае размер выбранной группы и число всех нужных объектов различны. Например, если выбрать только один заведомо подходящий документ из пяти, точность составит 100 %, но полнота - лишь 20 %. Напротив, выбор всей десятки даст полноту 100 %, а точность 50 %. Обе крайности показывают, почему по одной доле трудно судить о полезности системы.
Что меняет порог
Оценка модели задаёт порядок объектов по степени уверенности; она не обязана быть точно откалиброванной вероятностью. Порог превращает оценку в решение: объект с оценкой выше или равной порогу считается положительным. На ролике граница движется по той же десятке: справа остаются выбранные объекты, а заполненный кружок обозначает действительно нужный объект.
При пороге 0,7 выбраны три объекта: два нужных и один лишний. Точность равна , полнота - . При пороге 0,3 выбраны семь объектов: четыре нужных и три лишних. Получаем точность и полноту .
Снижение порога на фиксированной размеченной выборке добавляет объекты к выбранным и потому не уменьшает recall. Precision ведёт себя сложнее: если очередной объект положителен, она может вырасти, а если отрицателен - упасть. Поэтому нельзя утверждать, что полнота и точность обязательно движутся строго в разные стороны. В примере скачки видны на небольшом наборе; аналогичная ступенчатость возможна и на большом. Это свойство также описано в примере scikit-learn.
Как читать PR-кривую
На PR-графике по горизонтали откладывают recall, по вертикали - precision. Каждому порогу соответствует пара значений, а переход между порогами показывает, какие компромиссы доступны для конкретных оценок и меток. В калькуляторе показаны только пороги с шагом 0,1; золотая точка соответствует выбранному положению ползунка. Настоящую кривую обычно строят по всем различным оценкам, а не только по этой сетке.
Для сравнения моделей смотрите не только на всю кривую, но и на участок, соответствующий задаче. Если команда способна проверить ограниченное число сигналов, важна precision при приемлемом числе обращений. Если задана минимальная полнота, сначала найдите допустимые точки, затем сравнивайте точность в этой области. Две кривые могут пересекаться, поэтому единственного лучшего решения для всех условий может не быть.
Average precision (AP) сводит кривую к одному числу как взвешенную сумму значений precision, где веса - приросты recall. Это удобно для сравнения ранжирования, но не показывает конкретную рабочую точку. Кроме того, AP и площадь, рассчитанная по трапециям с линейной интерполяцией, не обязаны совпадать: документация scikit-learn явно различает эти способы. Для единственного баланса при фиксированном пороге отдельно применяют F1 score.
Почему доля положительного класса важна
Представим 1000 объектов, из которых 100 действительно положительны. Если чувствительность равна 80 %, а доля ложных тревог среди отрицательных - 10 %, получим 80 верных срабатываний и 90 ложных. Precision равна , recall - .
Теперь сохраним те же доли обнаружения и ложных тревог, но возьмём 1000 объектов с 10 положительными. Будет 8 верных и 99 ложных срабатываний: precision упадёт до , хотя recall останется 80 %. Числа здесь учебные. Они показывают, что при переносе модели в среду с другой распространённостью класса качество положительных ответов может измениться даже при неизменных условных характеристиках.
Для случайного ранжирования ориентир precision приблизительно равен доле положительных объектов в представительной выборке. Поэтому сравнивать PR-кривые осмысленно на одинаковом наборе данных или хотя бы с учётом различий состава. При малом числе положительных примеров отдельные ошибки сильно сдвигают процент: полезно указывать сами количества, а не только округлённые метрики.
Как выбрать рабочую точку
Сначала определите, что считается положительным классом и кто проверяет результат. Если ложная тревога запускает дорогое ручное расследование, команда может задать минимальную точность. Если пропуск критичен, можно потребовать минимальную полноту и среди подходящих порогов выбрать тот, который даёт меньше лишних сигналов. Реальная цена зависит от последующего процесса, поэтому один и тот же классификатор способен требовать разных порогов в разных сценариях. Такой подход к выбору метрик описан в руководстве Google.
Порог подбирают на валидационной выборке, а итоговую оценку сообщают на отдельной тестовой. Полезно проверить устойчивость к изменениям состава данных и качество разметки: ошибка эталонной метки попадает в расчёт как ошибка модели. При построении ансамбля, например через стекинг моделей, эти правила сохраняются: оценивают конечные предсказания ансамбля, а не сумму метрик его участников.
Частые ошибки
- Поменять знаменатели. У precision в знаменателе выбранные объекты, у recall - все фактически положительные.
- Назвать recall вероятностью правильного положительного ответа. Это доля найденных среди положительных; правильность выбранных измеряет precision.
- Объявить precision равной нулю без оговорок, когда модель ничего не выбрала. Формула даёт деление на ноль; библиотека может принять соглашение для такого случая, которое нужно указать.
- Выбрать порог по тестовой выборке и на ней же оценить результат. Это делает итог оптимистичным; отделяйте подбор от проверки.
- Сравнивать проценты без размера и состава выборки. При редком классе и малом числе меток метрики могут заметно колебаться.
FAQ
Может ли precision быть 100 %, а recall низкой?
Да. Если модель выбирает только один правильный объект из ста нужных, precision равна 100 %, а recall - 1 %. Ошибочных срабатываний нет, но почти все нужные объекты пропущены.
Что делать, если в выборке нет положительных объектов?
Тогда , и recall по формуле не определена. Аналогично precision не определена при . В отчёте нужно явно указать соглашение библиотеки и отсутствие соответствующей группы.
Всегда ли нужно повышать обе метрики?
Высокие значения желательны, но конкретное решение зависит от ограничений и стоимости ошибок. Улучшение модели или данных может повысить обе метрики; перемещение порога лишь выбирает рабочую точку для фиксированного набора оценок.
Коротко
Precision измеряет долю верных среди положительных предсказаний, recall - долю найденных среди всех положительных объектов. Порог меняет состав отбора, а PR-кривая показывает доступные пары показателей. Для решения нужны обе доли, числа объектов, состав выборки и цена двух видов ошибок.
Читайте также
Матрица ошибок (confusion matrix): формула и пример
Матрица ошибок confusion matrix показывает TP, FP, FN и TN классификатора: как её строить и считать accuracy, precision, recall и F1-score на примере спам-фильтра и медицинского теста.
F1 score: баланс precision и recall в классификации
Метрика F1 score: как она объединяет precision и recall через гармоническое среднее, когда применять F1-меру вместо accuracy и как считать её при дисбалансе классов.
Алгоритм ID3: как построить дерево решений
Алгоритм ID3 строит дерево решений по информационному выигрышу. Разбираем энтропию, выбор признака, пример расчёта, условия остановки и ограничения метода.
Алгоритм k-means: кластеризация по шагам
Алгоритм k-means простыми словами: как точки попадают в кластеры, как пересчитываются центроиды и сумма квадратов, как выбрать число групп и подготовить признаки.
Регуляризация Elastic Net: формула и пример расчёта
Регуляризация Elastic Net объединяет L1 и L2: разберём формулу, расчёт коэффициентов, настройку параметров, масштабирование данных и работу с коррелирующими признаками.
ROC-кривая и AUC: построение и смысл метрики
Как построить ROC-кривую по оценкам классификатора, вычислить AUC методом трапеций, выбрать порог и понять ограничения метрики на несбалансированных данных.