Регуляризация Elastic Net: формула и пример расчёта
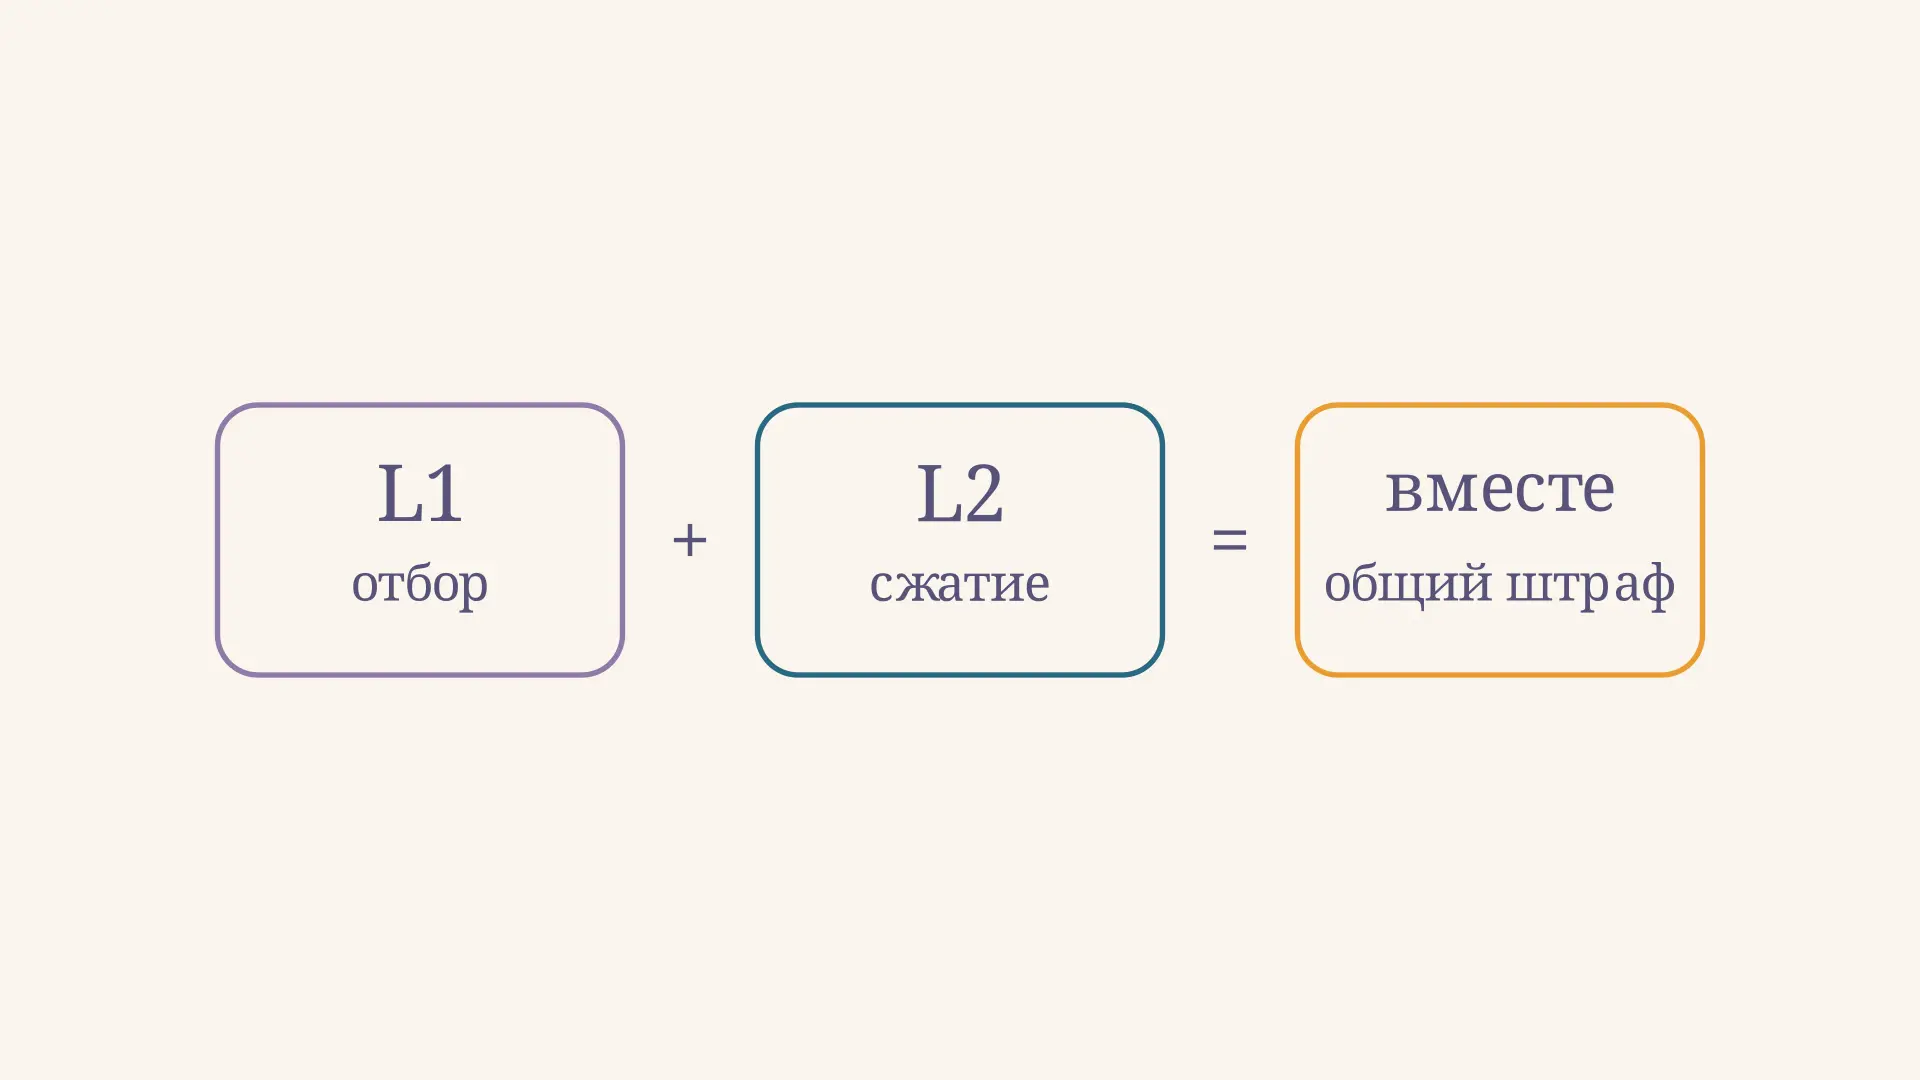
Elastic Net - способ обучить линейную модель, добавив к ошибке два штрафа за величину коэффициентов. Первый способен обнулить часть весов, второй сжимает оставшиеся и помогает стабилизировать решение. Такое сочетание полезно, когда признаков много и некоторые из них похожи друг на друга. В калькуляторе ниже можно менять оба параметра и наблюдать, какие коэффициенты сохраняются. Его пример специально упрощён: признаки ортогональны, поэтому результат вычисляется по простой формуле.
Зачем модели штраф за коэффициенты
Пусть линейная модель предсказывает ответ как сумму . Здесь - значение признака для объекта , - его вес, а - свободный член. При обычном методе наименьших квадратов обучение минимизирует сумму квадратов ошибок на обучающих данных.
Если признаков много или они сильно связаны, несколько разных наборов весов могут почти одинаково описывать выборку. Коэффициенты при этом способны сильно меняться из-за небольшого изменения данных. Штраф вводит дополнительное предпочтение: среди близких по ошибке решений модель выбирает более умеренные веса. Это может улучшить обобщение, хотя не гарантирует его для каждой выборки.
На видео сила штрафа растёт и затем возвращается к нулю. Слабый коэффициент становится ровно нулевым раньше остальных: так виден отбор признаков, который даёт L1-слагаемое. Учебные признаки здесь независимы в геометрическом смысле; видео не изображает эффект корреляции.
Формула Elastic Net
Для центрированного ответа и матрицы признаков запишем одну распространённую нормировку:
Здесь , а . Параметр задаёт общую силу регуляризации, от нуля до единицы - долю L1 в штрафе. Обычно свободный член не штрафуют. В других источниках множители и имена параметров могут отличаться, поэтому сравнивать численные значения без проверки формулы нельзя.
В документации scikit-learn такой же общий множитель называется alpha, а доля L1 - l1_ratio. При в нашей записи штраф исчезает; на практике для обычной регрессии удобнее использовать отдельный решатель наименьших квадратов.
Lasso, Ridge и промежуточный случай
При остаётся L1-штраф: получается Lasso. Его излом в нуле позволяет части коэффициентов стать строго нулевыми, то есть выполнить отбор признаков. При остаётся квадратичный L2-штраф, соответствующий Ridge в указанной нормировке. Он обычно уменьшает ненулевые коэффициенты, но сам по себе не делает их точно нулевыми.
При действуют оба механизма. Рост усиливает оба слагаемых сразу; изменение перераспределяет вес между ними. Поэтому нельзя считать, что один параметр отвечает только за точность, а другой только за отбор: оба влияют на итоговые веса. Кроме того, увеличение штрафа обычно повышает ошибку на обучающей выборке, но ошибка на новых данных может сначала уменьшиться, а затем снова вырасти.
Пример с тремя признаками
Рассмотрим искусственную задачу, в которой столбцы центрированы и стандартизованы так, что . Тогда нескоррелированные признаки имеют единичную нормированную дисперсию, а коэффициенты без штрафа равны . Для каждого признака решение находится отдельно:
Числитель выполняет мягкую пороговую обработку: из модуля исходного коэффициента вычитается , но результат не может стать отрицательным. Знаменатель дополнительно сжимает ненулевые значения. Формула точна именно при указанном условии ортогональности; для произвольной матрицы её нельзя применить независимо к исходным коэффициентам.
Подставим и . Порог равен , знаменатель - . Поэтому получаем , и : последний исходный вес не превышает порог. Эти же числа показаны на рисунке и при начальных положениях ползунков.
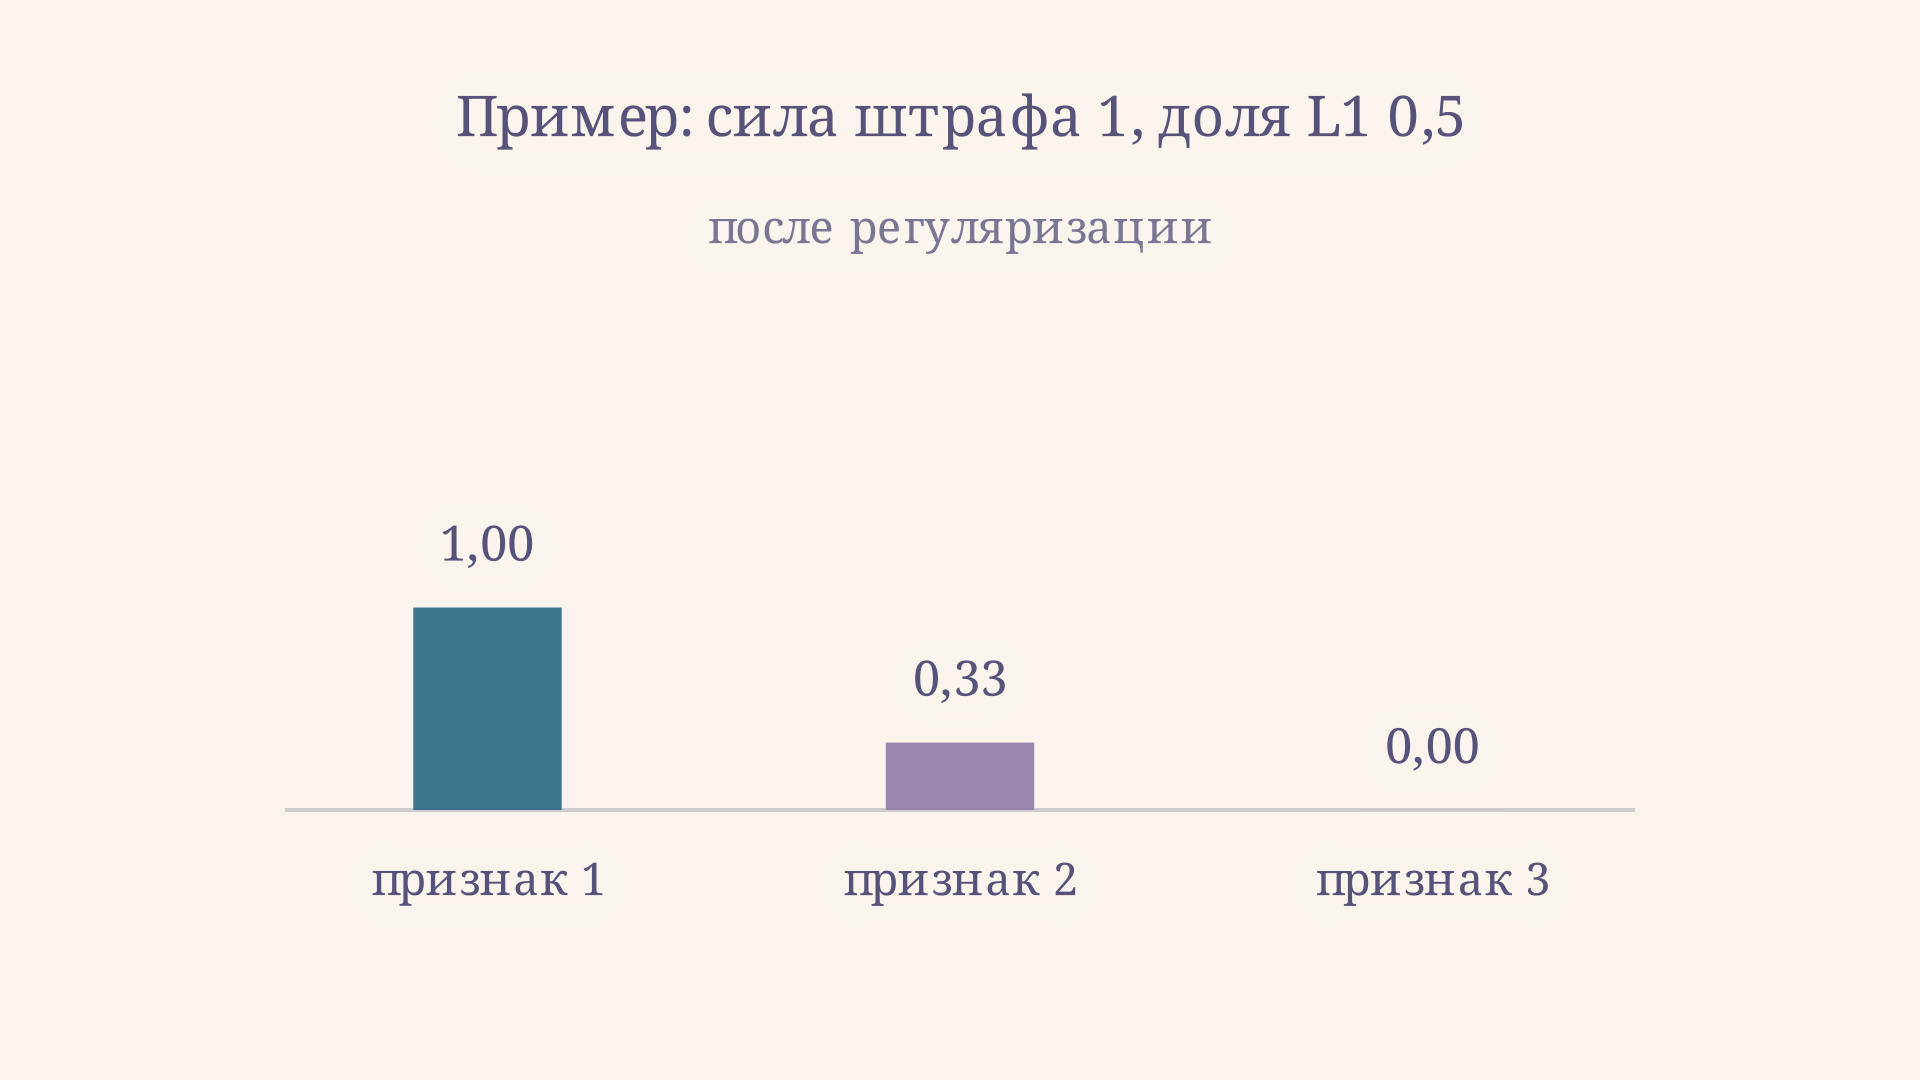
Теперь изменим долю L1 на ноль при той же силе штрафа. Порог исчезнет, а все три положительных веса разделятся на два: получатся , и . Если вместо этого выбрать долю L1, равную единице, результат будет , и . Такое сравнение показывает роль каждого слагаемого, но не позволяет судить о качестве прогноза без данных проверки.
Что происходит с похожими признаками
Сильно коррелирующие столбцы несут пересекающуюся информацию. Lasso может выбрать один из них, а другой обнулить; при изменении выборки выбор способен поменяться. Квадратичная часть Elastic Net поощряет близкие веса у близких стандартизованных признаков, поэтому метод может сохранять их группой. Это тенденция, а не обещание, что любой набор коррелирующих признаков обязательно войдёт в модель целиком.
При положительном коэффициенте L2 целевая функция строго выпукла по весам, и решение для них единственно даже при линейной зависимости столбцов. Но единственность математического решения не превращает коэффициенты в причинные эффекты и не устраняет всю неопределённость. Для диагностики связей между признаками полезно отдельно изучить коэффициент инфляции дисперсии VIF. Высокий VIF указывает на проблему интерпретации обычных оценок, но не является автоматическим правилом удаления столбца.
Как подготовить данные и выбрать параметры
- Разделите данные на обучающую и отложенную тестовую части с учётом способа их получения. Для временных рядов нельзя случайно перемешать будущее с прошлым.
- Внутри каждого обучающего фолда оцените параметры заполнения пропусков и масштабирования. Примените их к соответствующему проверочному фолду, не обучая преобразования на нём.
- Переберите сетку значений и , оцените нужную метрику на кросс-валидации и выберите сочетание по заранее заданному правилу.
- Переобучите весь конвейер на доступной обучающей части и один раз оцените выбранную модель на тестовой части.
Масштабирование существенно: штраф накладывается на коэффициенты, а их величина зависит от единиц измерения признаков. Без него переход от метров к миллиметрам изменит относительную цену соответствующего веса. Категориальные и разреженные признаки требуют подходящего преобразования; масштабировать их нужно с учётом формата данных. Для оптимизации больших задач применяют разные методы, в том числе покоординатный спуск; общий принцип итерационного уменьшения ошибки можно сопоставить со стохастическим градиентным спуском.
Выбор метрики зависит от задачи: например, средняя квадратичная ошибка сильнее реагирует на крупные промахи, чем средняя абсолютная. Сравнивайте Elastic Net с простой базовой моделью на одних и тех же разбиениях. Если признаков немного и они стабильны, более сложная настройка может не принести заметной пользы. А для нелинейных зависимостей можно заранее создать обоснованные преобразования признаков или сравнить подход с другими моделями; пример альтернативной идеи - линеаризация нелинейной регрессии.
Как читать результат после обучения
После выбора параметров посмотрите не только на общую метрику, но и на отдельные ошибки. Например, модель может хорошо предсказывать типичные значения и систематически ошибаться на редких больших ответах. Разбейте проверочные прогнозы на осмысленные группы и сравните их с простой базовой моделью. Если данных немного, различие метрик между фолдами может оказаться важнее небольшой разницы средних значений.
Ненулевой вес означает, что признак участвует в конкретной обученной модели. Его величина относится к тому масштабу, в котором модель получила данные: после стандартизации она не выражена напрямую в исходных единицах. Чтобы объяснить прогноз на исходной шкале, нужно учесть преобразование и свободный член. Полезно также повторить подбор на других допустимых разбиениях: если состав выбранных признаков заметно меняется, уверенно называть один из них главным оснований мало. Итоговое решение оценивают по цели задачи: иногда важнее стабильный прогноз, иногда - компактная и понятная модель.
Частые ошибки
- Штрафуют признаки в разных единицах без масштабирования. Тогда выбор весов зависит от масштаба измерения, а не только от информации в данных.
- Масштабируют всю выборку до кросс-валидации. Проверочные фолды влияют на подготовку, и оценка качества становится оптимистичной.
- Переносят формулу из примера на коррелирующие столбцы. В общей задаче веса связаны, поэтому нужен совместный численный решатель.
- Считают нулевой вес доказательством отсутствия влияния. При других данных, признаках или параметрах отбора результат может измениться.
- Сравнивают параметры разных библиотек по одному имени. Сначала проверьте нормировку ошибки и обоих штрафов.
FAQ
Elastic Net всегда лучше Lasso?
Нет. Качество зависит от данных, шума, признаков и выбранной метрики. Проверяйте обе модели на одинаковых разбиениях и учитывайте стабильность результата.
Можно ли использовать метод, когда признаков больше объектов?
Да. Регуляризация позволяет решать такую задачу, но не заменяет проверку качества на новых данных. При положительной L2-части решение по коэффициентам единственно; его полезность всё равно нужно оценивать экспериментально.
Что означает отрицательный коэффициент?
В линейной модели он описывает направление изменения прогноза при изменении данного признака и фиксированных остальных. Отрицательный знак сам по себе не доказывает причинную связь; при корреляции признаков и сильном штрафе интерпретация особенно требует осторожности.
Коротко
Elastic Net объединяет L1-отбор и L2-сжатие коэффициентов. Сила и доля определяют штраф вместе, а их выбор следует проверять на данных вне обучения. Простой расчёт по каждому признаку работает при ортогональной матрице; для реальных связанных признаков используют численную оптимизацию и корректный конвейер подготовки.
Читайте также
Алгоритм XGBoost: как работает градиентный бустинг
Алгоритм XGBoost простыми словами: градиентный бустинг над деревьями решений, формула аддитивной модели, learning rate, регуляризация, ранняя остановка и разбор типовых задач.
Алгоритм ID3: как построить дерево решений
Алгоритм ID3 строит дерево решений по информационному выигрышу. Разбираем энтропию, выбор признака, пример расчёта, условия остановки и ограничения метода.
Алгоритм k-means: кластеризация по шагам
Алгоритм k-means простыми словами: как точки попадают в кластеры, как пересчитываются центроиды и сумма квадратов, как выбрать число групп и подготовить признаки.
Метрика precision recall: точность и полнота
Метрики precision и recall показывают качество положительных ответов классификатора. Разбираем формулы, выбор порога, PR-кривую и влияние редкого класса на примерах.
ROC-кривая и AUC: построение и смысл метрики
Как построить ROC-кривую по оценкам классификатора, вычислить AUC методом трапеций, выбрать порог и понять ограничения метрики на несбалансированных данных.
Классификация снимков: этапы, методы и оценка
Как работает классификация снимков: выбор классов, подготовка данных, обучение модели и оценка ошибок. Учебный пример для проверки качества классификатора.