Алгоритм ID3: как построить дерево решений
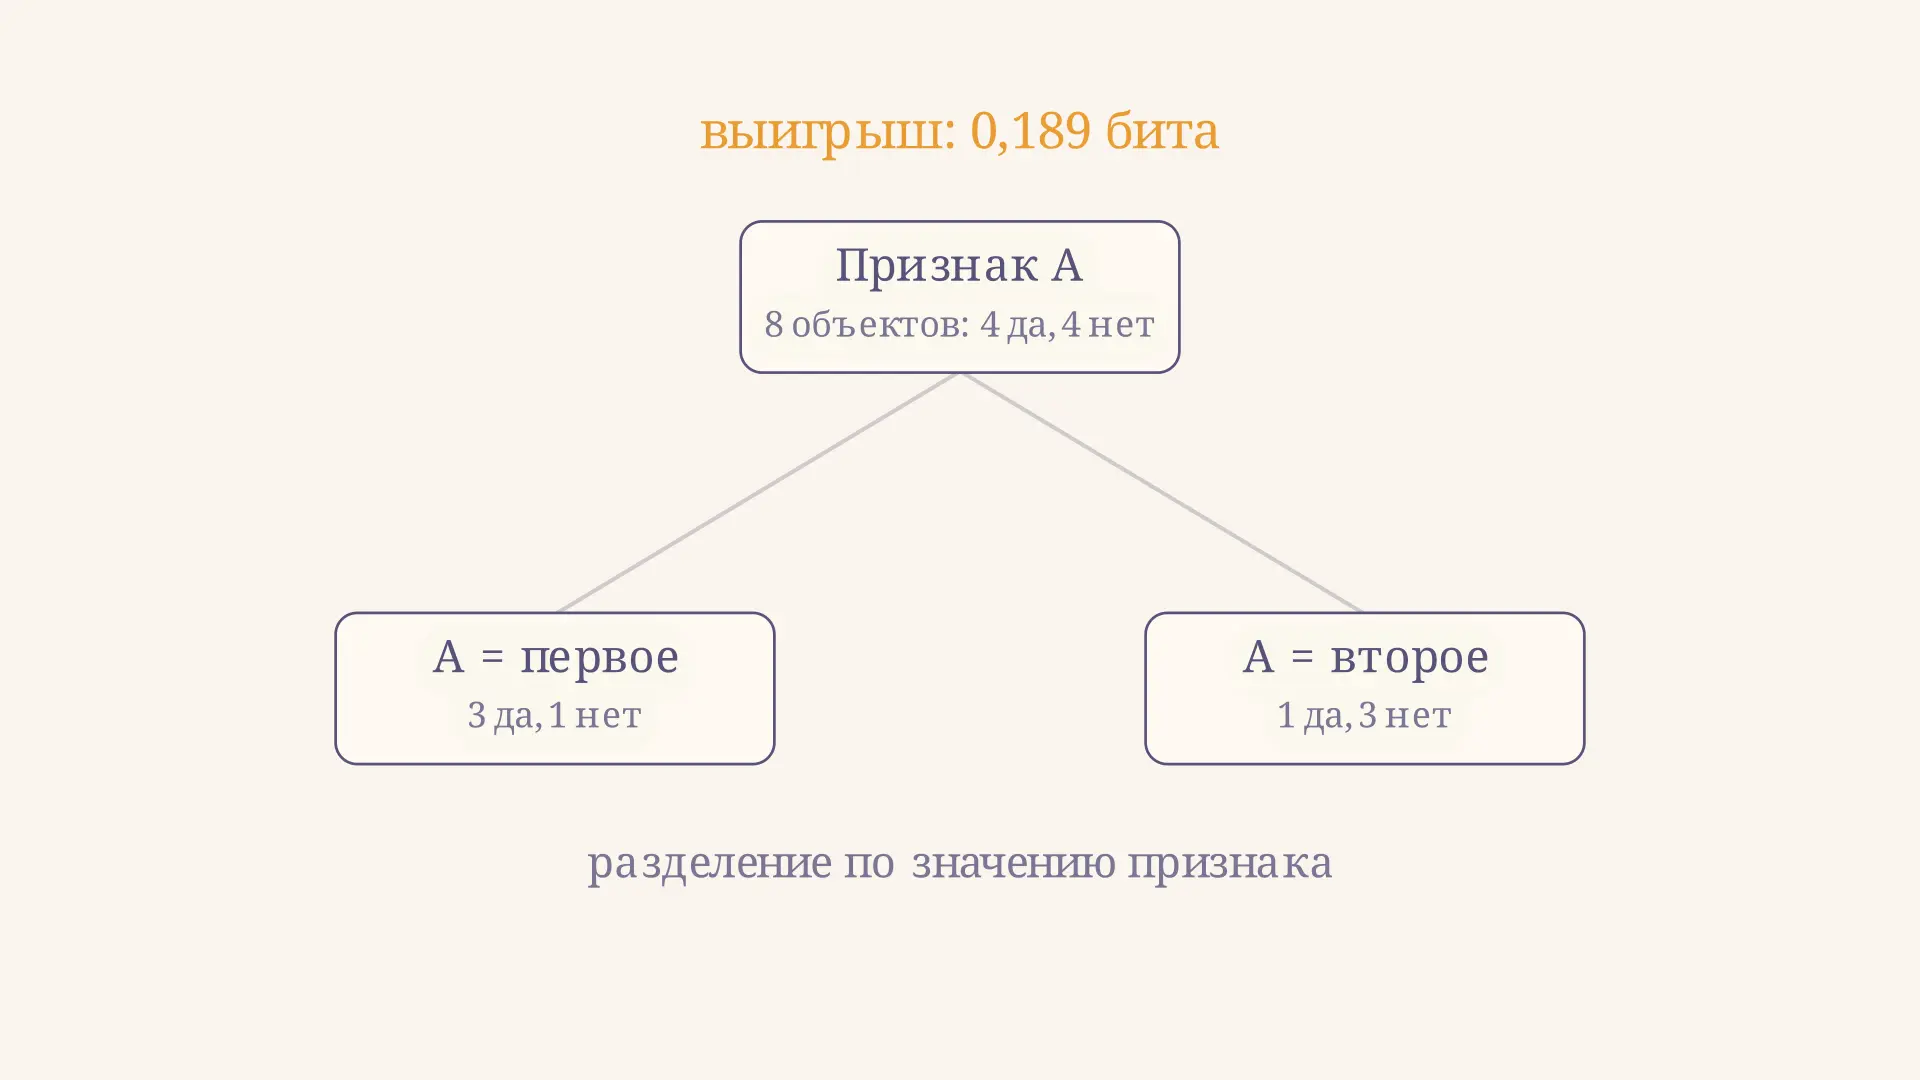
Алгоритм ID3 строит дерево решений по размеченным примерам: на каждом шаге он выбирает признак, который сильнее всего уменьшает неопределённость класса. Получается последовательность вопросов, по которым можно отнести новый объект к одной из категорий. Ниже разберём, как измерить качество вопроса энтропией, вычислить информационный выигрыш и понять, когда построение заканчивается. В калькуляторе можно менять состав двух ветвей и сразу видеть, насколько полезным получилось разделение.
От таблицы примеров к вопросам
Представим учебную таблицу с ответом «да» или «нет» для каждого объекта и несколькими категориальными признаками. Нужно построить правило, которое по признакам предсказывает ответ. Дерево начинается с корня, в котором находятся все обучающие объекты. Внутренний узел проверяет признак, ветви соответствуют его значениям, а лист выдаёт класс.
ID3 рассматривает доступные признаки и выбирает лучший для текущего набора объектов. Затем повторяет выбор отдельно внутри каждой получившейся группы. Поэтому один и тот же признак может оказаться полезным в одной части дерева и бесполезным в другой. Решение локально: алгоритм не перебирает все возможные деревья и не гарантирует самое маленькое из них.
При применении готового дерева обратного хода нет: объект проходит от корня до листа по значениям своих признаков. В отличие от обхода графа в ширину, для классификации здесь не нужно посещать все узлы: выбирается один путь.
Энтропия: насколько смешаны классы
Энтропия измеряет неоднородность меток в текущей группе. Для выборки с классами и долями она определяется формулой:
Слагаемое с принимают равным нулю. Основание два даёт единицу измерения бит. Если все объекты принадлежат одному классу, энтропия равна нулю. Для двух классов максимум равен одному биту и достигается при равных долях. Это мера состава группы, а не число ошибок конкретного классификатора.
Пусть в корне восемь объектов: четыре «да» и четыре «нет». Тогда , поэтому бит. Если группа содержит три «да» и одно «нет», её энтропия приблизительно равна бита. Класс большинства уже виден, но группа ещё не однородна. Для состава один к трём получится та же энтропия: формула не зависит от названия класса.
Как считается информационный выигрыш
Допустим, признак делит на подмножества по своим значениям . Среднюю энтропию после разделения считают с весами, равными долям объектов в ветвях:
Вес важен: большая ветвь влияет на среднее сильнее маленькой. Пустая ветвь имеет нулевой вес. Чем больше выигрыш, тем сильнее на этой выборке признак уменьшает среднюю неопределённость метки. Для обычного разбиения одной и той же выборки он неотрицателен; ноль означает, что пропорции классов в непустых ветвях совпадают с исходными.
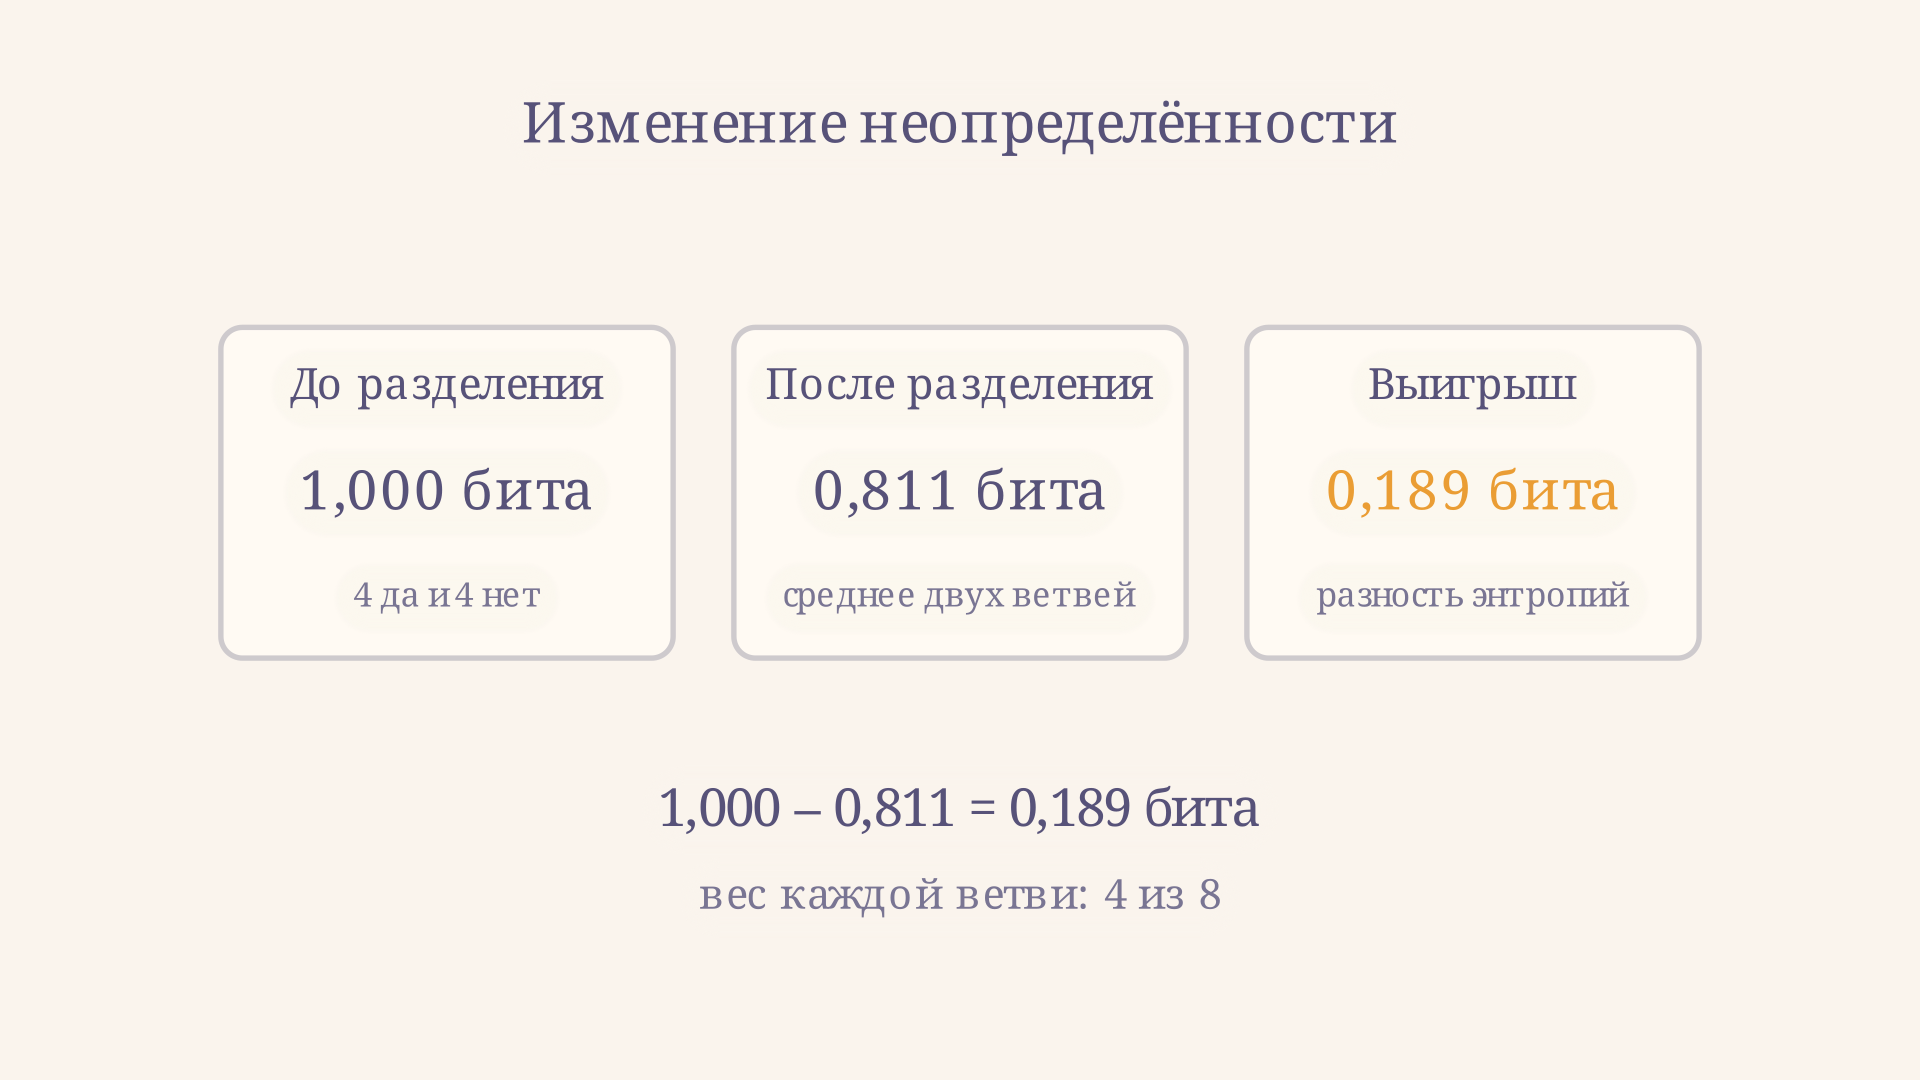
Сравнивать признаки нужно на одном наборе объектов: в корне - на всей обучающей выборке, ниже - только на объектах, попавших в соответствующий узел. В калькуляторе можно проверить крайние случаи: чистые ветви дают максимальный выигрыш для заданного состава корня, а одинаковые пропорции классов - нулевой.
Пример выбора корня
Возьмём те же восемь объектов. Кандидат делит их на две равные группы: в первой три «да» и одно «нет», во второй одно «да» и три «нет». Для каждой из них энтропия приблизительно бита. Вес каждой ветви равен , следовательно:
Пусть второй кандидат делит те же объекты на группы по четыре, в каждой из которых по два объекта каждого класса. Энтропия обеих групп равна единице, поэтому . Из этих двух кандидатов ID3 выберет . Если доступны другие признаки, их нужно вычислить и сравнить так же: победа над одним соперником ещё не доказывает максимальный выигрыш среди всех.
Результат не означает точность . Он выражен в битах и характеризует изменение энтропии на обучающих примерах. Кроме того, листья после первого разделения остаются смешанными. Чтобы продолжить построение, понадобятся значения оставшихся признаков для объектов внутри каждой ветви; одних суммарных чисел в примере для этого недостаточно.
Рекурсия и остановка
Для каждого узла базовую процедуру можно записать так:
- Если все объекты имеют один класс, создать лист с этим классом.
- Если признаки закончились, создать лист с классом большинства; правило разрешения ничьей задать заранее.
- Вычислить выигрыш каждого оставшегося признака на объектах узла и выбрать максимальный.
- Разделить объекты по значениям признака и повторить процедуру для каждой непустой группы.
- Для пустой ветви, если она предусмотрена набором возможных значений, использовать заранее заданный запасной ответ, например большинство родительского узла.
При равном выигрыше признаков также нужна детерминированная договорённость, например порядок столбцов таблицы. Базовый ID3 может продолжить разделение даже при нулевом выигрыше, пока остаются признаки: сочетание нескольких признаков иногда полезно, хотя каждый из них по отдельности ничего не даёт. Ограничение глубины или остановка при малом выигрыше - практические модификации, способные уменьшить дерево, но меняющие результат.
Следует различать тренировку и применение. При тренировке метки известны и участвуют в расчёте энтропии. При применении метка неизвестна: дерево просто проверяет признаки нового объекта. Качество таких предсказаний оценивают на отложенных данных, в том числе с помощью матрицы ошибок.
Как читать готовое правило
Путь от корня до листа можно переписать как условие вида «если значение первого признака такое и значение второго такое, то предсказанный класс - да». Каждая проверка сужает группу объектов, к которой относится правило. Например, после выбора первой ветви признака в нашем примере остаются четыре учебных объекта. Само по себе это ещё не окончательное правило: среди них есть и «да», и «нет».
Если дальнейшие признаки закончились, лист выдаст большинство, то есть «да». На этих четырёх учебных объектах такое решение ошибётся один раз. Но доля три из четырёх не является гарантированной вероятностью для будущих случаев: выборка мала и могла быть нерепрезентативной. Если же следующий признак разделит группу на однородные подгруппы, появятся отдельные листья для обоих ответов. Поэтому при чтении дерева полезно смотреть не только на итоговый класс, но и на количество примеров, на которых основан лист.
Ограничения и практические решения
Информационный выигрыш склонен отдавать предпочтение признакам с большим числом значений. Например, уникальный номер записи создаст чистые ветви по одному объекту и высокий выигрыш на обучении, но не поможет классифицировать новый номер. Удаление идентификаторов и проверка на независимой выборке помогают обнаружить такую ловушку. Большое дерево может также запомнить шум вместо закономерностей: это переобучение.
Классическое изложение ID3 обычно начинают с категориальных признаков и известных значений. Для числовой величины требуется определить порог или интервалы; для пропуска и неизвестной категории при применении - выбрать явную стратегию. Такие решения нельзя оставлять неоговорёнными. В работе Росса Куинлана об индукции деревьев описаны ID3 и расширения подхода к неполным и шумным данным. Последующие семейства деревьев используют и другие критерии, и способы обработки признаков.
Отдельное дерево удобно читать как набор правил, но его структура может сильно измениться при небольших изменениях данных. Случайный лес объединяет множество деревьев, а бэггинг объясняет общий принцип обучения моделей на разных выборках. Это другие методы, а не обязательные этапы ID3.
Частые ошибки
- Складывать энтропии ветвей без весов. Нужно умножить каждую на долю объектов в ней; иначе маленькая ветвь будет влиять слишком сильно.
- Выбирать минимальную энтропию одной ветви. Сравнивают взвешенное среднее всех ветвей и затем выигрыш относительно родителя.
- Использовать весь исходный набор на каждом уровне. После первого разбиения расчёт ведётся отдельно для каждого подмножества.
- Путать чистоту обучающих листьев с качеством на новых данных. Для оценки нужна отложенная выборка, не участвовавшая в выборе разбиений.
- Считать нулевой выигрыш автоматическим доказательством бесполезности всех следующих разбиений. Совместное действие признаков может проявиться только глубже.
FAQ
ID3 подходит только для двух классов?
Нет. Формула энтропии суммирует вклады всех классов. Число ветвей категориального признака тоже может быть больше двух.
Что делать при равном числе объектов разных классов в листе?
Заранее определить правило: например, выбрать фиксированный класс или класс большинства родительского узла. Выбор влияет на предсказания, поэтому его нужно зафиксировать при оценке модели.
Почему лучший первый вопрос не гарантирует лучшее дерево?
ID3 выбирает признак жадно, по выигрышу в текущем узле. Он не проверяет все будущие комбинации разбиений; другой первый вопрос иногда приводит к более компактному дереву.
Коротко
ID3 рекурсивно строит дерево классификации, выбирая в каждом узле признак с максимальным информационным выигрышем. Энтропия измеряет смешанность классов, а выигрыш сравнивает её до и после взвешенного разбиения. В примере с восемью объектами группы 3:1 и 1:3 дают около бита; надёжность полученных правил следует проверять на новых данных.
Читайте также
Алгоритм CART: как построить дерево решений
Алгоритм CART строит бинарное дерево для классификации и регрессии. Разбираем индекс Джини, выбор порога, числовой пример, обрезку и ограничения модели.
Алгоритм k-means: кластеризация по шагам
Алгоритм k-means простыми словами: как точки попадают в кластеры, как пересчитываются центроиды и сумма квадратов, как выбрать число групп и подготовить признаки.
Энтропия в химии: формулы и смысл реакции
Энтропия в химии: как вычислить изменение энтропии реакции, учесть окружение и связать энтальпию с энергией Гиббса. Примеры расчёта, единицы измерения и частые ошибки.
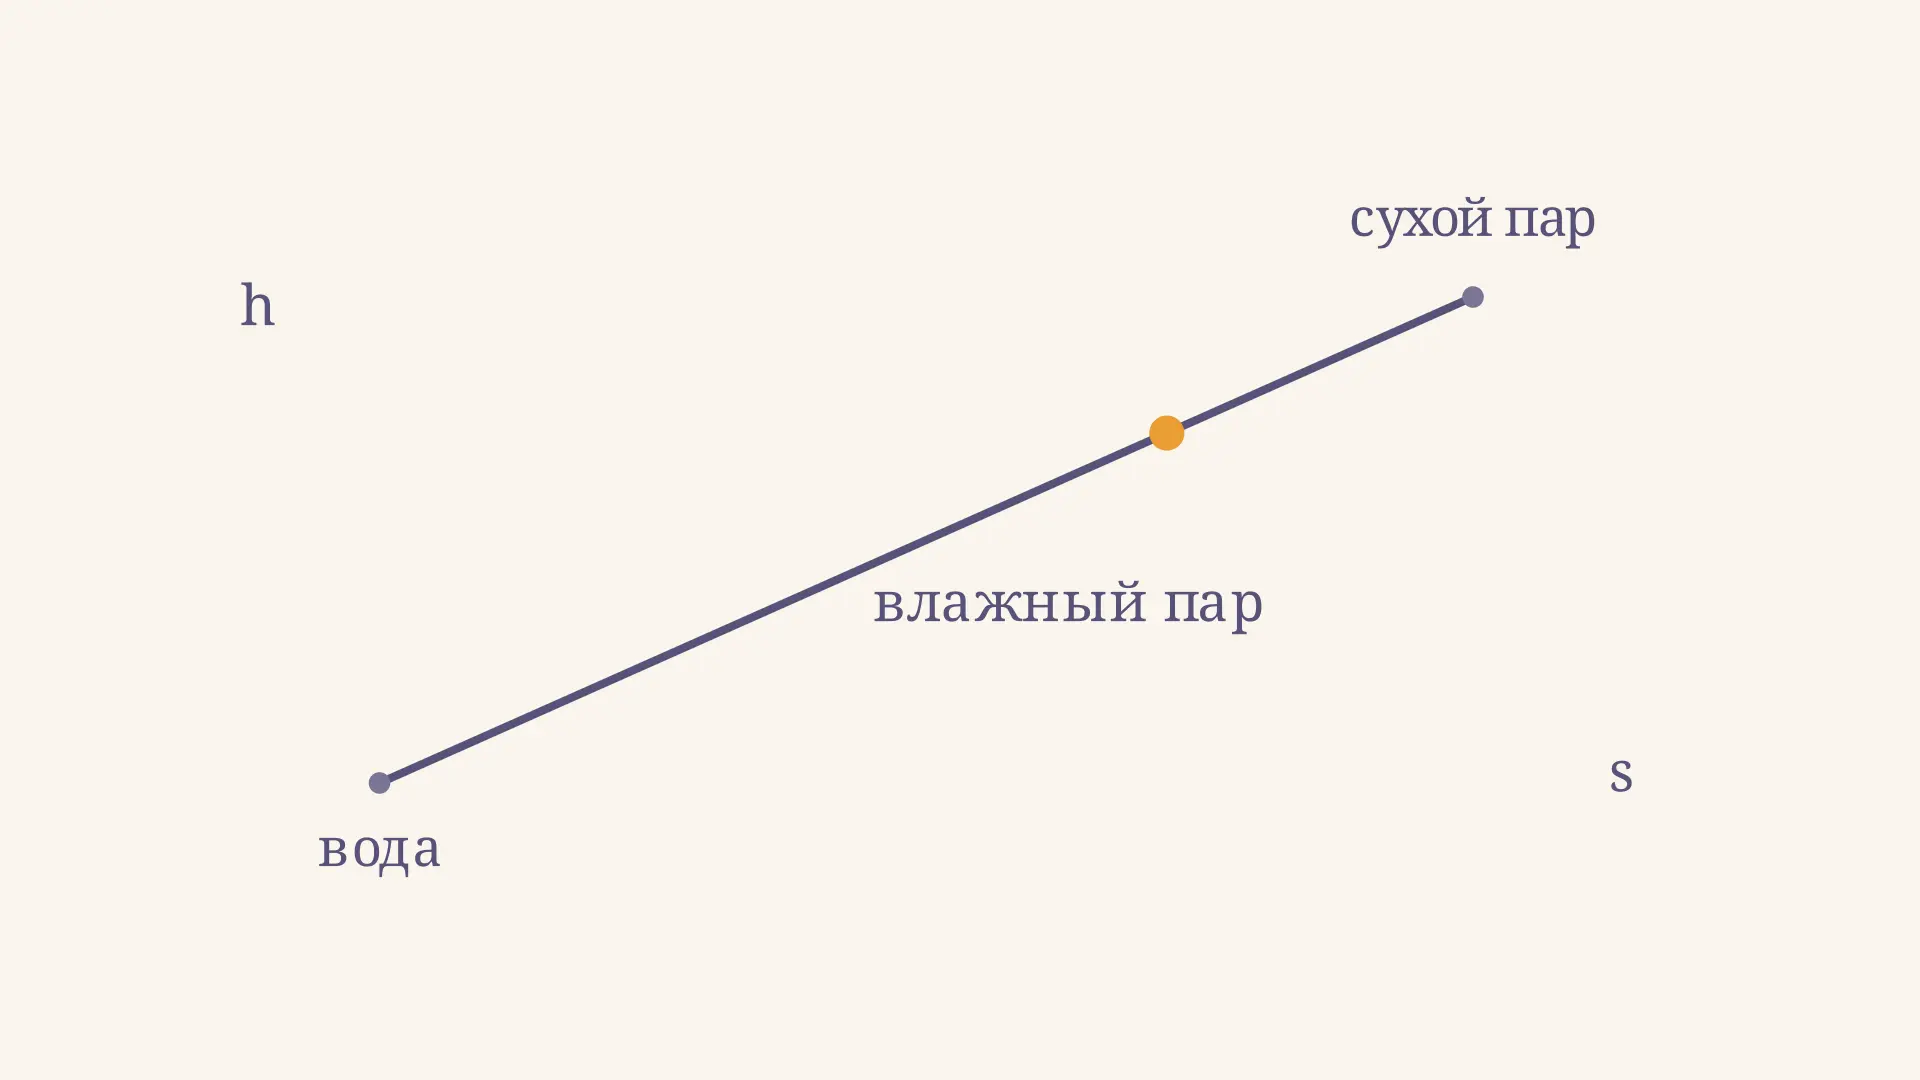
h-s диаграмма водяного пара: процессы и расчёт
Как читать h-s диаграмму водяного пара, находить степень сухости и изображать расширение в турбине, дросселирование и нагрев. Пример расчёта по таблице насыщения.
Изменение энтропии при нагревании вещества
Как найти изменение энтропии при нагревании вещества: формула через теплоёмкость, расчёт с логарифмом, переменная теплоёмкость и границы применимости модели.
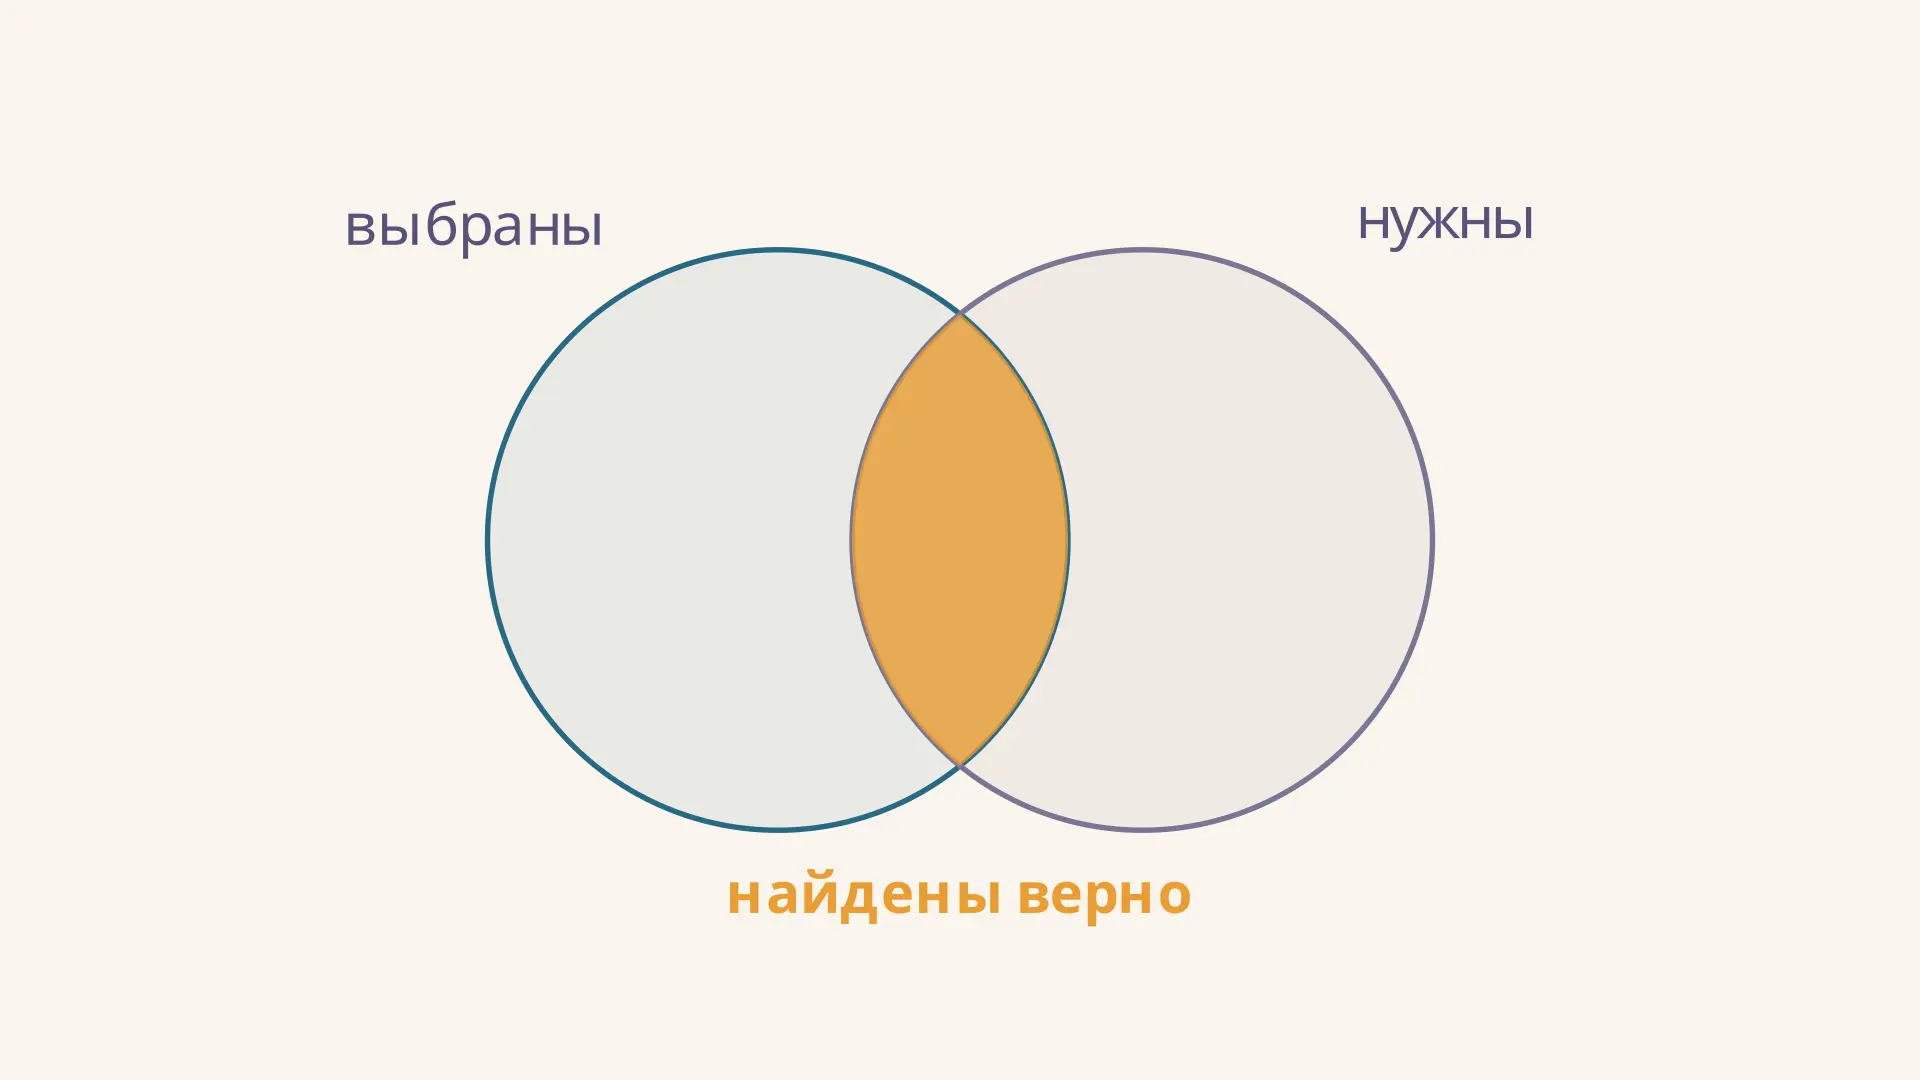
Метрика precision recall: точность и полнота
Метрики precision и recall показывают качество положительных ответов классификатора. Разбираем формулы, выбор порога, PR-кривую и влияние редкого класса на примерах.