Алгоритм CART: как построить дерево решений
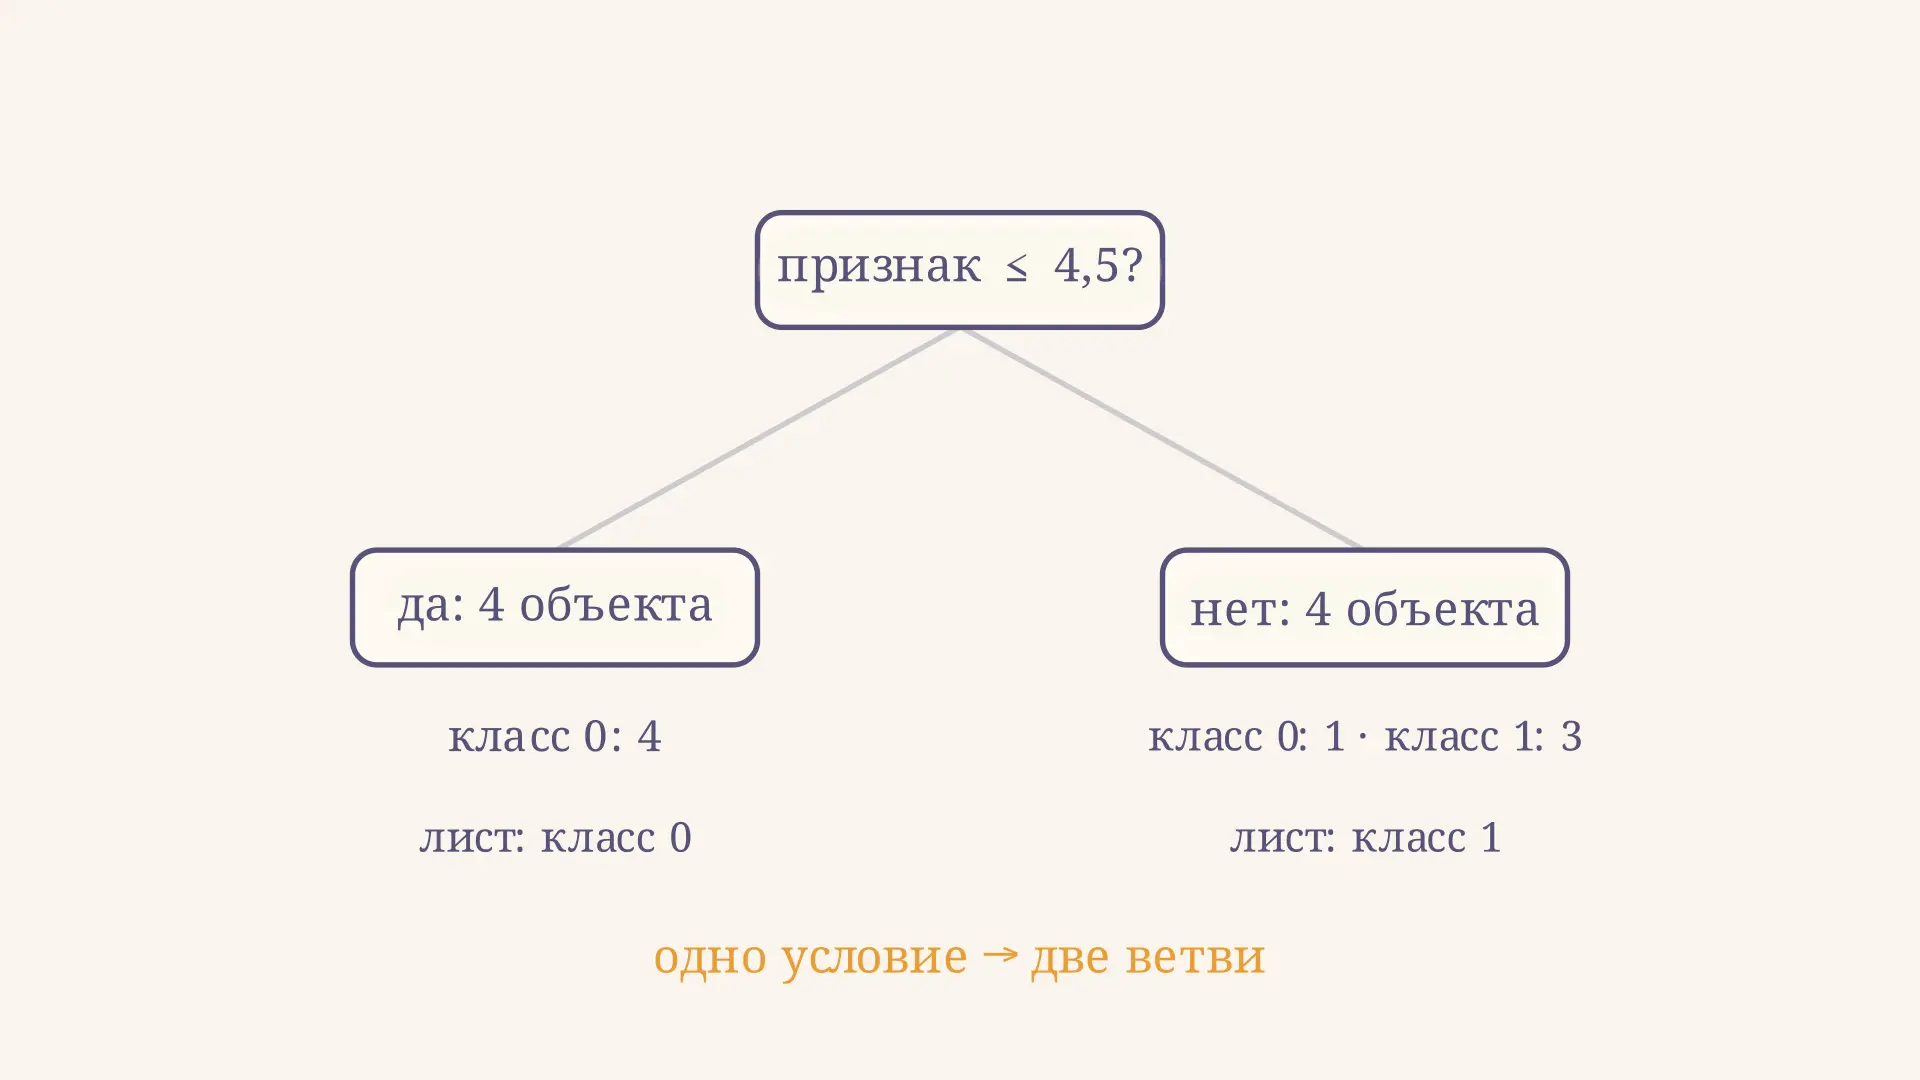
Алгоритм CART строит дерево решений из последовательности простых вопросов. Каждый вопрос делит обучающие объекты на две группы: например, значение признака не больше порога или больше него. Так можно предсказывать как класс объекта, так и число. Разберём выбор порога по индексу Джини, расчёт для восьми примеров и способы ограничить размер дерева. В калькуляторе можно сравнить все пороги этой учебной выборки.
Как устроено бинарное дерево
CART расшифровывается как Classification and Regression Trees: деревья классификации и регрессии. Обучающая таблица содержит признаки объектов и известную целевую переменную. В классификации цель - категория, например «да» или «нет»; в регрессии - число, например время доставки.
В корень попадают все обучающие объекты. Алгоритм выбирает условие и отправляет объекты в одну из двух ветвей. Затем он отдельно ищет условия в полученных группах. Узел без дальнейшего разделения называют листом: он хранит предсказание для объектов, которые в него попадут.
После обучения новому объекту не нужна известная метка: его признаки последовательно проверяют в узлах до листа. Возврат маркера в видео нужен для повтора; при обычном предсказании дерево проходит только от корня к листу. Дерево может использовать один и тот же числовой признак повторно на разных уровнях.
Индекс Джини и качество разбиения
Для классификации одна из типичных мер неоднородности узла - индекс Джини. Если доля класса в узле равна , то
Чистый узел с одним классом имеет . Для двух классов наибольшее значение равно при равных долях. Джини характеризует состав узла, а не долю ошибок готового дерева. Если в листе четыре объекта класса 0 и один класса 1, индекс равен , тогда как ошибка предсказания класса большинства на этих объектах составит .
Кандидатное условие создаёт левую и правую группы размера и . Их показатели усредняют с учётом размера, а не поровну:
Для одного узла выбирают допустимое разделение с наименьшим , то есть с наибольшим снижением . Вес не позволяет маленькой чистой ветви скрыть неоднородность большой. Выбор жадный: лучшее условие сейчас не гарантирует глобально оптимальное дерево целиком.
Числовой пример выбора порога
Пусть признак последовательно принимает значения от 1 до 8, а классы объектов в том же порядке равны . Это искусственная выборка для расчёта. В корне пять объектов класса 0 и три класса 1, поэтому .
Рассмотрим условие . В левой группе четыре объекта класса 0, поэтому . Справа один объект класса 0 и три класса 1: . Ветви равны по размеру, и потому
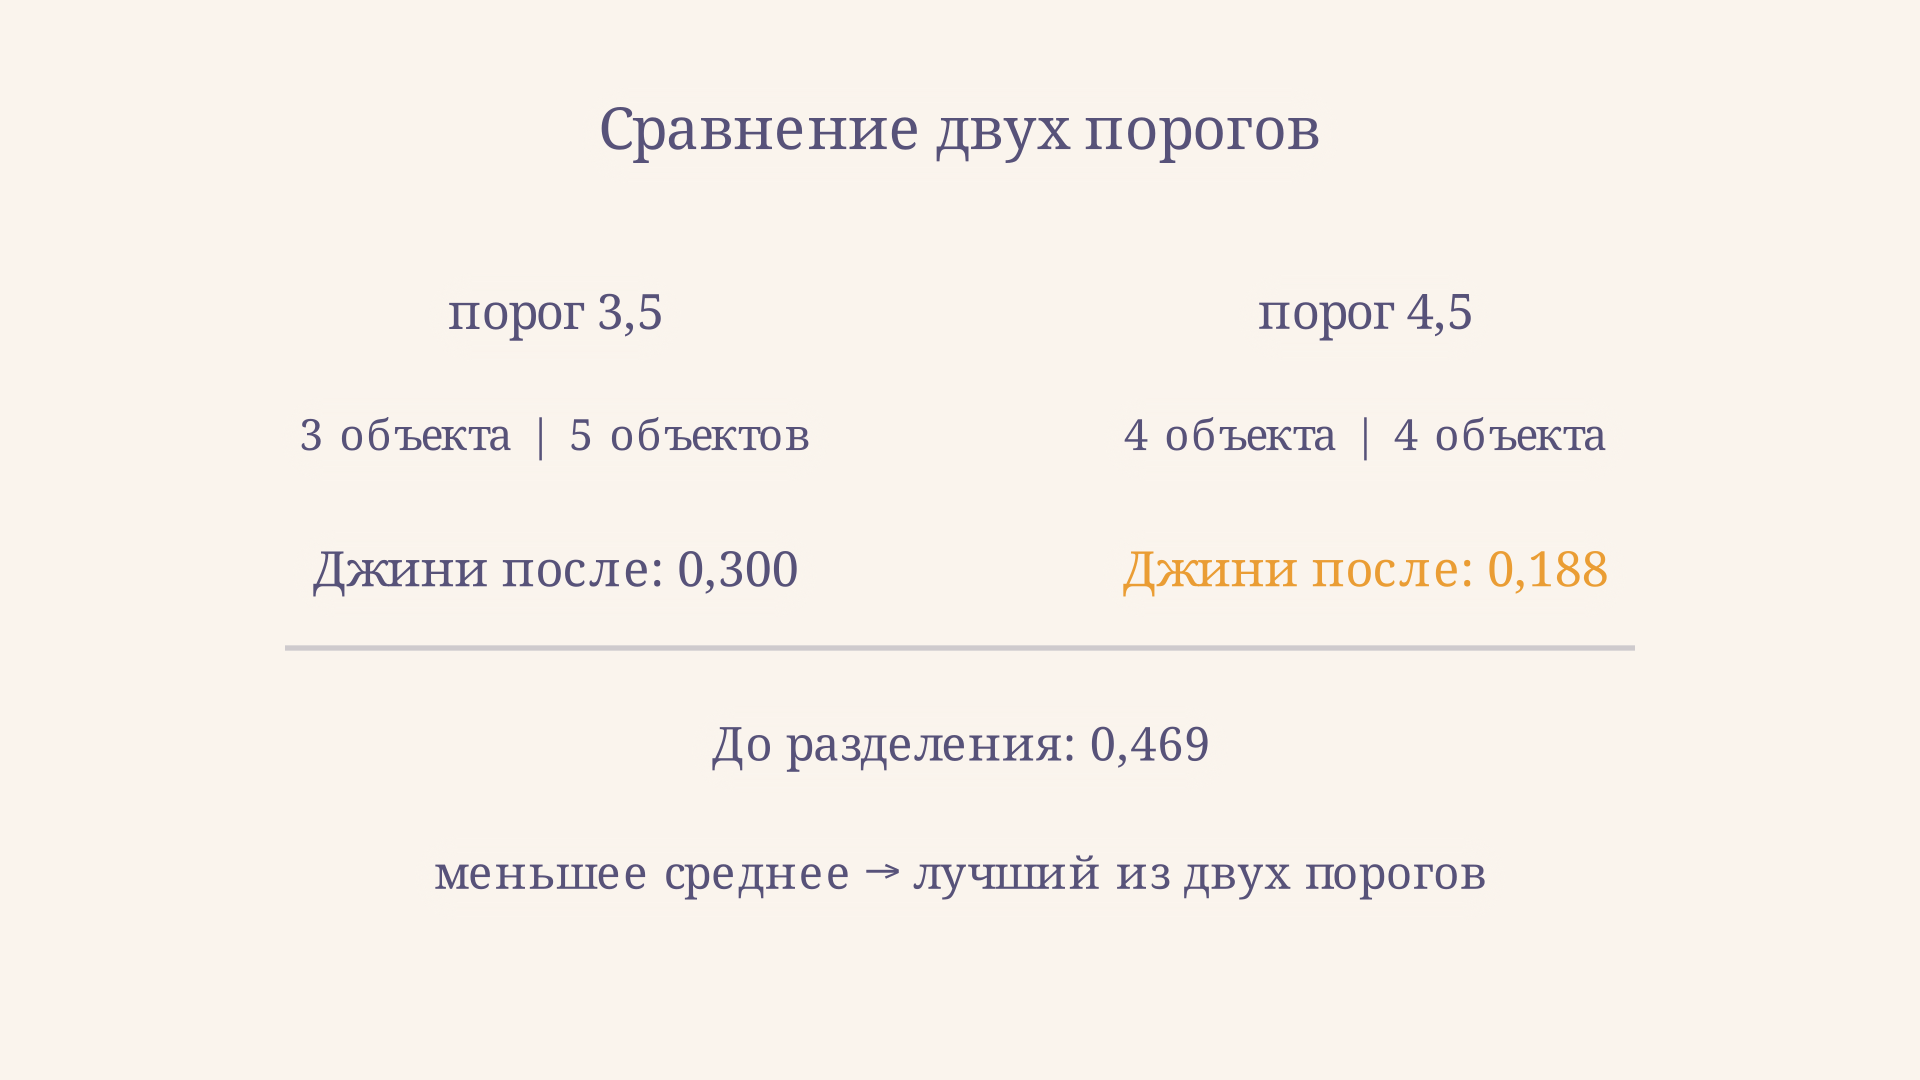
Для порога слева три объекта класса 0, а справа два класса 0 и три класса 1. Среднее равно . Значит, из этих двух условий лучше . Перебор всех семи промежутков показывает, что оно лучше и остальных: следующий по качеству порог даёт примерно . Значения на рисунке и в калькуляторе округлены до трёх знаков.
Порог выбирают между соседними различными значениями признака: внутри такого промежутка состав ветвей одинаков. При равенстве результатов нужна заранее установленная договорённость о выборе. Пример проверяет только один признак; если признаков несколько, аналогично сравнивают допустимые условия по каждому из них.
Что происходит после первого деления
Левый лист нашего примера чистый и предсказывает класс 0. Правая группа содержит значения с классами ; если рост продолжить, CART будет искать новый порог только среди этих четырёх объектов. Например, отделяет пару с классами от чистой пары . Затем смешанную пару можно разделить порогом .
На обучающих данных такое дерево станет чистым, но это ещё не доказательство хороших прогнозов для новых объектов. Класс в листе обычно выбирают по большинству; при равенстве действует правило конкретной реализации. Доли обучающих классов в листе можно использовать как оценки вероятностей, но в очень маленьком листе они особенно нестабильны.
По идее рекурсивных вопросов CART близок к алгоритму ID3. При этом классический ID3 выбирает категориальный признак по информационному выигрышу, а CART строит бинарные разделения и применим также к числовой цели. Критерии и возможности зависят от реализации.
Перед построением дерева полезно проверить, что каждый столбец действительно доступен в момент прогноза. Например, признак с итогом уже принятого решения может дать почти идеальное разбиение в обучении, но его нельзя использовать для прогноза до принятия решения. Такая утечка данных делает оценку качества обманчивой независимо от выбранного критерия.
Разделение по одному признаку удобно объяснять как границу на числовой прямой. При двух признаках последовательность таких проверок выделяет прямоугольные области на плоскости. Форма областей зависит от порядка вопросов: сначала можно отделить низкие значения одного признака, а внутри полученной группы проверить другой. Каждая область соответствует своему листу и одному прогнозу.
Если цель числовая: регрессия
При регрессии классов нет, поэтому Джини неприменим. При квадратичной функции потерь типичный лист предсказывает среднее значение цели в нём, а качество разделения оценивают суммой квадратов отклонений от средних в двух ветвях. Например, для целей среднее равно , а сумма квадратов ошибок равна .
Для каждого кандидата рассчитывают такую ошибку отдельно слева и справа и складывают результаты. Меньшая сумма означает лучшее разделение на текущих данных. Аналогичная запись через среднеквадратичные ошибки узлов использует веса по числу объектов. Модель в итоге выдаёт постоянное значение в каждом листе, поэтому прогноз меняется ступенчато, когда объект переходит границу области.
Остановка и обрезка
Если делить данные до чистоты или до единичных объектов, дерево может запомнить шум. Ограничения глубины и минимального числа объектов в листе останавливают рост заранее. Они упрощают модель, но слишком строгие ограничения могут скрыть важные закономерности.
Другой подход - сначала вырастить дерево, а затем удалить часть ветвей. При обрезке по стоимости сложности сравнивают качество дерева и число листьев с параметром штрафа: больший штраф обычно ведёт к более простой модели. Значения ограничений и штрафа выбирают на валидации или кросс-валидации, а итоговое качество проверяют на данных, не участвовавших в подборе.
Одно дерево удобно читать, но небольшое изменение выборки может изменить раннее разбиение и всю структуру ниже. Случайный лес объединяет множество деревьев, чтобы снизить эту нестабильность. Деревья служат базовыми моделями и в бэггинге и в градиентном бустинге XGBoost, хотя процедуры обучения ансамблей различаются.
При интерпретации дерева важно различать правило и причину. Если модель часто ставит признак ближе к корню, это означает, что он оказался полезен для разбиения именно в этих данных и при выбранных настройках. Из этого нельзя заключить, что изменение признака само по себе вызовет изменение результата. Связанные между собой признаки также могут конкурировать за одно и то же разделение.
Перед применением дерева стоит посмотреть не только общую точность, но и ошибки для важных классов или диапазонов числовой цели. При редком положительном классе высокий общий процент правильных ответов может скрывать пропущенные положительные случаи. Для классификации матрица ошибок помогает отдельно увидеть пропуски и ложные срабатывания. Поэтому метрику выбирают исходя из задачи, а не только из того, насколько чистыми получились листья.
Частые ошибки
- Усреднять показатели ветвей без весов. Для ветвей разного размера это меняет оценку разбиения и может изменить выбранный порог.
- Считать снижение Джини точностью. Оно измеряет изменение неоднородности обучающего узла, а качество предсказаний проверяют отдельно.
- Сравнивать пороги на разных подвыборках. Внутри узла все кандидаты оценивают на одних и тех же попавших в него объектах.
- Считать чистый лист гарантией обобщения. Модель могла запомнить особенности обучающей выборки; нужна независимая оценка.
- Предполагать одинаковую обработку пропусков и категорий. Возможности и настройки зависят от библиотеки, поэтому их проверяют в документации выбранной реализации.
FAQ
CART всегда использует индекс Джини?
Нет. Джини часто применяют для классификации, но реализации могут предлагать и другие критерии. Для регрессии выбирают функцию потерь для числовой цели.
Можно ли использовать один признак несколько раз?
Да. В разных узлах и даже на одном пути дерево может проверять разные пороги одного признака, последовательно сужая диапазон.
Нужно ли нормировать числовые признаки?
Для обычных пороговых разделений положительное линейное масштабирование сохраняет порядок значений и возможные разбиения. Однако требования конкретного конвейера и обработку пропусков следует проверять отдельно.
Коротко
CART рекурсивно делит данные на две части и сохраняет прогноз в каждом листе. В классификации индекс Джини помогает сравнить неоднородность ветвей с учётом их размера; в регрессии используют функцию потерь для чисел. Выбор в каждом узле локален, поэтому размер дерева и качество на новых данных нужно контролировать отдельно.
Читайте также
Алгоритм ID3: как построить дерево решений
Алгоритм ID3 строит дерево решений по информационному выигрышу. Разбираем энтропию, выбор признака, пример расчёта, условия остановки и ограничения метода.
ROC-кривая и AUC: построение и смысл метрики
Как построить ROC-кривую по оценкам классификатора, вычислить AUC методом трапеций, выбрать порог и понять ограничения метрики на несбалансированных данных.
Бинарная номенклатура Линнея: правила и примеры
Бинарная номенклатура Линнея: почему вид называют двумя словами, как писать латинское имя, что значат автор и год, как действуют приоритет, тип и кодексы.
Функция активации softmax: формула и расчёт
Функция активации softmax простыми словами: как из логитов получить вероятности классов, как вывести формулу, зачем нужна температура и численная устойчивость, где ошибаются студенты.
Модель с фиксированными эффектами: формула и пример
Модель с фиксированными эффектами для панельных данных: формула, расчёт на примере двух фирм, метод отклонений от средних, условия применения и ограничения.
Построение дерева решений: пример расчёта
Как построить дерево решений для экономической задачи: узлы выбора и случайных событий, вероятности, расчёт ожидаемой прибыли и проверка чувствительности.