Тест Льюнга-Бокса: проверка автокорреляции
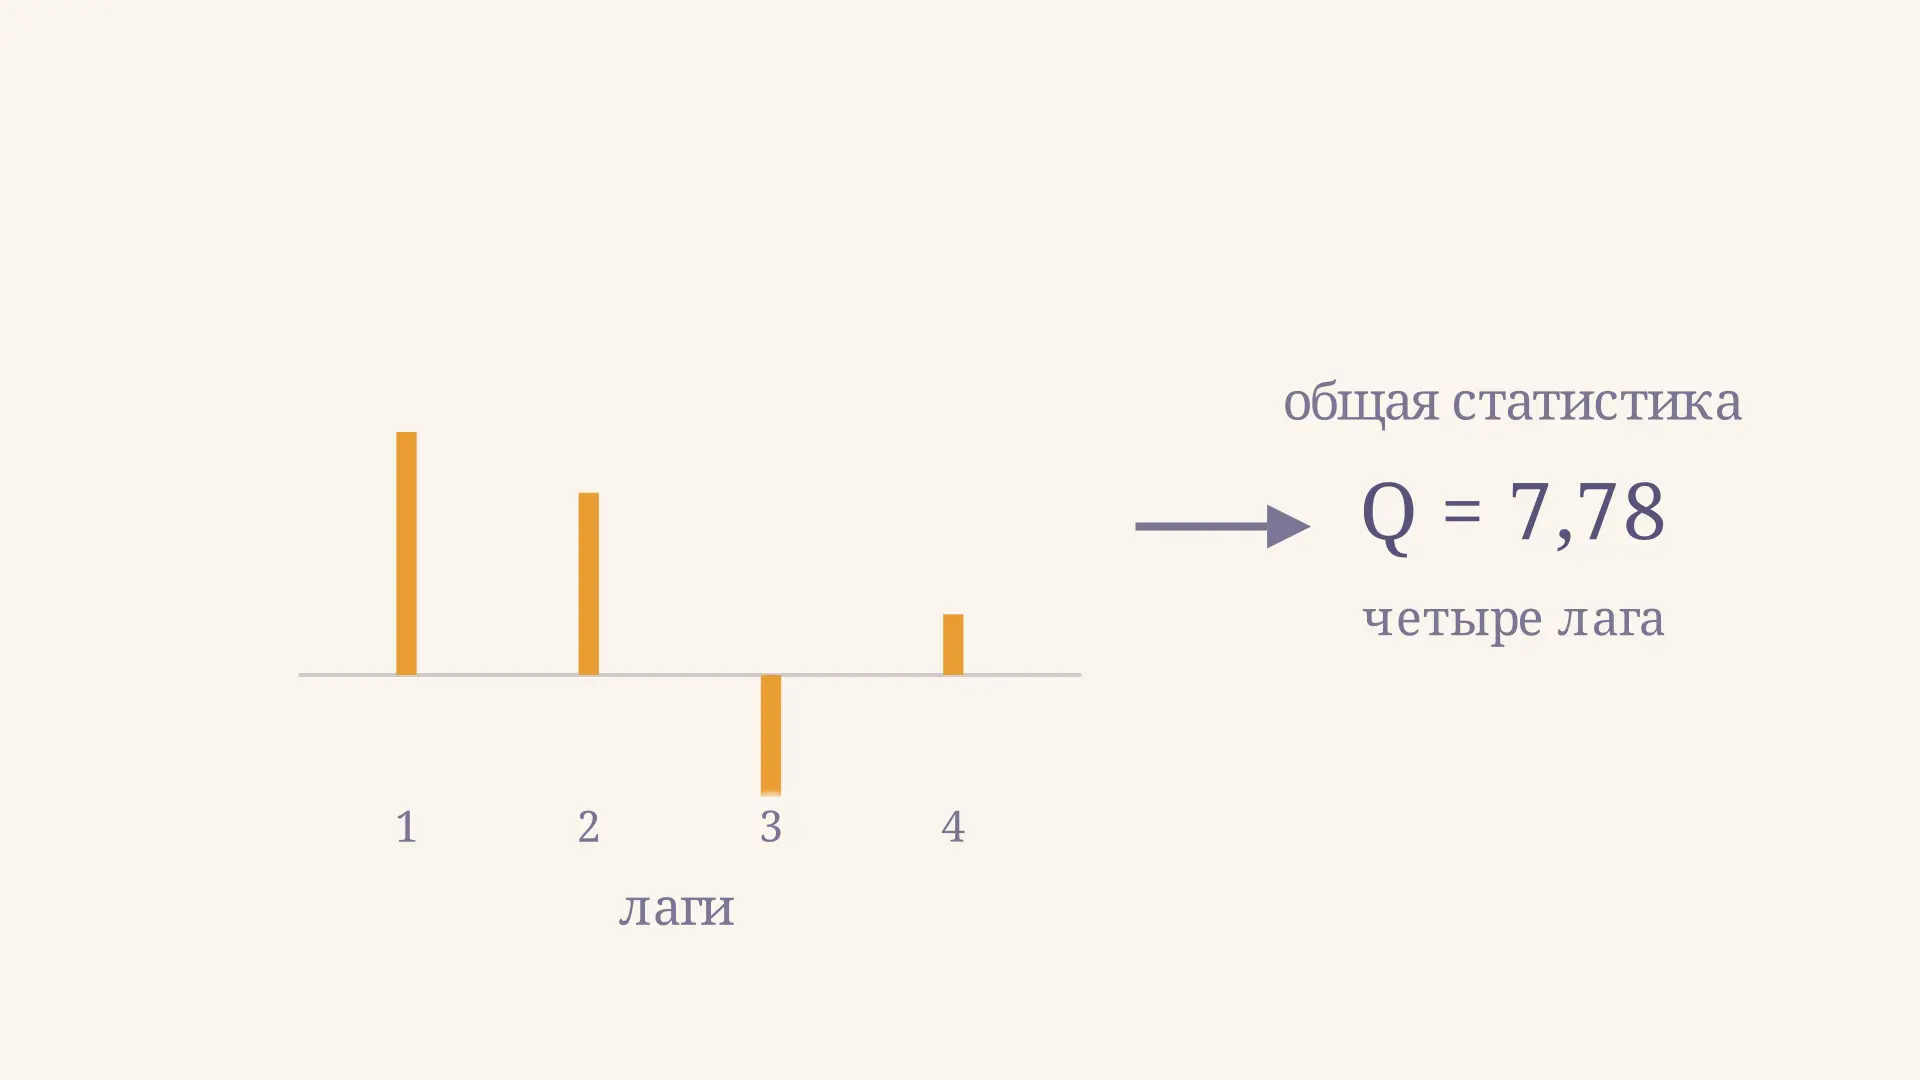
Тест Льюнга-Бокса помогает выяснить, осталась ли во временном ряду линейная зависимость от прошлых значений сразу на нескольких лагах. Его часто применяют к остаткам модели прогноза: если модель уловила временную структуру, заметной автокорреляции в остатках быть не должно. В учебном калькуляторе ниже можно менять число включённых лагов и наблюдать, как отдельные корреляции складываются в общую статистику.
Что проверяет совместный тест
Пусть - остаток модели в момент . Автокорреляция на лаге описывает линейную связь между и . Например, лаг 1 связывает соседние периоды, а лаг 4 для квартальных данных может указать на годовую сезонность. Отдельный коэффициент показывает только один сдвиг; тест Льюнга-Бокса объединяет первые коэффициентов в одну проверку.
Нулевая гипотеза утверждает, что истинные автокорреляции на лагах от 1 до одновременно равны нулю. Альтернатива : хотя бы одна из них отлична от нуля. Тест называют портманто-тестом: он собирает свидетельства из нескольких лагов в одну статистику. Он не говорит автоматически, какой именно лаг вызвал отклонение; для этого дополнительно изучают график автокорреляционной функции и саму модель.
Квадраты коэффициентов делают вклад неотрицательным: и положительная, и отрицательная корреляция увеличивают . На видео возвращение к первому лагу показывает тот же расчёт в обратном порядке, а не изменение исходных наблюдений.
Формула статистики и её смысл
Для ряда из наблюдений и выбранной верхней границы лагов статистика равна
Здесь - выборочная автокорреляция на лаге . При обычном определении она вычисляется как сумма произведений отклонений от среднего с временным сдвигом, делённая на сумму квадратов отклонений без сдвига:
Таким образом, порядок данных важен: перед вычислением нужно расположить наблюдения по времени и обработать пропуски, учитывая интервалы. Знаменатель в формуле учитывает число доступных пар на данном лаге, а множитель отличает эту статистику от более простой статистики Бокса - Пирса. Формулу и назначение диагностики приводит справочник NIST.
Для интерпретации отдельной связи полезно сначала разобрать коэффициент автокорреляции остатков. Совместная статистика отвечает на другой вопрос: достаточно ли велики все включённые связи в совокупности, чтобы возникло основание отвергнуть общую нулевую гипотезу.
Пример расчёта для четырёх лагов
Предположим, что в учебном ряду , а уже рассчитанные автокорреляции равны , , и . Это условные исходные данные, а не результаты исследования. Параметры модели не оценивались, поэтому для иллюстрации используем четыре степени свободы. При получаем:
Вклады по порядку составляют примерно , , и . Их округлённые значения дают небольшую погрешность при сложении; итог рассчитан по неокруглённым величинам. Третий вклад положителен, хотя его корреляция отрицательна.
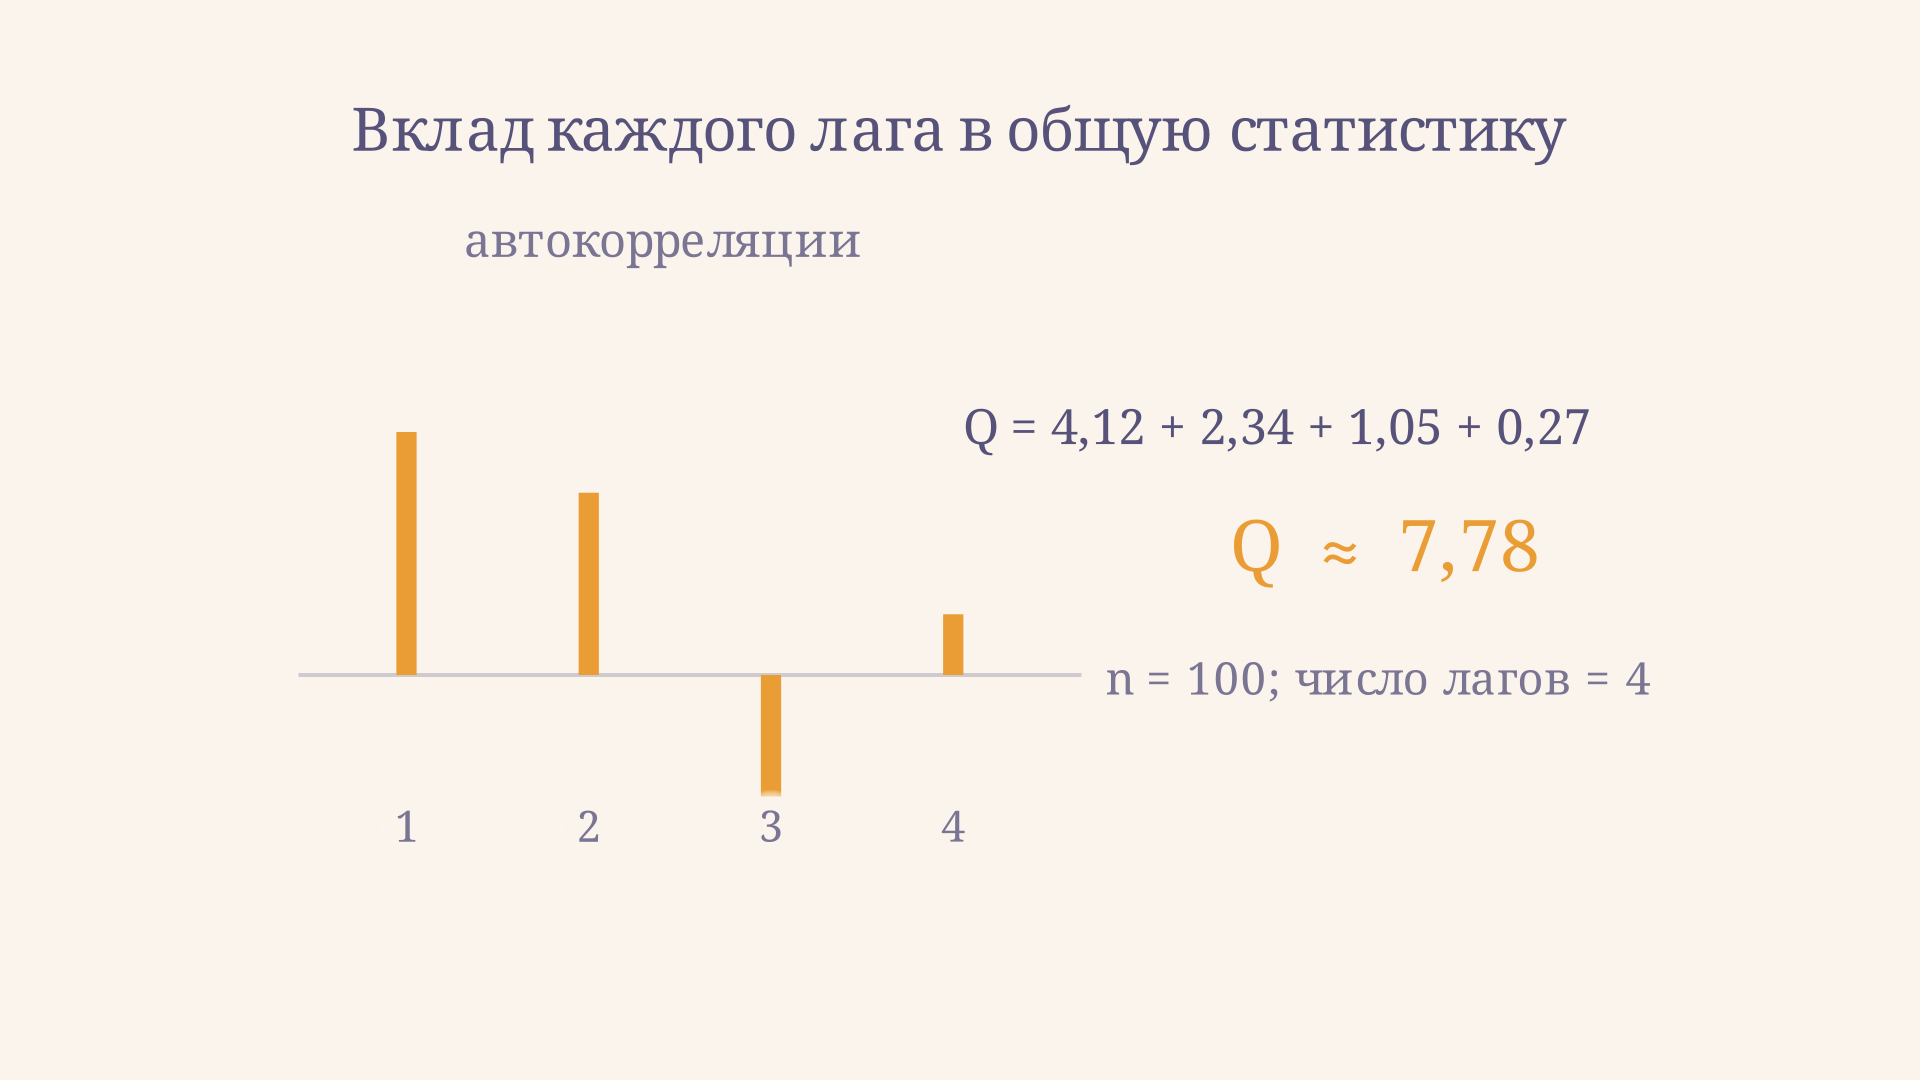
При четырёх степенях свободы верхнее критическое значение распределения на уровне составляет примерно . Поскольку , нулевую гипотезу не отвергают. Эквивалентно, . Это не доказательство отсутствия зависимости: данные просто не дали достаточных оснований отвергнуть ноль для выбранных четырёх лагов.
Как выбрать число лагов
Выбор связан с вопросом исследования и частотой наблюдений. Для месячных данных исследователь может заранее включить лаг 12, если его интересует годовая сезонность; для квартальных аналогичный ориентир - лаг 4. Важно также посмотреть на длину ряда: при большом относительно дальние корреляции вычисляются по небольшому числу пар, а приближение может работать плохо.
Слишком маленькое пропустит связь за пределами окна. Слишком большое добавит слабые и шумные корреляции и может снизить мощность против конкретной альтернативы. Универсального числа лагов для любой задачи нет: обоснуйте его периодичностью, размером выборки и характером модели до проверки. Документация MATLAB по тесту также указывает на потерю мощности при избыточном числе лагов.
Если перебрать много значений и сообщить только самое маленькое , обычный порог 5 % уже не описывает ошибку такого отбора. Несколько заранее оговорённых проверок могут быть полезны, но их совместную интерпретацию и проблему множественных сравнений нужно указать отдельно. График калькулятора показывает именно эту чувствительность: растёт с каждым лагом, однако критическое значение тоже меняется.
Как читать результат в отчёте
Предположим, что аналитик строит прогноз квартальных продаж и заранее проверяет остатки до четвёртого лага. Уровень 5 % означает правило принятия решения, выбранное до просмотра результата. Если программа выводит таблицу для нескольких границ, строка с лагом 4 описывает общую проверку лагов 1–4, а не отдельную проверку только четвёртого лага. Это различие особенно важно для сезонных рядов: результат общей проверки не устанавливает самостоятельно, что обнаружена именно сезонная связь.
В отчёте полезно указать размер выборки после удаления пропусков и начальных значений, потерянных при построении модели. Одни и те же исходные данные могут давать разные результаты при другом способе вычисления остатков или другой корректировке степеней свободы. Для короткого ряда асимптотическое приближение стоит трактовать особенно осторожно; в сложной модели могут потребоваться дополнительные методы диагностики, подходящие к её предпосылкам. Не следует подменять интерпретацию одним словом «прошёл»: читателю нужны число лагов, статистика, степени свободы и само p-значение.
Степени свободы после оценки модели
Для исходного ряда без оцениваемых параметров в простом асимптотическом приближении используют . Для остатков подогнанной модели число степеней свободы обычно корректируют: при ARMA берут , если выполнены условия соответствующей процедуры. Например, для остатков ARIMA при стандартная поправка по двум параметрам AR и MA даёт 10 степеней свободы. При сезонных и других моделях учитывают спецификацию и правила конкретной реализации.
Нужно, чтобы итоговое число степеней свободы было положительным. Иначе обычное -значение по такому приближению не определено. В документации statsmodels параметр model_df вычитается из числа лагов; проверьте его настройку и не полагайтесь на значение по умолчанию для остатков оценённой модели.
Что делать после проверки остатков
Если меньше заранее выбранного уровня значимости, проверьте временной график и автокорреляционную функцию остатков, сезонность, пропущенные лаги и спецификацию модели. Затем можно пересмотреть модель и проверить её на отложенных данных. Значимый результат указывает на оставшуюся линейную временную структуру в пределах окна, но сам по себе не выбирает правильное исправление.
Если велико, сохраните осторожную формулировку «нет оснований отвергнуть ». Маленькая выборка может плохо обнаруживать слабую зависимость. Нулевая автокорреляция также не гарантирует независимость, постоянную дисперсию или нормальность: эти свойства исследуют отдельно. Например, тест Уайта относится к проверке гетероскедастичности, а не заменяет анализ последовательной связи.
При проверке полезно записать не только решение, но и исходные настройки: длину ряда, выбранный лаг, поправку на параметры, значение статистики и уровень значимости. Это позволяет другому исследователю воспроизвести расчёт и понять, какие именно временные связи были включены. Разные программы могут по-разному задавать число лагов или степени свободы по умолчанию, поэтому настройки нужно сверять перед сравнением результатов.
Для сравнения, тест Дарбина - Уотсона сосредоточен на связи соседних остатков при своих условиях; тест Бройша - Годфри использует вспомогательную регрессию и пригоден для проверки автокорреляции более высокого порядка в регрессионной модели. Выбор зависит от постановки и допущений, а не только от доступной команды в программе.
Частые ошибки
- Считать доказательством независимости. Тест проверяет выбранные линейные автокорреляции, а не все виды зависимости.
- Путать лаг и степени свободы. После оценки параметров модели они могут различаться; проверьте поправку программы.
- Выбирать лаг после просмотра значимости. Это делает вывод слишком оптимистичным; правило выбора задают заранее.
- Искать виновный лаг только по . Совместное отклонение не локализует источник; изучите отдельные корреляции и контекст.
- Применять формулу к неупорядоченным или нерегулярным данным как к равномерному ряду. Сначала восстановите корректную временную сетку и разберитесь с пропусками.
FAQ
Можно ли применять тест к самому временному ряду?
Да, если вопрос касается его автокорреляций. Для диагностики качества прогнозной модели обычно проверяют именно её остатки: исходный ряд может закономерно содержать тренд или сезонность, которые модель должна объяснять.
Что означает малое p-значение?
При корректных допущениях это означает, что наблюдаемое значение или большее было бы маловероятно при нулевой гипотезе. При гипотезу об отсутствии автокорреляции до выбранного лага отвергают. Вероятностью истинности само не является.
Доказывает ли тест, что модель хороша для прогноза?
Нет. Отсутствие значимой автокорреляции - лишь один диагностический признак. Сравните прогнозы с фактическими значениями вне обучающей выборки и проверьте другие свойства ошибок.
Коротко
Тест Льюнга-Бокса объединяет квадраты автокорреляций до заранее выбранного лага в статистику . Её сравнивают с распределением , учитывая оценённые параметры модели. Результат помогает найти оставшуюся линейную структуру, но не доказывает независимость ошибок и не заменяет остальные проверки модели.
Читайте также
Коинтеграция: как найти долгосрочную связь рядов
Коинтеграция временных рядов простыми словами: как проверить стационарность остатка, провести тест Энгла и Грейнджера и понять модель коррекции ошибки на примере.
Модель Койка: формула распределённого лага и пример
Модель Койка в эконометрике: геометрическое убывание лагов, преобразование уравнения, краткосрочный и долгосрочный эффекты, средний лаг и пример расчёта.
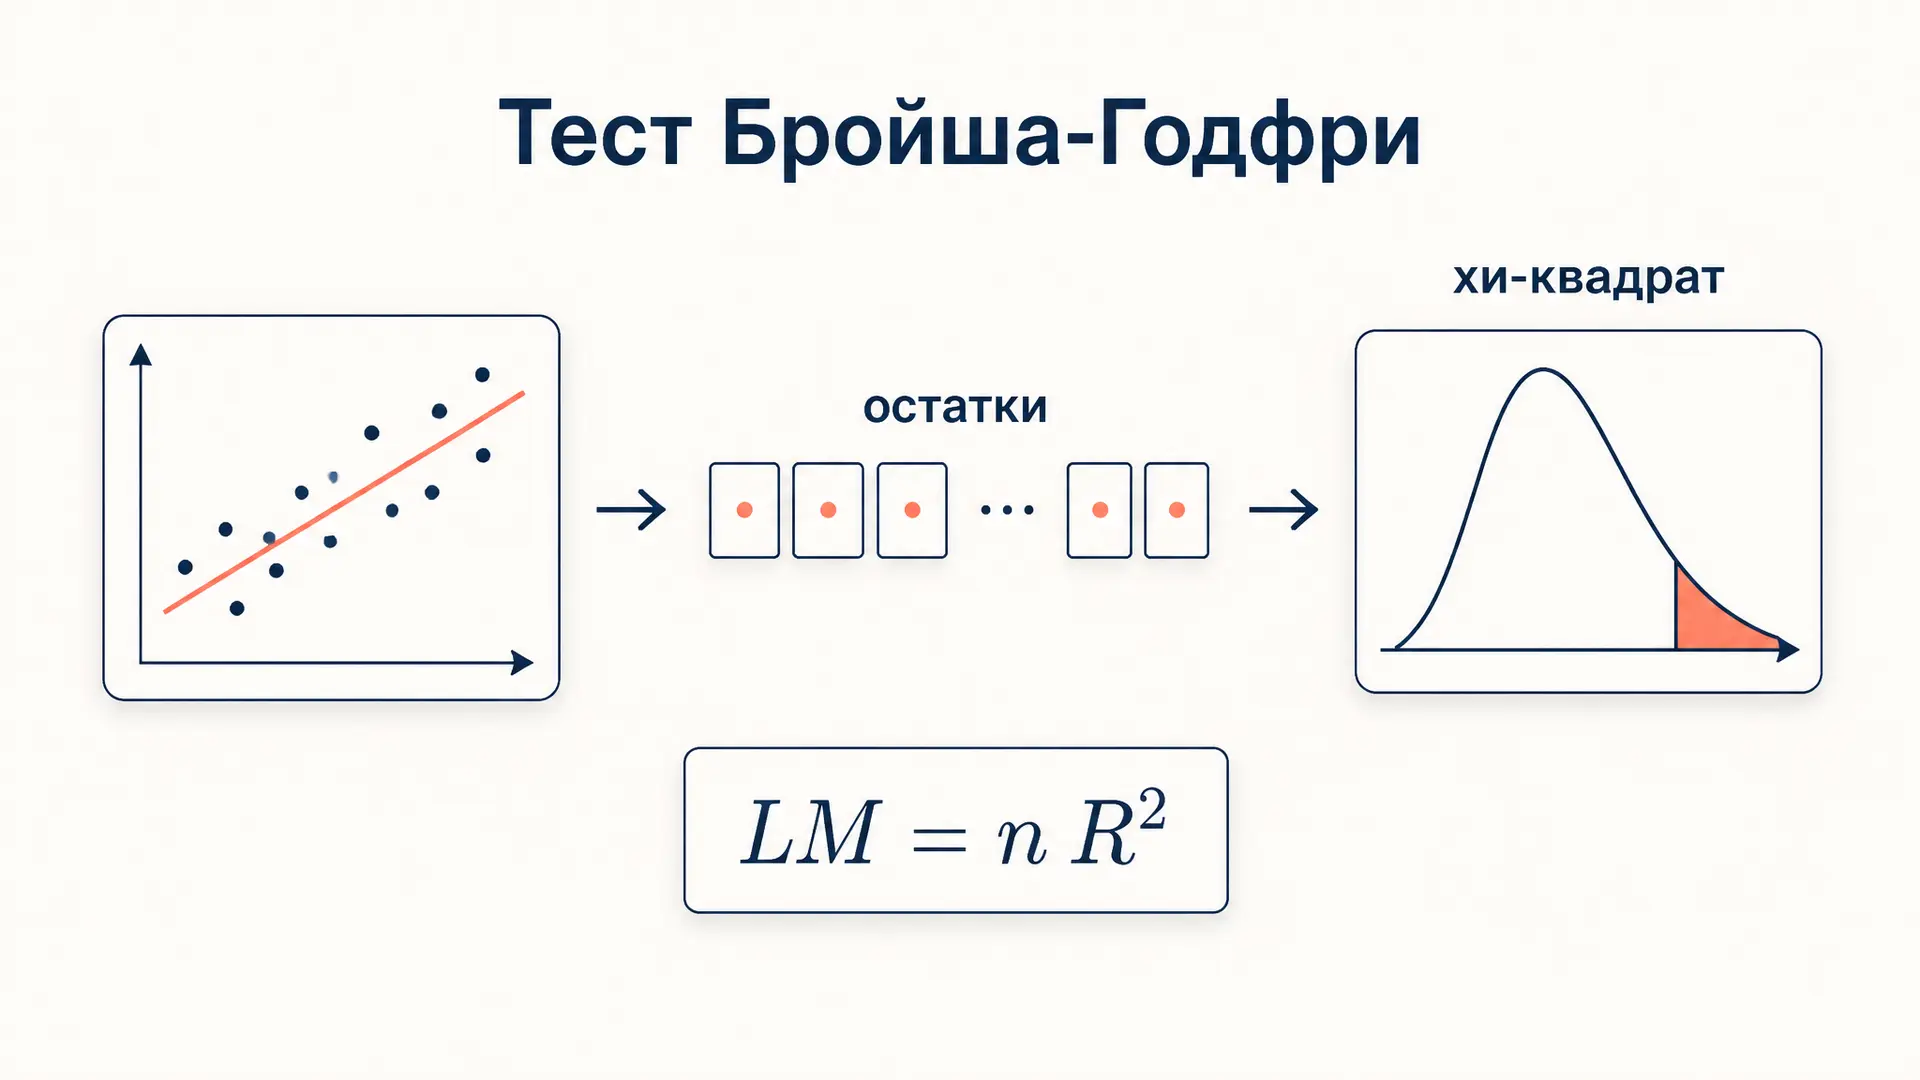
Тест Бройша-Годфри: проверка остатков на автокорреляцию
Тест Бройша-Годфри на автокорреляцию остатков регрессии: LM-статистика n·R², выбор числа лагов, сравнение с хи-квадрат, отличие от Дарбина-Уотсона и интерпретация p-значения.
Тест Дарбина-Уотсона: автокорреляция остатков
Тест Дарбина-Уотсона показывает, есть ли автокорреляция остатков регрессии. Разбираем статистику DW, границы dL и dU, проверку гипотез и как не ошибиться в выводах.
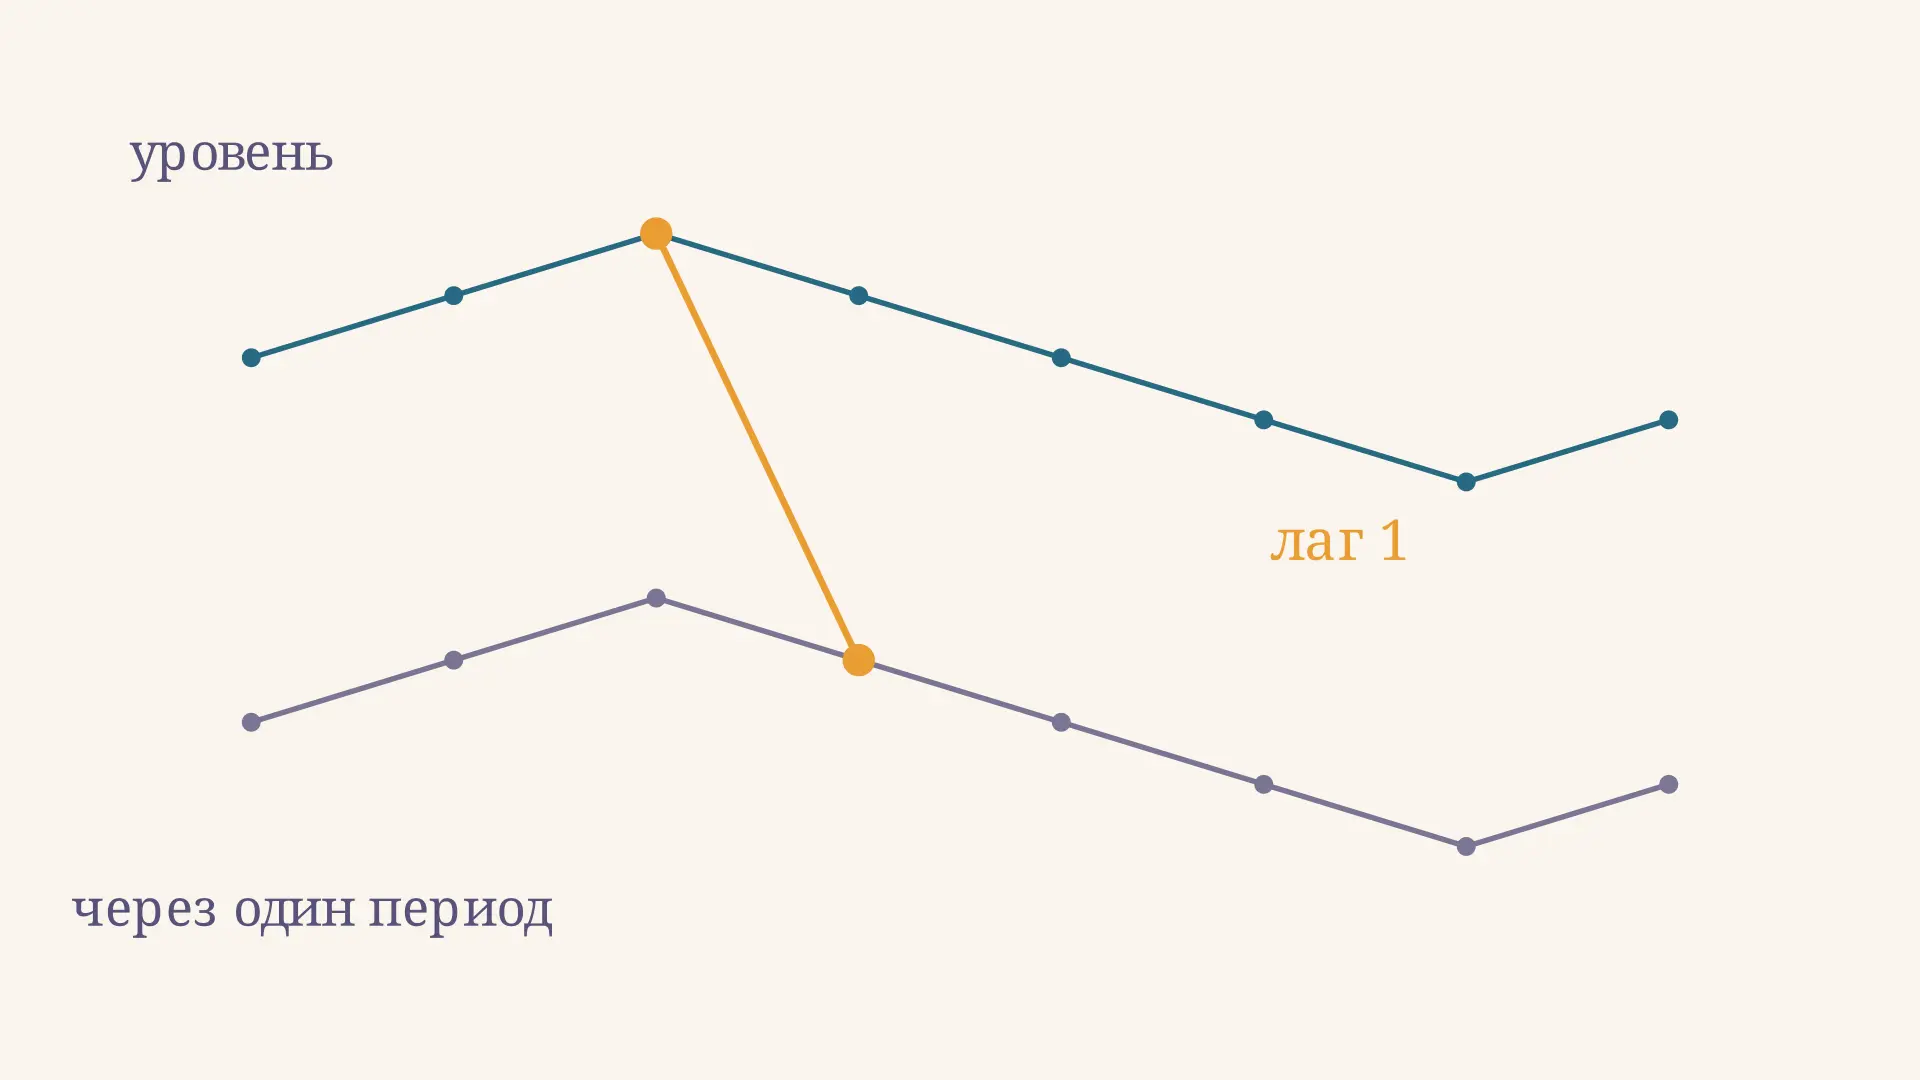
Автокорреляция уровней временного ряда: расчёт
Автокорреляция уровней временного ряда: как выбрать лаг, вычислить коэффициент на числовом примере и прочитать коррелограмму с учётом тренда и сезонности.
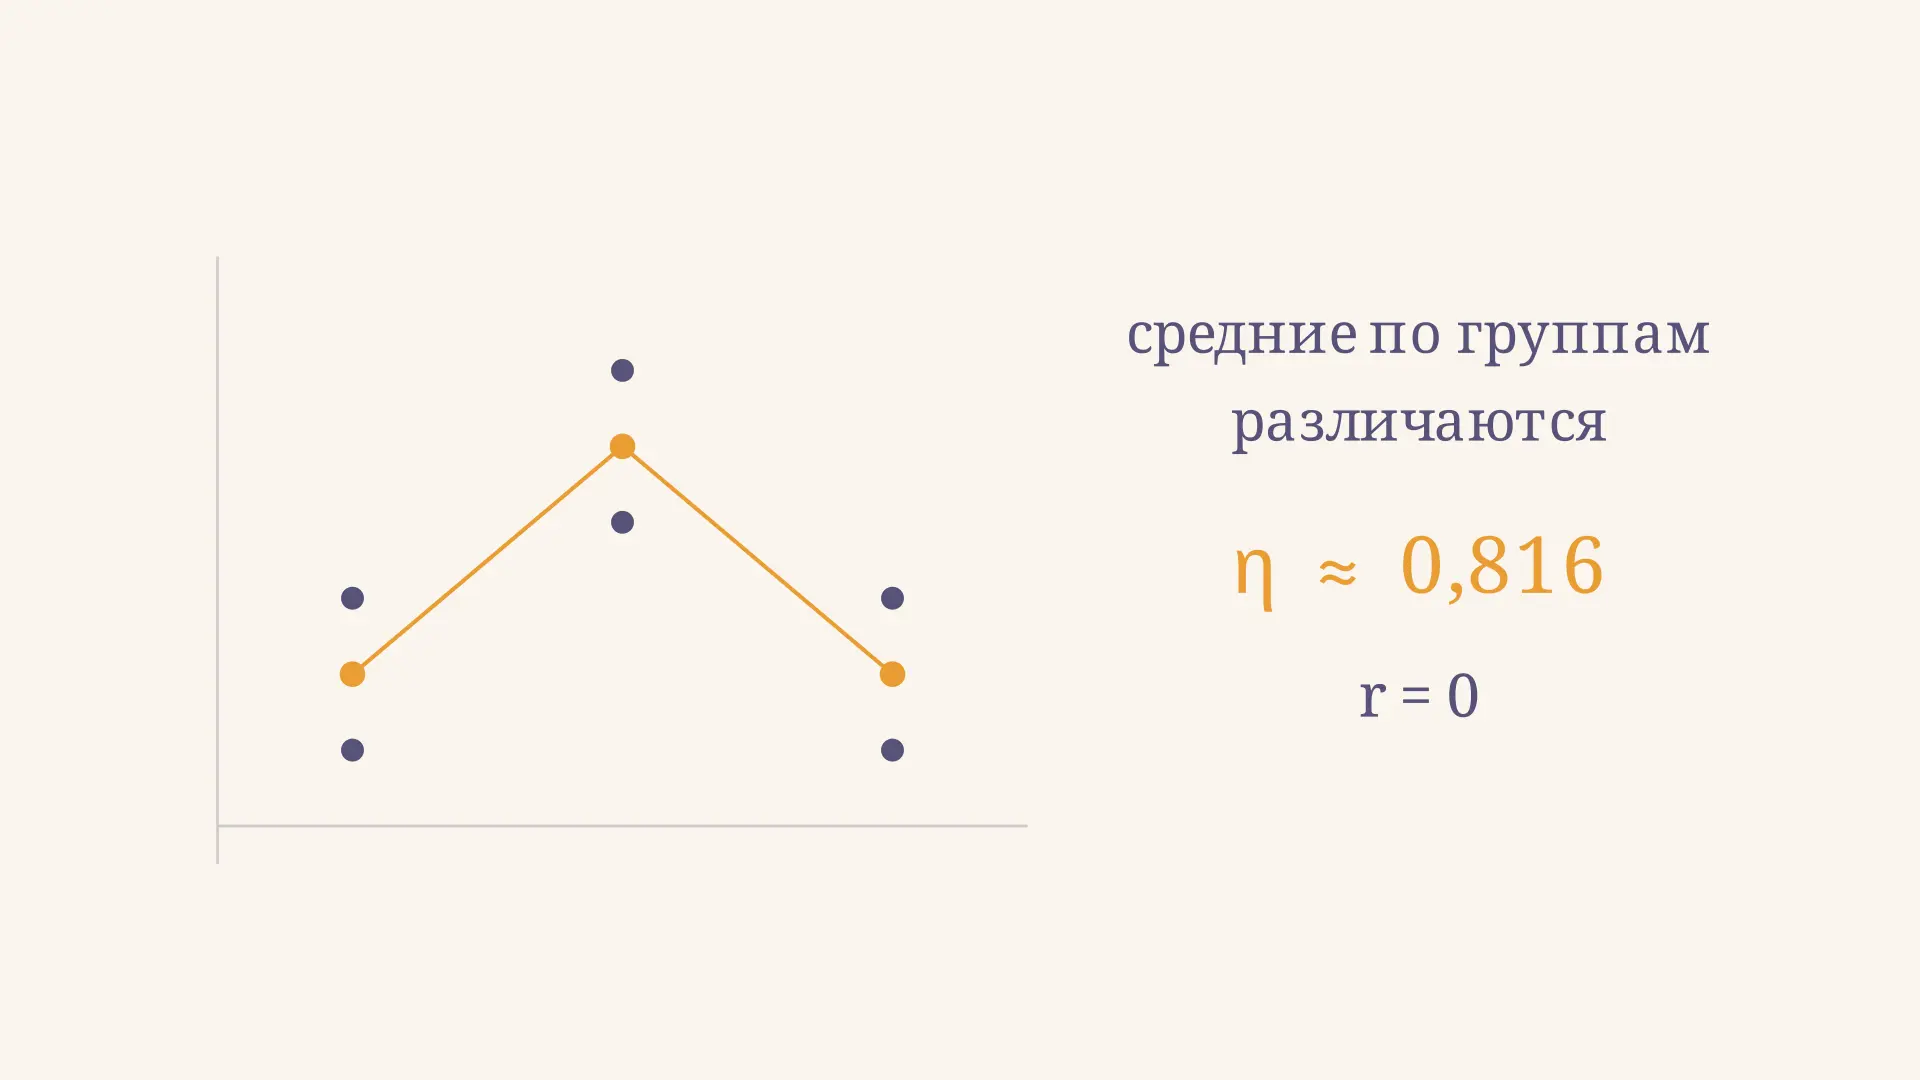
Индекс корреляции: формула и пример расчёта
Как рассчитать индекс корреляции по группам и остаткам модели, прочитать его квадрат и отличить нелинейную связь от коэффициента Пирсона: пример с таблицей.