Стохастический факторный анализ: методы и пример
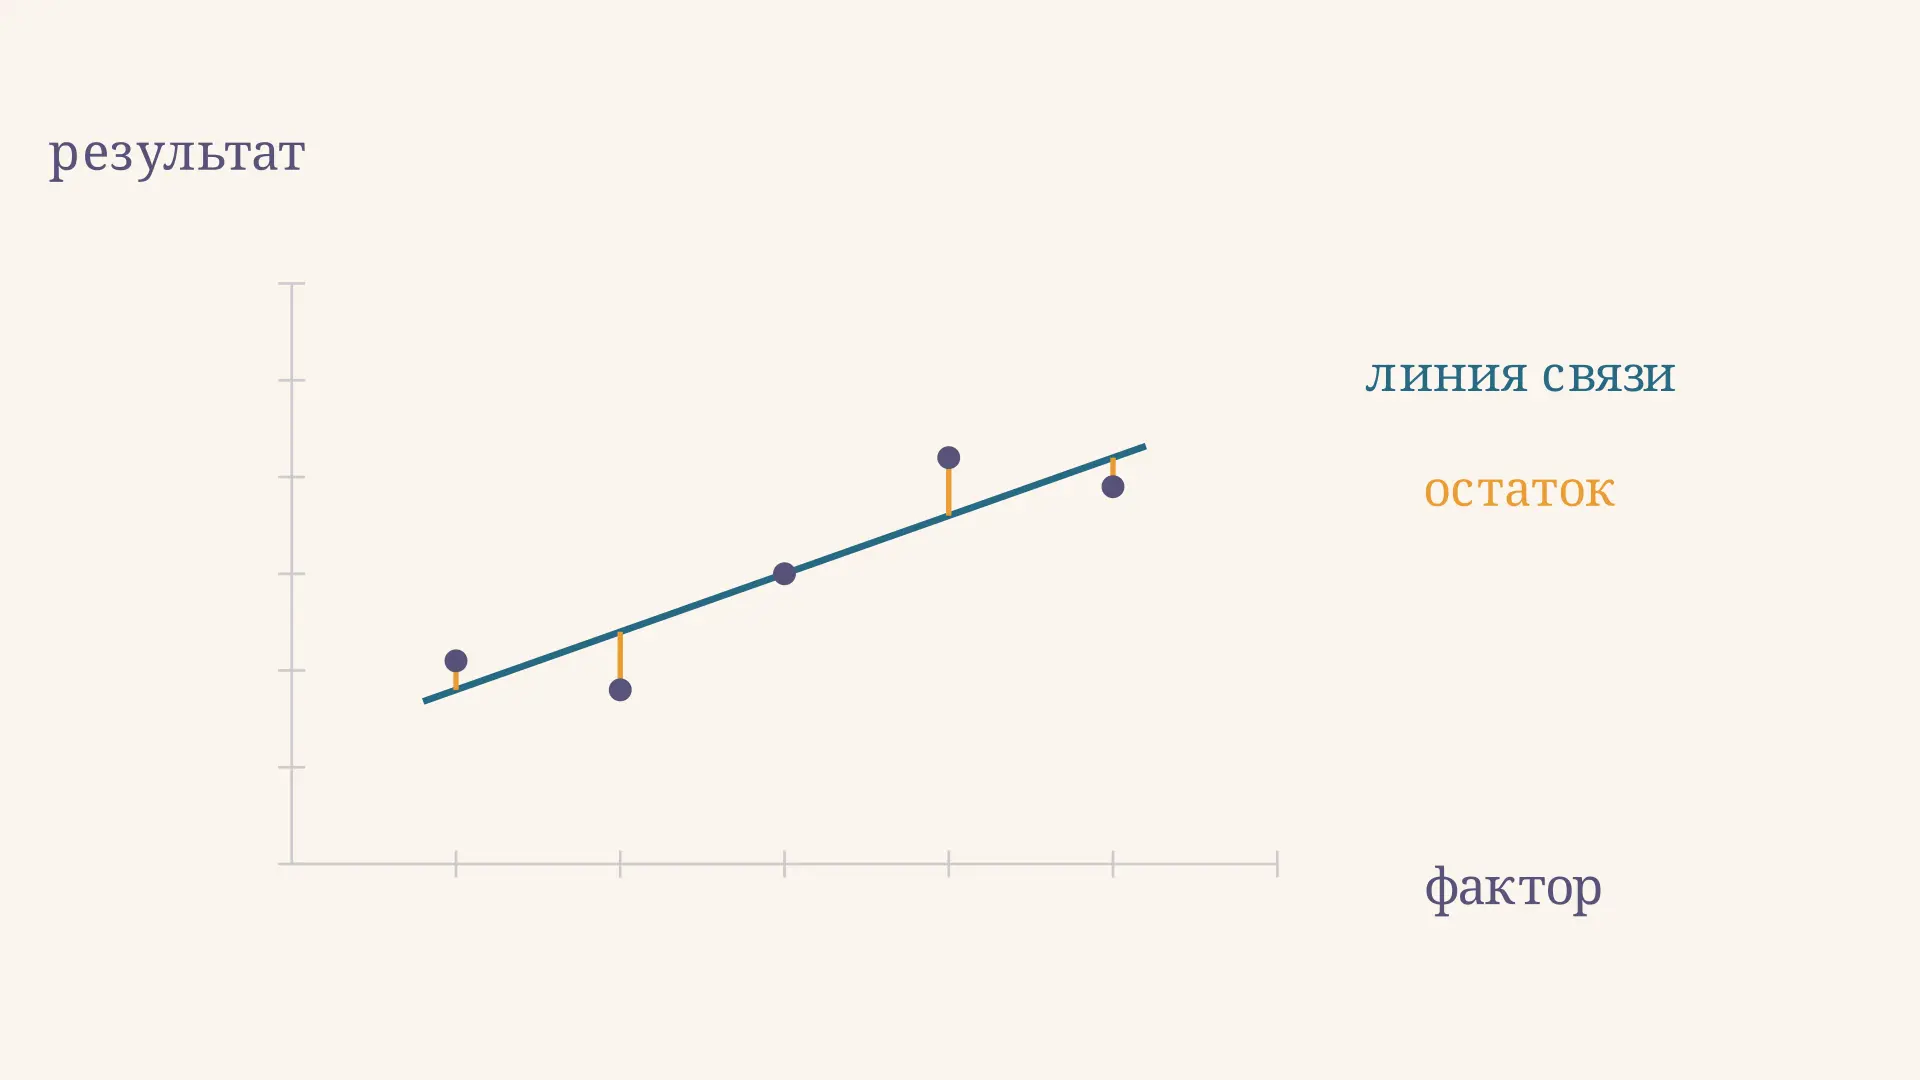
Стохастический факторный анализ изучает, как экономический результат статистически связан с одним или несколькими факторами, когда точной функциональной зависимости между ними нет. Например, выручка магазинов может расти вместе с рекламным бюджетом, но при одинаковом бюджете различаться из-за расположения, ассортимента и других условий. Анализ ищет закономерность на совокупности наблюдений и отдельно учитывает отклонения от неё. В калькуляторе ниже можно изменить разброс искусственных наблюдений и увидеть, как это влияет на качество линейного приближения.
Что означает стохастическая связь
При функциональной связи заданному набору факторов соответствует строго определённый результат по формуле. Например, при известных количестве проданных единиц и цене выручка равна их произведению. В мультипликативной факторной модели это тождество используют для разложения изменения показателя между периодами.
При стохастической связи одинаковому значению фактора могут соответствовать разные результаты. Поэтому исследователь описывает не каждое наблюдение без ошибки, а статистическую закономерность: например, как меняется условное среднее продаж при разных значениях рекламного бюджета. Термин «случайный» здесь не означает, что всё происходит беспричинно: в отклонениях могут скрываться неучтённые обстоятельства, ошибки измерения и естественная неоднородность объектов.
В ролике остатки подобраны специальным образом, чтобы оценённая прямая не менялась. В реальных данных при изменении наблюдений могут измениться и наклон, и свободный член. Сама анимация показывает лишь один контролируемый пример, а не общий закон изменения регрессии.
Модель и её составляющие
Простейшая линейная модель одного фактора записывается так:
Здесь - результат для объекта , - измеренный фактор, и - параметры модели, а - ненаблюдаемая случайная ошибка. Если условное среднее ошибки равно нулю, то : коэффициент показывает изменение условного среднего результата при увеличении фактора на единицу.
На практике параметры неизвестны. По выборке получают оценки и , строят прогноз и вычисляют остаток . Ошибка модели и остаток различаются: первая относится к неизвестному процессу, второй вычисляется после подгонки по данным. Знак остатка показывает, находится ли точка выше или ниже оценённой прямой.
При нескольких факторах модель расширяют: . Коэффициент при одном факторе описывает связь с результатом при фиксированных значениях включённых в модель остальных факторов. Это полезно, когда, например, размер магазина и рекламные расходы одновременно связаны с продажами. Но включение нескольких переменных само по себе не устраняет все пропущенные влияния.
Как находят коэффициенты методом наименьших квадратов
Обычный метод наименьших квадратов, или МНК, выбирает коэффициенты, минимизирующие сумму квадратов вертикальных остатков:
Квадраты не дают положительным и отрицательным отклонениям взаимно уничтожиться. Для одной переменной при наличии свободного члена и ненулевом разбросе оценки равны
Наклон измеряется в единицах результата на единицу фактора. Если - рекламный бюджет в тысячах рублей, а - выручка в тысячах рублей, наклон 0,6 означает связь дополнительной тысячи рублей бюджета с увеличением условного среднего результата на 0,6 тысячи рублей в рамках модели. Свободный член - значение линии при ; если ноль далёк от имеющихся данных, его экономический смысл может быть сомнительным.
МНК находит лучшую прямую по выбранному критерию, но не доказывает, что настоящая зависимость линейна. NIST описывает метод наименьших квадратов как способ оценки параметров и отдельно подчёркивает необходимость проверки модели по остаткам.
Пример расчёта по пяти наблюдениям
Возьмём искусственные данные: фактор , результат . Это не отчётность реальных магазинов, а пример, специально построенный для иллюстрации. Средние равны и . Сумма квадратов отклонений равна 10, а сумма произведений отклонений и равна 6. Поэтому
Расчётные значения равны 2,8; 3,4; 4,0; 4,6; 5,2. Остатки составляют 0,3; −0,6; 0; 0,6; −0,3. Их сумма квадратов равна . Для сравнения, общая сумма квадратов отклонений результата от среднего равна .
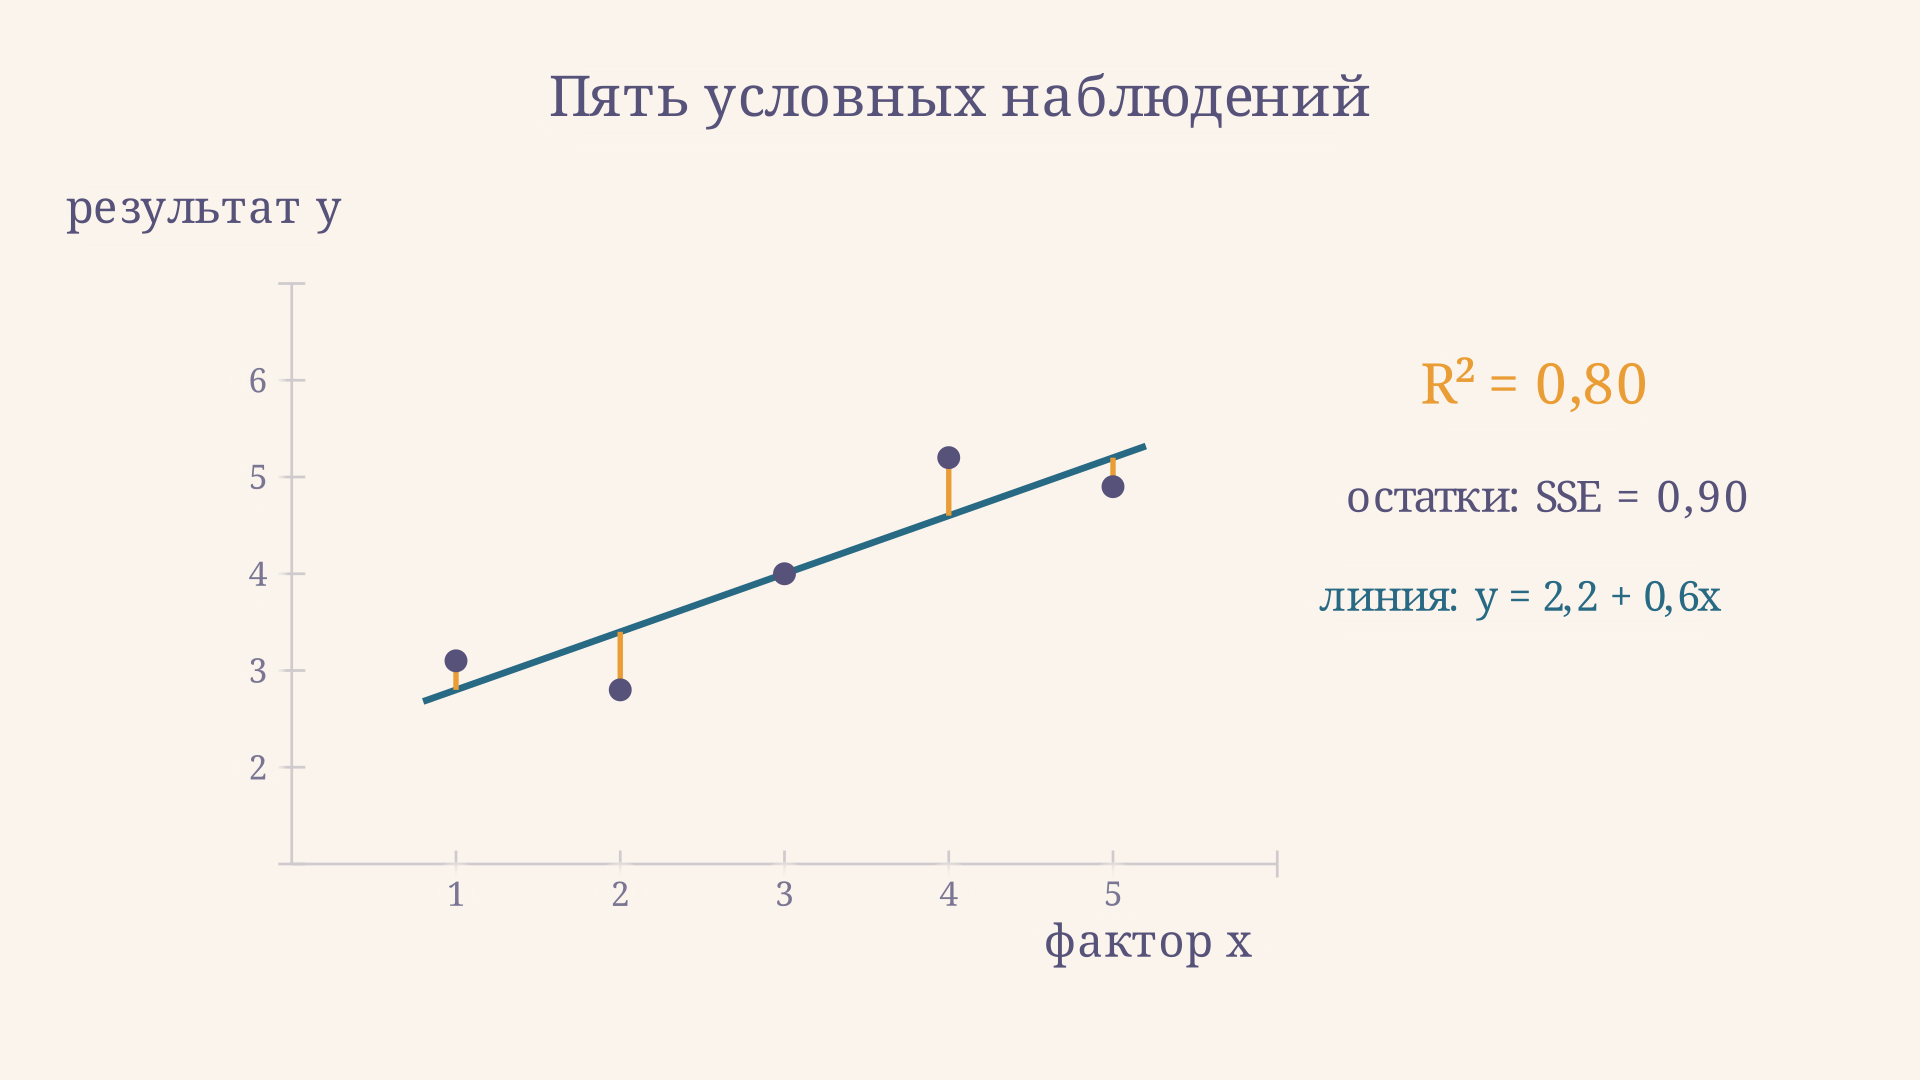
В калькуляторе начальное значение масштаба остатков воспроизводит эти числа. Значения созданы по правилу , где последовательность равна 1, −2, 0, 2, −1. Она ортогональна и константе, и отклонениям от среднего, поэтому при изменении линия остаётся прежней. В обычной выборке такого специально заданного свойства ждать не следует.
Что показывает коэффициент детерминации
Для регрессии со свободным членом на тех же наблюдениях коэффициент детерминации рассчитывается как
Это означает, что линия объясняет 80 % наблюдаемой вариации результата вокруг выборочного среднего в этом учебном наборе. Оставшиеся 20 % приходятся на остаточную вариацию по данной модели. Это не означает, что реклама вызвала 80 % выручки или что прогноз для нового объекта будет точен на 80 %. При нулевой общей вариации знаменатель равен нулю и указанная формула не определена.
При увеличении масштаба остатков с 0,3 до 1 сумма их квадратов возрастает с 0,9 до 10, а снижается примерно до 0,26. Наклон при этом остаётся 0,6 именно благодаря конструкции примера. Высокий также не гарантирует правильную форму зависимости, отсутствие выбросов или хорошее качество прогноза вне выборки.
Какие методы применяют и как проверяют вывод
Корреляционный анализ измеряет тесноту и направление линейной связи двух переменных; регрессия задаёт модель условного среднего и позволяет оценивать коэффициенты. При наличии категориального фактора сравнение средних групп часто рассматривают через однофакторный дисперсионный анализ. Название «факторный анализ» используют и в другом смысле - для поиска скрытых факторов по множеству наблюдаемых признаков; пример такой задачи связан с критерием сферичности Бартлетта. Не следует автоматически считать эти постановки одинаковыми.
Выбор наблюдений влияет на ответ не меньше формулы. Сначала нужно определить, кого сравнивают: отдельные магазины за один месяц или один магазин в разные месяцы. В первом случае различия между точками могут отражать местоположение и размер торговой площади, во втором - сезонность и изменение цен. Смешивание этих ситуаций без оговорки затруднит толкование коэффициента. Значения факторов и результата также должны относиться к сопоставимым периодам: расходы на рекламу сегодня могут быть связаны с продажами позднее, а не обязательно в тот же день.
Если один магазин резко отличается от остальных и одновременно имеет необычно большой бюджет, он может заметно повлиять на наклон прямой. Его нельзя автоматически удалять только потому, что он портит результат: сначала выясняют, является ли наблюдение ошибкой ввода или отражает реальный объект. Полезно сравнить оценки с ним и без него и сообщить, насколько изменился вывод. При нескольких факторах сильная корреляция между ними может сделать отдельные коэффициенты нестабильными, даже если совместный прогноз выглядит неплохо.
Практическая последовательность начинается с экономической гипотезы, единиц измерения и выбора сопоставимых наблюдений. Затем изучают пропуски, выбросы и графики, оценивают модель и исследуют остатки. Систематический изгиб остатков может указывать на неподходящую форму зависимости; меняющийся разброс - на неодинаковую дисперсию ошибок. Для временных рядов важна возможная зависимость соседних ошибок, а для нескольких факторов - сильная взаимная корреляция признаков.
Далее проверяют устойчивость оценок при разумных изменениях спецификации и на отложенных данных. Доверительные интервалы и проверки гипотез зависят от предпосылок и способа оценки стандартных ошибок; пять точек в нашем примере слишком мало для надёжных экономических обобщений. Руководство NIST по диагностике остатков показывает, почему графическая проверка дополняет единый показатель качества.
Статистическая связь не равна причинному эффекту. Например, успешные магазины могут одновременно больше рекламироваться и продавать больше по другим причинам; возможна и обратная связь от продаж к бюджету. Для причинного вывода нужны соответствующий дизайн и обоснованные предпосылки. В финансовой практике регрессия используется, например, в трёхфакторной модели Фамы - Френча, но смысл её факторов и коэффициентов определяется конкретной постановкой.
Частые ошибки
- Считать каждое отклонение ошибкой измерения: остаток может отражать и пропущенные факторы, и неподходящую форму модели.
- Называть коэффициент причинным эффектом без анализа отбора объектов, обратной связи и других объяснений.
- Сравнивать величины коэффициентов без учёта разных единиц измерения факторов.
- Делать вывод только по , игнорируя остатки, размер выборки и качество прогноза.
- Переносить формулу далеко за диапазон наблюдений без проверки: вне него связь может измениться.
FAQ
Чем стохастический анализ отличается от детерминированного?
В детерминированной модели результат точно задан функциональной формулой факторов. В стохастической модель описывает статистическую закономерность и допускает отклонения отдельных наблюдений.
Можно ли использовать несколько факторов?
Да. Множественная регрессия оценивает связь результата с каждым включённым фактором при фиксированных значениях остальных. Интерпретация зависит от состава модели и качества данных.
Всегда ли большой R² означает хорошую модель?
Нет. Он описывает подгонку к имеющимся данным, но не подтверждает причинность и не заменяет диагностику остатков и проверку прогнозов на новых наблюдениях.
Коротко
Стохастический факторный анализ помогает описать связь экономического показателя с факторами, когда отдельные наблюдения отклоняются от общей закономерности. Регрессия оценивает линию связи, остатки показывают расхождения с ней, а характеризует долю вариации, объяснённую моделью в выборке. Корректный вывод требует проверки предпосылок и осторожной интерпретации.
Читайте также

Аддитивная факторная модель: формула и пример расчёта
Аддитивная факторная модель в экономике: как разложить показатель на слагаемые, рассчитать вклад каждого изменения и проверить результат на примере прибыли.

Детерминированный факторный анализ: методы и пример
Детерминированный факторный анализ показывает вклад факторов в изменение показателя. Разбираем модели, цепные подстановки, абсолютные разницы и проверку расчёта.
Кратная факторная модель: формула и пример расчёта
Кратная факторная модель в экономике: формула отношения, цепные подстановки, расчёт влияния числителя и знаменателя и проверка результата на примере выработки.
Смешанная факторная модель: формула и пример
Смешанная факторная модель объединяет разные операции в формуле показателя. Разбираем прибыль, цепные подстановки, проверку суммы влияний и зависимость результата от порядка факторов.
Способ относительных разниц: формулы и пример расчёта
Способ относительных разниц в экономическом анализе: формулы для двух и трёх факторов, пошаговый пример выручки, проверка суммы и влияние порядка подстановок.
Абсолютное преимущество Смита: пример и расчёт
Абсолютное преимущество Смита простыми словами: как сравнить затраты труда, рассчитать выигрыш от специализации и отличить его от сравнительного преимущества Рикардо.