Сортировка связного списка слиянием: алгоритм
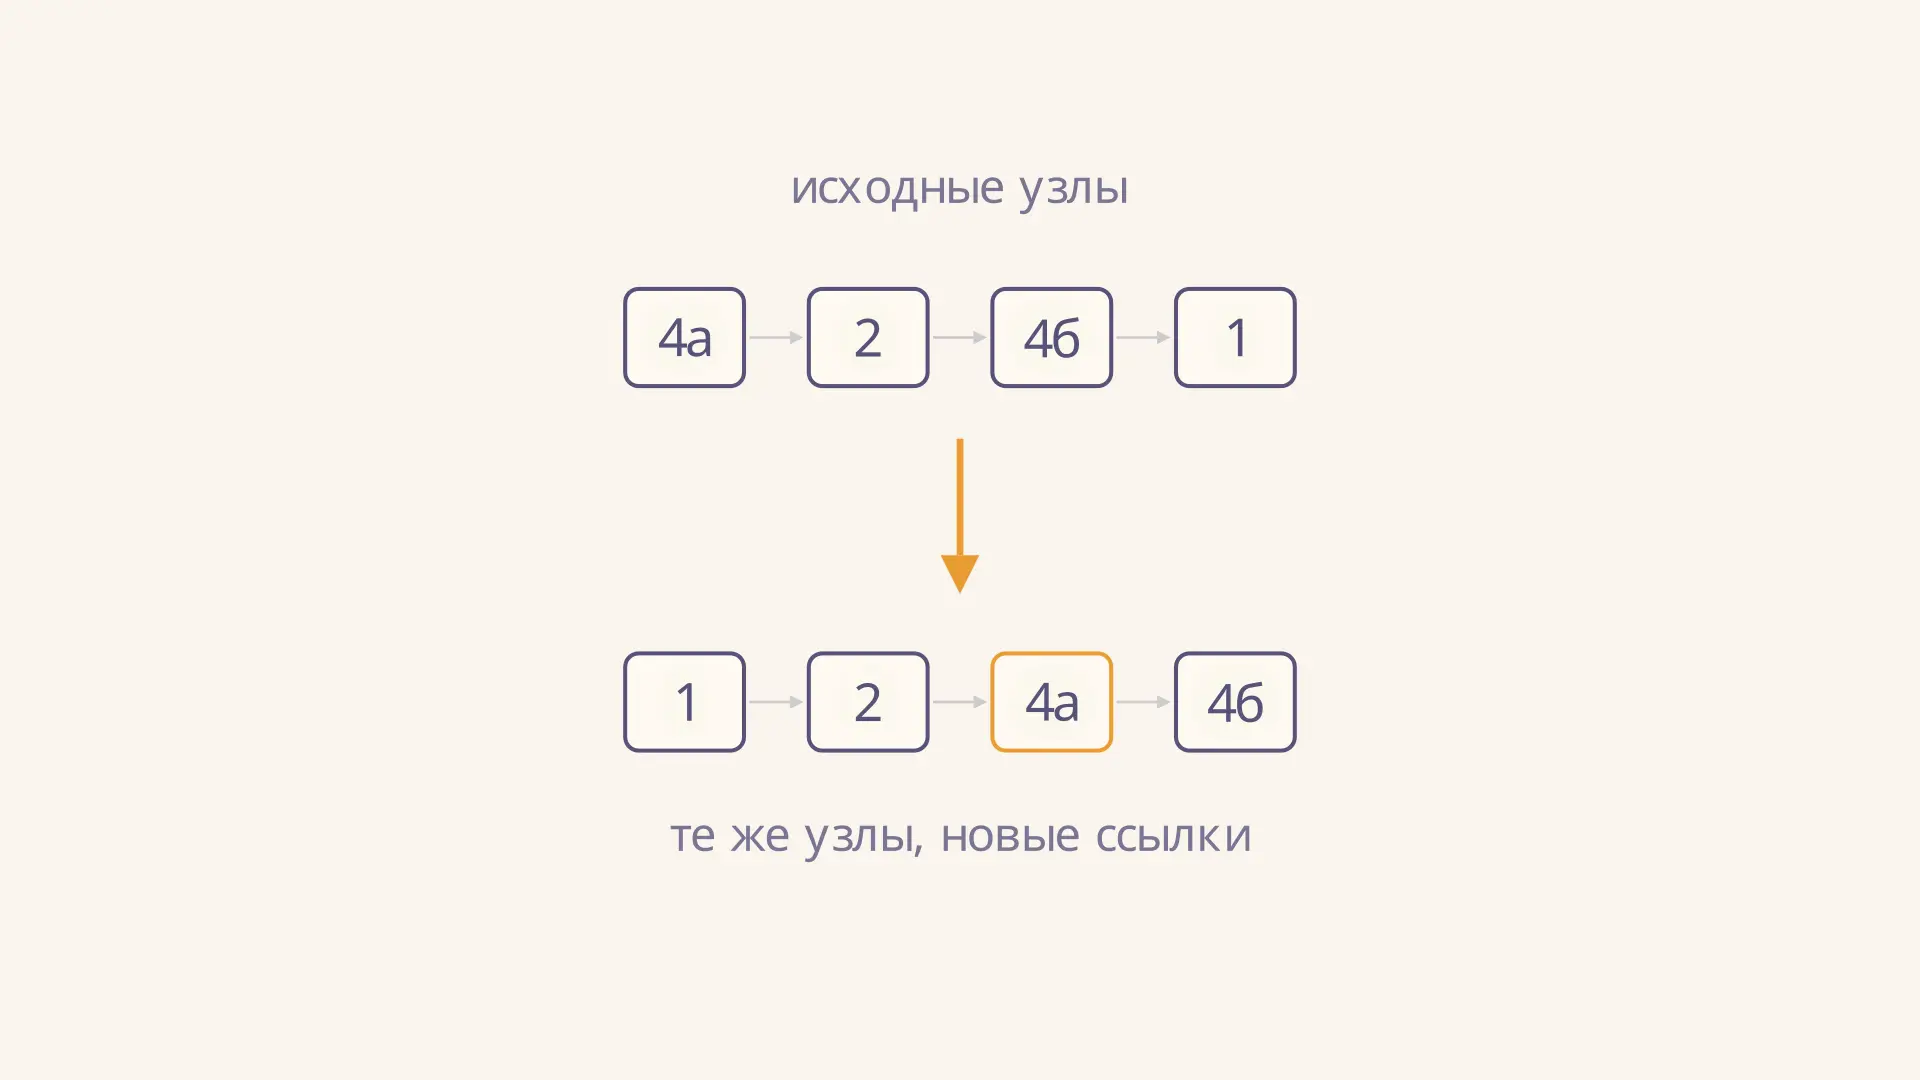
Сортировка связного списка меняет порядок обхода узлов. В массиве удобно обращаться к элементу по индексу, а в односвязном списке до нужного узла приходится идти по цепочке ссылок. Зато два соседних фрагмента можно соединить, изменив несколько ссылок, не перенося содержимое узлов в новые ячейки.
Один из удобных вариантов - сортировка слиянием. Она делит цепочку на части, сортирует их и соединяет в нужном порядке. В модели ниже выберите длину примера и посмотрите, сколько сравнений ключей выполняется на каждом уровне. Буквы различают равные ключи: они помогают проверить устойчивость.
Почему устройство списка влияет на алгоритм
У каждого узла есть ключ и ссылка next на следующий узел; последняя ссылка равна None. Переменная head хранит начало цепочки. Пустой список представляют значением None. Подробно эти операции разобраны в статье про односвязный список.
Ссылки можно перенаправить так, чтобы те же объекты проходились в другом порядке. Это полезно, если узлы содержат большие записи или на них уже ссылается другой код: при сортировке не нужно копировать данные из одного узла в другой. Однако внешние ссылки на узлы не начинают указывать на их новых соседей автоматически; изменяются именно поля next и, возможно, голова списка.
Для слияния не нужен произвольный доступ по индексу. Достаточно сравнивать первые узлы двух уже отсортированных цепочек и продвигаться по одной из них. На видео показаны исходная последовательность, отсортированные половины и итог. После результата состояния показываются в обратном порядке для повтора; это не шаги самой сортировки.
Разделение: быстрый и медленный указатели
Для списка хотя бы из двух узлов поставим slow на голову, а fast на следующий узел. Пока fast и его следующий узел существуют, сдвигаем slow на один шаг, а fast на два. Когда быстрый указатель доходит до конца, slow стоит у конца левой половины. Правая начинается с slow.next; затем необходимо записать slow.next = None, чтобы физически разорвать цепочку.
Например, для четырёх узлов слева и справа окажется по два. Для пяти слева будет три, справа два. Пустую цепочку и цепочку из одного узла уже можно считать отсортированными: это базовые случаи рекурсии. Без явного разрыва половины продолжают пересекаться, и рекурсивные вызовы могут повторяться бесконечно.
Затем каждую половину сортируют тем же способом. Это частный случай общей сортировки слиянием; особенность списка в том, что разделение ищется обходом, а результат собирается через ссылки, а не через вспомогательный массив значений.
Слияние двух цепочек по шагам
Пусть отсортированные половины начинаются узлами left и right. Сравните их ключи, присоедините меньший узел к хвосту результата и продвиньте указатель соответствующей половины. Повторяйте, пока обе половины непусты. Когда одна закончится, оставшийся хвост второй уже отсортирован, поэтому его можно присоединить целиком без новых сравнений ключей.
Рассмотрим : буквы обозначают разные узлы с одинаковым ключом 4. После сортировки половины имеют вид и . При финальном слиянии сравниваются и , затем и , затем и . Последний оставшийся узел присоединяется целиком. Итого три сравнения на верхнем уровне и по одному внутри каждой половины: пять сравнений. Ответ: .
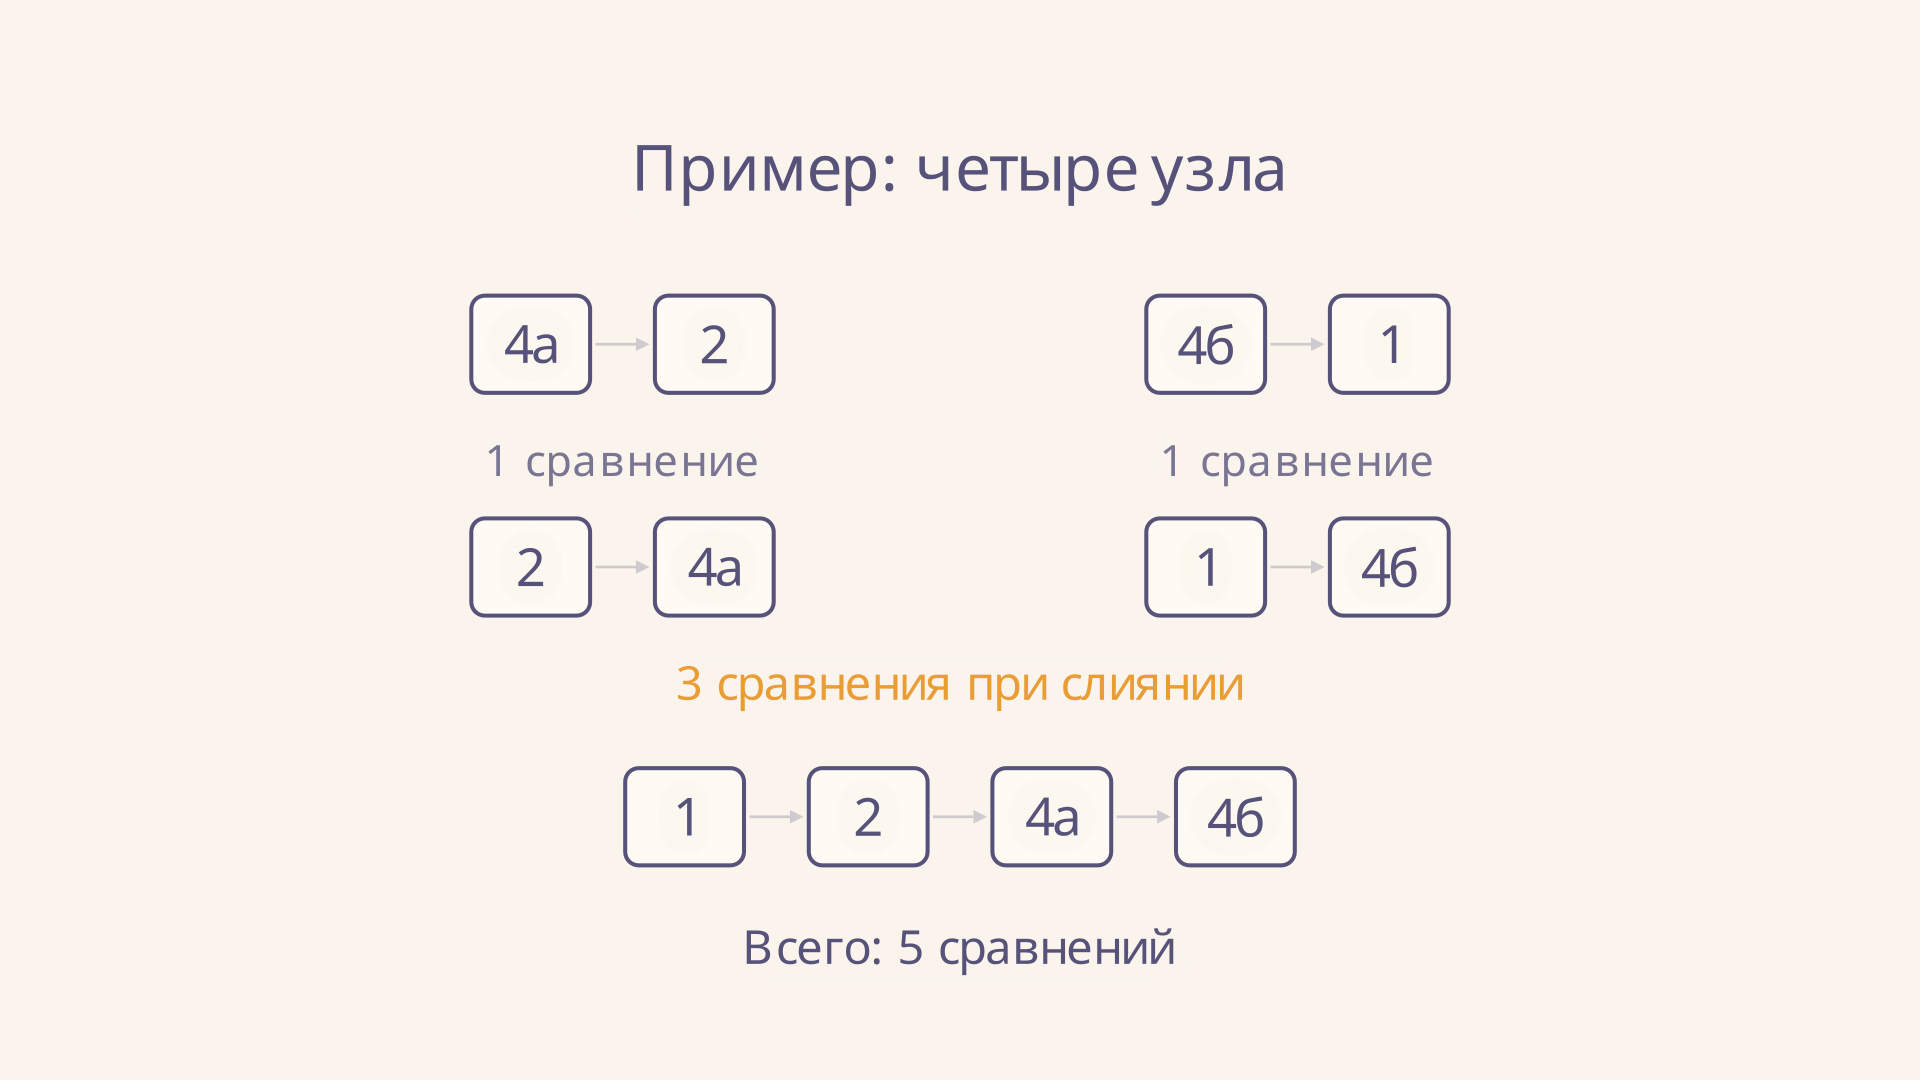
Счётчик зависит от данных и конкретного способа разбиения. Калькулятор считает только сравнения ключей при слияниях, а не проверки на конец списка или изменения ссылок. У него для четырёх узлов тот же порядок и тот же результат; дополнительная буква у уникальных ключей лишь маркирует узел.
Реализация на Python
Ниже Node - существующий класс с полями value и next. Функция возвращает новую голову, которую вызывающий код должен сохранить. Вспомогательный фиктивный узел не обязателен: голову результата можно выбрать отдельно.
def merge(a, b):
    if a is None:
        return b
    if b is None:
        return a
    if a.value <= b.value:
        head, a = a, a.next
    else:
        head, b = b, b.next
    tail = head
    while a is not None and b is not None:
        if a.value <= b.value:
            tail.next, a = a, a.next
        else:
            tail.next, b = b, b.next
        tail = tail.next
    tail.next = a if a is not None else b
    return head


def sort_list(head):
    if head is None or head.next is None:
        return head
    slow, fast = head, head.next
    while fast is not None and fast.next is not None:
        slow = slow.next
        fast = fast.next.next
    right = slow.next
    slow.next = None
    return merge(sort_list(head), sort_list(right))
В множественном присваивании Python сначала вычисляет правую часть: следующий узел сохраняется до переназначения ссылки хвоста. При переносе идеи в другой язык безопаснее явно записать следующий узел во временную переменную. Код предполагает конечный список без цикла и корректно сравнимые значения. При разборе своих входных данных полезно вести таблицу трассировки: отдельно записывать голову результата, хвост и оставшиеся части.
Устойчивость и сохранение узлов
Сортировка устойчива, если равные по ключу записи остаются в исходном относительном порядке. Для этого при равенстве в merge выбирается узел из левой половины: условие использует <=, а не <. Левая половина исходно предшествует правой, и это правило сохраняет порядок равных элементов на каждом уровне.
Устойчивость важна, например, когда записи сначала упорядочили по дате, а затем сортируют по категории: одинаковые категории сохранят порядок дат. Это свойство относится к порядку равных ключей, а не к неизменности позиций всех записей. В документации ядра Linux также описана устойчивая сортировка списка и требования к функции сравнения.
В реализации выше новые узлы с данными не создаются и значения местами не меняются. После вызова старую переменную головы обязательно заменяют результатом: head = sort_list(head). Иначе она может указывать на середину новой цепочки, и обход с неё не покажет все узлы.
Сложность времени и памяти
На каждом уровне рекурсии разделение и слияния суммарно проходят не более линейного числа узлов, то есть стоят . Число уровней при делении примерно пополам равно , поэтому время в худшем случае составляет . Сравнения и переходы по ссылкам предполагаются операциями за константное время; дорогой пользовательский компаратор меняет реальную стоимость.
В приведённом варианте слияние использует лишь несколько указателей, но рекурсивные вызовы занимают стек глубиной . Поэтому дополнительная память всей функции - , а не . Итеративная сортировка снизу вверх с проходами по сериям длины 1, 2, 4 и так далее может обойтись дополнительной памяти при аккуратном переназначении ссылок. Это не означает, что она всегда быстрее: на практике важны расположение узлов в памяти и стоимость обхода.
Для сравнения, пирамидальная сортировка хорошо использует индексы массива для доступа к детям кучи. В односвязной цепочке такой доступ требует обхода, поэтому прямое перенесение её индексной реализации теряет это преимущество.
Как проверить результат на своих данных
Проверяйте не только последовательность значений. При работе со ссылками алгоритм может случайно потерять узел, продублировать его в обходе или создать цикл, даже если несколько первых значений выглядят правильно. До сортировки сохраните для проверки число узлов и их идентичности, а после неё убедитесь, что каждый исходный узел встречается ровно один раз и обход заканчивается. Сравните соседние ключи: каждый должен быть не больше следующего. Для повторяющихся ключей отдельно проверьте исходный относительный порядок записей.
Начните с пустого списка, одного узла и двух узлов в прямом и обратном порядке. Затем проверьте уже отсортированную цепочку, обратную, нечётную по длине и цепочку, где все ключи равны. Последний случай особенно полезен для устойчивости: он показывает, не переставляет ли правило слияния равные узлы между половинами. Если узлы содержат записи с одинаковым ключом, присвойте им разные метки, как в примере с двумя четвёрками.
При итеративном варианте проверка границ серий приобретает особое значение. На каждом проходе берут соседние отрезки заданной длины, сливают их и присоединяют к уже собранной части. Последняя серия может оказаться короче заданной длины или вообще не иметь пары. После прохода ширину удваивают и повторяют его, пока вся цепочка не станет одной серией. Важно не потерять ссылку на начало следующей пары до изменения текущих связей.
Частые ошибки
- Не разорвать список при делении. Правая половина останется частью левой, и рекурсия не уменьшит задачу корректно.
- Потерять следующий узел при переназначении ссылки. Сначала сохраните продолжение цепочки, затем меняйте поле
next. - Выбирать справа при равенстве и обещать устойчивость. Для устойчивого слияния равных ключей первым берут левый узел.
- Забыть сохранить новую голову. После сортировки прежний первый узел может находиться внутри результата.
- Не учитывать стек рекурсии. В показанном коде он занимает дополнительной памяти.
FAQ
Можно ли отсортировать пустой список?
Да. Функция сразу возвращает None; для одного узла она возвращает тот же узел.
Меняются ли данные внутри узлов?
В показанном алгоритме нет: меняются ссылки между существующими узлами. Их ключи и остальные поля остаются на своих местах.
Всегда ли выполняется пять сравнений?
Нет. Пять - результат для указанной четвёрки и показанного порядка разбиения. Для других ключей одна половина может закончиться раньше, поэтому число сравнений изменится.
Коротко
Сортировка слиянием подходит связному списку благодаря последовательному обходу и соединению существующих узлов через ссылки. Разделяйте список на непересекающиеся части, сливайте их по меньшей голове и при равенстве выбирайте левую. Рекурсивный вариант работает за времени и использует памяти стека; итеративный может уменьшить дополнительную память до .
Читайте также
Сортировка слиянием: как работает merge sort
Сортировка слиянием на примере массива: разбор проходов и числа сравнений, устойчивость, оценка времени и памяти, реализация на Python и области применения.
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
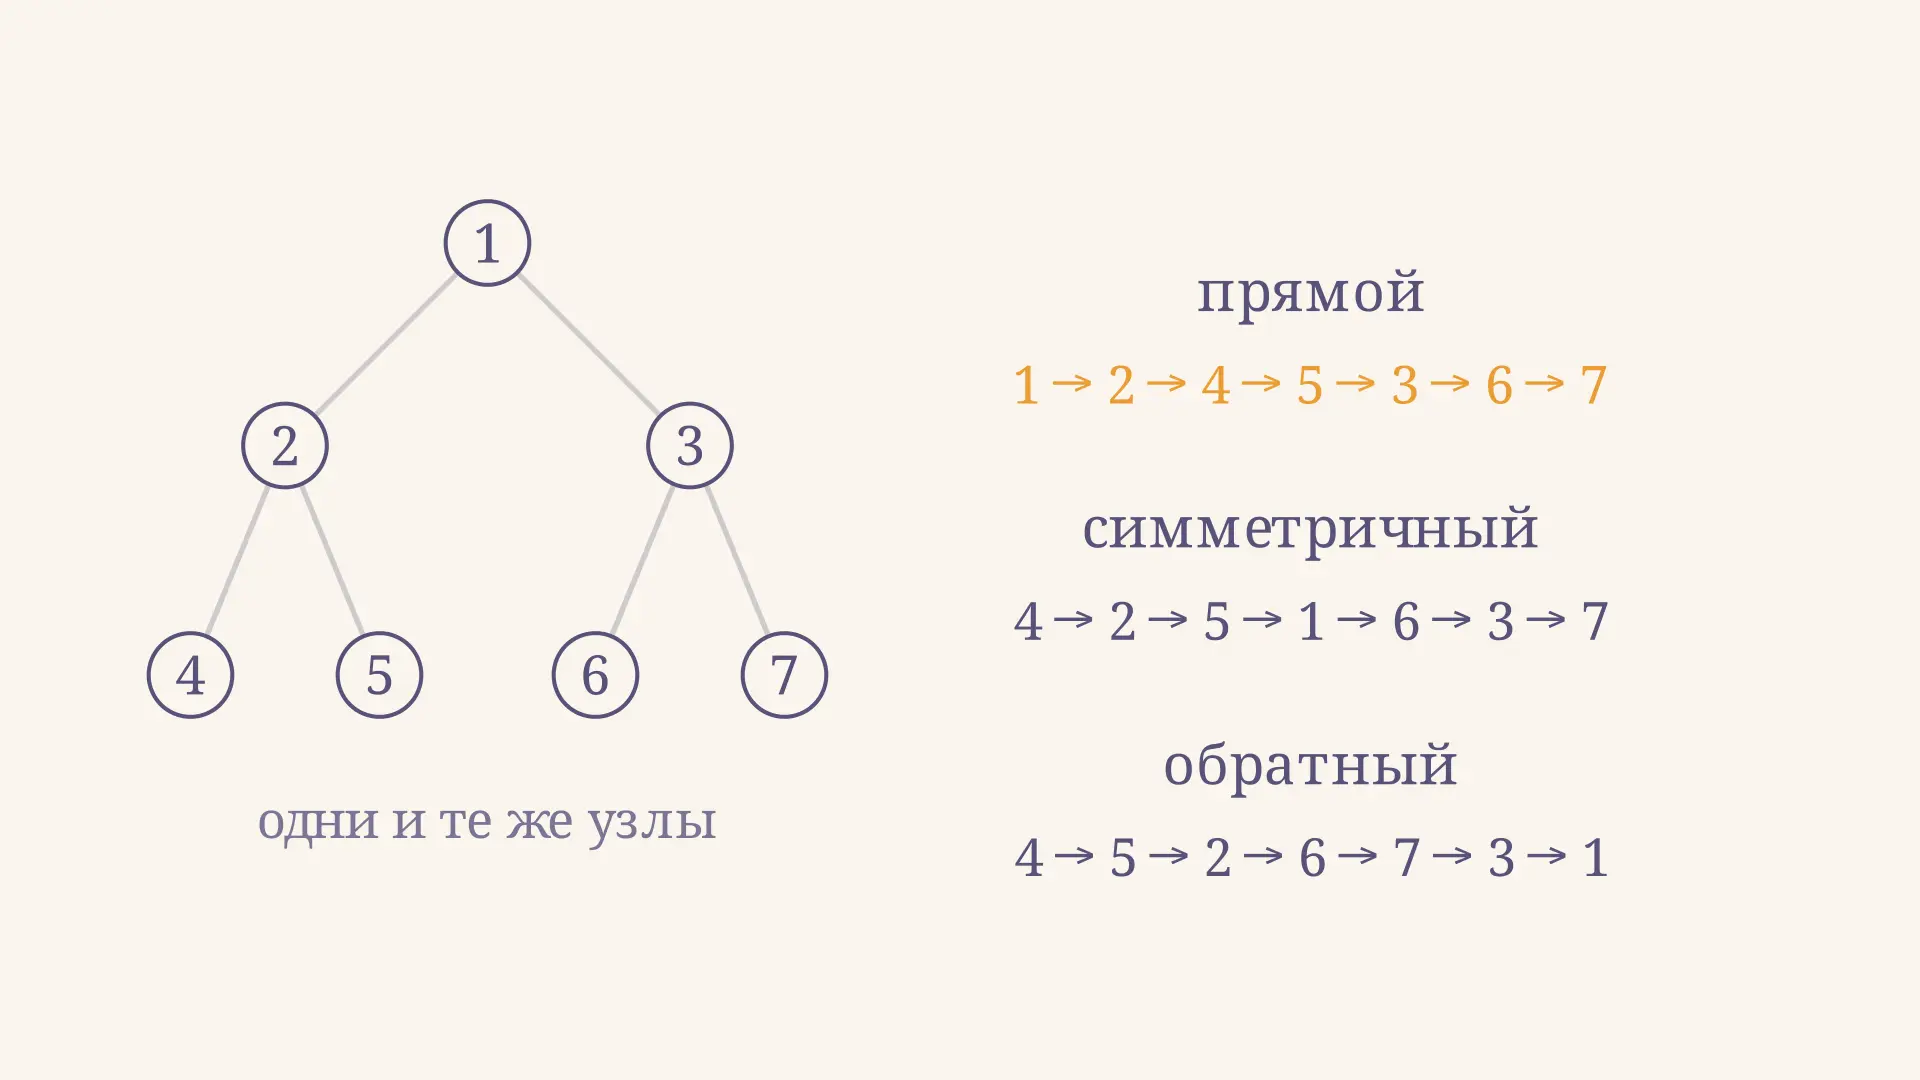
Обходы двоичного дерева: порядки и примеры
Обходы двоичного дерева на одном примере: прямой, симметричный, обратный и по уровням. Как работают рекурсия, стек и очередь, какие результаты и сложность.
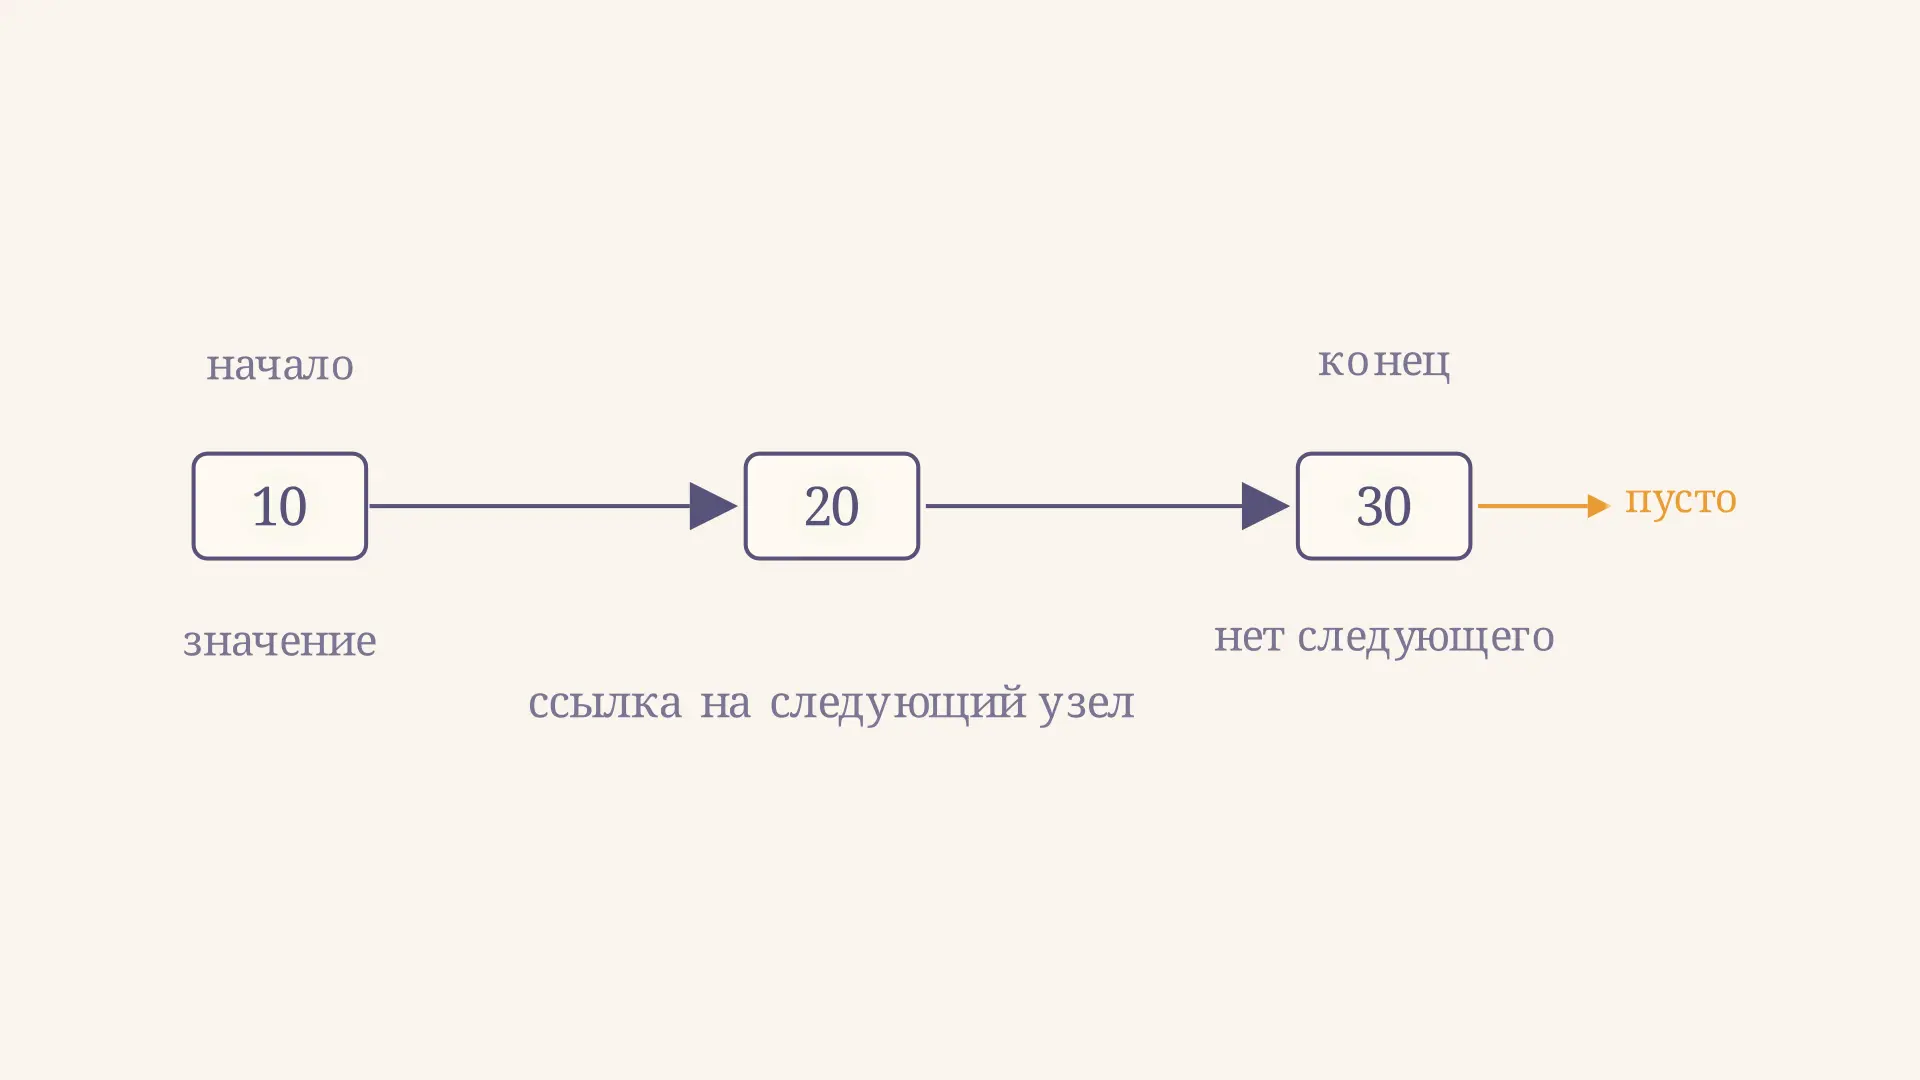
Односвязный список: операции и их сложность
Односвязный список: как устроены узлы и ссылки, как выполнять поиск, вставку и удаление, сколько переходов они требуют и когда нужен указатель на хвост.
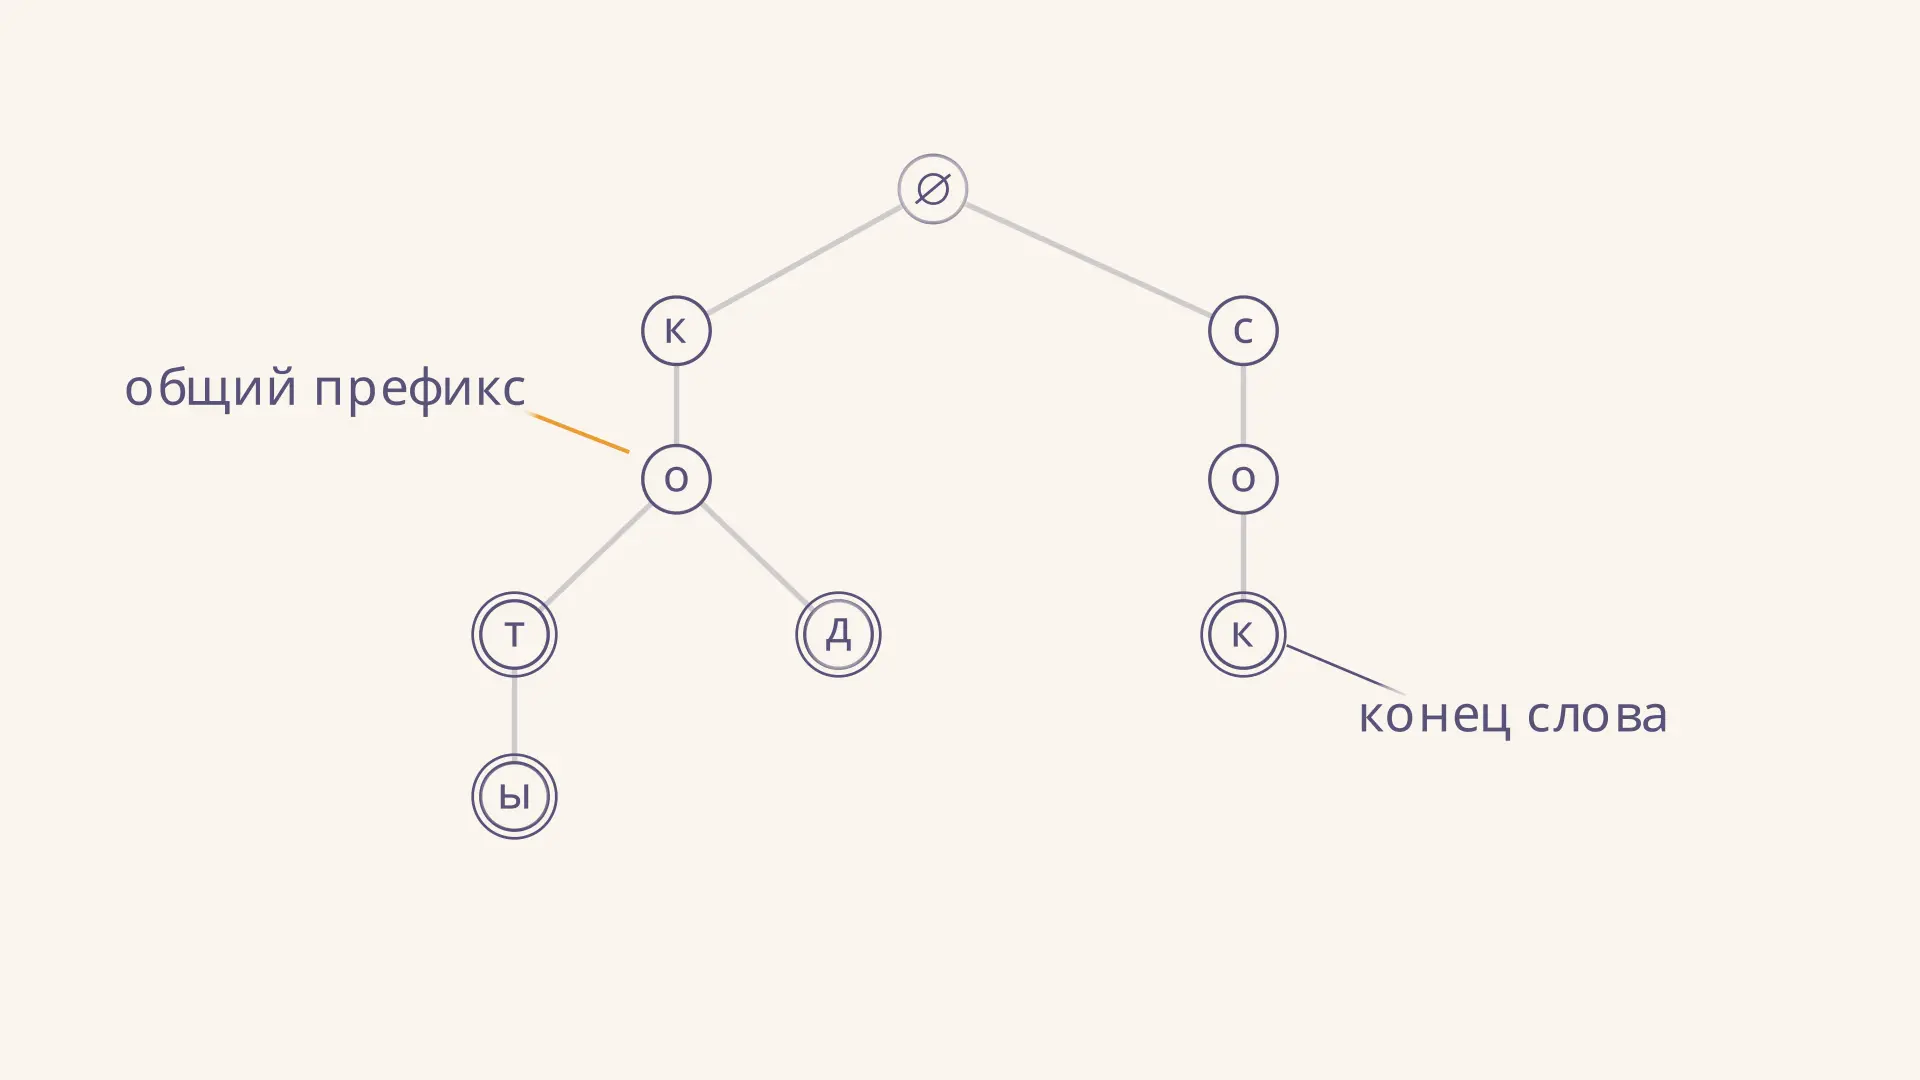
Префиксное дерево: как устроен бор строк
Префиксное дерево хранит общие начала строк вместе. Разбираем построение бора, поиск и удаление слов, сложность операций и применение на наглядном примере.
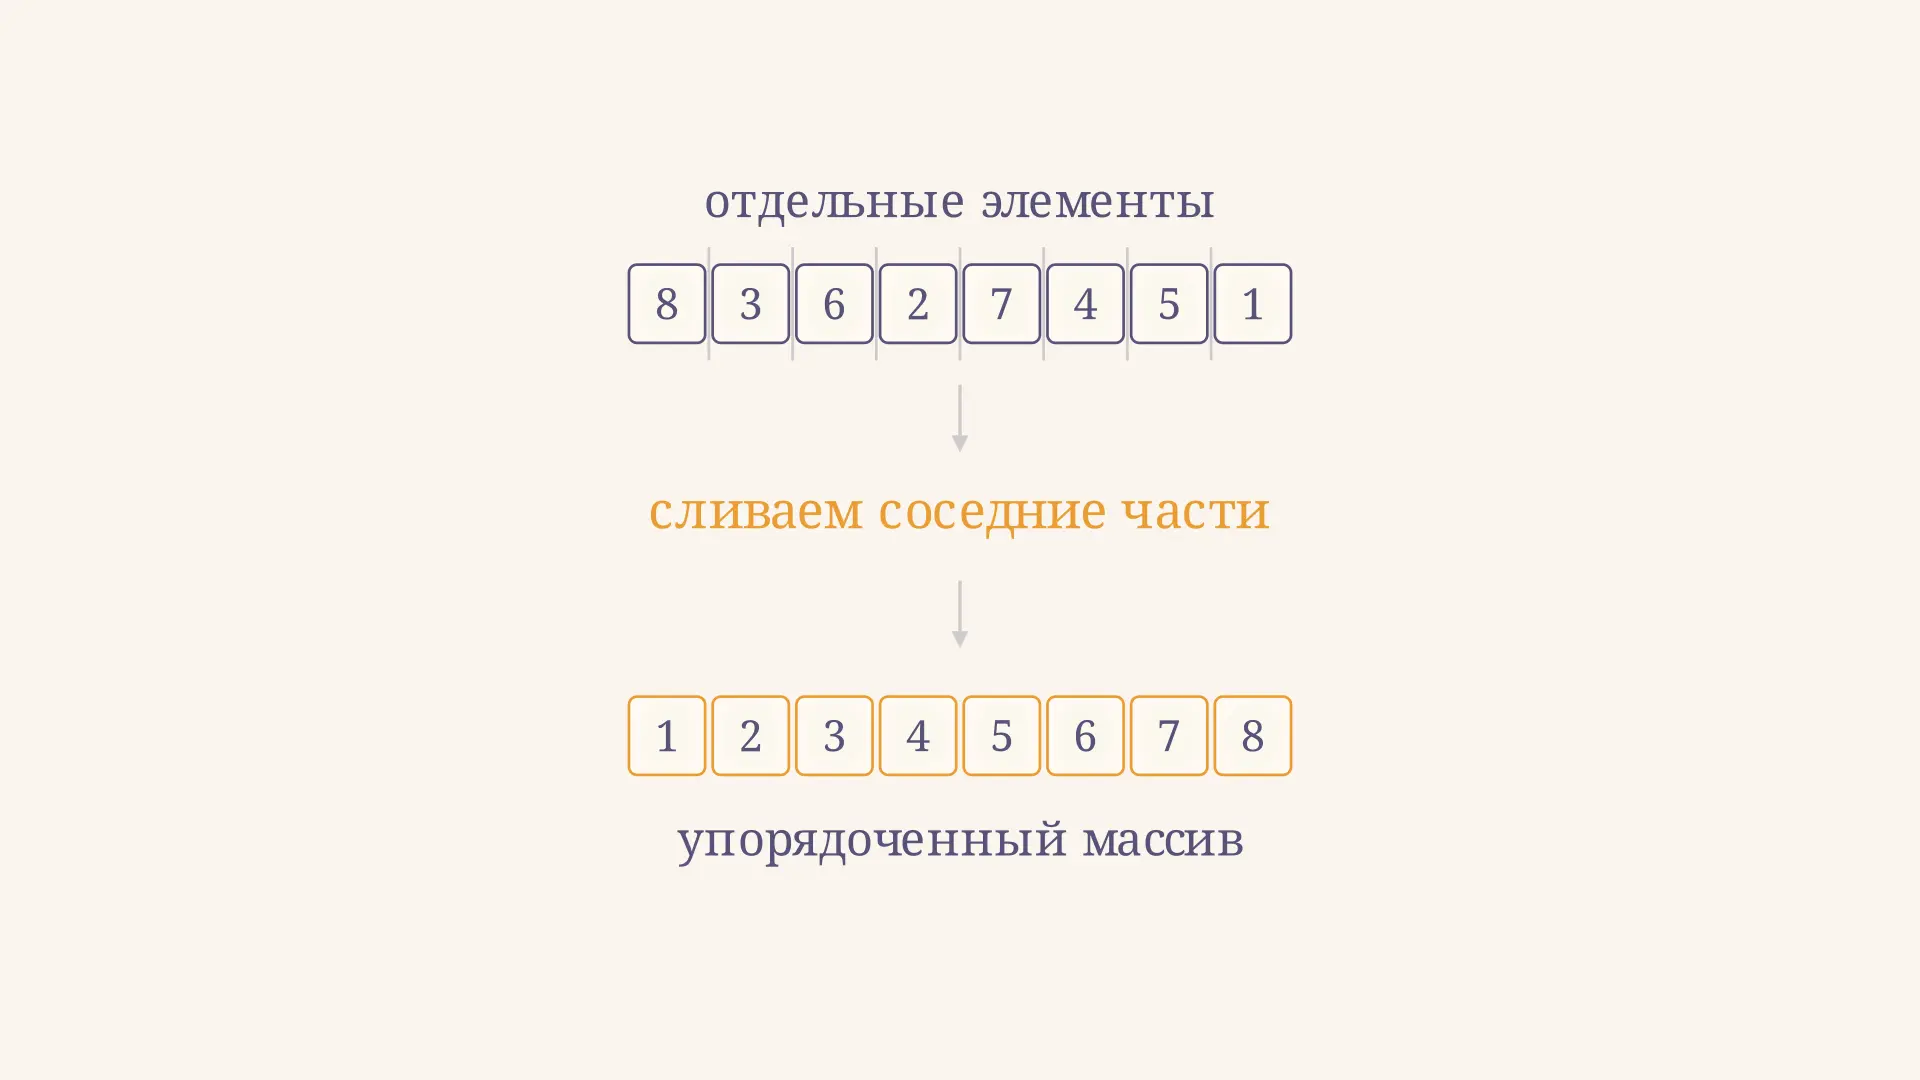
Сортировка слиянием: сложность по времени и памяти
Разбираем сложность сортировки слиянием: вывод O(n log n), число сравнений на примере, расход дополнительной памяти и условия устойчивости алгоритма при равных ключах.