Односвязный список: операции и их сложность
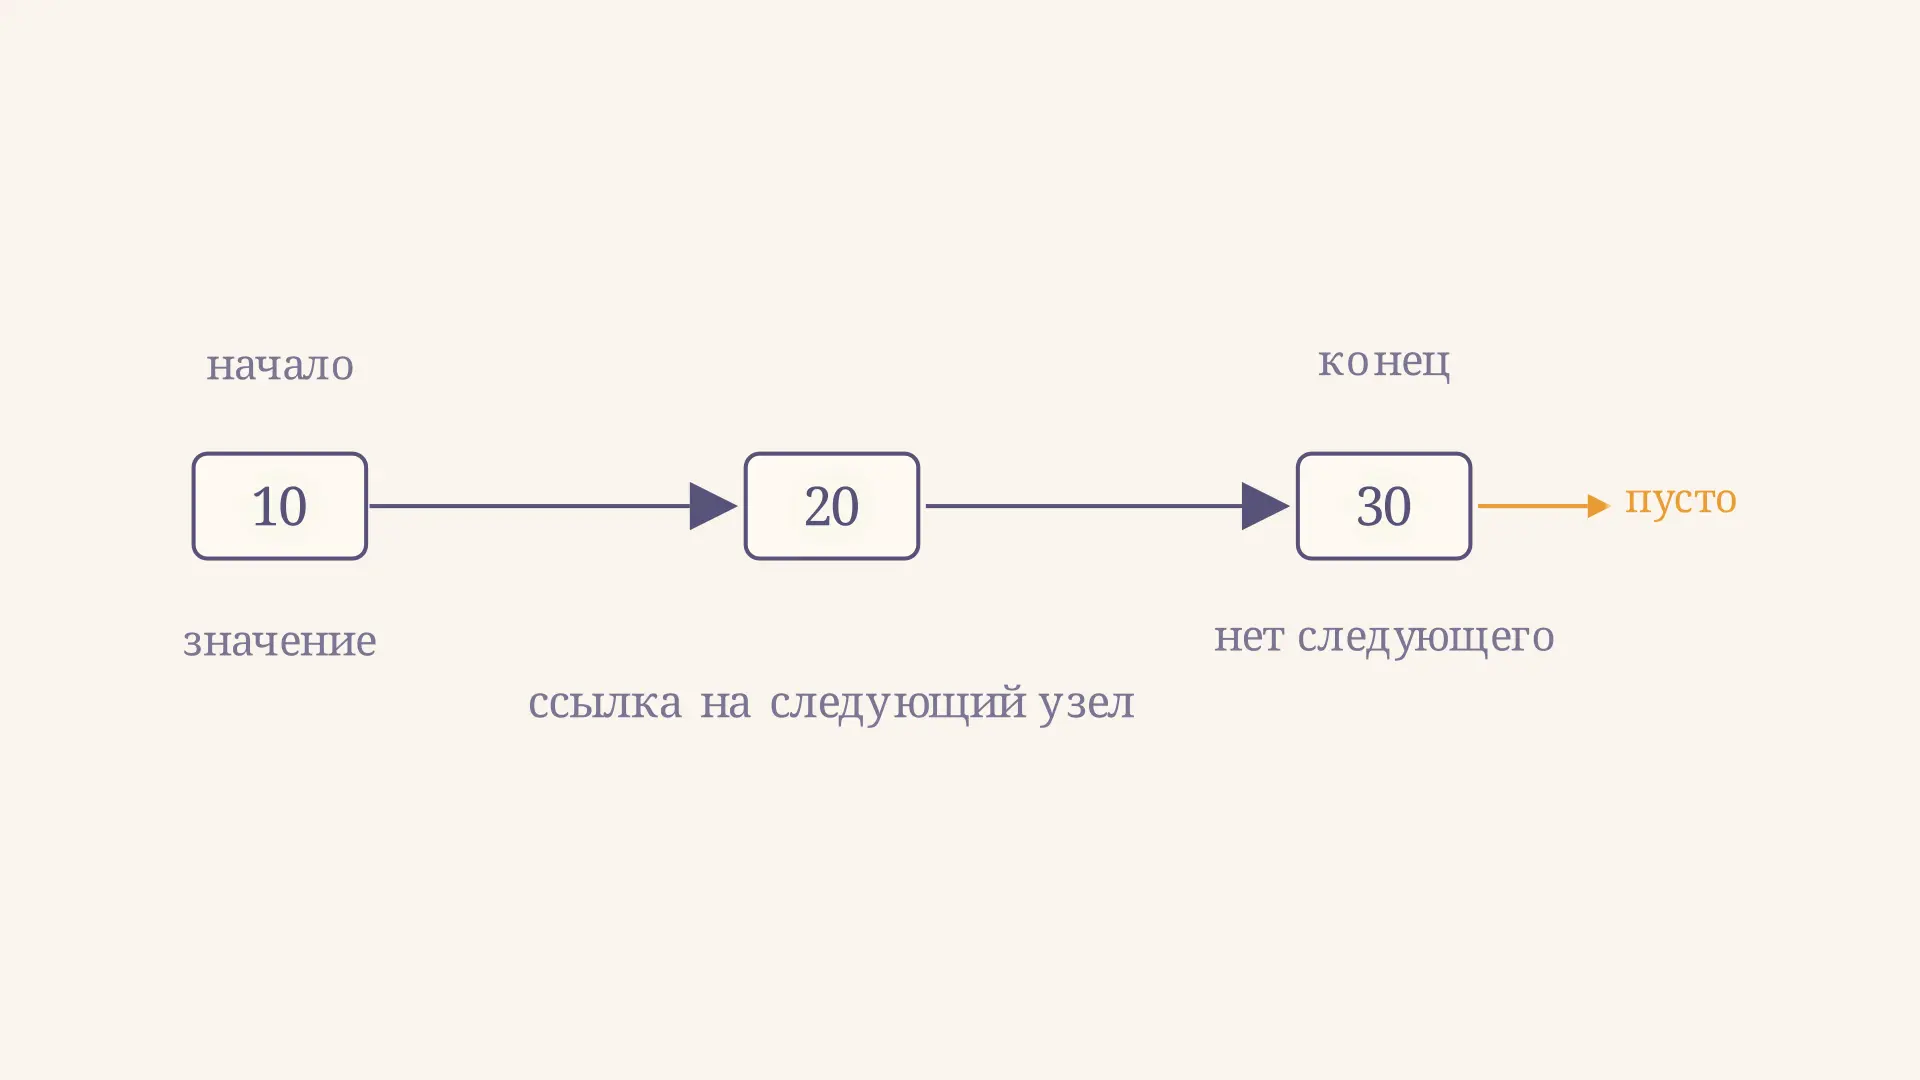
Односвязный список - последовательность узлов, каждый из которых хранит значение и ссылку на следующий узел. Достаточно знать начало цепочки, чтобы пройти её вперёд. При этом попасть сразу к произвольному элементу, как по индексу массива, нельзя: придётся последовательно читать ссылки.
Разберём поиск, вставку и удаление на примере 10 → 20 → 30, а также выясним, какие действия действительно занимают постоянное время. В интерактиве можно изменить длину цепочки и увидеть, сколько ссылок нужно пройти до выбранного индекса.
Узлы, голова и конец цепочки
Узел состоит из данных и поля next, в котором хранится ссылка на следующий узел. Ссылка head указывает на первый узел, или голову. У последнего next равно null: это признак конца обычного некольцевого списка. У пустого списка head тоже равно null. Значения в узлах могут повторяться; одинаковые данные не делают сами узлы одним объектом.
Стрелки показывают логический порядок. Соседние узлы не обязаны лежать рядом в памяти. Слово «односвязный» означает, что каждый узел знает только следующего соседа: ссылки на предыдущий нет. Поэтому движение назад требует дополнительной информации или нового прохода от головы.
Вставим 15 после узла 10. Порядок действий важен: сначала новый узел должен узнать о продолжении цепочки, затем предыдущий укажет на него. Ролик возвращается к исходному состоянию, чтобы последовательность можно было рассмотреть ещё раз.
В обратной части цикла показаны состояния в обратном порядке, а не обычный алгоритм вставки. В рабочем коде каждый переход между состояниями реализуется отдельным присваиванием ссылки.
Обход и поиск значения
Для обхода начните с head, обработайте значение текущего узла и перейдите по next. Повторяйте это, пока текущая ссылка не станет null. Поиск значения использует тот же проход, но останавливается при первом совпадении. Если совпадений нет, необходимо дойти до конца.
Для списка из узлов поиск в худшем случае занимает времени и дополнительной памяти при итеративном обходе. При этом удачный поиск головы завершится сразу. Оценка описывает рост верхней границы, а не утверждает, что каждый запрос проходит всю цепочку.
Доступ по индексу работает похоже: при нумерации с нуля к узлу с индексом ведут ровно переходов от головы, если индекс допустим. Чтобы прочитать индекс 2 в примере, посещаем 10, 20 и 30 и выполняем два перехода. Счёт посещённых узлов включает голову, поэтому он на единицу больше числа переходов.
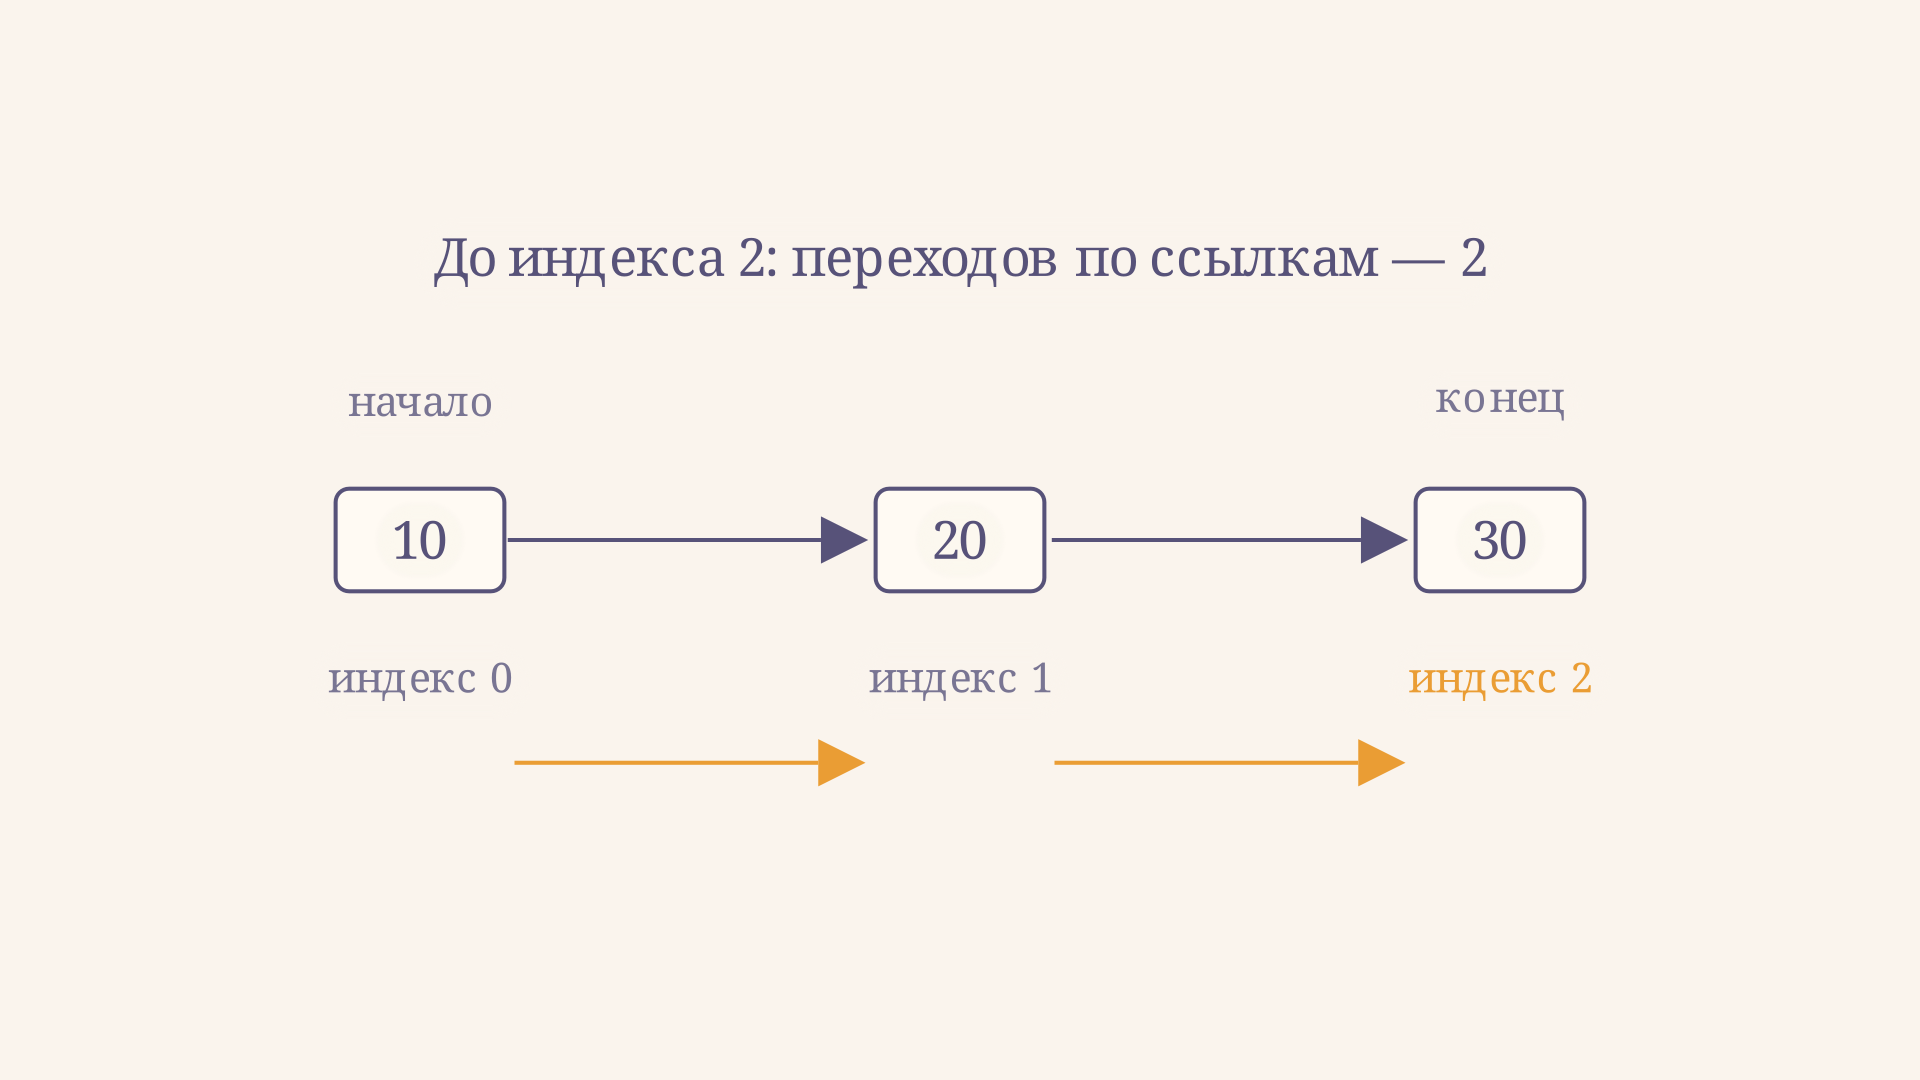
При неизвестном или неверном индексе проверяйте конец на каждом шаге. Если хранится размер, он помогает заранее отклонить индекс вне диапазона, но не превращает доступ к внутреннему узлу в прямой. Поиск в других структурах подчиняется другим правилам: например, поиск в двоичном дереве выбирает ветвь по сравнению ключей.
Вставка в начало и после узла
Для вставки в начало создайте узел, запишите в его next старый head, затем назначьте head новым узлом. Это работает и для пустого списка: старый head равен null, поэтому новый узел становится одновременно первым и последним. Если отдельно хранится указатель tail, при переходе от пустого списка его тоже нужно установить на новый узел.
Вставка после уже известного узла p требует двух переназначений ссылок:
new.next = p.next
p.next = new
Например, при p = 10 сначала поле next нового узла 15 получает ссылку на 20. Затем 10.next меняется на 15. Получается 10 → 15 → 20 → 30. Если выполнить второе присваивание первым и не сохранить старую ссылку отдельно, оставшаяся часть списка станет недоступной через голову.
Оба варианта вставки выполняют постоянное число действий, то есть стоят , если ссылка на p уже есть и стоимость выделения одного узла рассматривается как постоянная. Но поиск p по значению или индексу может занять ; полная операция включает и этот поиск. При вставке после последнего узла обновите tail, если он хранится.
Удаление головы и следующего узла
Для удаления непустой головы сохраните старый узел, перенесите head на его next, затем освободите старый узел там, где память освобождается вручную. Если список стал пустым, сохранённый tail также должен стать null. В языке со сборщиком мусора отброшенный узел может быть собран, когда на него не останется доступных ссылок.
Чтобы удалить узел после известного p, сначала убедитесь, что p.next существует. Сохраните удаляемый узел q = p.next и присвойте p.next = q.next. Так в цепочке 10 → 20 → 30 ссылка узла 10 начинает вести сразу на 30. При удалении последнего узла обновите tail до p, если он есть.
Перепривязка занимает , когда предшественник уже известен. Однако ссылка только на удаляемый внутренний узел обычно не даёт доступа к его предшественнику: для обычного удаления требуется найти его от головы. Особый случай головы обрабатывается отдельно. Попытку удалить из пустого списка или после последнего узла нужно явно отклонить или описать как операцию без результата.
Сложность основных операций
Пусть - число узлов, а head известен. В таблице отдельно указано, какая ссылка уже имеется до начала работы.
| Операция | Условие | Время |
|---|---|---|
| Прочитать или вставить голову | Известен head | |
| Удалить голову | Список непуст | |
| Найти значение или индекс | Начинаем с головы | в худшем случае |
| Вставить после узла или удалить следующий | Известен предшественник | |
| Добавить в конец | Есть корректный tail | |
| Удалить последний | Только head и, возможно, tail | в худшем случае |
Указатель на хвост позволяет сразу найти место добавления, но сам по себе не сообщает, кто стоит перед хвостом. Поэтому при удалении последнего узла односвязного списка предшественника обычно ищут проходом. Это ограничение подробно видно в описании односвязного списка в Open Data Structures.
Длину можно хранить отдельным счётчиком и обновлять при каждой успешной вставке и удалении. Тогда чтение длины стоит ; без счётчика нужен обход за . Дополнительная ссылка в каждом узле и, возможно, служебные поля самого списка занимают память, которую тоже стоит учитывать при выборе структуры.
Для примера проследим границу из одного элемента. Пусть и голова, и хвост указывают на узел 10. После удаления головы новая голова равна null; хвост тоже необходимо обнулить. Если затем добавить 20 в пустой список, обе ссылки должны указывать уже на 20. Такой маленький пример помогает проверить инвариант: пустой список не имеет ни первого, ни последнего узла, а в непустом хвост указывает на узел с пустой следующей ссылкой.
Отдельно стоит проверить повторяющиеся значения. При поиске 20 в цепочке 10 → 20 → 20 первый найденный узел и второй остаются разными объектами. Алгоритм удаления должен заранее определить, удаляет ли он первое совпадение или все совпадения: после удаления первого повторная проверка ссылки предшественника позволяет не пропустить второй узел.
Когда список полезен
Односвязный список удобен, когда операции часто происходят у головы или когда программа уже хранит ссылки на нужных предшественников. На нём можно реализовать стек: добавлять и снимать элементы с головы. С указателями на голову и хвост можно также добавлять в хвост и снимать с головы очереди. Разницу порядка LIFO и FIFO объясняет статья про стек и очередь.
Массив лучше подходит, когда часто нужен элемент по индексу: прямой доступ занимает , а элементы обычно расположены подряд. Но вставка внутрь массива может потребовать сдвига следующих элементов. Реализация стека на списке Python показывает другой выбор: в Python такой список является динамическим массивом, а не описанной здесь цепочкой узлов.
Сравнивая структуры, уточняйте не только асимптотику, но и доступные ссылки, стоимость выделения памяти и характер обращений. Например, биномиальная куча решает задачу работы с приоритетами и использует другую организацию данных; её оценки нельзя переносить на обычную цепочку.
Частые ошибки
- Считать любую вставку : без ссылки на нужного предшественника время поиска может доминировать.
- Перезаписывать
p.nextдо сохранения продолжения: часть цепочки может потеряться. - Путать два перехода и три посещённых узла при доступе к индексу 2.
- Забывать обновлять
head,tailи счётчик размера при изменении пустого или одноэлементного списка. - Разыменовывать
nullпри поиске отсутствующего значения или удалении после последнего узла.
FAQ
Можно ли пройти односвязный список с конца к началу?
По одним полям next напрямую нельзя. Можно сначала пройти список от головы и сохранить узлы, либо снова искать предшественника для каждого шага, либо выбрать двусвязную структуру с обратными ссылками. У этих решений разные затраты памяти и времени.
Можно ли удалить узел за , зная только его значение?
В общем случае нет: сначала узел и его предшественника надо найти. Исключение - когда удаляемая голова сразу совпала со значением; гарантии постоянного времени для произвольного значения это не даёт.
Зачем хранить хвост, если известна голова?
Чтобы добавлять новый узел в конец без полного прохода. При этом нужно поддерживать tail при каждой операции, меняющей последний узел, включая удаление единственного элемента.
Коротко
Односвязный список соединяет узлы ссылками вперёд. Вставка и удаление у головы или после известного предшественника требуют постоянного числа изменений ссылок; поиск и доступ к произвольному индексу в худшем случае линейны. Всегда учитывайте стоимость поиска, пустой список и обновление служебных указателей.
Читайте также
Сортировка слиянием: как работает merge sort
Сортировка слиянием на примере массива: разбор проходов и числа сравнений, устойчивость, оценка времени и памяти, реализация на Python и области применения.
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
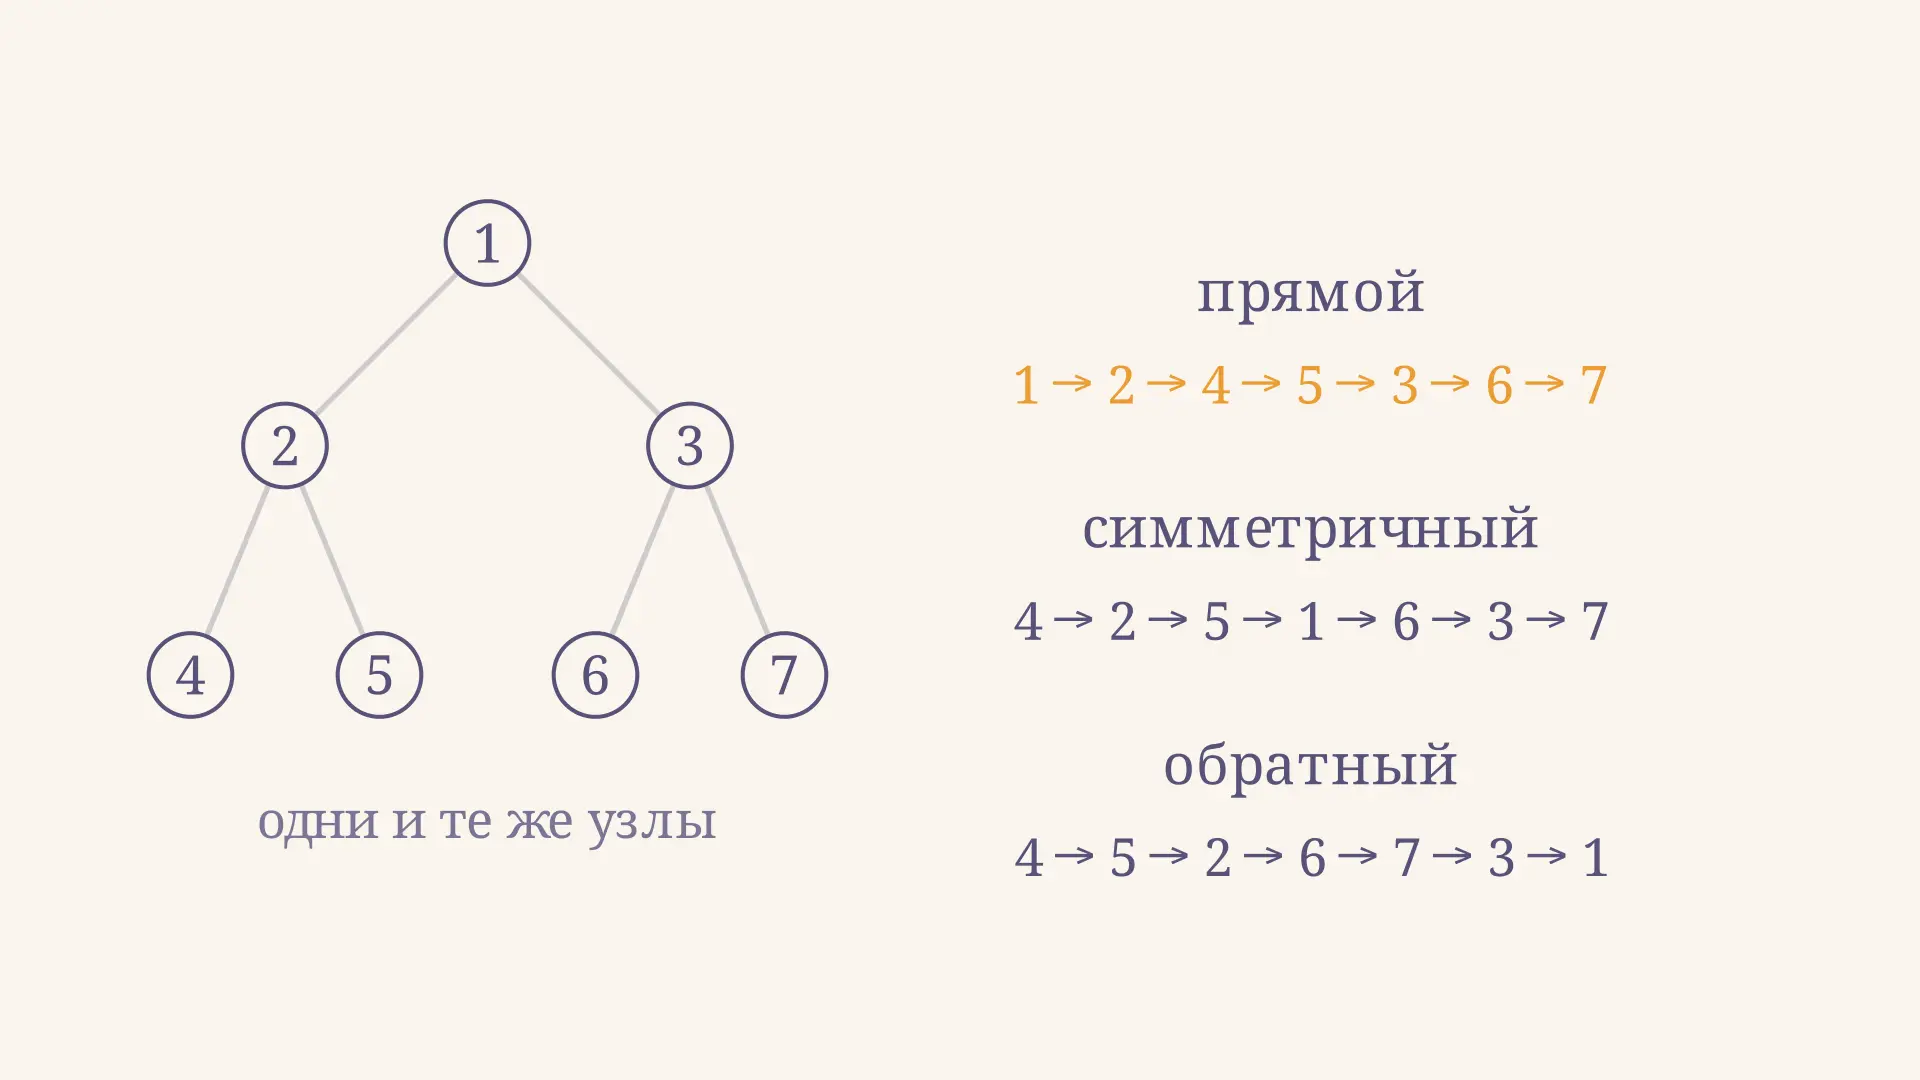
Обходы двоичного дерева: порядки и примеры
Обходы двоичного дерева на одном примере: прямой, симметричный, обратный и по уровням. Как работают рекурсия, стек и очередь, какие результаты и сложность.
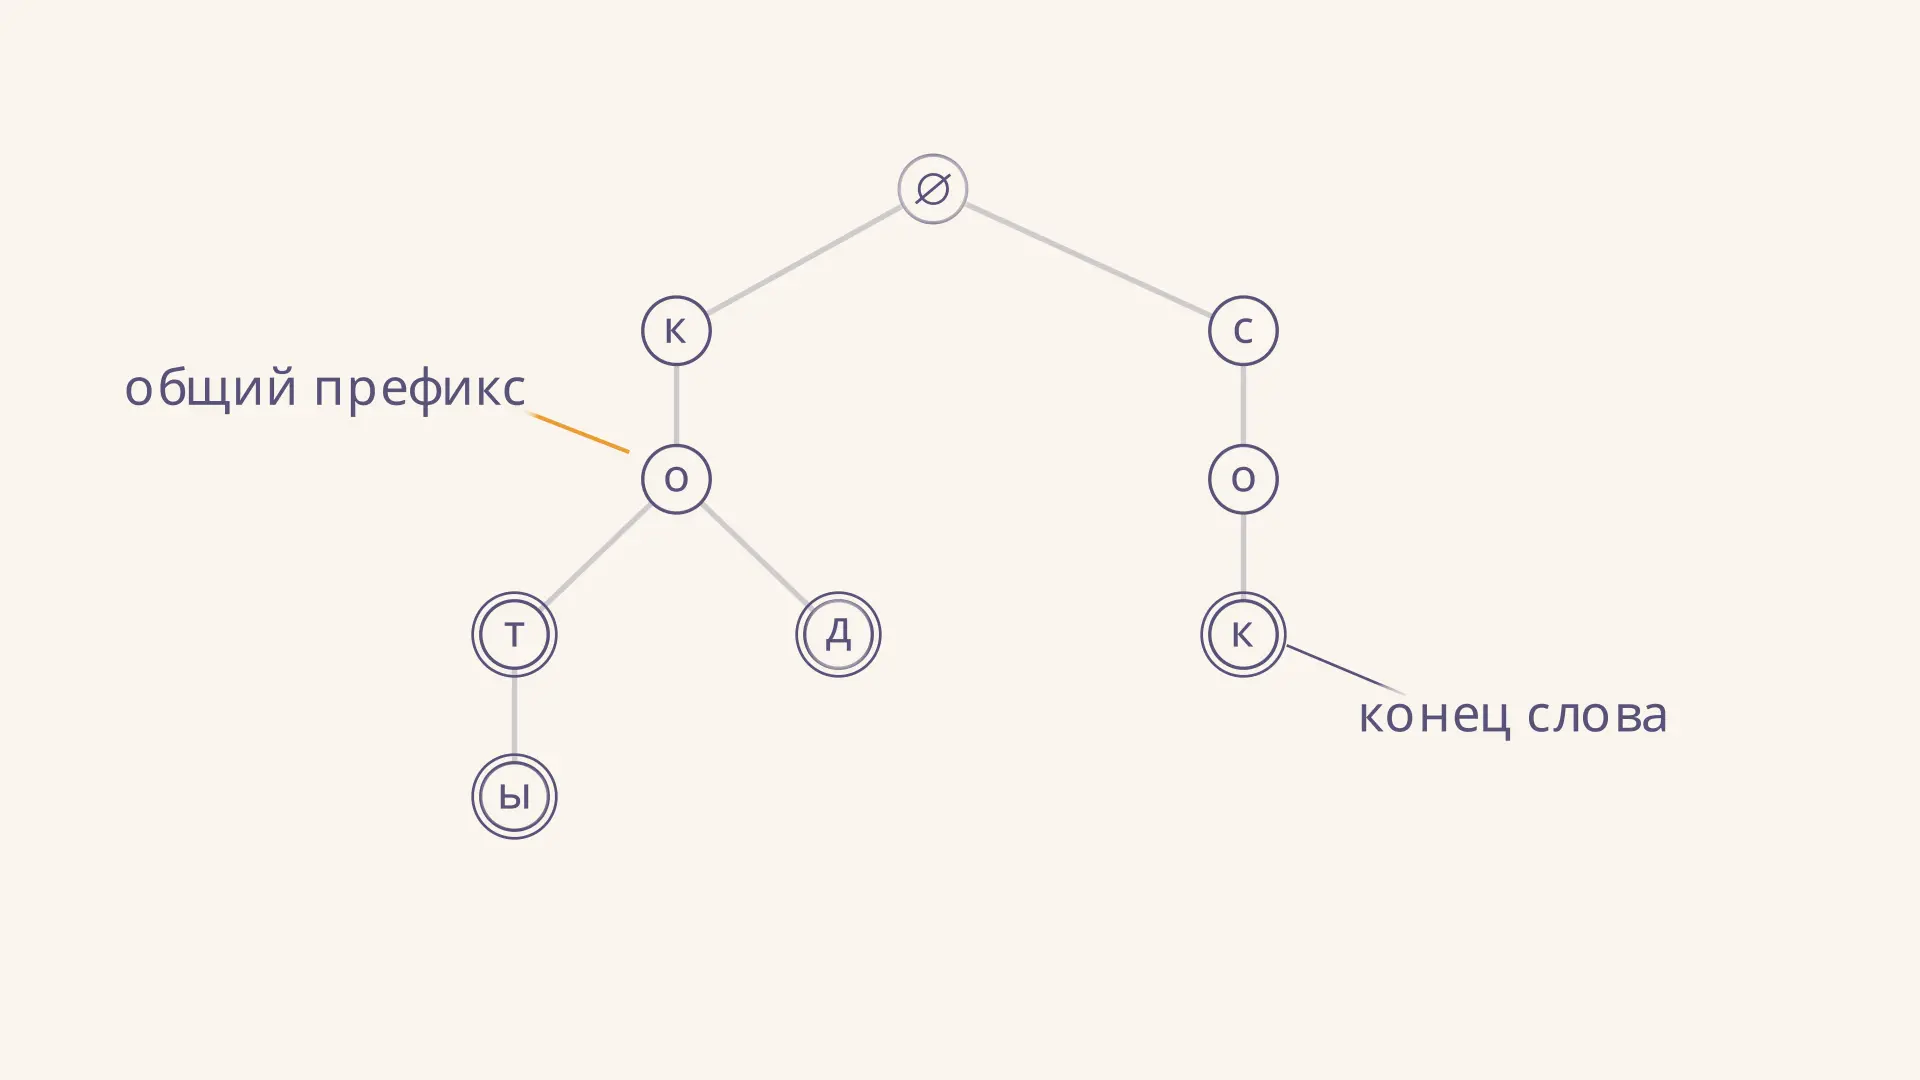
Префиксное дерево: как устроен бор строк
Префиксное дерево хранит общие начала строк вместе. Разбираем построение бора, поиск и удаление слов, сложность операций и применение на наглядном примере.
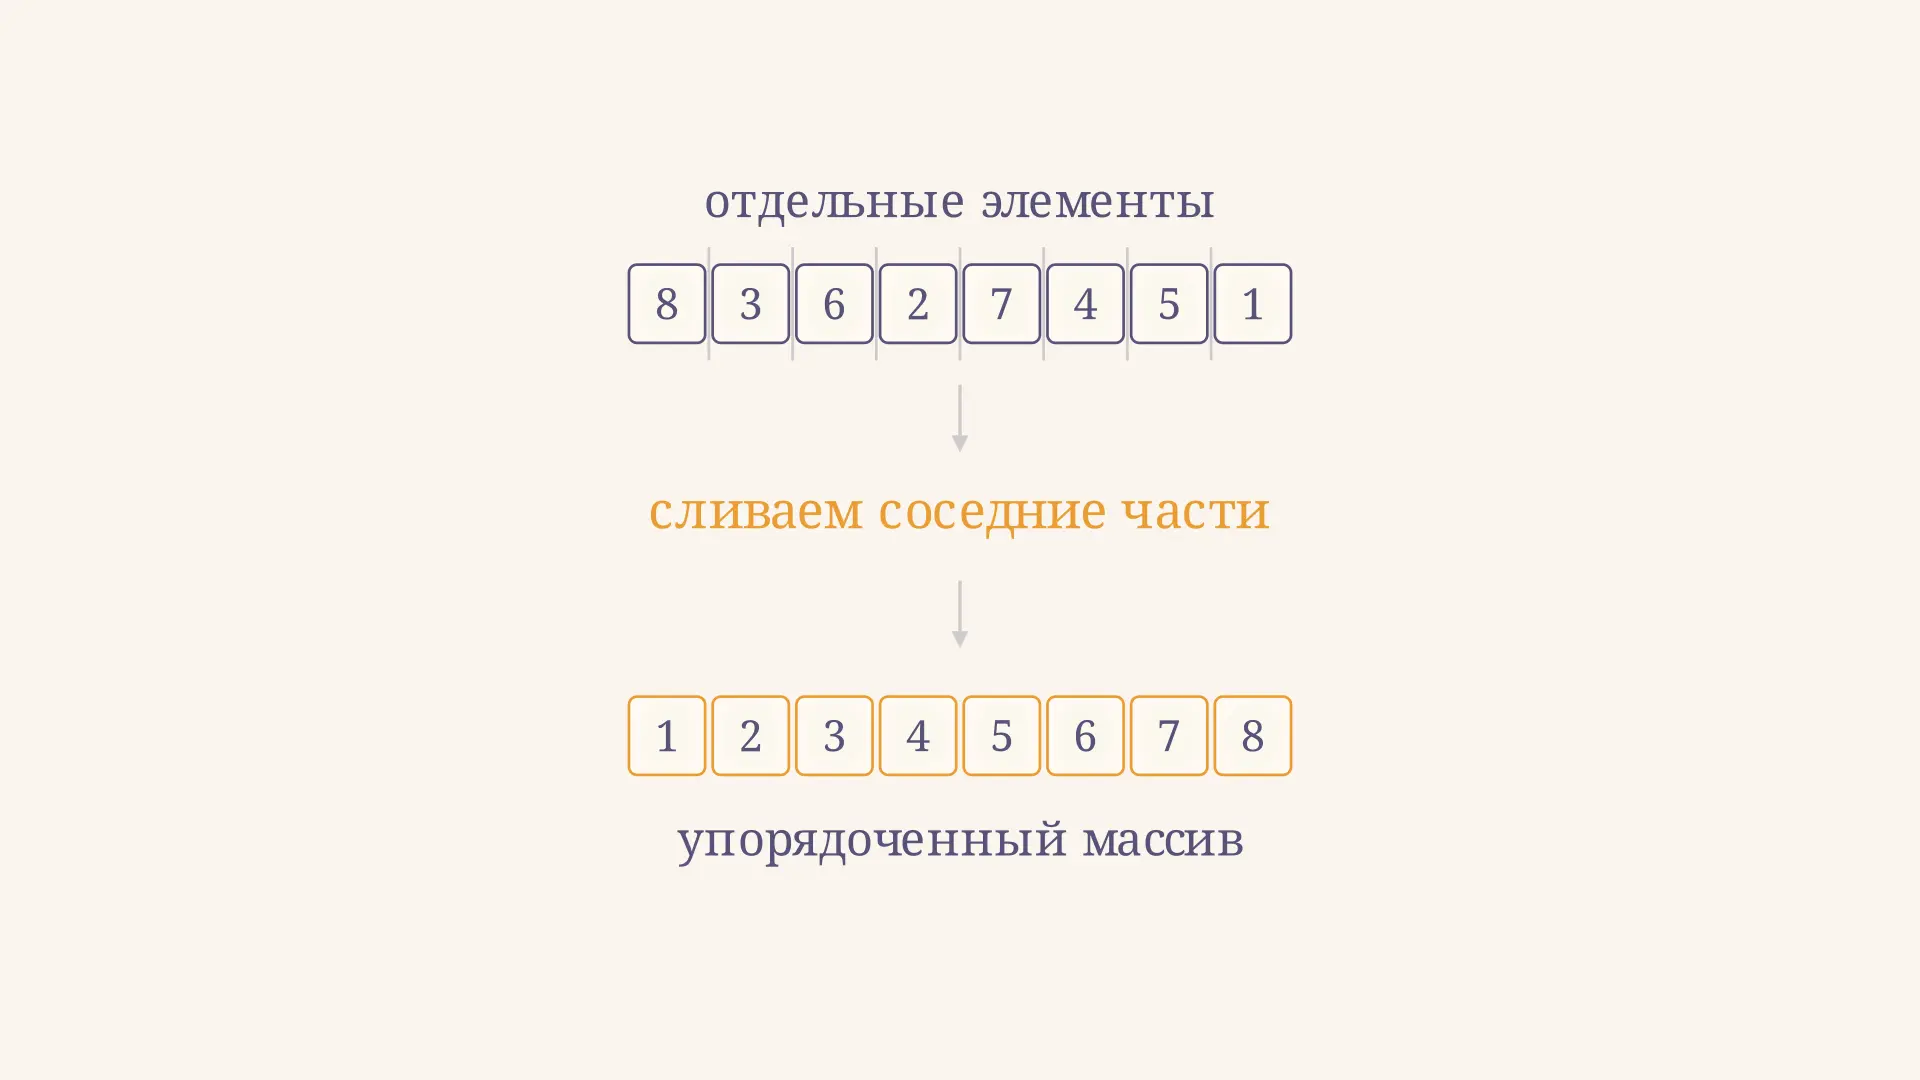
Сортировка слиянием: сложность по времени и памяти
Разбираем сложность сортировки слиянием: вывод O(n log n), число сравнений на примере, расход дополнительной памяти и условия устойчивости алгоритма при равных ключах.
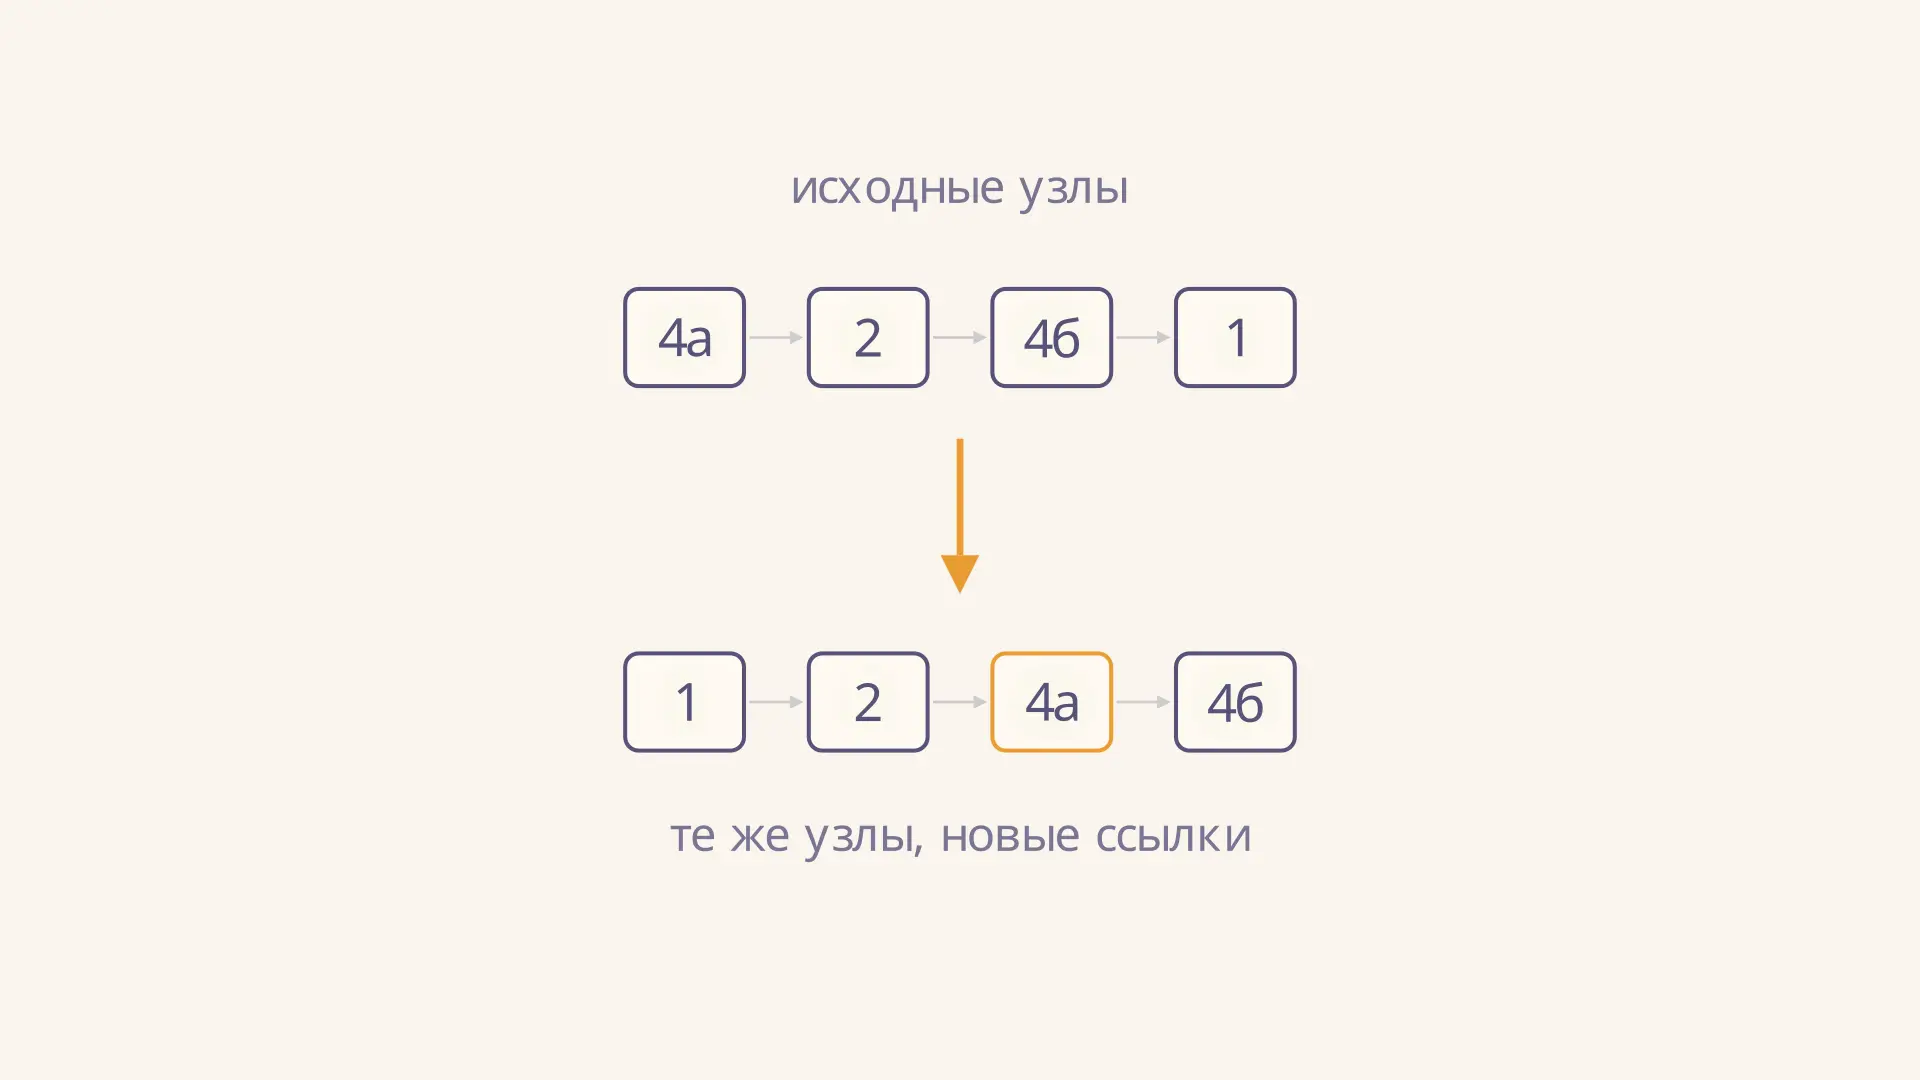
Сортировка связного списка слиянием: алгоритм
Как отсортировать односвязный список слиянием: разделение быстрым и медленным указателями, перестановка ссылок, устойчивость и оценка времени и памяти.