Сортировка слиянием: сложность по времени и памяти
Сортировка слиянием для массива из элементов в обычной реализации работает за времени и использует дополнительной памяти. Она делит массив на части, сортирует каждую и объединяет результаты. Линейная работа слияния повторяется на логарифмическом числе уровней: именно из этого произведения возникает оценка. Она сохраняется для лучшего, среднего и худшего входа, если алгоритм всегда выполняет слияния и стоимость сравнения постоянна.
В калькуляторе можно изменить размер массива и сравнить точные минимальное и максимальное числа сравнений ключей для такой версии. Они не равны полному числу действий: копирование элементов и проверки границ в счётчик не входят.
Как работают разделение и слияние
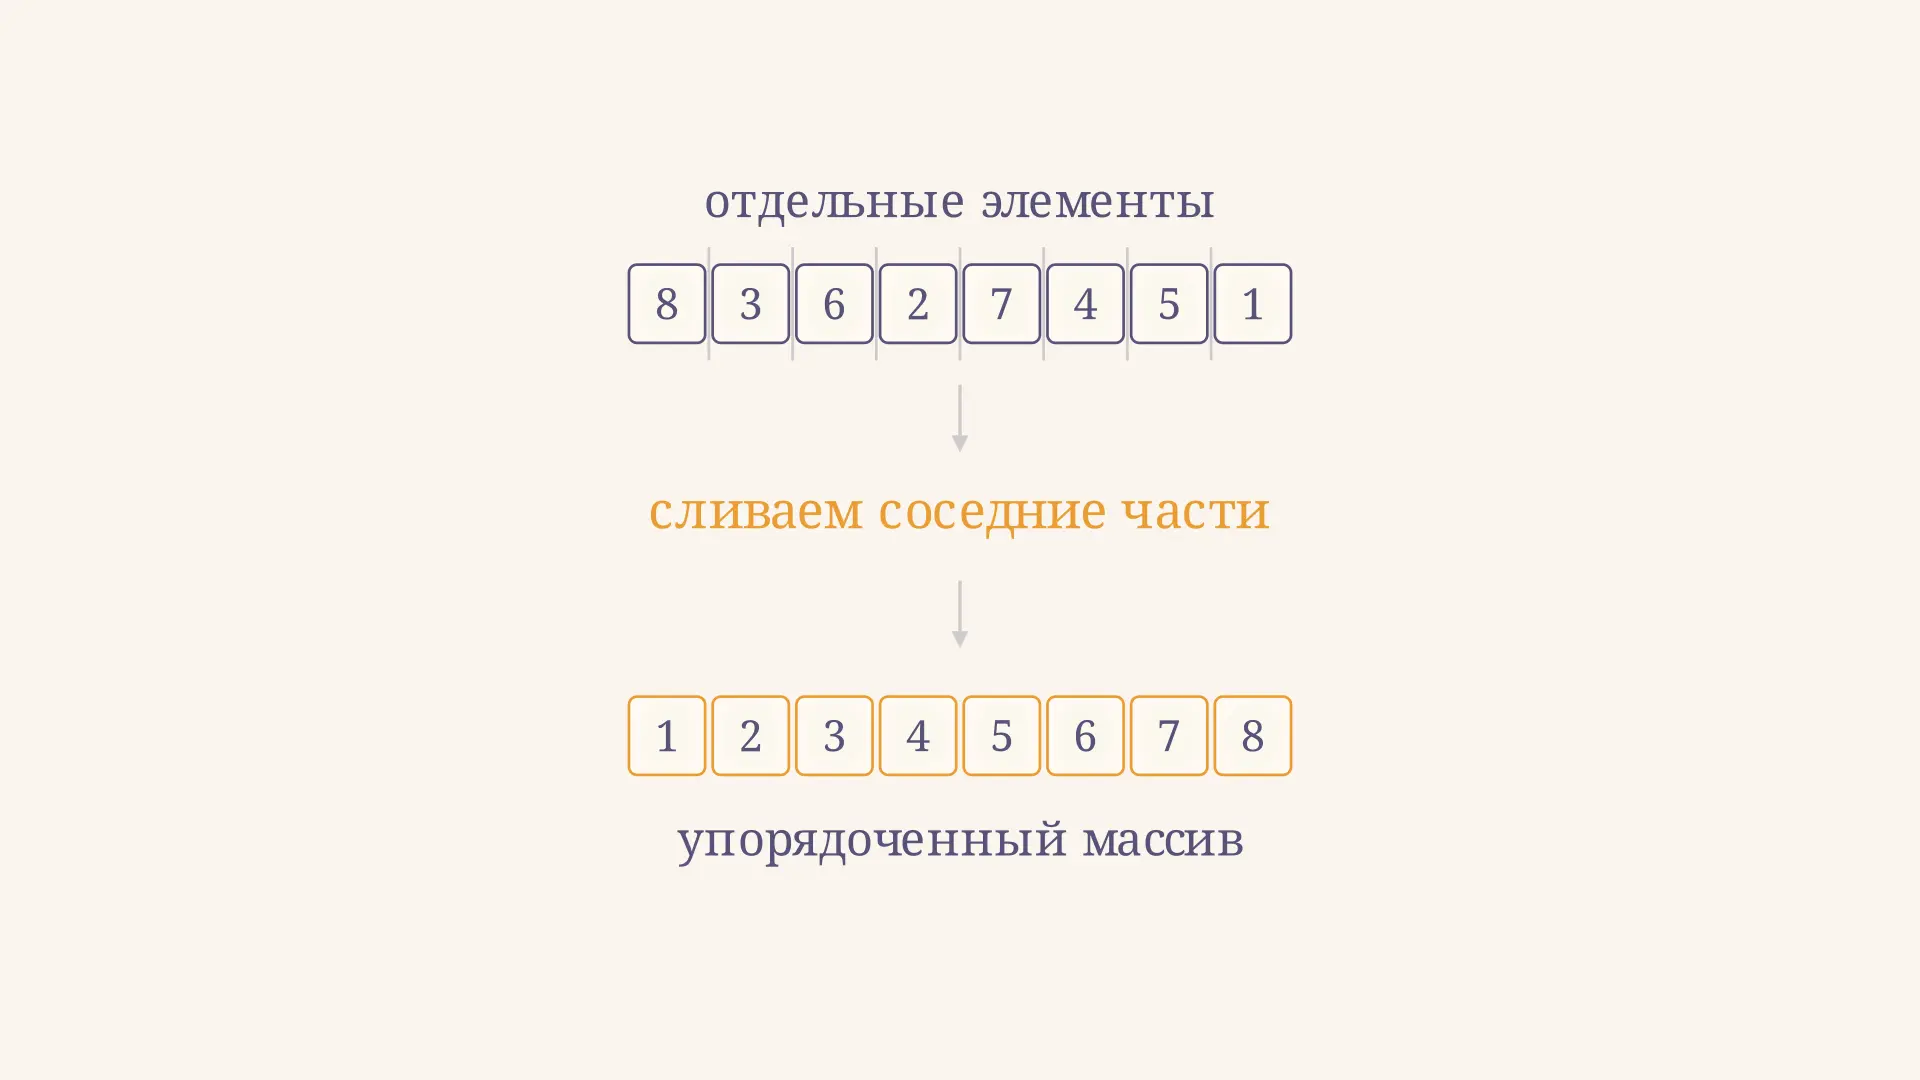
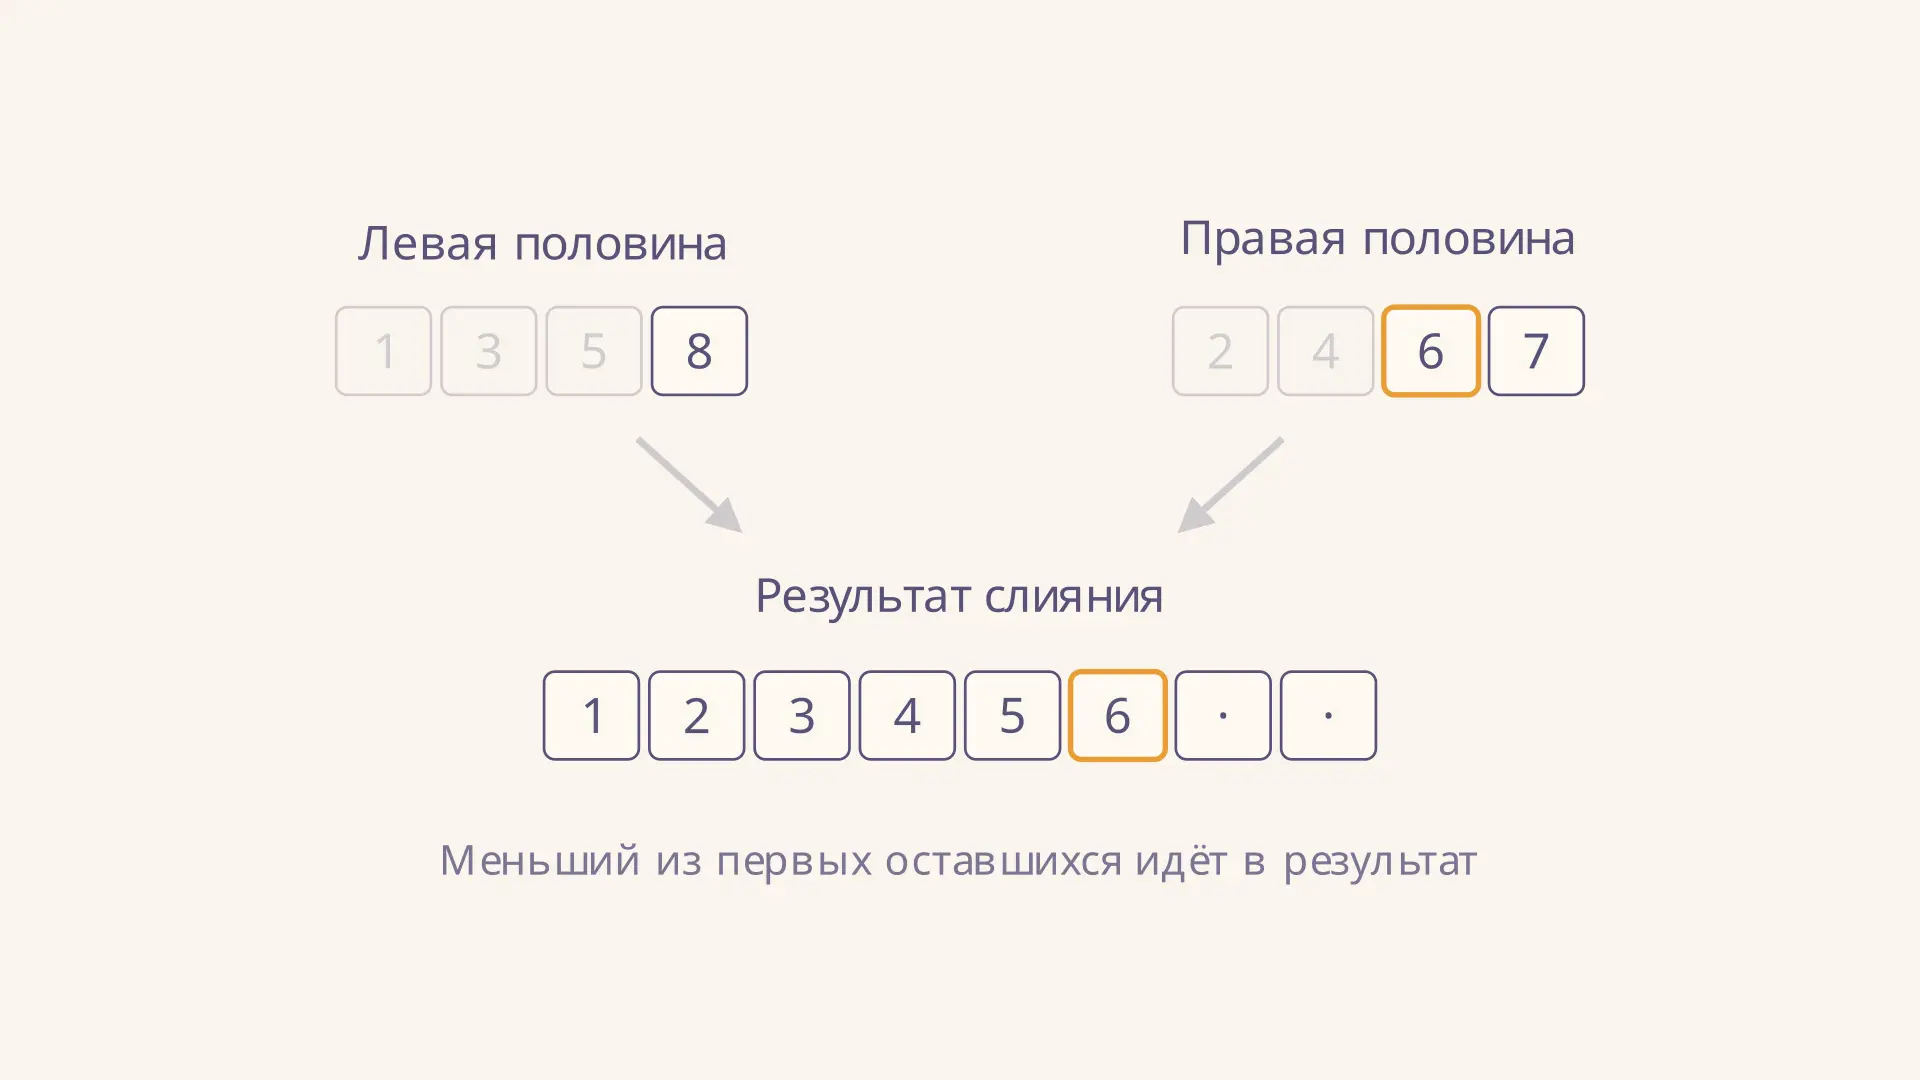
Один элемент уже упорядочен. Поэтому алгоритм рекурсивно делит массив пополам, пока не получит части длины один, а затем поднимается обратно. На каждом шаге он объединяет две уже отсортированные последовательности: сравнивает их первые ещё не перенесённые элементы и добавляет меньший в результат. Когда одна часть кончилась, остаток другой переносится целиком.
Например, при слиянии и сравниваются и , затем и , потом и . Получается : оставшуюся восьмёрку сравнивать уже не нужно. На слияние частей общей длины требуется не более сравнений ключей, а перенос всех элементов занимает действий. При пустой части сравнения вообще не нужны.
Важно, что итог первой пары частей ещё не отсортировывает весь массив. Гарантия касается только текущего объединённого отрезка. Условие сохранения порядка внутри каждой части позволяет каждый раз выбирать меньший из двух первых элементов: среди остальных подходящих кандидатов меньшего уже нет.
Почему получается n log n
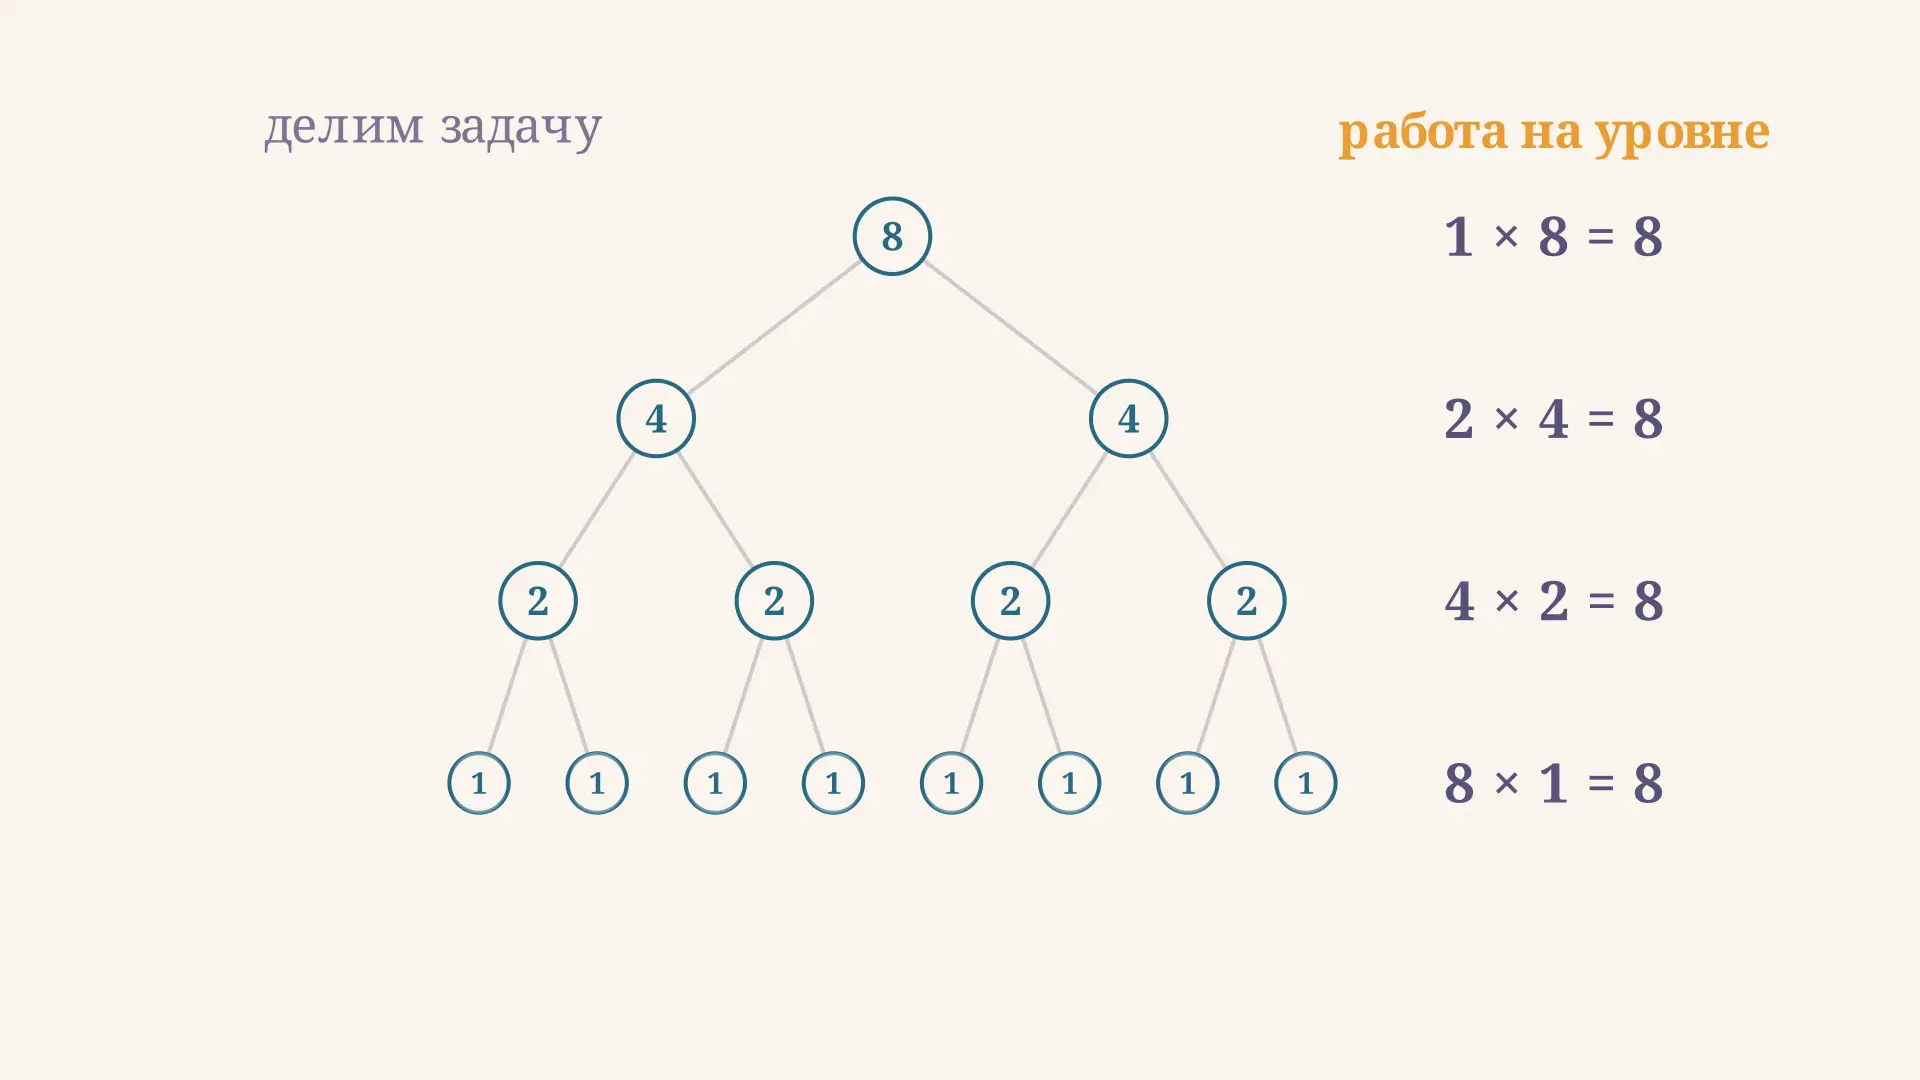
Пусть для начала . На самом верхнем уровне одно слияние обрабатывает элементов. Уровнем ниже есть два слияния по элементов, вместе опять . Ещё ниже - четыре по . В сумме на каждом уровне переносится элементов, а уровней слияния ровно .
Отсюда общая работа по переносу имеет порядок . Разделение, вызовы и проверки границ также учитываются в общей оценке и не меняют её порядок. При последовательном выполнении базовая рекурсия записывается так:
Идея решать меньшие подзадачи встречается и в алгоритме Карацубы, хотя его рекуррентное соотношение другое. Разворачивая соотношение сортировки по уровням, получаем для . Буква здесь означает и верхнюю, и нижнюю границу одного порядка; подробнее разница между обозначениями разобрана в статье о временной и пространственной сложности. Вывод через рекурсию также приведён в учебных материалах MIT.
Если не степень двойки, половины имеют размеры и . Ветви заканчиваются на соседних глубинах, максимальная глубина равна , а асимптотика остаётся . Нельзя просто подставлять дробное число элементов в формулу точного счёта: для него нужны округления на каждом разбиении.
Сколько сравнений на конкретном массиве
Возьмём массив . После разбиения на отдельные элементы объединяем соседние части. Поскольку размер равен восьми, удобно посчитать сравнения по трём проходам снизу вверх:
- Четыре пары дают , , , . На каждую пару нужно одно сравнение, всего 4.
- Слияния пар дают и . Каждое требует по три сравнения, всего 6.
- При объединении двух четвёрок требуется 7 сравнений. Последний оставшийся элемент переносится без сравнения.
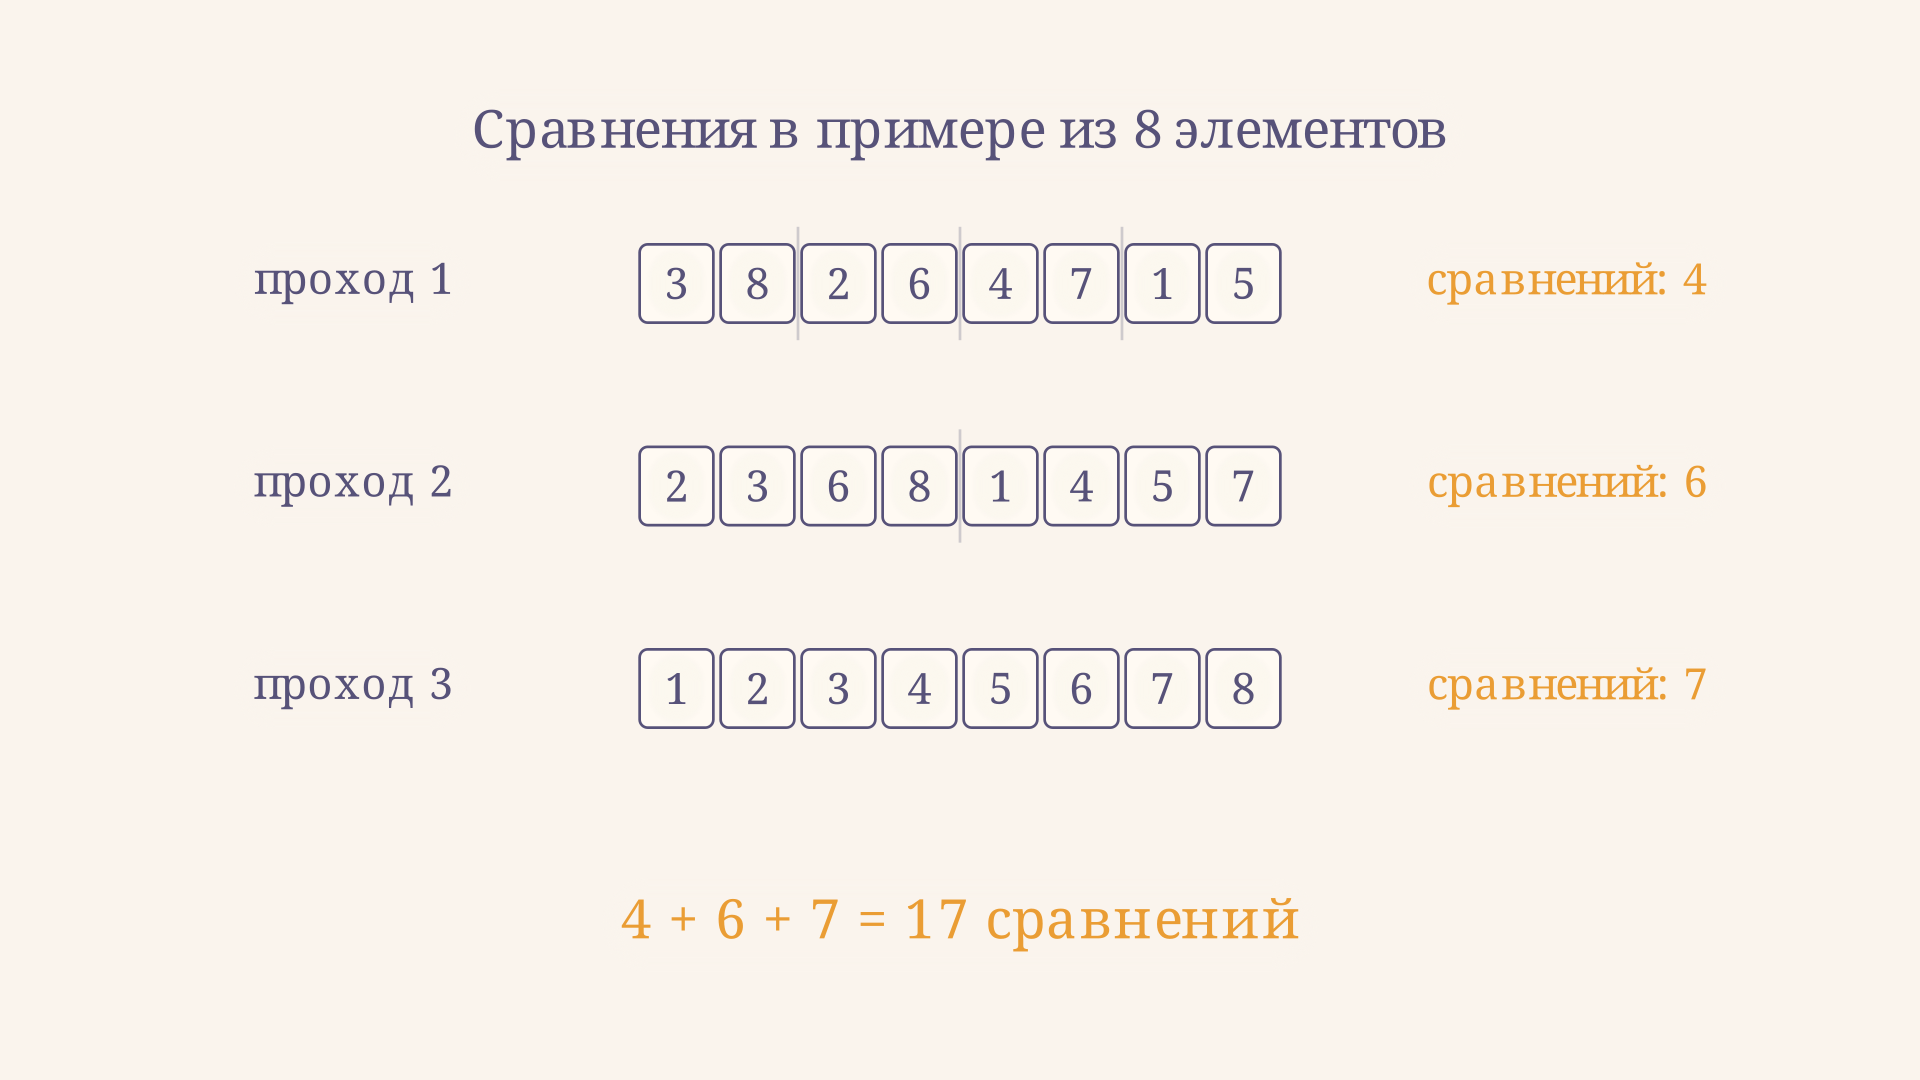
Итого . Это максимум для данного размера, хотя другой массив из восьми элементов может потребовать меньше сравнений. Например, уже отсортированный массив при тех же обязательных слияниях потребует : на каждом слиянии сначала исчерпывается левая половина. Элементы всё равно копируются на каждом уровне. Поэтому уменьшение числа сравнений само по себе не превращает обычную реализацию в линейную по времени.
Для максимум сравнений удовлетворяет соотношению , . Его решение:
При формула даёт . Для произвольного калькулятор применяет рекурсию к двум целым половинам. Максимум для слияния отрезка длины равен , минимум - длине меньшей половины; для полного алгоритма результаты складываются по дереву вызовов. Такой счёт относится к сравнениям ключей, а не к проверкам индексов или записи в память. Рекуррентный вывод максимума разобран в конспекте MIT по рекуррентным соотношениям.
Лучшая, средняя и худшая сложность
У обычного варианта дерево разбиения зависит от размера массива, а не от порядка значений. Сравнений на отдельных слияниях бывает разное количество, но алгоритм проходит все уровни и переносит данные. Следовательно, лучший, средний и худший случаи имеют порядок . Случайный ввод для этой гарантии не нужен.
Однако формулировка зависит от реализации. Если перед слиянием проверять, не меньше ли первый элемент правой половины последнего элемента левой, уже упорядоченные соседние части можно оставить как есть. На полностью отсортированном массиве такая оптимизация в подходящей реализации даёт линейное время, хотя худший случай остаётся . Это отличие важно при сравнении с калькулятором, где пропуска слияний нет. Идею проверки границы описывают и авторы курса Algorithms.
Сколько нужно дополнительной памяти
Для слияния массива обычно выделяют вспомогательный буфер на элементов и повторно используют его на разных уровнях. При последовательной обработке половин их буферы не обязаны одновременно занимать по мест на каждом уровне: пиковая дополнительная память буфера составляет . Стек рекурсии добавляет кадров, поэтому общая оценка остаётся .
Это именно пиковый расход сверх исходного массива. Суммарное количество записей в буфер за всё выполнение может быть : повторное использование ячеек не означает, что данные записывались туда лишь однажды. В конкретной программе на расход также влияют копирование срезов, размер объектов и способ выделения памяти.
Существуют более сложные слияния на месте, но приведённая оценка относится к распространённому варианту с буфером. В пирамидальной сортировке массивов дополнительная память может быть , зато она обычно неустойчива. В связном списке слияние можно организовать перестановкой ссылок, поэтому расходы памяти зависят и от структуры данных.
Устойчивость и сравнение с другими сортировками
Сортировка устойчива, если записи с равными ключами сохраняют исходный относительный порядок. При слиянии для этого достаточно при равенстве выбирать элемент левой части первым, а внутри частей порядок не нарушать. Например, записи с одинаковой оценкой останутся в прежнем порядке, если до сортировки они уже были упорядочены по имени. Если при равенстве брать правый элемент первым, эта гарантия исчезает.
Слияние полезно, когда нужны предсказуемое время и устойчивость, а дополнительный буфер допустим. Для больших данных, не помещающихся в оперативную память, можно отдельно отсортировать блоки и затем последовательно сливать их. Стоимость доступа к диску в такой постановке требует отдельной модели; одна только оценка сравнений её не описывает.
У быстрой сортировки характерное разбиение выполняется вокруг опорного элемента, а не на заранее равные по размеру отрезки. Неудачный выбор опорных элементов может привести к квадратичному времени. У слияния сбалансированность задаётся индексами независимо от значений, но за простой гарантированный вариант приходится платить буфером. При выборе алгоритма важны также цена сравнения и объём перемещаемых данных.
Частые ошибки
- Считать, что - цена одного слияния. Одно слияние линейно по суммарной длине частей; логарифм возникает из числа уровней.
- Умножать размер буфера на глубину рекурсии. Повторно используемый буфер занимает в пике, а не .
- Принимать 17 сравнений за число для любого массива из восьми элементов. Это максимум модели; минимум равен 12.
- Считать устойчивость автоматической. Она зависит от правила обработки равных ключей и сохранения порядка в частях.
- Переносить оценку на произвольную оптимизацию без оговорок. Пропуск уже упорядоченных слияний меняет лучший случай.
FAQ
Сортировка слиянием всегда работает за O(n log n)?
Обычная сбалансированная версия с линейным слиянием имеет такую верхнюю границу для любого входа при постоянной цене сравнения. Для неё справедлива и точная асимптотика . Оптимизации могут улучшить лучший случай.
Сколько сравнений нужно для восьми элементов?
В принятой модели - от 12 до 17. Точное значение зависит от порядка ключей. Верхняя граница получается по формуле .
Подходит ли алгоритм для стабильной сортировки?
Да, если при равенстве ключей выбирать элемент левой части и сохранять порядок внутри каждой части. Не всякая реализация слияния соблюдает это правило.
Коротко
Сортировка слиянием обрабатывает все элементов на каждом из примерно уровней. Обычный вариант с буфером гарантирует времени и требует дополнительной памяти; устойчивость обеспечивается выбором левого элемента при равенстве. Число сравнений зависит от входа и правил реализации.
Читайте также
Сортировка слиянием: как работает merge sort
Сортировка слиянием на примере массива: разбор проходов и числа сравнений, устойчивость, оценка времени и памяти, реализация на Python и области применения.
Дерево рекурсии: как посчитать сложность по уровням
Дерево рекурсии помогает разобрать рекуррентное соотношение: построим уровни вызовов, сложим их стоимость и найдём сложность на примерах деления задачи.
Обходы двоичного дерева: порядки и примеры
Обходы двоичного дерева на одном примере: прямой, симметричный, обратный и по уровням. Как работают рекурсия, стек и очередь, какие результаты и сложность.
Односвязный список: операции и их сложность
Односвязный список: как устроены узлы и ссылки, как выполнять поиск, вставку и удаление, сколько переходов они требуют и когда нужен указатель на хвост.
Сортировка связного списка слиянием: алгоритм
Как отсортировать односвязный список слиянием: разделение быстрым и медленным указателями, перестановка ссылок, устойчивость и оценка времени и памяти.
Поиск в двоичном дереве поиска: алгоритм и сложность
Как работает поиск в двоичном дереве поиска (BST): пошаговый алгоритм, число сравнений в среднем и худшем случае, влияние баланса дерева и типичные ошибки в задачах.