Обходы двоичного дерева: порядки и примеры
Обход двоичного дерева - это способ посетить его узлы в определённом порядке. Одно и то же дерево можно прочитать несколькими последовательностями: например, обработать родителя до его потомков или дождаться результатов обоих поддеревьев. Порядок важен, когда нужно скопировать структуру, вычислить выражение или вывести ключи.
В интерактивной схеме выберите способ и передвигайте ползунок: золотой узел покажет очередное посещение. Сравните последовательности для одного дерева, прежде чем разбирать алгоритмы.
Дерево для примера и значение посещения
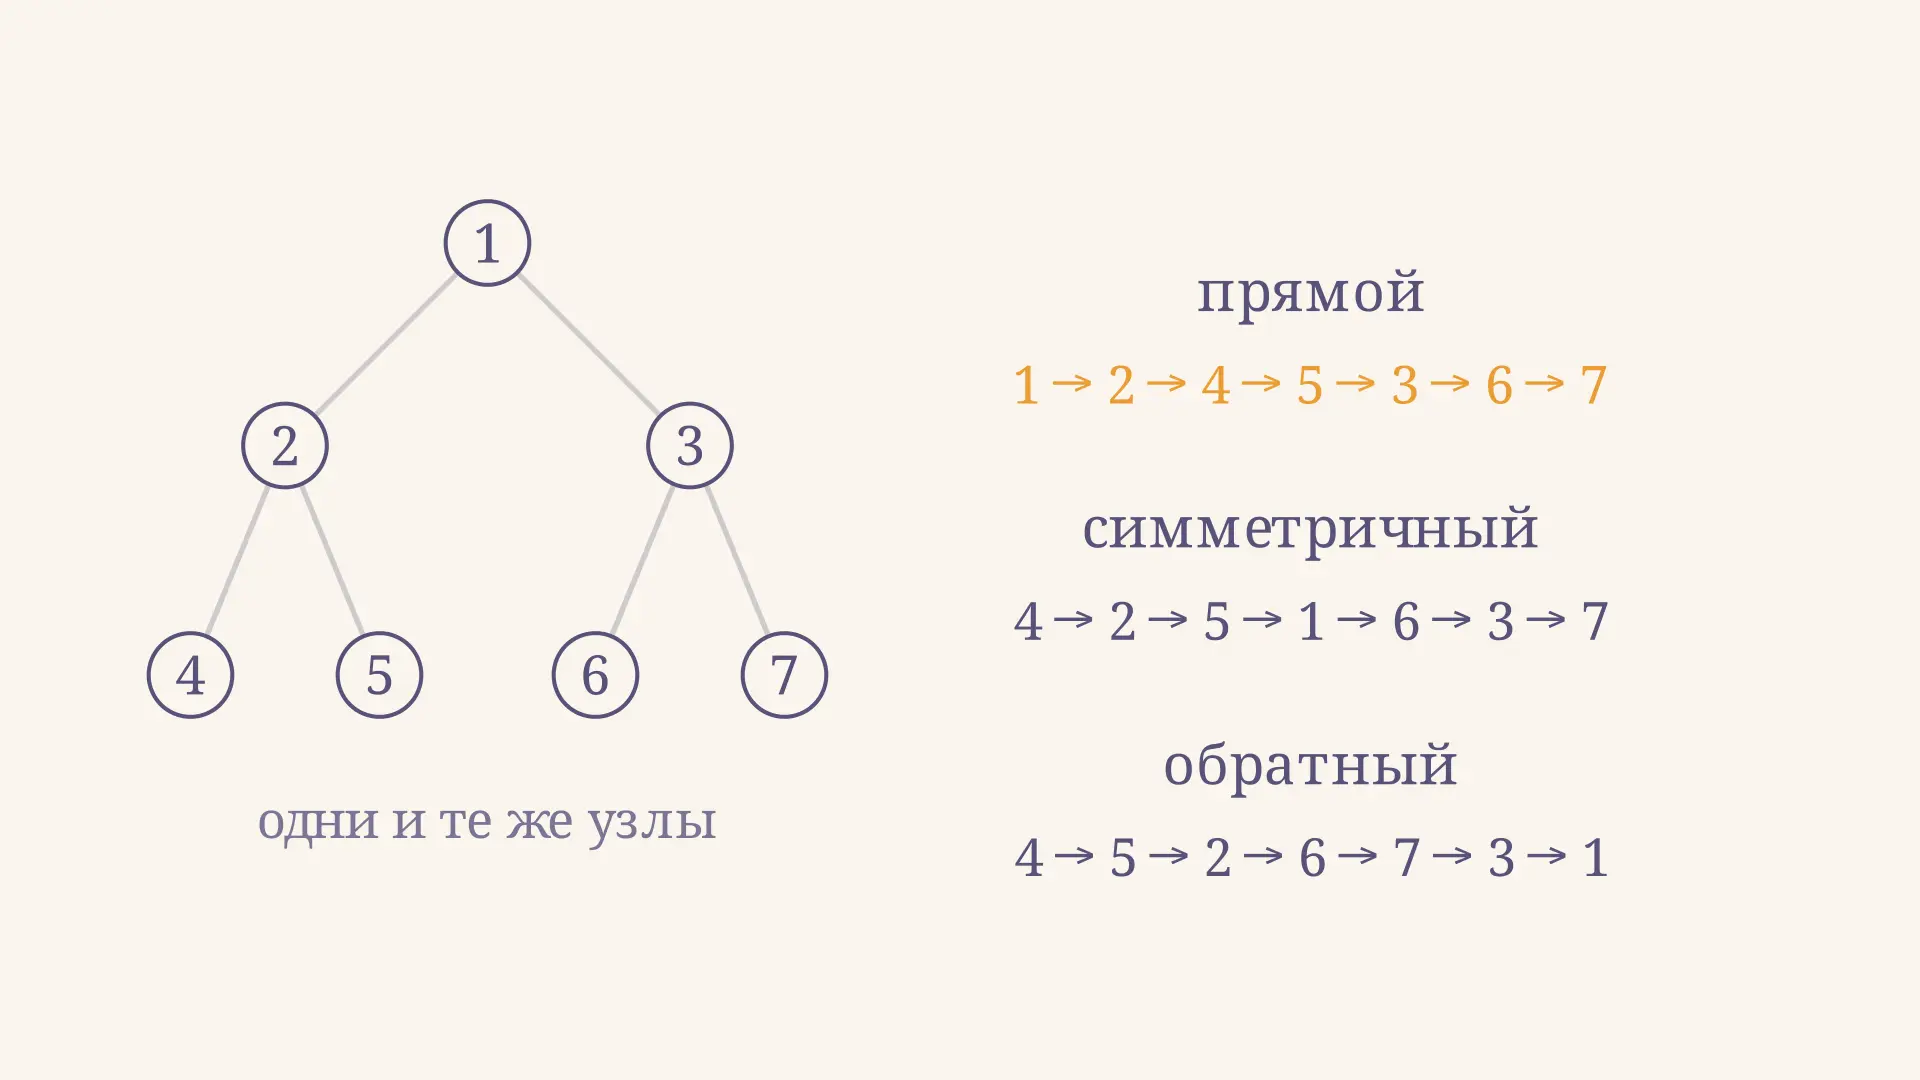
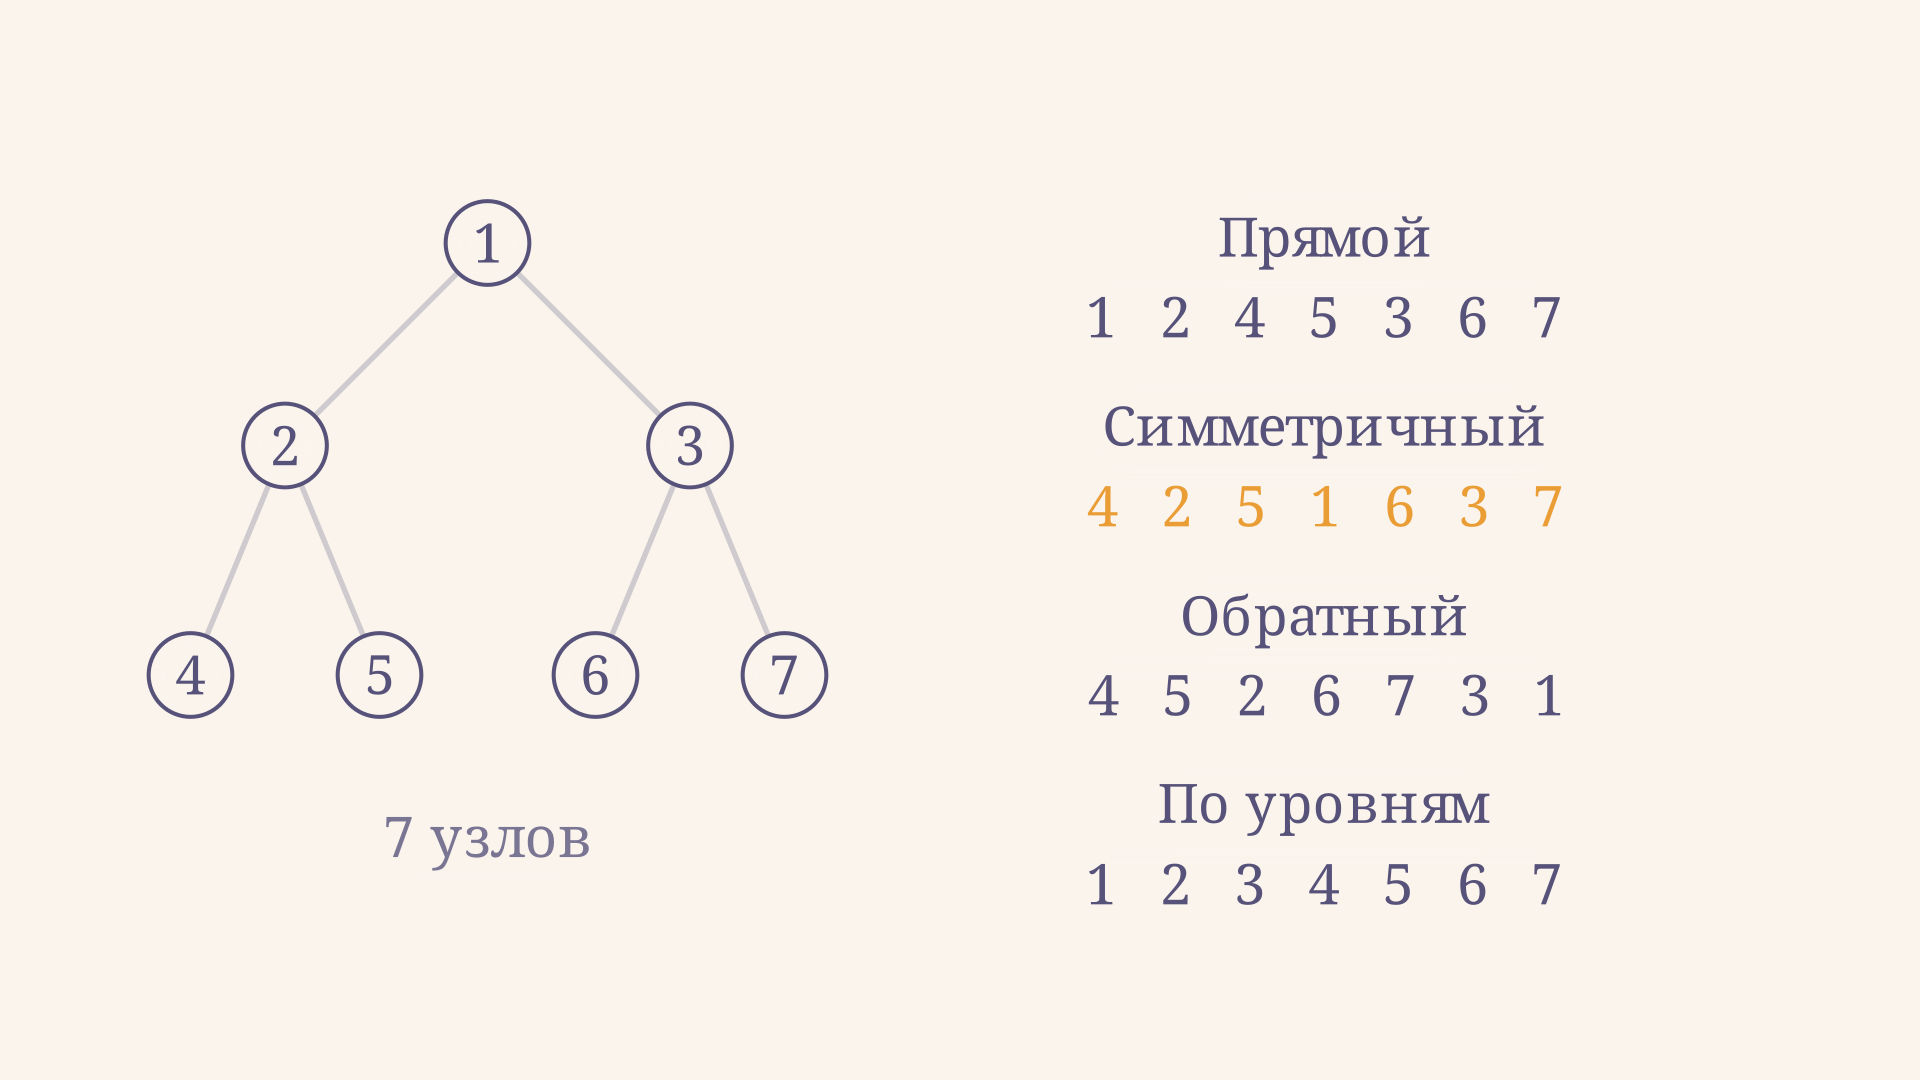
У корня 1 два ребёнка: 2 слева и 3 справа. У узла 2 дети 4 и 5, у узла 3 - 6 и 7. Узлы 4, 5, 6 и 7 - листья. В примере числа служат именами, а не обязательно ключами дерева поиска. Левое и правое поддеревья различаются даже тогда, когда у узла есть только один ребёнок.
Посетить узел - значит выполнить нужное действие: записать значение, вывести его или обработать данные. Мы будем записывать номер ровно один раз. Проход по ребру и возврат из рекурсивного вызова сами по себе не считаются посещением. Термины уровня и глубины полезны для обхода по слоям; их соглашения разобраны в статье о высоте и глубине дерева.
Прямой обход: корень, левое, правое
Прямой обход, или preorder, сначала посещает текущий узел, затем полностью обходит левое поддерево и только потом правое. Это правило применяется снова внутри каждого поддерева, а не только у общего корня.
Для примера получаем 1, 2, 4, 5, 3, 6, 7. Сначала записываем 1, затем переходим к 2 и его листьям 4 и 5. Лишь завершив всю левую часть, посещаем 3, 6 и 7. Анимация показывает именно моменты записи узлов; переход выделения не обозначает обязательный путь по одному ребру.
Такой порядок удобен, когда родитель должен быть обработан раньше детей, например при создании копии дерева сверху вниз. Важно сохранить сведения о пустых дочерних ссылках: одна последовательность значений в общем случае не определяет исходную форму дерева.
Симметричный обход: левое, корень, правое
При симметричном обходе, или inorder, сначала полностью обрабатывается левое поддерево, затем текущий узел и наконец правое. Для нашего дерева результат - 4, 2, 5, 1, 6, 3, 7. Корень 1 оказывается между всеми узлами левого и правого поддеревьев. То же верно для узла 2: сначала 4, затем 2, затем 5.
Симметричный обход выдаёт ключи по возрастанию, если дерево удовлетворяет правилу двоичного дерева поиска: ключи слева меньше ключа узла, справа больше. Для дерева на рисунке значения расположены иначе, поэтому последовательность не отсортирована. Сам обход не сортирует произвольное дерево. О свойстве ключей подробнее в статье про поиск в двоичном дереве поиска.
Обратный обход: левое, правое, корень
Обратный обход, или postorder, посещает узел после обоих поддеревьев. В примере это 4, 5, 2, 6, 7, 3, 1: сначала завершается ветвь 2, затем ветвь 3, а общий корень записывается последним.
Такой порядок подходит для вычислений, где результат родителя зависит от результатов детей. Например, в дереве арифметического выражения сначала вычисляют операнды, а затем применяют операцию в родительском узле. Аналогично при освобождении связанных узлов сначала обрабатывают потомков, пока ссылки на них доступны. «Обратный» здесь не означает простое чтение прямой последовательности справа налево: сравните приведённые семь чисел.
Рекурсивный алгоритм трёх обходов
Рекурсия повторяет структуру определения: пустое поддерево ничего не делает, а непустое обрабатывает два поддерева и свой корень. Меняется только место вызова visit:
def traverse(node, order, visit):
    if node is None:
        return
    if order == "pre":
        visit(node.value)
    traverse(node.left, order, visit)
    if order == "in":
        visit(node.value)
    traverse(node.right, order, visit)
    if order == "post":
        visit(node.value)
Перед вызовом выберите одно из трёх допустимых значений order. Базовый случай проверяет сам текущий узел, поэтому вызов с пустым корнем безопасен. После возврата из левой ветви выполнение продолжается со следующей строки в вызове родителя. Правила этих трёх порядков также приведены в учебных материалах OpenDSA о двоичных деревьях.
На бумаге удобно нарисовать три точки вокруг каждого узла: до левого поддерева, между поддеревьями и после правого. Записывайте значение в выбранной точке одинаково для всех узлов. Это позволяет не перепутать возвращение к родителю с его повторным посещением.
Обход по уровням и очередь
Обход по уровням - level order - идёт сверху вниз, а внутри каждого уровня в нашем соглашении слева направо. Для того же дерева он даёт 1, 2, 3, 4, 5, 6, 7. Здесь используется очередь: первым выходит тот узел, который первым в неё попал.
Начните с очереди [1]. Извлеките 1, посетите его и добавьте 2, затем 3: получится [2, 3]. После извлечения 2 и добавления его детей очередь станет [3, 4, 5]. Узел 3 уже ждал раньше, поэтому обрабатывается до 4 и 5; затем в конец попадают 6 и 7. Продолжайте до пустой очереди, добавляя только существующих детей.
Это частный случай обхода графа в ширину. У обычного дерева каждый узел имеет единственный путь от корня, поэтому отдельное множество посещённых не требуется. Для произвольного графа с циклами оно необходимо, чтобы не возвращаться бесконечно. Обходы preorder и postorder, напротив, связаны с идеей обхода в глубину.
Как пройти дерево без рекурсии
Для прямого обхода можно хранить ожидающие узлы в явном стеке. Положите в него корень, затем повторяйте действия, пока стек не пуст: извлеките верхний узел, посетите его, положите правого ребёнка и после него левого, если они существуют. Поскольку стек отдаёт последний добавленный элемент первым, левый ребёнок будет обработан раньше правого. В нашем примере после посещения 1 стек содержит 3 и 2, причём 2 лежит сверху. После обработки 2 сверху окажется 4, а 5 и 3 будут ждать своей очереди.
Для симметричного обхода приём другой. От текущего узла спускайтесь влево, добавляя каждый встреченный узел в стек. Достигнув пустой ссылки, извлеките вершину стека и посетите её; затем перейдите к её правому ребёнку и повторите спуск. Остановитесь, когда текущая ссылка пуста и стек тоже пуст. Так родитель остаётся в памяти до завершения левой части, но посещается раньше правой.
Обратный порядок требует помнить, завершено ли правое поддерево, либо использовать дополнительный стек. Не стоит просто заменить очередь в алгоритме по уровням на стек и ожидать любой из трёх результатов: порядок помещения детей и момент посещения определяют алгоритм. Для проверки вручную выпишите содержимое структуры после каждого извлечения и отдельно отмечайте уже посещённые узлы.
Сложность и выбор способа
Если дерево содержит узлов и обработка каждого занимает постоянное время, все четыре полных обхода работают за : каждый узел посещается один раз. Если действие в узле дорогое, его стоимость нужно добавить отдельно. Для пустого дерева результат пуст, а для дерева из одного узла все четыре порядка совпадают.
Рекурсивным обходам нужна память стека , где - высота в рёбрах: одновременно активны вызовы вдоль одного пути. Для цепочки эта величина достигает , и ограничение глубины рекурсии языка может стать практической проблемой. Итеративный вариант с явным стеком помогает контролировать память программы, хотя асимптотическая оценка остаётся той же.
Очередь обхода по уровням требует дополнительной памяти, где - максимальная ширина, то есть наибольшее число узлов на одном уровне. В очереди одновременно могут находиться части двух соседних уровней, но их суммарный размер ограничен величиной порядка . Запись готового списка из значений в обоих случаях дополнительно занимает ; при обработке на лету хранить весь вывод не обязательно.
Частые ошибки
- Менять правило внутри поддерева. Если выбран inorder, левую и правую части тоже нужно обходить в этом порядке.
- Считать inorder сортировкой любого дерева. Упорядоченность результата следует из свойства дерева поиска, а не из самого алгоритма.
- Записывать узел при каждом возврате. Проход может несколько раз касаться родителя, но выбранный полный обход посещает его один раз.
- Путать стек и очередь. Стек извлекает последний добавленный элемент; очередь - первый. Поэтому порядок обработки различается.
- Забывать пустых детей. Рекурсивная функция должна завершаться на пустой ссылке, а очередь не должна получать отсутствующие узлы.
FAQ
Можно ли восстановить дерево по одному обходу?
В общем случае нет: разные формы могут дать одну последовательность. Дополнительные данные, например метки пустых детей или подходящая пара обходов с различными значениями, позволяют восстановить структуру при соответствующих условиях.
Чем обход отличается от поиска?
Полный обход перечисляет все узлы. Поиск может остановиться после нахождения нужного значения; в дереве поиска он также может исключать целое поддерево благодаря порядку ключей.
Какой обход выбрать для вычисления выражения?
Обычно обратный: значения дочерних выражений готовы до обработки операции в родителе. Для вывода выражения в привычной записи применяют симметричный порядок с необходимыми скобками.
Коротко
Прямой обход посещает корень до поддеревьев, симметричный - между ними, обратный - после них. Обход по уровням использует очередь и последовательно проходит слои. Выбор зависит от того, какие данные должны быть готовы к моменту обработки узла.
Читайте также
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
Высота и глубина дерева: формулы и примеры
Разбираем высоту и глубину дерева в информатике: точные определения, формулы для полного двоичного и вырожденного дерева, примеры задач и типичные ошибки.
Ханойские башни и рекурсия: решение по шагам
Ханойские башни и рекурсия: разберём правила, семь ходов для трёх дисков, рекурсивный алгоритм, доказательство минимального числа ходов и его сложность.
Односвязный список: операции и их сложность
Односвязный список: как устроены узлы и ссылки, как выполнять поиск, вставку и удаление, сколько переходов они требуют и когда нужен указатель на хвост.
Префиксное дерево: как устроен бор строк
Префиксное дерево хранит общие начала строк вместе. Разбираем построение бора, поиск и удаление слов, сложность операций и применение на наглядном примере.
Сортировка слиянием: как работает merge sort
Сортировка слиянием на примере массива: разбор проходов и числа сравнений, устойчивость, оценка времени и памяти, реализация на Python и области применения.