Префиксное дерево: как устроен бор строк
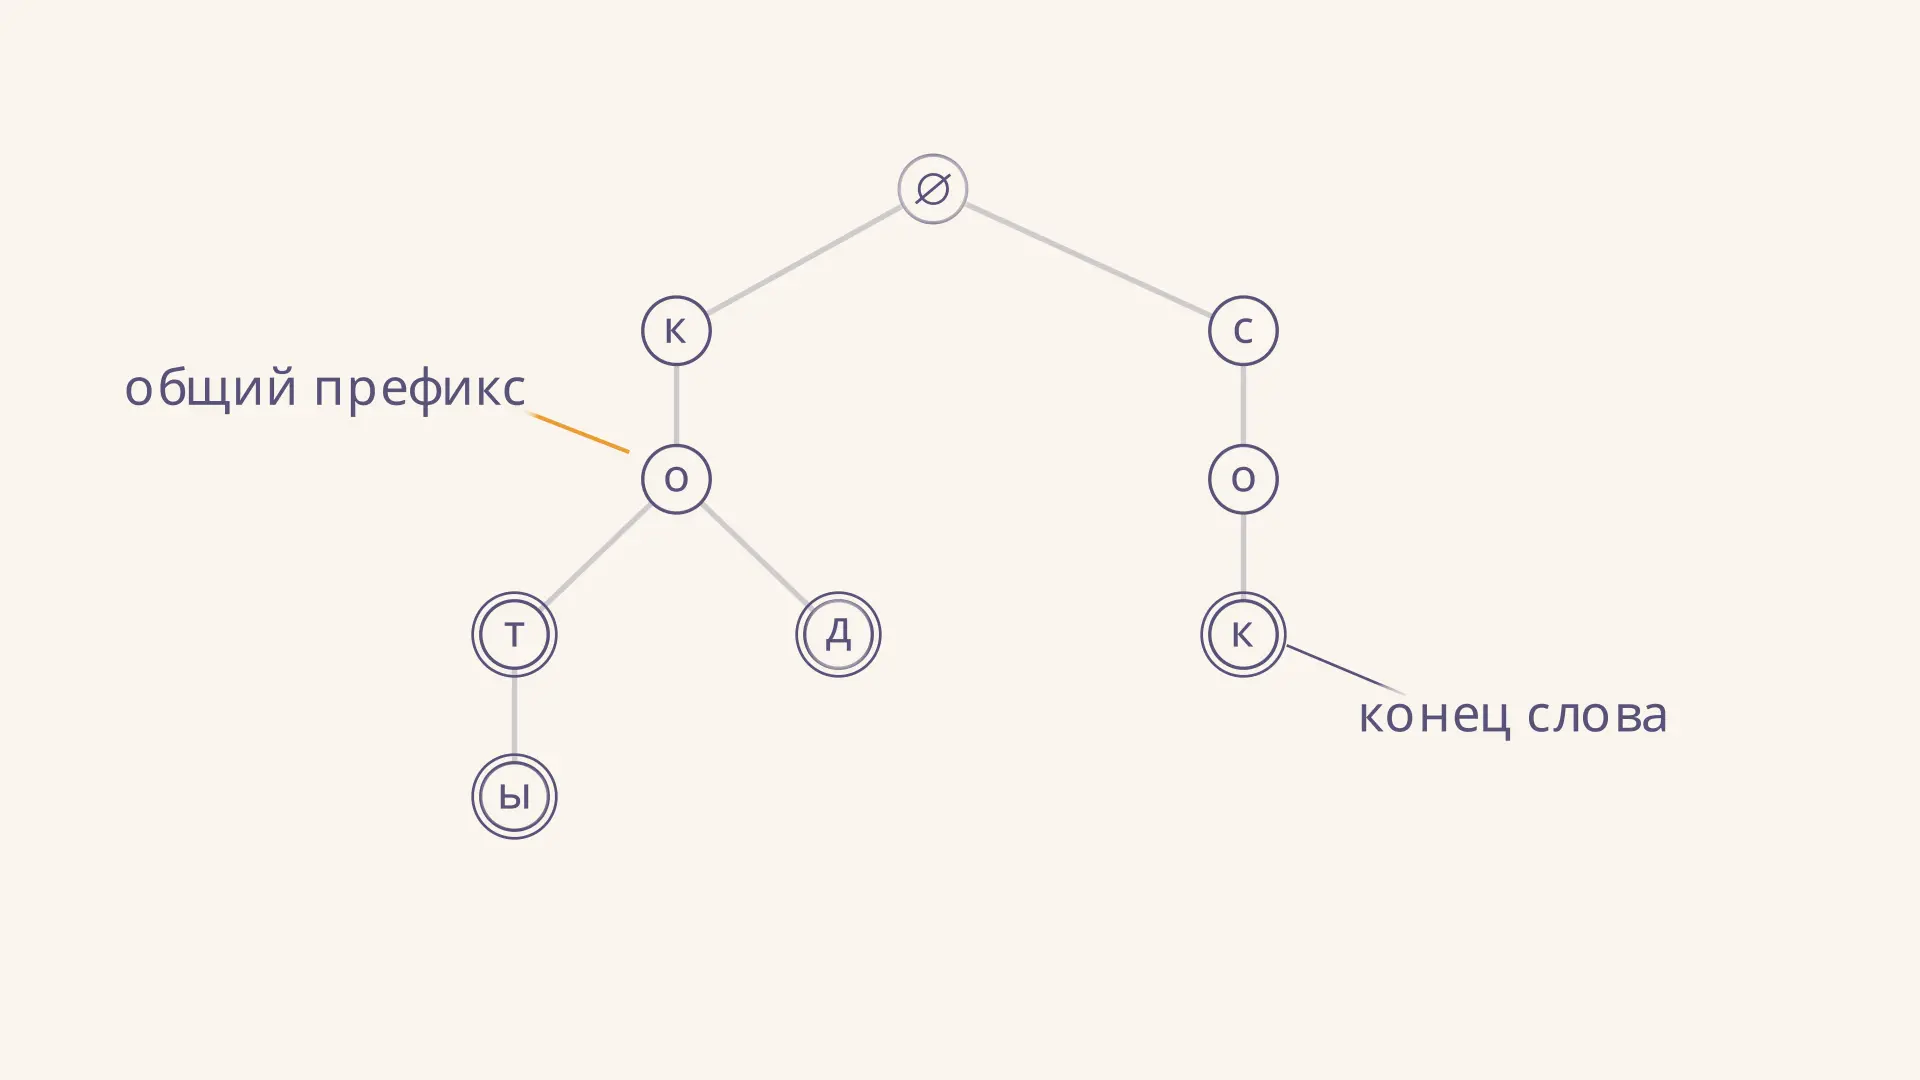
Префиксное дерево, или бор, хранит строки так, чтобы их общие начала не приходилось повторять. Например, слова «кот» и «коты» проходят по одному пути до буквы «т», а затем второе слово продолжается. Такая организация удобна, когда нужно не только проверить слово целиком, но и найти все продолжения введённого начала. Добавляйте слова в интерактиве: он покажет, как число разных префиксов связано с размером дерева.
Что хранится в узлах бора
Начнём с пустого корня. Каждое ребро вниз соответствует одному символу, а путь от корня до узла задаёт префикс. В рисунках букву часто помещают внутрь дочернего узла: она обозначает символ ребра, по которому мы туда пришли. Два слова с одинаковым началом используют один и тот же путь, пока их следующие символы не различаются.
Важна отдельная отметка конца слова: сам факт существования пути ещё не доказывает, что строка добавлена в словарь. В нашем примере «ко» - путь к нескольким словам, но отдельного слова «ко» нет. А «кот» есть, хотя его узел не лист: у него есть продолжение «ы». Отметку можно хранить как логическое поле узла или как значение, связанное с ключом.
Название trie связано с английским словом retrieval. В словаре алгоритмов NIST структура определяется через общие префиксы; конкретное представление концов строк в разных реализациях может отличаться.
Строим дерево на четырёх словах
Добавим по очереди «кот», «коты», «код» и «сок». Для первого слова создаём цепочку к → о → т и отмечаем последний узел. У второго первые три перехода уже существуют, поэтому добавляем только ребро «ы» и отмечаем его конец. У «код» общая часть - «ко»: после неё создаём отдельное ребро «д». Для «сок» от корня нужна новая цепочка с → о → к.
Получается четыре терминальных узла. Двойной круг обозначает именно признак сохранённого слова, а не просто лист: поэтому узел «кот» тоже обведён дважды. Если добавить «ко», достаточно отметить существующий узел - новые рёбра не понадобятся. Повторная вставка уже имеющегося слова также не увеличит число узлов, если структура хранит множество без повторов.
Всего в исходных четырёх словах 13 символов. Различных непустых префиксов восемь: «к», «ко», «кот», «коты», «код», «с», «со», «сок». Каждому соответствует одно ребро и один некорневой узел. Вместе с корнем выходит девять узлов. Это подсчёт для обычного посимвольного бора, а не оценка размера в байтах.
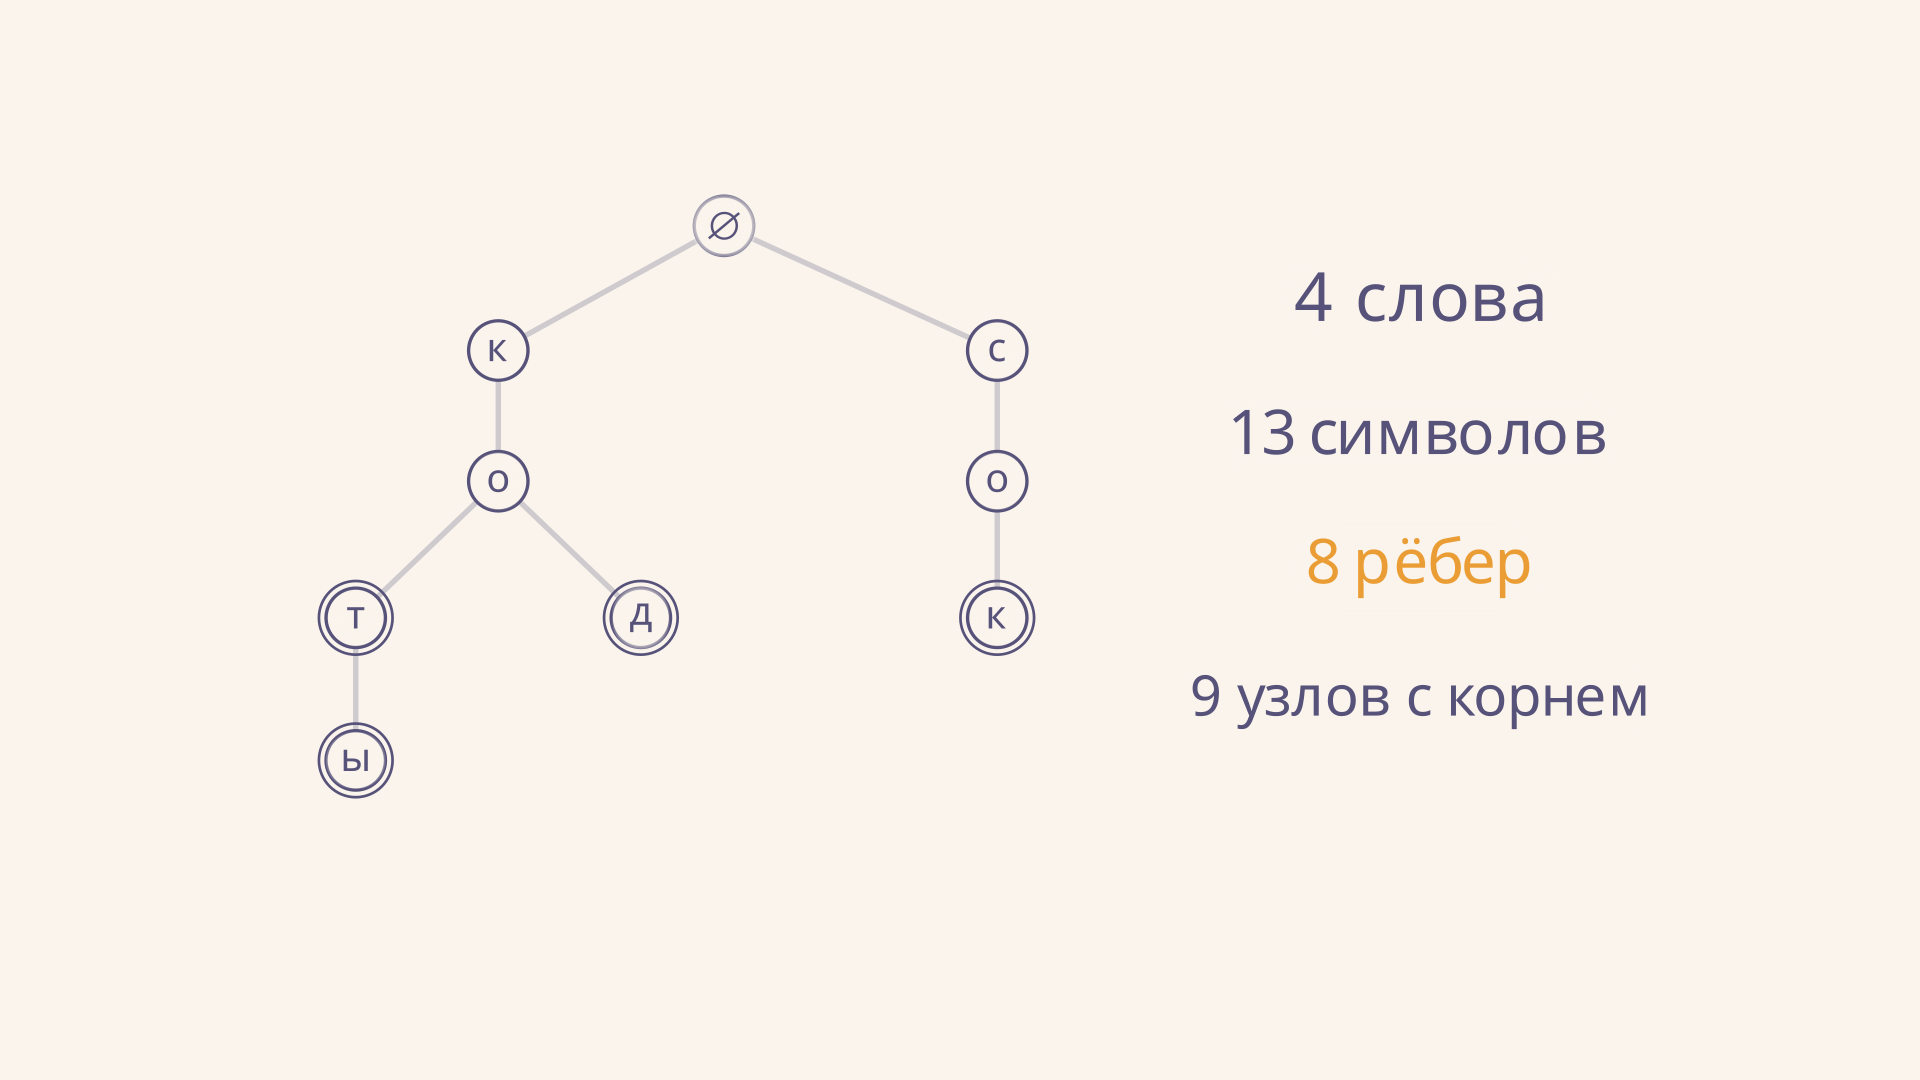
Сравнение 13 и 8 показывает повторное использование префиксов, но не доказывает экономию памяти: узлам нужны ссылки, признаки конца и служебные данные. На маленьких наборах их накладные расходы могут быть больше сэкономленных символов.
Вставка и проверка слова
Для вставки начинаем в корне и читаем символы слева направо. Если переход по очередному символу существует, используем его; иначе создаём узел и ребро. После последнего символа ставим признак конца. Для пустой строки, если её разрешает интерфейс, достаточно отметить сам корень.
Точный поиск похож, но ничего не создаёт. При отсутствии нужного перехода ответ сразу отрицательный. Если все символы пройдены, проверяем признак конца в достигнутом узле. Поиск «кот» успешен, поиск «ко» нет, а поиск «кит» останавливается на отсутствующем переходе после «к».
Псевдокод для двух операций:
вставить(слово):
    узел = корень
    для каждого символа c в слове:
        если перехода c нет: создать его
        узел = узел.дети[c]
    узел.конец = истина

содержит(слово):
    узел = корень
    для каждого символа c в слове:
        если перехода c нет: вернуть ложь
        узел = узел.дети[c]
    вернуть узел.конец
Если к ключу привязано значение, вместо одного флага можно хранить и значение. При этом отсутствие значения и допустимое пустое значение нужно различать явно. Для обычного множества повторная вставка не меняет дерево; для мультимножества потребуется счётчик в терминальном узле.
Поиск всех продолжений
Чтобы найти слова с префиксом «ко», сначала проходим к соответствующему узлу. Затем обходим его поддерево и выдаём каждую строку, у которой обнаружена отметка конца. Ответ в нашем наборе: «кот», «коты» и «код». Если перехода для префикса нет, ответ пуст. Если сам префикс является словом, его тоже нужно включить в результат.
Один проход до узла не выдаёт готовый список: на обход и формирование результата требуется дополнительное время. Оно зависит от посещённого поддерева и объёма выданных строк. Порядок ответа зависит от порядка обхода детей; для лексикографического порядка символы нужно перебирать упорядоченно. Именно такая двухступенчатая схема - поиск узла, затем сбор ключей - показана в материалах Принстонского университета.
Автодополнение использует эту идею, но популярные подсказки могут требовать дополнительных счётчиков или рейтингов. Сам по себе бор не знает, какое слово пользователь предпочитает. Можно ограничить число выдаваемых результатов, однако для выбора лучших всё равно нужна подходящая организация данных о частоте.
Удаление без потери других слов
Удалять ветку целиком сразу опасно: путь может быть общим. Чтобы удалить «кот», сначала находим его и снимаем признак конца. Узел «т» остаётся, потому что через него проходит «коты». После этого точный поиск «кот» вернёт ложь, а «коты» по-прежнему найдётся.
Если удалить «коты» следом, узел «ы» больше не нужен. Поднимаемся обратно и убираем узел, только когда у него нет детей и он не отмечает конец другого слова. На узле «ко» остановимся: от него ещё идёт ветка к слову «код». Такой подход называют очисткой ненужного суффикса пути; можно также оставить неиспользуемые узлы, но тогда память не вернётся сразу.
Сложность и выбор представления
Пусть длина запроса равна , а суммарная длина вставленных строк - . При переходе к ребёнку за постоянное время вставка и точный поиск занимают . Например, массив ссылок по фиксированному алфавиту даёт такую оценку при прямой индексации. Хеш-таблица детей обычно даёт ожидаемое на переход, но не безусловную гарантию; упорядоченная карта может добавить множитель , где - число детей узла.
В обычном боре число узлов не превосходит : каждый новый узел появляется при обработке символа, плюс один корень. Это не всегда означает ячеек памяти для любого представления: массив из ссылок в каждом узле может занимать места. Разреженная карта хранит только существующие переходы, но добавляет накладные расходы и влияет на скорость.
Сжатый бор объединяет цепочки без ветвлений в рёбра с несколькими символами; при поиске эти участки всё равно нужно сравнивать. B-дерево решает другую задачу: организует упорядоченные ключи в узлах, удобных для блочного доступа. AVL-дерево поддерживает баланс для сравнений ключей. Бор же разделяет строки по символам и особенно удобен для запросов по началу строки.
Где бор полезен и чего он не делает
Типичные применения - словари, автодополнение, маршрутизация по битовым префиксам и проверка допустимых продолжений. В задачах поиска нескольких образцов алгоритм Ахо - Корасик расширяет бор дополнительными переходами и позволяет обрабатывать текст; один только бор не даёт всех его свойств.
Для поиска одного образца внутри текста есть другие подходы, например алгоритм Кнута - Морриса - Пратта. Бор по словам индексирует их начала, поэтому поиск произвольной подстроки требует другой организации индекса или дополнительных действий.
Перед построением словаря определите, что считать символом и одинаковыми строками. Байт, кодовая точка Unicode и видимый знак не всегда совпадают; регистр и разные формы записи тоже могут повлиять на результат. Применяйте выбранную нормализацию одинаково при вставке и запросе.
Частые ошибки
- Считать любой пройденный путь словом. Нужна отметка конца.
- Отмечать только листья. Слово может быть началом другого слова.
- Удалять общий путь целиком. Сначала снимите отметку и проверьте наличие детей.
- Приписывать выдаче всех продолжений время : результат и обход поддерева тоже стоят времени.
- Приравнивать число узлов к расходу памяти в байтах. Представление переходов существенно влияет на размер.
FAQ
Бор и префиксное дерево - одно и то же? Да, обычно это два названия структуры trie, хотя конкретные варианты представления узлов и концов слов различаются.
Зависит ли поиск от числа слов? Число переходов ограничено длиной запроса. Стоимость одного перехода зависит от реализации и числа детей, а выдача нескольких результатов требует дополнительной работы.
Можно ли хранить числа? Да. Их можно представить последовательностями цифр или битов; выбор представления определяет, какие префиксы будут общими.
Коротко
Префиксное дерево объединяет общие начала строк в общие пути. Вставка создаёт недостающие переходы и отмечает конец, точный поиск дополнительно проверяет эту отметку, а поиск по префиксу обходит соответствующее поддерево. Размер и скорость на практике зависят от представления детей и характера запросов.
Читайте также
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
Обходы двоичного дерева: порядки и примеры
Обходы двоичного дерева на одном примере: прямой, симметричный, обратный и по уровням. Как работают рекурсия, стек и очередь, какие результаты и сложность.
Односвязный список: операции и их сложность
Односвязный список: как устроены узлы и ссылки, как выполнять поиск, вставку и удаление, сколько переходов они требуют и когда нужен указатель на хвост.
Сортировка слиянием: как работает merge sort
Сортировка слиянием на примере массива: разбор проходов и числа сравнений, устойчивость, оценка времени и памяти, реализация на Python и области применения.
Сортировка связного списка слиянием: алгоритм
Как отсортировать односвязный список слиянием: разделение быстрым и медленным указателями, перестановка ссылок, устойчивость и оценка времени и памяти.
Дерево Фенвика: суммы и обновления по шагам
Дерево Фенвика хранит суммы блоков массива и помогает быстро отвечать на запросы и менять элементы. Разбираем lowbit, пример вычислений, реализацию на Python и сложность операций.