Дерево Фенвика: суммы и обновления по шагам
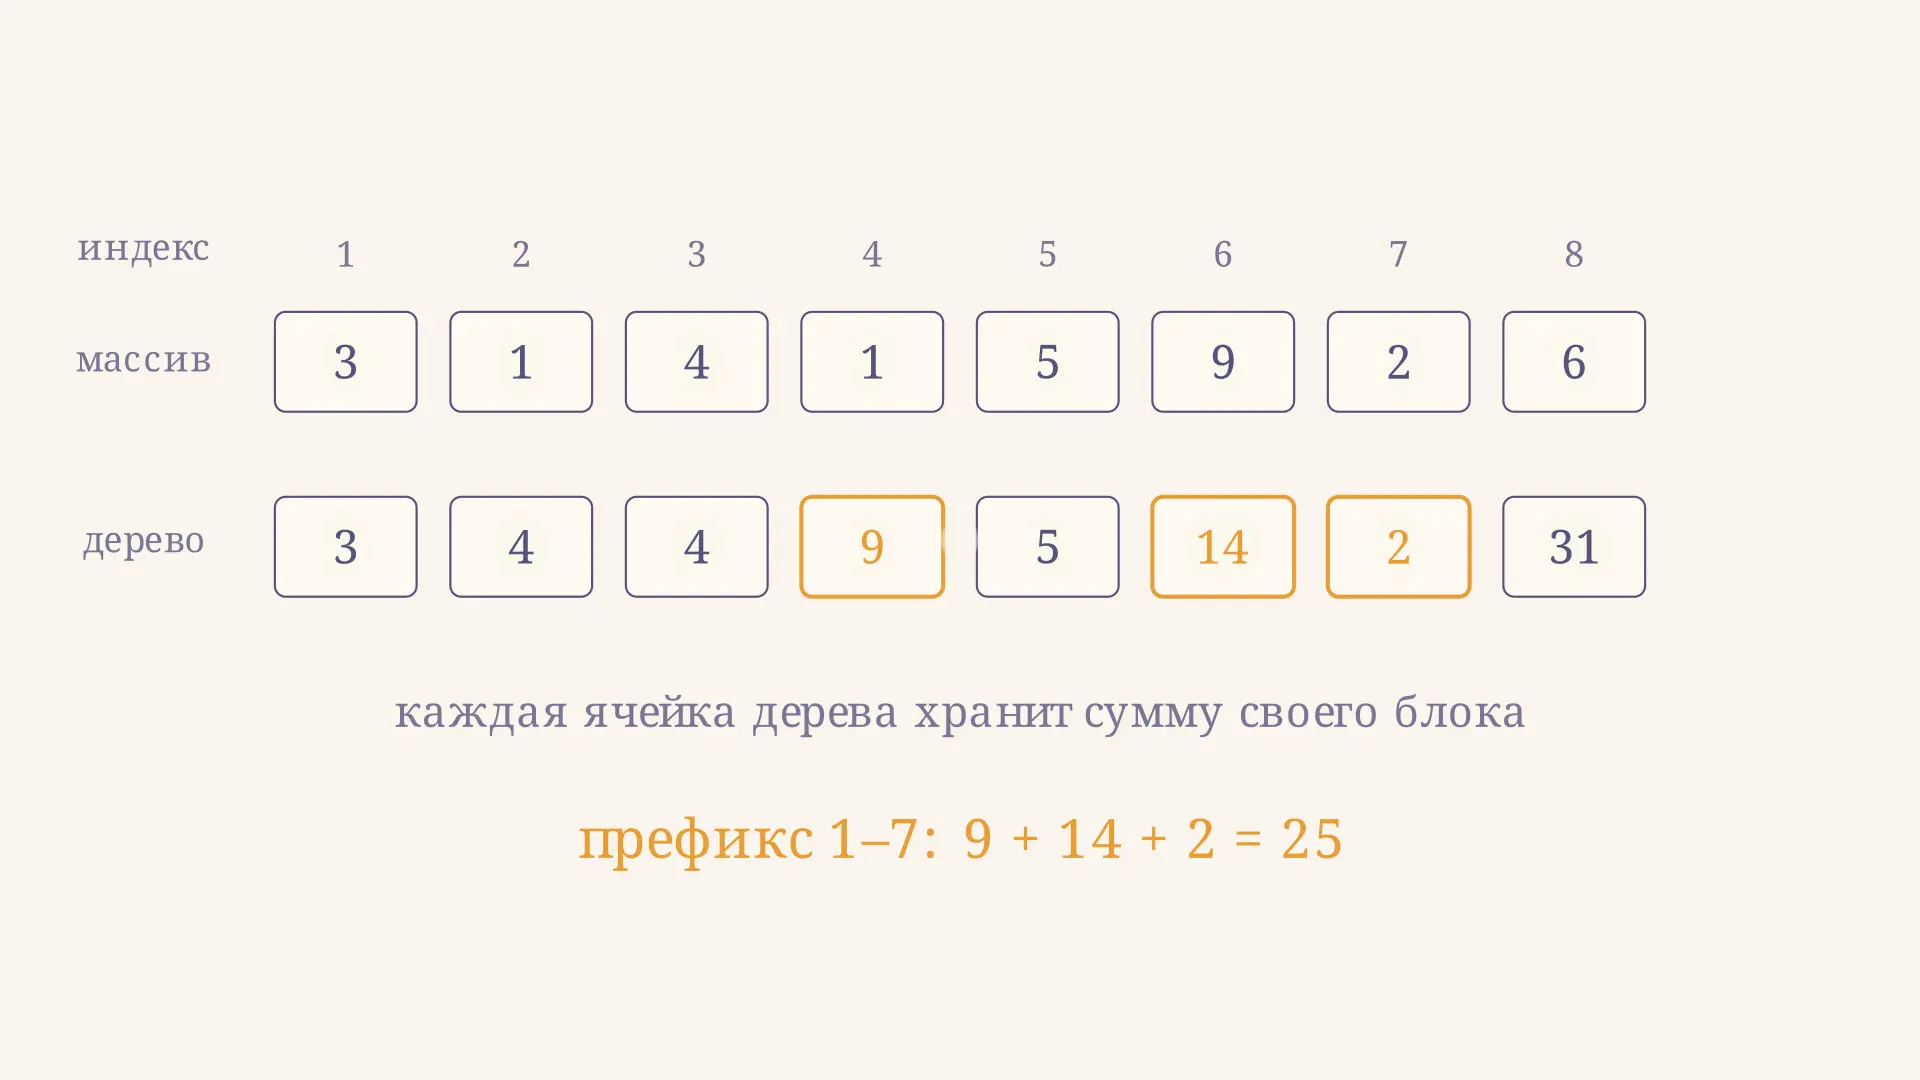
Дерево Фенвика - структура данных, которая позволяет быстро находить суммы префиксов массива и изменять отдельные элементы. Её также называют бинарным индексированным деревом: связи между ячейками задаются битами индексов, а хранится структура в обычном массиве. Например, сумму первых семи элементов можно собрать из трёх заранее подсчитанных блоков. В интерактиве ниже измените конец префикса и третий элемент: столбцы покажут, какие блоки участвуют в ответе.
Зачем нужно дерево Фенвика
Пусть есть массив . Поступают два вида запросов: прибавить число к одному элементу и найти сумму первых элементов. Если каждый раз суммировать элементы заново, запрос занимает до сложений, хотя изменение ячейки выполняется за постоянное время. Можно заранее сохранить все префиксные суммы: тогда ответ получается сразу, но после изменения одного элемента придётся исправить все последующие префиксы.
Дерево Фенвика предлагает компромисс: оба действия занимают в худшем случае, а дополнительная память - . Питер Фенвик описал структуру для накопленных таблиц частот в статье 1994 года. Она полезна, когда данные меняются между запросами: например, при подсчёте частот или обработке последовательности событий.
Название «дерево» отражает связи между индексами. В отличие от дерева бинарного поиска, здесь узлы не сравнивают ключи и не содержат указателей на потомков. Каждая позиция хранит сумму определённого отрезка исходного массива.
Как устроена ячейка
Далее индексы начинаются с единицы. Определим : это значение младшего установленного бита положительного индекса. Например, , поэтому ; у результат равен 4. Операция использует побитовое И в представлении целых чисел с дополнительным кодом.
Ячейка хранит сумму блока длины , заканчивающегося в :
Для массива получаем . Так, , а . Индекс 8 хранит сумму всего массива. Блоки ячеек могут перекрываться, но при конкретном префиксном запросе алгоритм выбирает непересекающиеся блоки.
В двоичной записи младший установленный бит показывает наибольшую степень двойки, на которую делится индекс. У нечётных индексов он равен единице, поэтому их блоки состоят из одного элемента. У индекса 6 длина блока равна двум, а у индекса 8 - восьми. Границу блока можно определить по одному индексу, не храня отдельные пары границ для каждой ячейки. Именно это делает представление компактным.
Как найти сумму префикса
Начинаем с индекса : добавляем к ответу и переходим к . Вычитаем длину только что учтённого блока, поэтому следующий блок заканчивается непосредственно перед ним. Повторяем до нуля. В ролике выделение проходит по ячейкам для префикса из семи элементов, затем возвращается к началу.
Для путь таков: . Сначала берём за позицию 7, затем за позиции 5–6 и за позиции 1–4. Ответ равен . Ноль - граница обхода, а не ячейка с данными.
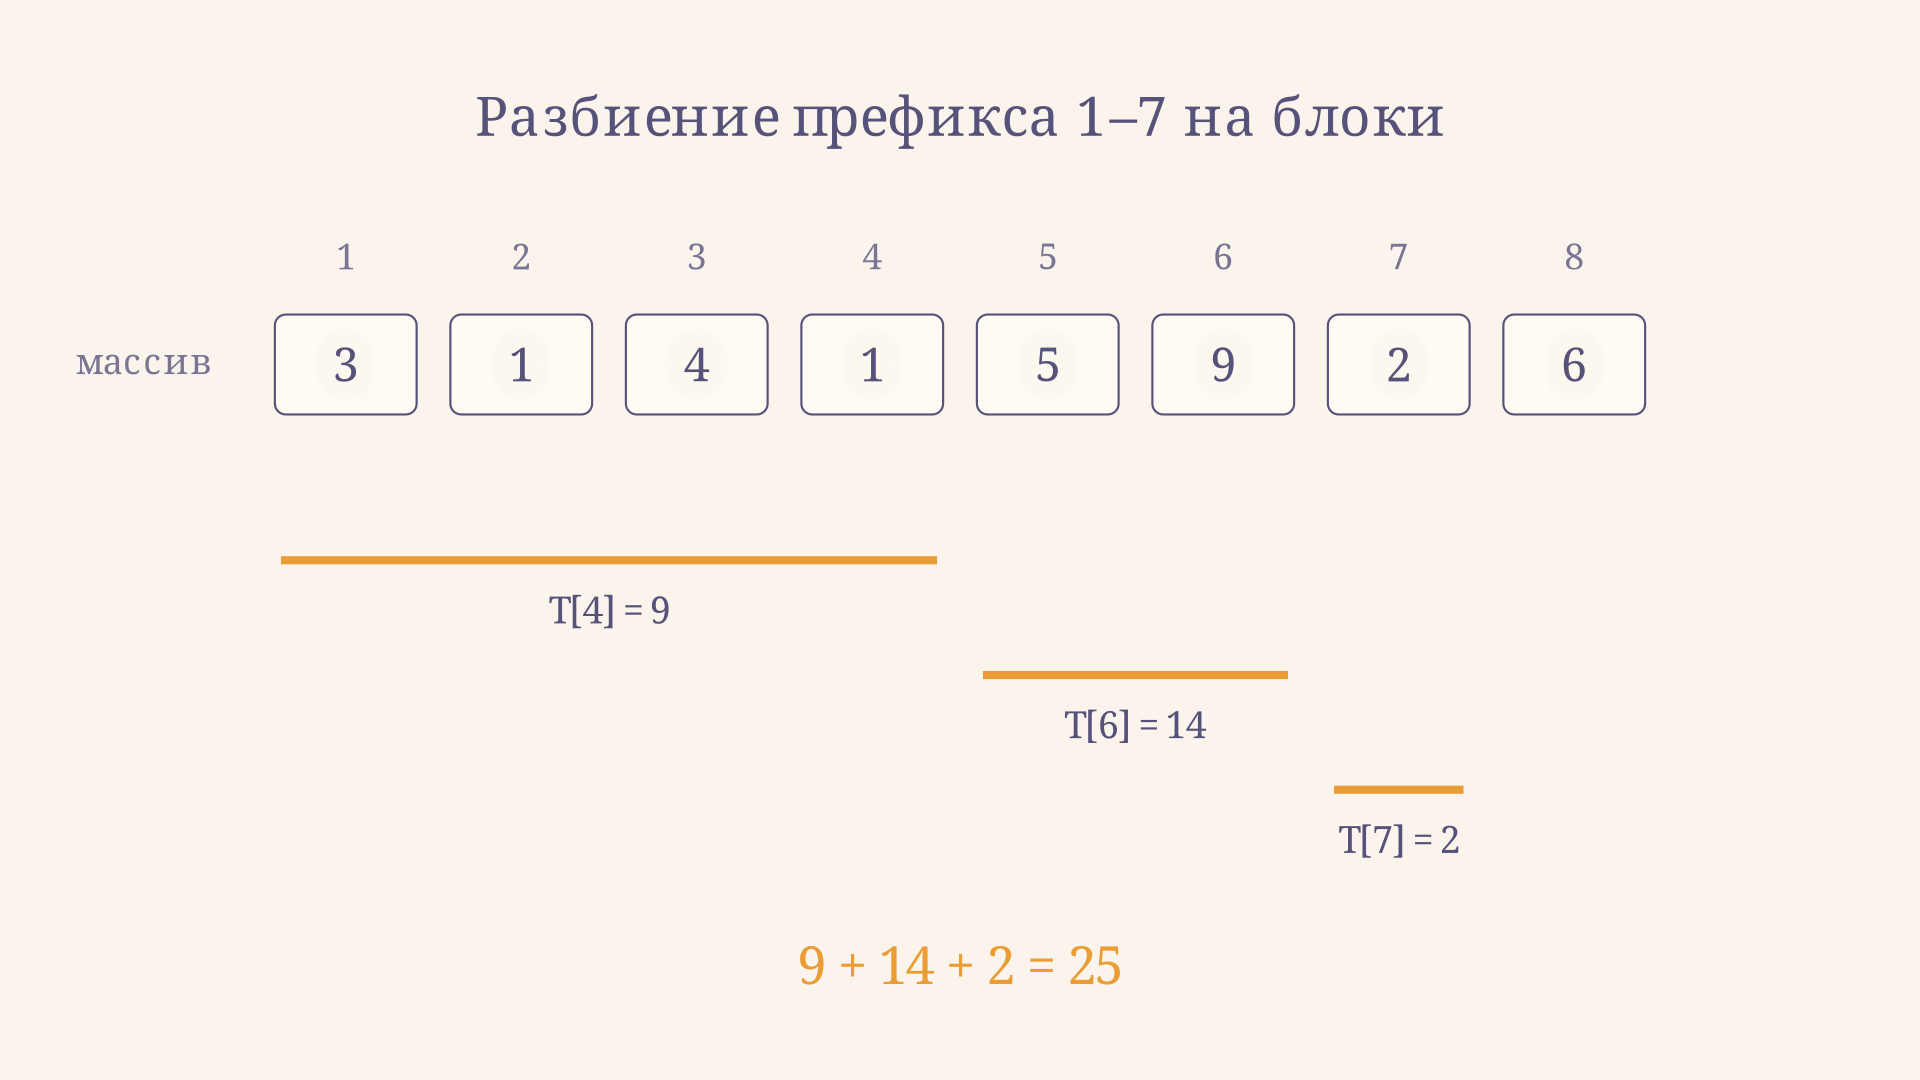
На каждом шаге из индекса удаляется его младший установленный бит. Число шагов равно числу единиц в двоичной записи , поэтому не превышает . Для достаточно одной ячейки, а для нужны три. Эта оценка описывает рост числа действий, а не конкретное время на компьютере.
Обратите внимание на границы блоков: отрезок – заканчивается ровно перед –, а тот - перед позицией . Ни один элемент не пропущен и не посчитан дважды. Такой способ проверки полезен при ручной трассировке: выпишите не только индексы посещённых ячеек, но и диапазоны, которые они представляют. Если диапазоны перекрываются или между ними есть промежуток, ошибка кроется в длине блока или в переходе к следующему индексу.
Сумма произвольного отрезка
Обозначим через сумму первых элементов, а . Тогда сумма включительного отрезка от до равна
В нашем примере , , следовательно, сумма позиций 3–7 равна . Проверка напрямую даёт . На границе второй запрос возвращает ноль. Вычитание требует обратной операции; поэтому такой приём работает для сумм, но не переносится напрямую на минимум: из двух минимумов префиксов нельзя восстановить минимум отрезка.
Как обновить элемент
Пусть к прибавляют . Обновить нужно все сохранённые блоки, содержащие позицию 3. Начинаем с , прибавляем к и переходим к , пока индекс не превысит . Получаем путь . Изменятся , и ; остальные ячейки останутся прежними.
После обновления запрос первых семи элементов вернёт . В интерактиве выберите прибавку 2 и конец префикса 7, чтобы проверить результат. Замена значения на новое отличается от прибавления: сначала найдите разницу между новым и старым значением и передайте эту разницу в обновление. Для этого удобно отдельно хранить исходный массив.
Почему путь обновления отличается от пути запроса? При запросе мы разбираем один префикс на блоки, последовательно отрезая правую часть. При обновлении ищем блоки, в которые входит изменённая позиция: сначала самый короткий блок, затем содержащий его более крупный. Поэтому обходы движутся в противоположных направлениях. Для позиции 3 блоки имеют границы 3–3, 1–4 и 1–8; каждый действительно содержит изменённый элемент. Соседний блок 5–6 его не содержит, так что менять не нужно.
Реализация на Python
Следующий вариант хранит дерево отдельно от массива и принимает только индексы от 1 до . Построение выполняется повторными обновлениями: это проще для понимания и стоит .
class Fenwick:
    def __init__(self, values):
        self.n = len(values)
        self.t = [0] * (self.n + 1)
        for i, value in enumerate(values, 1):
            self.add(i, value)

    def add(self, i, delta):
        if not 1 <= i <= self.n:
            raise IndexError('индекс вне массива')
        while i <= self.n:
            self.t[i] += delta
            i += i & -i

    def prefix(self, i):
        if not 0 <= i <= self.n:
            raise IndexError('индекс вне массива')
        result = 0
        while i > 0:
            result += self.t[i]
            i -= i & -i
        return result

    def range_sum(self, left, right):
        if not 1 <= left <= right <= self.n:
            raise IndexError('неверные границы')
        return self.prefix(right) - self.prefix(left - 1)
Проверка в обновлении существенна: у нуля младший установленный бит равен нулю, и цикл с шагом не завершится. Существуют и варианты с нулевой индексацией, но их формулы переходов другие. Не смешивайте соглашения в одной реализации.
Проверить реализацию удобно на небольших входах: после каждого добавления сравните каждый префикс с прямой суммой соответствующего среза массива. Включите проверку первого и последнего индексов, отрицательной прибавки и отрезка из одного элемента. Это обнаружит ошибки границ, которые на одном удачном запросе могут остаться незаметными.
Для самостоятельной проверки можно также перебрать все пары границ на коротком массиве: вызвать метод суммы отрезка и сравнить его результат с прямым сложением. Затем изменить несколько элементов и повторить сравнение. Если отдельно хранится текущий массив для присваиваний, его нужно обновлять одновременно с деревом, иначе следующая вычисленная разница окажется неверной. На больших числах в языках с фиксированной разрядностью выбирайте тип, вмещающий не только элементы, но и сумму всего массива.
Когда выбирать эту структуру
При неизменном массиве готовые префиксные суммы дают запрос за и часто проще. Если нужны суммы с точечными изменениями, дерево Фенвика компактно и удобно. Дерево отрезков гибче для многих других операций и запросов, но обычно требует больше кода и памяти. Выбор зависит от набора операций, а не от того, какая структура выглядит универсальнее.
Для подсчёта инверсий элементы можно обрабатывать по одному, храня частоты уже увиденных значений; если значения велики, их предварительно сжимают до рангов. Здесь полезно помнить и о быстрой сортировке, которая может помочь упорядочить значения при подготовке рангов. Структура применяется и в задачах с динамическими частотами: префикс тогда означает число наблюдений не выше выбранного ранга. Отрицательные элементы при обычных суммах допустимы, но поиск позиции по заданной накопленной сумме требует дополнительных условий, например неотрицательных частот.
Как и в пирамидальной сортировке, дерево представлено массивом, но смысл индексов различается: в куче они задают отношения родителей и детей, а здесь - границы суммируемых блоков. С AVL-деревом его объединяет логарифмическая оценка операций, хотя AVL хранит упорядоченные ключи и поддерживает балансировку поворотами.
Для учебной задачи сначала зафиксируйте соглашение об индексах, затем постройте таблицу блоков и только после этого выполняйте запрос. Такая последовательность делает ошибку в границах заметной ещё до вычисления ответа.
Частые ошибки
- Путать содержимое с исходным элементом. Например, , хотя : ячейка охватывает две позиции.
- Вычитать при обновлении и прибавлять при запросе. Для префикса идём к меньшему индексу, для изменения - к большему.
- Забывать включительность границ. Из надо вычесть , а не .
- Запускать обновление с нуля. Индекс не изменится, и цикл станет бесконечным.
- Считать, что любая операция заменяет сумму. Для отрезка через два префикса нужна возможность отменить вклад левого префикса.
FAQ
Почему структура называется бинарной? Длина блока и переход к следующей ячейке определяются младшим установленным битом индекса, то есть его двоичной записью.
Можно ли хранить отрицательные числа? Да, сложение и вычитание префиксных сумм продолжают работать. Но накопленные суммы могут перестать быть монотонными, что влияет на поиск по ним.
Можно ли построить дерево быстрее? Да, существует линейное построение за : готовую сумму каждого блока передают следующей содержащей его ячейке. Приведённый код использует более простое построение за .
Коротко
Дерево Фенвика хранит суммы блоков, длина которых определяется младшим установленным битом индекса. Префикс собирается движением влево, изменение элемента распространяется вправо; обе операции занимают , а сумма отрезка находится разностью двух префиксов.
Читайте также
Список смежности: представление графа с примерами
Как построить список смежности графа по рёбрам и восстановить граф по спискам. Разбираем ориентированные и взвешенные графы, сложность операций и отличие от матрицы.
Стек на списке: реализация push и pop через массив
Как реализовать стек на списке: индекс вершины, амортизированная сложность push O(1), расширение массива вдвое при переполнении и почему pop не освобождает память сразу.
Высота и глубина дерева: формулы и примеры
Разбираем высоту и глубину дерева в информатике: точные определения, формулы для полного двоичного и вырожденного дерева, примеры задач и типичные ошибки.
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
Обходы двоичного дерева: порядки и примеры
Обходы двоичного дерева на одном примере: прямой, симметричный, обратный и по уровням. Как работают рекурсия, стек и очередь, какие результаты и сложность.
Односвязный список: операции и их сложность
Односвязный список: как устроены узлы и ссылки, как выполнять поиск, вставку и удаление, сколько переходов они требуют и когда нужен указатель на хвост.