Сортировка слиянием: как работает merge sort
Сортировка слиянием, или merge sort, упорядочивает данные в два приёма: делит последовательность на части, а затем соединяет уже отсортированные части. Секрет в том, что при слиянии достаточно сравнивать только первые оставшиеся элементы двух половин. Алгоритм гарантирует время и при обычной реализации массива использует дополнительный буфер размера . В калькуляторе можно изменить длину примера и проследить, сколько сравнений приходится на каждый проход.
Как работает слияние двух половин
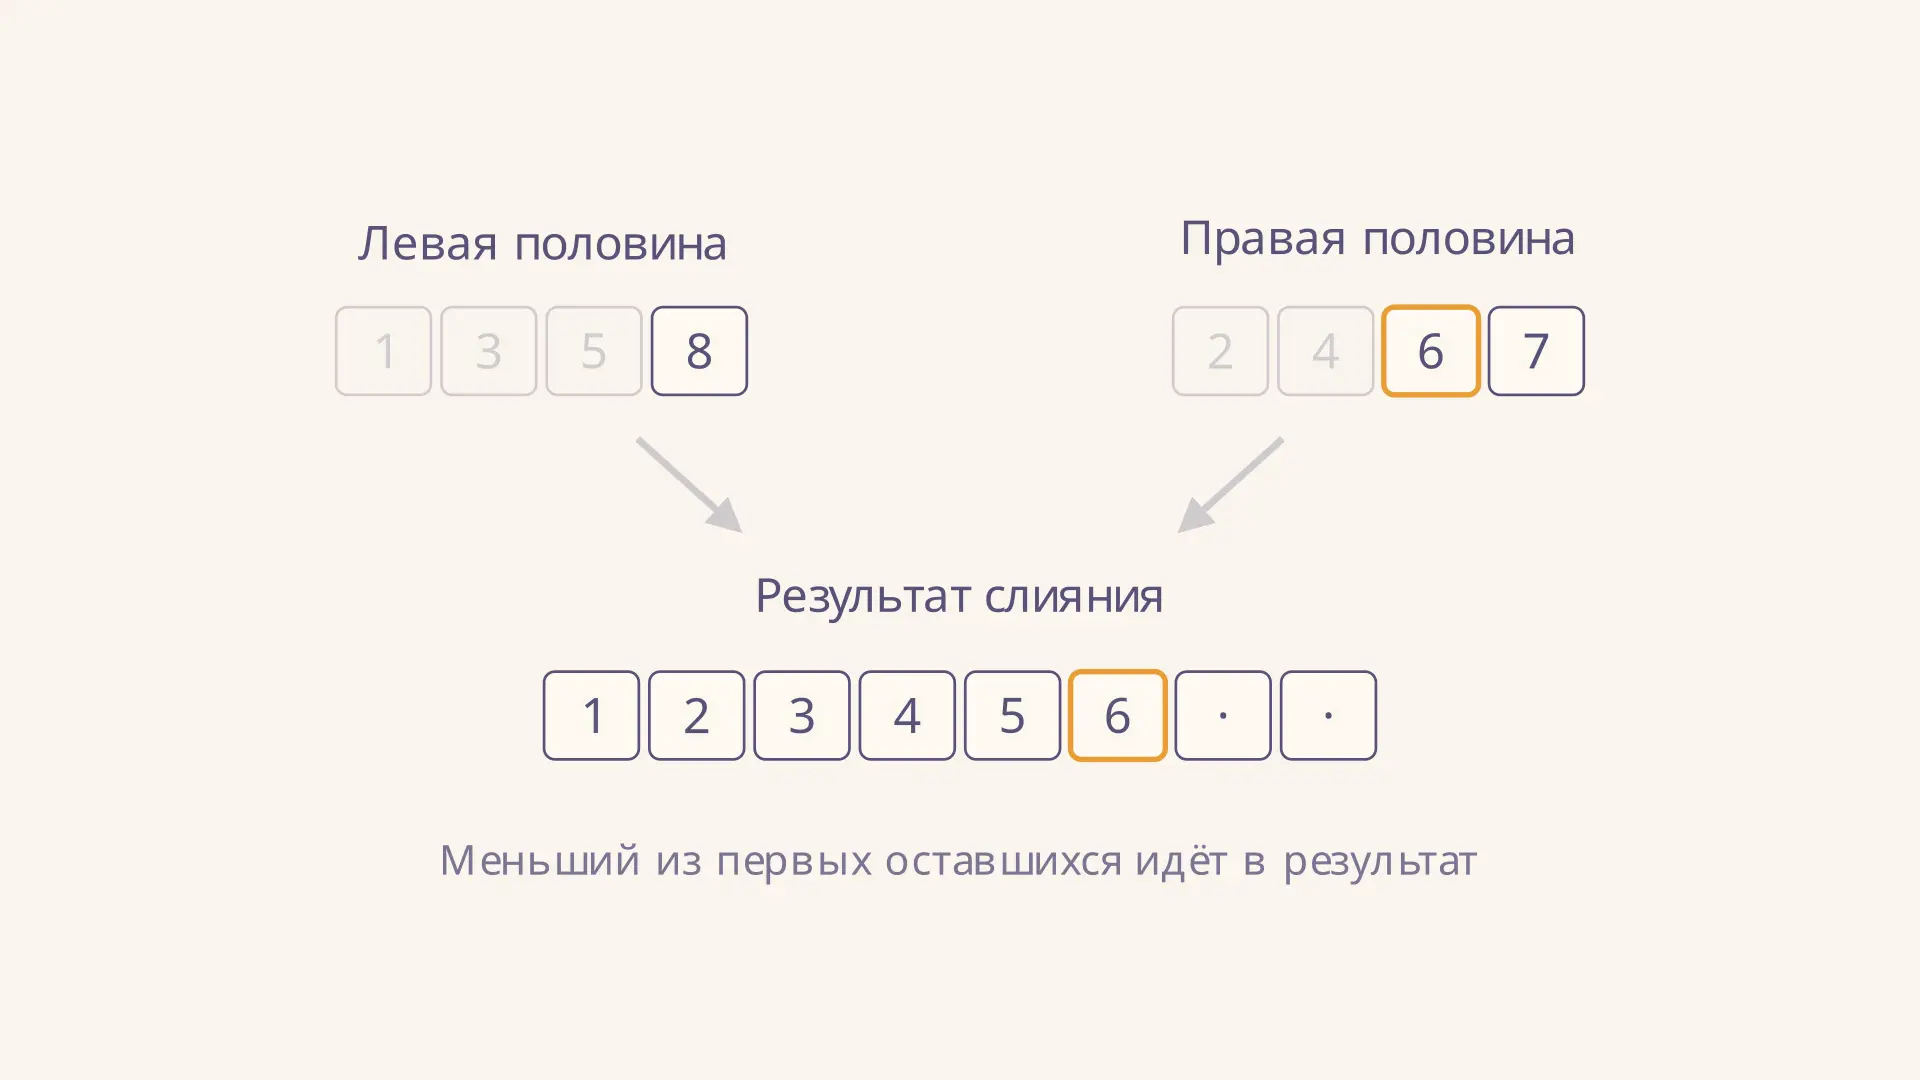
Предположим, что отдельно уже отсортированы последовательности и . Сравним первые элементы: , поэтому в результат идёт единица. Теперь сравниваем и , забираем двойку, затем сравниваем и . Каждый раз указатель продвигается только в той половине, откуда взяли элемент.
Когда одна половина закончилась, оставшийся хвост другой уже отсортирован и больше не нуждается в сравнениях ключей. В нашем примере финальное слияние даёт за семь сравнений. Общее правило: слияние непустых последовательностей длины и требует не более сравнений, хотя может закончиться и раньше. Запись результата всё равно занимает линейное время по числу элементов.
Почему достаточно смотреть только на первые оставшиеся значения? Всё, что стоит дальше в каждой половине, не меньше её первого элемента. Меньший из двух кандидатов потому не больше любого другого оставшегося числа. После его добавления то же рассуждение работает снова: это инвариант слияния.
Разделение и обратная сборка на примере
Начнём с массива . Если делить его пополам до отдельных элементов, каждый фрагмент длины один уже отсортирован. Теперь соседние фрагменты можно сливать, постепенно увеличивая размер упорядоченных блоков. Снизу вверх получаются такие проходы:
- Пары: , , , . Каждая пара требует одного сравнения, всего четыре.
- Четвёрки: и . На два слияния уходит по три сравнения, всего шесть.
- Восемь элементов: обе четвёрки сливаются в итоговый массив за семь сравнений.
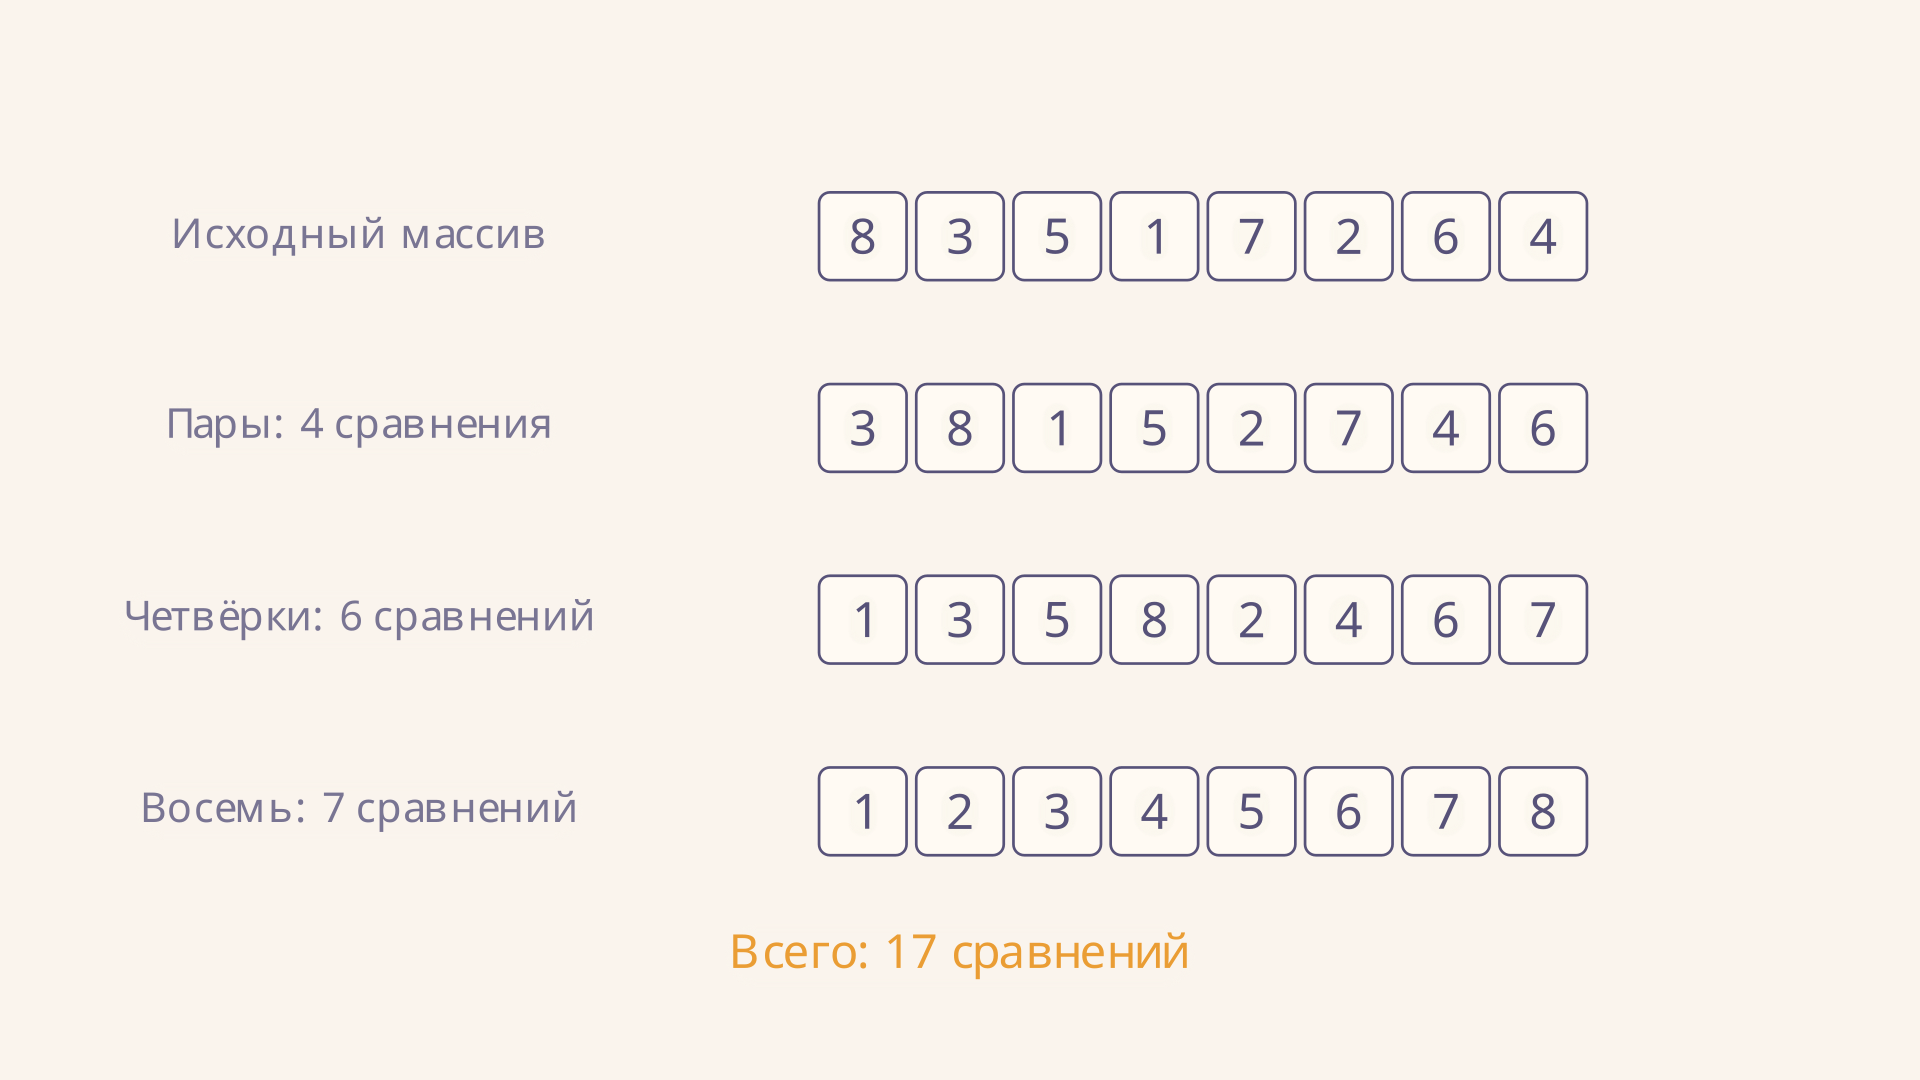
Итого для этих данных и именно такого способа слияния: сравнений ключей. Это не универсальное число для любого массива из восьми элементов: если одна половина исчерпается раньше, сравнений будет меньше. Калькулятор считает их отдельно от копирования оставшихся элементов и показывает те же 17 при восьми элементах. Для нечётной длины непарный блок переносится на следующий проход без слияния.
Реализация на Python
Следующий вариант делит массив рекурсивно. Он возвращает новый список и при равенстве берёт элемент из левой половины. Срезы и новые списки делают код понятным, хотя на практике буфер часто выделяют один раз и переиспользуют.
def merge_sort(a):
    if len(a) <= 1:
        return a[:]
    mid = len(a) // 2
    left = merge_sort(a[:mid])
    right = merge_sort(a[mid:])
    result = []
    i = j = 0
    while i < len(left) and j < len(right):
        if left[i] <= right[j]:
            result.append(left[i])
            i += 1
        else:
            result.append(right[j])
            j += 1
    result.extend(left[i:])
    result.extend(right[j:])
    return result
База рекурсии важна: пустой массив и массив из одного элемента уже упорядочены. После каждого вызова обе половины отсортированы, поэтому описанный выше инвариант гарантирует правильность их слияния. По той же причине после верхнего вызова упорядочен весь массив. Если элементы - записи, вместо сравнения самих объектов нужно сравнивать выбранные ключи.
Есть и нерекурсивный вариант: сначала сливать соседние блоки длины один, потом длины два, четыре и так далее. Именно его проходы показывает калькулятор. Он удобен, когда нужно явно управлять обходом и не использовать стек рекурсивных вызовов. При неравных размерах последних блоков второй блок может быть короче или вовсе отсутствовать.
Откуда берётся O(n log n)
Для деление даёт уровней слияния. На каждом уровне все фрагменты вместе содержат элементов, и их слияние занимает времени. Поэтому общая работа составляет . То же следует из рекуррентного соотношения при .
Если не степень двойки, размеры половин отличаются не более чем на единицу, а число уровней ограничено . Оценка порядка роста сохраняется. В стандартной реализации, которая выполняет слияния на каждом уровне, время также ограничено снизу величиной порядка : каждый уровень обрабатывает все элементы. Здесь предполагается, что сравнение и перемещение одного элемента имеют постоянную стоимость. Для длинных строк или тяжёлых записей стоимость отдельной операции тоже надо учитывать.
Для степени двойки можно уточнить именно верхнюю границу сравнений в этой простой схеме. На проходе с блоками длины каждое слияние использует не более сравнений, а таких слияний . Значит, на проход приходится не более сравнений. Суммирование по всем проходам даёт . При эта граница равна : выбранный пример как раз достигает её. Граница не означает, что столько сравнений обязательно потребуется каждому входу. Она также не включает проверки индексов, выделение памяти и копирование: это отдельные операции.
Например, если обе половины уже разделены по значениям, как и , итоговому слиянию достаточно четырёх сравнений. Оставшуюся правую половину затем копируют целиком. Поэтому число сравнений показывает конкретную трассу, а асимптотическая оценка описывает рост затрат при увеличении размера входа. Разницу особенно полезно помнить, когда экспериментируют с маленькими массивами: на них постоянные расходы могут перевесить различие оценок.
Гарантия относится и к худшему расположению входных данных: разбиение примерно пополам не зависит от выбранного опорного элемента. Для контраста, в худшем случае быстрой сортировки неудачные разбиения могут дать квадратичную работу. Это не означает, что merge sort всегда быстрее: на реальное время влияют копирование, доступ к памяти и конкретная реализация.
Память и устойчивость
Обычный merge sort для массива использует вспомогательный буфер на элементов, то есть дополнительной памяти; рекурсивный стек занимает . Не нужно суммировать объёмы всех слияний за всё время как одновременно занятую память: один буфер можно использовать повторно. В приведённом коде создаются срезы и новые списки, но при последовательном выполнении рекурсии пиковая дополнительная память тоже имеет порядок . Существуют специальные варианты с меньшей памятью, однако их устройство сложнее.
Устойчивость означает сохранение исходного порядка записей с равными ключами. Пусть записи с одинаковой оценкой идут как и , причём был раньше. Если они оказались в разных половинах, правило «при равенстве взять слева» сначала выдаст . При условии, что обе половины уже устойчиво отсортированы, это сохраняет порядок равных записей и во всём результате. Если при равенстве брать справа, такая гарантия пропадает.
Для сравнения, пирамидальная сортировка тоже гарантирует в худшем случае, но стандартная версия сортирует массив на месте и не является устойчивой. Выбор зависит от того, важнее ли сохранить порядок равных ключей или ограничить дополнительную память.
Когда подходит сортировка слиянием
Метод удобен, когда важны предсказуемое время и устойчивость: например, при последовательной сортировке таблицы по нескольким полям. Устойчивый второй проход сохраняет прежний порядок внутри групп равных новых ключей. Для корректного результата нужен согласованный порядок сравнения ключей.
Слияние полезно и при обработке файлов, не помещающихся целиком в оперативную память: сначала создают отсортированные серии, затем последовательно объединяют их, используя небольшие буферы ввода и вывода. Здесь стоимость обращений к диску имеет отдельное значение. Слияние естественно и для односвязных списков: элементы можно соединять изменением ссылок, не создавая массивный буфер. Для последовательного списка рекурсивный стек при этом всё ещё требует памяти, а детали зависят от реализации. Само слово «слияние» встречается и в других структурах: биномиальная куча объединяет не отсортированные последовательности, а леса деревьев по другим правилам.
Частые ошибки
- Сливать неотсортированные половины. Сравнение только их первых элементов правильно лишь после сортировки каждой половины.
- Считать копирование хвоста сравнениями. После исчерпания одной стороны оставшиеся ключи уже не сравниваются друг с другом, хотя их надо записать.
- Объявлять любой вариант устойчивым. При равных ключах стандартное устойчивое слияние выбирает левую запись; правило сравнения имеет значение.
- Путать суммарный объём копирования с пиковой памятью. Данные проходят через уровни многократно, но рабочий буфер можно переиспользовать.
FAQ
Сколько сравнений нужно для восьми элементов?
В приведённом примере - 17. Число зависит от входного порядка и реализации: отдельное слияние останавливает сравнения, как только одна сторона опустела.
Можно ли выполнить сортировку слиянием без рекурсии?
Да. Итеративная версия сливает соседние блоки длины один, два, четыре и так далее, пока не останется один отсортированный блок.
Всегда ли нужен буфер размера массива?
Для обычной реализации слияния массивов - да, это стандартная плата за простой линейный проход и устойчивость. Для списков и специальных алгоритмов существуют другие варианты с иной организацией памяти.
Коротко
Сортировка слиянием строит большие отсортированные фрагменты из маленьких. Каждый проход обрабатывает все элементы, а число проходов логарифмически растёт с длиной входа. Стандартный алгоритм устойчив при выборе левого элемента в случае равенства, работает за и использует дополнительной памяти для массива.
Читайте также
Односвязный список: операции и их сложность
Односвязный список: как устроены узлы и ссылки, как выполнять поиск, вставку и удаление, сколько переходов они требуют и когда нужен указатель на хвост.
Сортировка слиянием: сложность по времени и памяти
Разбираем сложность сортировки слиянием: вывод O(n log n), число сравнений на примере, расход дополнительной памяти и условия устойчивости алгоритма при равных ключах.
Сортировка связного списка слиянием: алгоритм
Как отсортировать односвязный список слиянием: разделение быстрым и медленным указателями, перестановка ссылок, устойчивость и оценка времени и памяти.
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
Обходы двоичного дерева: порядки и примеры
Обходы двоичного дерева на одном примере: прямой, симметричный, обратный и по уровням. Как работают рекурсия, стек и очередь, какие результаты и сложность.
Префиксное дерево: как устроен бор строк
Префиксное дерево хранит общие начала строк вместе. Разбираем построение бора, поиск и удаление слов, сложность операций и применение на наглядном примере.