Скрытая марковская модель: устройство и три задачи
Скрытая марковская модель (HMM, hidden Markov model) описывает ситуацию, знакомую любому исследователю: интересующий нас процесс напрямую не виден, а видны лишь его следы. Погода за окном чужого города скрыта, но известно, чем человек занимался; фонема скрыта, а измерен спектр звука; состояние рынка скрыто, а наблюдается доходность. Модель предполагает, что скрытый процесс марковский (следующее состояние зависит только от текущего), а каждое состояние с известными вероятностями порождает наблюдение. Ниже разберём параметры модели, три классические задачи и оба ключевых алгоритма на сквозном числовом примере. Калькулятор под этим абзацем считает тот же пример: подвигайте вероятности и посмотрите, как меняются правдоподобие и восстановленная цепочка состояний.
Что скрыто и что наблюдается
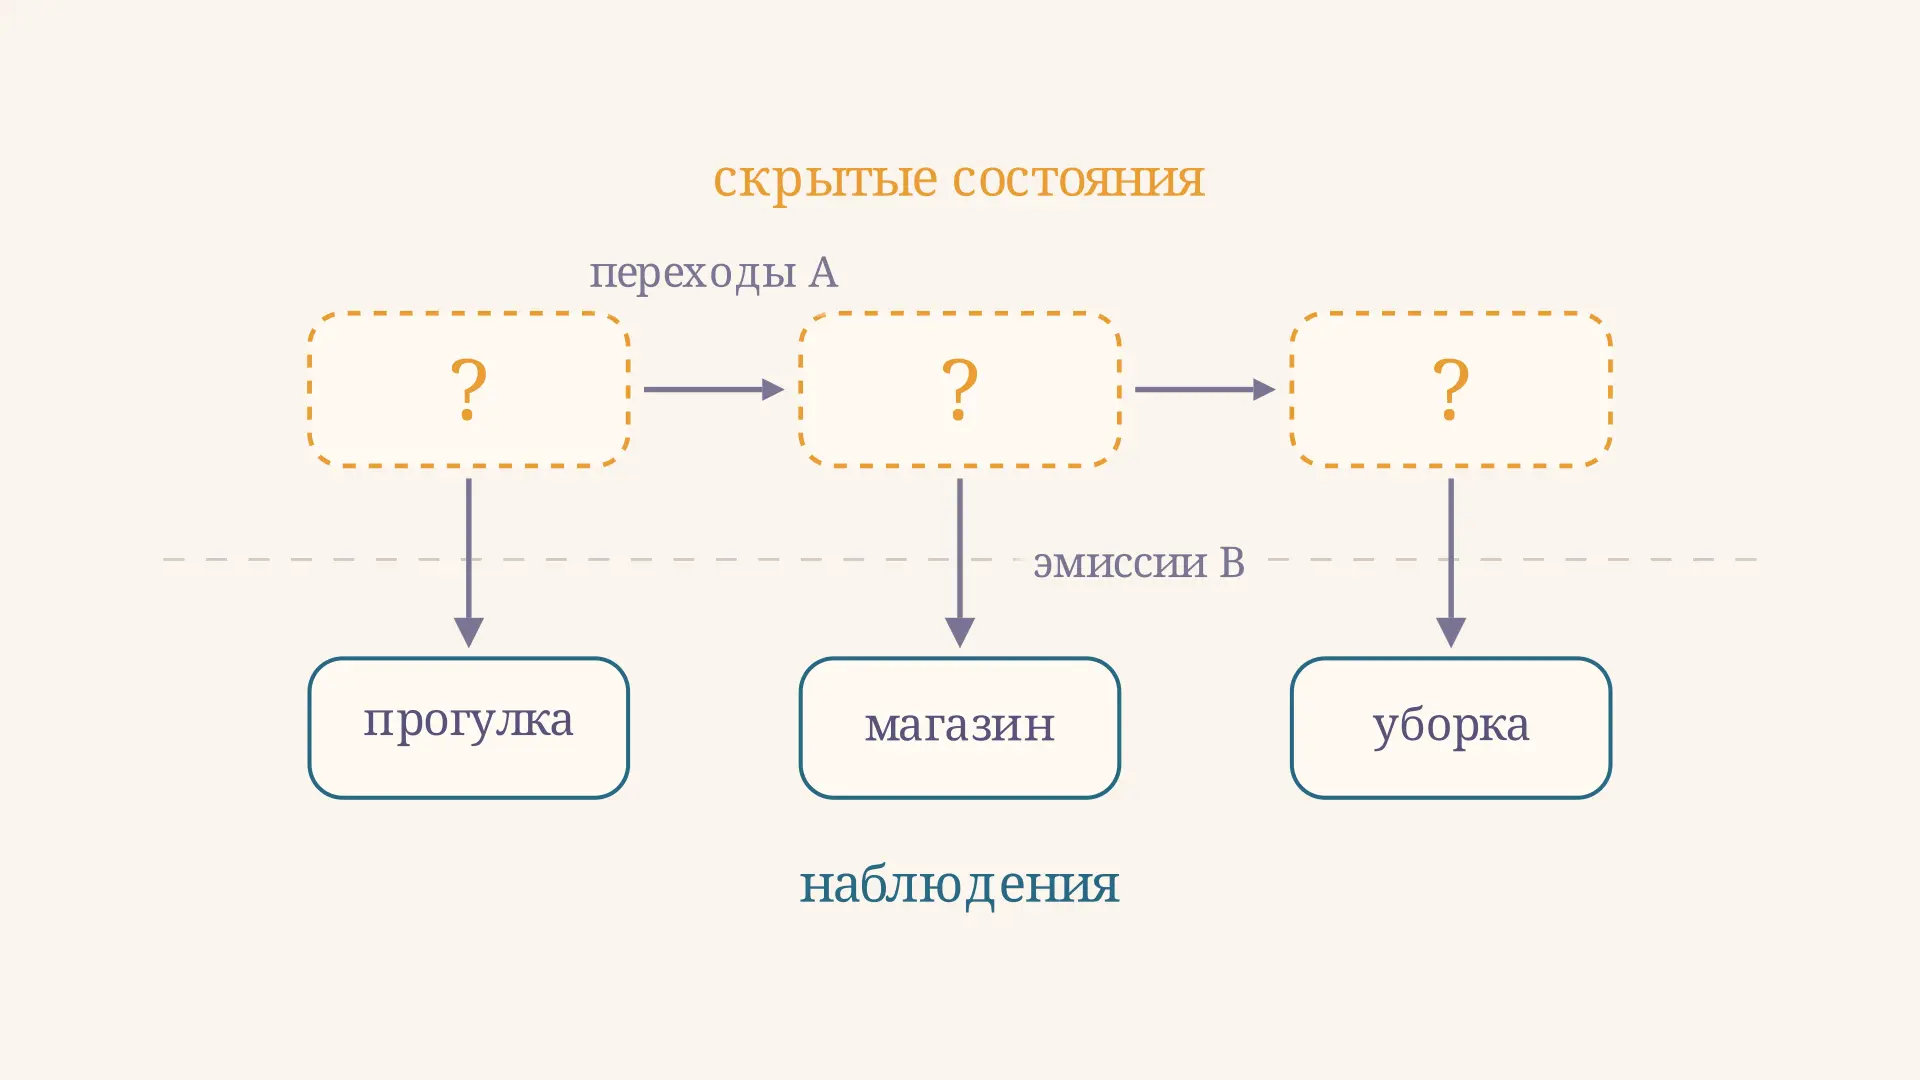
В обычной цепи Маркова состояния видны напрямую. В скрытой марковской модели появляется второй слой: последовательность состояний существует, но недоступна наблюдателю, и вместо неё фиксируется последовательность наблюдений . Связь между слоями вероятностная: находясь в состоянии , модель выдаёт символ с вероятностью .
Отсюда два независимых предположения, на которых держится вся конструкция:
Первое - марковское свойство скрытого слоя, второе - условная независимость наблюдения от всего, кроме текущего состояния. В сквозном примере скрытые состояния это «Солнечно» и «Дождливо», а наблюдения - занятия человека: прогулка, магазин, уборка.
Параметры модели: начальное распределение, A и B
Модель полностью задаётся тройкой :
- - начальное распределение по состояниям;
- - матрица переходов между скрытыми состояниями;
- - матрица эмиссий (наблюдений).
Строки всех трёх объектов нормированы: сумма по в каждой строке равна единице, сумма по в каждой строке - тоже. Наш пример:
| Состояние | в Солнечно | в Дождливо | прогулка | магазин | уборка | |
|---|---|---|---|---|---|---|
| Солнечно | 0,6 | 0,4 | 0,6 | 0,3 | 0,1 | 0,4 |
| Дождливо | 0,3 | 0,7 | 0,1 | 0,4 | 0,5 | 0,6 |
Читается так: солнечный день с вероятностью 0,6 сменится солнечным, а человек в солнечный день с вероятностью 0,6 пойдёт гулять и лишь с вероятностью 0,1 возьмётся за уборку. Если добавить к этому набору действия агента и награды, получится марковский процесс принятия решений - другая надстройка над той же цепью Маркова, где состояния как раз наблюдаемы, а неизвестна оптимальная политика.
Полезно сразу оценить, сколько в модели свободных параметров: при состояниях и символах наблюдений их в матрице переходов, в матрице эмиссий и в начальном распределении, потому что каждая строка теряет одну степень свободы из-за нормировки. Для нашей модели это 2, 4 и 1, итого семь чисел. Чем длиннее наблюдаемая последовательность по сравнению с этим количеством, тем устойчивее будет оценка параметров.
Три задачи, которые решают для HMM
Практически всё, что делают со скрытой марковской моделью, сводится к трём задачам Рабинера. Они отличаются тем, что дано и что ищется.
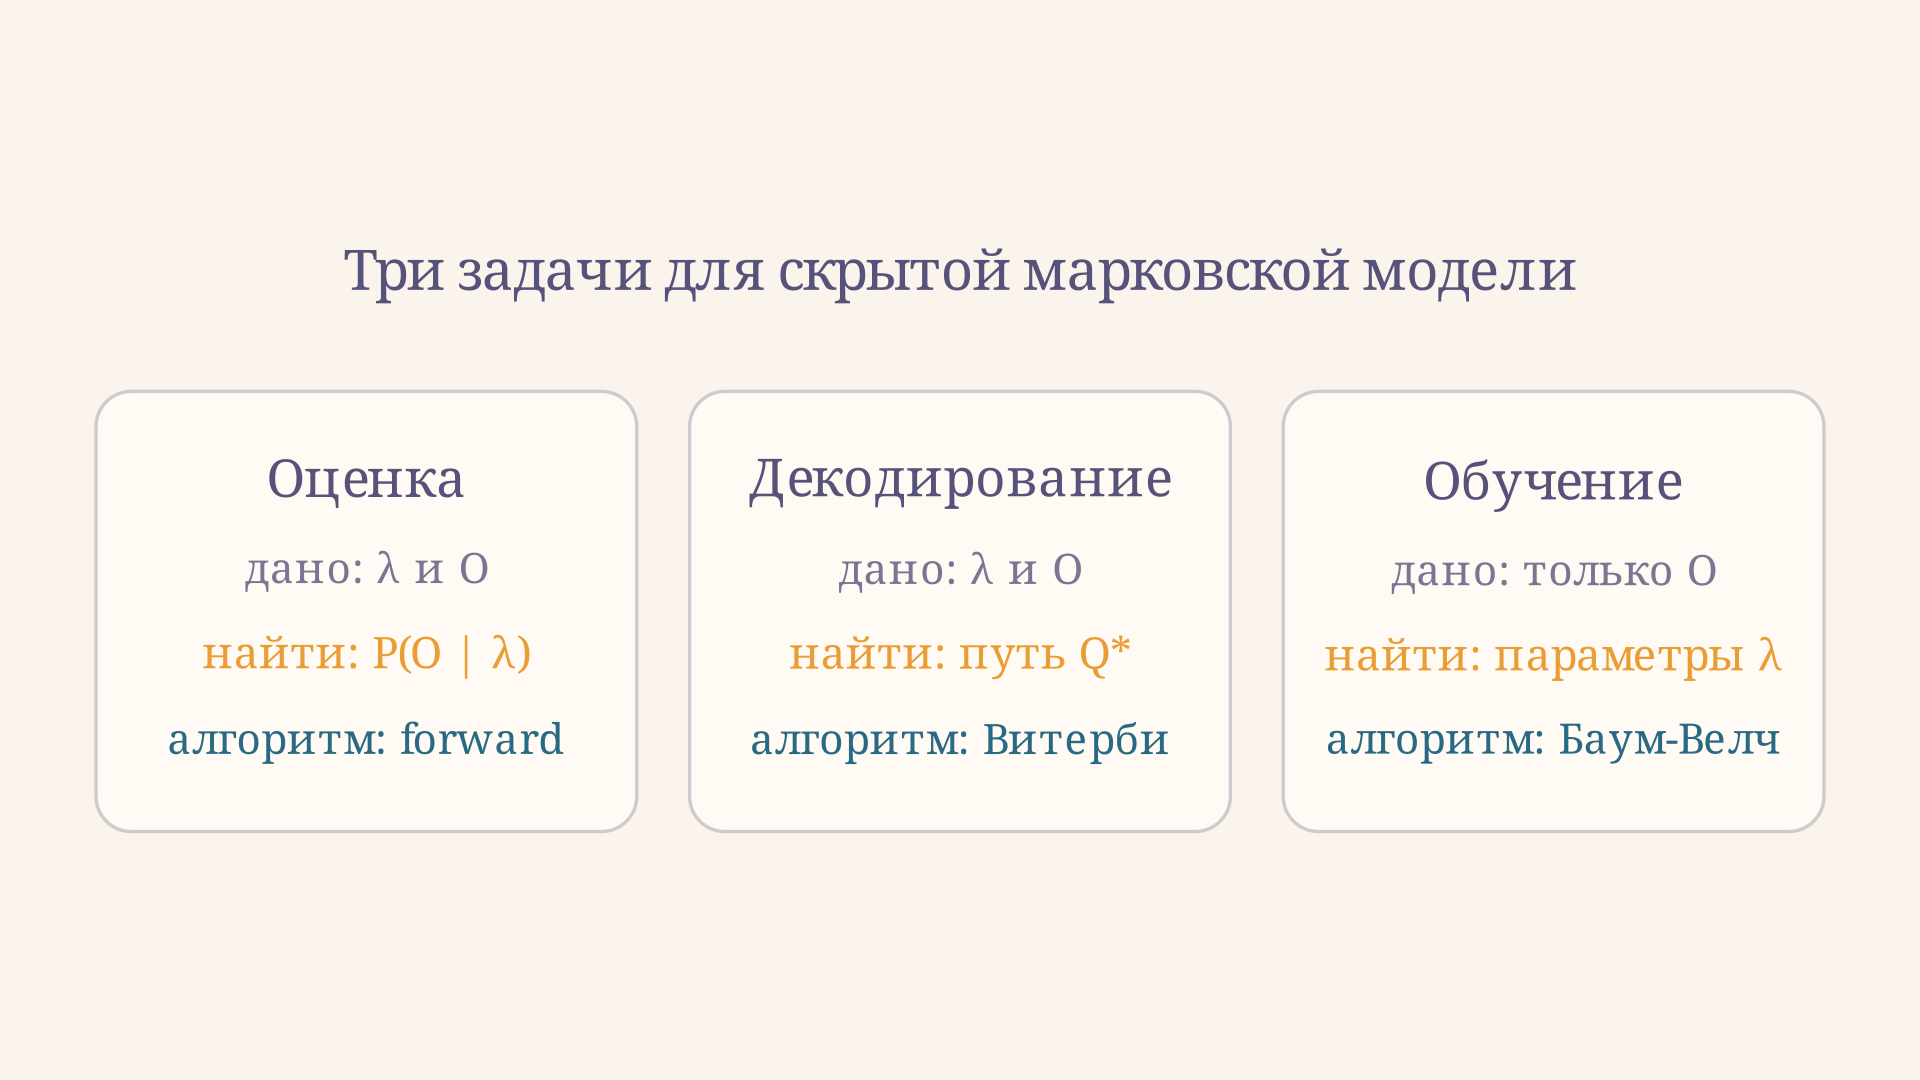
- Оценка. Даны параметры и наблюдения ; найти . Это мера того, насколько модель правдоподобно объясняет данные, и именно по ней выбирают между несколькими обученными моделями (например, между HMM разных слов при распознавании речи).
- Декодирование. Даны и ; найти последовательность скрытых состояний , максимизирующую . Ответ на вопрос «что там на самом деле происходило».
- Обучение. Даны только наблюдения; подобрать параметры , при которых максимально.
Лобовой перебор в первых двух задачах невозможен: путей длины по состояниям ровно , при 10 состояниях и 100 шагах это вариантов. Спасает динамическое программирование - то же, что и в задачах на последовательные решения: вместо путей хранят значения в узлах.
Алгоритм forward: правдоподобие наблюдений
Прямая переменная - это вероятность увидеть первые наблюдений и оказаться в состоянии :
Её считают по шагам. Инициализация , дальше рекуррентно:
Ключевое слово здесь - сумма: все пути, ведущие в узел, складываются, потому что нас интересует вероятность наблюдений при любой скрытой траектории. Сложность падает с до .
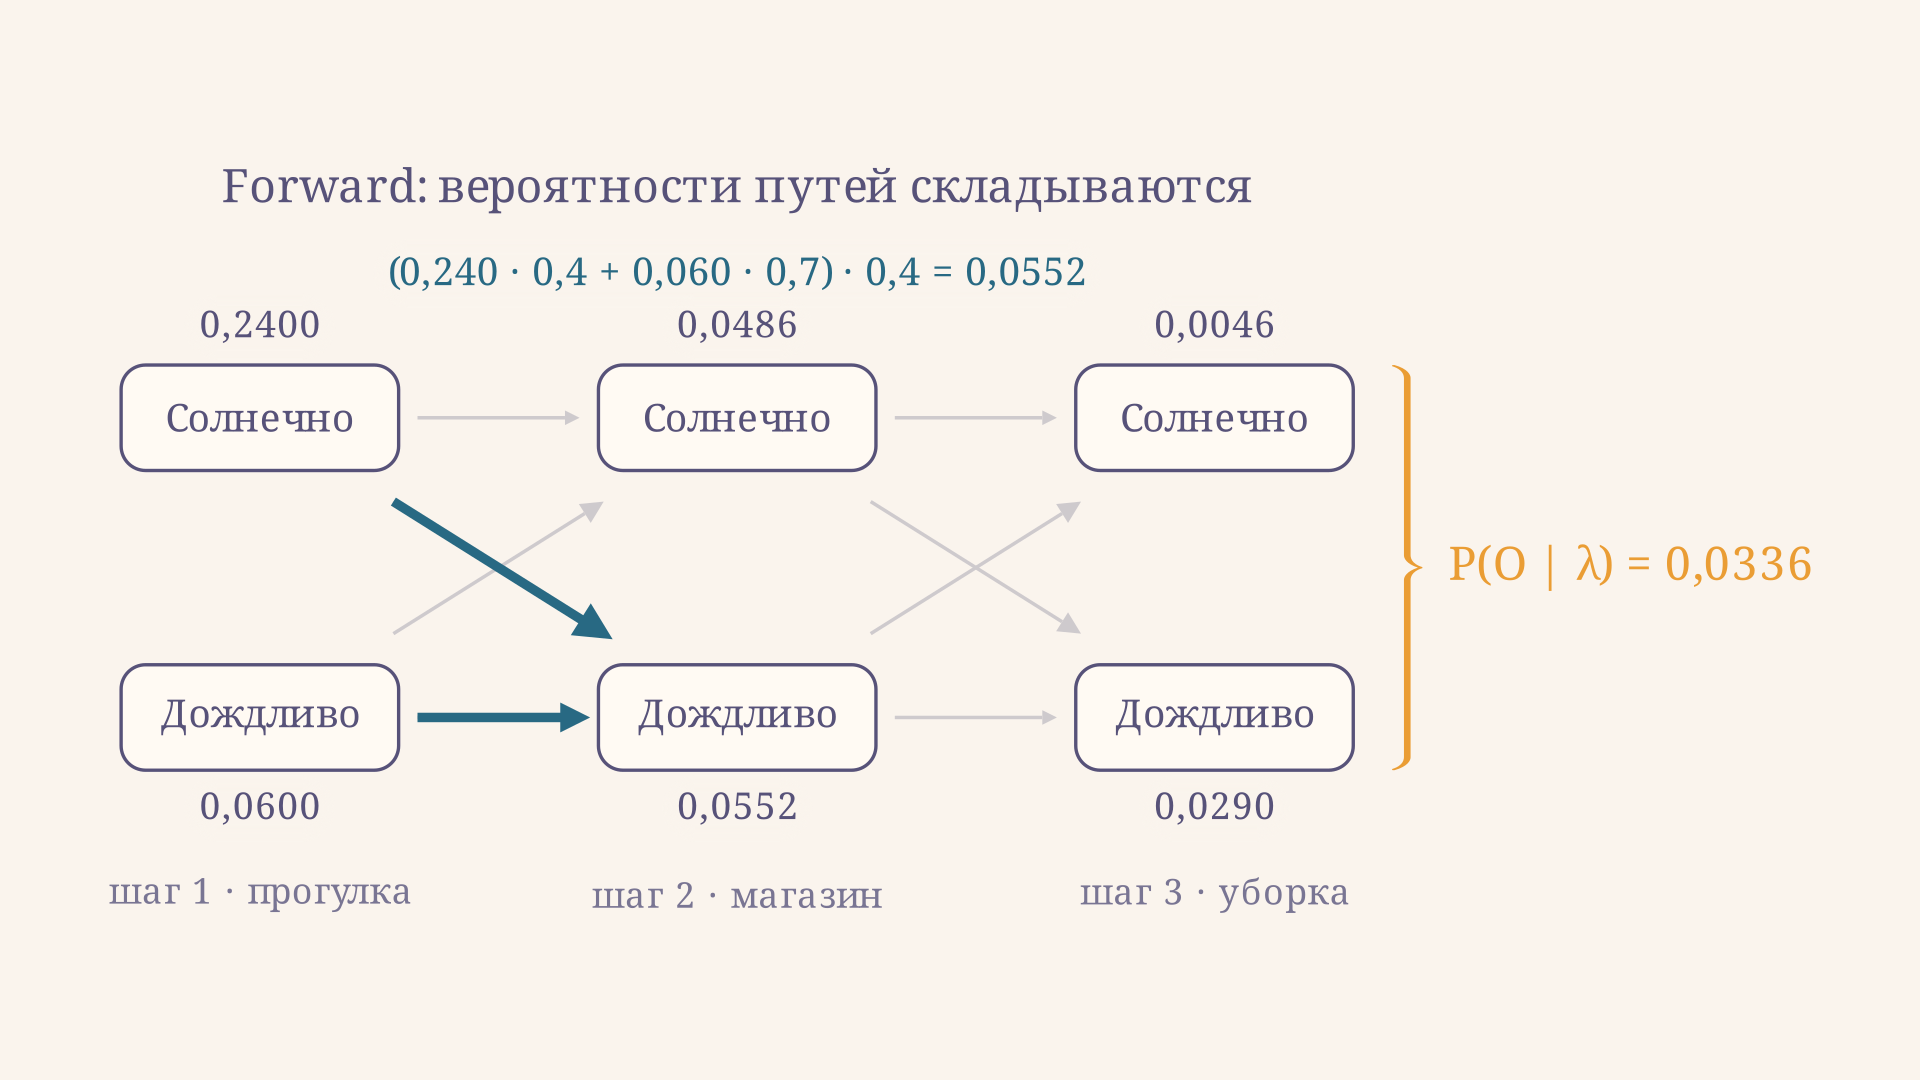
Для нашей последовательности «прогулка, магазин, уборка» первый столбец равен и , второй - и , третий - и . Сумма последнего столбца даёт . Само по себе число маленькое, и это нормально: вероятность конкретной тройки наблюдений и должна быть малой. Сравнивают такие числа только между моделями на одних и тех же данных, как апостериорные вероятности гипотез.
Алгоритм Витерби: лучший путь по решётке
Декодирование отличается от forward одной заменой: вместо суммы по предшественникам берётся максимум, а вместе со значением запоминается указатель на победителя.
В конце берут узел с наибольшим и идут по указателям назад, восстанавливая путь от конца к началу.
Витерби максимизирует вероятность последовательности целиком, а не выбирает самое вероятное состояние на каждом шаге по отдельности. В нашем примере оба подхода дают один и тот же ответ, но в общем случае они расходятся: цепочка из поштучных максимумов может оказаться вовсе невозможной, если между какими-то состояниями стоит нулевая вероятность перехода. Ровно поэтому алгоритм хранит указатели и делает обратный ход, а не читает таблицу по столбцам. Вес найденного пути составляет около 40 % правдоподобия : одна траектория из восьми возможных объясняет две пятых вероятности наблюдений.
Баум-Велч: обучение без разметки
Третья задача самая тяжёлая: параметры надо оценить, ни разу не увидев скрытых состояний. Алгоритм Баума-Велча - это частный случай EM-алгоритма, и работает он итерациями.
На шаге E при текущих параметрах считают апостериорные величины: - вероятность быть в состоянии в момент , и - вероятность перехода между моментами и . Обе выражаются через прямые и обратные переменные. На шаге M параметры пересчитывают как «ожидаемые частоты»:
Смысл пересчёта прозрачен: если бы скрытые состояния были известны, вероятность перехода оценивалась бы простой частотой «сколько раз из попали в , делённое на то, сколько раз были в ». Состояния неизвестны, поэтому вместо счётчиков подставляют их ожидаемые значения при текущей модели, и процедура повторяется до сходимости.
Каждая итерация не уменьшает правдоподобие, но гарантирует лишь локальный максимум: из разных начальных приближений Баум-Велч приходит к разным моделям. Отсюда практика нескольких запусков со случайной инициализацией и выбора лучшего результата.
Где применяются скрытые марковские модели
Исторически HMM выросла на распознавании речи, где скрытый слой - последовательность фонем, а наблюдения - кадры спектра. Дальше она разошлась по областям, где данные упорядочены во времени или вдоль цепочки:
- разметка частей речи и распознавание именованных сущностей в NLP;
- поиск генов и выравнивание последовательностей в биоинформатике (профильные HMM);
- распознавание рукописного текста и жестов;
- определение режимов рынка в финансах (regime switching);
- диагностика состояния оборудования по косвенным измерениям.
Нейросетевые модели потеснили HMM в распознавании речи, но там, где данных мало, а структура процесса известна заранее, скрытая марковская модель остаётся рабочим инструментом: её параметры интерпретируемы, а обучение не требует размеченного скрытого слоя.
Частые ошибки
- Путают forward и Витерби. Формулы отличаются одним символом: сумма против максимума. Если в задаче на декодирование сложить веса вместо взятия максимума, получится правдоподобие, а не путь.
- Забывают умножить на вероятность эмиссии. Типичная потеря множителя на шаге рекурсии: числа остаются похожими на правильные, но ответ неверен.
- Собирают путь по поштучным максимумам. Последовательность самых вероятных состояний в каждый момент может оказаться вовсе невозможной, если между ними нулевой переход.
- Не нормируют строки матриц. Сумма по строке и по строке обязана равняться единице, иначе модель не задаёт распределения вероятностей.
- Считают длинные последовательности без масштабирования. Значения убывают экспоненциально и при порядка сотен обнуляются машинно; на практике переходят к логарифмам или нормируют на каждом шаге.
FAQ
Чем скрытая марковская модель отличается от обычной цепи Маркова? В цепи Маркова наблюдаются сами состояния, и вероятность последовательности считается перемножением переходов. В HMM состояния скрыты, а наблюдения порождаются ими вероятностно, поэтому появляется второй набор параметров (матрица эмиссий) и необходимость восстанавливать скрытый слой алгоритмически.
Сколько скрытых состояний брать? Число состояний - гиперпараметр, он не определяется алгоритмом обучения. Его выбирают из предметного смысла (число фонем, число режимов рынка) или по информационным критериям AIC и BIC на отложенной выборке: рост числа состояний всегда повышает правдоподобие на обучающих данных и рано или поздно приводит к переобучению.
Можно ли работать с непрерывными наблюдениями? Да. Тогда дискретная матрица эмиссий заменяется плотностью, чаще всего смесью гауссиан для каждого состояния. Структура алгоритмов не меняется: в рекурсиях forward и Витерби вместо подставляется значение плотности в точке наблюдения.
Коротко
Скрытая марковская модель задаётся тройкой и описывает два слоя: марковскую цепь скрытых состояний и порождаемые ею наблюдения. С ней решают три задачи: правдоподобие считают алгоритмом forward, суммируя веса всех путей в решётке; наиболее вероятную цепочку состояний находят алгоритмом Витерби, где сумма заменяется максимумом и добавляются обратные указатели; параметры по неразмеченным данным подбирает Баум-Велч, итеративно повышая правдоподобие до локального максимума. Оба алгоритма стоят на динамическом программировании и работают за вместо экспоненциального перебора.
Читайте также
Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
Как работают агрегатные функции SQL: COUNT, SUM, AVG, MIN и MAX, группировка GROUP BY, порядок выполнения запроса, разница HAVING и WHERE и поведение NULL внутри агрегата.
Интегральный синус Si(x): ряд Тейлора и максимум
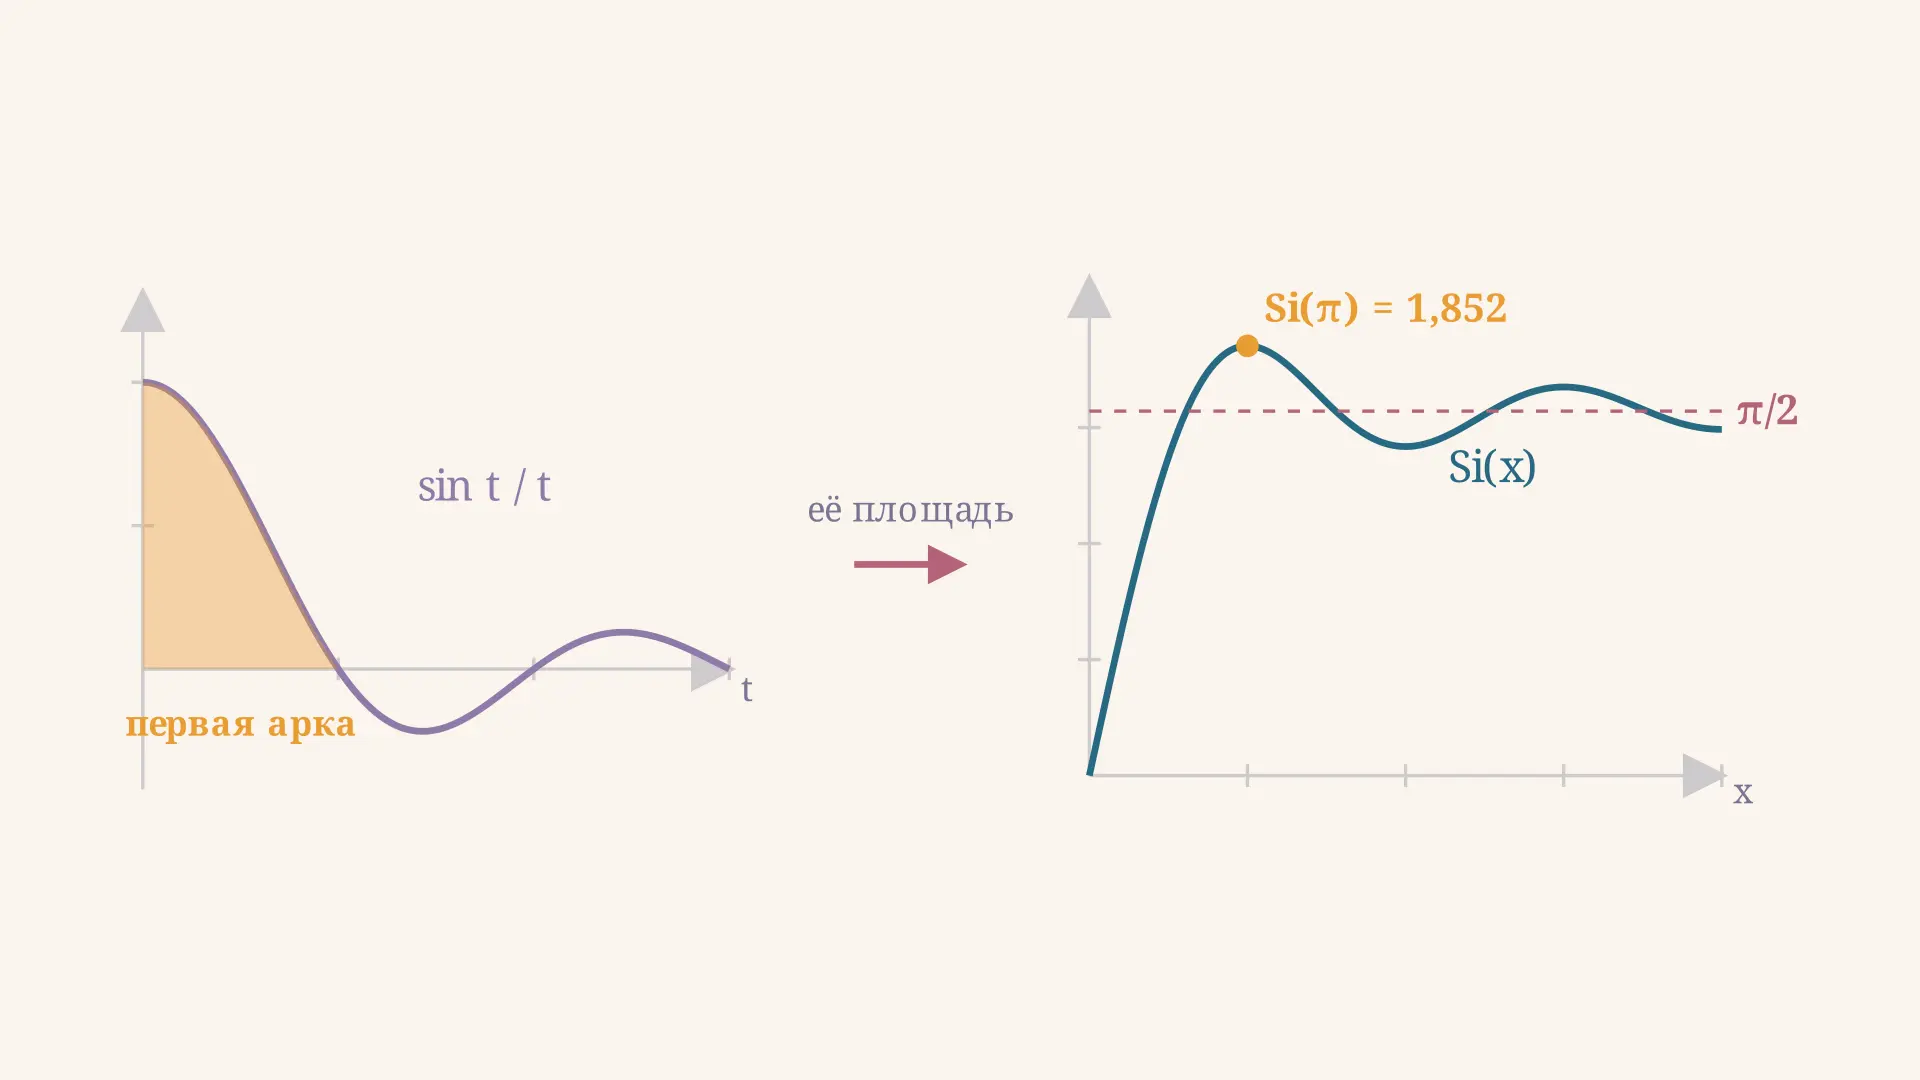
Интегральный синус Si(x): почему интеграл sin t / t не берётся в элементарных функциях, разложение в ряд, предел π/2, максимум Si(π) и выброс Гиббса. С калькулятором.
Куча как структура данных: массив и просеивание
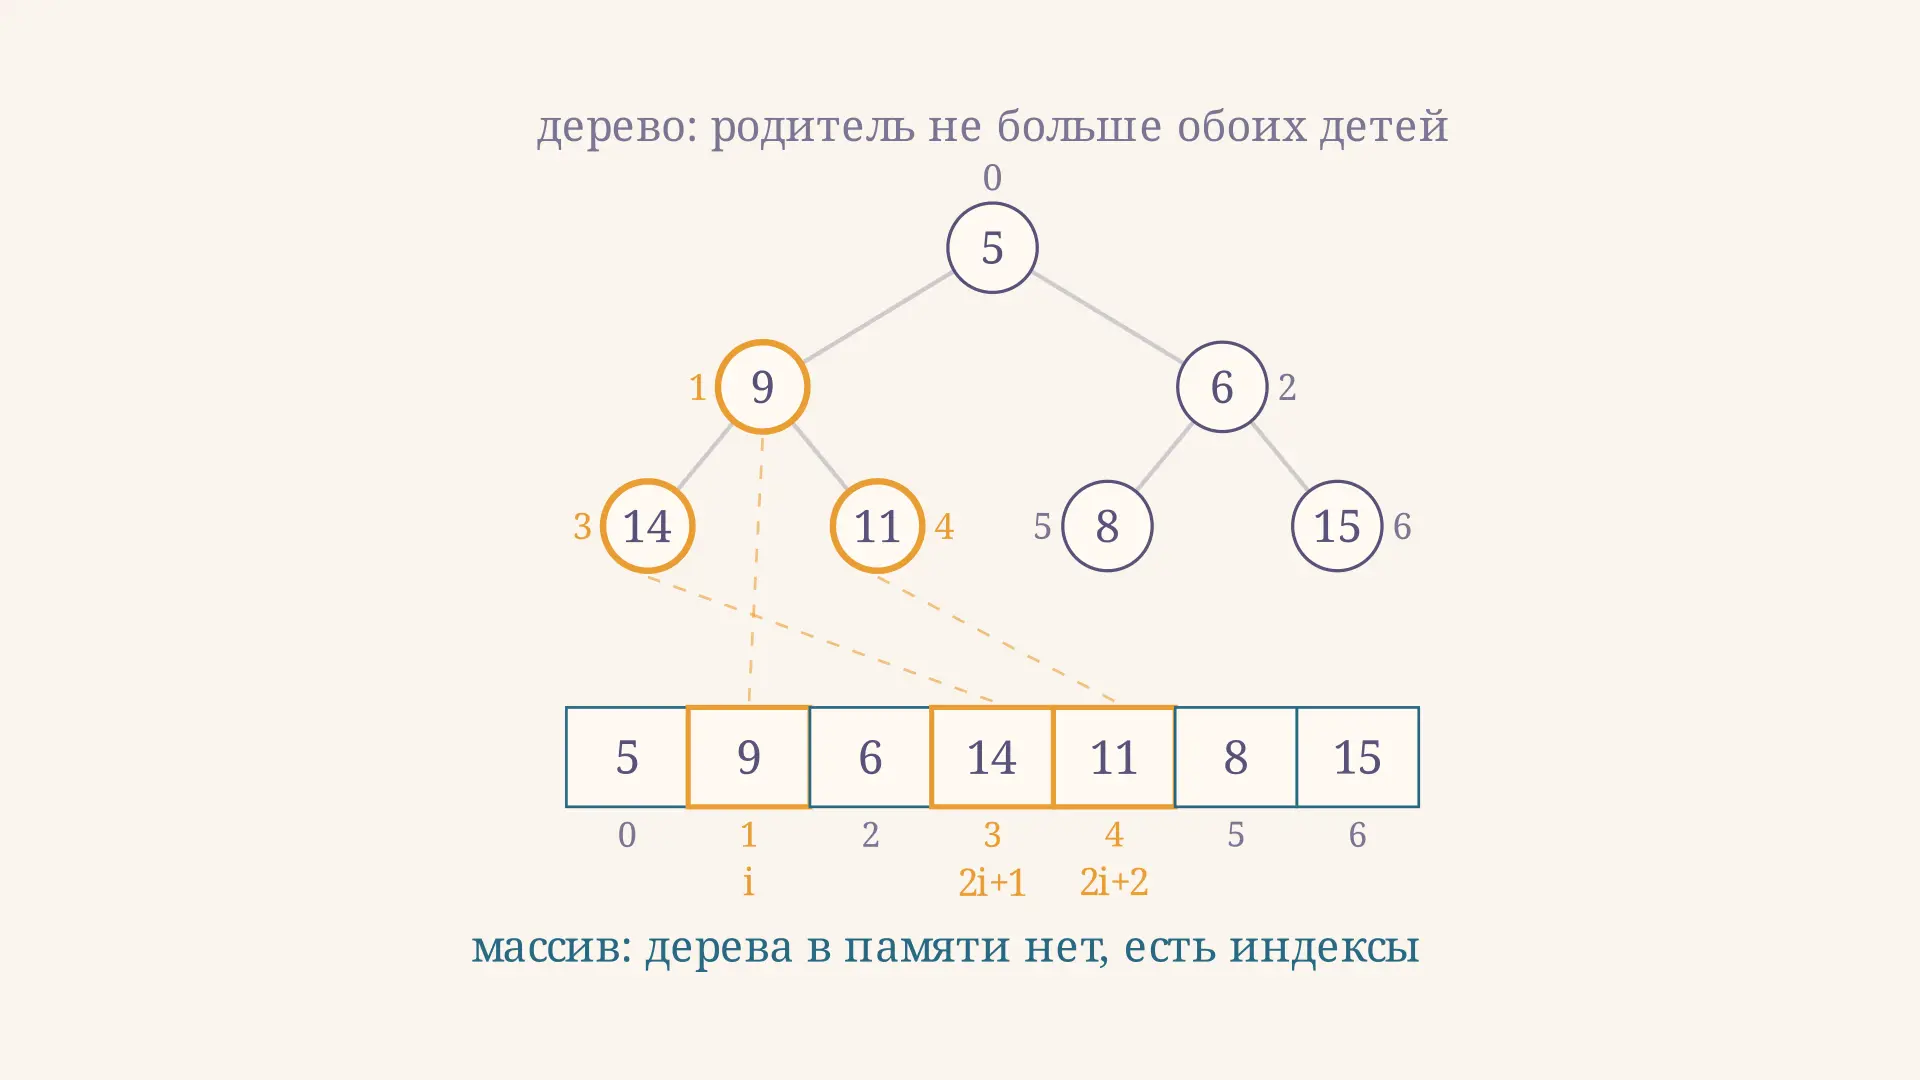
Куча как структура данных: свойство кучи, хранение в обычном массиве и индексы 2i+1 и 2i+2, просеивание sift-up и sift-down, построение за O(n) и приоритетная очередь.
Линейная зависимость векторов: критерии и примеры
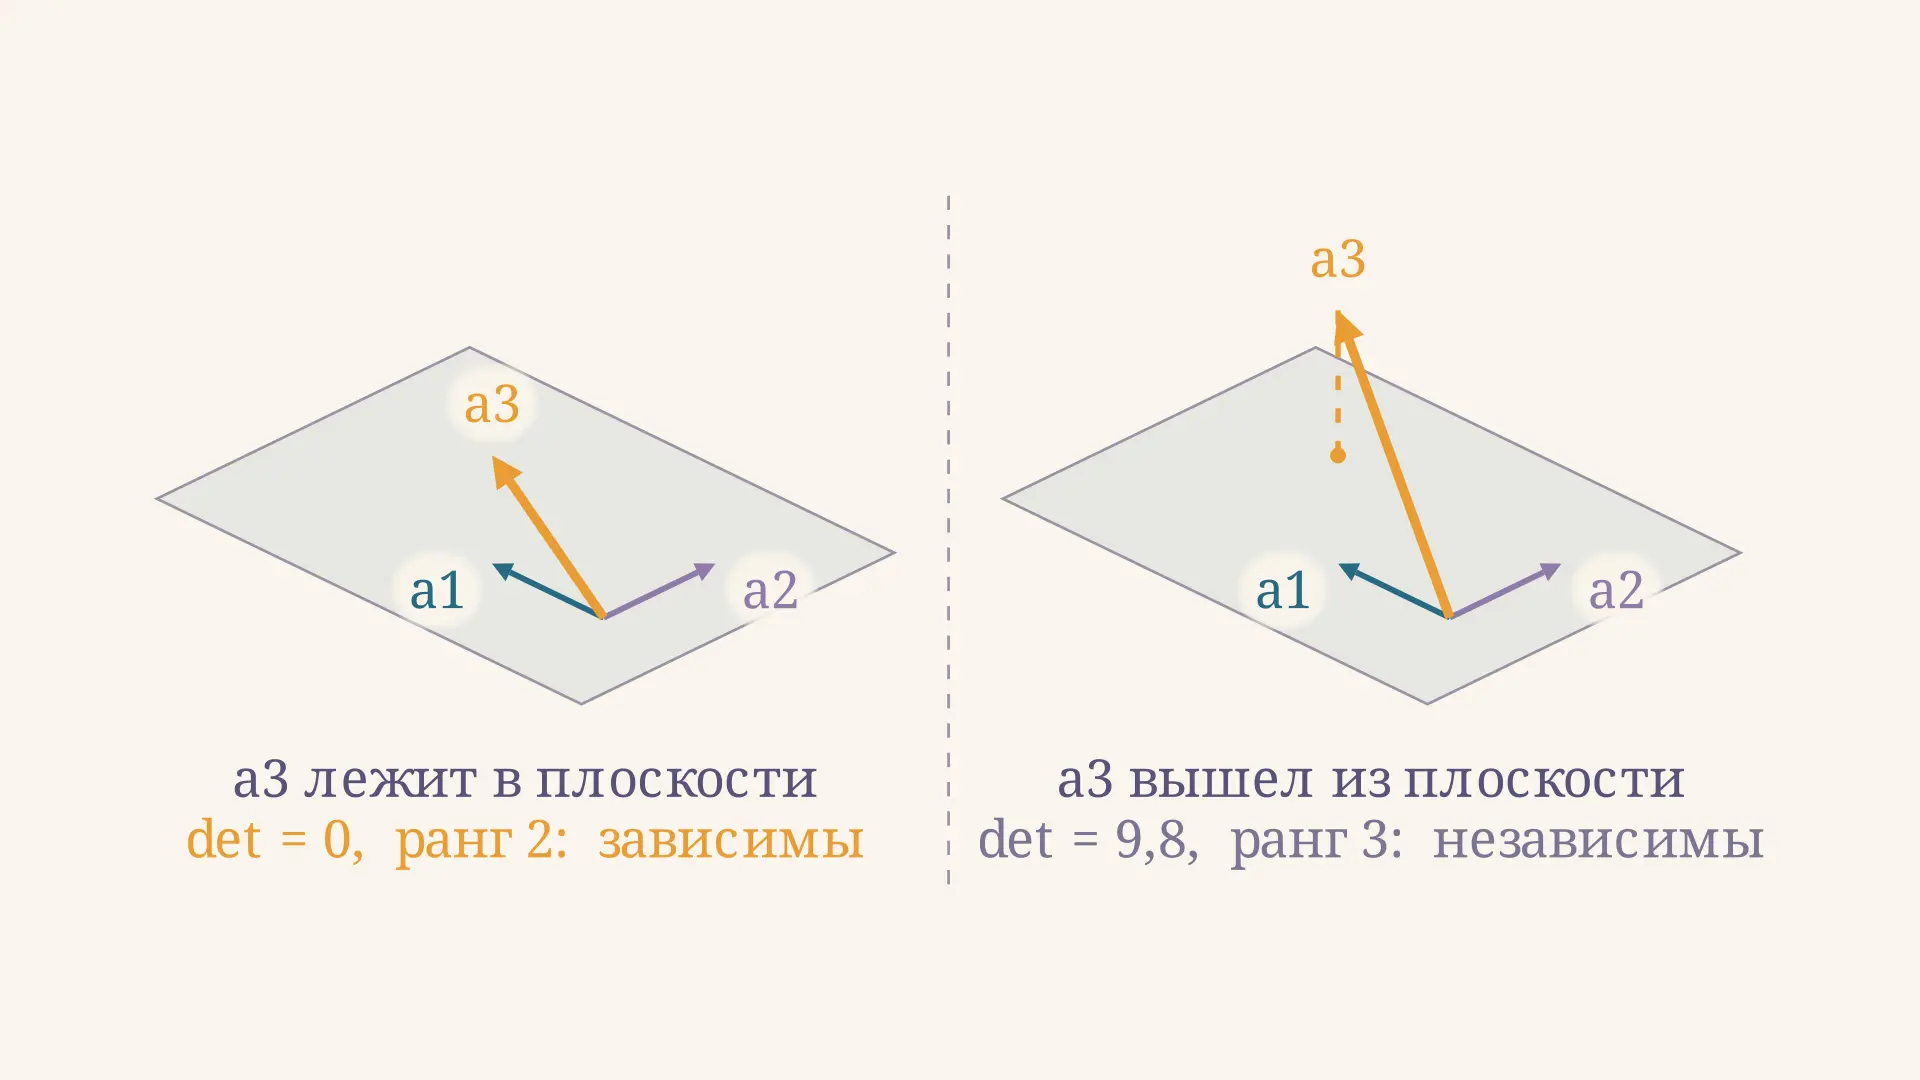
Что такое линейная зависимость векторов, как проверить её определителем и рангом матрицы, чем коллинеарность отличается от компланарности и как всё это связано с базисом.
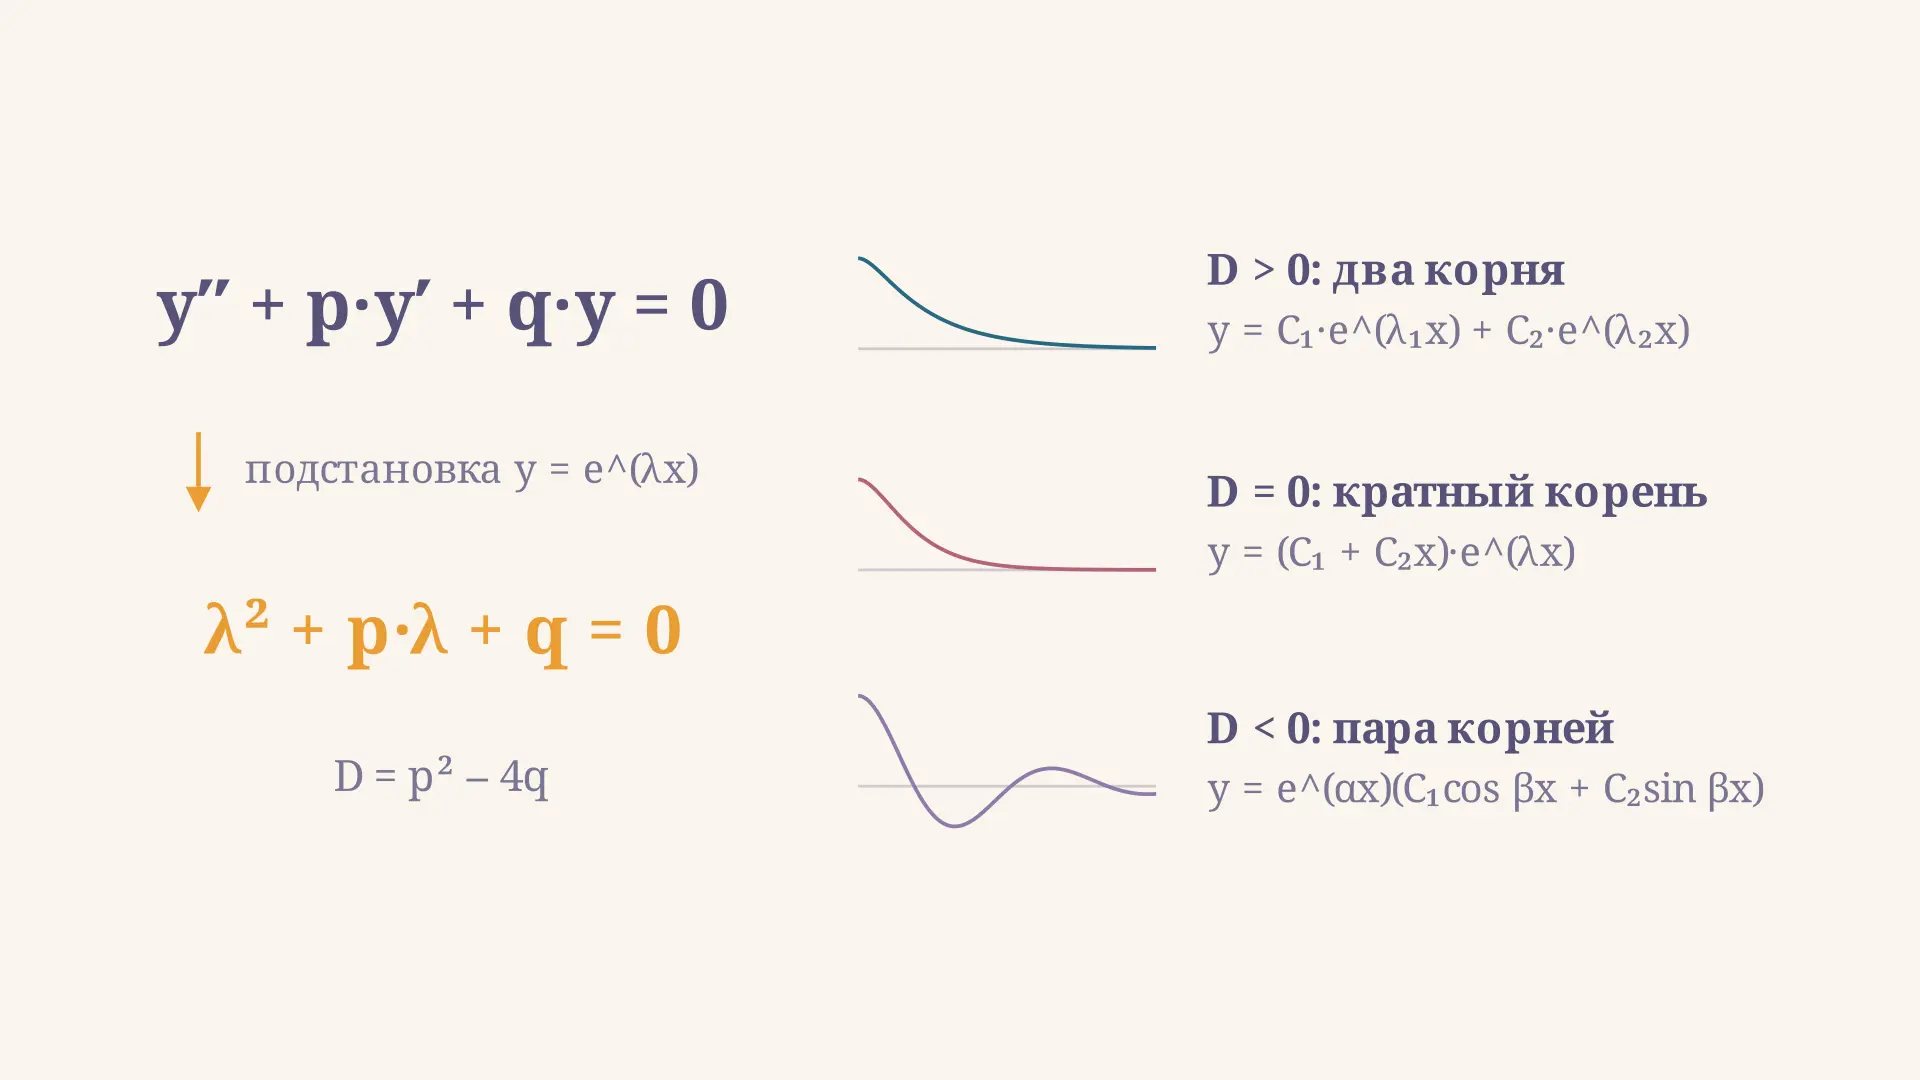
Линейное уравнение второго порядка: общее решение
Как решить линейное однородное уравнение второго порядка с постоянными коэффициентами: характеристическое уравнение, три случая корней, фундаментальная система и задача Коши с разбором.
Метод вариации постоянных: формулы и разбор примера
Метод вариации произвольных постоянных: как из решений однородного уравнения собрать частное, зачем здесь определитель Вронского и когда быстрее оказывается подбор по виду правой части.