Распространение выборочных данных на совокупность
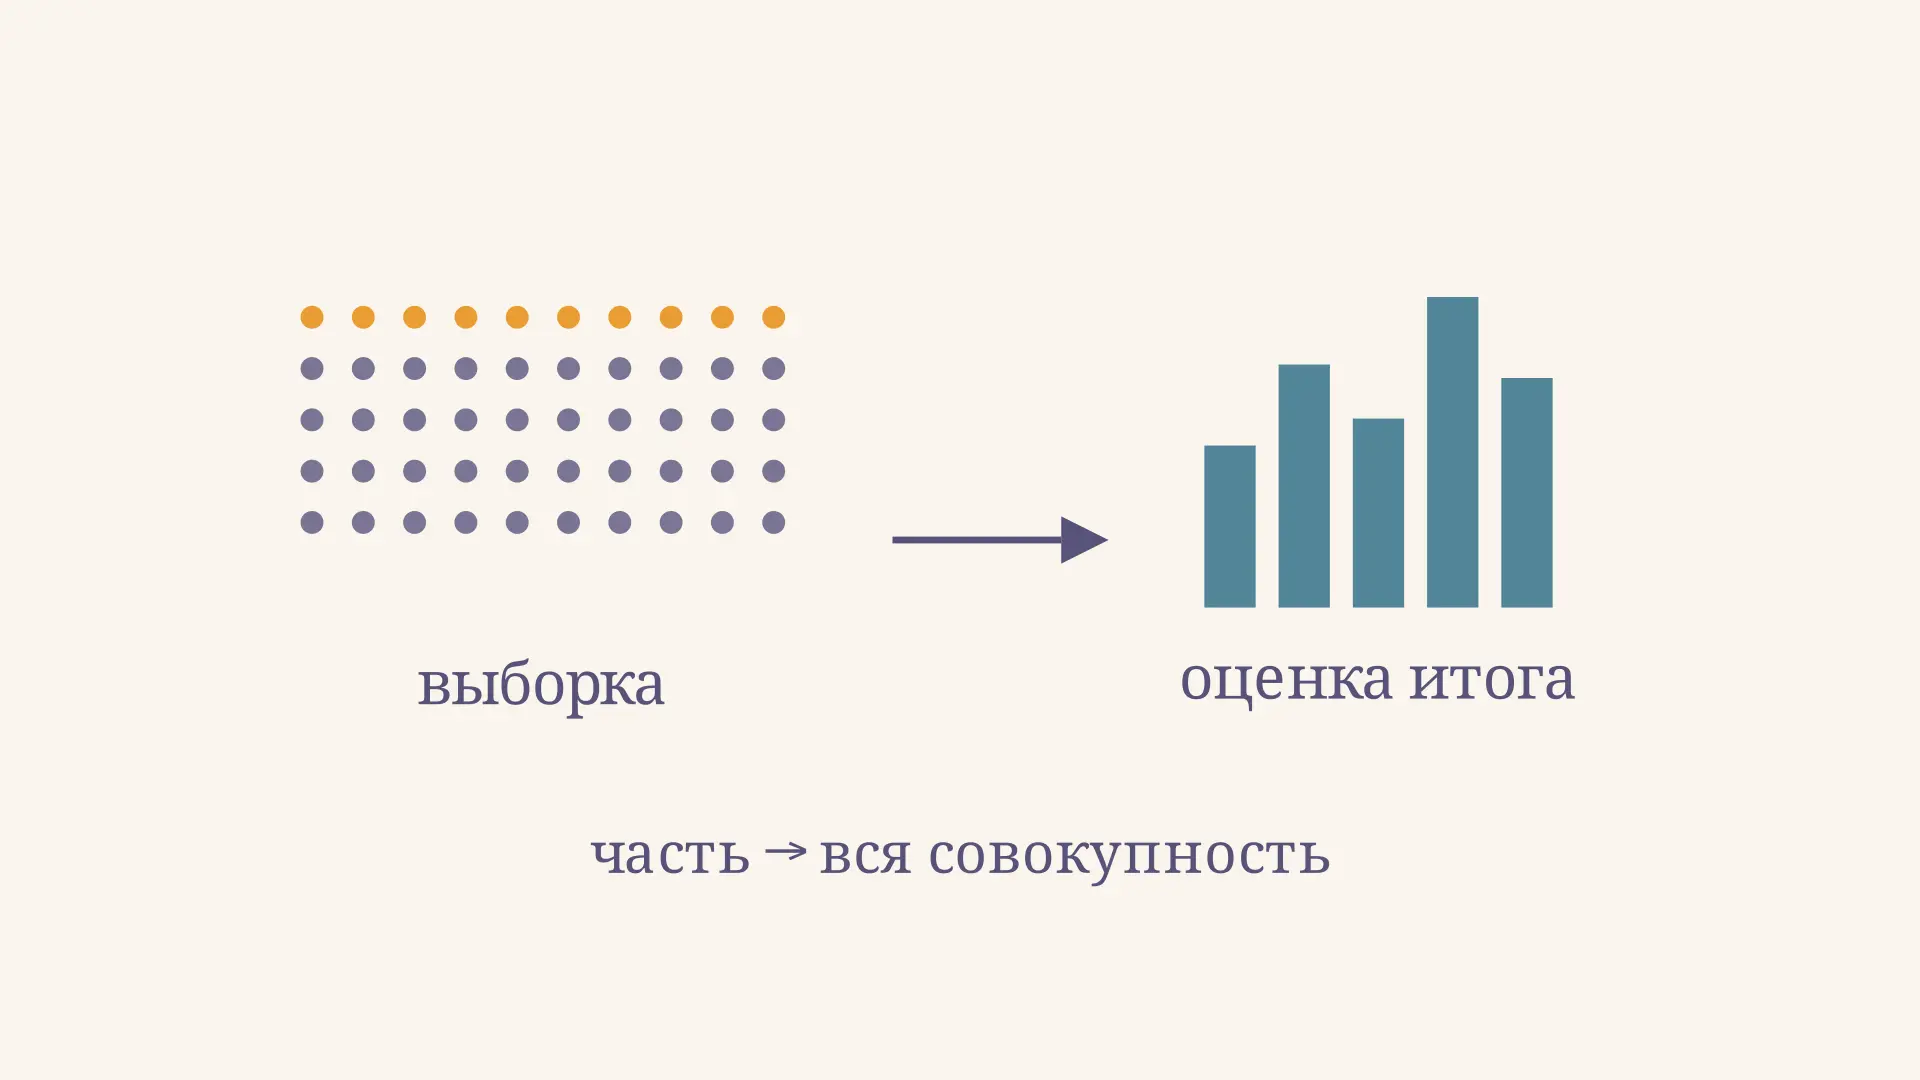
Распространение выборочных данных - это оценивание показателя всей генеральной совокупности по сведениям о её части. Например, по обороту случайно отобранных предприятий статистик оценивает средний и общий оборот всех предприятий в заданном списке. Полученное число - оценка, а не точный итог переписи: другая выборка могла бы дать иной результат. В калькуляторе можно изменить размер выборки и увидеть, как меняется случайная неопределённость при фиксированных среднем и разбросе.
От выборки к экономическому итогу
Пусть известен список из предприятий, но подробный учёт доступен только для из них. Нужно оценить, например, суммарный месячный оборот списка. Сначала важно определить единицу наблюдения, границы совокупности, период и единицы измерения. Если в список не вошли малые фирмы, результат относится к списку, а не автоматически ко всем фирмам региона. Разницу между объектом исследования и фактически доступным списком подробнее объясняет статья о генеральной совокупности и выборке.
При простой случайной бесповторной выборке каждый набор из единиц имеет одинаковую вероятность отбора. Тогда средний оборот отобранных предприятий служит оценкой среднего по списку, а его произведение на - оценкой общего оборота. На видео оценка зафиксирована: движение показывает только то, как при прочих равных увеличение сужает приближённый интервал.
Это сравнение вариантов дизайна, а не обещание, что новые наблюдения сохранят прежнее среднее. В реальных данных вместе с объёмом обычно меняются и оценка, и оценённый разброс.
Прямой пересчёт среднего и суммы
Обозначим наблюдаемые значения . Выборочное среднее и оценка генерального итога равны:
Для простого случайного отбора такая оценка несмещённая: среднее значение оценки по всем возможным выборкам данного размера равно истинному итогу. Это свойство метода при повторении отбора, а не гарантия точности одной конкретной выборки. Такой пересчёт также можно понимать как взвешивание: каждое наблюдение представляет единиц, поэтому .
Нельзя просто умножить выборочную сумму на : она уже содержит наблюдений. Правильный множитель для неё - . Если неизвестно, получить итог этим способом невозможно, хотя среднее ещё можно оценивать при подходящем дизайне. При неравных вероятностях включения единиц нужны соответствующие веса; единый множитель не подходит автоматически. Оценивание среднего и итога при простой случайной выборке разбирает учебный курс Университета штата Пенсильвания.
Расчёт на примере предприятий
Рассмотрим условные данные: в списке предприятий, случайно без возвращения обследовано . Их средний месячный оборот равен 50 тыс. руб., выборочное стандартное отклонение тыс. руб. Тогда оценка общего оборота:
Это учебный пример, а не данные обследования. Для оценки случайной ошибки сначала вычисляют выборочную дисперсию . Стандартная ошибка среднего для указанного дизайна и соответствующая ошибка итога составляют:
Поправка учитывает бесповторный отбор из конечной совокупности. Здесь тыс. руб., а млн руб. Стандартная ошибка показывает типичный масштаб колебаний оценки при повторном отборе, а не известную ошибку именно этой выборки.
Для достаточно хорошего нормального приближения построим ориентировочный 95%-й интервал как . Его границы - примерно и млн руб. Нормальное приближение требует обоснования распределением оценки и дизайном: при малой выборке, сильной асимметрии или выбросах оно может работать плохо. В таких случаях метод интервала выбирают отдельно.
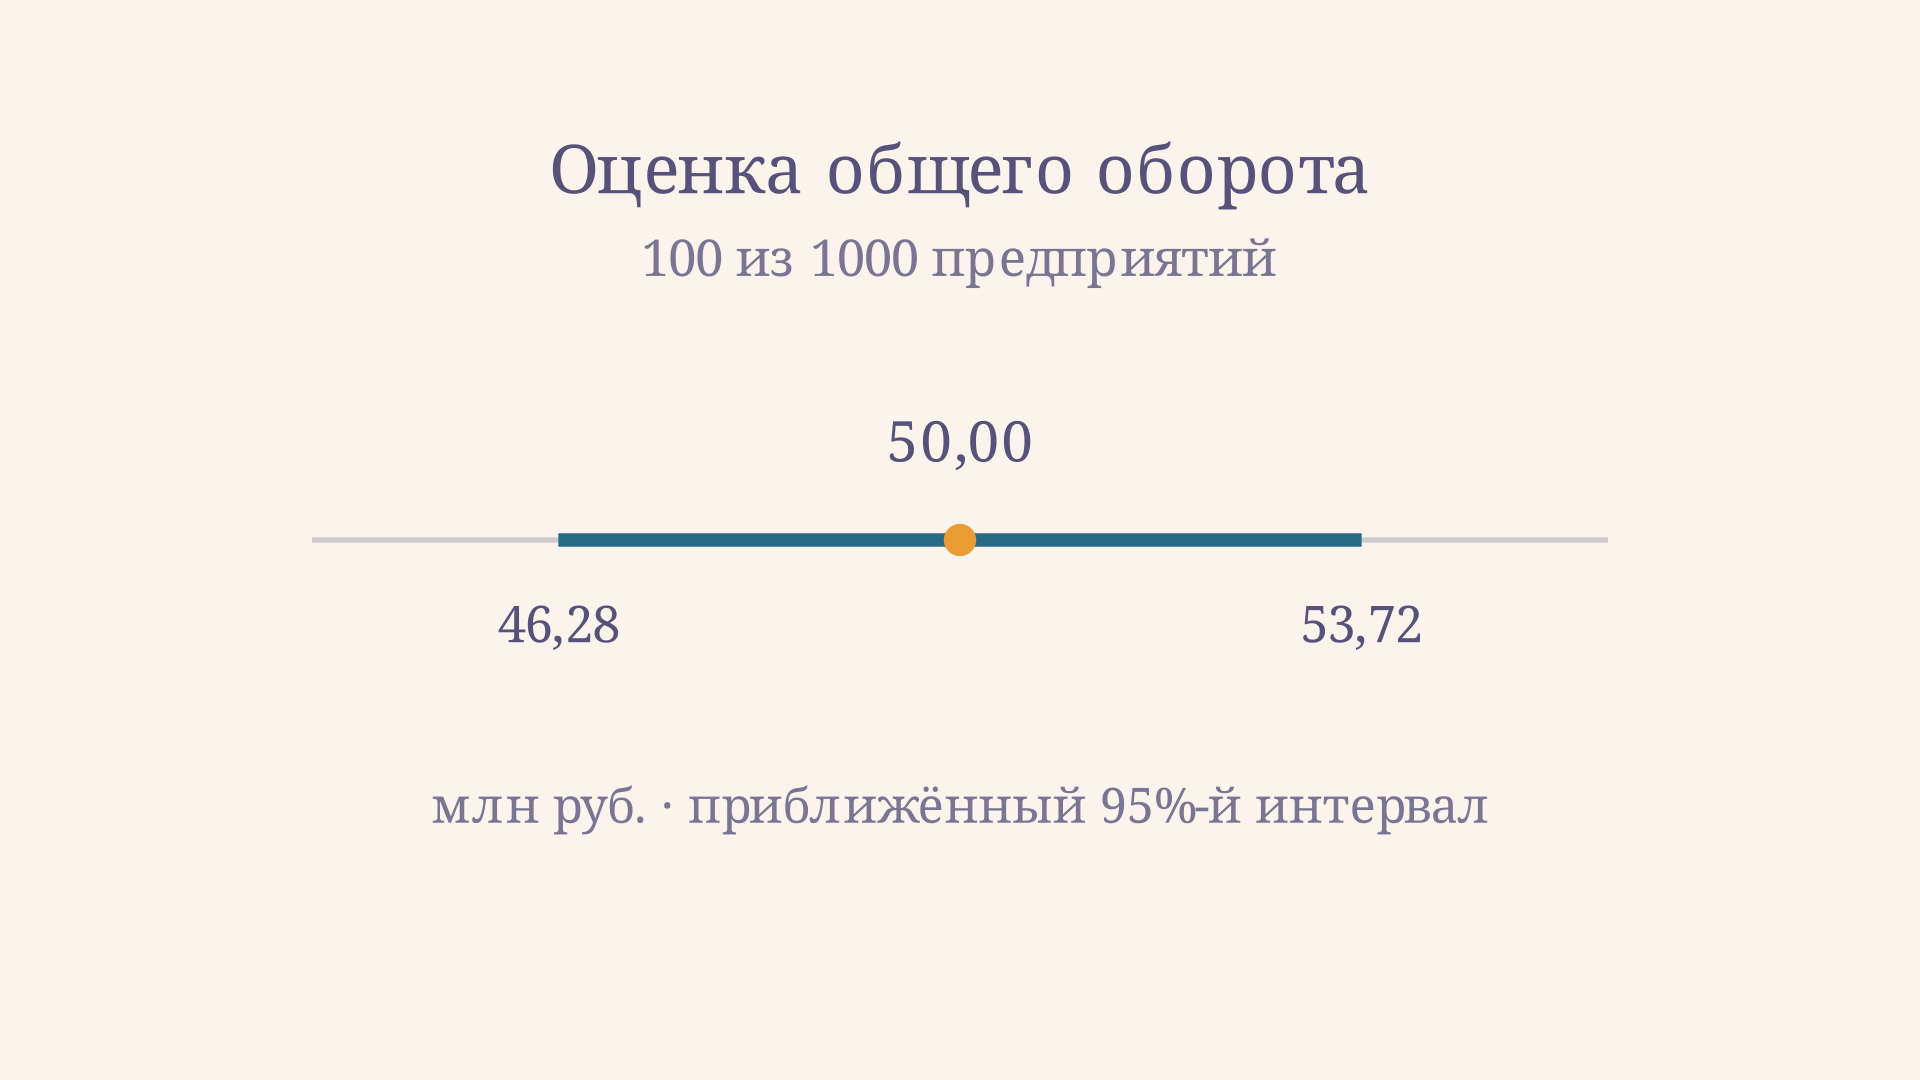
95% относится к процедуре: при многократном повторении отбора примерно 95% построенных таким способом интервалов накрывали бы фиксированный истинный итог, если приближение и предпосылки пригодны. Это не доля предприятий внутри интервала и не вероятность того, что уже полученный фиксированный итог случайно меняется. Подробнее о связи доверительного уровня и процедуры - в статье о доверительной вероятности.
В калькуляторе можно сравнить тот же условный расчёт при 50 и 500 наблюдениях. Если оставить среднее и стандартное отклонение неизменными, стандартная ошибка итога уменьшится примерно с 2,76 до 0,63 млн руб. Оценка самого итога при этом останется равной 50 млн руб. Такой опыт изолирует влияние размера выборки и конечной совокупности: при обработке настоящего обследования оценку разброса нужно пересчитывать по фактическим данным.
Границы интервала не равнозначны гарантированным нижнему и верхнему пределам оборота. Метод может промахнуться даже при корректном случайном отборе. Кроме того, вычисленный интервал учитывает только ту неопределённость, которую описывает принятая модель: например, ошибочное измерение выручки или отсутствие части фирм в списке в его ширину не включено.
Как распространить выборочную долю
Для качественного признака, например наличия прибыли, оценка доли равна , где - число предприятий с признаком. При тех же условиях отбора оценка числа таких предприятий во всей совокупности - . Если в случайной выборке из 200 предприятий 60 прибыльны, то . Для списка из 2000 предприятий оценка составляет предприятий.
Здесь важно различать 30% и 600: первое оценивает долю, второе - количество и зависит от известного размера совокупности. Оценка 600 не означает, что поимённо установлены именно эти предприятия. Для неопределённости доли при таком дизайне можно использовать для индикатора признака и ту же поправку на конечную совокупность; около нуля или единицы обычный нормальный интервал особенно ненадёжен. Связь бинарного признака с разбросом раскрыта в статье о дисперсии альтернативного признака.
Что может сделать перенос некорректным
Случайная ошибка - лишь одна часть неопределённости. Неполный список, отказы отвечать, неверный учёт оборота или замена неудобных для опроса фирм доступными могут внести систематическую ошибку. Увеличение числа ответов само по себе не устраняет недопредставленность целой группы. Статистическая служба Канады отдельно определяет ошибку выборки как результат наблюдения части совокупности и связывает её оценивание с вероятностным отбором.
Для стратифицированного или гнездового дизайна оценки и ошибки учитывают схему отбора, веса и структуру групп. Нельзя механически подставлять общий в формулу простой случайной выборки. Например, предприятия одного гнезда могут быть похожи друг на друга; подробнее об этом - в материале о гнездовой выборке. При квотном или добровольном опросе без известных вероятностей отбора приведённая формула не обосновывает заявленную погрешность.
Перед расчётом полезно проверить полноту ответов внутри самой выборки. Допустим, из отобранных фирм регулярно не отвечают наиболее крупные: тогда среднее только по ответившим может оказаться ниже среднего по всем отобранным. Простое увеличение множителя до отношения размера списка к числу ответивших не доказывает, что смещение исчезло. Нужны сведения о неответах и обоснованный способ обработки, соответствующий исследованию.
Отдельно проверяют совместимость периода и показателя. Месячную выручку нельзя складывать с годовой без приведения к сопоставимому периоду, а оборот предприятия нельзя автоматически считать прибылью. В отчёте также следует назвать источник списка, даты обследования и долю полученных ответов: читателю будет проще понять, к кому относится оценка и какие ограничения остаются.
Как оформить решение
Сначала запишите, на какую совокупность переносится результат, известен ли её размер и как отобраны единицы. Затем обозначьте показатель: среднее, долю, итог или число объектов с признаком. Проверьте единицы и только после этого выберите оценку и формулу её ошибки. В конце приведите численный ответ с округлением, тип интервала и ограничения, включая возможные неответы.
Если задача сообщает только среднее и размер выборки, точечную оценку итога при известном найти можно, но для стандартной ошибки среднего нужны сведения о разбросе и схеме отбора. Если речь идёт о выборе метода опроса, отдельно проверьте основу и доступность респондентов: собственно-случайная выборка требует реального случайного механизма, а не произвольного выбора наблюдателем.
Частые ошибки
- Считать оценку точным итогом. Укажите, что итог получен по части единиц и имеет случайную ошибку.
- Переносить результат за пределы списка. Сначала установите, кого охватывала основа выборки и кто не ответил.
- Путать среднее и сумму. Среднее умножают на , а выборочную сумму - на при равных вероятностях отбора.
- Игнорировать дизайн. Поправка и формула ошибки выше относятся к простой случайной бесповторной выборке; для других схем нужен иной расчёт.
- Считать 95% гарантией для конкретной оценки. Уровень описывает долгосрочное покрытие процедуры при её предпосылках.
FAQ
Можно ли распространить среднее без размера совокупности?
Да, оценить среднее можно при подходящей схеме отбора, но оценка общего итога требует знания или отдельной оценки .
Всегда ли большая выборка лучше?
При том же дизайне и фиксированном разбросе случайная ошибка обычно уменьшается. Но большой объём не исправляет ошибки охвата, неответов и измерения.
Почему используется поправка на конечную совокупность?
При бесповторном отборе каждая уже выбранная единица исключается из дальнейшего отбора. По мере приближения к случайная ошибка уменьшается до нуля при полном охвате; ошибки измерения при этом могут остаться.
Коротко
Распространение данных превращает выборочное среднее или долю в оценку показателя заданной совокупности. При простой случайной бесповторной выборке итог оценивают как , а неопределённость - с учётом разброса, размера выборки и поправки на конечную совокупность. Корректный вывод всегда указывает границы охвата и ограничения метода.
Читайте также
Бюджетные обследования: как изучают расходы домохозяйств
Бюджетные обследования показывают доходы и расходы домохозяйств. Разбираем выборку, дневник, расчёт структуры потребления и важные ограничения результатов.
Абсолютное преимущество Смита: пример и расчёт
Абсолютное преимущество Смита простыми словами: как сравнить затраты труда, рассчитать выигрыш от специализации и отличить его от сравнительного преимущества Рикардо.

Аддитивная факторная модель: формула и пример расчёта
Аддитивная факторная модель в экономике: как разложить показатель на слагаемые, рассчитать вклад каждого изменения и проверить результат на примере прибыли.
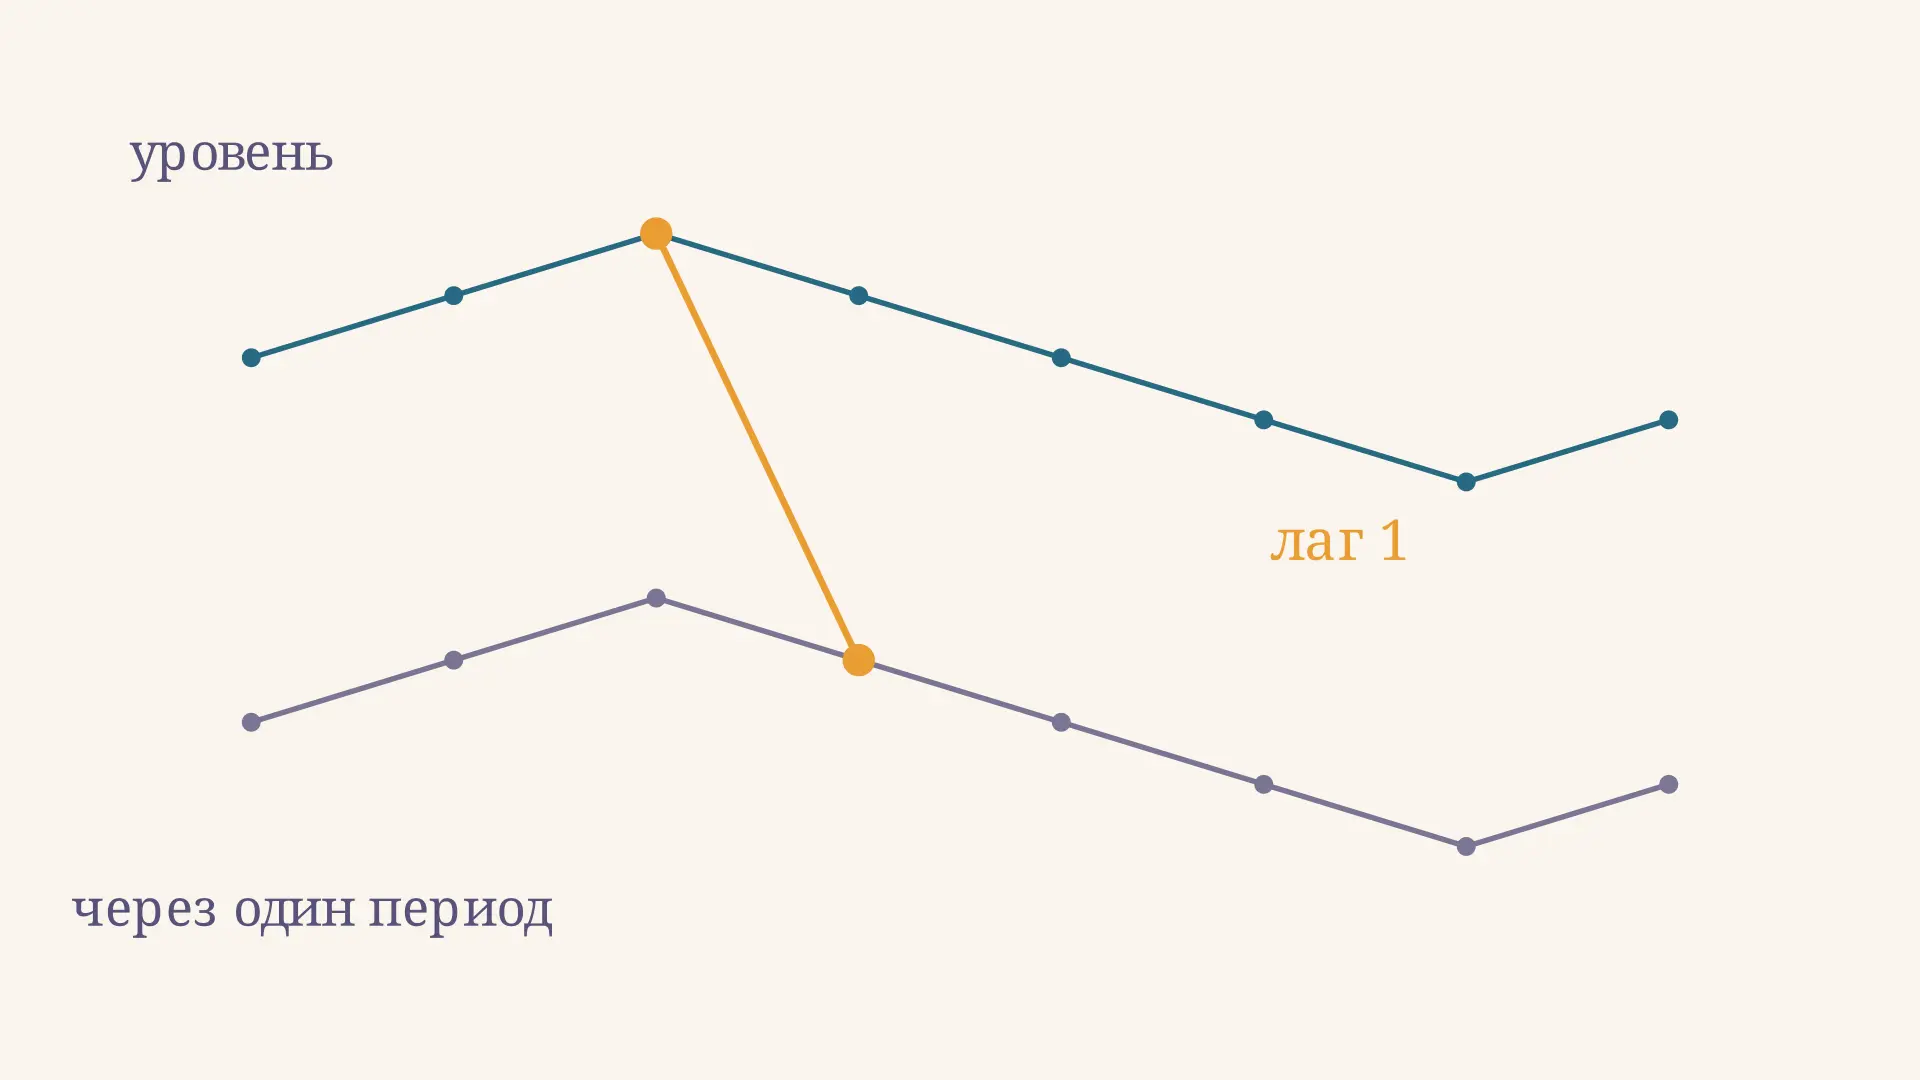
Автокорреляция уровней временного ряда: расчёт
Автокорреляция уровней временного ряда: как выбрать лаг, вычислить коэффициент на числовом примере и прочитать коррелограмму с учётом тренда и сезонности.
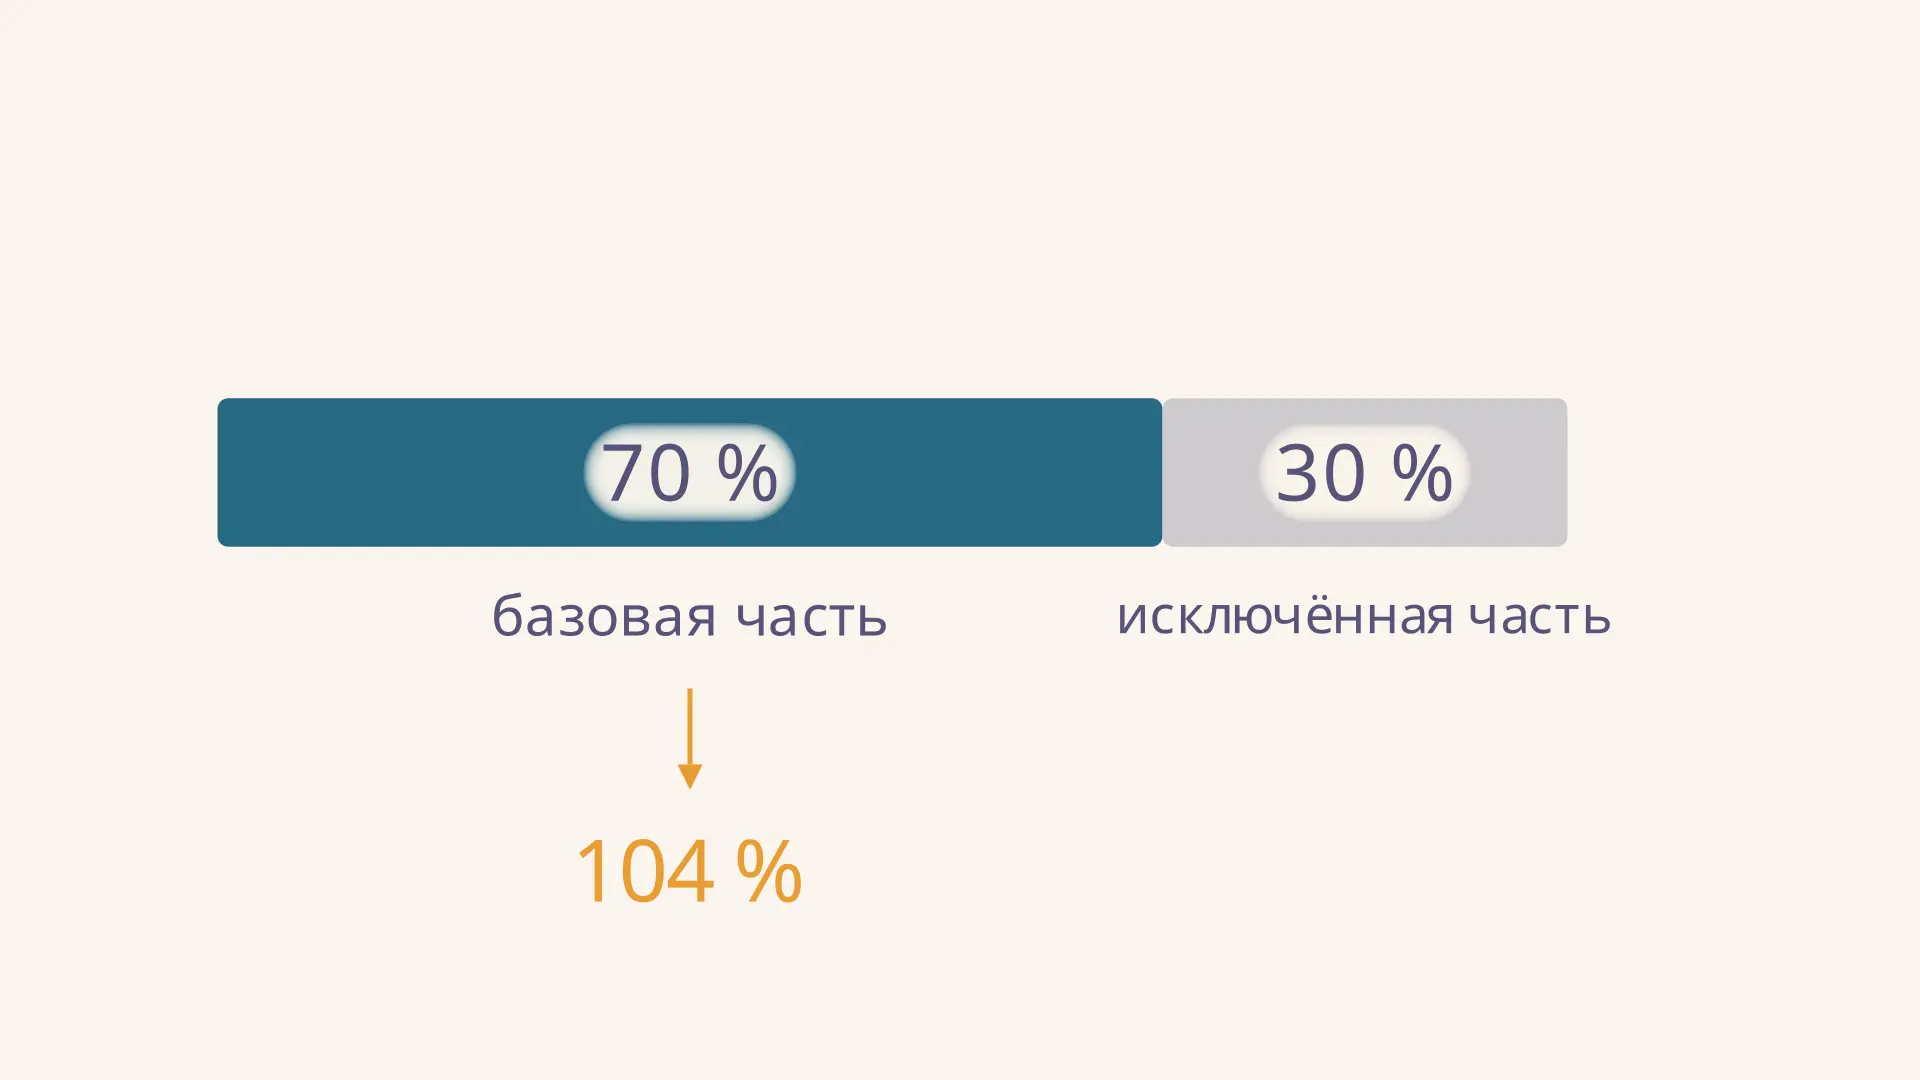
Базовый индекс потребительских цен: смысл и расчёт
Что показывает базовый индекс потребительских цен, какие компоненты исключают из расчёта, как сопоставить его с общим ИПЦ и правильно прочитать результат на примере.
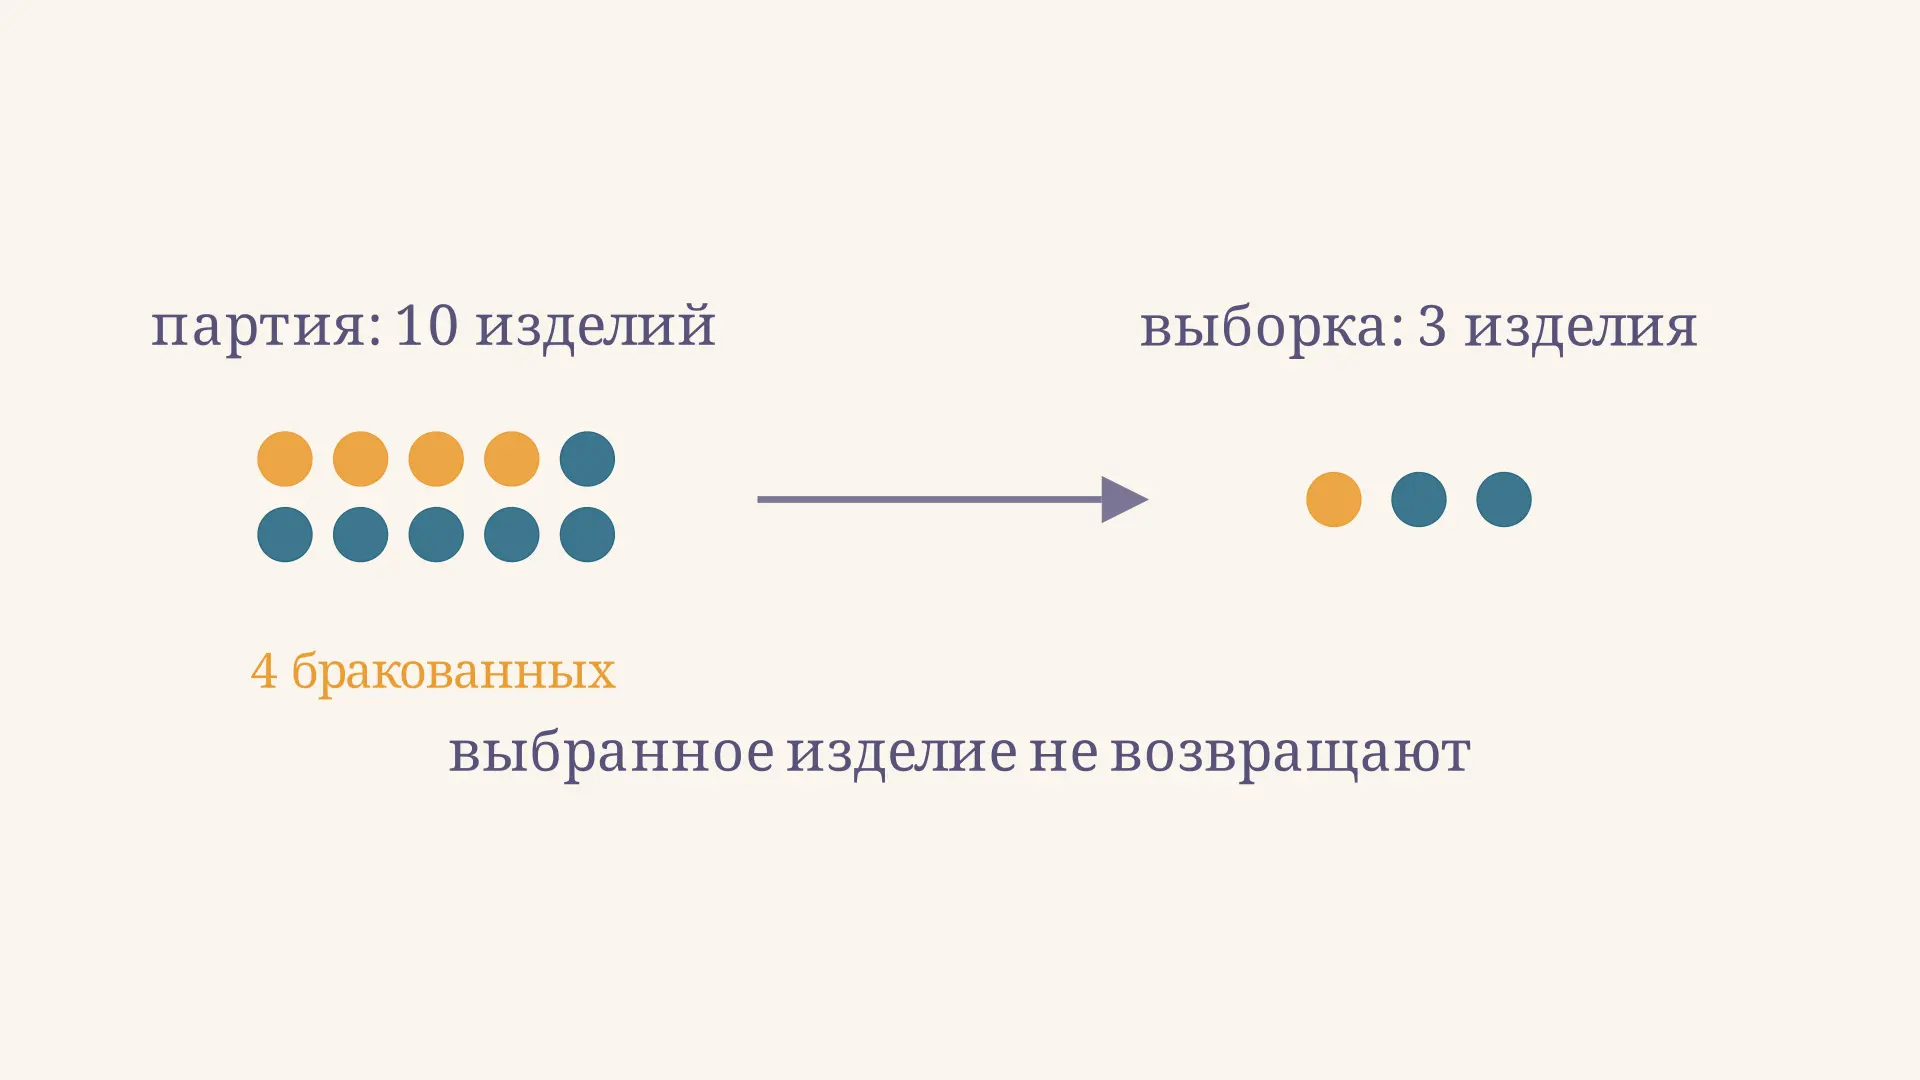
Бесповторный отбор: формулы и пример расчёта
Бесповторный отбор в статистике: как меняются вероятности, рассчитать состав случайной выборки и учесть конечную совокупность на примере контроля партии.