Парадокс Симпсона в статистике: пример и объяснение
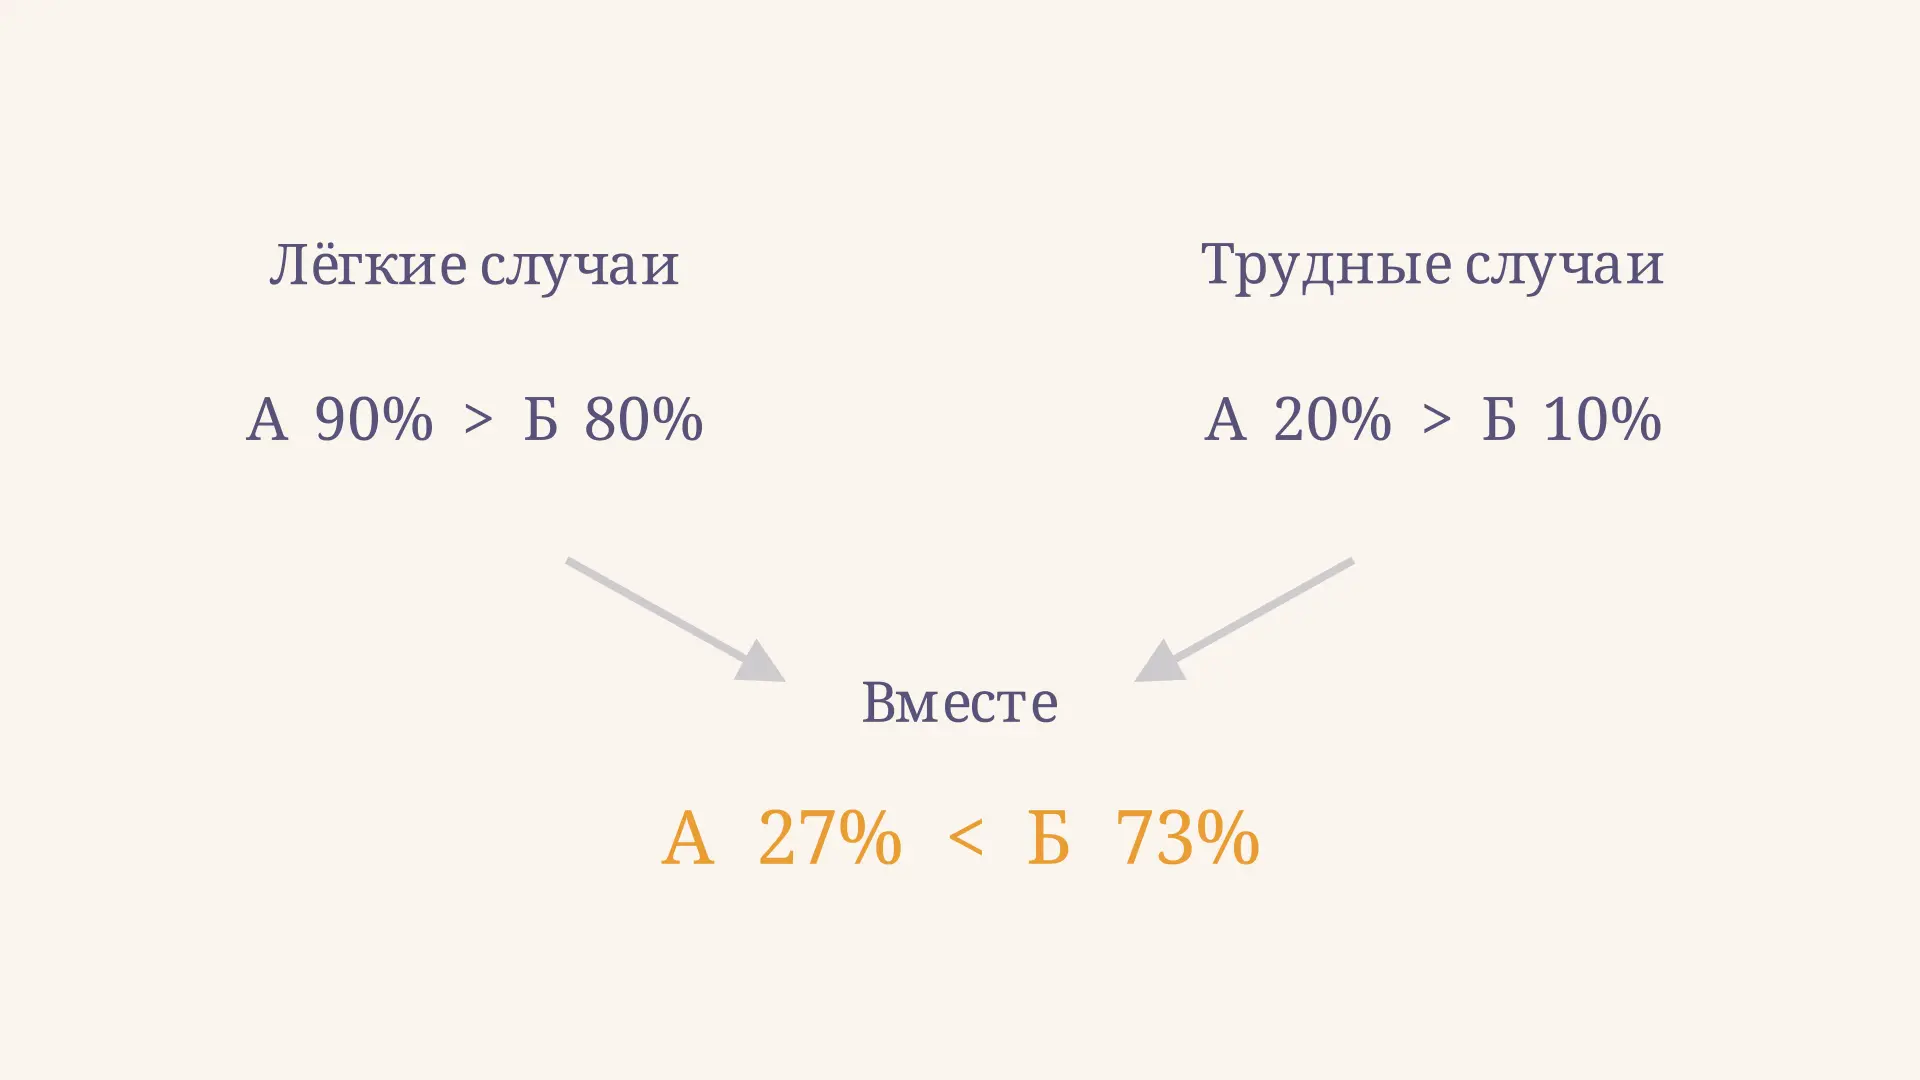
Парадокс Симпсона в статистике возникает, когда направление сравнения внутри каждой группы меняется на противоположное после объединения данных. Например, один метод успешнее другого отдельно в лёгких и трудных случаях, но проигрывает по общему проценту. Противоречия в арифметике нет: общий процент учитывает группы с разными весами. Ниже разберём учебный пример, а в калькуляторе можно изменить состав групп и увидеть, когда порядок меняется.
Как выглядит парадокс Симпсона
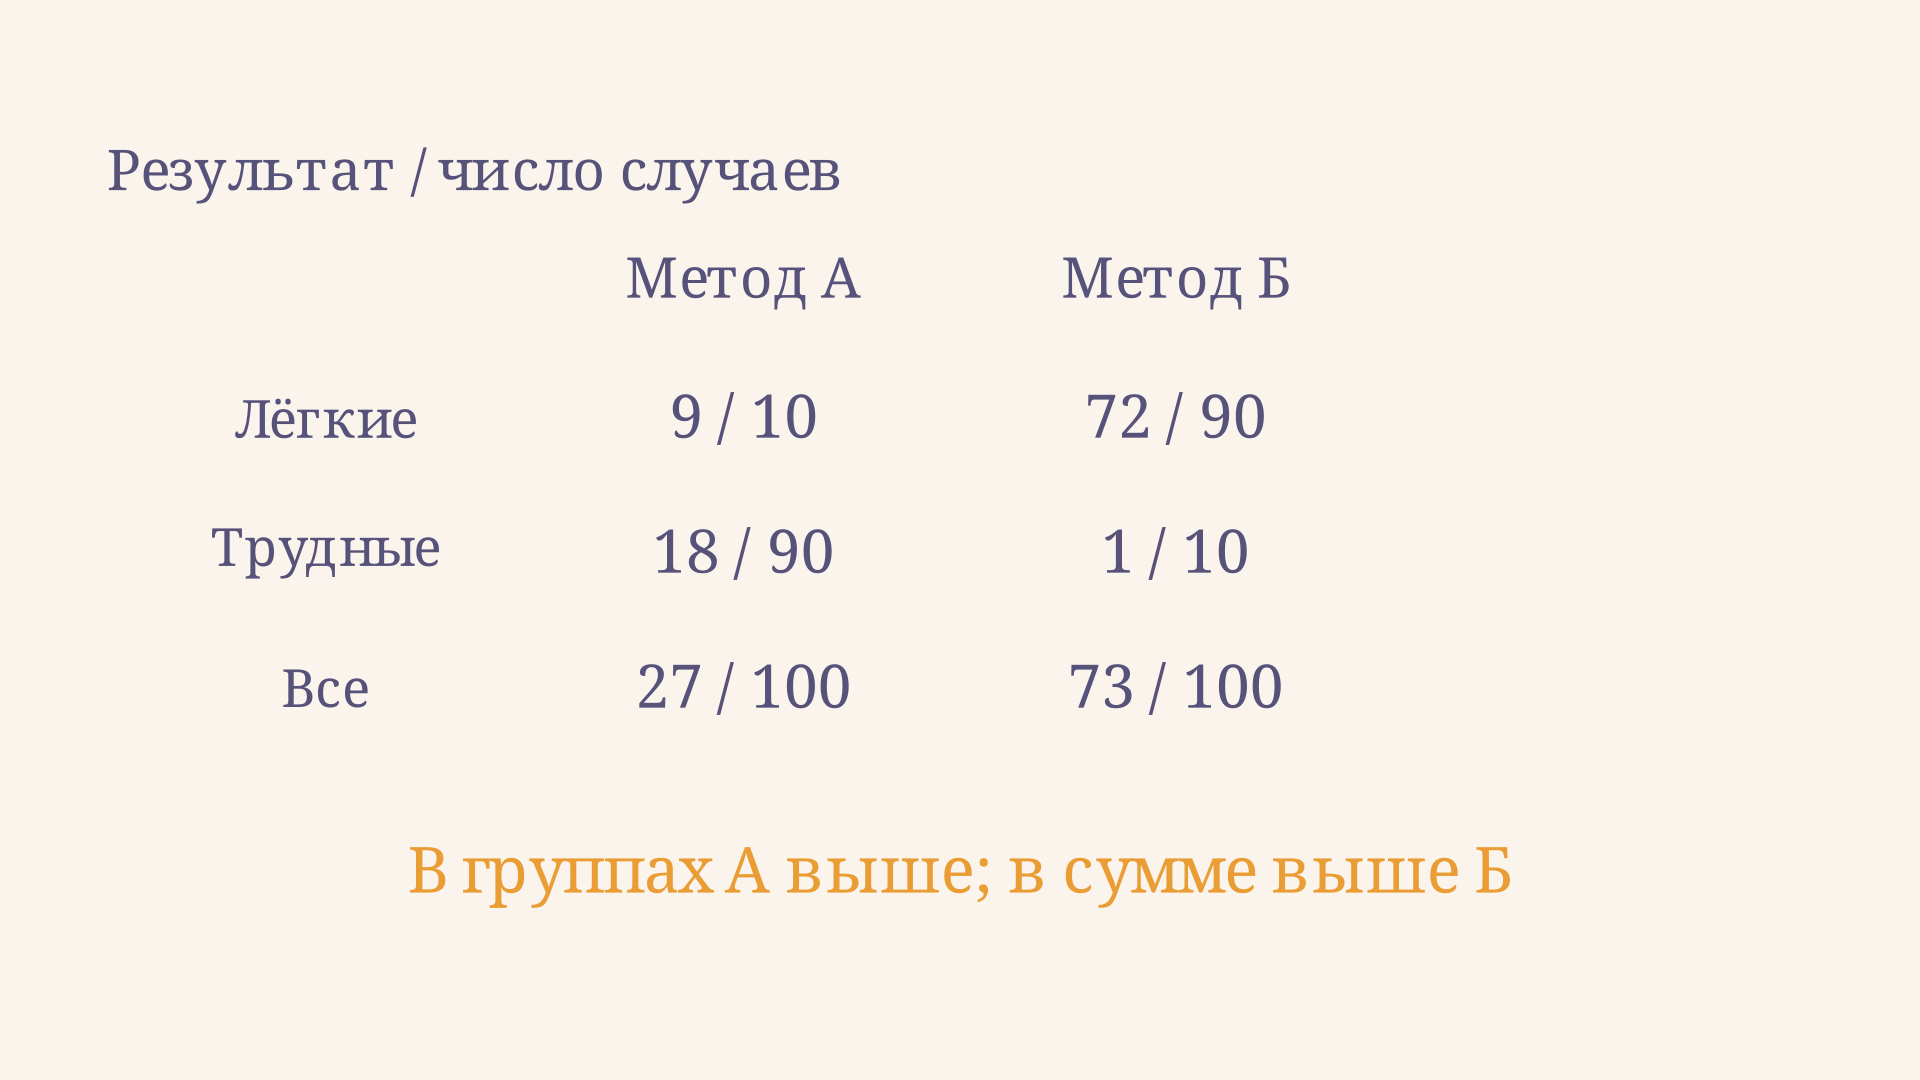
Представим два метода решения задач, А и Б, и два уровня сложности. Числа вымышленные: они нужны для объяснения, а не описывают реальное исследование. Успехом назовём правильно решённую задачу. В каждой строке делим число успехов на число задач соответствующего метода и уровня.
| Уровень | Метод А | Метод Б |
|---|---|---|
| Лёгкий | 9 из 10 = 90 % | 72 из 90 = 80 % |
| Трудный | 18 из 90 = 20 % | 1 из 10 = 10 % |
| Все задачи | 27 из 100 = 27 % | 73 из 100 = 73 % |
Метод А впереди на 10 процентных пунктов и среди лёгких задач, и среди трудных. Но при объединении метод Б имеет 73 % успеха против 27 % у А. Различие возникает потому, что А досталось много трудных задач, а Б - много лёгких. Сравнение внутри уровня отвечает на вопрос о долях при фиксированной сложности; итоговая строка описывает результаты при фактических, разных составах.
Движение показывает именно роль состава: оно не меняет 90 %, 80 %, 20 % и 10 % внутри групп. В середине ролика лёгких случаев больше у А, поэтому общая картина уже иная. Затем состав возвращается к исходному.
Почему итоговые проценты переворачиваются
Общий процент - это взвешенное среднее групповых процентов. Для метода А обозначим долю лёгких случаев через , а доли успеха в лёгкой и трудной группах через и . Тогда
Аналогичная формула действует для метода Б со своим весом . В примере , а . Поэтому , тогда как .
Можно получить те же числа суммированием числителей и знаменателей: у А успехов на задач, у Б на . Важно не усреднять 90 % и 20 % поровну, когда реальные размеры групп равны 10 и 90. Обычное среднее процентов дало бы 55 %, но это ответ для другого состава, с равными весами.
Само различие весов ещё не гарантирует переворот: оно должно быть достаточно большим относительно различий внутри групп. Перед интерпретацией полезно выписать и проценты, и исходные численности. Это также позволяет заметить маленькие группы, где одна дополнительная удача сильно изменит процент.
Одинаковые веса и стандартизация
Чтобы сравнить методы на одном составе задач, выберем общие веса: 50 % лёгких и 50 % трудных. Применим их к обоим наборам групповых долей:
Получаем 55 % против 45 %. Это стандартизованные показатели для выбранного состава, а не фактические общие проценты из таблицы. Иные общие веса тоже сохранят здесь преимущество А на 10 пунктов: разница внутри обеих групп одинакова. В других данных величина стандартизованной разницы будет зависеть от выбранных весов.
Веса выбирают по смыслу задачи: например, по распределению сложности в целевой совокупности. Если какой-то уровень почти отсутствует или совсем не представлен у одного из методов, надёжно оценить его результат на этом уровне трудно или невозможно. Подробнее о различии между наблюдаемой выборкой и генеральной совокупностью важно помнить до переноса вывода на новые данные.
Как проверить данные пошагово
- Определите исход и знаменатель: что считается успехом и сколько наблюдений было у каждого метода.
- Разбейте данные по переменной, которая может влиять на исход и распределена между методами неодинаково. В примере это сложность.
- Вычислите доли отдельно в каждом слое, затем - по объединённым данным из сумм успехов и численностей.
- Сравните не только проценты, но и веса слоёв. При необходимости пересчитайте оба метода на одном заранее выбранном составе.
- Проверьте контекст: как выбирали метод, какие факторы не измерили и насколько устойчивы оценки при малых числах.
Направление связи может различаться и при рассмотрении других признаков. Так, частная корреляция помогает изучать линейную связь с учётом другой переменной, но её коэффициент не заменяет анализ структуры групп и причинных предположений. Корреляции, доли и разности процентов отвечают на разные вопросы.
Какой вывод выбрать: общий или по группам
Ни одна строка таблицы не является автоматически «правильной» для любого вопроса. Если нужно описать фактически достигнутую долю успеха в каждой группе метода, общие 27 % и 73 % корректны. Если интересует сравнение при одинаковой сложности, подходят слоевые или стандартизованные показатели. Но чтобы утверждать, что назначение А вызывает больше успехов, одной таблицы недостаточно.
Допустим, сложность известна до выбора метода и влияет и на выбор, и на исход. Тогда она может быть смешивающим фактором: сравнение на одном уровне сложности помогает устранить именно это смешение. Однако остаются возможные различия в подготовке, качестве измерения и других признаках. Нужно понимать, как собирали данные и назначали методы.
Бывает и обратная ситуация: переменная появляется после применения метода или зависит одновременно от метода и других причин исхода. Механическая корректировка по ней способна исказить оценку. Выбор переменных для причинного анализа определяется не только таблицей, но и предположениями о причинных связях; это подчёркивается в работе Джудеи Перла о причинном выводе. Исходная статья Эдварда Симпсона 1951 года рассматривала интерпретацию взаимодействия в таблицах сопряжённости.
Где ещё встречается эффект
Та же арифметика возможна при сравнении успеваемости школ с разным составом учащихся, конверсии рекламных каналов с разной аудиторией или результатов отделений с разной тяжестью случаев. Это не значит, что в каждом таком сравнении уже обнаружен парадокс: для него нужно проверить конкретные условные и общие показатели.
Например, высокий общий процент поступления в вуз может объясняться разным выбором направлений с различной конкуренцией. Для содержательного сравнения нужны данные по направлениям и понимание механизма выбора. В любом примере агрегированный показатель может быть полезен для описания нагрузки, но скрывать различия между слоями.
Название легко спутать с другими понятиями. Метод Симпсона в интегрировании приближает площадь под кривой, а индекс разнообразия Симпсона описывает разнообразие состава. Оба относятся к другим задачам и не являются этим статистическим парадоксом.
Когда результат чувствителен к составу
В калькуляторе можно оставить долю лёгких задач у Б равной 90 %, а затем постепенно увеличивать её у А. Групповые результаты при этом не меняются, но общий показатель А растёт: каждая дополнительная доля лёгких случаев заменяет такую же долю трудных. При 10 % лёгких задач у А его результат составляет 27 %, при 90 % - уже 83 %. В обоих случаях доля успеха Б при неизменном составе остаётся 73 %. Значит, изменение порядка не требует ни ошибки в записи, ни изменения качества методов внутри слоёв.
В реальной таблице граница между лёгкими и трудными случаями может быть определена неточно, а внутри каждой категории сохраняться значительные различия. Поэтому полезно проверить несколько содержательно обоснованных способов группировки и показать читателю, как они влияют на вывод. Такая проверка не даёт права выбирать разбиение только потому, что оно подтверждает желаемый ответ. Если отдельные ячейки малы, рядом с процентами особенно нужны численности и интервалы неопределённости. Объединение групп повышает число наблюдений, но при этом может скрыть важную неоднородность.
Частые ошибки
- Усреднять проценты без весов. Сначала найдите численности групп и вычислите итог как сумму успехов, делённую на сумму наблюдений.
- Называть любой разрыв парадоксом. Для приведённой формы требуется обратный порядок общего сравнения относительно порядка в каждой рассматриваемой группе.
- Всегда доверять только детализации. Стратификация по неподходящей переменной может сама внести смещение; выбор зависит от вопроса и причинной схемы.
- Путать описание с эффектом вмешательства. Доли в наблюдаемых данных не гарантируют, что назначение метода изменит исход на ту же величину.
- Игнорировать неопределённость. В малых группах проценты нестабильны; для обобщения нужны интервалы неопределённости и сведения о дизайне исследования.
FAQ
Парадокс Симпсона нарушает правила вероятности?
Нет. Условные и общие вероятности относятся к разным распределениям. Формула полной вероятности учитывает веса групп и точно объясняет оба результата.
Достаточно ли обнаружить переворот, чтобы найти причину?
Нет. Переворот показывает зависимость сравнения от группировки. Для причинного вывода нужны дизайн исследования, предположения о факторах и оценка возможных смещений.
Может ли парадокс исчезнуть при равных весах?
Да. Если в каждом слое А строго превосходит Б и оба результата усредняются с одними и теми же неотрицательными весами, А останется впереди. В примере равные веса дают 55 % против 45 %.
Коротко
Парадокс Симпсона - изменение направления сравнения при объединении групп из-за разных весов. В примере А лучше в каждой группе, но его общий результат ниже из-за преобладания трудных случаев. Сверяйте числители, знаменатели и состав групп, а для причинного вывода дополнительно изучайте дизайн и причинные связи.
Читайте также
Анализ выживаемости Каплана-Мейера: пример расчёта
Анализ выживаемости Каплана-Мейера: как построить ступенчатую кривую, учесть цензурирование, рассчитать медиану и правильно прочитать результат на примере.
Доверительная вероятность и уровень значимости
Как связаны доверительная вероятность и уровень значимости: формула, смысл ошибок, пример доверительного интервала среднего и проверка двусторонней гипотезы.
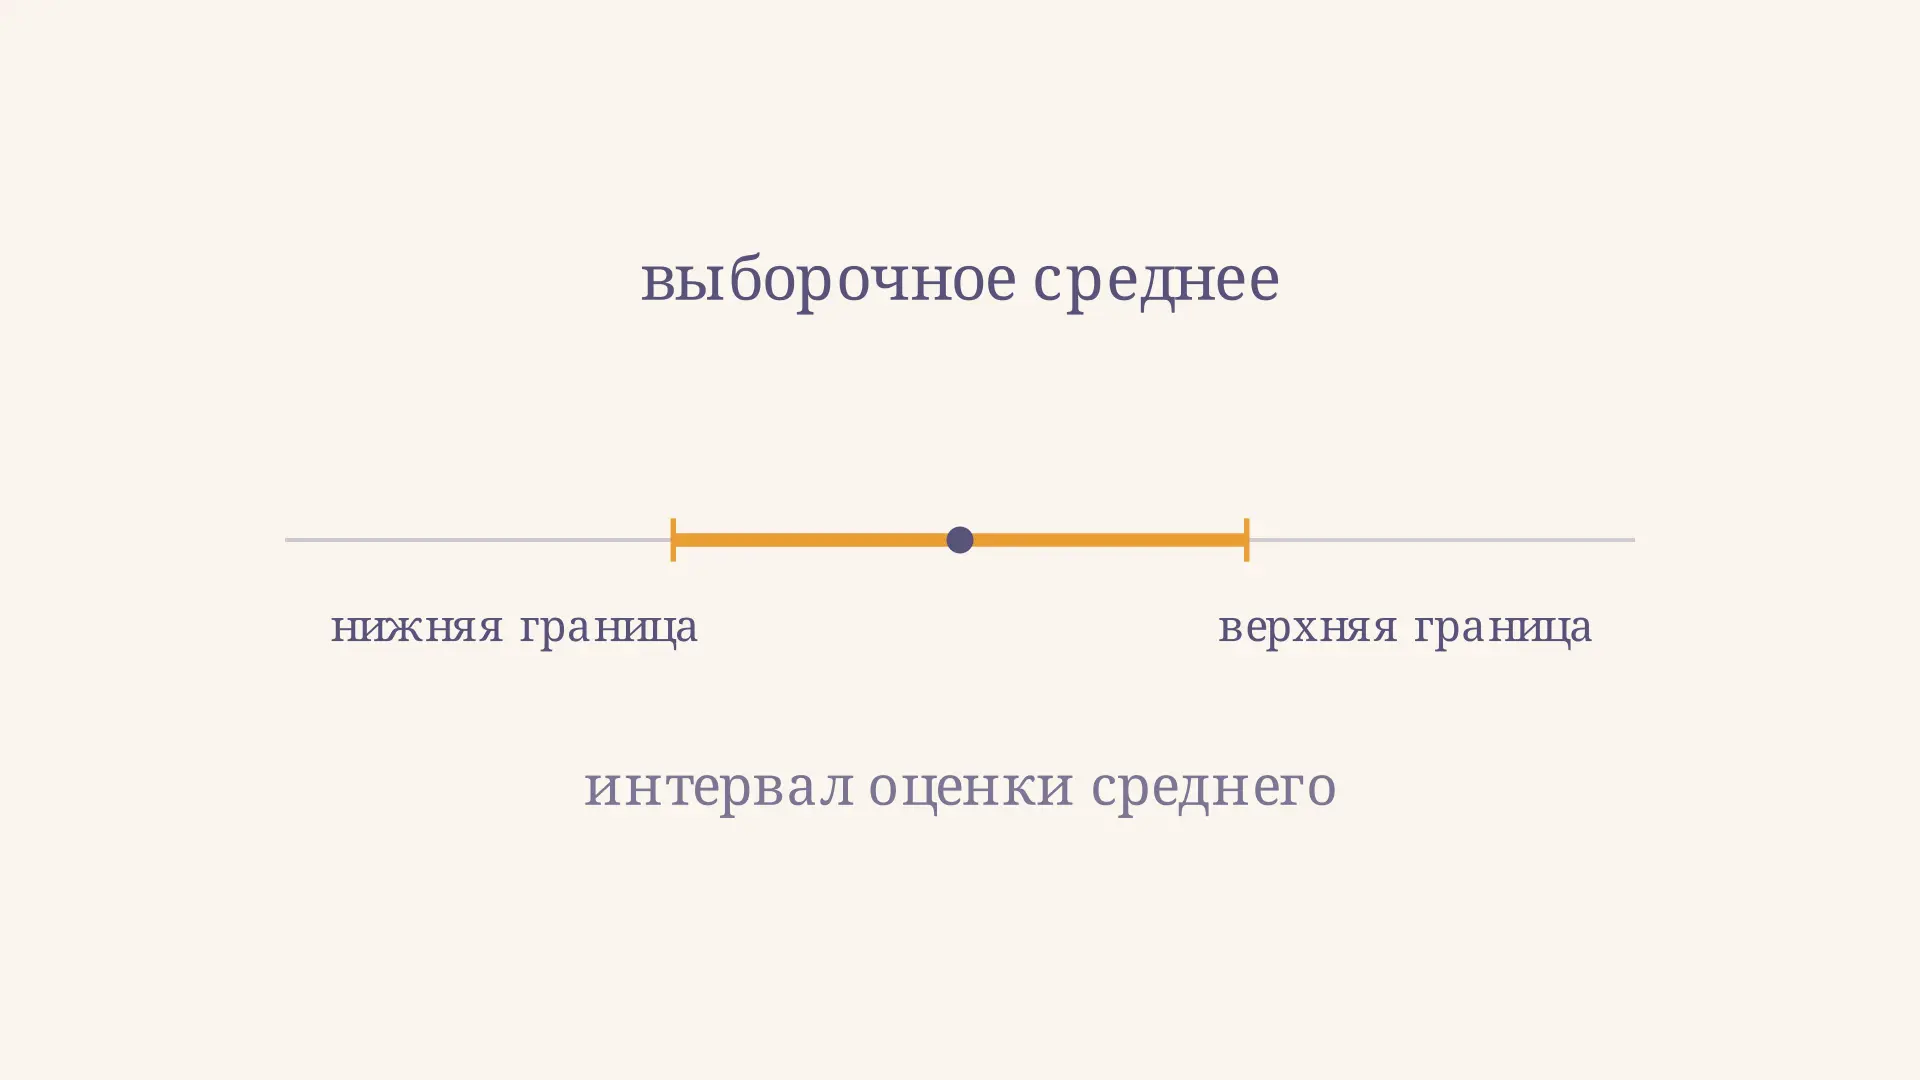
Доверительный интервал среднего при неизвестной дисперсии
Как построить доверительный интервал для математического ожидания при неизвестной дисперсии: формула Стьюдента, условия, пример расчёта и интерпретация.
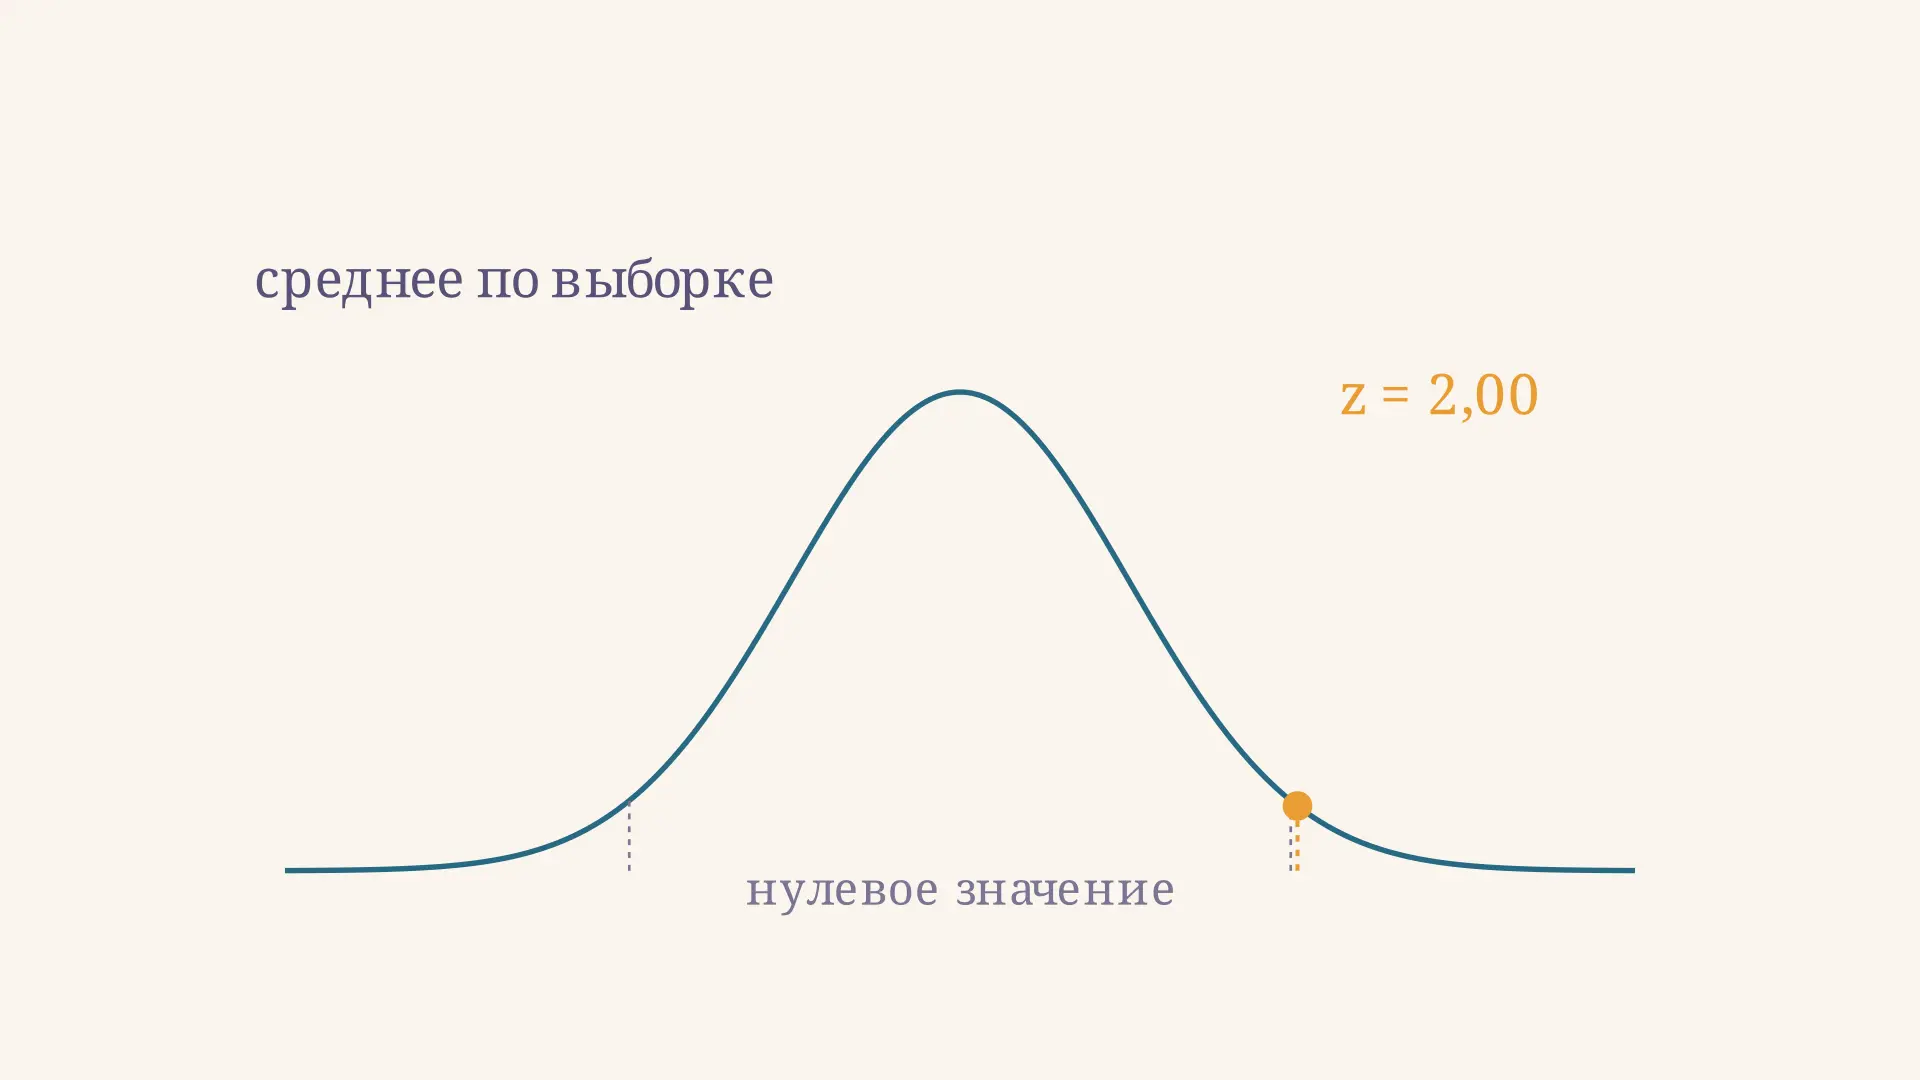
Проверка гипотезы о среднем нормального распределения
Как проверить гипотезу о среднем нормального распределения: выбор Z- или t-критерия, формулы, пример расчёта, критические области и интерпретация результата.
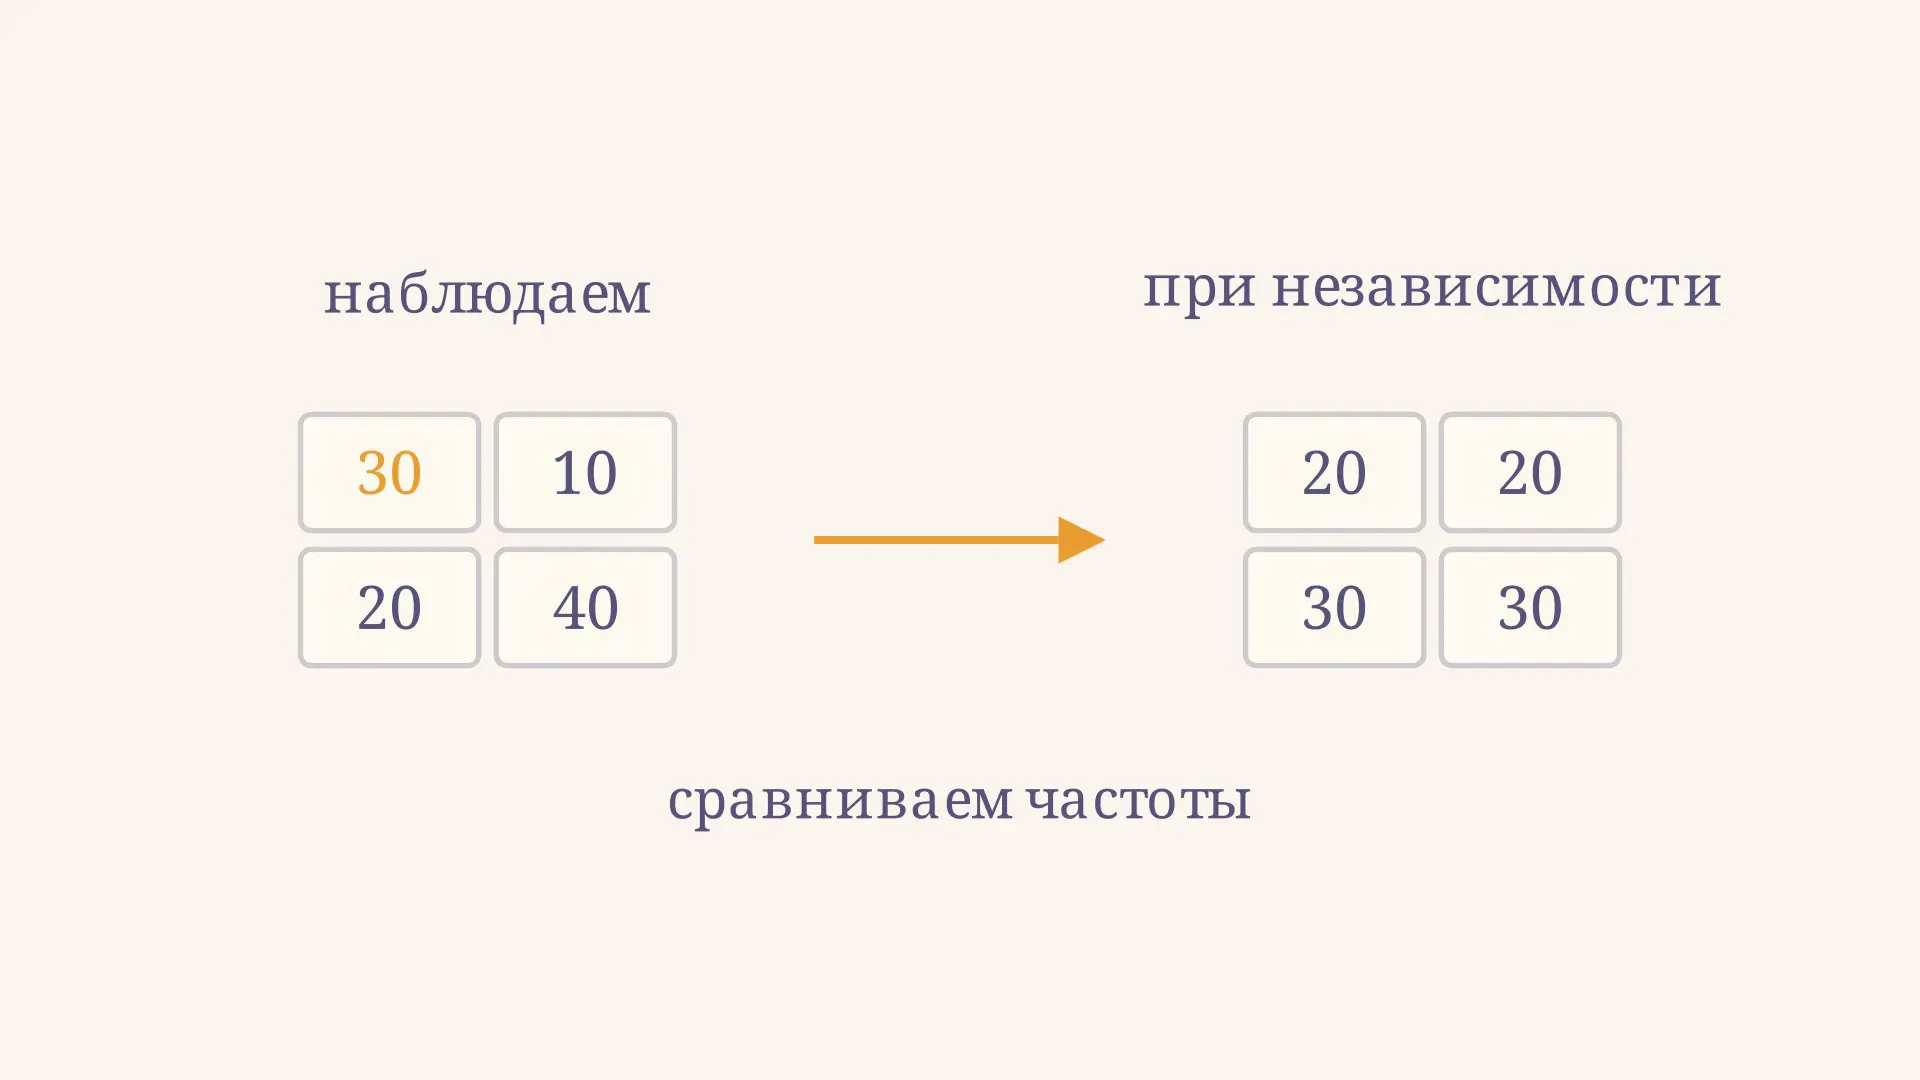
Таблица сопряжённости и критерий хи-квадрат Пирсона
Как проверить независимость признаков по таблице сопряжённости: ожидаемые частоты, расчёт хи-квадрат Пирсона, степени свободы, p-значение и ограничения метода.
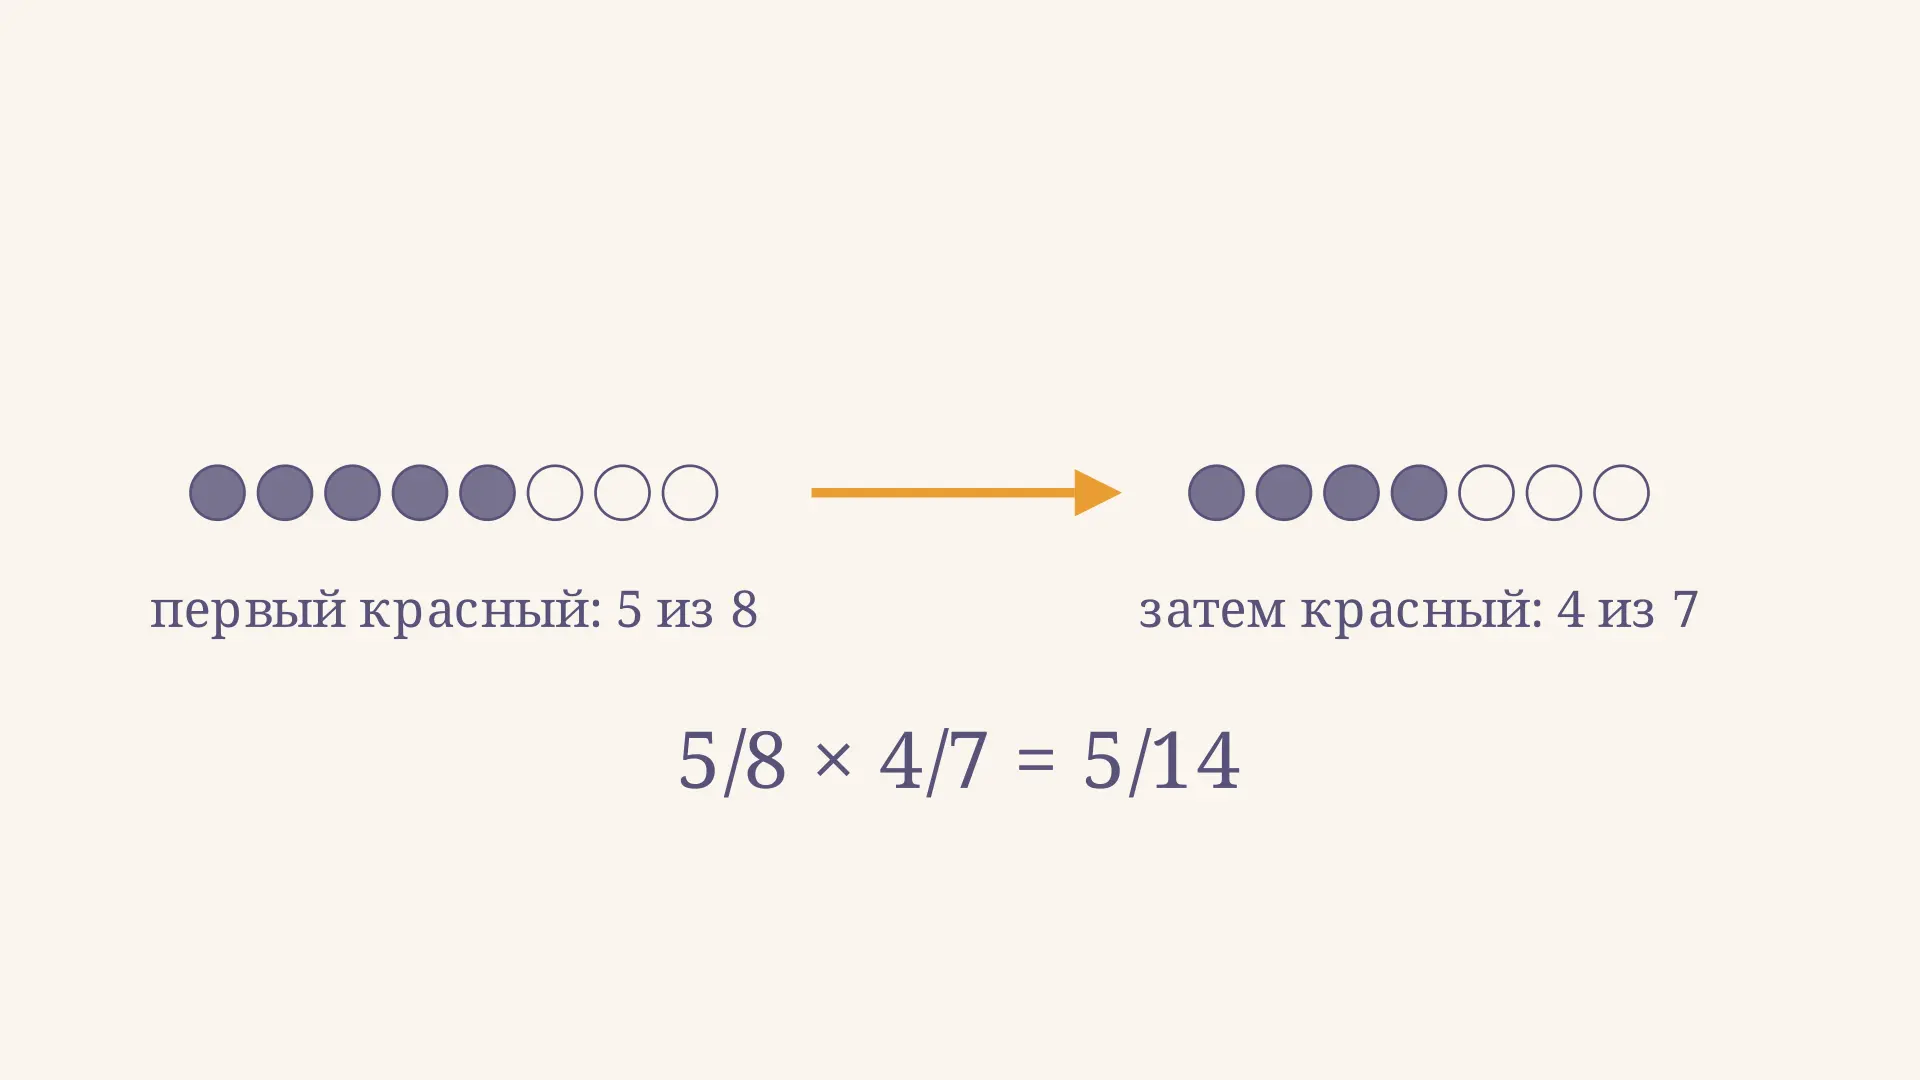
Теорема умножения вероятностей зависимых событий
Как найти вероятность нескольких зависимых событий: формула умножения, условные вероятности, подробный пример с шарами и проверка ответа на дереве исходов.