Доверительный интервал среднего при неизвестной дисперсии
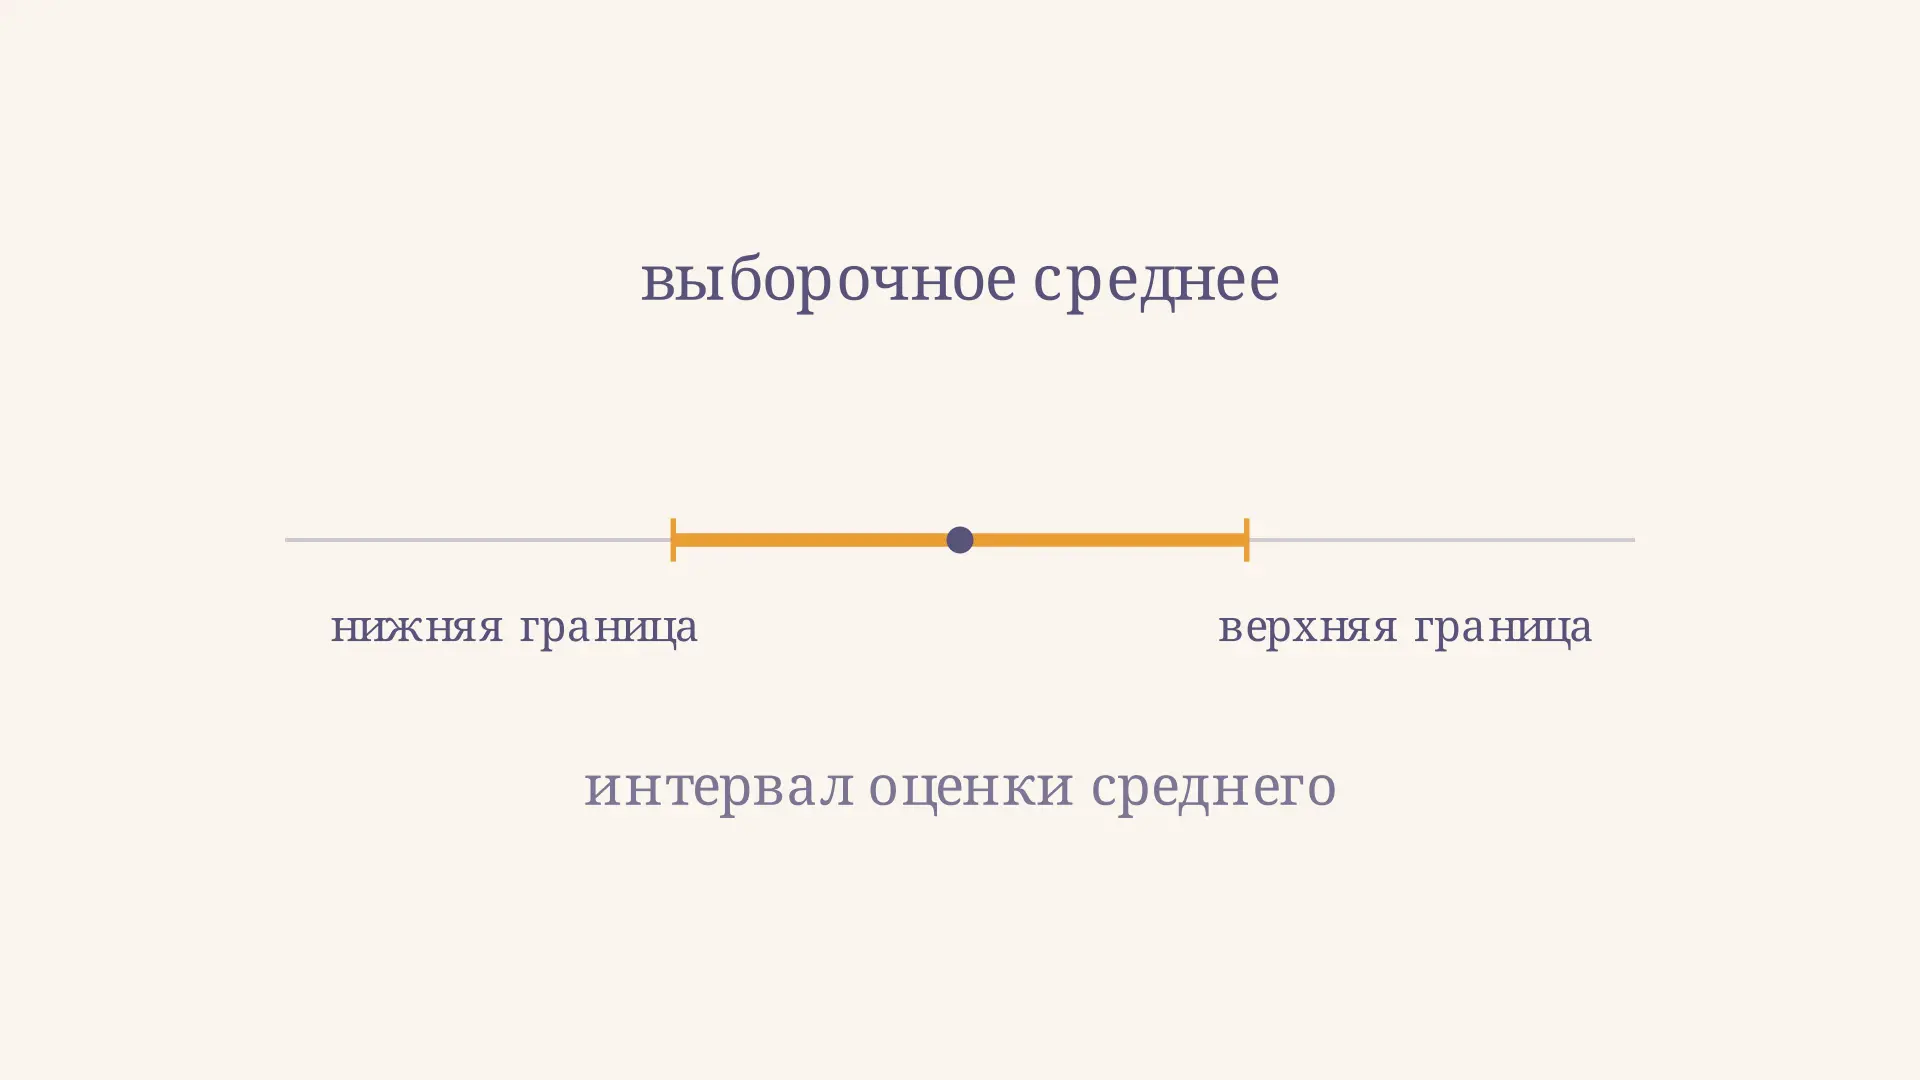
Выборочное среднее даёт одну оценку математического ожидания, но другая случайная выборка дала бы другое число. Доверительный интервал помогает выразить эту неопределённость границами. Когда дисперсия генеральной совокупности неизвестна и оценивается по тем же наблюдениям, для классического двустороннего интервала используют распределение Стьюдента.
Калькулятор ниже показывает, как меняются границы 95%-го интервала при разных объёме, среднем и выборочном стандартном отклонении. Начальные значения соответствуют примеру из статьи; результат предполагает независимые наблюдения из нормальной совокупности.
Какую величину оценивает интервал
Пусть - независимые одинаково распределённые наблюдения с неизвестным математическим ожиданием и неизвестной дисперсией . Параметр относится ко всей совокупности, а не только к имеющимся данным. Например, это среднее значение признака среди всех объектов, из которых случайно выбирают наблюдения. Различие между параметром и его оценкой подробнее разобрано в статье о генеральной совокупности и выборке.
Среднее - центр интервала, но оно не сообщает само по себе, насколько точна оценка. Для этого нужны разброс наблюдений и число независимых данных. При одинаковых оценках разброса увеличение уменьшает стандартную ошибку, а также меняет критическое значение. На видео показано именно такое сравнение: среднее и удерживаются постоянными, а объём выборки увеличивается и возвращается обратно. Это сравнение моделей, а не утверждение, что при добавлении реальных данных и среднее обязательно сохранятся.
Формула и смысл её частей
Для независимой выборки из нормального распределения двусторонний интервал уровня имеет вид:
где
Здесь - выборочное стандартное отклонение с поправкой Бесселя, - оценка стандартной ошибки среднего, а - соответствующий квантиль распределения Стьюдента. Произведение квантили на стандартную ошибку называют половиной ширины, или предельной погрешностью. Та же формула и обозначения приведены в справочнике NIST.
Для 95 % берут : вне центральной области остаётся по в каждом хвосте, поэтому нужна квантиль порядка . Некоторые таблицы обозначают её через вероятность в правом хвосте ; важно проверить заголовок таблицы. Это двусторонний интервал: для односторонней границы квантиль выбирают иначе.
Почему появляется распределение Стьюдента
Если бы была известна, нормированное среднее делили бы на и использовали нормальное распределение. Здесь же заменена случайной величиной , вычисленной по той же выборке. При нормальности исходной совокупности статистика
имеет распределение Стьюдента с степенями свободы. Из отклонений от среднего последнее определяется остальными: их сумма равна нулю. Поэтому в оценке дисперсии остаётся свободных отклонений. Для вычисления необходимо хотя бы два наблюдения.
У распределения Стьюдента более тяжёлые хвосты, чем у стандартного нормального: оценённый разброс добавляет неопределённость. При увеличении числа степеней свободы оно приближается к нормальному. Как меняется его форма, показано отдельно в статье о распределении Стьюдента и степенях свободы.
Расчёт на конкретной выборке
Возьмём учебные данные: . Единицы измерения не заданы; для величины в сантиметрах границы также выражались бы в сантиметрах. Предположим, что выполнены условия модели, и построим 95%-й интервал.
- Число наблюдений , сумма равна , поэтому .
- Сумма квадратов отклонений от 12 равна . Исправленная дисперсия , а .
- Стандартная ошибка .
- Для девяти степеней свободы . Половина ширины равна .
- Получаем , то есть приблизительно после округления границ.
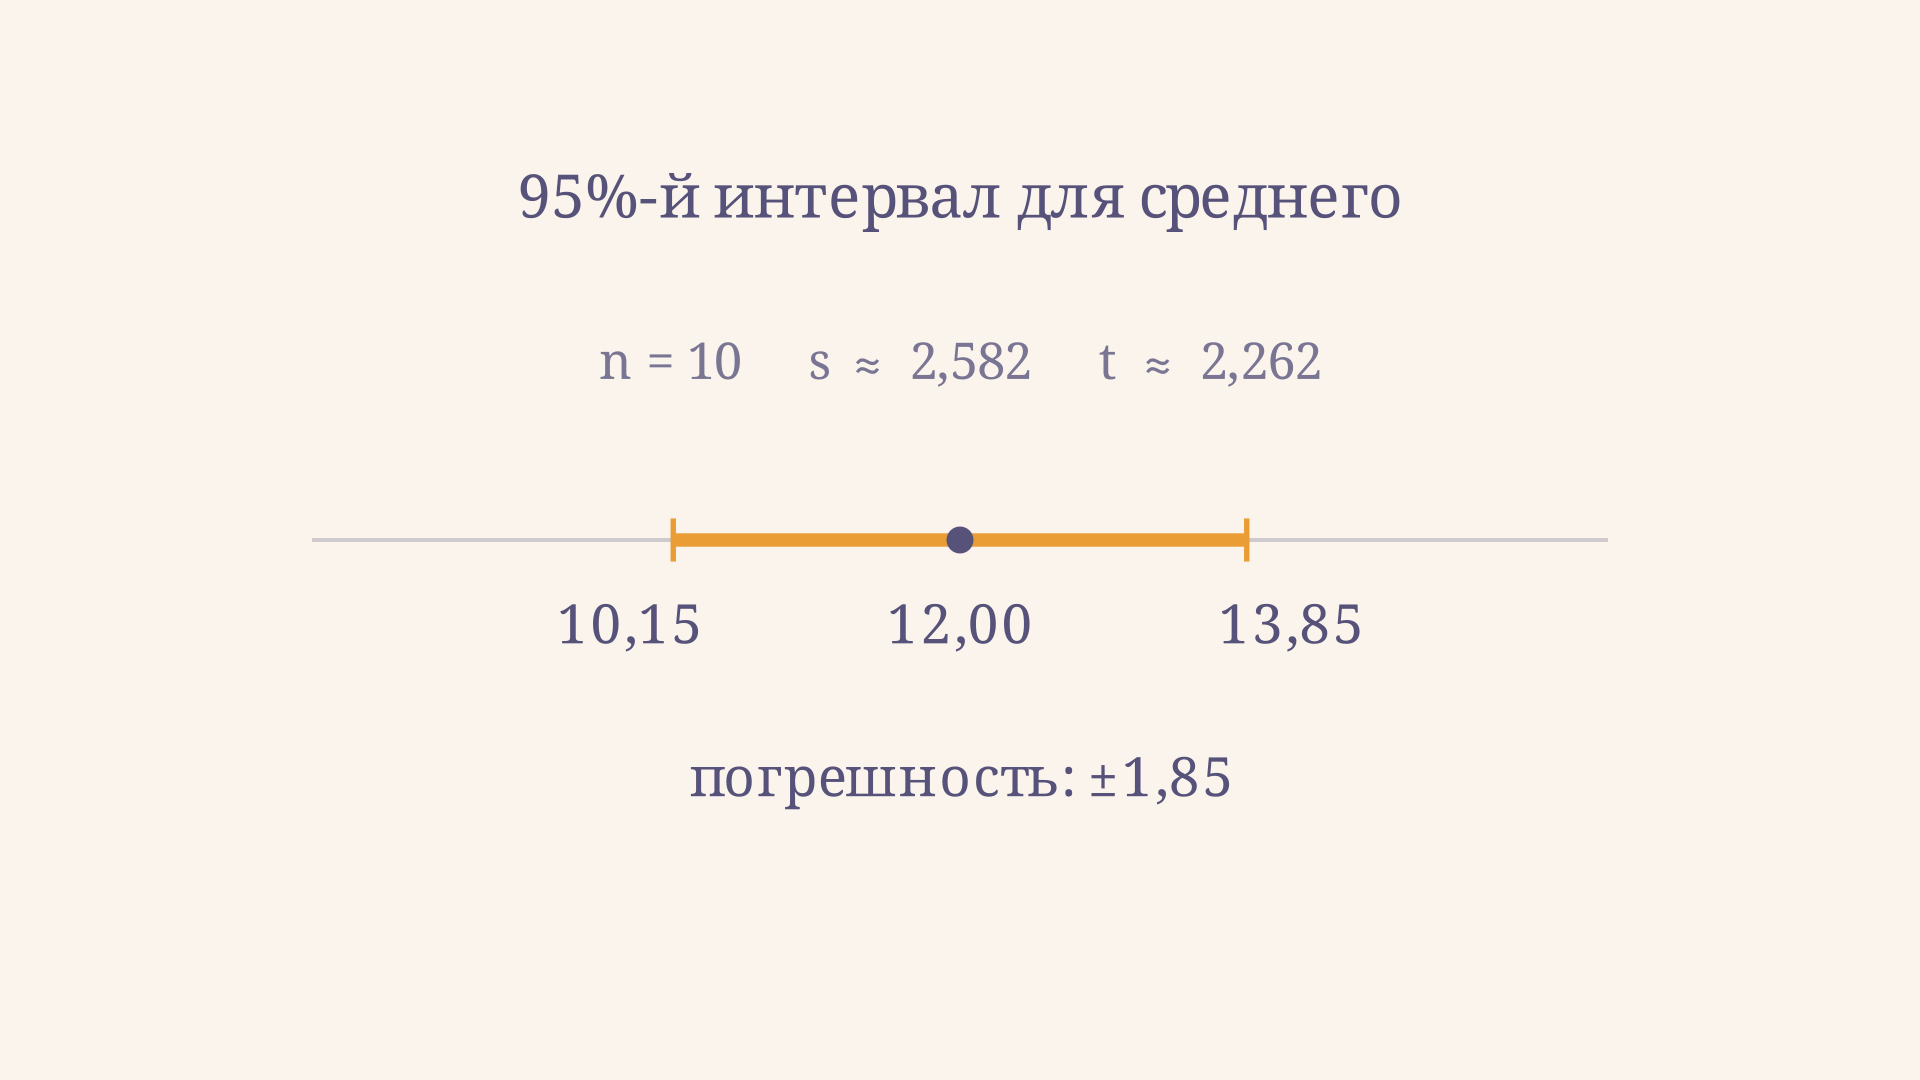
Промежуточные вычисления лучше вести с дополнительными знаками и округлять границы в конце. В калькуляторе исходное хранится без промежуточного округления, хотя на экране показаны два знака. Получившаяся ширина относится к оценке среднего, а не к разбросу отдельных наблюдений.
Как понимать уровень доверия
В частотной интерпретации - фиксированный параметр, а границы интервала зависят от случайной выборки. Если многократно независимо повторять выборку по одной схеме и каждый раз строить интервал тем же способом, около 95 % таких интервалов будут содержать истинное при выполнении модели. Для уже вычисленного интервала параметр либо находится внутри, либо нет; число 95 % характеризует процедуру до наблюдения данных.
Поэтому фраза «вероятность того, что фиксированное лежит в полученном интервале, равна 95 %» не является частотной интерпретацией. Вероятностное высказывание о параметре после наблюдения данных требует другой, например байесовской, модели. Уровень доверия также не означает, что внутри интервала лежат 95 % отдельных измерений: это уже вопрос о распределении наблюдений или о прогнозном интервале.
Когда формула применима
Точное покрытие уровня обеспечивается для независимых одинаково распределённых нормальных наблюдений с конечной ненулевой дисперсией. Случайный отбор помогает связать выборку с интересующей совокупностью; коррелированные повторные измерения, например последовательные значения одного процесса, могут содержать меньше независимой информации, чем кажется по числу строк.
При ненормальной совокупности интервал для среднего часто применяют приближённо на достаточно большой выборке, но универсального порога нет: сильная асимметрия, тяжёлые хвосты и выбросы могут потребовать гораздо больше данных. На малой выборке форму распределения трудно проверить, а один выброс заметно меняет и среднее, и . Полезно изучить исходные данные, условия отбора и причину выброса, прежде чем выбирать модель; автоматически удалять неудобное значение нельзя. NIST отмечает, что малые выборки и сильные отклонения от нормальности особенно важны для надёжности приближения.
Если наблюдения зависимы, выборка имеет сложный дизайн или распределение сильно асимметрично, может понадобиться другая модель либо подход к оценке неопределённости. Одно увеличение числа записей не устраняет систематическую ошибку отбора. В задачах физических измерений отдельно рассматривают и другие источники неопределённости: см. обработку прямых многократных измерений.
От чего зависит ширина
При фиксированных данных переход от 95 % к 99 % увеличивает критическую квантиль и делает интервал шире: более высокий уровень покрытия требует более осторожной процедуры. При фиксированных и уровне доверия увеличение вдвое увеличивает половину ширины вдвое. При фиксированном рост уменьшает множитель ; квантиль Стьюдента тоже постепенно снижается.
В реальной новой выборке одновременно меняются и среднее, и оценка разброса. Поэтому отдельный более крупный набор данных не обязан дать более узкий интервал, хотя при прочих равных большая выборка обычно повышает точность. Для предварительного планирования нужно задавать ожидаемый разброс и проверять расчёт для подходящей модели; имеющийся маленький набор не гарантирует будущей ширины.
Как читать результат и записывать ответ
При решении задачи сначала обозначьте объект оценки: среднее всей совокупности, из которой получены наблюдения. Затем выпишите известные характеристики выборки и проверьте, как именно определено стандартное отклонение. Если в условии уже дано исправленное , повторно пересчитывать его с другим знаменателем не нужно. Если приведена дисперсия, перед подстановкой извлеките квадратный корень. Число степеней свободы следует из способа оценки, а не из числа знаков в таблице.
В ответе полезно указать уровень доверия, границы, единицы измерения и предположения, на которых основан расчёт. Например: «При предположении независимых нормальных наблюдений 95%-й доверительный интервал среднего составляет от 10,15 до 13,85 единицы». Такая запись отделяет результат вычисления от условий его надёжности. Если условия существенно нарушены, аккуратно рассчитанные границы сами по себе не обеспечивают заявленного покрытия.
Сравнивая два опубликованных интервала, проверьте, совпадают ли уровни доверия, определения признака и способы отбора. Более узкий интервал говорит о большей точности оценки в рамках соответствующей модели, но не доказывает отсутствия систематической ошибки. Интервалы для разных совокупностей могут различаться из-за состава выборок, метода измерения или действительно разных средних; только по ширине отличить эти причины нельзя.
Частые ошибки
- Подставлять дисперсию вместо стандартного отклонения. В формуле стоит , а не ; иначе нарушаются и единицы измерения.
- Делить сумму квадратов на . Для указанной t-формулы нужна исправленная выборочная дисперсия с делителем .
- Брать степеней свободы. При оценке среднего по той же выборке их ; в других моделях число может быть иным.
- Использовать 1,96 автоматически. Это нормальная квантиль; особенно при малом t-квантиль заметно больше.
- Приписывать интервалу причинный смысл. Он оценивает среднее в заданной модели и не исправляет смещение отбора или зависимость наблюдений.
FAQ
Можно ли построить интервал по одной точке? Нет, по одному значению нельзя оценить выборочную дисперсию с делителем . Нужны дополнительные данные или иная обоснованная модель неопределённости.
Почему 99%-й интервал шире 95%-го? При тех же данных и двусторонней процедуре квантиль для 99 % больше: на каждый хвост оставляют по 0,5 %, а не по 2,5 %.
Достаточно ли большой выборки для любого распределения? Нет. Качество приближения зависит от формы распределения, зависимости и способа отбора. Сильная асимметрия или тяжёлые хвосты могут сделать обычное приближение ненадёжным даже при сравнительно большом .
Коротко
При неизвестной дисперсии двусторонний интервал среднего равен . Для нормальной независимой выборки его покрытие точно равно заданному уровню. В примере десять наблюдений дали среднее 12 и 95%-й интервал приблизительно от 10,15 до 13,85. Уровень доверия описывает долю успешных интервалов при повторении процедуры, а качество конкретного вывода зависит от условий модели и отбора.
Читайте также
Доверительная вероятность и уровень значимости
Как связаны доверительная вероятность и уровень значимости: формула, смысл ошибок, пример доверительного интервала среднего и проверка двусторонней гипотезы.
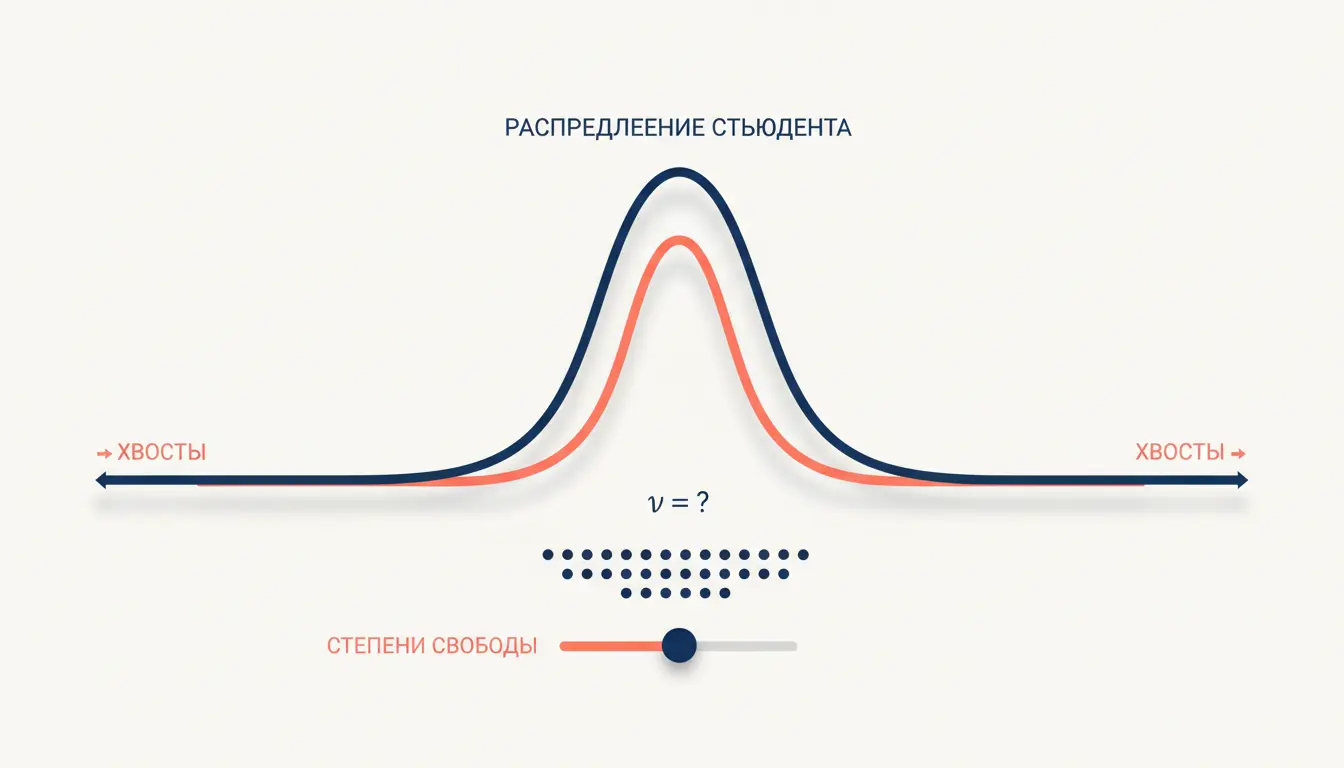
Распределение Стьюдента: роль степеней свободы
Распределение Стьюдента и его степени свободы: что такое параметр df, как он меняет форму t-распределения, как считать критические значения и применять в t-тестах и доверительных интервалах.
Анализ выживаемости Каплана-Мейера: пример расчёта
Анализ выживаемости Каплана-Мейера: как построить ступенчатую кривую, учесть цензурирование, рассчитать медиану и правильно прочитать результат на примере.
Неравенство Маркова и Чебышёва: сравнение оценок
Неравенства Маркова и Чебышёва оценивают вероятность по среднему и дисперсии. Сравним границы одного события, проверим условия и разберём примеры равенства.
Парадокс Симпсона в статистике: пример и объяснение
Парадокс Симпсона в статистике: как направление сравнения меняется при объединении групп, почему важны веса и когда стратификация помогает избежать ошибки.
Проверка гипотезы о среднем нормального распределения
Как проверить гипотезу о среднем нормального распределения: выбор Z- или t-критерия, формулы, пример расчёта, критические области и интерпретация результата.