Propensity score matching: подбор сравнимых групп
Допустим, экономист изучает, повысили ли курсы переквалификации доход участников. Простое сравнение выпускников курсов с остальными может обмануть: на обучение записываются люди с иным опытом, возрастом или положением на рынке труда. Разница доходов тогда смешивает возможный эффект курсов с исходными различиями групп.
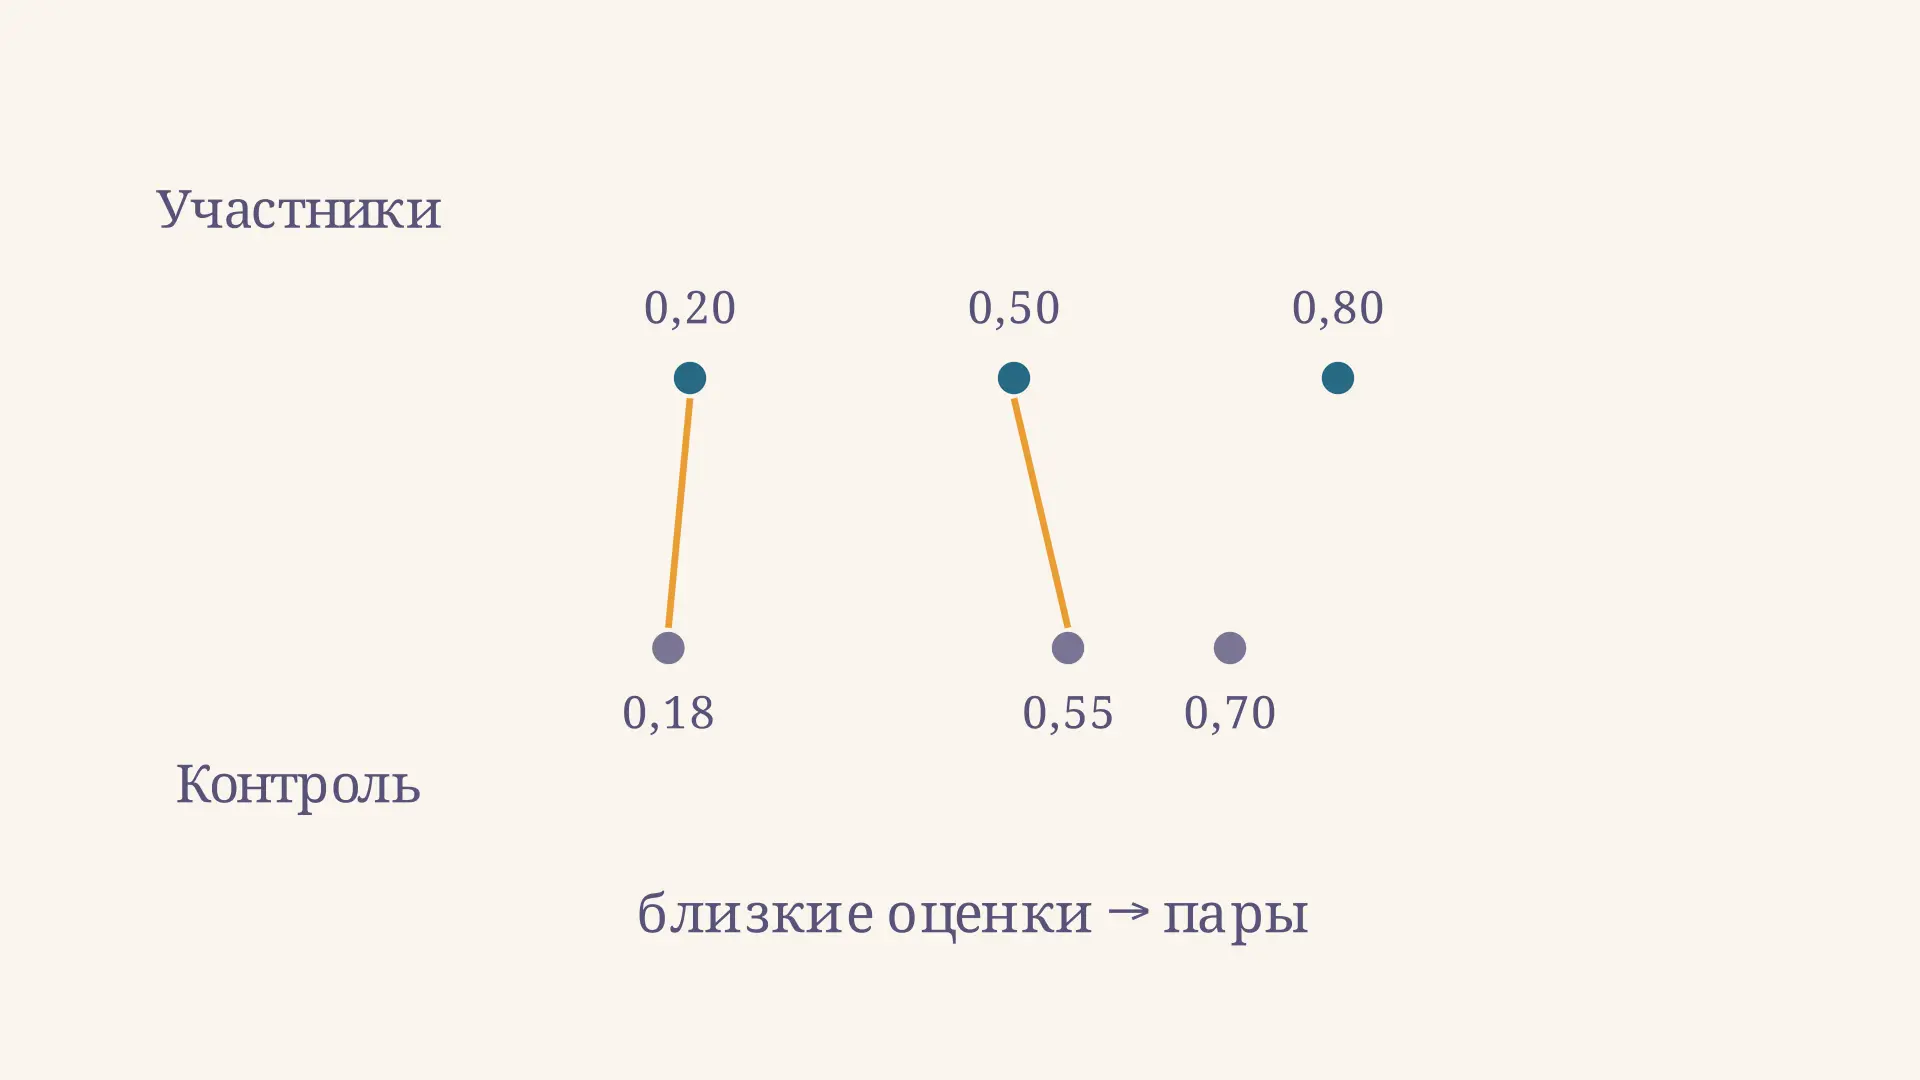
Propensity score matching (PSM) - сопоставление по оценке склонности к участию. Сначала для каждого человека оценивают вероятность попасть в программу по признакам, известным до её начала. Затем участникам подбирают людей из контрольной группы с близкими оценками. Попробуйте менять допустимое расстояние в учебном примере: оно влияет и на число пар, и на среднюю разницу результатов.
Зачем нужна оценка склонности
В идеальном сравнении мы знали бы доход одного и того же человека и после участия, и без участия в тот же период. В действительности наблюдается только один исход. Второй, потенциальный, приходится оценивать по другим людям. Если распределение в программу было случайным, группы при достаточно большом числе наблюдений обычно сопоставимы по исходным характеристикам. В наблюдательных данных решение об участии часто связано с этими характеристиками.
Обозначим участие через : единица означает участие, ноль - контроль. Вектор содержит измеренные до программы признаки. Оценка склонности определяется как
Это вероятность участия при данных признаках, а не вероятность успеха программы и не сам эффект. Её часто оценивают логистической регрессией, хотя возможны и другие модели. В исходной работе Розенбаума и Рубина оценка склонности рассматривается как способ балансировать наблюдаемые ковариаты. Работа с несколькими объясняющими переменными напоминает множественную регрессию, но цель модели здесь - построить сравнение, а не просто предсказать исход.
Как образуются пары
При подборе ближайшего соседа для каждого участника ищут контрольное наблюдение с минимальной абсолютной разницей оценок. Можно задать допуск (caliper): если даже ближайший кандидат находится дальше этого порога, пара не создаётся. На видео допуск растёт от нуля до 0,10 и возвращается обратно: линии появляются, когда расстояние достаточно мало.
Подбор бывает с возвратом и без возврата. В первом случае один контрольный человек может использоваться несколько раз; во втором - только один. Возможен также подбор нескольких контролей на участника. Порядок обхода при жадном подборе без возврата способен повлиять на результат: ранний участник может занять контроль, который оказался бы ближе другому. Поэтому алгоритм, порядок, правило разрешения равенств и допуск нужно описывать заранее.
В более крупной задаче сопоставление можно формулировать и как задачу поиска пар в графе; общую идею паросочетаний разбирает статья об алгоритме Куна. Однако максимальное число пар само по себе не гарантирует хорошего баланса экономических характеристик.
Расчёт на условных данных
Пусть оценки склонности трёх участников равны 0,20; 0,50; 0,80, а их результаты - 12, 15 и 18 условных единиц. В контроле оценки равны 0,18; 0,55; 0,70, результаты - 10, 12 и 13. Данные вымышлены и нужны только для демонстрации алгоритма; исходные признаки, по которым могли быть получены оценки, здесь не заданы.
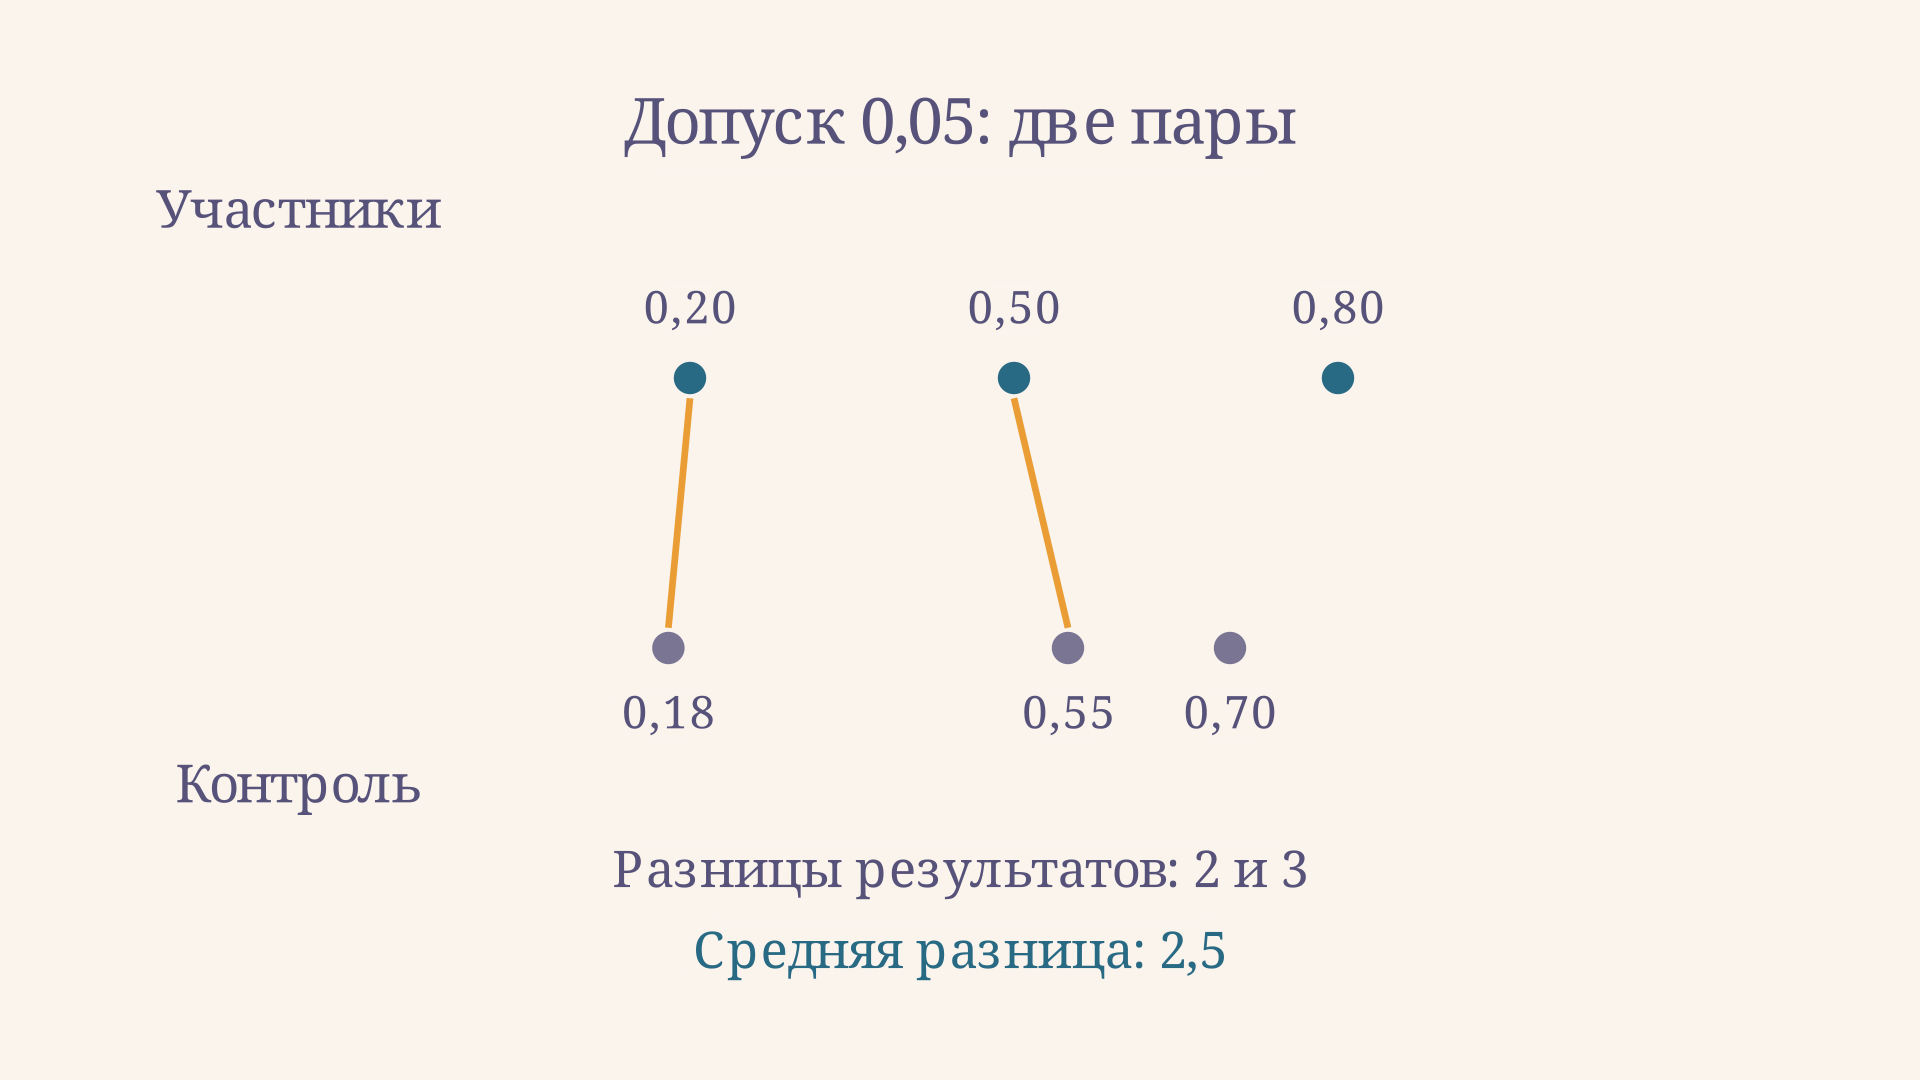
При последовательном подборе без возврата и допуске 0,05 включительно получаем:
| Участник | Контроль | Расстояние оценок | Разница результатов |
|---|---|---|---|
| 0,20; результат 12 | 0,18; результат 10 | 0,02 | 2 |
| 0,50; результат 15 | 0,55; результат 12 | 0,05 | 3 |
| 0,80; результат 18 | нет пары | ближайшее 0,10 | - |
Средняя разница по двум парам равна условной единицы. Если расширить допуск до 0,10, добавится третья пара с разницей , а среднее станет . Изменилось не только качество близости, но и множество участников, для которых рассчитано среднее. При допуске меньше 0,02 ни одной пары нет и средняя разница не определена.
Это арифметика сопоставленных наблюдений, а не установленный эффект курсов. Чтобы обсуждать причинность, нужны сведения о выборке, исходных признаках и выполнении предпосылок. Подбор по оценке сам по себе не доказывает, что оставшиеся группы действительно похожи по каждому важному признаку.
Перекрытие и целевая группа
Область общего перекрытия - значения оценок, в которых представлены и участники, и контроль. Если у некоторых участников оценки намного выше любых контрольных, найти им сопоставимых людей невозможно. Даже при формальной близости оценок следует посмотреть на распределения и убедиться, что пары не построены в редких хвостах данных.
Исключение наблюдений без пары меняет вопрос исследования. Среднее по сохранившимся участникам относится к ним, а не автоматически ко всем получателям программы или ко всему населению. Для эффекта на участников часто используют обозначение , где и - потенциальные исходы. Если часть участников исключена из-за отсутствия подходящего контроля, полученная оценка обычно описывает более узкую группу; её следует назвать явно.
На практике исследователь показывает, сколько наблюдений было до и после отбора, распределения оценок в группах и причины исключений. Проблема представительности начинается ещё на этапе формирования выборки: качественное сопоставление внутри имеющихся данных не исправляет автоматически отбор в само исследование.
Как проверить баланс признаков
После подбора сравнивают исходные ковариаты участников и контроля, а не только сами оценки склонности. Например, если средний возраст в группах всё ещё сильно различается, близкие оценки не решили задачу. Для непрерывного признака можно рассчитать стандартизованную разницу средних:
где - выбранное заранее опорное стандартное отклонение. Для сравнения до и после подбора удобно сохранять один и тот же знаменатель; нужно сообщить, как он рассчитан. Смотрят также распределения, доли категорий и важные взаимодействия, а не только средние. Малое значение отдельного SMD - практический ориентир, а не гарантия отсутствия всех смещений.
Если баланс неудовлетворителен, пересматривают спецификацию модели или способ подбора и снова оценивают баланс. Выбирать вариант исключительно по размеру желаемого эффекта опасно. Итоговую неопределённость тоже нужно оценивать с учётом дизайна подбора и зависимости внутри пар; формула для независимых наблюдений не всегда подходит. Общую идею интервальной оценки поясняет материал о доверительном интервале коэффициента регрессии, хотя для PSM процедура расчёта может отличаться.
На этапе планирования полезно зафиксировать и единицу наблюдения: человек, фирма или территория. Затем определяют момент начала программы и окно, в котором измеряют результат. Например, доход через месяц и доход через год отвечают на разные вопросы. Один и тот же набор пар не делает эти исходы взаимозаменяемыми; пропуски результатов также могут нарушить сопоставимость, если они связаны с участием и будущим доходом. В отчёте следует указать, как обработаны пропуски и сколько пар сохранилось для каждого исхода. При необходимости проводят анализ чувствительности к возможному неизмеренному смешению: он показывает, насколько вывод зависит от дополнительных предположений, но не измеряет скрытую мотивацию напрямую.
Когда возможна причинная интерпретация
Главное допущение - при заданных измеренных до воздействия признаках распределение участия не зависит от потенциальных исходов. Его называют условной независимостью или отсутствием неизмеренного смешения. К примеру, если мотивация влияет и на запись на курсы, и на будущий доход, но не измерена, пары могут различаться именно по ней. Проверка баланса наблюдаемых данных не способна доказать отсутствие такого скрытого фактора.
Также требуется достаточное перекрытие вероятностей участия и ясное определение воздействия и исходов. Обычно предполагают, что воздействие одного человека не меняет потенциальный исход другого и что версии воздействия определены достаточно однозначно. В экономических программах эти условия могут нарушаться, например когда участники конкурируют за одни вакансии.
В модель включают содержательно обоснованные факторы, известные до программы, особенно общие причины участия и исхода. Переменные, возникшие после начала программы и находящиеся на пути её влияния на результат, способны исказить оценку. Точный выбор признаков требует знания предметной области, а не только высокого качества предсказания участия.
Частые ошибки
- Считать одинаковые оценки доказательством одинаковости людей. Баланс проверяют по каждому существенному исходному признаку.
- Называть среднюю разницу причинным эффектом без обсуждения неизмеренных факторов и перекрытия.
- Скрывать потерянные наблюдения: после отсева целевая группа может измениться.
- Выбирать допуск только ради максимального числа пар. Более широкие пары могут оказаться менее сопоставимыми.
- Использовать признаки, измеренные после начала воздействия, как обычные исходные ковариаты.
FAQ
Обязательно ли использовать логистическую регрессию?
Нет. Она часто применяется для оценки вероятностей, но метод оценки выбирают по задаче. Результат оценивают по перекрытию и балансу, а не только по точности классификации участия.
Одинаковые оценки означают одинаковые исходные признаки?
Нет. Разные наборы характеристик могут давать близкие вероятности. Баланс - свойство распределений групп, которое необходимо проверить на данных после подбора.
Почему нельзя просто сравнить средние доходы всех групп?
Можно посчитать такую разницу, но при самостоятельном отборе в программу она смешивает её возможное влияние с различиями участников и контроля. Сопоставление пытается уменьшить наблюдаемую часть этого смешения при явных предпосылках.
Коротко
PSM строит сравнимые группы с помощью оценок вероятности участия по исходным признакам. Допуск, способ подбора и наличие перекрытия определяют состав пар; после этого проверяют баланс и оценивают неопределённость. Причинный вывод дополнительно зависит от содержательных предпосылок, включая отсутствие существенных неизмеренных факторов.
Читайте также
Абсолютное преимущество Смита: пример и расчёт
Абсолютное преимущество Смита простыми словами: как сравнить затраты труда, рассчитать выигрыш от специализации и отличить его от сравнительного преимущества Рикардо.

Аддитивная факторная модель: формула и пример расчёта
Аддитивная факторная модель в экономике: как разложить показатель на слагаемые, рассчитать вклад каждого изменения и проверить результат на примере прибыли.
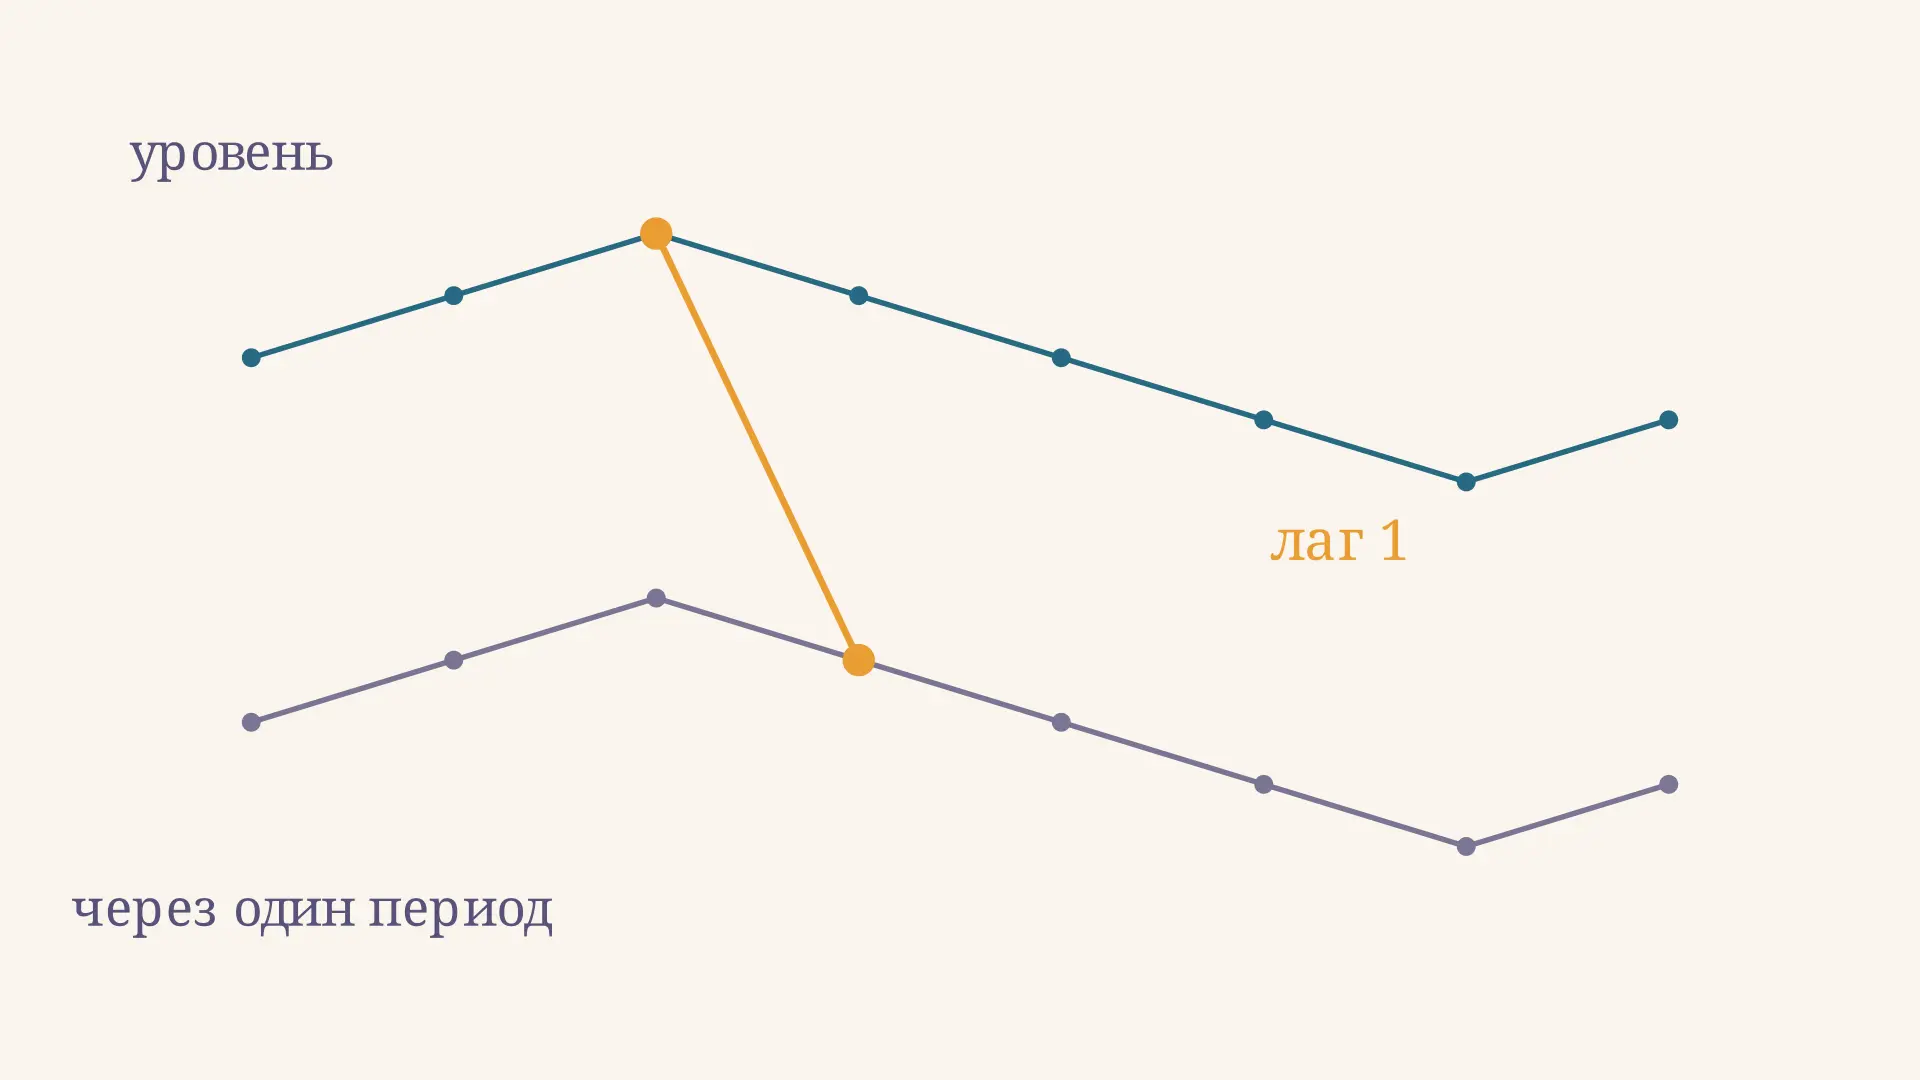
Автокорреляция уровней временного ряда: расчёт
Автокорреляция уровней временного ряда: как выбрать лаг, вычислить коэффициент на числовом примере и прочитать коррелограмму с учётом тренда и сезонности.
Базовый индекс потребительских цен: смысл и расчёт
Что показывает базовый индекс потребительских цен, какие компоненты исключают из расчёта, как сопоставить его с общим ИПЦ и правильно прочитать результат на примере.

Детерминированный факторный анализ: методы и пример
Детерминированный факторный анализ показывает вклад факторов в изменение показателя. Разбираем модели, цепные подстановки, абсолютные разницы и проверку расчёта.
Горизонтальная и вертикальная дифференциация
Горизонтальная и вертикальная дифференциация продуктов: как различить вкусы и качество, сравнить выбор при равных ценах и разобрать смешанные примеры.