Индекс энтропии: формула и расчёт индекса Тейла
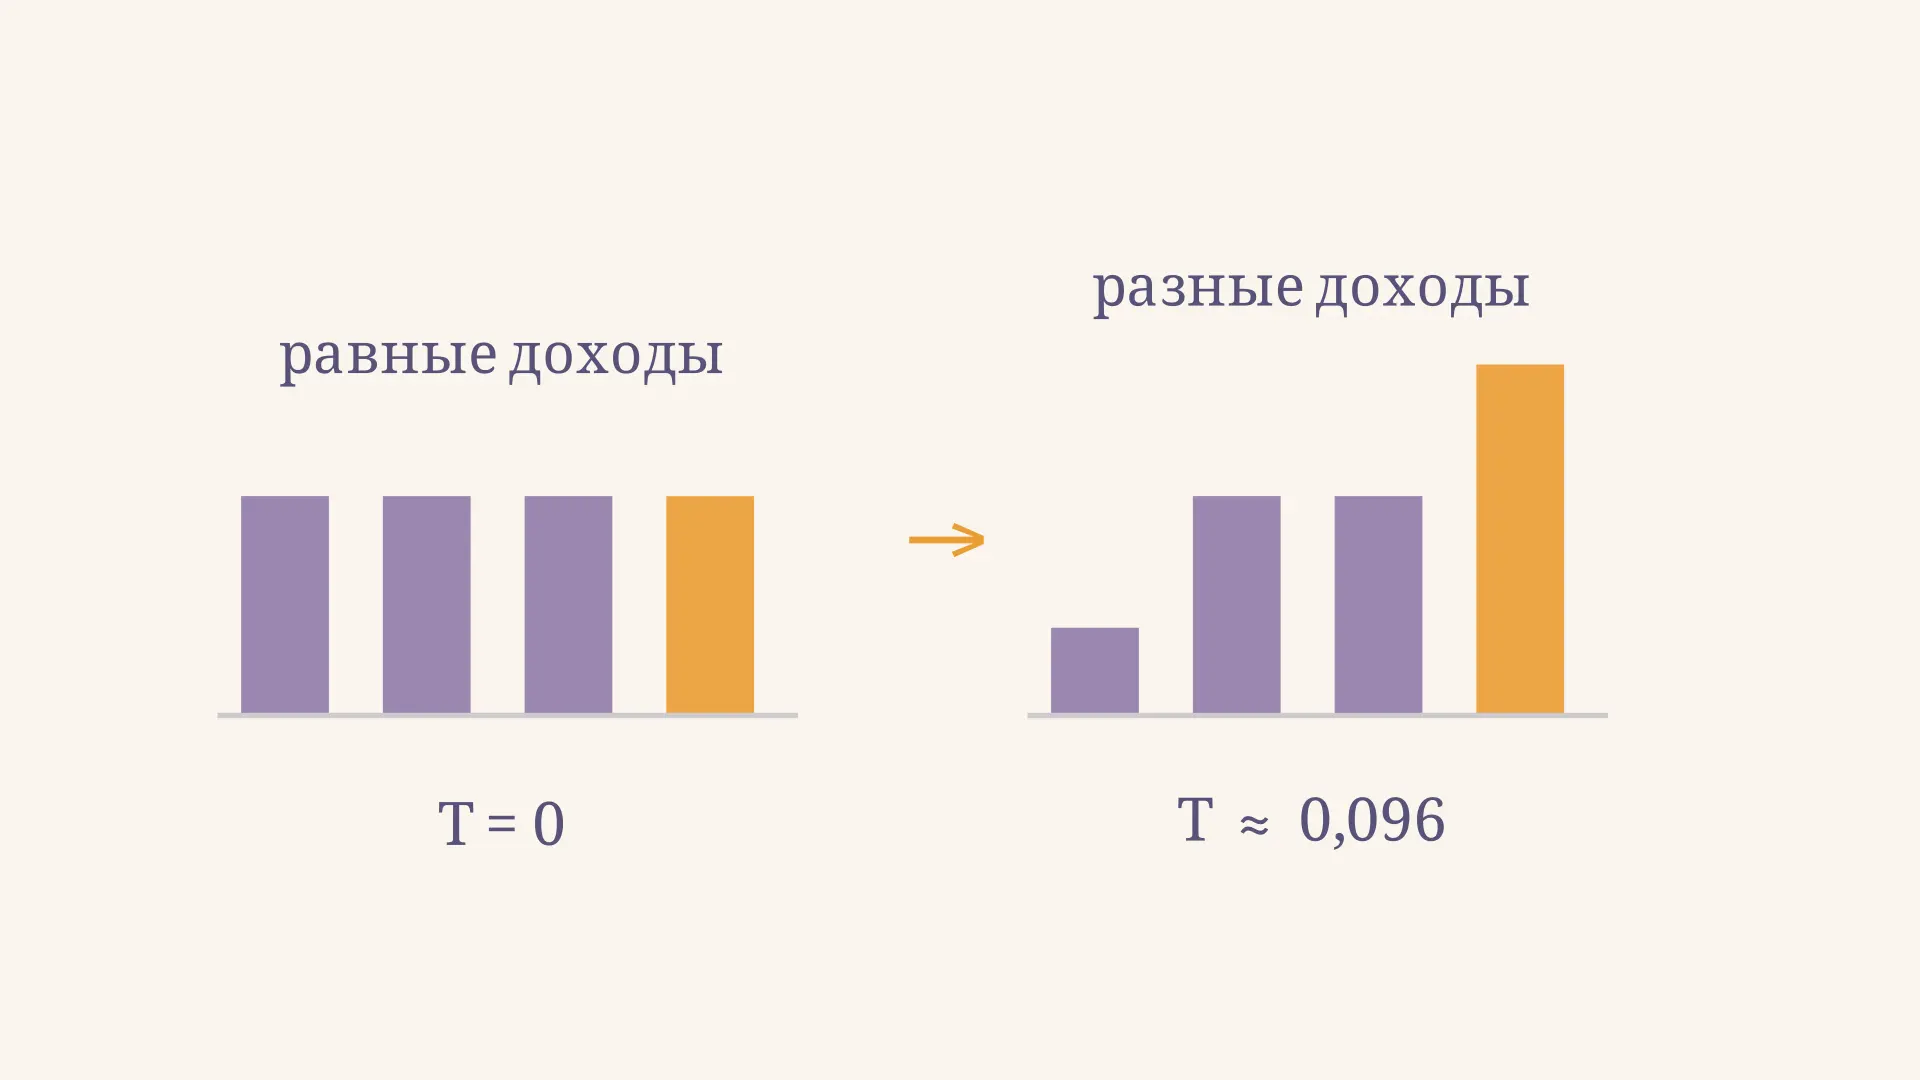
Индекс энтропии в экономике помогает описать, насколько неравномерно распределён доход. Под этим названием встречаются разные показатели, поэтому формулу всегда нужно уточнять. Здесь разберём индекс Тейла T, или : он равен нулю при одинаковых доходах и возрастает, когда распределение становится более концентрированным. В учебной модели ниже можно переместить часть дохода от одного человека к другому и увидеть, как изменится показатель при неизменной общей сумме.
Что измеряет индекс Тейла
Представим четырёх получателей с доходами по 25 условных единиц. Их общий доход равен 100, а доля каждого составляет четверть. Если первый передаст 15 единиц четвёртому, получится распределение 10, 25, 25 и 40. Средний доход по-прежнему равен 25, но равенство исчезло. Индекс Тейла позволяет выразить это изменение одним числом.
Показатель относится к семейству обобщённой энтропии. Всемирный банк обозначает индекс Тейла как и выделяет его способность раскладываться по подгруппам. При этом «энтропия» здесь связана с распределением долей дохода, а не с измерением температуры или теплоты. Физический смысл другой: об этом подробнее в статье об энтропии в химии.
Высокий означает большее относительное неравенство, чем низкий , если сравниваются одинаково определённые доходы и сопоставимые группы. Число не говорит само по себе, достаточно ли людям денег, справедливо ли распределение или почему возникли различия. Для этих выводов нужны дополнительные данные.
Формула и обозначения
Пусть - число людей, - доход человека, а - средний доход. Для неотрицательных доходов при положительной общей сумме индекс рассчитывают так:
Здесь - натуральный логарифм. Отношение безразмерно: единицы измерения дохода сокращаются. Доход ниже среднего даёт отрицательное слагаемое, а выше среднего - положительное; однако вся сумма неотрицательна. Если все доходы равны среднему, каждый логарифм равен нулю и .
Удобна и другая запись. Обозначим через долю человека в общем доходе. Тогда
Эта формула сравнивает долю дохода с равной долей . При нулевом доходе соответствующее слагаемое принимается равным нулю по пределу . При отрицательных доходах такая запись неприменима; если общий доход равен нулю, индекс также не определён.
Пример расчёта по четырём доходам
Возьмём учебные данные 10, 25, 25 и 40. Их сумма равна 100, среднее - 25, а доли равны 0,10; 0,25; 0,25 и 0,40. Подстановка в формулу долей даёт:
Два средних дохода дают нулевые слагаемые. Остальные вместе дают . Это не процент дохода и не доля населения: показатель безразмерен. Если умножить все четыре дохода на десять, доли и индекс останутся прежними. Сравнивая значения за разные годы, следует проверить, что они относятся к одной единице наблюдения, например к людям, а не в одном году к людям и в другом к домохозяйствам.
Для конечной группы из человек максимальное значение достигается, когда весь доход приходится на одного человека. Поэтому при максимум равен . Иногда используют нормировку ; в нашем примере она составляет около . Это отдельная величина, и её не следует молча подменять исходным индексом. При нормировка не определена.
Разложение на группы
Одно из преимуществ индекса Тейла - возможность отделить различия внутри групп от различий между их средними доходами. Разделим пример на две пары: первая получает 10 и 25, вторая - 25 и 40. Обозначим через долю группы в населении, через - её долю в доходе, а через - индекс, рассчитанный только внутри группы. Тогда
Вес внутреннего индекса T - именно доля дохода группы. Межгрупповая часть показывает, каким был бы индекс, если бы каждый внутри своей группы получал средний доход этой группы. Это разложение требует непересекающихся групп, которые вместе охватывают всю совокупность. Группу с нулевым суммарным доходом в формуле по долям учитывают по пределу; её внутренний индекс отдельно не определён.
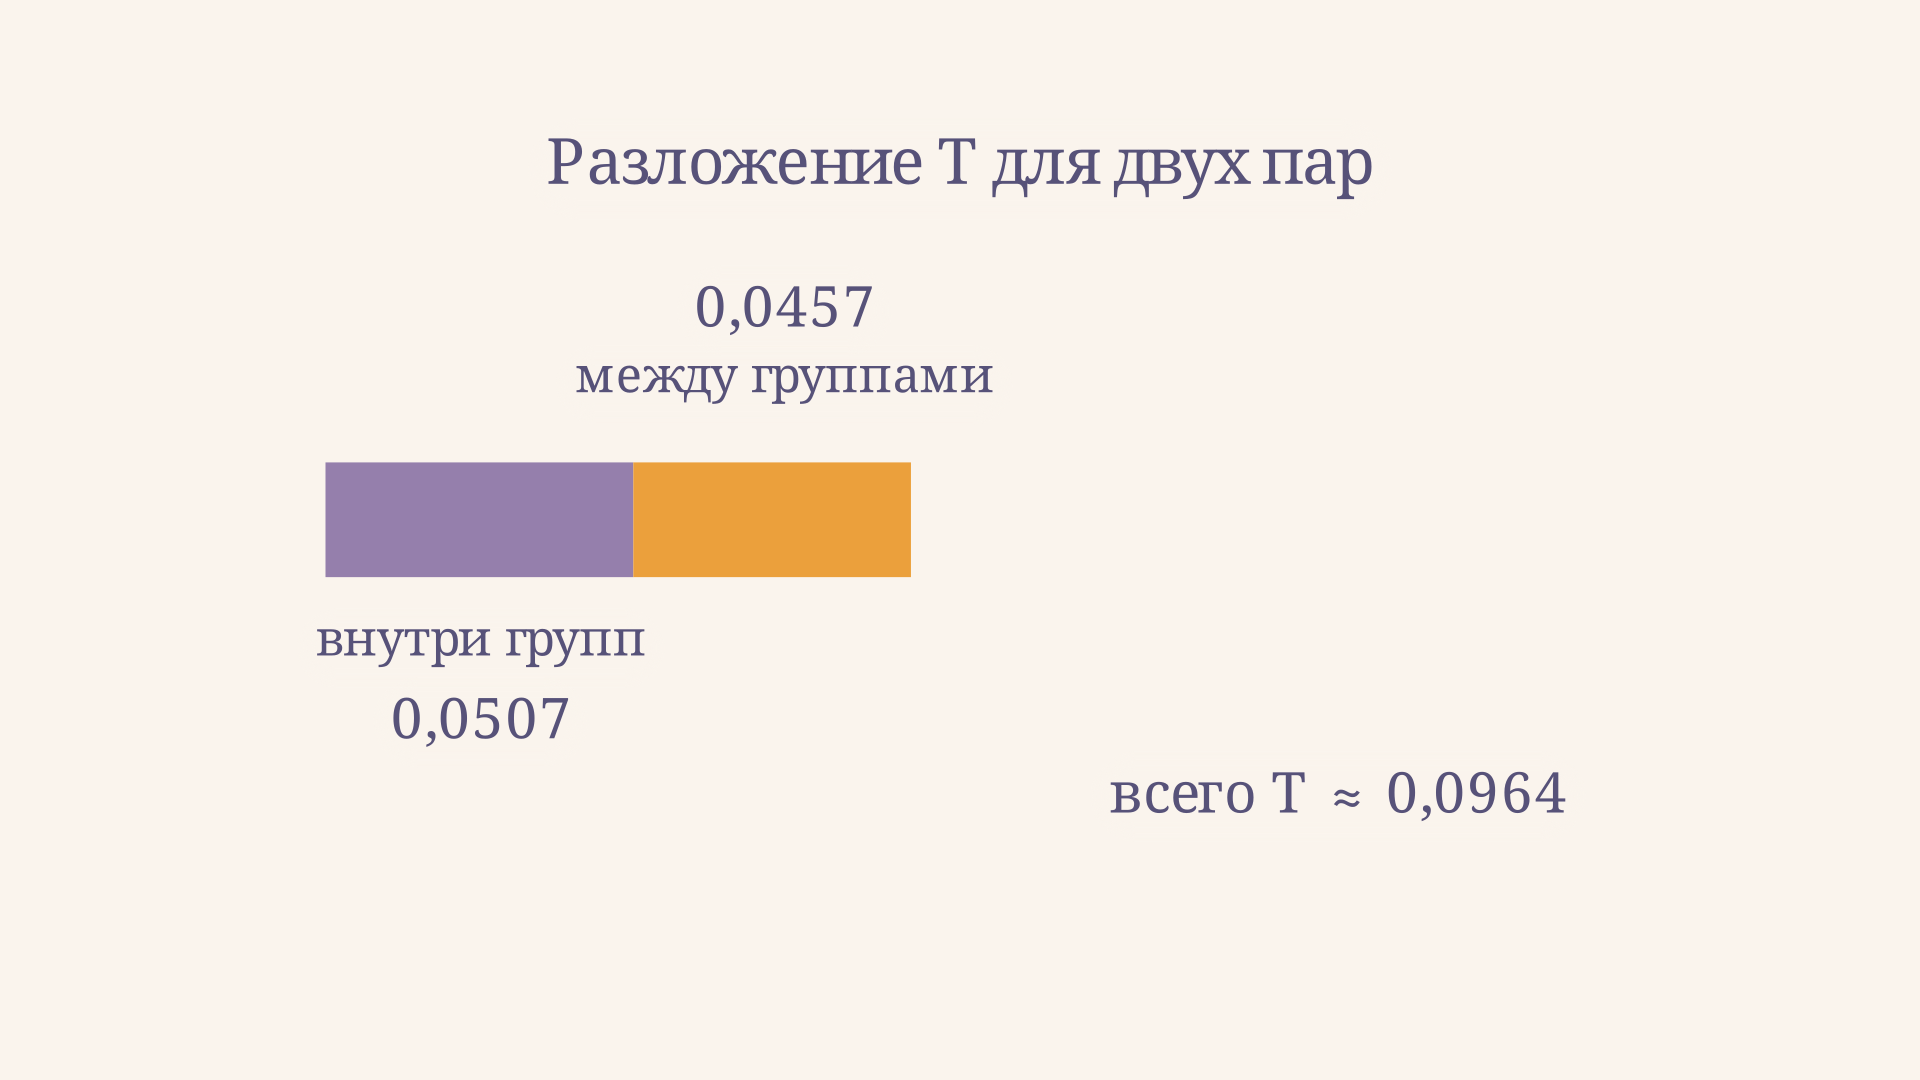
В первой паре доля населения 0,5 и доля дохода 0,35; во второй - соответственно 0,5 и 0,65. Расчёт даёт внутреннюю компоненту около 0,0507, а межгрупповую - около 0,0457. Их сумма с учётом округления составляет 0,0964. Подробный вывод разложения приведён в руководстве Всемирного банка по измерению бедности и неравенства.
Межгрупповая часть зависит от выбранного разбиения. Если группировать людей по регионам, она описывает различия средних региональных доходов; если по возрасту - различия между возрастными средними. Это не доказательство того, что регион или возраст вызвал неравенство: признаки могут быть связаны с образованием, занятостью и другими факторами.
Как связаны энтропия и неравенство
Для долей дохода можно определить энтропию Шеннона . При равных долях она равна , а индекс Тейла записывается как
Таким образом, при фиксированном числе получателей измеряет отклонение энтропии долей дохода от её максимума. Чем ближе распределение к равным долям, тем меньше разность. Эта связь не превращает доход в вероятность случайного события буквально: здесь доли используются как математическое распределение. Аналогии с порядком полезны, пока не заменяют определение показателя; похожую осторожность при переносе термина в другую область обсуждает статья об энтропии и искусстве Арнхейма.
Семейство включает и среднее логарифмическое отклонение , или индекс Тейла L. Оно использует другую формулу и иначе взвешивает внутренние групповые компоненты; при нулевом доходе человека конечное значение L не получается. Поэтому обозначение «индекс Тейла» без буквы или формулы недостаточно для воспроизводимого расчёта.
Сравнение с коэффициентом Джини
Коэффициент Джини также описывает относительное неравенство, но основан на другой конструкции - кривой Лоренца или попарных различиях доходов. Его привычный диапазон от нуля до единицы не переносится автоматически на индекс Тейла: при нескольких получателях может превышать единицу. Числа двух показателей нельзя напрямую сравнивать как одинаковые проценты.
Выбор зависит от вопроса. Для объяснения общего разрыва часто удобен Джини и его графическая интерпретация. Для анализа вклада различий внутри и между заранее заданными группами полезно аддитивное разложение Тейла. В исследовании дифференциации заработной платы показатели распределения дополняют друг друга, но не заменяют сведения о причинах различий.
Как читать сравнение двух распределений
Пусть в двух выборках одинаковое число людей и одинаковый средний доход. Если в первой у всех по 25 единиц, её индекс равен нулю; распределение 10, 25, 25 и 40 из примера имеет положительный индекс. Разница говорит о большей концентрации дохода во второй выборке, но не раскрывает отдельные истории её участников. Один и тот же индекс могут дать разные наборы доходов, поэтому рядом полезно показывать медиану, доли групп или сами распределения.
Даже рост среднего дохода не обязан уменьшать индекс. Например, пропорциональное удвоение всех доходов повышает среднее вдвое, но сохраняет относительные доли каждого человека и, следовательно, T. Обратное тоже возможно: перераспределение при постоянной сумме меняет индекс, хотя среднее остаётся прежним. Поэтому динамику уровня жизни и динамику относительного неравенства рассматривают как разные вопросы.
При сравнении территорий с разной численностью важно также указать, применяется ли нормировка на . В исследовательской практике обычно приводят исходное значение выбранной меры и явно описывают правила расчёта, чтобы другой исследователь мог повторить результат. Округление оставляют на последний шаг: раннее округление долей и логарифмов может создать расхождение между общей величиной и суммой её компонент.
Как подготовить данные
Сначала определите единицу наблюдения и сам доход: личный или домохозяйства, до налогов или после них, за месяц или год. Затем проверьте пропуски, нули и отрицательные значения. Ноль допустим для при положительной общей сумме, но убыток требует другого подхода. При сравнении территорий или периодов определения и состав данных должны совпадать.
В расчёте выше каждый получатель имеет одинаковый вес. Если исходные данные сгруппированы, одной записи на группу недостаточно: нужно учитывать численность или выборочные веса. Замена всех доходов группы её средним уничтожает различия внутри группы и поэтому показывает только межгрупповую часть для выбранного разбиения. Такой результат не равен полному индексу, когда внутри групп есть различия.
Частые ошибки
- Считать как «9,64 % дохода»: это значение индекса, а не доля дохода.
- Смешивать натуральный и десятичный логарифмы: численные значения получатся разными.
- Взвешивать внутренние индексы T долями населения вместо долей дохода.
- Исключать нулевые доходы без объяснения: это меняет состав выборки и результат.
- Приписывать межгрупповую компоненту причинному эффекту признака группировки.
FAQ
Может ли индекс Тейла быть больше единицы?
Да. Для неотрицательных доходов при положительной сумме максимум , который при достаточно большом превышает единицу. Это не ошибка вычисления.
Что означает нулевой индекс?
Все доходы в рассматриваемой группе равны. Нуль не показывает, высоки ли эти доходы: одинаково низкие и одинаково высокие доходы дают один результат.
Чем T отличается от L?
Оба принадлежат семейству обобщённой энтропии, но используют разные формулы и веса. Для T нулевой доход учитывается по пределу; в L логарифм от нулевого дохода не даёт конечного значения.
Коротко
Индекс энтропии Тейла T сравнивает доли дохода с равным распределением. Для четырёх доходов 10, 25, 25 и 40 он составляет около 0,0964; разложение на две пары даёт 0,0507 внутри групп и 0,0457 между группами. Интерпретация зависит от формулы, единицы наблюдения, исходных данных и способа разбиения.
Читайте также
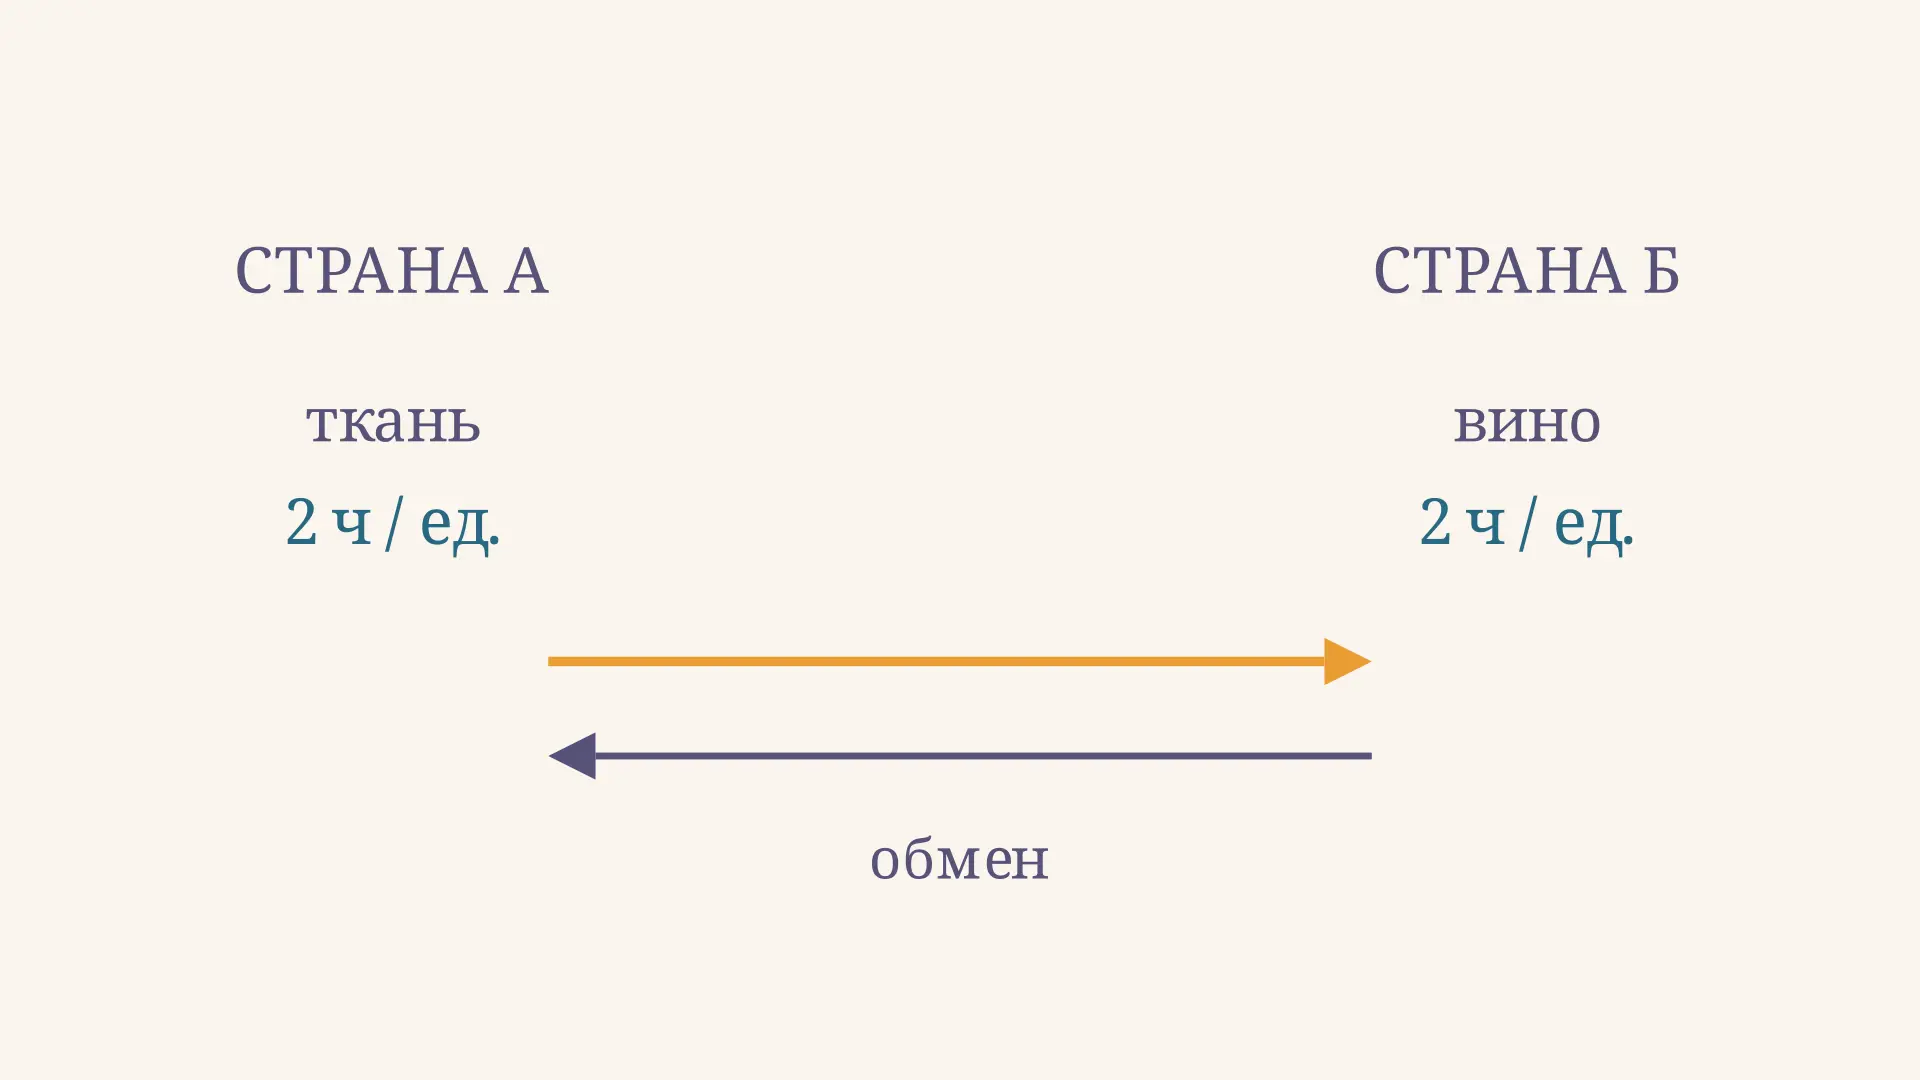
Абсолютное преимущество Смита: пример и расчёт
Абсолютное преимущество Смита простыми словами: как сравнить затраты труда, рассчитать выигрыш от специализации и отличить его от сравнительного преимущества Рикардо.

Аддитивная факторная модель: формула и пример расчёта
Аддитивная факторная модель в экономике: как разложить показатель на слагаемые, рассчитать вклад каждого изменения и проверить результат на примере прибыли.
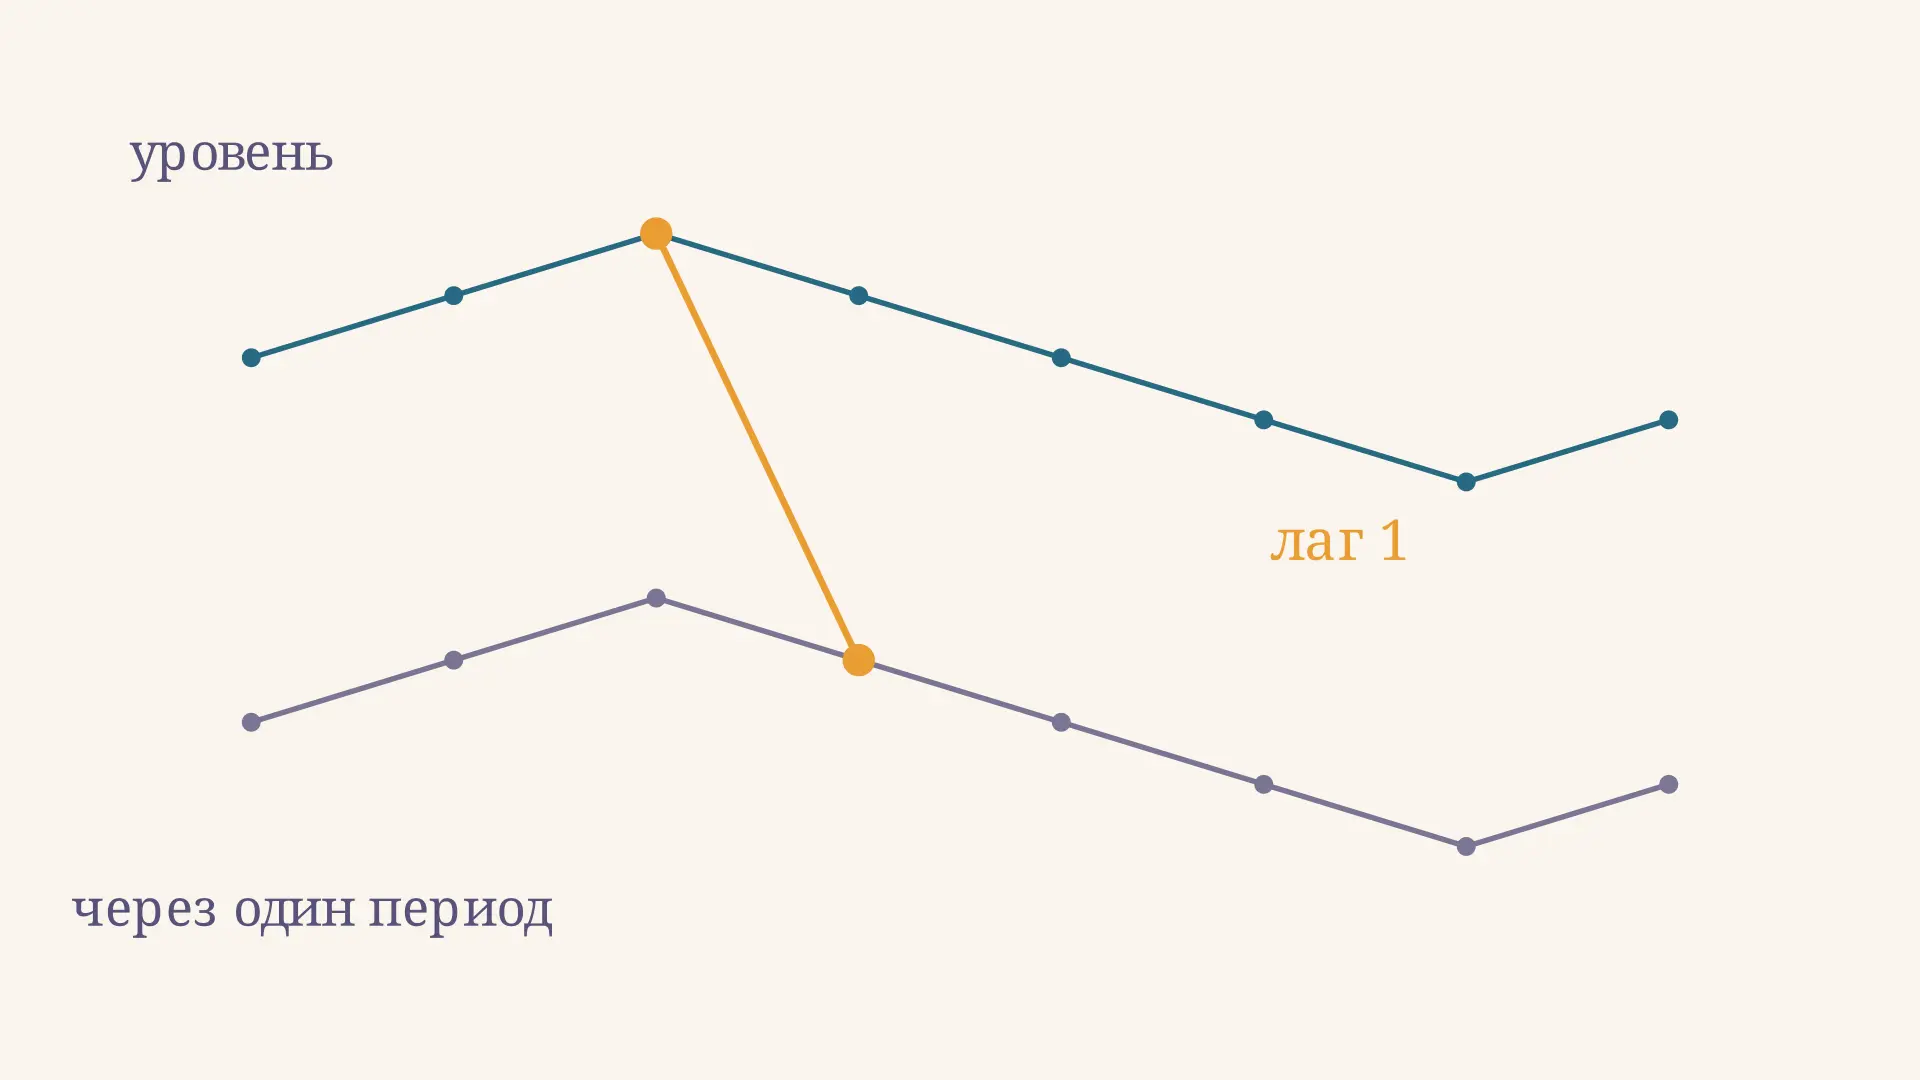
Автокорреляция уровней временного ряда: расчёт
Автокорреляция уровней временного ряда: как выбрать лаг, вычислить коэффициент на числовом примере и прочитать коррелограмму с учётом тренда и сезонности.
Базовый индекс потребительских цен: смысл и расчёт
Что показывает базовый индекс потребительских цен, какие компоненты исключают из расчёта, как сопоставить его с общим ИПЦ и правильно прочитать результат на примере.

Детерминированный факторный анализ: методы и пример
Детерминированный факторный анализ показывает вклад факторов в изменение показателя. Разбираем модели, цепные подстановки, абсолютные разницы и проверку расчёта.
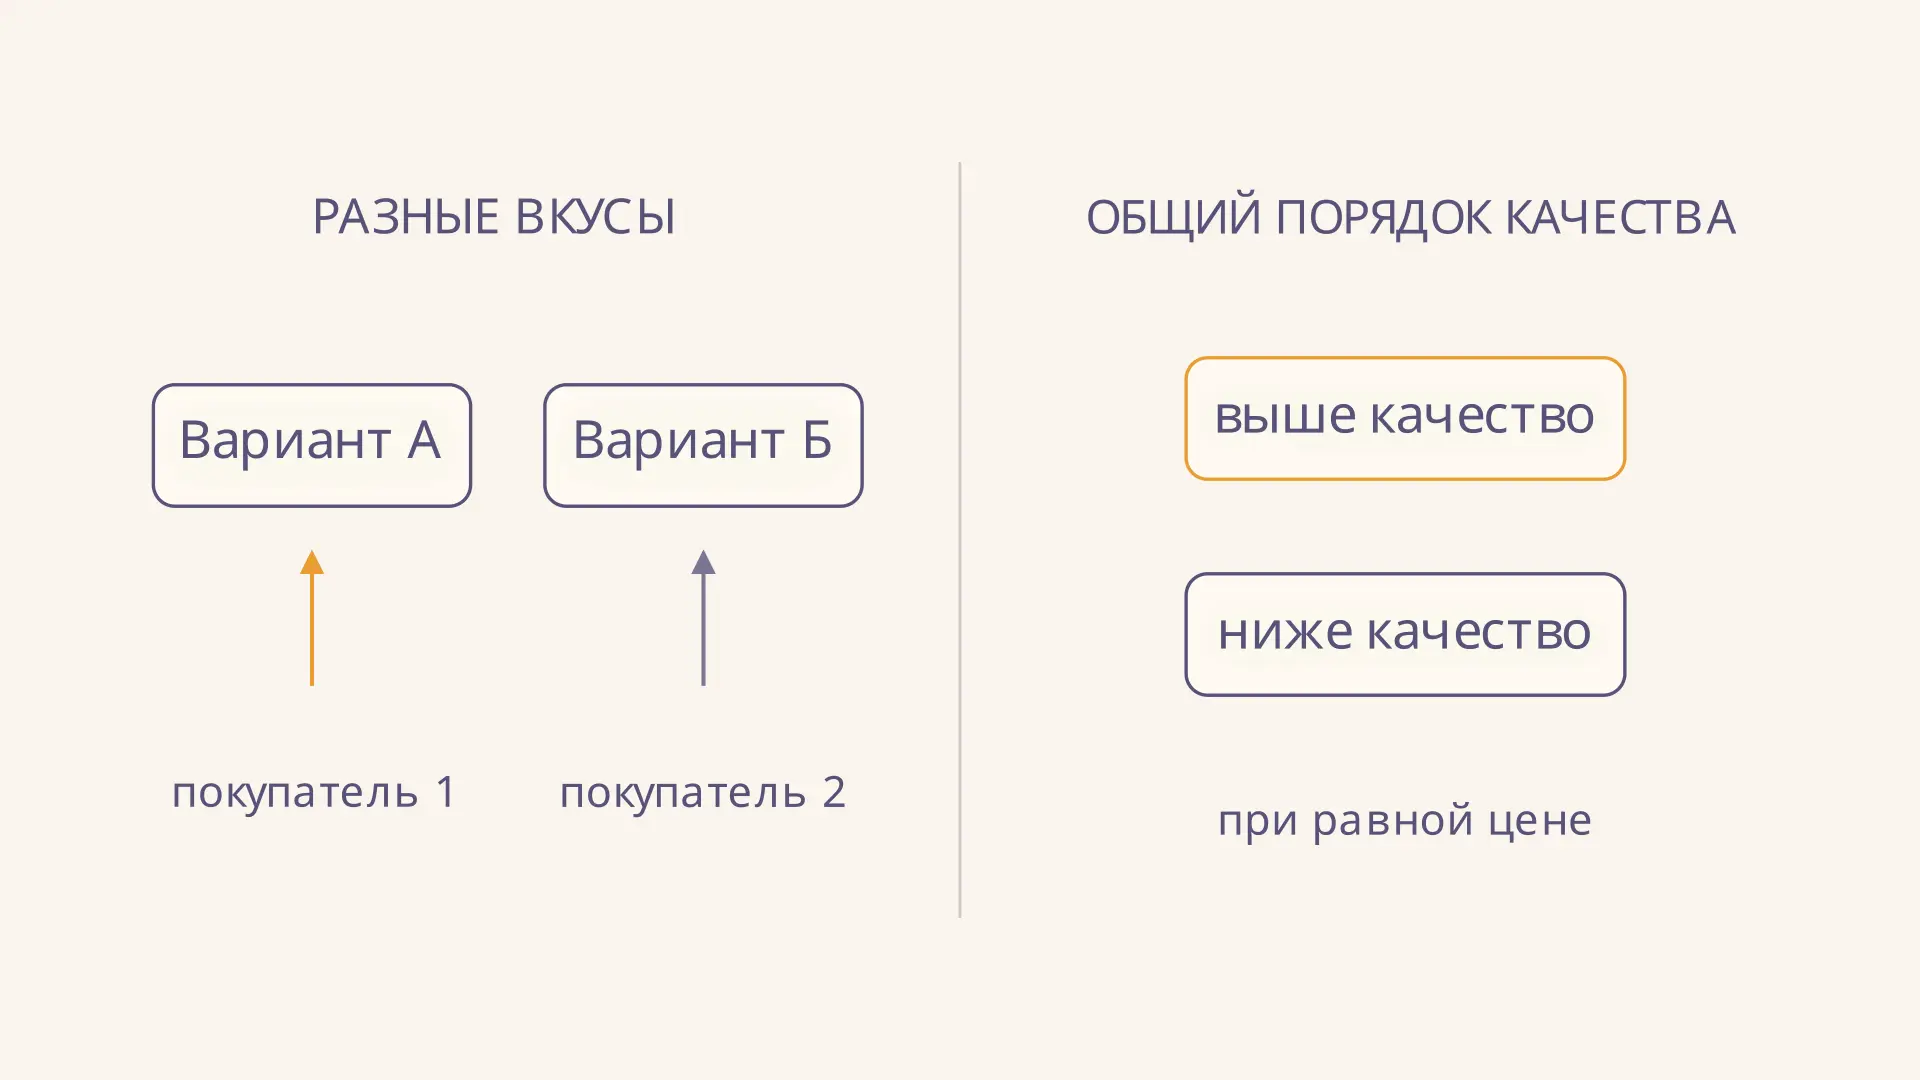
Горизонтальная и вертикальная дифференциация
Горизонтальная и вертикальная дифференциация продуктов: как различить вкусы и качество, сравнить выбор при равных ценах и разобрать смешанные примеры.